CV輪講 (Jan. 10, 2020)
How Much Position Information
Do Convolutional Neural Networks Encode?
宮澤 一之
AI本部AIシステム部AI研究開発第二グループ
株式会社ディー・エヌ・エー
自己紹介
2
@kzykmyzw
宮澤 一之
AI本部AIシステム部AI研究開発第二G
株式会社ディー・エヌ・エー
2007〜2010年 東北大学博士課程
2010〜2019年 電機メーカ研究所
2019年〜 DeNA
生体認証やステレオビジョンの研究に従事
日本学術振興会特別研究員(DC1)
映像符号化、標準化活動
車載・監視カメラ物体認識、外観検査
AI研究開発エンジニア
論文情報
タイトル
How Much Position Information Do Convolutional Neural Networks Encode?
著者
Md Amirul Islam, Sen Jia, Neil D. B. Bruce (Ryerson University)
概要
• CNNは画像の絶対位置情報を隠に学習しているという仮説を検証
• シンプルな実験方法で位置情報が学習されていることを確認
• 何が位置情報の学習に寄与しているかを指摘し、実験で妥当性を確認
3
なぜこの論文を選んだか
• ICLR2020にspotlightでアクセプト
• OpenReviewを見ると、査読者3人が全員8点満点* (全員8点は2594本中わずか34本)
• 課題設定が面白く、実験方法もシンプルでわかりやすい
• CNNが位置情報を学習するのに必要な要素を指摘している
4
* OpenReviewにおける点数ランキングは以下から確認できる
https://chillee.github.io/OpenReviewExplorer/
CNNは位置情報を学習しているか?
• CNNが学習しているのは局所的なフィルタの係数であり、画像の絶対位置は学習してい
ないため、カプセルネットワークやRNNによる位置情報の陽な獲得が試みられてきた
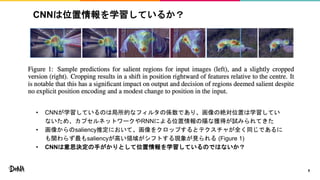
• 画像からのsaliency推定において、画像をクロップするとテクスチャが全く同じであるに
も関わらず最もsaliencyが高い領域がシフトする現象が見られる (Figure 1)
• CNNは意思決定の手がかりとして位置情報を学習しているのではないか?
5
どうやって確かめるか
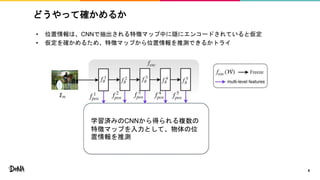
• 位置情報は、CNNで抽出される特徴マップ中に隠にエンコードされていると仮定
• 仮定を確かめるため、特徴マップから位置情報を推測できるかトライ
6
学習済みのCNNから得られる複数の
特徴マップを入力として、物体の位
置情報を推測
PosENet (Position Encoding Network)
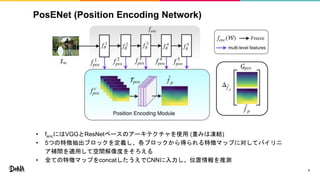
• fencにはVGGとResNetベースのアーキテクチャを使用 (重みは凍結)
• 5つの特徴抽出ブロックを定義し、各ブロックから得られる特徴マップに対してバイリニ
ア補間を適用して空間解像度をそろえる
• 全ての特徴マップをconcatしたうえでCNNに入力し、位置情報を推測
7
位置情報の真値とは?
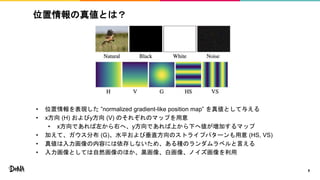
• 位置情報を表現した ”normalized gradient-like position map” を真値として与える
• x方向 (H) およびy方向 (V) のそれぞれのマップを用意
• x方向であれば左から右へ、y方向であれば上から下へ値が増加するマップ
• 加えて、ガウス分布 (G)、水平および垂直方向のストライプパターンも用意 (HS, VS)
• 真値は入力画像の内容には依存しないため、ある種のランダムラベルと言える
• 入力画像としては自然画像のほか、黒画像、白画像、ノイズ画像を利用
8
PosENetの学習
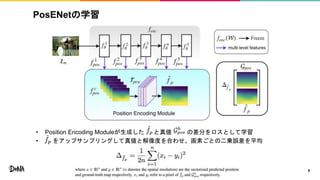
• Position Encoding Moduleが生成した と真値 の差分をロスとして学習
• をアップサンプリングして真値と解像度を合わせ、画素ごとの二乗誤差を平均
9
実験
• 実験にはSaliency検出向けのデータセットを利用
• 学習:DUT-S (10,533枚)
• 検証:PASCAL-S、黒画像、白画像、ノイズ画像
• 評価尺度
• Spearman Correlation (SPC):PosENet出力と真値のスピアマン相関
• Mean Absolute Error (MAE):PosENet出力と真値の平均絶対誤差
10
ネットワークアーキテクチャ
• 特徴抽出のためのネットワークにはImageNetで学習したVGG16および
ResNet-152を利用 (重みは固定)
• PosENetはカーネルサイズ3x3の畳み込み1層だけ
• 学習時には画像サイズを224x224に固定
• 抽出する特徴マップのサイズはリサイズで28x28に揃える
• 特徴抽出をせず、画像をダイレクトにPosENetに入力する方法も実験
11
結果
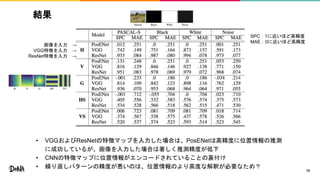
• VGGおよびResNetの特徴マップを入力した場合は、PosENetは高精度に位置情報の推測
に成功しているが、画像を入力した場合は著しく推測精度が低下
• CNNの特徴マップに位置情報がエンコードされていることの裏付け
• 繰り返しパターンの精度が悪いのは、位置情報のより高度な解釈が必要なため?
12
SPC:1に近いほど高精度
MAE:0に近いほど高精度
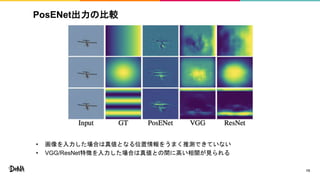
画像を入力 →
VGG特徴を入力 →
ResNet特徴を入力 →
PosENet出力の比較
• 画像を入力した場合は真値となる位置情報をうまく推測できていない
• VGG/ResNet特徴を入力した場合は真値との間に高い相関が見られる
13
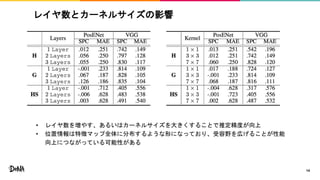
レイヤ数とカーネルサイズの影響
• レイヤ数を増やす、あるいはカーネルサイズを大きくすることで推定精度が向上
• 位置情報は特徴マップ全体に分布するような形になっており、受容野を広げることが性能
向上につながっている可能性がある
14
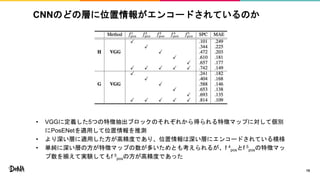
CNNのどの層に位置情報がエンコードされているのか
• VGGに定義した5つの特徴抽出ブロックのそれぞれから得られる特徴マップに対して個別
にPosENetを適用して位置情報を推測
• より深い層に適用した方が高精度であり、位置情報は深い層にエンコードされている模様
• 単純に深い層の方が特徴マップの数が多いためとも考えられるが、f 4
posとf 5
posの特徴マッ
プ数を揃えて実験してもf 5
posの方が高精度であった
15
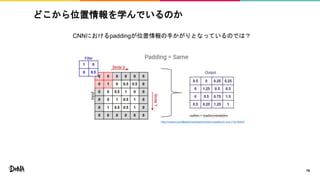
どこから位置情報を学んでいるのか
CNNにおけるpaddingが位置情報の手かがりとなっているのでは?
16
https://medium.com/@ayeshmanthaperera/what-is-padding-in-cnns-71b21fb0dd7
実験による確認
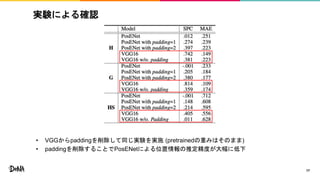
• VGGからpaddingを削除して同じ実験を実施 (pretrainedの重みはそのまま)
• paddingを削除することでPosENetによる位置情報の推定精度が大幅に低下
17
実験による確認
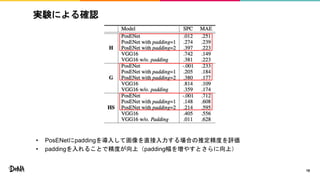
• PosENetにpaddingを導入して画像を直接入力する場合の推定精度を評価
• paddingを入れることで精度が向上(padding幅を増やすとさらに向上)
18
実験による確認
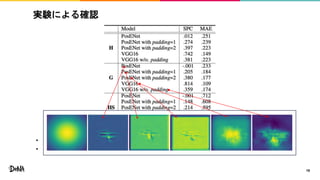
• PosENetにpaddingを導入して画像を直接入力する場合の推定精度を評価
• paddingを入れることで精度が向上(padding幅を増やすとさらに向上)
19
より位置情報が重要なタスクでの検証
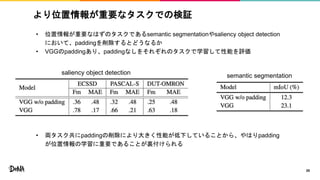
• 位置情報が重要なはずのタスクであるsemantic segmentationやsaliency object detection
において、paddingを削除するとどうなるか
• VGGのpaddingあり、paddingなしをそれぞれのタスクで学習して性能を評価
• 両タスク共にpaddingの削除により大きく性能が低下していることから、やはりpadding
が位置情報の学習に重要であることが裏付けられる
20
saliency object detection semantic segmentation
より位置情報が重要なタスクでの検証
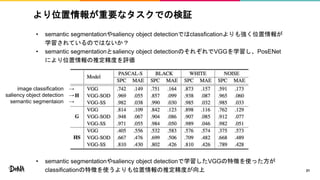
• semantic segmentationやsaliency object detectionではclassficationよりも強く位置情報が
学習されているのではないか?
• semantic segmentationとsaliency object detectionのそれぞれでVGGを学習し、PosENet
により位置情報の推定精度を評価
• semantic segmentationやsaliency object detectionで学習したVGGの特徴を使った方が
classificationの特徴を使うよりも位置情報の推定精度が向上 21
image classification →
saliency object detection →
semantic segmentaion →
まとめ
• CNNは学習の過程で画像の絶対位置の情報を隠にエンコードしているのではないかという
仮説を検証
• 学習済みCNNの特徴マップから極めてシンプルなCNNで位置情報が抽出できることを実証
• CNNで一般的に使われるpaddingが位置情報の学習に重要であることを指摘し、さまざま
な実験によりその妥当性を確認
22