畳み込みニューラルネットワークの
高精度化と高速化
内田祐介
AIシステム部
株式会社ディー・エヌ・エー
1
第21回ステアラボ人工知能セミナー
自己紹介
• 内田祐介(株式会社ディー・エヌ・エー AIシステム部 副部長)
• 〜2017年:通信キャリアの研究所で画像認識・検索の研究に従事
• 2016年 :社会人学生として博士号を取得(情報理工学)
• 2017年〜:DeNA中途入社、深層学習を中心とした
コンピュータビジョン技術の研究開発に従事
2
Twitter: https://twitter.com/yu4u
GitHub: https://github.com/yu4u
Qiita: https://qiita.com/yu4u
SlideShare: https://www.slideshare.net/ren4yu
medium: https://medium.com/@yu4u
本日の発表の内容
• 畳み込みニューラルネットワークの高精度化
• ILSVRC歴代の優勝モデルから
畳み込みニューラルネットワークの歴史を振り返る
• 近年の畳み込みニューラルネットワーク高精度化手法を
いくつかのタイプに分類、解説
• 畳み込みニューラルネットワークの高速化
• 特定のハードウェアに依存しない高速化手法を
いくつかのタイプに分類、解説
3
畳み込みニューラルネットワークの
高精度化
4
ILSVRCで振り返るCNNの進化
• ImageNet Large Scale Visual Recognition Challenge (ILSVRC)
• ImageNetデータセットを利用したコンペ
• WordNetをもとにクラスを定義
• 各クラスのデータを大量に収集&アノテーション
• 学習データ120万枚、テストデータ10万枚
• クラス分類、物体検出、位置特定等のタスクが存在
• 特にクラス分類の精度の推移が画像認識の進化の
指標として参考にされることが多い
• 2012年に深層学習ベースの手法が優勝して以降、
(畳み込み)ニューラルネットワークの天下一武道会化
• ここでの優勝モデルがデファクトスタンダードとして利用される
• セグメンテーション等、他のタスクでも利用される
5
ILSVRC
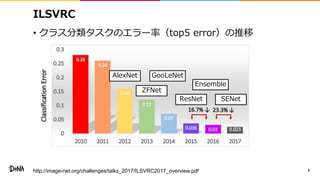
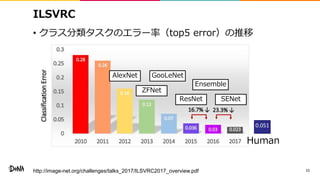
• クラス分類タスクのエラー率(top5 error)の推移
6
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
ILSVRC
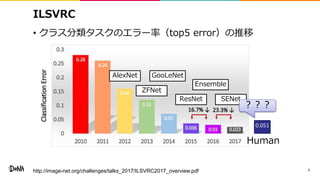
• クラス分類タスクのエラー率(top5 error)の推移
7http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
0.051
Human
???
人間のエラー率5.1%?
• そもそも人間のエラー率は0%なのでは?
• No, ImageNetがどうやって作成されたかに関係
• ImageNetデータセットの作成手順
• WordNetを元に1000クラスを定義
• 検索エンジンで各クラスの画像を収集
• クラウドワーカーが各画像とクラスが
対応しているか否かのバイナリ判定
• ImageNetのタスク
• 画像が与えられ、1000クラスから1つのクラスを選択
8http://karpathy.github.io/2014/09/02/what-i-learned-from-competing-against-a-convnet-on-imagenet/
人間のエラー率5.1%?
• “1 smart, trained and highly education human being
performed at that error rate”
https://amundtveit.com/tag/imagenet/
• Andrej Karpathyさん (Stanford→OpenAI→Tesla)
9https://github.com/karpathy
Karpathyさんのエラー率5.1までの道のり
• 2014年のGoogLeNetの達成精度 (top5 error 6.7%) から
人間との比較をすべきと考えた
• 専用のアノテーションツールを作成
• ILSVRCに従事しているラボメンでも
1000クラスから5クラス選択することは非常に難しい
• GoogLeNetの結果を利用して、候補を100クラスに限定
• それでも難しくラボの熟練ラベラーでも13〜15%のエラー率
• 自分が訓練データを用い、”苦痛を伴う長時間の学習”を経て、じっ
くりアノテーションするのが効率的と気づいた
• train on 500 validation images -> 1500 test images
• テストエラー5.1%を達成!犬の品種に詳しくなった!
• 上記のように、エラー率5.1%は天才がかなり頑張った結果
• とはいえCNNの学習時間に比べるとまだ足りないという考え方も 10
ILSVRC
• クラス分類タスクのエラー率(top5 error)の推移
11
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
0.051
Human
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
Before AlexNet
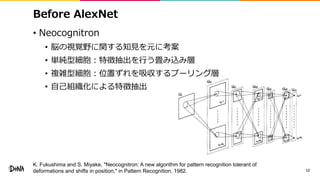
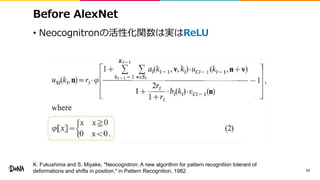
• Neocognitron
• 脳の視覚野に関する知見を元に考案
• 単純型細胞:特徴抽出を行う畳み込み層
• 複雑型細胞:位置ずれを吸収するプーリング層
• 自己組織化による特徴抽出
12
K. Fukushima and S. Miyake, "Neocognitron: A new algorithm for pattern recognition tolerant of
deformations and shifts in position," in Pattern Recognition, 1982.
Before AlexNet
• Neocognitronの活性化関数は実はReLU
13
K. Fukushima and S. Miyake, "Neocognitron: A new algorithm for pattern recognition tolerant of
deformations and shifts in position," in Pattern Recognition, 1982.
Before AlexNet
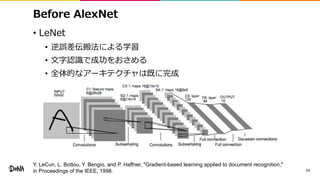
• LeNet
• 逆誤差伝搬法による学習
• 文字認識で成功をおさめる
• 全体的なアーキテクチャは既に完成
14
Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, "Gradient-based learning applied to document recognition,"
in Proceedings of the IEEE, 1998.
Before AlexNet
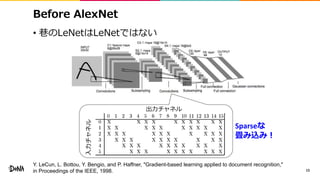
• 巷のLeNetはLeNetではない
15
出力チャネル
入力チャネル
Sparseな
畳み込み!
Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, "Gradient-based learning applied to document recognition,"
in Proceedings of the IEEE, 1998.
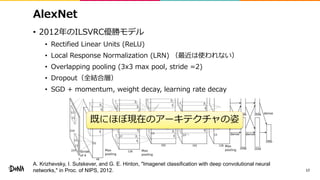
AlexNet
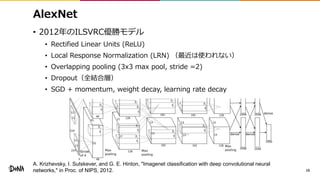
• 2012年のILSVRC優勝モデル
• Rectified Linear Units (ReLU)
• Local Response Normalization (LRN) (最近は使われない)
• Overlapping pooling (3x3 max pool, stride =2)
• Dropout(全結合層)
• SGD + momentum, weight decay, learning rate decay
16
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "Imagenet classification with deep convolutional neural
networks," in Proc. of NIPS, 2012.
AlexNet
• 2012年のILSVRC優勝モデル
• Rectified Linear Units (ReLU)
• Local Response Normalization (LRN) (最近は使われない)
• Overlapping pooling (3x3 max pool, stride =2)
• Dropout(全結合層)
• SGD + momentum, weight decay, learning rate decay
17
既にほぼ現在のアーキテクチャの姿
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "Imagenet classification with deep convolutional neural
networks," in Proc. of NIPS, 2012.
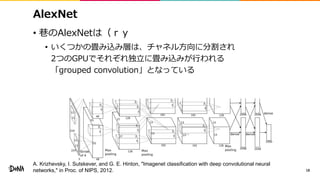
AlexNet
• 巷のAlexNetは(ry
• いくつかの畳み込み層は、チャネル方向に分割され
2つのGPUでそれぞれ独立に畳み込みが行われる
「grouped convolution」となっている
18
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "Imagenet classification with deep convolutional neural
networks," in Proc. of NIPS, 2012.
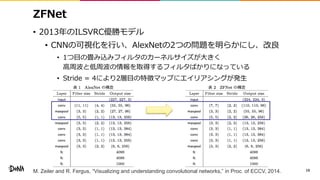
ZFNet
• 2013年のILSVRC優勝モデル
• CNNの可視化を行い、AlexNetの2つの問題を明らかにし、改良
• 1つ目の畳み込みフィルタのカーネルサイズが大きく
高周波と低周波の情報を取得するフィルタばかりになっている
• Stride = 4により2層目の特徴マップにエイリアシングが発生
19M. Zeiler and R. Fergus, “Visualizing and understanding convolutional networks,” in Proc. of ECCV, 2014.
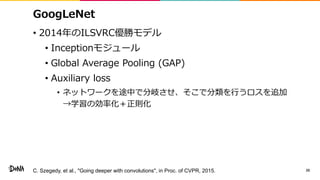
GoogLeNet
• 2014年のILSVRC優勝モデル
• Inceptionモジュール
• Global Average Pooling (GAP)
• Auxiliary loss
• ネットワークを途中で分岐させ、そこで分類を行うロスを追加
→学習の効率化+正則化
20C. Szegedy, et al., "Going deeper with convolutions", in Proc. of CVPR, 2015.
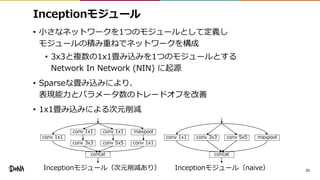
Inceptionモジュール
• 小さなネットワークを1つのモジュールとして定義し
モジュールの積み重ねでネットワークを構成
• 3x3と複数の1x1畳み込みを1つのモジュールとする
Network In Network (NIN) に起源
• Sparseな畳み込みにより、
表現能力とパラメータ数のトレードオフを改善
• 1x1畳み込みによる次元削減
21
concat
conv 1x1 conv 1x1 maxpool
conv 1x1
conv 3x3 conv 5x5 conv 1x1
concat
maxpoolconv 1x1 conv 3x3 conv 5x5
Inceptionモジュール(次元削減あり) Inceptionモジュール(naive)
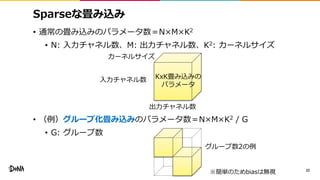
Sparseな畳み込み
• 通常の畳み込みのパラメータ数=N×M×K2
• N: 入力チャネル数、M: 出力チャネル数、K2: カーネルサイズ
• (例)グループ化畳み込みのパラメータ数=N×M×K2 / G
• G: グループ数
22
入力チャネル数
出力チャネル数
カーネルサイズ
グループ数2の例
※簡単のためbiasは無視
KxK畳み込みの
パラメータ
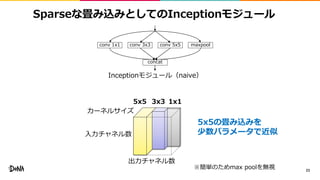
Sparseな畳み込みとしてのInceptionモジュール
23
concat
maxpoolconv 1x1 conv 3x3 conv 5x5
Inceptionモジュール(naive)
入力チャネル数
出力チャネル数
カーネルサイズ
5x5 3x3 1x1
5x5の畳み込みを
少数パラメータで近似
※簡単のためmax poolを無視
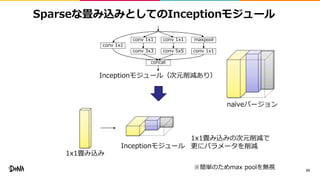
Sparseな畳み込みとしてのInceptionモジュール
24
concat
conv 1x1 conv 1x1 maxpool
conv 1x1
conv 3x3 conv 5x5 conv 1x1
Inceptionモジュール(次元削減あり)
1x1畳み込み
Inceptionモジュール
※簡単のためmax poolを無視
1x1畳み込みの次元削減で
更にパラメータを削減
naïveバージョン
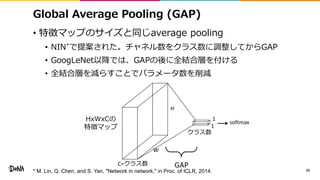
Global Average Pooling (GAP)
• 特徴マップのサイズと同じaverage pooling
• NIN*で提案された。チャネル数をクラス数に調整してからGAP
• GoogLeNet以降では、GAPの後に全結合層を付ける
• 全結合層を減らすことでパラメータ数を削減
25
W
H
C=クラス数
1
1HxWxCの
特徴マップ
クラス数
GAP
softmax
* M. Lin, Q. Chen, and S. Yan, "Network in network," in Proc. of ICLR, 2014.
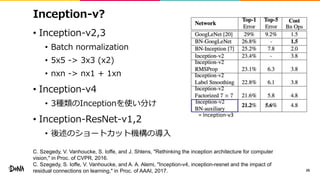
Inception-v?
• Inception-v2,3
• Batch normalization
• 5x5 -> 3x3 (x2)
• nxn -> nx1 + 1xn
• Inception-v4
• 3種類のInceptionを使い分け
• Inception-ResNet-v1,2
• 後述のショートカット機構の導入
26
= Inception-v3
C. Szegedy, V. Vanhoucke, S. Ioffe, and J. Shlens, "Rethinking the inception architecture for computer
vision," in Proc. of CVPR, 2016.
C. Szegedy, S. Ioffe, V. Vanhoucke, and A. A. Alemi, "Inception-v4, inception-resnet and the impact of
residual connections on learning," in Proc. of AAAI, 2017.
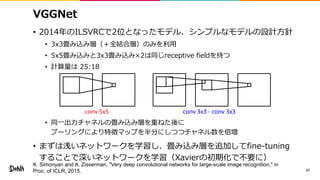
VGGNet
• 2014年のILSVRCで2位となったモデル、シンプルなモデルの設計方針
• 3x3畳み込み層(+全結合層)のみを利用
• 5x5畳み込みと3x3畳み込み×2は同じreceptive fieldを持つ
• 計算量は 25:18
• 同一出力チャネルの畳み込み層を重ねた後に
プーリングにより特徴マップを半分にしつつチャネル数を倍増
• まずは浅いネットワークを学習し、畳み込み層を追加してfine-tuning
することで深いネットワークを学習(Xavierの初期化で不要に)
27
conv 5x5 conv 3x3 - conv 3x3
K. Simonyan and A. Zisserman, "Very deep convolutional networks for large-scale image recognition," in
Proc. of ICLR, 2015.
Residual Networks (ResNet)*
• 2015年のILSVRC優勝モデル
• Residualモジュール(ショートカット機構)の導入→後述
• Batch normalizationの導入
• ネットワーク内の共変量シフトを軽減
• Global Average Pooling (GAP) の利用
• Heの初期化の利用
• ReLUを考慮したパラメータの初期化
• ショートカットを展開していくと複数の深さの違う
ネットワークのアンサンブルとなっている**
28
* K. He, X. Zhang, S. Ren, and J. Sun, "Deep residual learning for image recognition," in Proc. of CVPR, 2016.
** A. Veit, M. Wilber, and S. Belongie, "Residual networks behave like ensembles of relatively shallow
networks," in Proc. of NIPS, 2016.
Residualモジュール
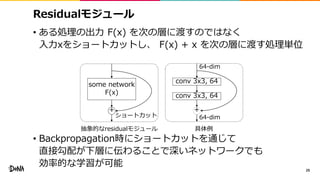
• ある処理の出力 F(x) を次の層に渡すのではなく
入力xをショートカットし、 F(x) + x を次の層に渡す処理単位
• Backpropagation時にショートカットを通じて
直接勾配が下層に伝わることで深いネットワークでも
効率的な学習が可能
29
some network
F(x) conv 3x3, 64
conv 3x3, 64
ショートカット
+ +
64-dim
64-dim
抽象的なresidualモジュール 具体例
ResNetの構造
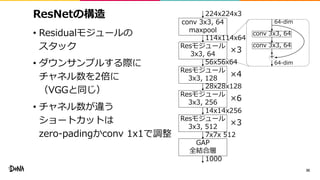
• Residualモジュールの
スタック
• ダウンサンプルする際に
チャネル数を2倍に
(VGGと同じ)
• チャネル数が違う
ショートカットは
zero-padingかconv 1x1で調整
30
Resモジュール
3x3, 64
Resモジュール
3x3, 128
Resモジュール
3x3, 256
Resモジュール
3x3, 512
GAP
全結合層
conv 3x3, 64
maxpool
×3
×4
×6
×3
conv 3x3, 64
conv 3x3, 64
+
64-dim
64-dim
114x114x64
224x224x3
56x56x64
28x28x128
14x14x256
7x7x 512
1000
ResNet Bottleneckバージョン
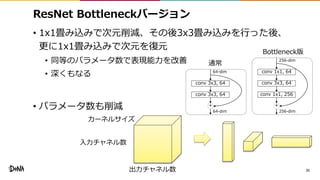
• 1x1畳み込みで次元削減、その後3x3畳み込みを行った後、
更に1x1畳み込みで次元を復元
• 同等のパラメータ数で表現能力を改善
• 深くもなる
• パラメータ数も削減
31
conv 3x3, 64
conv 3x3, 64
+
64-dim
64-dim
conv 1x1, 256
conv 3x3, 64
+
conv 1x1, 64
256-dim
256-dim
入力チャネル数
出力チャネル数
カーネルサイズ
通常
Bottleneck版
Squeeze-and-Excitation Networks (SENet)
• 2017年のILSVRC優勝モデル
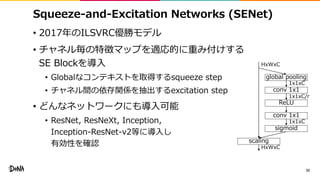
• チャネル毎の特徴マップを適応的に重み付けする
SE Blockを導入
• Globalなコンテキストを取得するsqueeze step
• チャネル間の依存関係を抽出するexcitation step
• どんなネットワークにも導入可能
• ResNet, ResNeXt, Inception,
Inception-ResNet-v2等に導入し
有効性を確認
32
conv 1x1
global pooling
ReLU
conv 1x1
sigmoid
scaling
HxWxC
1x1xC
1x1xC/r
1x1xC
HxWxC
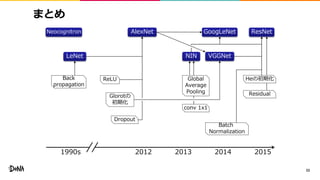
まとめ
33
Residual
AlexNet
VGGNet
GoogLeNet ResNet
Batch
Normalization
LeNet
Neocognitron
Back
propagation
Heの初期化
Glorotの
初期化
conv 1x1
Dropout
ReLU
1990s 2012 2013 2014 2015
NIN
Global
Average
Pooling
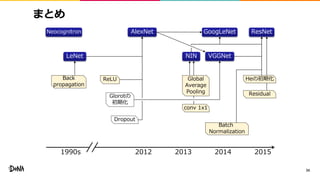
まとめ
34
AlexNet
VGGNet
GoogLeNet ResNet
Batch
Normalization
LeNet
Neocognitron
Back
propagation
Heの初期化
Glorotの
初期化
conv 1x1
Dropout
ReLU
1990s 2012 2013 2014 2015
NIN
Global
Average
Pooling Residual
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
※基本的に各論文の手法は自身がstate-of-the-artだと
言っているので精度の結果とかは載せません
35
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
36
Residualモジュールの改良
• Residualモジュールをゴニョゴニョする
• WideResNet*
• 深くするより、幅(チャネル数)を大きくして(相対的に)
浅いネットワークのほうが精度・学習速度が優秀
• PyramidNet**
• サウンサンプルするタイミングでチャネル数を
2倍にするのではなく、全てのresidualモジュールで
徐々にチャネル数を増加させる
• チャネル数を2倍にするresidualモジュールに
ネットワークが過度に依存してしまうのを防ぐ
37
* S. Zagoruyko and N. Komodakis, "Wide residual networks," in Proc. of BMVC, 2016.
** D. Han, J. Kim, and J. Kim, "Deep pyramidal residual networks," in Proc. of CVPR, 2017.
Residualモジュールのベストプラクティス
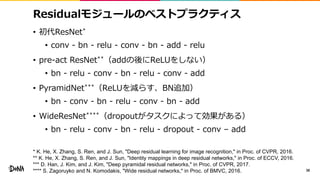
• 初代ResNet*
• conv - bn - relu - conv - bn - add - relu
• pre-act ResNet**(addの後にReLUをしない)
• bn - relu - conv - bn - relu - conv - add
• PyramidNet***(ReLUを減らす、BN追加)
• bn - conv - bn - relu - conv - bn - add
• WideResNet****(dropoutがタスクによって効果がある)
• bn - relu - conv - bn - relu - dropout - conv – add
38
* K. He, X. Zhang, S. Ren, and J. Sun, "Deep residual learning for image recognition," in Proc. of CVPR, 2016.
** K. He, X. Zhang, S. Ren, and J. Sun, "Identity mappings in deep residual networks," in Proc. of ECCV, 2016.
*** D. Han, J. Kim, and J. Kim, "Deep pyramidal residual networks," in Proc. of CVPR, 2017.
**** S. Zagoruyko and N. Komodakis, "Wide residual networks," in Proc. of BMVC, 2016.
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
39
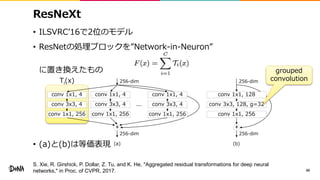
conv 1x1, 4
conv 3x3, 4
conv 1x1, 256
conv 1x1, 4
conv 3x3, 4
conv 1x1, 256
conv 1x1, 4
conv 3x3, 4
conv 1x1, 256
...
+
256-dim
256-dim
conv 1x1, 128
conv 3x3, 128, g=32
conv 1x1, 256
256-dim
256-dim
+
(a) (b)
Ti(x)
grouped
convolution
ResNeXt
• ILSVRC’16で2位のモデル
• ResNetの処理ブロックを”Network-in-Neuron”
に置き換えたもの
• (a)と(b)は等価表現
40
S. Xie, R. Girshick, P. Dollar, Z. Tu, and K. He, "Aggregated residual transformations for deep neural
networks," in Proc. of CVPR, 2017.
ResNeXt
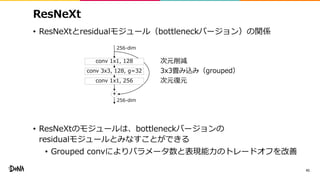
• ResNeXtとresidualモジュール(bottleneckバージョン)の関係
• ResNeXtのモジュールは、bottleneckバージョンの
residualモジュールとみなすことができる
• Grouped convによりパラメータ数と表現能力のトレードオフを改善
41
conv 1x1, 128
conv 3x3, 128, g=32
conv 1x1, 256
256-dim
256-dim
+
次元削減
次元復元
3x3畳み込み(grouped)
PolyNet
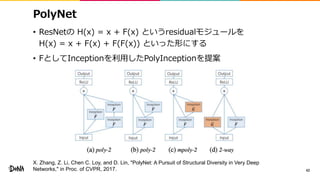
• ResNetの H(x) = x + F(x) というresidualモジュールを
H(x) = x + F(x) + F(F(x)) といった形にする
• FとしてInceptionを利用したPolyInceptionを提案
42
X. Zhang, Z. Li, Chen C. Loy, and D. Lin, "PolyNet: A Pursuit of Structural Diversity in Very Deep
Networks," in Proc. of CVPR, 2017.
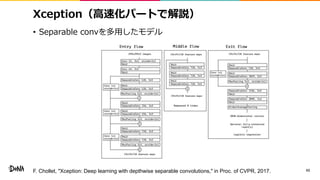
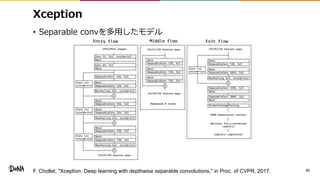
Xception(高速化パートで解説)
• Separable convを多用したモデル
43F. Chollet, "Xception: Deep learning with depthwise separable convolutions," in Proc. of CVPR, 2017.
Octave Convolution
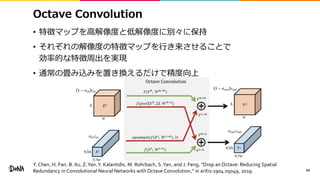
• 特徴マップを高解像度と低解像度に別々に保持
• それぞれの解像度の特徴マップを行き来させることで
効率的な特徴周出を実現
• 通常の畳み込みを置き換えるだけで精度向上
44
Y. Chen, H. Fan, B. Xu, Z.Yan,Y. Kalantidis, M. Rohrbach, S.Yan, and J. Feng, "Drop an Octave: Reducing Spatial
Redundancy in Convolutional Neural Networks with Octave Convolution," in arXiv:1904.05049, 2019.
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
45
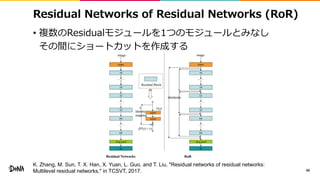
Residual Networks of Residual Networks (RoR)
• 複数のResidualモジュールを1つのモジュールとみなし
その間にショートカットを作成する
46
K. Zhang, M. Sun, T. X. Han, X. Yuan, L. Guo, and T. Liu, "Residual networks of residual networks:
Multilevel residual networks," in TCSVT, 2017.
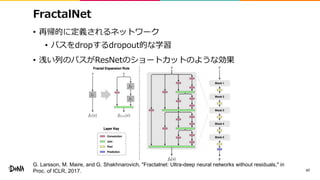
FractalNet
• 再帰的に定義されるネットワーク
• パスをdropするdropout的な学習
• 浅い列のパスがResNetのショートカットのような効果
47
G. Larsson, M. Maire, and G. Shakhnarovich, "Fractalnet: Ultra-deep neural networks without residuals," in
Proc. of ICLR, 2017.
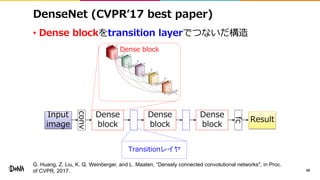
DenseNet (CVPR’17 best paper)
• Dense blockをtransition layerでつないだ構造
48
conv
Dense
block
Dense
block
Dense
block
fc
Input
image
Result
G. Huang, Z. Liu, K. Q. Weinberger, and L. Maaten, “Densely connected convolutional networks", in Proc.
of CVPR, 2017.
Dense block
Transitionレイヤ
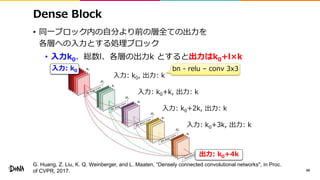
Dense Block
• 同一ブロック内の自分より前の層全ての出力を
各層への入力とする処理ブロック
• 入力k0、総数l、各層の出力k とすると出力はk0+l×k
49
入力: k0, 出力: k
入力: k0+k, 出力: k
入力: k0+2k, 出力: k
入力: k0+3k, 出力: k
bn - relu – conv 3x3入力: k0
出力: k0+4k
G. Huang, Z. Liu, K. Q. Weinberger, and L. Maaten, “Densely connected convolutional networks", in Proc.
of CVPR, 2017.
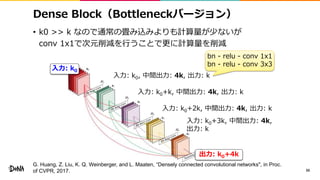
Dense Block(Bottleneckバージョン)
• k0 >> k なので通常の畳み込みよりも計算量が少ないが
conv 1x1で次元削減を行うことで更に計算量を削減
50
入力: k0, 中間出力: 4k, 出力: k
入力: k0+k, 中間出力: 4k, 出力: k
入力: k0+2k, 中間出力: 4k, 出力: k
入力: k0+3k, 中間出力: 4k,
出力: k
bn - relu - conv 1x1
bn - relu - conv 3x3
入力: k0
出力: k0+4k
G. Huang, Z. Liu, K. Q. Weinberger, and L. Maaten, “Densely connected convolutional networks", in Proc.
of CVPR, 2017.
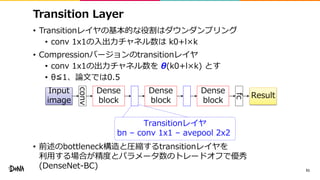
Transition Layer
• Transitionレイヤの基本的な役割はダウンダンプリング
• conv 1x1の入出力チャネル数は k0+l×k
• Compressionバージョンのtransitionレイヤ
• conv 1x1の出力チャネル数を θ(k0+l×k) とす
• θ≦1、論文では0.5
• 前述のbottleneck構造と圧縮するtransitionレイヤを
利用する場合が精度とパラメータ数のトレードオフで優秀
(DenseNet-BC) 51
conv
Dense
block
Dense
block
Dense
block
fc
Input
image
Result
Transitionレイヤ
bn – conv 1x1 – avepool 2x2
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
52
Residual
モジュール
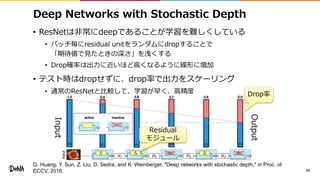
Drop率
Input
Output
Deep Networks with Stochastic Depth
• ResNetは非常にdeepであることが学習を難しくしている
• バッチ毎にresidual unitをランダムにdropすることで
「期待値で見たときの深さ」を浅くする
• Drop確率は出力に近いほど高くなるように線形に増加
• テスト時はdropせずに、drop率で出力をスケーリング
• 通常のResNetと比較して、学習が早く、高精度
53
G. Huang, Y. Sun, Z. Liu, D. Sedra, and K. Weinberger, "Deep networks with stochastic depth," in Proc. of
ECCV, 2016.
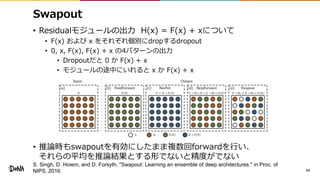
Swapout
• Residualモジュールの出力 H(x) = F(x) + xについて
• F(x) および x をそれぞれ個別にdropするdropout
• 0, x, F(x), F(x) + x の4パターンの出力
• Dropoutだと 0 か F(x) + x
• モジュールの途中にいれると x か F(x) + x
• 推論時もswapoutを有効にしたまま複数回forwardを行い、
それらの平均を推論結果とする形でないと精度がでない
54
S. Singh, D. Hoiem, and D. Forsyth, "Swapout: Learning an ensemble of deep architectures," in Proc. of
NIPS, 2016.
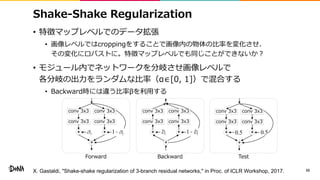
Shake-Shake Regularization
• 特徴マップレベルでのデータ拡張
• 画像レベルではcroppingをすることで画像内の物体の比率を変化させ、
その変化にロバストに。特徴マップレベルでも同じことができないか?
• モジュール内でネットワークを分岐させ画像レベルで
各分岐の出力をランダムな比率(α∈[0, 1])で混合する
• Backward時には違う比率βを利用する
55
conv 3x3
conv 3x3 conv 3x3
conv 3x3
+
** al 1-al
conv 3x3
conv 3x3 conv 3x3
conv 3x3
+
** bl 1-bl
conv 3x3
conv 3x3 conv 3x3
conv 3x3
+
** 0.5 0.5
Forward Backward Test
X. Gastaldi, "Shake-shake regularization of 3-branch residual networks," in Proc. of ICLR Workshop, 2017.
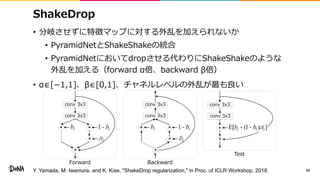
ShakeDrop
• 分岐させずに特徴マップに対する外乱を加えられないか
• PyramidNetとShakeShakeの統合
• PyramidNetにおいてdropさせる代わりにShakeShakeのような
外乱を加える(forward α倍、backward β倍)
• α∈[−1,1]、β∈[0,1]、チャネルレベルの外乱が最も良い
56
conv 3x3
conv 3x3
** bl 1-bl
Forward
al*
+
conv 3x3
conv 3x3
** bl 1-bl
Backward
bl*
+
conv 3x3
conv 3x3
*
+
Test
E[bl +(1-bl )al ]
Y. Yamada, M. Iwamura, and K. Kise, "ShakeDrop regularization," in Proc. of ICLR Workshop, 2018.
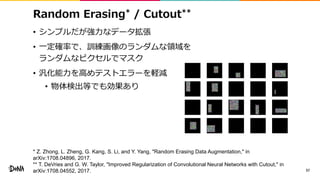
Random Erasing* / Cutout**
• シンプルだが強力なデータ拡張
• 一定確率で、訓練画像のランダムな領域を
ランダムなピクセルでマスク
• 汎化能力を高めテストエラーを軽減
• 物体検出等でも効果あり
57
* Z. Zhong, L. Zheng, G. Kang, S. Li, and Y. Yang, "Random Erasing Data Augmentation," in
arXiv:1708.04896, 2017.
** T. DeVries and G. W. Taylor, "Improved Regularization of Convolutional Neural Networks with Cutout," in
arXiv:1708.04552, 2017.
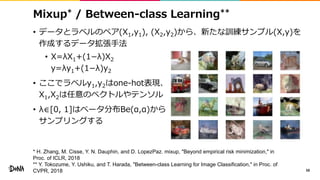
Mixup* / Between-class Learning**
• データとラベルのペア(X1,y1), (X2,y2)から、新たな訓練サンプル(X,y)を
作成するデータ拡張手法
• X=λX1+(1−λ)X2
y=λy1+(1−λ)y2
• ここでラベルy1,y2はone-hot表現、
X1,X2は任意のベクトルやテンソル
• λ∈[0, 1]はベータ分布Be(α,α)から
サンプリングする
58
* H. Zhang, M. Cisse, Y. N. Dauphin, and D. LopezPaz. mixup, "Beyond empirical risk minimization," in
Proc. of ICLR, 2018
** Y. Tokozume, Y. Ushiku, and T. Harada, "Between-class Learning for Image Classification," in Proc. of
CVPR, 2018
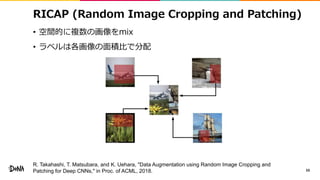
RICAP (Random Image Cropping and Patching)
• 空間的に複数の画像をmix
• ラベルは各画像の面積比で分配
59
R. Takahashi, T. Matsubara, and K. Uehara, "Data Augmentation using Random Image Cropping and
Patching for Deep CNNs," in Proc. of ACML, 2018.
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
60
Neural Architecture Search
• NNのアーキテクチャを自動設計する手法
• 探索空間、探索手法、精度評価手法で大まかに分類される
• 探索空間
• Global, cell-based
• 探索手法
• 強化学習、進化的アルゴリズム、gradientベース、random
• 精度測定手法
• 全学習、部分学習、weight-share、枝刈り探索
61
T. Elsken, J. Metzen, and F. Hutter, "Neural Architecture Search: A Survey," in JMLR, 2019.
M. Wistuba, A. Rawat, and T. Pedapati, "A Survey on Neural Architecture Search," in arXiv:1905.01392,
2019.
https://github.com/D-X-Y/awesome-NAS
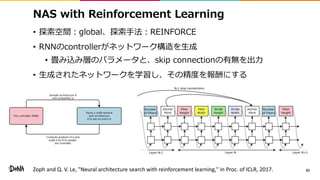
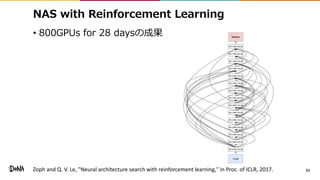
NAS with Reinforcement Learning
• 探索空間:global、探索手法:REINFORCE
• RNNのcontrollerがネットワーク構造を生成
• 畳み込み層のパラメータと、skip connectionの有無を出力
• 生成されたネットワークを学習し、その精度を報酬にする
62Zoph and Q. V. Le, "Neural architecture search with reinforcement learning," in Proc. of ICLR, 2017.
NAS with Reinforcement Learning
• 800GPUs for 28 daysの成果
63Zoph and Q. V. Le, "Neural architecture search with reinforcement learning," in Proc. of ICLR, 2017.
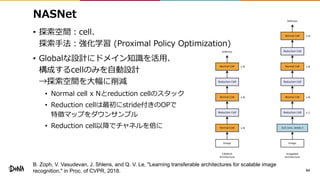
NASNet
• 探索空間:cell、
探索手法:強化学習 (Proximal Policy Optimization)
• Globalな設計にドメイン知識を活用、
構成するcellのみを自動設計
→探索空間を大幅に削減
• Normal cell x Nとreduction cellのスタック
• Reduction cellは最初にstride付きのOPで
特徴マップをダウンサンプル
• Reduction cell以降でチャネルを倍に
64
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
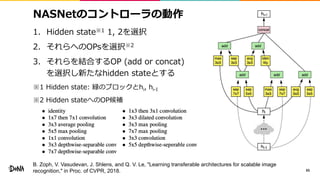
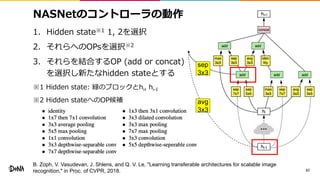
NASNetのコントローラの動作
1. Hidden state※1 1, 2を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
65
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
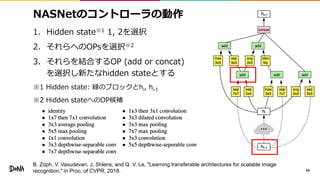
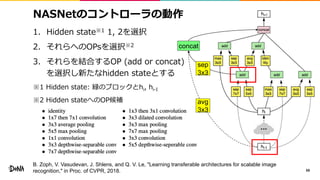
NASNetのコントローラの動作
1. Hidden state※1 1, 2を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
66
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
NASNetのコントローラの動作
1. Hidden state※1 1, 2を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
67
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
sep
3x3
avg
3x3
NASNetのコントローラの動作
1. Hidden state※1 1, 2を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
68
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
concat
sep
3x3
avg
3x3
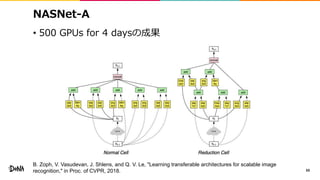
NASNet-A
• 500 GPUs for 4 daysの成果
69
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
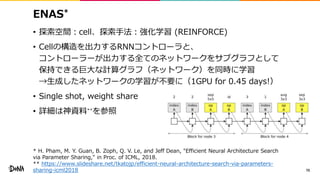
ENAS*
• 探索空間:cell、探索手法:強化学習 (REINFORCE)
• Cellの構造を出力するRNNコントローラと、
コントローラーが出力する全てのネットワークをサブグラフとして
保持できる巨大な計算グラフ(ネットワーク)を同時に学習
→生成したネットワークの学習が不要に(1GPU for 0.45 days!)
• Single shot, weight share
• 詳細は神資料**を参照
70
* H. Pham, M. Y. Guan, B. Zoph, Q. V. Le, and Jeff Dean, "Efficient Neural Architecture Search
via Parameter Sharing," in Proc. of ICML, 2018.
** https://www.slideshare.net/tkatojp/efficient-neural-architecture-search-via-parameters-
sharing-icml2018
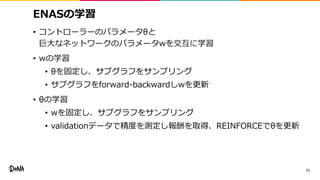
ENASの学習
• コントローラーのパラメータθと
巨大なネットワークのパラメータwを交互に学習
• wの学習
• θを固定し、サブグラフをサンプリング
• サブグラフをforward-backwardしwを更新
• θの学習
• wを固定し、サブグラフをサンプリング
• validationデータで精度を測定し報酬を取得、REINFORCEでθを更新
71
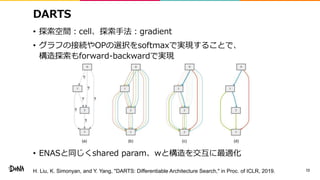
DARTS
• 探索空間:cell、探索手法:gradient
• グラフの接続やOPの選択をsoftmaxで実現することで、
構造探索もforward-backwardで実現
• ENASと同じくshared param、wと構造を交互に最適化
72H. Liu, K. Simonyan, and Y. Yang, "DARTS: Differentiable Architecture Search," in Proc. of ICLR, 2019.
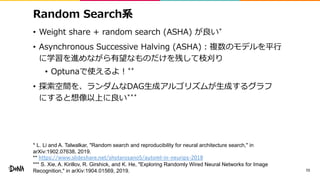
Random Search系
• Weight share + random search (ASHA) が良い*
• Asynchronous Successive Halving (ASHA):複数のモデルを平行
に学習を進めながら有望なものだけを残して枝刈り
• Optunaで使えるよ!**
• 探索空間を、ランダムなDAG生成アルゴリズムが生成するグラフ
にすると想像以上に良い***
73
* L. Li and A. Talwalkar, "Random search and reproducibility for neural architecture search," in
arXiv:1902.07638, 2019.
** https://www.slideshare.net/shotarosano5/automl-in-neurips-2018
*** S. Xie, A. Kirillov, R. Girshick, and K. He, "Exploring Randomly Wired Neural Networks for Image
Recognition," in arXiv:1904.01569, 2019.
最新のCNN改良手法
• Residualモジュールの改良
• 独自モジュールの利用
• 独自マクロアーキテクチャの利用
• 正則化/データ拡張
• アーキテクチャの自動設計
74
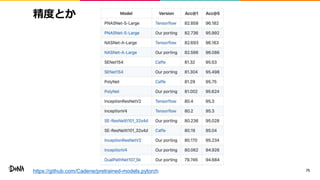
精度とか
75https://github.com/Cadene/pretrained-models.pytorch
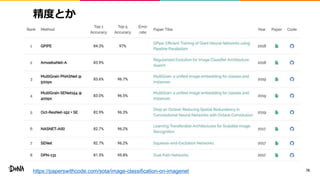
精度とか
76https://paperswithcode.com/sota/image-classification-on-imagenet
畳み込みニューラルネットワークの
高速化
77
前提
• 主に下記の条件を満たす手法を紹介
• 特定のハードウェアに依存せずに実現可能
• 畳み込みニューラルネットワーク (CNN) が対象
• 推論時の高速化が対象
78
高速化?
• モデルパラメータ数の削減
• FLOPs (MACs) 数の削減
• モデルファイルサイズの削減
• 推論時間の削減
• 訓練時間の削減
微妙に違う
79
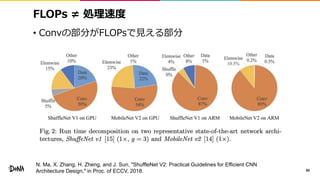
FLOPs ≠ 処理速度
• Convの部分がFLOPsで見える部分
80
N. Ma, X. Zhang, H. Zheng, and J. Sun, "ShuffleNet V2: Practical Guidelines for Efficient CNN
Architecture Design," in Proc. of ECCV, 2018.
畳み込みニューラルネットワーク
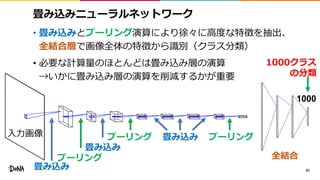
• 畳み込みとプーリング演算により徐々に高度な特徴を抽出、
全結合層で画像全体の特徴から識別(クラス分類)
• 必要な計算量のほとんどは畳み込み層の演算
→いかに畳み込み層の演算を削減するかが重要
81
畳み込み
プーリング
畳み込み
プーリング 畳み込み プーリング
全結合
1000
1000クラス
の分類
入力画像
モデル高速化
• 畳み込みの分解 (Factorization)
• 枝刈り (Pruning)
• 早期終了 (Early termination)
• 蒸留 (Distillation)
• 量子化 (Quantization)
82
モデル高速化
• 畳み込みの分解 (Factorization)
• 枝刈り (Pruning)
• 早期終了 (Early termination)
• 蒸留 (Distillation)
• 量子化 (Quantization)
83
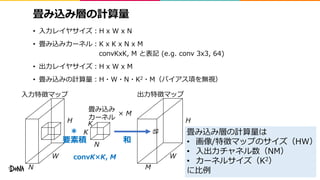
畳み込み層の計算量
• 入力レイヤサイズ:H x W x N
• 畳み込みカーネル:K x K x N x M
convKxK, M と表記 (e.g. conv 3x3, 64)
• 出力レイヤサイズ:H x W x M
• 畳み込みの計算量:H・W・N・K2・M(バイアス項を無視)
84
W
H
N M
K
K
W
H
入力特徴マップ
畳み込み
カーネル
N
出力特徴マップ
*
和要素積
× M
convK×K, M
畳み込み層の計算量は
• 画像/特徴マップのサイズ(HW)
• 入出力チャネル数(NM)
• カーネルサイズ(K2)
に比例
空間方向の分解
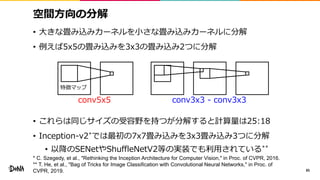
• 大きな畳み込みカーネルを小さな畳み込みカーネルに分解
• 例えば5x5の畳み込みを3x3の畳み込み2つに分解
• これらは同じサイズの受容野を持つが分解すると計算量は25:18
• Inception-v2*では最初の7x7畳み込みを3x3畳み込み3つに分解
• 以降のSENetやShuffleNetV2等の実装でも利用されている**
85
特徴マップ
conv5x5 conv3x3 - conv3x3
* C. Szegedy, et al., "Rethinking the Inception Architecture for Computer Vision," in Proc. of CVPR, 2016.
** T. He, et al., "Bag of Tricks for Image Classification with Convolutional Neural Networks," in Proc. of
CVPR, 2019.
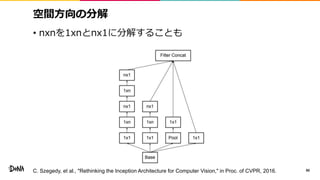
空間方向の分解
• nxnを1xnとnx1に分解することも
86C. Szegedy, et al., "Rethinking the Inception Architecture for Computer Vision," in Proc. of CVPR, 2016.
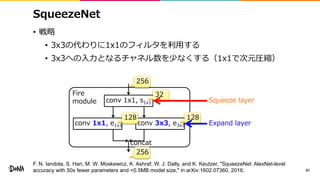
SqueezeNet
• 戦略
• 3x3の代わりに1x1のフィルタを利用する
• 3x3への入力となるチャネル数を少なくする(1x1で次元圧縮)
87
conv 1x1, s1x1
conv 1x1, e1x1 conv 3x3, e3x3
concat
Fire
module
32
128128
256
256
Squeeze layer
Expand layer
F. N. Iandola, S. Han, M. W. Moskewicz, K. Ashraf, W. J. Dally, and K. Keutzer, "SqueezeNet: AlexNet-level
accuracy with 50x fewer parameters and <0.5MB model size," in arXiv:1602.07360, 2016.
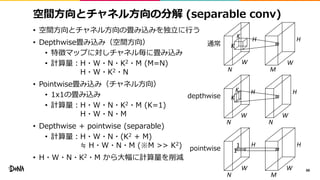
空間方向とチャネル方向の分解 (separable conv)
• 空間方向とチャネル方向の畳み込みを独立に行う
• Depthwise畳み込み(空間方向)
• 特徴マップに対しチャネル毎に畳み込み
• 計算量:H・W・N・K2・M (M=N)
H・W・K2・N
• Pointwise畳み込み(チャネル方向)
• 1x1の畳み込み
• 計算量:H・W・N・K2・M (K=1)
H・W・N・M
• Depthwise + pointwise (separable)
• 計算量:H・W・N・(K2 + M)
≒ H・W・N・M (※M >> K2)
• H・W・N・K2・M から大幅に計算量を削減
88W
H
W
H
N
1
1
M
W
H
W
H
N
K
K
N
W
H
W
H
N M
K
K通常
depthwise
pointwise
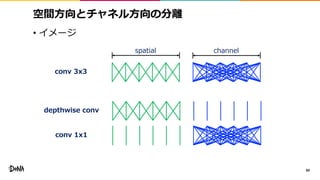
空間方向とチャネル方向の分離
• イメージ
89
conv 3x3
conv 1x1
depthwise conv
spatial channel
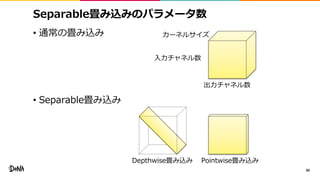
Separable畳み込みのパラメータ数
• 通常の畳み込み
• Separable畳み込み
90
入力チャネル数
出力チャネル数
カーネルサイズ
Depthwise畳み込み Pointwise畳み込み
Xception
• Separable convを多用したモデル
91F. Chollet, "Xception: Deep learning with depthwise separable convolutions," in Proc. of CVPR, 2017.
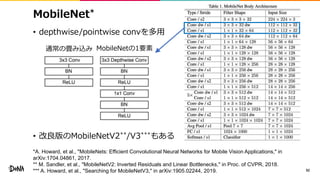
MobileNet*
• depthwise/pointwise convを多用
• 改良版のMobileNetV2**/V3***もある
92
通常の畳み込み MobileNetの1要素
*A. Howard, et al., "MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications," in
arXiv:1704.04861, 2017.
** M. Sandler, et al., "MobileNetV2: Inverted Residuals and Linear Bottlenecks," in Proc. of CVPR, 2018.
*** A. Howard, et al., "Searching for MobileNetV3," in arXiv:1905.02244, 2019.
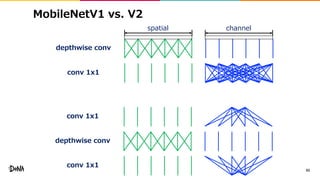
MobileNetV1 vs. V2
93
depthwise conv
conv 1x1
depthwise conv
conv 1x1
conv 1x1
spatial channel
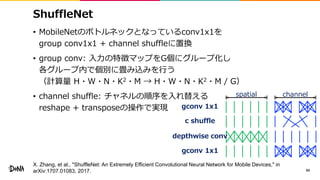
ShuffleNet
• MobileNetのボトルネックとなっているconv1x1を
group conv1x1 + channel shuffleに置換
• group conv: 入力の特徴マップをG個にグループ化し
各グループ内で個別に畳み込みを行う
(計算量 H・W・N・K2・M → H・W・N・K2・M / G)
• channel shuffle: チャネルの順序を入れ替える
reshape + transposeの操作で実現
94
c shuffle
depthwise conv
gconv 1x1
spatial channel
gconv 1x1
X. Zhang, et al., "ShuffleNet: An Extremely Efficient Convolutional Neural Network for Mobile Devices," in
arXiv:1707.01083, 2017.
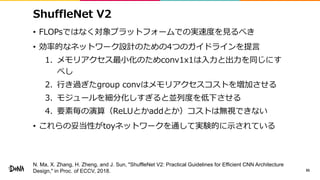
ShuffleNet V2
• FLOPsではなく対象プラットフォームでの実速度を見るべき
• 効率的なネットワーク設計のための4つのガイドラインを提言
1. メモリアクセス最小化のためconv1x1は入力と出力を同じにす
べし
2. 行き過ぎたgroup convはメモリアクセスコストを増加させる
3. モジュールを細分化しすぎると並列度を低下させる
4. 要素毎の演算(ReLUとかaddとか)コストは無視できない
• これらの妥当性がtoyネットワークを通して実験的に示されている
95
N. Ma, X. Zhang, H. Zheng, and J. Sun, "ShuffleNet V2: Practical Guidelines for Efficient CNN Architecture
Design," in Proc. of ECCV, 2018.
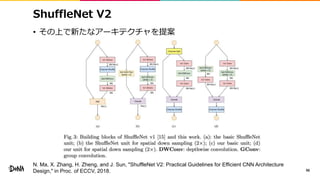
ShuffleNet V2
• その上で新たなアーキテクチャを提案
96
N. Ma, X. Zhang, H. Zheng, and J. Sun, "ShuffleNet V2: Practical Guidelines for Efficient CNN Architecture
Design," in Proc. of ECCV, 2018.
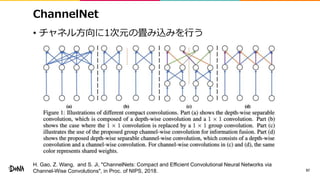
ChannelNet
• チャネル方向に1次元の畳み込みを行う
97
H. Gao, Z. Wang, and S. Ji, "ChannelNets: Compact and Efficient Convolutional Neural Networks via
Channel-Wise Convolutions", in Proc. of NIPS, 2018.
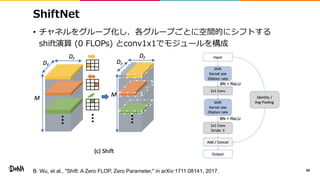
ShiftNet
• チャネルをグループ化し、各グループごとに空間的にシフトする
shift演算 (0 FLOPs) とconv1x1でモジュールを構成
98B. Wu, et al., "Shift: A Zero FLOP, Zero Parameter," in arXiv:1711.08141, 2017.
他にも…
99
G. Huang, S. Liu, L. Maaten, and K. Weinberger, "CondenseNet: An Efficient DenseNet using Learned
Group Convolutions," in Proc. of CVPR, 2018.
T. Zhang, G. Qi, B. Xiao, and J. Wang. Interleaved group convolutions for deep neural networks," in Proc.
of ICCV, 2017.
G. Xie, J. Wang, T. Zhang, J. Lai, R. Hong, and G. Qi, "IGCV2: Interleaved Structured Sparse
Convolutional Neural Networks, in Proc. of CVPR, 2018.
K. Sun, M. Li, D. Liu, and J. Wang, "IGCV3: Interleaved Low-Rank Group Convolutions for Efficient Deep
Neural Networks," in BMVC, 2018.
J. Zhang, "Seesaw-Net: Convolution Neural Network With Uneven Group Convolution," in
arXiv:1905.03672, 2019.
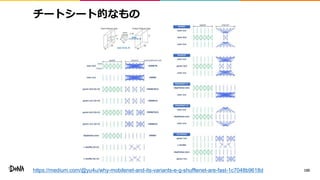
チートシート的なもの
100https://medium.com/@yu4u/why-mobilenet-and-its-variants-e-g-shufflenet-are-fast-1c7048b9618d