Mobility Technologies Co., Ltd.
画像認識と深層学習
株式会社Mobility Technologies
内田 祐介
日本ロボット学会
第126回ロボット工学セミナー
Mobility Technologies Co., Ltd.
深層学習が様々な画像認識タスクで活用されるようになった
• クラス分類、物体検出、ランドマーク検出、
セマンティックセグメンテーション、姿勢推定、行動認識、属性認識、
顔認証、物体追跡、深度推定、SfM、…
• 従来考えられなかったようなタスクまでも応用が広がっている
画像認識と深層学習
2
Mobility Technologies Co., Ltd.
深層学習によるタスクの広がり
3[Liu+, ECCV'16] [He+, ICCV’17]
[Viola+, CVPR'01]
顔検出
[Lazebnik+, CVPR'06]
マルチクラス物体検出
クラス分類
セグメンテーション
ポーズ推定
Mobility Technologies Co., Ltd.
問題・やりたいことを適切なタスクとして定義する
訓練・検証のためのデータセットを構築する
モデルを設計(選定)する
• タスクに応じた損失関数(ロス)を選定する
学習・検証
• Optimizer選定、学習率スケジューリング、Augmentation
画像認識
4
Mobility Technologies Co., Ltd.
5
1. クラス分類向けモデルについて
• ILSVRCで振り返る進化の歴史
• その他重要なモデル
• モデルの自動設計
(Neural Architecture Search)
2. モデルの高速化について
• 軽量モデル
• その他モデルの高速化手法
3. クラス分類以外のタスクにおけるモデル
4. おまけ
Agenda
Mobility Technologies Co., Ltd.
最も基本的かつ重要なタスク
入力画像がどのようなクラス(例:猫)に
対応するのかを判定する
畳み込みニューラルネットワーク (CNN) により実現
• 画像を入力とする認識はほぼCNNが利用される
• クラス分類タスクで進化したCNNのモデルが
他の様々なタスクで利用される
• 画像以外モダリティも画像(3次元テンソル)に変換されてCNNが利用され
ることも多い
• 音響信号→スペクトログラム、点群→固定サイズの3次元テンソル
クラス分類モデルは他のタスクの基礎となっている
クラス分類
6
Mobility Technologies Co., Ltd.
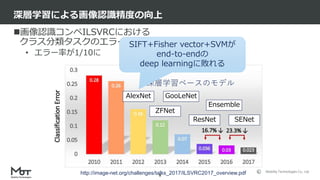
画像認識コンペILSVRCにおける
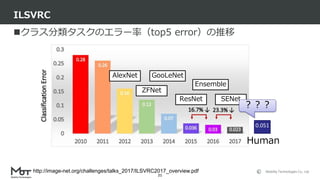
クラス分類タスクのエラー率(top5 error)推移
• エラー率が1/10に
深層学習による画像認識精度の向上
7
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
深層学習ベースのモデル
Mobility Technologies Co., Ltd.
画像認識コンペILSVRCにおける
クラス分類タスクのエラー率(top5 error)推移
• エラー率が1/10に
深層学習による画像認識精度の向上
8
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
深層学習ベースのモデル
SIFT+Fisher vector+SVMが
end-to-endの
deep learningに敗れる
Mobility Technologies Co., Ltd.
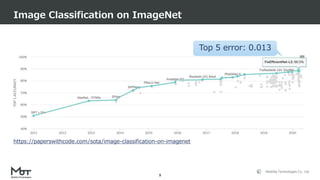
Image Classification on ImageNet
9
https://paperswithcode.com/sota/image-classification-on-imagenet
Top 5 error: 0.013
Mobility Technologies Co., Ltd.
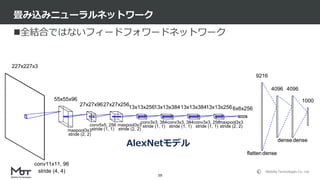
全結合ではないフィードフォワードネットワーク
畳み込みニューラルネットワーク
10
227x227x3
55x55x96
27x27x9627x27x256
13x13x25613x13x38413x13x38413x13x2566x6x256
9216
4096 4096
1000
conv11x11, 96
stride (4, 4)
maxpool3x3
stride (2, 2)
conv5x5, 256
stride (1, 1)
maxpool3x3
stride (2, 2)
conv3x3, 384
stride (1, 1)
conv3x3, 384
stride (1, 1)
conv3x3, 256
stride (1, 1)
maxpool3x3
stride (2, 2)
flattenflatten densedense
densedensedensedense
AlexNetモデル
Mobility Technologies Co., Ltd.
この図はKeras風にCNNを定義すると自動的に作れます
ちなみに
11
https://github.com/yu4u/convnet-drawer
Mobility Technologies Co., Ltd.
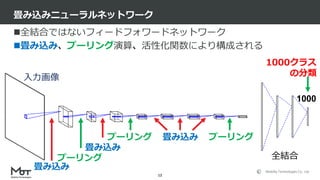
全結合ではないフィードフォワードネットワーク
畳み込み、プーリング演算、活性化関数により構成される
畳み込みニューラルネットワーク
12
畳み込み
プーリング
畳み込み
プーリング 畳み込み プーリング
全結合
1000
1000クラス
の分類入力画像
Mobility Technologies Co., Ltd.
3次元テンソルに対して、畳み込みカーネルを
適用し、認識に重要な特徴を抽出する
個々の出力は入力の一部のみ影響を受け、カーネルは空間座標によ
らず共通
畳み込み演算
13
W
H
N M
K
K
W
H
入力テンソル
畳み込み
カーネル
N
出力テンソル
*
和
要素積
× M
Conv K×K, M
Mobility Technologies Co., Ltd.
畳み込み演算にも色々ある
• Grouped convolution, depthwise convolution(後述)、transposed
convolution (deconvolution, upconvolution)…
Padding, strideの概念や、transposed convolution, dilated
convolutionは↓
https://github.com/vdumoulin/conv_arithmetic
畳み込み演算
14
Mobility Technologies Co., Ltd.
テンソルの各要素に(非線形な)活性化関数 φ(x) を適用する
活性化関数
15
W
N
入力テンソル 出力テンソル
W
N
φ(x)
シグモイド関数
ReLU
Mobility Technologies Co., Ltd.
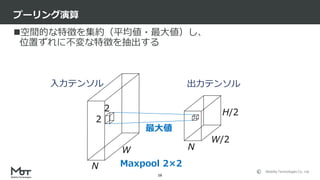
空間的な特徴を集約(平均値・最大値)し、
位置ずれに不変な特徴を抽出する
プーリング演算
16
W
W/2
N
N
H/2
2
2
最大値
Maxpool 2×2
入力テンソル 出力テンソル
Mobility Technologies Co., Ltd.
全結合ではないフィードフォワードネットワーク
畳み込み、プーリング演算、活性化関数により構成される
組み合わせにより様々なモデルが提案されてきた(配線芸)
畳み込みニューラルネットワーク
17
畳み込み
プーリング
畳み込み
プーリング 畳み込み プーリング
全結合
1000
1000クラス
の分類入力画像
Mobility Technologies Co., Ltd.
18
1. クラス分類向けモデルについて
• ILSVRCで振り返る進化の歴史
• その他重要なモデル
• モデルの自動設計
(Neural Architecture Search)
2. モデルの高速化について
• 軽量モデル
• その他モデルの高速化手法
3. クラス分類以外のタスクにおけるモデル
4. おまけ
Agenda
Mobility Technologies Co., Ltd.
ImageNet Large Scale Visual Recognition Challenge (ILSVRC)
ImageNetデータセットを利用したコンペ
• WordNetをもとにクラスを定義
• 各クラスのデータを大量に収集&アノテーション
• 学習データ120万枚、テストデータ10万枚
クラス分類、物体検出、位置特定等のタスクが存在
• 特にクラス分類の精度の推移が画像認識の進化の
指標として参考にされることが多い
2012年に深層学習ベースの手法が優勝して以降、
(畳み込み)ニューラルネットワークの天下一武道会化
• ここでの優勝モデルがデファクトスタンダードとして利用される
• セグメンテーション等、他のタスクでも利用される
ILSVRCで振り返るCNNの進化
19
Mobility Technologies Co., Ltd.
クラス分類タスクのエラー率(top5 error)の推移
ILSVRC
20
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
Mobility Technologies Co., Ltd.
クラス分類タスクのエラー率(top5 error)の推移
ILSVRC
21
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
0.051
Human
???
Mobility Technologies Co., Ltd.
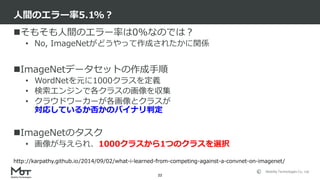
そもそも人間のエラー率は0%なのでは?
• No, ImageNetがどうやって作成されたかに関係
ImageNetデータセットの作成手順
• WordNetを元に1000クラスを定義
• 検索エンジンで各クラスの画像を収集
• クラウドワーカーが各画像とクラスが
対応しているか否かのバイナリ判定
ImageNetのタスク
• 画像が与えられ、1000クラスから1つのクラスを選択
人間のエラー率5.1%?
22
http://karpathy.github.io/2014/09/02/what-i-learned-from-competing-against-a-convnet-on-imagenet/
Mobility Technologies Co., Ltd.
“1 smart, trained and highly education human being
performed at that error rate”
https://amundtveit.com/tag/imagenet/
Andrej Karpathyさん (Stanford→OpenAI→Tesla)
人間のエラー率5.1%?
23
https://github.com/karpathy
Mobility Technologies Co., Ltd.
2014年のGoogLeNetの達成精度 (top5 error 6.7%) から
人間との比較をすべきと考えた
専用のアノテーションツールを作成
• ILSVRCに従事しているラボメンでも
1000クラスから5クラス選択することは非常に難しい
GoogLeNetの結果を利用して、候補を100クラスに限定
• それでも難しくラボの熟練ラベラーでも13〜15%のエラー率
自分が訓練データを用い、”苦痛を伴う長時間の学習”を経て、じっくりア
ノテーションするのが効率的と気づいた
• train on 500 validation images -> 1500 test images
• テストエラー5.1%を達成!犬の品種に詳しくなった!
上記のように、エラー率5.1%は天才がかなり頑張った結果
• とはいえCNNの学習時間に比べるとまだ足りないという考え方も
Karpathyさんのエラー率5.1までの道のり
24
Mobility Technologies Co., Ltd.
クラス分類タスクのエラー率(top5 error)の推移
ILSVRC
25
AlexNet
ZFNet
SENetResNet
GooLeNet
Ensemble
0.051
Human
http://image-net.org/challenges/talks_2017/ILSVRC2017_overview.pdf
Mobility Technologies Co., Ltd.
Neocognitron
• 脳の視覚野に関する知見を元に考案
• 単純型細胞:特徴抽出を行う畳み込み層
• 複雑型細胞:位置ずれを吸収するプーリング層
• 自己組織化による特徴抽出
Before AlexNet
26
K. Fukushima and S. Miyake, "Neocognitron: A new algorithm for pattern recognition tolerant of
deformations and shifts in position," in Pattern Recognition, 1982.
Mobility Technologies Co., Ltd.
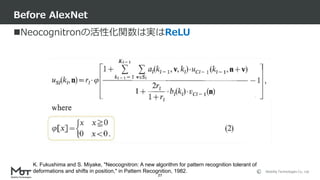
Neocognitronの活性化関数は実はReLU
Before AlexNet
27
K. Fukushima and S. Miyake, "Neocognitron: A new algorithm for pattern recognition tolerant of
deformations and shifts in position," in Pattern Recognition, 1982.
Mobility Technologies Co., Ltd.
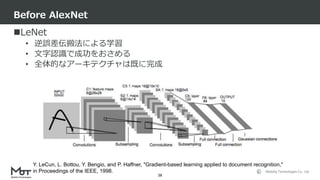
LeNet
• 逆誤差伝搬法による学習
• 文字認識で成功をおさめる
• 全体的なアーキテクチャは既に完成
Before AlexNet
28
Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, "Gradient-based learning applied to document recognition,"
in Proceedings of the IEEE, 1998.
Mobility Technologies Co., Ltd.
巷のLeNetはLeNetではない
Before AlexNet
29
出力チャネル
入力チャネル
Sparseな
畳み込み!
Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, "Gradient-based learning applied to document recognition,"
in Proceedings of the IEEE, 1998.
Mobility Technologies Co., Ltd.
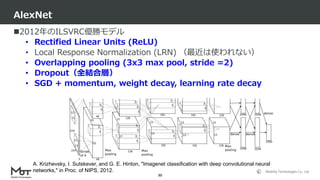
2012年のILSVRC優勝モデル
• Rectified Linear Units (ReLU)
• Local Response Normalization (LRN) (最近は使われない)
• Overlapping pooling (3x3 max pool, stride =2)
• Dropout(全結合層)
• SGD + momentum, weight decay, learning rate decay
AlexNet
30
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "Imagenet classification with deep convolutional neural
networks," in Proc. of NIPS, 2012.
Mobility Technologies Co., Ltd.
2012年のILSVRC優勝モデル
• Rectified Linear Units (ReLU)
• Local Response Normalization (LRN) (最近は使われない)
• Overlapping pooling (3x3 max pool, stride =2)
• Dropout(全結合層)
• SGD + momentum, weight decay, learning rate decay
AlexNet
31
既にほぼ現在のアーキテクチャの姿
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "Imagenet classification with deep convolutional neural
networks," in Proc. of NIPS, 2012.
Mobility Technologies Co., Ltd.
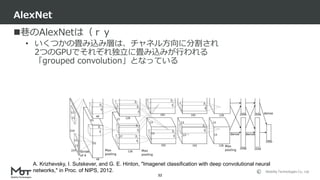
巷のAlexNetは(ry
• いくつかの畳み込み層は、チャネル方向に分割され
2つのGPUでそれぞれ独立に畳み込みが行われる
「grouped convolution」となっている
AlexNet
32
A. Krizhevsky, I. Sutskever, and G. E. Hinton, "Imagenet classification with deep convolutional neural
networks," in Proc. of NIPS, 2012.
Mobility Technologies Co., Ltd.
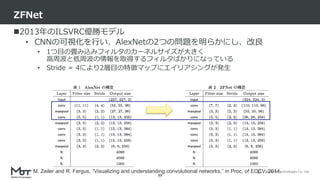
2013年のILSVRC優勝モデル
• CNNの可視化を行い、AlexNetの2つの問題を明らかにし、改良
• 1つ目の畳み込みフィルタのカーネルサイズが大きく
高周波と低周波の情報を取得するフィルタばかりになっている
• Stride = 4により2層目の特徴マップにエイリアシングが発生
ZFNet
33
M. Zeiler and R. Fergus, “Visualizing and understanding convolutional networks,” in Proc. of ECCV, 2014.
Mobility Technologies Co., Ltd.
2014年のILSVRC優勝モデル
• Inceptionモジュール
• Global Average Pooling (GAP)
• Auxiliary loss
• ネットワークを途中で分岐させ、そこで分類を行うロスを追加
→学習の効率化+正則化
GoogLeNet
34
C. Szegedy, et al., "Going deeper with convolutions", in Proc. of CVPR, 2015.
Mobility Technologies Co., Ltd.
小さなネットワークを1つのモジュールとして定義し
モジュールの積み重ねでネットワークを構成
• 3x3と複数の1x1畳み込みを1つのモジュールとする
Network In Network (NIN) に起源
Sparseな畳み込みにより、
表現能力とパラメータ数のトレードオフを改善
1x1畳み込みによる次元削減
Inceptionモジュール
35
concat
conv 1x1 conv 1x1 maxpool
conv 1x1
conv 3x3 conv 5x5 conv 1x1
concat
maxpoolconv 1x1 conv 3x3 conv 5x5
Inceptionモジュール(次元削減あり) Inceptionモジュール(naive)
Mobility Technologies Co., Ltd.
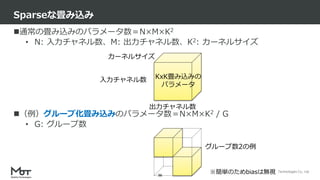
通常の畳み込みのパラメータ数=N×M×K2
• N: 入力チャネル数、M: 出力チャネル数、K2: カーネルサイズ
(例)グループ化畳み込みのパラメータ数=N×M×K2 / G
• G: グループ数
Sparseな畳み込み
36
入力チャネル数
出力チャネル数
カーネルサイズ
グループ数2の例
※簡単のためbiasは無視
KxK畳み込みの
パラメータ
Mobility Technologies Co., Ltd.
Sparseな畳み込みとしてのInceptionモジュール
37
concat
maxpoolconv 1x1 conv 3x3 conv 5x5
Inceptionモジュール(naive)
入力チャネル数
出力チャネル数
カーネルサイズ
5x5 3x3 1x1
5x5の畳み込みを
少数パラメータで近似
※簡単のためmax poolを無視
Mobility Technologies Co., Ltd.
Sparseな畳み込みとしてのInceptionモジュール
38
concat
conv 1x1 conv 1x1 maxpool
conv 1x1
conv 3x3 conv 5x5 conv 1x1
Inceptionモジュール(次元削減あり)
1x1畳み込み
Inceptionモジュール
※簡単のためmax poolを無視
1x1畳み込みの次元削減で
更にパラメータを削減
naïveバージョン
Mobility Technologies Co., Ltd.
特徴マップのサイズと同じaverage pooling
• NIN*で提案された。チャネル数をクラス数に調整してからGAP
• GoogLeNet以降では、GAPの後に全結合層を付ける
• 全結合層を減らすことでパラメータ数を削減
Global Average Pooling (GAP)
39
W
H
C=クラス数
1
1HxWxCの
特徴マップ
クラス数
GAP
softmax
* M. Lin, Q. Chen, and S. Yan, "Network in network," in Proc. of ICLR, 2014.
Mobility Technologies Co., Ltd.
Inception-v2,3
• Batch normalization
• 5x5 -> 3x3 (x2)
• nxn -> nx1 + 1xn
Inception-v4
• 3種類のInceptionを使い分け
Inception-ResNet-v1,2
• 後述のショートカット機構の導入
Inception-v?
40
= Inception-v3
C. Szegedy, V. Vanhoucke, S. Ioffe, and J. Shlens, "Rethinking the inception architecture for computer
vision," in Proc. of CVPR, 2016.
C. Szegedy, S. Ioffe, V. Vanhoucke, and A. A. Alemi, "Inception-v4, inception-resnet and the impact of
residual connections on learning," in Proc. of AAAI, 2017.
Mobility Technologies Co., Ltd.
2014年のILSVRCで2位となったモデル、シンプルなモデルの設計方針
• 3x3畳み込み層(+全結合層)のみを利用
• 5x5畳み込みと3x3畳み込み×2は同じreceptive fieldを持つ
• 計算量は 25:18
• 同一出力チャネルの畳み込み層を重ねた後に
プーリングにより特徴マップを半分にしつつチャネル数を倍増
まずは浅いネットワークを学習し、畳み込み層を追加してfine-tuningすること
で深いネットワークを学習(Xavierの初期化で不要に)
VGGNet
41
conv 5x5 conv 3x3 - conv 3x3
K. Simonyan and A. Zisserman, "Very deep convolutional networks for large-scale image recognition," in
Proc. of ICLR, 2015.
Mobility Technologies Co., Ltd.
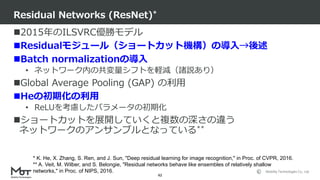
2015年のILSVRC優勝モデル
Residualモジュール(ショートカット機構)の導入→後述
Batch normalizationの導入
• ネットワーク内の共変量シフトを軽減(諸説あり)
Global Average Pooling (GAP) の利用
Heの初期化の利用
• ReLUを考慮したパラメータの初期化
ショートカットを展開していくと複数の深さの違う
ネットワークのアンサンブルとなっている**
Residual Networks (ResNet)*
42
* K. He, X. Zhang, S. Ren, and J. Sun, "Deep residual learning for image recognition," in Proc. of CVPR, 2016.
** A. Veit, M. Wilber, and S. Belongie, "Residual networks behave like ensembles of relatively shallow
networks," in Proc. of NIPS, 2016.
Mobility Technologies Co., Ltd.
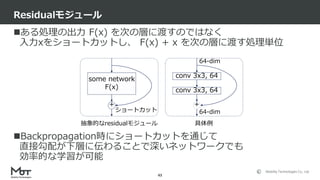
ある処理の出力 F(x) を次の層に渡すのではなく
入力xをショートカットし、 F(x) + x を次の層に渡す処理単位
Backpropagation時にショートカットを通じて
直接勾配が下層に伝わることで深いネットワークでも
効率的な学習が可能
Residualモジュール
43
some network
F(x) conv 3x3, 64
conv 3x3, 64
ショートカット
+ +
64-dim
64-dim
抽象的なresidualモジュール 具体例
Mobility Technologies Co., Ltd.
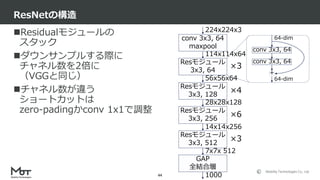
Residualモジュールの
スタック
ダウンサンプルする際に
チャネル数を2倍に
(VGGと同じ)
チャネル数が違う
ショートカットは
zero-padingかconv 1x1で調整
ResNetの構造
44
Resモジュール
3x3, 64
Resモジュール
3x3, 128
Resモジュール
3x3, 256
Resモジュール
3x3, 512
GAP
全結合層
conv 3x3, 64
maxpool
×3
×4
×6
×3
conv 3x3, 64
conv 3x3, 64
+
64-dim
64-dim
114x114x64
224x224x3
56x56x64
28x28x128
14x14x256
7x7x 512
1000
Mobility Technologies Co., Ltd.
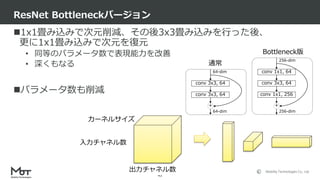
1x1畳み込みで次元削減、その後3x3畳み込みを行った後、
更に1x1畳み込みで次元を復元
• 同等のパラメータ数で表現能力を改善
• 深くもなる
パラメータ数も削減
ResNet Bottleneckバージョン
45
conv 3x3, 64
conv 3x3, 64
+
64-dim
64-dim
conv 1x1, 256
conv 3x3, 64
+
conv 1x1, 64
256-dim
256-dim
入力チャネル数
出力チャネル数
カーネルサイズ
通常
Bottleneck版
Mobility Technologies Co., Ltd.
2017年のILSVRC優勝モデル
チャネル毎の特徴マップを適応的に重み付けする
SE Blockを導入
• Globalなコンテキストを取得するsqueeze step
• チャネル間の依存関係を抽出するexcitation step
どんなネットワークにも導入可能
• ResNet, ResNeXt, Inception,
Inception-ResNet-v2等に導入し
有効性を確認
• 特にResNeXtと合体したSE-ResNeXtは大人気
Squeeze-and-Excitation Networks (SENet)
46
conv 1x1
global pooling
ReLU
conv 1x1
sigmoid
scaling
HxWxC
1x1xC
1x1xC/r
1x1xC
HxWxC
Mobility Technologies Co., Ltd.
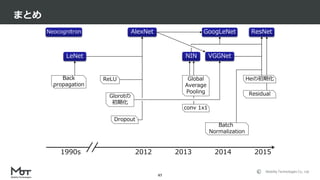
まとめ
47
Residual
AlexNet
VGGNet
GoogLeNet ResNet
Batch
Normalization
LeNet
Neocognitron
Back
propagation
Heの初期化
Glorotの
初期化
conv 1x1
Dropout
ReLU
1990s 2012 2013 2014 2015
NIN
Global
Average
Pooling
Mobility Technologies Co., Ltd.
まとめ
48
AlexNet
VGGNet
GoogLeNet ResNet
Batch
Normalization
LeNet
Neocognitron
Back
propagation
Heの初期化
Glorotの
初期化
conv 1x1
Dropout
ReLU
1990s 2012 2013 2014 2015
NIN
Global
Average
Pooling Residual
Mobility Technologies Co., Ltd.
49
1. クラス分類向けモデルについて
• ILSVRCで振り返る進化の歴史
• その他重要なモデル
• モデルの自動設計
(Neural Architecture Search)
2. モデルの高速化について
• 軽量モデル
• その他モデルの高速化手法
3. クラス分類以外のタスクにおけるモデル
4. おまけ
Agenda
Mobility Technologies Co., Ltd.
Residualモジュールをゴニョゴニョする
WideResNet*
• 深くするより、幅(チャネル数)を大きくして(相対的に)
浅いネットワークのほうが精度・学習速度が優秀
PyramidNet**
• サウンサンプルするタイミングでチャネル数を
2倍にするのではなく、全てのresidualモジュールで
徐々にチャネル数を増加させる
• チャネル数を2倍にするresidualモジュールに
ネットワークが過度に依存してしまうのを防ぐ
Residualモジュールの改良
50
* S. Zagoruyko and N. Komodakis, "Wide residual networks," in Proc. of BMVC, 2016.
** D. Han, J. Kim, and J. Kim, "Deep pyramidal residual networks," in Proc. of CVPR, 2017.
Mobility Technologies Co., Ltd.
初代ResNet*
• conv - bn - relu - conv - bn - add - relu
pre-act ResNet**(addの後にReLUをしない)
• bn - relu - conv - bn - relu - conv - add
PyramidNet***(ReLUを減らす、BN追加)
• bn - conv - bn - relu - conv - bn - add
WideResNet****(dropoutがタスクによって効果がある)
• bn - relu - conv - bn - relu - dropout - conv – add
Residualモジュールのベストプラクティス
51
* K. He, X. Zhang, S. Ren, and J. Sun, "Deep residual learning for image recognition," in Proc. of CVPR, 2016.
** K. He, X. Zhang, S. Ren, and J. Sun, "Identity mappings in deep residual networks," in Proc. of ECCV, 2016.
*** D. Han, J. Kim, and J. Kim, "Deep pyramidal residual networks," in Proc. of CVPR, 2017.
**** S. Zagoruyko and N. Komodakis, "Wide residual networks," in Proc. of BMVC, 2016.
Mobility Technologies Co., Ltd.
conv 1x1, 4
conv 3x3, 4
conv 1x1, 256
conv 1x1, 4
conv 3x3, 4
conv 1x1, 256
conv 1x1, 4
conv 3x3, 4
conv 1x1, 256
...
+
256-dim
256-dim
conv 1x1, 128
conv 3x3, 128, g=32
conv 1x1, 256
256-dim
256-dim
+
(a) (b)
Ti(x)
grouped
convolution
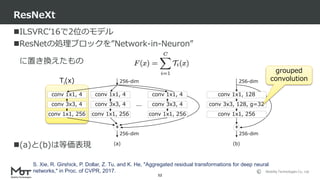
ILSVRC’16で2位のモデル
ResNetの処理ブロックを”Network-in-Neuron”
に置き換えたもの
(a)と(b)は等価表現
ResNeXt
52
S. Xie, R. Girshick, P. Dollar, Z. Tu, and K. He, "Aggregated residual transformations for deep neural
networks," in Proc. of CVPR, 2017.
Mobility Technologies Co., Ltd.
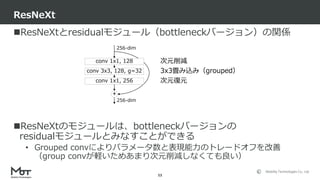
ResNeXtとresidualモジュール(bottleneckバージョン)の関係
ResNeXtのモジュールは、bottleneckバージョンの
residualモジュールとみなすことができる
• Grouped convによりパラメータ数と表現能力のトレードオフを改善
(group convが軽いためあまり次元削減しなくても良い)
ResNeXt
53
conv 1x1, 128
conv 3x3, 128, g=32
conv 1x1, 256
256-dim
256-dim
+
次元削減
次元復元
3x3畳み込み(grouped)
Mobility Technologies Co., Ltd.
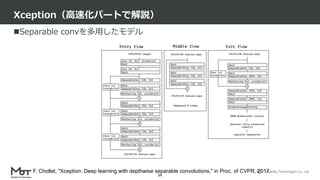
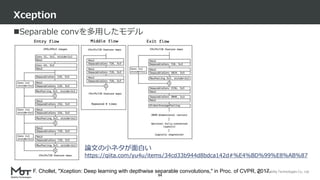
Separable convを多用したモデル
Xception(高速化パートで解説)
54
F. Chollet, "Xception: Deep learning with depthwise separable convolutions," in Proc. of CVPR, 2017.
Mobility Technologies Co., Ltd.
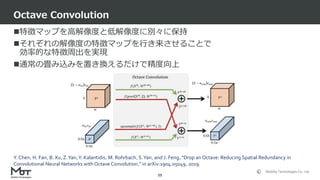
特徴マップを高解像度と低解像度に別々に保持
それぞれの解像度の特徴マップを行き来させることで
効率的な特徴周出を実現
通常の畳み込みを置き換えるだけで精度向上
Octave Convolution
55
Y. Chen, H. Fan, B. Xu, Z.Yan,Y. Kalantidis, M. Rohrbach, S.Yan, and J. Feng, "Drop an Octave: Reducing Spatial Redundancy in
Convolutional Neural Networks with Octave Convolution," in arXiv:1904.05049, 2019.
Mobility Technologies Co., Ltd.
複数のResidualモジュールを1つのモジュールとみなし
その間にショートカットを作成する
Residual Networks of Residual Networks (RoR)
56
K. Zhang, M. Sun, T. X. Han, X. Yuan, L. Guo, and T. Liu, "Residual networks of residual networks:
Multilevel residual networks," in TCSVT, 2017.
Mobility Technologies Co., Ltd.
再帰的に定義されるネットワーク
• パスをdropするdropout的な学習
浅い列のパスがResNetのショートカットのような効果
FractalNet
57
G. Larsson, M. Maire, and G. Shakhnarovich, "Fractalnet: Ultra-deep neural networks without residuals," in
Proc. of ICLR, 2017.
Mobility Technologies Co., Ltd.
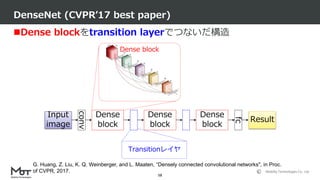
Dense blockをtransition layerでつないだ構造
DenseNet (CVPR’17 best paper)
58
conv
Dense
block
Dense
block
Dense
block
fc
Input
image
Result
G. Huang, Z. Liu, K. Q. Weinberger, and L. Maaten, “Densely connected convolutional networks", in Proc.
of CVPR, 2017.
Dense block
Transitionレイヤ
Mobility Technologies Co., Ltd.
同一ブロック内の自分より前の層全ての出力を
各層への入力とする処理ブロック
• 入力k0、総数l、各層の出力k とすると出力はk0+l×k
Dense Block
59
入力: k0, 出力: k
入力: k0+k, 出力: k
入力: k0+2k, 出力: k
入力: k0+3k, 出力: k
bn - relu – conv 3x3入力: k0
出力: k0+4k
G. Huang, Z. Liu, K. Q. Weinberger, and L. Maaten, “Densely connected convolutional networks", in Proc.
of CVPR, 2017.
Mobility Technologies Co., Ltd.
k0 >> k なので通常の畳み込みよりも計算量が少ないが
conv 1x1で次元削減を行うことで更に計算量を削減
Dense Block(Bottleneckバージョン)
60
入力: k0, 中間出力: 4k, 出力: k
入力: k0+k, 中間出力: 4k, 出力: k
入力: k0+2k, 中間出力: 4k, 出力: k
入力: k0+3k, 中間出力: 4k,
出力: k
bn - relu - conv 1x1
bn - relu - conv 3x3
入力: k0
出力: k0+4k
G. Huang, Z. Liu, K. Q. Weinberger, and L. Maaten, “Densely connected convolutional networks", in Proc.
of CVPR, 2017.
Mobility Technologies Co., Ltd.
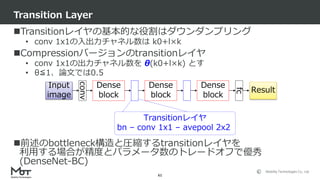
Transitionレイヤの基本的な役割はダウンダンプリング
• conv 1x1の入出力チャネル数は k0+l×k
Compressionバージョンのtransitionレイヤ
• conv 1x1の出力チャネル数を θ(k0+l×k) とす
• θ≦1、論文では0.5
前述のbottleneck構造と圧縮するtransitionレイヤを
利用する場合が精度とパラメータ数のトレードオフで優秀
(DenseNet-BC)
Transition Layer
61
conv
Dense
block
Dense
block
Dense
block
fc
Input
image
Result
Transitionレイヤ
bn – conv 1x1 – avepool 2x2
Mobility Technologies Co., Ltd.
62
1. クラス分類向けモデルについて
• ILSVRCで振り返る進化の歴史
• その他重要なモデル
• モデルの自動設計
(Neural Architecture Search)
2. モデルの高速化について
• 軽量モデル
• その他モデルの高速化手法
3. クラス分類以外のタスクにおけるモデル
4. おまけ
Agenda
Mobility Technologies Co., Ltd.
これまでのモデルはhand crafted(←特徴を自動抽出とは…)
これに対し、NASはNNのモデル(アーキテクチャ)を自動設計する手法
構成要素が、探索空間・探索手法・精度評価手法で大まかに分類される
探索空間
• Global(制約なく全体を設計する), cell-based(大まかな構成は決まって
おりそれを構成する小さなパーツのみを設計)
探索手法
• 強化学習、進化的アルゴリズム、gradientベース、random
精度測定手法
• 全学習、部分学習、weight-share、枝刈り探索
(出来上がったものの評価をどれだけサボれるか)
Neural Architecture Search (NAS)
63
T. Elsken, J. Metzen, and F. Hutter, "Neural Architecture Search: A Survey," in JMLR, 2019.
M. Wistuba, A. Rawat, and T. Pedapati, "A Survey on Neural Architecture Search," in arXiv:1905.01392,
2019.
https://github.com/D-X-Y/awesome-NAS
Mobility Technologies Co., Ltd.
探索空間:global、探索手法:REINFORCE
RNNのcontrollerがネットワーク構造を生成
• 畳み込み層のパラメータと、skip connectionの有無を出力
生成されたネットワークを学習し、その精度を報酬にする
NAS with Reinforcement Learning
64
Zoph and Q. V. Le, "Neural architecture search with reinforcement learning," in Proc. of ICLR, 2017.
Mobility Technologies Co., Ltd.
800GPUs for 28 daysの成果
配線芸!
NAS with Reinforcement Learning
65
Zoph and Q. V. Le, "Neural architecture search with reinforcement learning," in Proc. of ICLR, 2017.
Mobility Technologies Co., Ltd.
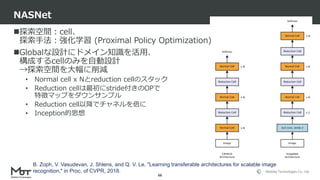
探索空間:cell、
探索手法:強化学習 (Proximal Policy Optimization)
Globalな設計にドメイン知識を活用、
構成するcellのみを自動設計
→探索空間を大幅に削減
• Normal cell x Nとreduction cellのスタック
• Reduction cellは最初にstride付きのOPで
特徴マップをダウンサンプル
• Reduction cell以降でチャネルを倍に
• Inception的思想
NASNet
66
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
Mobility Technologies Co., Ltd.
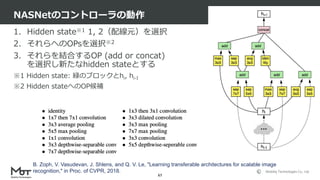
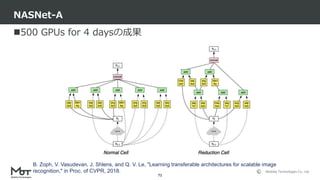
1. Hidden state※1 1, 2(配線元)を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
NASNetのコントローラの動作
67
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
Mobility Technologies Co., Ltd.
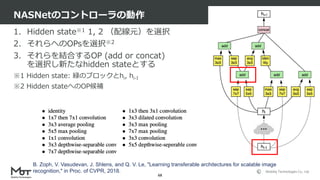
1. Hidden state※1 1, 2 (配線元)を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
NASNetのコントローラの動作
68
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
Mobility Technologies Co., Ltd.
1. Hidden state※1 1, 2 (配線元)を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
NASNetのコントローラの動作
69
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
sep
3x3
avg
3x3
Mobility Technologies Co., Ltd.
1. Hidden state※1 1, 2 (配線元)を選択
2. それらへのOPsを選択※2
3. それらを結合するOP (add or concat)
を選択し新たなhidden stateとする
※1 Hidden state: 緑のブロックとhi, hi-I
※2 Hidden stateへのOP候補
NASNetのコントローラの動作
70
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
concat
sep
3x3
avg
3x3
Mobility Technologies Co., Ltd.
500 GPUs for 4 daysの成果
NASNet-A
71
B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, "Learning transferable architectures for scalable image
recognition," in Proc. of CVPR, 2018.
Mobility Technologies Co., Ltd.
探索空間:cell、探索手法:強化学習 (REINFORCE)
Cellの構造を出力するRNNコントローラと、
コントローラーが出力する全てのネットワークをサブグラフとして保持できる
巨大な計算グラフ(ネットワーク)を同時に学習
→生成したネットワークの学習が不要に(1GPU for 0.45 days!)
• 全結合グラフからサブグラフをサンプリングしてくるイメージ
Single shot, weight share
詳細は資料**を参照
ENAS*
72
* H. Pham, M. Y. Guan, B. Zoph, Q. V. Le, and Jeff Dean, "Efficient Neural Architecture Search
via Parameter Sharing," in Proc. of ICML, 2018.
** https://www.slideshare.net/tkatojp/efficient-neural-architecture-search-via-parameters-
sharing-icml2018
Mobility Technologies Co., Ltd.
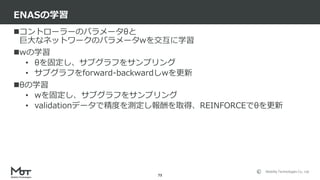
コントローラーのパラメータθと
巨大なネットワークのパラメータwを交互に学習
wの学習
• θを固定し、サブグラフをサンプリング
• サブグラフをforward-backwardしwを更新
θの学習
• wを固定し、サブグラフをサンプリング
• validationデータで精度を測定し報酬を取得、REINFORCEでθを更新
ENASの学習
73
Mobility Technologies Co., Ltd.
探索空間:cell、探索手法:gradient
グラフの接続やOPの選択をsoftmaxで実現することで、
構造探索もforward-backwardで実現
ENASと同じくshared param、wと構造を交互に最適化
DARTS
74
H. Liu, K. Simonyan, and Y. Yang, "DARTS: Differentiable Architecture Search," in Proc. of ICLR, 2019.
Mobility Technologies Co., Ltd.
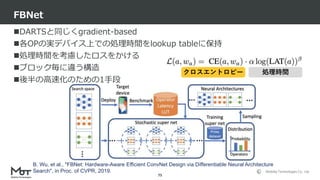
DARTSと同じくgradient-based
各OPの実デバイス上での処理時間をlookup tableに保持
処理時間を考慮したロスをかける
ブロック毎に違う構造
後半の高速化のための1手段
FBNet
75
B. Wu, et al., "FBNet: Hardware-Aware Efficient ConvNet Design via Differentiable Neural Architecture
Search", in Proc. of CVPR, 2019.
クロスエントロピー 処理時間
Mobility Technologies Co., Ltd.
H. Cai, L. Zhu, and S. Han, "ProxylessNAS: Direct Neural Architecture Search on Target
Task and Hardware," in Proc. of ICLR, 2019.
M. Tan, B. Chen, R. Pang, V. Vasudevan, M. Sandler, A. Howard, and Q. V. Le, "MnasNet:
Platform-Aware Neural Architecture Search for Mobile," in Proc. of CVPR, 2019.
X. Dai, et al., "ChamNet: Towards Efficient Network Design through Platform-Aware
Model Adaptation," in Proc. of CVPR, 2019.
D. Stamoulis, et al., "Single-Path NAS: Device-Aware Efficient ConvNet Design," in Proc.
of ICMLW, 2019.
他にも
76
Mobility Technologies Co., Ltd.
Weight share + random search (ASHA) が良い*
Asynchronous Successive Halving (ASHA):複数のモデルを平行に学習を進
めながら有望なものだけを残して枝刈り
• Optunaで使えるよ!**
探索空間を、ランダムなDAG生成アルゴリズムが生成するグラフ
にすると想像以上に良い***
Random Search系
77
* L. Li and A. Talwalkar, "Random search and reproducibility for neural architecture search," in
arXiv:1902.07638, 2019.
** https://www.slideshare.net/shotarosano5/automl-in-neurips-2018
*** S. Xie, A. Kirillov, R. Girshick, and K. He, "Exploring Randomly Wired Neural Networks for Image
Recognition," in arXiv:1904.01569, 2019.
Mobility Technologies Co., Ltd.
クラス分類モデルはILSVRCとともに進化してきた
ResNetで1つの完成形
• この資料ももはや古典
NASが庶民の手に
• Single shot, weight share
• FLOPsではなく実速度を最適化(mobile device-aware)
ベースモジュール (cell) は人手だったり(後述のMNasNetとか)
• むしろ昔はcellのほうが自動設計(高速化観点だと配線多いのがNG)
• あまり探索された感がない(greedyなgrid search感)
小まとめ
78
Mobility Technologies Co., Ltd.
79
1. クラス分類向けモデルについて
• ILSVRCで振り返る進化の歴史
• その他重要なモデル
• モデルの自動設計
(Neural Architecture Search)
2. モデルの高速化について
• 軽量モデル
• その他モデルの高速化手法
3. クラス分類以外のタスクにおけるモデル
4. おまけ
Agenda
Mobility Technologies Co., Ltd.
実用上、精度を維持しつつモデルの計算量を削減することが重要
• リアルタイム性
• 計算コスト
主に下記の条件を満たす手法を紹介
• 特定のハードウェアに依存せずに実現可能
• 畳み込みニューラルネットワーク (CNN) が対象
• 推論時の高速化
モデルの高速化
80
Mobility Technologies Co., Ltd.
モデルパラメータ数の削減
FLOPs (Floating-point Operations) の削減
モデルファイルサイズの削減
推論時間の削減
訓練時間の削減
微妙に違う
高速化?
81
Mobility Technologies Co., Ltd.
Convの部分がFLOPsで見える部分
FLOPs ≠ 処理速度
82
N. Ma, X. Zhang, H. Zheng, and J. Sun, "ShuffleNet V2: Practical Guidelines for Efficient CNN
Architecture Design," in Proc. of ECCV, 2018.
Mobility Technologies Co., Ltd.
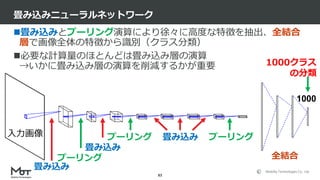
畳み込みとプーリング演算により徐々に高度な特徴を抽出、全結合
層で画像全体の特徴から識別(クラス分類)
必要な計算量のほとんどは畳み込み層の演算
→いかに畳み込み層の演算を削減するかが重要
畳み込みニューラルネットワーク
83
畳み込み
プーリング
畳み込み
プーリング 畳み込み プーリング
全結合
1000
1000クラス
の分類
入力画像
Mobility Technologies Co., Ltd.
まずは軽量なモデルを使ってみる
性能より速度が欲しい場合は画像サイズやチャネル数を単純に削減
更にシビアな性能を求められる場合は真面目に高速化する
モデルの高速化
84
Mobility Technologies Co., Ltd.
85
1. クラス分類向けモデルについて
• ILSVRCで振り返る進化の歴史
• その他重要なモデル
• モデルの自動設計
(Neural Architecture Search)
2. モデルの高速化について
• 軽量モデル
• その他モデルの高速化手法
3. クラス分類以外のタスクにおけるモデル
4. おまけ
Agenda
Mobility Technologies Co., Ltd.
 入力レイヤサイズ:H x W x N
 畳み込みカーネル:K x K x N x M
convKxK, M と表記 (e.g. conv 3x3, 64)
 出力レイヤサイズ:H x W x M
 畳み込みの計算量:H・W・N・K2・M(バイアス項を無視)
畳み込み層の計算量
86
W
H
N M
K
K
W
H
入力特徴マップ
畳み込み
カーネル
N
出力特徴マップ
*
和要素積
× M
convK×K, M
畳み込み層の計算量は
• 画像/特徴マップのサイズ(HW)
• 入出力チャネル数(NM)
• カーネルサイズ(K2)
に比例
Mobility Technologies Co., Ltd.
畳み込みと空間方向やチャネル方向に分割する
=局所的には全結合となっている畳み込みを疎結合にする
軽量モデルの方針
87
Mobility Technologies Co., Ltd.
大きな畳み込みカーネルを小さな畳み込みカーネルに分解
例えば5x5の畳み込みを3x3の畳み込み2つに分解
これらは同じサイズの受容野を持つが分解すると計算量は25:18
Inception-v2*では最初の7x7畳み込みを3x3畳み込み3つに分解
• 以降のSENetやShuffleNetV2等の実装でも利用されている**
空間方向の分解
88
特徴マップ
conv5x5 conv3x3 - conv3x3
* C. Szegedy, et al., "Rethinking the Inception Architecture for Computer Vision," in Proc. of CVPR, 2016.
** T. He, et al., "Bag of Tricks for Image Classification with Convolutional Neural Networks," in Proc. of
CVPR, 2019.
Mobility Technologies Co., Ltd.
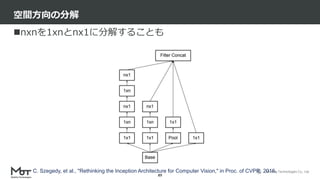
nxnを1xnとnx1に分解することも
空間方向の分解
89
C. Szegedy, et al., "Rethinking the Inception Architecture for Computer Vision," in Proc. of CVPR, 2016.
Mobility Technologies Co., Ltd.
戦略
• 3x3の一部をサボって1x1のフィルタを利用する
• 3x3への入力となるチャネル数を少なくする(1x1で次元圧縮)
MobileNetが流行る前は大人気だった
SqueezeNet
90
conv 1x1, s1x1
conv 1x1, e1x1 conv 3x3, e3x3
concat
Fire
module
32
128128
256
256
Squeeze layer
Expand layer
F. N. Iandola, S. Han, M. W. Moskewicz, K. Ashraf, W. J. Dally, and K. Keutzer, "SqueezeNet: AlexNet-level
accuracy with 50x fewer parameters and <0.5MB model size," in arXiv:1602.07360, 2016.
Mobility Technologies Co., Ltd.
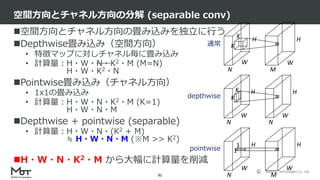
空間方向とチャネル方向の畳み込みを独立に行う
Depthwise畳み込み(空間方向)
• 特徴マップに対しチャネル毎に畳み込み
• 計算量:H・W・N・K2・M (M=N)
H・W・K2・N
Pointwise畳み込み(チャネル方向)
• 1x1の畳み込み
• 計算量:H・W・N・K2・M (K=1)
H・W・N・M
Depthwise + pointwise (separable)
• 計算量:H・W・N・(K2 + M)
≒ H・W・N・M (※M >> K2)
H・W・N・K2・M から大幅に計算量を削減
空間方向とチャネル方向の分解 (separable conv)
91
W
H
W
H
N
1
1
M
W
H
W
H
N
K
K
N
W
H
W
H
N M
K
K通常
depthwise
pointwise
Mobility Technologies Co., Ltd.
イメージ
空間方向とチャネル方向の分離
92
conv 3x3
conv 1x1
depthwise conv
spatial channel
in
out
Mobility Technologies Co., Ltd.
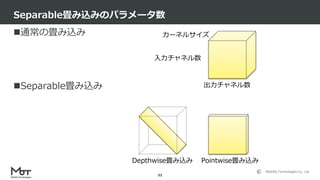
通常の畳み込み
Separable畳み込み
Separable畳み込みのパラメータ数
93
入力チャネル数
出力チャネル数
カーネルサイズ
Depthwise畳み込み Pointwise畳み込み
Mobility Technologies Co., Ltd.
Separable convを多用したモデル
Xception
94
F. Chollet, "Xception: Deep learning with depthwise separable convolutions," in Proc. of CVPR, 2017.
論文の小ネタが面白い
https://qiita.com/yu4u/items/34cd33b944d8bdca142d#%E4%BD%99%E8%AB%87
Mobility Technologies Co., Ltd.
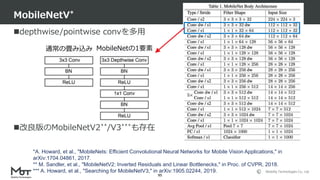
depthwise/pointwise convを多用
改良版のMobileNetV2**/V3***も存在
MobileNetV*
95
通常の畳み込み MobileNetの1要素
*A. Howard, et al., "MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications," in
arXiv:1704.04861, 2017.
** M. Sandler, et al., "MobileNetV2: Inverted Residuals and Linear Bottlenecks," in Proc. of CVPR, 2018.
*** A. Howard, et al., "Searching for MobileNetV3," in arXiv:1905.02244, 2019.
Mobility Technologies Co., Ltd.
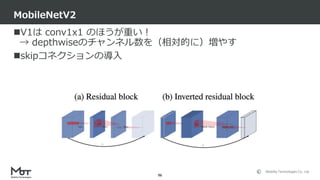
V1は conv1x1 のほうが重い!
→ depthwiseのチャンネル数を(相対的に)増やす
skipコネクションの導入
MobileNetV2
96
Mobility Technologies Co., Ltd.
V1
V2
MobileNetV2
97
depthwise conv
conv 1x1
depthwise conv
conv 1x1
conv 1x1
spatial channel
V1は conv1x1のほうが重い!
→ depthwiseのチャンネル数を(相対的に)増やす
Mobility Technologies Co., Ltd.
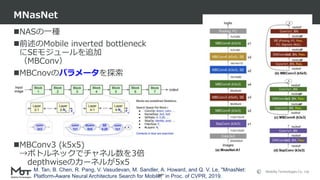
NASの一種
前述のMobile inverted bottleneck
にSEモジュールを追加
(MBConv)
MBCnovのパラメータを探索
MBConv3 (k5x5)
→ボトルネックでチャネル数を3倍
depthwiseのカーネルが5x5
MNasNet
98
M. Tan, B. Chen, R. Pang, V. Vasudevan, M. Sandler, A. Howard, and Q. V. Le, "MnasNet:
Platform-Aware Neural Architecture Search for Mobile," in Proc. of CVPR, 2019.
Mobility Technologies Co., Ltd.
MnasNetをベースに最適化
SEモジュールチャネル数を増加
(h-)swishの利用、実装の最適化
NetAdaptによるPruning(後述)
Compactation↓
MobileNetV3
99
swishが入ったMBConvは
Kaggleで大活躍のEfficientNetでも
基本モジュールとして採用
Mobility Technologies Co., Ltd.
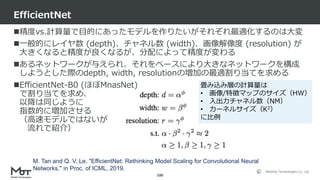
精度vs.計算量で目的にあったモデルを作りたいがそれぞれ最適化するのは大変
一般的にレイヤ数 (depth)、チャネル数 (width)、画像解像度 (resolution) が
大きくなると精度が良くなるが、分配によって精度が変わる
あるネットワークが与えられ、それをベースにより大きなネットワークを構成
しようとした際のdepth, width, resolutionの増加の最適割り当てを求める
EfficientNet-B0 (ほぼMnasNet)
で割り当てを求め、
以降は同じように
指数的に増加させる
(高速モデルではないが
流れで紹介)
EfficientNet
100
M. Tan and Q. V. Le, "EfficientNet: Rethinking Model Scaling for Convolutional Neural
Networks," in Proc. of ICML, 2019.
畳み込み層の計算量は
• 画像/特徴マップのサイズ(HW)
• 入出力チャネル数(NM)
• カーネルサイズ(K2)
に比例