Skip to main content More Related Content

PPTX

PPTX

PDF
(2022年3月版)深層学習によるImage Classificaitonの発展 
PDF

PPTX

PDF
0から理解するニューラルネットアーキテクチャサーチ(NAS) 
PDF

PDF
【論文読み会】Deep Clustering for Unsupervised Learning of Visual Features What's hot

PPTX
【DL輪読会】ViT + Self Supervised Learningまとめ 
PDF
深層学習の不確実性 - Uncertainty in Deep Neural Networks - 
PDF
【メタサーベイ】基盤モデル / Foundation Models 
PPTX
【DL輪読会】Scaling Laws for Neural Language Models 
PPTX
【DL輪読会】言語以外でのTransformerのまとめ (ViT, Perceiver, Frozen Pretrained Transformer etc) 
PPTX
近年のHierarchical Vision Transformer 
PPTX
Semi supervised, weakly-supervised, unsupervised, and active learning 
PDF
Word Tour: One-dimensional Word Embeddings via the Traveling Salesman Problem... 
PPTX
[DL輪読会]GLIDE: Guided Language to Image Diffusion for Generation and Editing 
PDF

PDF
SSII2021 [OS2-02] 深層学習におけるデータ拡張の原理と最新動向 
PDF
【メタサーベイ】Transformerから基盤モデルまでの流れ / From Transformer to Foundation Models 
PDF

PPTX
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets 
PPTX

PPTX
[DL輪読会]Vision Transformer with Deformable Attention (Deformable Attention Tra... 
PDF

PDF
[DL輪読会]Reward Augmented Maximum Likelihood for Neural Structured Prediction 
PPTX
[DL輪読会]Revisiting Deep Learning Models for Tabular Data (NeurIPS 2021) 表形式デー... 
PPTX
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021) Similar to ResNetの仕組み

PPTX

PDF
Deep residual learning for image recognition 
PPTX
PRML 5.5.6-5.6 畳み込みネットワーク(CNN)・ソフト重み共有・混合密度ネットワーク 
PDF
Skip Connection まとめ(Neural Network) 
PDF
(2021年8月版)深層学習によるImage Classificaitonの発展 
PPTX
画像認識 �6.3-6.6 畳込みニューラル�ネットワーク 
PDF
Deep Residual Learning (ILSVRC2015 winner) 
PDF
[Dl輪読会]bridging the gaps between residual learning, recurrent neural networks... 
PPTX

PDF
Convolutional Neural Networks のトレンド @WBAFLカジュアルトーク#2 
PDF

PDF

PDF
ConvNetの歴史とResNet亜種、ベストプラクティス 
PDF
Efficient Neural Architecture Searchvia Parameter Sharing 
PPTX
Densely Connected Convolutional Networks 
PDF
When NAS Meets Robustness:�In Search of Robust Architectures against�Adversar... 
PDF
Centerlossを読んでみた_20170618@abeja 
PDF
CVPR2018のPointCloudのCNN論文とSPLATNet 
PDF

PPTX
Image net classification with Deep Convolutional Neural Networks ResNetの仕組み
- 1.
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
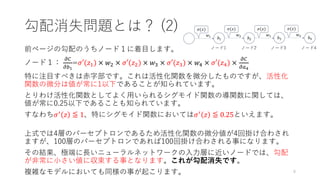
勾配消失問題とは? (2)
前ページの勾配のうちノード1に着目します。
ノード1:
𝜕𝐶
𝜕𝑏1
=𝜎′(𝑧1) ×𝑤2 × 𝜎′(𝑧2) × 𝑤3 × 𝜎′(𝑧3) × 𝑤4 × 𝜎′(𝑧4) ×
𝜕𝐶
𝜕𝑎4
特に注目すべきは赤字部です。これは活性化関数を微分したものですが、活性化
関数の微分は値が常に1以下であることが知られています。
とりわけ活性化関数としてよく用いられるシグモイド関数の導関数に関しては、
値が常に0.25以下であることも知られています。
すなわち𝜎′
𝑧 ≦ 1、特にシグモイド関数においては𝜎′
𝑧 ≦ 0.25といえます。
上式では4層のパーセプトロンであるため活性化関数の微分値が4回掛け合わされ
ますが、100層のパーセプトロンであれば100回掛け合わされる事になります。
その結果、極端に長いニューラルネットワークの入力層に近いノードでは、勾配
が非常に小さい値に収束する事となります。これが勾配消失です。
複雑なモデルにおいても同様の事が起こります。 8
- 9.
- 10.
- 11.
- 12.
- 13.
- 14.
- 15.
派生研究 (1)
• 100層を超えるResNetは学習に数週間を要する。改善できない
か?
⇒深い層ではdeeppathが0に近い値を出力することが知られている。
Gao(2016)らの論文ではそれを利用し、深い層において一定確率で
deep pathを無視し、shortcut connectionを素通りするようなモデ
ルを作成。精度を下げることなく25%程度の時間短縮に成功(Deep
Networks with Stochastic Depth)。
• 層を深くするのでなく、畳み込み時のフィルタの数を増やして
ネットワークを広くする事で性能を上げられないか?
⇒Sergeyらの論文によると、ネットワークを広げる事によって僅か
16層程度のモデルでも既存のResNetの性能を出す事が可能に。
層数も少なくできるので学習時間の削減にも成功(Wide ResNet)。
15
- 16.
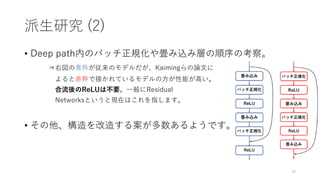
派生研究 (2)
• Deeppath内のバッチ正規化や畳み込み層の順序の考察。
⇒右図の青枠が従来のモデルだが、Kaimingらの論文に
よると赤枠で描かれているモデルの方が性能が高い。
合流後のReLUは不要。一般にResidual
Networksというと現在はこれを指します。
• その他、構造を改造する案が多数あるようです。
16
- 17.
参考論文等
• He, Kaiming,et al. "Deep Residual Learning for Image Recognition." arXiv preprint
arXiv:1512.03385 (2015)
• Veit, Andreas, et al. “Residual Networks Behave Like Ensembles of Relatively Shallow
Networks.” arXiv preprint arXiv:1605.006431 (2016)
• Huang, Gao, et al. "Deep networks with stochastic depth." arXiv preprint
arXiv:1603.09382 (2016)
• Zagoruyko & Komodakis “Wide Residual Networks.” arXiv preprint arXiv:1605.07146
(2016)
• He, Kaiming, et al. "Identity mappings in deep residual networks." arXiv preprint
arXiv:1603.05027 (2016)
17
 Most read
 Most read
 Most read