Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
Takao Yamanaka
PDF, PPTX
72,048 views
混合モデルとEMアルゴリズム(PRML第9章)
研究室で説明した「パターン認識と機械学習(下)」の第9章混合モデルとEMアルゴリズムについてです.
Read more
87
Save
Share
Embed
Save to Drive
Download now
Download as PDF, PPTX
1
/ 46
2
/ 46
Most read
3
/ 46
4
/ 46
5
/ 46
6
/ 46
Most read
7
/ 46
8
/ 46
9
/ 46
10
/ 46
11
/ 46
12
/ 46
13
/ 46
14
/ 46
15
/ 46
16
/ 46
17
/ 46
18
/ 46
19
/ 46
20
/ 46
More Related Content
PPTX
PRML第9章「混合モデルとEM」
by
Keisuke Sugawara
55 slides
6.7K views
PDF
PRML Chapter 14
by
Masahito Ohue
65 slides
7.7K views
PPTX
マルコフ連鎖モンテカルロ法 (2/3はベイズ推定の話)
by
Yoshitake Takebayashi
48 slides
51.2K views
PPTX
PRML第6章「カーネル法」
by
Keisuke Sugawara
61 slides
29.7K views
PPTX
変分ベイズ法の説明
by
Haruka Ozaki
27 slides
42.6K views
PDF
【博士論文発表会】パラメータ制約付き特異モデルの統計的学習理論
by
Naoki Hayashi
74 slides
1.9K views
PDF
PRML 上 2.3.6 ~ 2.5.2
by
禎晃 山崎
67 slides
2.3K views
PDF
EMアルゴリズム
by
Sotetsu KOYAMADA(小山田創哲)
55 slides
79.4K views
PRML第9章「混合モデルとEM」
by
Keisuke Sugawara
55 slides
6.7K views
PRML Chapter 14
by
Masahito Ohue
65 slides
7.7K views
マルコフ連鎖モンテカルロ法 (2/3はベイズ推定の話)
by
Yoshitake Takebayashi
48 slides
51.2K views
PRML第6章「カーネル法」
by
Keisuke Sugawara
61 slides
29.7K views
変分ベイズ法の説明
by
Haruka Ozaki
27 slides
42.6K views
【博士論文発表会】パラメータ制約付き特異モデルの統計的学習理論
by
Naoki Hayashi
74 slides
1.9K views
PRML 上 2.3.6 ~ 2.5.2
by
禎晃 山崎
67 slides
2.3K views
EMアルゴリズム
by
Sotetsu KOYAMADA(小山田創哲)
55 slides
79.4K views
What's hot
PDF
PRML輪読#11
by
matsuolab
25 slides
7.8K views
PDF
PRML輪読#10
by
matsuolab
73 slides
9.9K views
PDF
PRML輪読#3
by
matsuolab
38 slides
12.4K views
PDF
GAN(と強化学習との関係)
by
Masahiro Suzuki
77 slides
88K views
PDF
変分推論法(変分ベイズ法)(PRML第10章)
by
Takao Yamanaka
34 slides
32.6K views
PDF
基礎からのベイズ統計学 輪読会資料 第4章 メトロポリス・ヘイスティングス法
by
Ken'ichi Matsui
87 slides
28.4K views
PPTX
ようやく分かった!最尤推定とベイズ推定
by
Akira Masuda
31 slides
99.7K views
PDF
深層生成モデルと世界モデル
by
Masahiro Suzuki
57 slides
17.9K views
PDF
グラフィカルモデル入門
by
Kawamoto_Kazuhiko
67 slides
125.9K views
PDF
あなたの心にBridgeSampling
by
daiki hojo
38 slides
5.7K views
PPTX
パターン認識と機械学習(PRML)第2章 確率分布 2.3 ガウス分布
by
Nagayoshi Yamashita
46 slides
32.7K views
PPTX
WAICとWBICのご紹介
by
Tomoki Matsumoto
20 slides
8.5K views
PPTX
[DL輪読会]Flow-based Deep Generative Models
by
Deep Learning JP
62 slides
17.6K views
PDF
統計的因果推論への招待 -因果構造探索を中心に-
by
Shiga University, RIKEN
56 slides
29.1K views
PDF
グラフニューラルネットワーク入門
by
ryosuke-kojima
65 slides
57.7K views
PDF
混合ガウスモデルとEMアルゴリスム
by
貴之 八木
63 slides
24.9K views
PDF
パターン認識 04 混合正規分布
by
sleipnir002
28 slides
59.5K views
PDF
HiPPO/S4解説
by
Morpho, Inc.
96 slides
13.3K views
PDF
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
by
Deep Learning JP
29 slides
19.7K views
PPTX
2014 3 13(テンソル分解の基礎)
by
Tatsuya Yokota
44 slides
42.3K views
PRML輪読#11
by
matsuolab
25 slides
7.8K views
PRML輪読#10
by
matsuolab
73 slides
9.9K views
PRML輪読#3
by
matsuolab
38 slides
12.4K views
GAN(と強化学習との関係)
by
Masahiro Suzuki
77 slides
88K views
変分推論法(変分ベイズ法)(PRML第10章)
by
Takao Yamanaka
34 slides
32.6K views
基礎からのベイズ統計学 輪読会資料 第4章 メトロポリス・ヘイスティングス法
by
Ken'ichi Matsui
87 slides
28.4K views
ようやく分かった!最尤推定とベイズ推定
by
Akira Masuda
31 slides
99.7K views
深層生成モデルと世界モデル
by
Masahiro Suzuki
57 slides
17.9K views
グラフィカルモデル入門
by
Kawamoto_Kazuhiko
67 slides
125.9K views
あなたの心にBridgeSampling
by
daiki hojo
38 slides
5.7K views
パターン認識と機械学習(PRML)第2章 確率分布 2.3 ガウス分布
by
Nagayoshi Yamashita
46 slides
32.7K views
WAICとWBICのご紹介
by
Tomoki Matsumoto
20 slides
8.5K views
[DL輪読会]Flow-based Deep Generative Models
by
Deep Learning JP
62 slides
17.6K views
統計的因果推論への招待 -因果構造探索を中心に-
by
Shiga University, RIKEN
56 slides
29.1K views
グラフニューラルネットワーク入門
by
ryosuke-kojima
65 slides
57.7K views
混合ガウスモデルとEMアルゴリスム
by
貴之 八木
63 slides
24.9K views
パターン認識 04 混合正規分布
by
sleipnir002
28 slides
59.5K views
HiPPO/S4解説
by
Morpho, Inc.
96 slides
13.3K views
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
by
Deep Learning JP
29 slides
19.7K views
2014 3 13(テンソル分解の基礎)
by
Tatsuya Yokota
44 slides
42.3K views
Viewers also liked
PDF
数式を使わずイメージで理解するEMアルゴリズム
by
裕樹 奥田
14 slides
73.3K views
PDF
共起要素のクラスタリングを用いた分布類似度計算
by
長岡技術科学大学 自然言語処理研究室
16 slides
1.9K views
PDF
研究室内PRML勉強会 8章1節
by
Koji Matsuda
22 slides
4.3K views
PPT
SVM&R with Yaruo!!
by
guest8ee130
61 slides
8.3K views
PDF
Chapter9 2
by
Takuya Minagawa
35 slides
9.5K views
PPTX
確率ロボティクス第12回
by
Ryuichi Ueda
15 slides
7.9K views
PDF
Deformable Part Modelとその発展
by
Takao Yamanaka
31 slides
17.8K views
PPTX
確率ロボティクス第11回
by
Ryuichi Ueda
17 slides
9.3K views
PDF
PRML輪読#13
by
matsuolab
35 slides
9.4K views
ODP
音声認識の基礎
by
Akinori Ito
35 slides
36.2K views
PDF
Deep Learning for Speech Recognition - Vikrant Singh Tomar
by
WithTheBest
17 slides
3K views
PDF
Objectnessとその周辺技術
by
Takao Yamanaka
51 slides
7.8K views
PDF
Fisher線形判別分析とFisher Weight Maps
by
Takao Yamanaka
37 slides
50.3K views
PDF
高速な物体候補領域提案手法 (Fast Object Proposal Methods)
by
Takao Yamanaka
22 slides
5.6K views
PPTX
機械学習を用いた異常検知入門
by
michiaki ito
83 slides
38.6K views
数式を使わずイメージで理解するEMアルゴリズム
by
裕樹 奥田
14 slides
73.3K views
共起要素のクラスタリングを用いた分布類似度計算
by
長岡技術科学大学 自然言語処理研究室
16 slides
1.9K views
研究室内PRML勉強会 8章1節
by
Koji Matsuda
22 slides
4.3K views
SVM&R with Yaruo!!
by
guest8ee130
61 slides
8.3K views
Chapter9 2
by
Takuya Minagawa
35 slides
9.5K views
確率ロボティクス第12回
by
Ryuichi Ueda
15 slides
7.9K views
Deformable Part Modelとその発展
by
Takao Yamanaka
31 slides
17.8K views
確率ロボティクス第11回
by
Ryuichi Ueda
17 slides
9.3K views
PRML輪読#13
by
matsuolab
35 slides
9.4K views
音声認識の基礎
by
Akinori Ito
35 slides
36.2K views
Deep Learning for Speech Recognition - Vikrant Singh Tomar
by
WithTheBest
17 slides
3K views
Objectnessとその周辺技術
by
Takao Yamanaka
51 slides
7.8K views
Fisher線形判別分析とFisher Weight Maps
by
Takao Yamanaka
37 slides
50.3K views
高速な物体候補領域提案手法 (Fast Object Proposal Methods)
by
Takao Yamanaka
22 slides
5.6K views
機械学習を用いた異常検知入門
by
michiaki ito
83 slides
38.6K views
Similar to 混合モデルとEMアルゴリズム(PRML第9章)
PDF
PRML輪読#9
by
matsuolab
44 slides
6.5K views
PDF
PRML復々習レーン#15 前回までのあらすじ
by
sleepy_yoshi
16 slides
4K views
PDF
Bishop prml 9.3_wk77_100408-1504
by
Wataru Kishimoto
31 slides
1.7K views
PDF
PRML復々習レーン#14 ver.2
by
Takuya Fukagai
29 slides
1.6K views
PPTX
Gmm勉強会
by
Hayato Ohya
27 slides
2.9K views
PDF
PRML復々習レーン#14
by
Takuya Fukagai
27 slides
586 views
PDF
prml_titech_9.0-9.2
by
Taikai Takeda
28 slides
1.1K views
PDF
Oshasta em
by
Naotaka Yamada
15 slides
20.2K views
PDF
PRML 9章
by
ぱんいち すみもと
23 slides
951 views
PPTX
続・わかりやすいパターン認識 9章
by
hakusai
35 slides
312 views
PDF
Prml2.1 2.2,2.4-2.5
by
Takuto Kimura
83 slides
10.9K views
PDF
[PRML] パターン認識と機械学習(第1章:序論)
by
Ryosuke Sasaki
44 slides
1.8K views
PDF
PRML2.1 2.2
by
Takuto Kimura
31 slides
4.8K views
PDF
PRML_titech 2.3.1 - 2.3.7
by
Takafumi Sakakibara
65 slides
1.5K views
PPTX
PILCO - 第一回高橋研究室モデルベース強化学習勉強会
by
Shunichi Sekiguchi
36 slides
2.3K views
PDF
クラシックな機械学習の入門 9. モデル推定
by
Hiroshi Nakagawa
59 slides
8.6K views
PDF
PRML2.3.8~2.5 Slides in charge
by
Junpei Matsuda
79 slides
1.5K views
PPTX
Prml 最尤推定からベイズ曲線フィッティング
by
takutori
43 slides
1.7K views
PDF
PRML 上 1.2.4 ~ 1.2.6
by
禎晃 山崎
28 slides
613 views
PDF
PRML復々習レーン#3 前回までのあらすじ
by
sleepy_yoshi
18 slides
2.8K views
PRML輪読#9
by
matsuolab
44 slides
6.5K views
PRML復々習レーン#15 前回までのあらすじ
by
sleepy_yoshi
16 slides
4K views
Bishop prml 9.3_wk77_100408-1504
by
Wataru Kishimoto
31 slides
1.7K views
PRML復々習レーン#14 ver.2
by
Takuya Fukagai
29 slides
1.6K views
Gmm勉強会
by
Hayato Ohya
27 slides
2.9K views
PRML復々習レーン#14
by
Takuya Fukagai
27 slides
586 views
prml_titech_9.0-9.2
by
Taikai Takeda
28 slides
1.1K views
Oshasta em
by
Naotaka Yamada
15 slides
20.2K views
PRML 9章
by
ぱんいち すみもと
23 slides
951 views
続・わかりやすいパターン認識 9章
by
hakusai
35 slides
312 views
Prml2.1 2.2,2.4-2.5
by
Takuto Kimura
83 slides
10.9K views
[PRML] パターン認識と機械学習(第1章:序論)
by
Ryosuke Sasaki
44 slides
1.8K views
PRML2.1 2.2
by
Takuto Kimura
31 slides
4.8K views
PRML_titech 2.3.1 - 2.3.7
by
Takafumi Sakakibara
65 slides
1.5K views
PILCO - 第一回高橋研究室モデルベース強化学習勉強会
by
Shunichi Sekiguchi
36 slides
2.3K views
クラシックな機械学習の入門 9. モデル推定
by
Hiroshi Nakagawa
59 slides
8.6K views
PRML2.3.8~2.5 Slides in charge
by
Junpei Matsuda
79 slides
1.5K views
Prml 最尤推定からベイズ曲線フィッティング
by
takutori
43 slides
1.7K views
PRML 上 1.2.4 ~ 1.2.6
by
禎晃 山崎
28 slides
613 views
PRML復々習レーン#3 前回までのあらすじ
by
sleepy_yoshi
18 slides
2.8K views
混合モデルとEMアルゴリズム(PRML第9章)
1.
2013/11/13 上智大学 山中高夫 混合モデルとEMアルゴリズム 「第9章
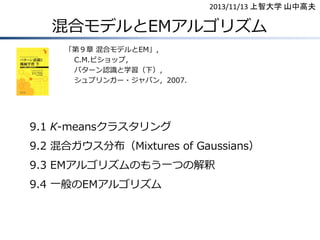
混合モデルとEM」, C.M.ビショップ, パターン認識と学習(下), シュプリンガー・ジャパン,2007. 9.1 K-meansクラスタリング 9.2 混合ガウス分布(Mixtures of Gaussians) 9.3 EMアルゴリズムのもう一つの解釈 9.4 一般のEMアルゴリズム
2.
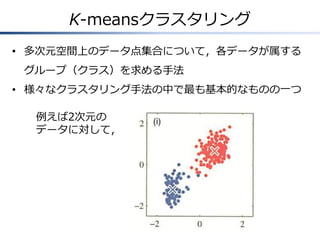
K-meansクラスタリング • 多次元空間上のデータ点集合について,各データが属する グループ(クラス)を求める手法 • 様々なクラスタリング手法の中で最も基本的なものの一つ 例えば2次元の データに対して,
3.
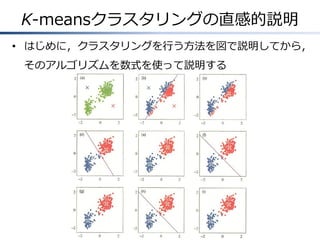
K-meansクラスタリングの直感的説明 • はじめに,クラスタリングを行う方法を図で説明してから, そのアルゴリズムを数式を使って説明する
4.
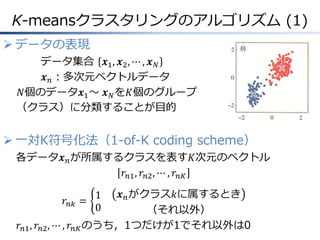
K-meansクラスタリングのアルゴリズム (1) データの表現 データ集合
𝒙1 , 𝒙2 , ⋯ , 𝒙 𝑁 𝒙 𝑛 :多次元ベクトルデータ 𝑁個のデータ𝒙1 ~ 𝒙 𝑁 を𝐾個のグループ (クラス)に分類することが目的 一対K符号化法(1-of-K coding scheme) 各データ𝒙 𝑛 が所属するクラスを表す𝐾次元のベクトル 𝑟 𝑛1 , 𝑟 𝑛2 , ⋯ , 𝑟 𝑛𝐾 𝒙 𝑛 がクラス𝑘に属するとき (それ以外) 𝑟 𝑛1 , 𝑟 𝑛2 , ⋯ , 𝑟 𝑛𝐾 のうち,1つだけが1でそれ以外は0 𝑟 𝑛𝑘 = 1 0
5.
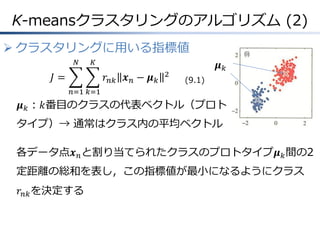
K-meansクラスタリングのアルゴリズム (2) クラスタリングに用いる指標値 𝑁 𝐾 𝐽= 𝑟
𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 2 𝝁𝑘 (9.1) 𝑛=1 𝑘=1 𝝁 𝑘 :𝑘番目のクラスの代表ベクトル(プロト タイプ)→ 通常はクラス内の平均ベクトル 各データ点𝒙 𝑛 と割り当てられたクラスのプロトタイプ𝝁 𝑘 間の2 定距離の総和を表し,この指標値が最小になるようにクラス 𝑟 𝑛𝑘 を決定する
6.
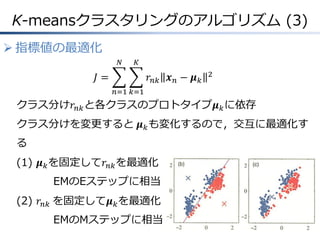
K-meansクラスタリングのアルゴリズム (3) 指標値の最適化 𝑁 𝐾 𝐽= 𝑟
𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 2 𝑛=1 𝑘=1 クラス分け𝑟 𝑛𝑘 と各クラスのプロトタイプ𝝁 𝑘 に依存 クラス分けを変更すると 𝝁 𝑘 も変化するので,交互に最適化す る (1) 𝝁 𝑘 を固定して𝑟 𝑛𝑘 を最適化 EMのEステップに相当 (2) 𝑟 𝑛𝑘 を固定して𝝁 𝑘 を最適化 EMのMステップに相当
7.
K-meansクラスタリングのアルゴリズム (4) (1) 𝝁
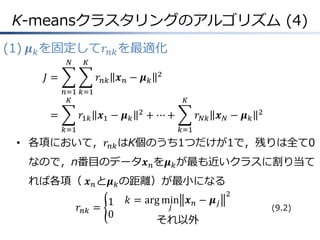
𝑘 を固定して𝑟 𝑛𝑘 を最適化 𝑁 𝐾 𝐽= 𝑟 𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 2 𝑛=1 𝑘=1 𝐾 = 𝐾 𝑟1𝑘 𝒙1 − 𝝁 𝑘 2 + ⋯+ 𝑘=1 𝑟 𝑁𝑘 𝒙 𝑁 − 𝝁 𝑘 2 𝑘=1 • 各項において,𝑟 𝑛𝑘 はK個のうち1つだけが1で,残りは全て0 なので,n番目のデータ𝒙 𝑛 を𝝁 𝑘 が最も近いクラスに割り当て れば各項( 𝒙 𝑛 と𝝁 𝑘 の距離)が最小になる 𝑟 𝑛𝑘 1 = 0 𝑘 = arg min 𝒙 𝑛 − 𝝁 𝑗 𝑗 それ以外 2 (9.2)
8.
K-meansクラスタリングのアルゴリズム (5) (2) 𝑟
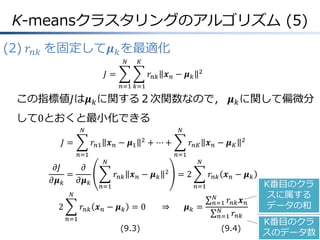
𝑛𝑘 を固定して𝝁 𝑘 を最適化 𝑁 𝐾 𝐽= 𝑟 𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 2 𝑛=1 𝑘=1 この指標値𝐽は𝝁 𝑘 に関する2次関数なので, 𝝁 𝑘 に関して偏微分 して0とおくと最小化できる 𝑁 𝐽= 𝑁 𝑟 𝑛1 𝒙 𝑛 − 𝝁1 𝑛=1 𝜕𝐽 𝜕 = 𝜕𝝁 𝑘 𝜕𝝁 𝑘 2 + ⋯+ 𝑟 𝑛𝐾 𝒙 𝑛 − 𝝁 𝐾 𝑛=1 𝑁 𝑟 𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 2 𝑛=1 𝑁 =2 𝑟 𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 𝑛=1 𝑁 2 2 𝑟 𝑛𝑘 𝒙 𝑛 − 𝝁 𝑘 = 0 𝑛=1 (9.3) ⇒ 𝝁𝑘 = 𝑁 𝑛=1 𝑟 𝑛𝑘 𝒙 𝑛 𝑁 𝑛=1 𝑟 𝑛𝑘 (9.4) K番目のクラ スに属する データの和 K番目のクラ スのデータ数
9.
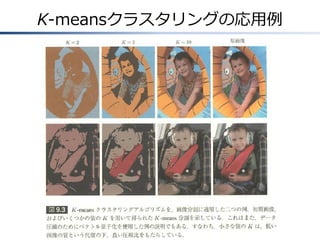
K-meansクラスタリングの応用例
10.
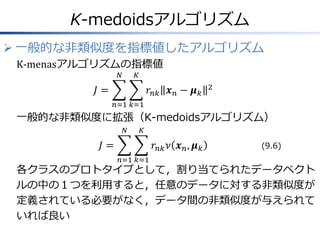
K-medoidsアルゴリズム 一般的な非類似度を指標値したアルゴリズム K-menasアルゴリズムの指標値 𝑁 𝐾 𝐽= 𝑟 𝑛𝑘
𝒙 𝑛 − 𝝁 𝑘 2 𝑛=1 𝑘=1 一般的な非類似度に拡張(K-medoidsアルゴリズム) 𝑁 𝐾 𝐽= 𝑟 𝑛𝑘 𝜈 𝒙 𝑛 , 𝝁 𝑘 𝑛=1 𝑘=1 (9.6) 各クラスのプロトタイプとして,割り当てられたデータベクト ルの中の1つを利用すると,任意のデータに対する非類似度が 定義されている必要がなく,データ間の非類似度が与えられて いれば良い
11.
混合モデルとEMアルゴリズム 「第9章 混合モデルとEM」, C.M.ビショップ, パターン認識と学習(下), シュプリンガー・ジャパン,2007. 9.1 K-meansクラスタリング 9.2
混合ガウス分布(Mixtures of Gaussians) 9.3 EMアルゴリズムのもう一つの解釈 9.4 一般のEMアルゴリズム
12.
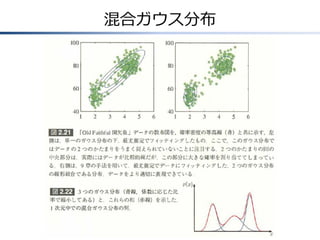
混合ガウス分布
13.
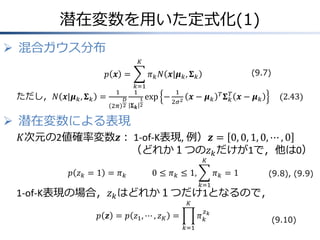
潜在変数を用いた定式化(1) 混合ガウス分布 𝐾 𝑝 𝒙
= ただし,𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 = 𝑘=1 1 1 2𝜋 𝐷 2 (9.7) 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝚺 1 𝒌 2 exp − 1 2 𝒙− 𝝁𝑘 𝑇 𝚺 −1 𝑘 𝒙− 𝝁𝑘 (2.43) 潜在変数による表現 𝐾次元の2値確率変数𝒛: 1-of-K表現, 例)𝒛 = 0, 0, 1, 0, ⋯ , 0 (どれか1つの𝑧 𝑘 だけが1で,他は0) 𝐾 𝑝 𝑧𝑘 = 1 = 𝜋𝑘 0 ≤ 𝜋 𝑘 ≤ 1, 𝜋𝑘 = 1 (9.8), (9.9) 𝑘=1 1-of-K表現の場合,𝑧 𝑘 はどれか1つだけ1となるので, 𝐾 𝑧 𝜋𝑘𝑘 𝑝 𝒛 = 𝑝 𝑧1 , ⋯ , 𝑧 𝐾 = 𝑘=1 (9.10)
14.
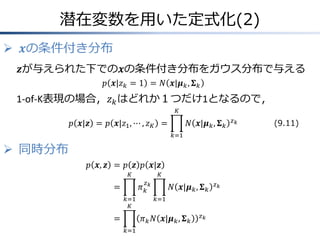
潜在変数を用いた定式化(2) 𝒙の条件付き分布 𝒛が与えられた下での𝒙の条件付き分布をガウス分布で与える 𝑝 𝒙|𝑧
𝑘 = 1 = 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 1-of-K表現の場合,𝑧 𝑘 はどれか1つだけ1となるので, 𝐾 𝑝 𝒙|𝒛 = 𝑝 𝒙|𝑧1 , ⋯ , 𝑧 𝐾 = 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝑘=1 同時分布 𝑝 𝒙, 𝒛 = 𝑝 𝒛 𝑝 𝒙|𝒛 𝐾 𝐾 𝑧 𝜋𝑘𝑘 = 𝑘=1 𝐾 = 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝑘=1 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝑘=1 𝑧𝑘 𝑧𝑘 𝑧𝑘 (9.11)
15.
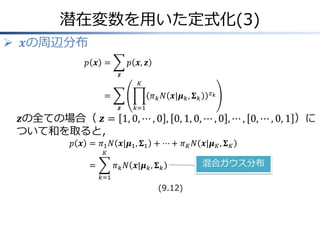
潜在変数を用いた定式化(3) 𝒙の周辺分布 𝑝 𝒙
= 𝑝 𝒙, 𝒛 𝒛 𝐾 = 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝒛 𝑧𝑘 𝑘=1 𝒛の全ての場合( 𝒛 = 1, 0, ⋯ , 0 , 0, 1, 0, ⋯ , 0 , ⋯ , 0, ⋯ , 0, 1 )に ついて和を取ると, 𝑝 𝒙 = 𝜋1 𝑁 𝒙|𝝁1 , 𝚺1 + ⋯ + 𝜋 𝐾 𝑁 𝒙|𝝁 𝐾 , 𝚺 𝐾 𝐾 = 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝑘=1 (9.12) 混合ガウス分布
16.
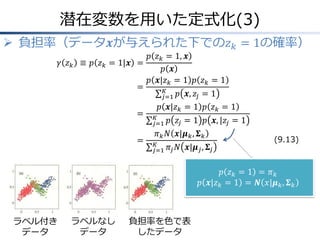
潜在変数を用いた定式化(3) 負担率(データ𝒙が与えられた下での𝑧 𝑘
= 1の確率) 𝛾 𝑧 𝑘 ≡ 𝑝 𝑧 𝑘 = 1|𝒙 = = = = 𝑝 𝑧 𝑘 = 1, 𝒙 𝑝 𝒙 𝑝 𝒙|𝑧 𝑘 = 1 𝑝 𝑧 𝑘 = 1 𝐾 𝑗=1 𝑝 𝒙, 𝑧 𝑗 = 1 𝑝 𝒙|𝑧 𝑘 = 1 𝑝 𝑧 𝑘 = 1 𝐾 𝑗=1 𝑝 𝑧 𝑗 = 1 𝑝 𝒙, |𝑧 𝑗 = 1 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝒙|𝝁 𝑗 , 𝚺 𝑗 (9.13) 𝑝 𝑧𝑘 = 1 = 𝜋𝑘 𝑝 𝒙|𝑧 𝑘 = 1 = 𝑵 𝑥|𝝁 𝑘 , 𝚺 𝑘 ラベル付き データ ラベルなし データ 負担率を色で表 したデータ
17.
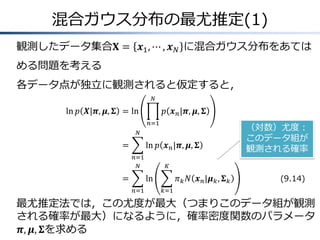
混合ガウス分布の最尤推定(1) 観測したデータ集合𝐗 = 𝒙1
, ⋯ , 𝒙 𝑁 に混合ガウス分布をあては める問題を考える 各データ点が独立に観測されると仮定すると, 𝑁 ln 𝑝 𝑿|𝝅, 𝝁, 𝚺 = ln 𝑝 𝒙 𝑛 |𝝅, 𝝁, 𝚺 𝑛=1 𝑁 = ln 𝑝 𝒙 𝑛 |𝝅, 𝝁, 𝚺 𝑛=1 𝑁 = 𝐾 ln 𝑛=1 (対数)尤度: このデータ組が 観測される確率 𝜋 𝑘 𝑁 𝒙 𝑛 |𝝁 𝑘 , 𝚺 𝑘 (9.14) 𝑘=1 最尤推定法では,この尤度が最大(つまりこのデータ組が観測 される確率が最大)になるように,確率密度関数のパラメータ 𝝅, 𝝁, 𝚺を求める
18.
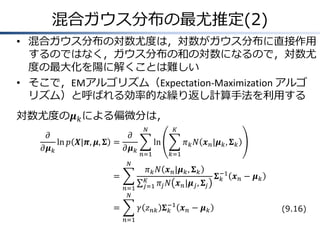
混合ガウス分布の最尤推定(2) • 混合ガウス分布の対数尤度は,対数がガウス分布に直接作用 するのではなく,ガウス分布の和の対数になるので,対数尤 度の最大化を陽に解くことは難しい • そこで,EMアルゴリズム(Expectation-Maximization
アルゴ リズム)と呼ばれる効率的な繰り返し計算手法を利用する 対数尤度の𝝁 𝑘 による偏微分は, 𝜕 𝜕 ln 𝑝 𝑿|𝝅, 𝝁, 𝚺 = 𝜕𝝁 𝑘 𝜕𝝁 𝑘 𝑁 = 𝑛=1 𝑁 𝑁 𝐾 ln 𝑛=1 𝜋 𝑘 𝑁 𝒙 𝑛 |𝝁 𝑘 , 𝚺 𝑘 𝑘=1 𝜋 𝑘 𝑁 𝒙 𝑛 |𝝁 𝑘 , 𝚺 𝑘 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝒙 𝑛 |𝝁 𝑗 , 𝚺 𝑗 𝛾 𝑧 𝑛𝑘 𝚺 −1 𝒙 𝑛 − 𝝁 𝑘 𝑘 = 𝑛=1 𝚺 −1 𝒙 𝑛 − 𝝁 𝑘 𝑘 (9.16)
19.
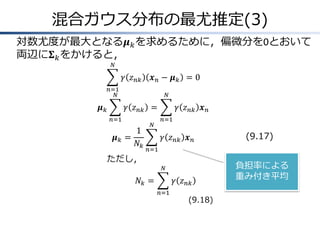
混合ガウス分布の最尤推定(3) 対数尤度が最大となる𝝁 𝑘 を求めるために,偏微分を0とおいて 両辺に𝚺
𝑘 をかけると, 𝑁 𝛾 𝑧 𝑛𝑘 𝒙𝑛− 𝝁𝑘 =0 𝑛=1 𝑁 𝝁𝑘 𝑁 𝛾 𝑧 𝑛𝑘 = 𝑛=1 𝝁𝑘 = 1 𝑁𝑘 ただし, 𝑁 𝛾 𝑧 𝑛𝑘 𝒙 𝑛 𝑛=1 𝛾 𝑧 𝑛𝑘 𝒙 𝑛 (9.17) 𝑛=1 𝑁 𝑁𝑘 = 𝛾 𝑧 𝑛𝑘 𝑛=1 (9.18) 負担率による 重み付き平均
20.
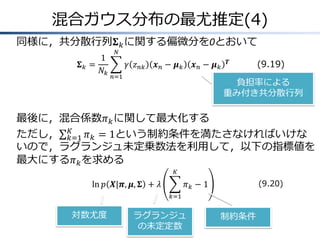
混合ガウス分布の最尤推定(4) 同様に,共分散行列𝚺 𝑘 に関する偏微分を0とおいて 𝚺𝑘
= 1 𝑁𝑘 𝑁 𝛾 𝑧 𝑛𝑘 𝒙𝑛− 𝝁𝑘 𝒙𝑛− 𝝁𝑘 𝑛=1 𝑻 (9.19) 負担率による 重み付き共分散行列 最後に,混合係数𝜋 𝑘 に関して最大化する 𝐾 ただし, 𝑘=1 𝜋 𝑘 = 1という制約条件を満たさなければいけな いので,ラグランジュ未定乗数法を利用して,以下の指標値を 最大にする𝜋 𝑘 を求める 𝐾 ln 𝑝 𝑿|𝝅, 𝝁, 𝚺 + 𝜆 (9.20) 𝜋𝑘 −1 𝑘=1 対数尤度 ラグランジュ の未定定数 制約条件
21.
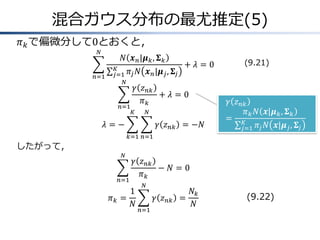
混合ガウス分布の最尤推定(5) 𝜋 𝑘 で偏微分して0とおくと, 𝑁 𝑁
𝒙 𝑛 |𝝁 𝑘 , 𝚺 𝑘 𝑛=1 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝑛=1 𝑁 𝒙 𝑛 |𝝁 𝑗 , 𝚺 𝑗 + 𝜆=0 𝛾 𝑧 𝑛𝑘 + 𝜆=0 𝜋𝑘 𝐾 𝑁 𝜆=− 𝛾 𝑧 𝑛𝑘 = −𝑁 (9.21) 𝛾 𝑧 𝑛𝑘 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 = 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝒙|𝝁 𝑗 , 𝚺 𝑗 𝑘=1 𝑛=1 したがって, 𝑁 𝑛=1 𝜋𝑘 = 𝛾 𝑧 𝑛𝑘 − 𝑁=0 𝜋𝑘 1 𝑁 𝑁 𝛾 𝑧 𝑛𝑘 = 𝑛=1 𝑁𝑘 𝑁 (9.22)
22.
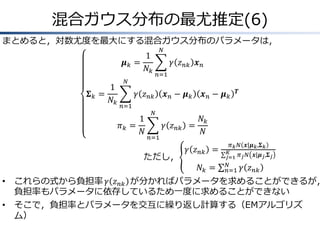
混合ガウス分布の最尤推定(6) まとめると,対数尤度を最大にする混合ガウス分布のパラメータは, 𝑁 1 𝝁𝑘 = 𝑁𝑘 1 𝚺𝑘 = 𝑁𝑘 𝛾
𝑧 𝑛𝑘 𝒙 𝑛 𝑛=1 𝑁 𝛾 𝑧 𝑛𝑘 𝑛=1 1 𝜋𝑘 = 𝑁 𝒙𝑛− 𝝁𝑘 𝑁 𝛾 𝑧 𝑛𝑘 𝑛=1 ただし, 𝒙𝑛− 𝝁𝑘 𝑻 𝑁𝑘 = 𝑁 𝛾 𝑧 𝑛𝑘 = 𝑁𝑘 = 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 ,𝚺 𝑘 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝒙|𝝁 𝑗 ,𝚺 𝑗 𝑁 𝑛=1 𝛾 𝑧 𝑛𝑘 • これらの式から負担率 𝛾 𝑧 𝑛𝑘 が分かればパラメータを求めることができるが, 負担率もパラメータに依存しているため一度に求めることができない • そこで,負担率とパラメータを交互に繰り返し計算する(EMアルゴリズ ム)
23.
混合ガウス分布の最尤推定(7) 混合ガウス分布のためのEMアルゴリズム 1. 平均𝝁 𝑘
,分散𝚺 𝑘 ,混合係数𝜋 𝑘 を初期化する 2. Eステップ:現在のパラメータを使って負担率を計算する 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 (9.23) 𝛾 𝑧 𝑛𝑘 = 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝒙|𝝁 𝑗 , 𝚺 𝑗 3. Mステップ:現在の負担率を使ってパラメータを更新する 𝑁 1 𝝁𝑘 = 𝑁𝑘 1 𝚺𝑘 = 𝑁𝑘 𝛾 𝑧 𝑛𝑘 𝑛=1 (9.24) 𝑛=1 𝑁 1 𝜋𝑘 = 𝑁 4. 𝛾 𝑧 𝑛𝑘 𝒙 𝑛 𝒙𝑛− 𝝁𝑘 𝑁 𝛾 𝑧 𝑛𝑘 𝑛=1 ただし, 𝒙𝑛− 𝝁𝑘 𝑁𝑘 = 𝑁 𝑻 (9.25) (9.26) 𝑁 𝑁𝑘 = 𝛾 𝑧 𝑛𝑘 𝑛=1 (9.27) 収束性を確認し,収束基準を満たしていない場合,2に戻って繰り返 し計算する
24.
混合モデルとEMアルゴリズム 「第9章 混合モデルとEM」, C.M.ビショップ, パターン認識と学習(下), シュプリンガー・ジャパン,2007. 9.1 K-meansクラスタリング 9.2
混合ガウス分布(Mixtures of Gaussians) 9.3 EMアルゴリズムのもう一つの解釈 9.4 一般のEMアルゴリズム
25.
抽象的なEMアルゴリズム表現(1) EMアルゴリズムの目的 潜在変数をもつモデルについて最尤解(尤度が最大となる確率 密度関数のパラメータ)を求めること 𝑿:観測データの集合 𝒁:潜在変数データの集合 𝜽:全ての確率密度関数のパラメータ組 𝑝 𝑿,
𝒁|𝜽 :パラメータ𝜽が与えられた下でのデータ組 𝑿, 𝒁 の尤度 対数尤度関数 ln 𝑝 𝑿|𝜽 = ln 𝑝 𝑿, 𝒁|𝜽 𝒁 (9.29) 尤度の和の対数と なっているので,ガ ウス分布のような指 数型分布族の場合で も計算が簡単になら ない
26.
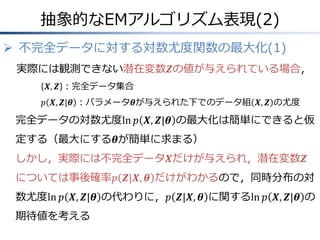
抽象的なEMアルゴリズム表現(2) 不完全データに対する対数尤度関数の最大化(1) 実際には観測できない潜在変数𝒁の値が与えられている場合, 𝑿, 𝒁
:完全データ集合 𝑝 𝑿, 𝒁|𝜽 :パラメータ𝜽が与えられた下でのデータ組 𝑿, 𝒁 の尤度 完全データの対数尤度ln 𝑝 𝑿, 𝒁|𝜽 の最大化は簡単にできると仮 定する(最大にする𝜽が簡単に求まる) しかし,実際には不完全データ𝑿だけが与えられ,潜在変数𝒁 については事後確率𝑝 𝒁|𝑿, 𝜽 だけがわかるので,同時分布の対 数尤度ln 𝑝 𝑿, 𝒁|𝜽 の代わりに,𝑝 𝒁|𝑿, 𝜽 に関するln 𝑝 𝑿, 𝒁|𝜽 の 期待値を考える
27.
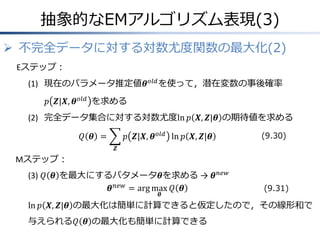
抽象的なEMアルゴリズム表現(3) 不完全データに対する対数尤度関数の最大化(2) Eステップ: (1) 現在のパラメータ推定値𝜽
𝑜𝑙𝑑 を使って,潜在変数の事後確率 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 を求める (2) 完全データ集合に対する対数尤度ln 𝑝 𝑿, 𝒁|𝜽 の期待値を求める 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 ln 𝑝 𝑿, 𝒁|𝜽 𝑄 𝜽 = (9.30) 𝒁 Mステップ: (3) 𝑄 𝜽 を最大にするパタメータ𝜽を求める → 𝜽 𝑛𝑒𝑤 𝜽 𝑛𝑒𝑤 = arg max 𝑄 𝜽 𝜽 (9.31) ln 𝑝 𝑿, 𝒁|𝜽 の最大化は簡単に計算できると仮定したので,その線形和で 与えられる𝑄 𝜽 の最大化も簡単に計算できる
28.
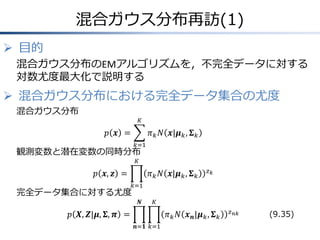
混合ガウス分布再訪(1) 目的 混合ガウス分布のEMアルゴリズムを,不完全データに対する 対数尤度最大化で説明する 混合ガウス分布における完全データ集合の尤度 混合ガウス分布 𝐾 𝑝
𝒙 = 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝑘=1 観測変数と潜在変数の同時分布 𝐾 𝑝 𝒙, 𝒛 = 完全データ集合に対する尤度 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝑧𝑘 𝑘=1 𝑵 𝐾 𝑝 𝑿, 𝒁|𝝁, 𝚺, 𝝅 = 𝜋 𝑘 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝒏=𝟏 𝑘=1 𝑧 𝑛𝑘 (9.35)
29.
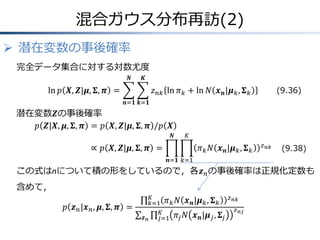
混合ガウス分布再訪(2) 潜在変数の事後確率 完全データ集合に対する対数尤度 𝑵 𝑲 ln 𝑝
𝑿, 𝒁|𝝁, 𝚺, 𝝅 = (9.36) 𝑧 𝑛𝑘 ln 𝜋 𝑘 + ln 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝒏=𝟏 𝒌=𝟏 潜在変数𝒁の事後確率 𝑝 𝒁|𝑿, 𝝁, 𝚺, 𝝅 = 𝑝 𝑿, 𝒁|𝝁, 𝚺, 𝝅 /𝑝 𝑿 𝑵 𝐾 ∝ 𝑝 𝑿, 𝒁|𝝁, 𝚺, 𝝅 = 𝜋 𝑘 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝑧 𝑛𝑘 (9.38) 𝒏=𝟏 𝑘=1 この式はnについて積の形をしているので,各𝒛 𝑛 の事後確率は正規化定数も 含めて, 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 = 𝐾 𝑘=1 𝜋 𝑘 𝑁 𝐾 𝒛𝑛 𝑗=1 𝜋 𝑗 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝑁 𝒙 𝒏 |𝝁 𝑗 , 𝚺 𝑗 𝑧 𝑛𝑘 𝑧 𝑛𝑗
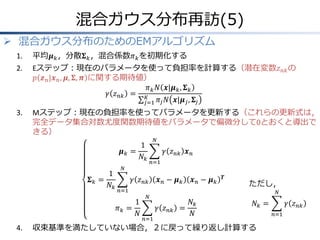
30.
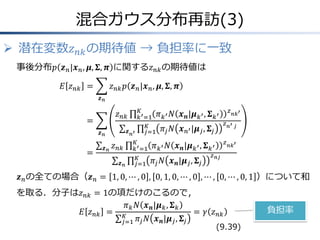
混合ガウス分布再訪(3) 潜在変数𝑧 𝑛𝑘
の期待値 → 負担率に一致 事後分布𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 に関する𝑧 𝑛𝑘 の期待値は 𝐸 𝑧 𝑛𝑘 = 𝑧 𝑛𝑘 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 𝒛𝑛 𝐾 𝑘 ′ =1 𝐾 𝒛 𝑛′ 𝑗=1 𝑧 𝑛𝑘 = 𝒛𝑛 = 𝒛𝑛 𝑧 𝑛𝑘 𝒛𝑛 𝐾 𝑘 ′ =1 𝐾 𝑗=1 𝜋 𝑘 ′ 𝑁 𝒙 𝒏 |𝝁 𝑘 ′ , 𝚺 𝑘 ′ 𝜋 𝑗 𝑁 𝒙 𝑛′ |𝝁 𝑗 , 𝚺 𝑗 𝑧 𝑛′ 𝑗 𝑧 𝑛𝑘′ 𝜋 𝑘 ′ 𝑁 𝒙 𝒏 |𝝁 𝑘 ′ , 𝚺 𝑘 ′ 𝜋 𝑗 𝑁 𝒙 𝒏 |𝝁 𝑗 , 𝚺 𝑗 𝑧 𝑛𝑘′ 𝑧 𝑛𝑗 𝒛 𝑛 の全ての場合(𝒛 𝑛 = 1, 0, ⋯ , 0 , 0, 1, 0, ⋯ , 0 , ⋯ , 0, ⋯ , 0, 1 )について和 を取る.分子は𝑧 𝑛𝑘 = 1の項だけのこるので, 𝜋 𝑘 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝐸 𝑧 𝑛𝑘 = 𝐾 = 𝛾 𝑧 𝑛𝑘 𝑗=1 𝜋 𝑗 𝑁 𝒙 𝒏 |𝝁 𝑗 , 𝚺 𝑗 (9.39) 負担率
31.
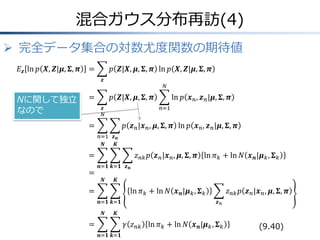
混合ガウス分布再訪(4) 完全データ集合の対数尤度関数の期待値 𝐸 𝒛
ln 𝑝 𝑿, 𝒁|𝝁, 𝚺, 𝝅 = 𝑝 𝒁|𝑿, 𝝁, 𝚺, 𝝅 ln 𝑝 𝑿, 𝒁|𝝁, 𝚺, 𝝅 𝒛 Nに関して独立 なので = 𝑁 𝑝 𝒁|𝑿, 𝝁, 𝚺, 𝝅 𝒛 𝑁 ln 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝝁, 𝚺, 𝝅 𝑛=1 = 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 ln 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝝁, 𝚺, 𝝅 𝑛=1 𝒛 𝒏 𝑵 𝑲 = = 𝑧 𝑛𝑘 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 ln 𝜋 𝑘 + ln 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝒏=𝟏 𝒌=𝟏 𝒛 𝒏 𝑵 𝑲 = ln 𝜋 𝑘 + ln 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝒏=𝟏 𝒌=𝟏 𝑵 𝑧 𝑛𝑘 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 𝒛𝑛 𝑲 = 𝛾 𝑧 𝑛𝑘 ln 𝜋 𝑘 + ln 𝑁 𝒙 𝒏 |𝝁 𝑘 , 𝚺 𝑘 𝒏=𝟏 𝒌=𝟏 (9.40)
32.
混合ガウス分布再訪(5) 混合ガウス分布のためのEMアルゴリズム 1. 平均𝝁 𝑘
,分散𝚺 𝑘 ,混合係数𝜋 𝑘 を初期化する 2. Eステップ:現在のパラメータを使って負担率を計算する(潜在変数𝑧 𝑛𝑘 の 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝚺, 𝝅 に関する期待値) 𝜋 𝑘 𝑁 𝒙|𝝁 𝑘 , 𝚺 𝑘 𝛾 𝑧 𝑛𝑘 = 𝐾 𝑗=1 𝜋 𝑗 𝑁 𝒙|𝝁 𝑗 , 𝚺 𝑗 3. Mステップ:現在の負担率を使ってパラメータを更新する(これらの更新式は, 完全データ集合対数尤度関数期待値をパラメータで偏微分して0とおくと導出で きる) 𝝁𝑘 = 𝚺𝑘 = 1 𝑁𝑘 1 𝑁𝑘 𝛾 𝑧 𝑛𝑘 𝒙 𝑛 𝑛=1 𝑁 𝛾 𝑧 𝑛𝑘 𝑛=1 𝜋𝑘 = 4. 𝑁 1 𝑁 𝒙𝑛− 𝝁𝑘 𝑻 ただし, 𝑁 𝑁 𝛾 𝑧 𝑛𝑘 = 𝑛=1 𝒙𝑛− 𝝁𝑘 𝑁𝑘 𝑁 𝑁𝑘 = 収束基準を満たしていない場合,2に戻って繰り返し計算する 𝛾 𝑧 𝑛𝑘 𝑛=1
33.
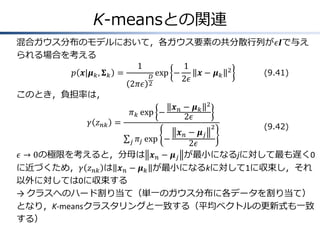
K-meansとの関連 混合ガウス分布のモデルにおいて,各ガウス要素の共分散行列が𝜖𝑰で与え られる場合を考える 1 1 𝑝 𝒙|𝝁 𝑘
, 𝚺 𝑘 = exp − 𝒙− 𝝁𝑘 2 (9.41) 𝐷 2𝜖 2𝜋𝜖 2 このとき,負担率は, 𝒙𝑛− 𝝁𝑘 2 𝜋 𝑘 exp − 2𝜖 𝛾 𝑧 𝑛𝑘 = 2 (9.42) 𝒙 𝑛 − 𝝁𝑗 𝜋 𝑗 exp − 𝑗 2𝜖 𝜖 → 0の極限を考えると,分母は 𝒙 𝑛 − 𝝁 𝑗 が最小になるjに対して最も遅く0 に近づくため,𝛾 𝑧 𝑛𝑘 は 𝒙 𝑛 − 𝝁 𝑘 が最小になるkに対して1に収束し,それ 以外に対しては0に収束する → クラスへのハード割り当て(単一のガウス分布に各データを割り当て) となり,K-meansクラスタリングと一致する(平均ベクトルの更新式も一致 する)
34.
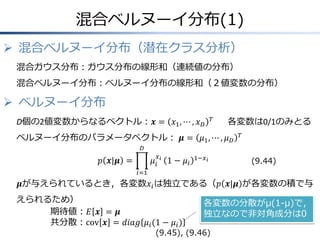
混合ベルヌーイ分布(1) 混合ベルヌーイ分布(潜在クラス分析) 混合ガウス分布:ガウス分布の線形和(連続値の分布) 混合ベルヌーイ分布:ベルヌーイ分布の線形和(2値変数の分布) ベルヌーイ分布 D個の2値変数からなるベクトル:𝒙
= 𝑥1 , ⋯ , 𝑥 𝐷 𝑇 各変数は0/1のみとる ベルヌーイ分布のパラメータベクトル: 𝝁 = 𝜇1 , ⋯ , 𝜇 𝐷 𝑇 𝐷 𝑝 𝒙|𝝁 = 𝜇𝑖 𝑥𝑖 1 − 𝜇𝑖 1−𝑥 𝑖 (9.44) 𝑖=1 𝝁が与えられているとき,各変数𝑥 𝑖 は独立である(𝑝 𝒙|𝝁 が各変数の積で与 えられるため) 期待値:𝐸 𝒙 = 𝝁 共分散:cov 𝒙 = 𝑑𝑖𝑎𝑔 𝜇 𝑖 (1 − 𝜇 𝑖 ) 各変数の分散がμ(1-μ)で, 独立なので非対角成分は0 (9.45), (9.46)
35.
混合ベルヌーイ分布(2) 混合ベルヌーイ分布(潜在クラス分析) ベルヌーイ分布の有限混合分布 𝐾 𝑝 𝒙|𝝁,
𝝅 = 𝐾 𝐷 𝜋 𝑘 𝑝 𝒙|𝝁 𝑘 = 𝑘=1 𝑥 𝜇 𝑘𝑖𝑖 1 − 𝜇 𝑘𝑖 𝜋𝑘 𝑘=1 1−𝑥 𝑖 (9.47) 𝑖=1 混合分布の期待値と分散は, 𝐾 𝑘=1 期待値:𝐸 𝒙 = 共分散:cov 𝒙 = (9.49) 𝝅𝑘 𝝁𝑘 𝐾 𝑘=1 𝑇 𝝅 𝑘 𝚺 𝑘 + 𝝁 𝑘 𝝁 𝑘 − 𝐸 𝒙 𝐸 𝒙 𝑇] (9.50) 対数尤度関数 𝑁 ln 𝑝 𝑿|𝝁, 𝝅 = 𝐾 ln 𝑛=1 𝜋 𝑘 𝑝 𝒙|𝝁 𝑘 𝑘=1 対数の中に和の形が現れ,最尤解を陽の形で求められない →EMアルゴリズムで解く (9.51)
36.
混合ベルヌーイ分布(3) 潜在変数による表現 𝐾次元の2値確率変数𝒛 =
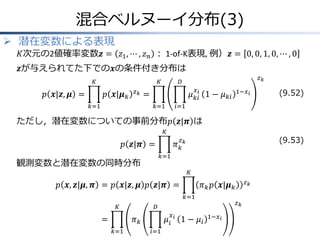
𝑧1 , ⋯ , 𝑧 𝑛 : 1-of-K表現, 例)𝒛 = 0, 0, 1, 0, ⋯ , 0 𝒛が与えられてた下での𝒙の条件付き分布は 𝐾 𝑝 𝒙|𝒛, 𝝁 = 𝐾 𝑝 𝒙|𝝁 𝑘 𝑧𝑘 𝑘=1 𝑧𝑘 𝐷 𝑥 𝜇 𝑘𝑖𝑖 1 − 𝜇 𝑘𝑖 = 𝑘=1 1−𝑥 𝑖 (9.52) 𝑖=1 ただし,潜在変数についての事前分布𝑝 𝒛|𝝅 は 𝐾 (9.53) 𝑧 𝜋𝑘𝑘 𝑝 𝒛|𝝅 = 𝑘=1 観測変数と潜在変数の同時分布 𝐾 𝑝 𝒙, 𝒛|𝝁, 𝝅 = 𝑝 𝒙|𝒛, 𝝁 𝑝 𝒛|𝝅 = 𝑘=1 𝐾 = 𝑘=1 𝑧𝑘 𝐷 𝜋𝑘 𝜇𝑖 𝑖=1 𝑥𝑖 𝑧𝑘 𝜋 𝑘 𝑝 𝒙|𝝁 𝑘 1 − 𝜇𝑖 1−𝑥 𝑖
37.
混合ベルヌーイ分布(4) 完全データ集合に対する対数尤度関数 したがって,完全データ集合に対する対数尤度関数は, 𝑁 ln 𝑝
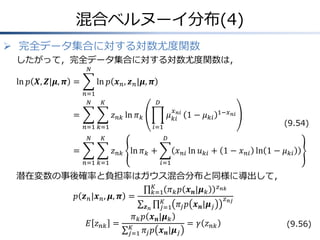
𝑿, 𝒁|𝝁, 𝝅 = ln 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝝁, 𝝅 𝑛=1 𝑁 𝐾 = 𝐷 𝑥 𝜇 𝑘𝑖𝑛𝑖 1 − 𝜇 𝑘𝑖 𝑧 𝑛𝑘 ln 𝜋 𝑘 𝑛=1 𝑘=1 𝑁 𝑖=1 𝐾 = (9.54) 𝐷 𝑧 𝑛𝑘 ln 𝜋 𝑘 + 𝑛=1 𝑘=1 1−𝑥 𝑛𝑖 𝑥 𝑛𝑖 ln 𝑢 𝑘𝑖 + 1 − 𝑥 𝑛𝑖 ln 1 − 𝜇 𝑘𝑖 𝑖=1 潜在変数の事後確率と負担率はガウス混合分布と同様に導出して, 𝐾 𝑧 𝑛𝑘 𝑘=1 𝜋 𝑘 𝑝 𝒙 𝒏 |𝝁 𝑘 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝝁, 𝝅 = 𝑧 𝑛𝑗 𝐾 𝜋 𝑗 𝑝 𝒙 𝒏 |𝝁 𝑗 𝒛𝑛 𝑗=1 𝜋 𝑘 𝑝 𝒙 𝒏 |𝝁 𝑘 𝐸 𝑧 𝑛𝑘 = 𝐾 = 𝛾 𝑧 𝑛𝑘 (9.56) 𝑗=1 𝜋 𝑗 𝑝 𝒙 𝒏 |𝝁 𝑗
38.
混合ベルヌーイ分布(5) 潜在変数の事後確率に関する完全データ集合対数尤度関数の 期待値 𝐸 𝒁
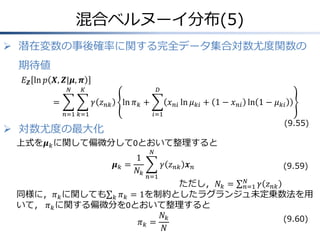
ln 𝑝 𝑿, 𝒁|𝝁, 𝝅 𝑁 𝐾 = 𝐷 𝛾 𝑧 𝑛𝑘 ln 𝜋 𝑘 + 𝑛=1 𝑘=1 𝑥 𝑛𝑖 ln 𝜇 𝑘𝑖 + 1 − 𝑥 𝑛𝑖 ln 1 − 𝜇 𝑘𝑖 𝑖=1 対数尤度の最大化 (9.55) 上式を𝝁 𝑘 に関して偏微分して0とおいて整理すると 1 𝝁𝑘 = 𝑁𝑘 𝑁 𝛾 𝑧 𝑛𝑘 𝒙 𝑛 𝑛=1 (9.59) 𝑁 ただし,𝑁 𝑘 = 𝑛=1 𝛾 𝑧 𝑛𝑘 同様に,𝜋 𝑘 に関しても 𝑘 𝜋 𝑘 = 1を制約としたラグランジュ未定乗数法を用 いて, 𝜋 𝑘 に関する偏微分を0とおいて整理すると 𝑁𝑘 (9.60) 𝜋𝑘 = 𝑁
39.
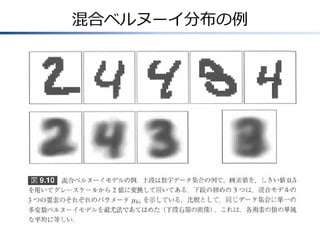
混合ベルヌーイ分布の例
40.
混合モデルとEMアルゴリズム 「第9章 混合モデルとEM」, C.M.ビショップ, パターン認識と学習(下), シュプリンガー・ジャパン,2007. 9.1 K-meansクラスタリング 9.2
混合ガウス分布(Mixtures of Gaussians) 9.3 EMアルゴリズムのもう一つの解釈 9.4 一般のEMアルゴリズム
41.
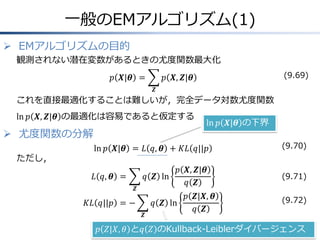
一般のEMアルゴリズム(1) EMアルゴリズムの目的 観測されない潜在変数があるときの尤度関数最大化 𝑝 𝑿|𝜽
= (9.69) 𝑝 𝑿, 𝒁|𝜽 𝒁 これを直接最適化することは難しいが,完全データ対数尤度関数 ln 𝑝 𝑿, 𝒁|𝜽 の最適化は容易であると仮定する 尤度関数の分解 ただし, ln 𝑝 𝑿|𝜽 の下界 ln 𝑝 𝑿|𝜽 = 𝐿 𝑞, 𝜽 + 𝐾𝐿 𝑞||𝑝 (9.70) 𝑝 𝑿, 𝒁|𝜽 𝑞 𝒁 (9.71) 𝐿 𝑞, 𝜽 = 𝑞 𝒁 ln 𝒁 𝐾𝐿 𝑞||𝑝 = − 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑞 𝒁 ln 𝑞 𝒁 (9.72) 𝑝 𝑍|𝑋, 𝜃 と𝑞 𝑍 のKullback-Leiblerダイバージェンス
42.
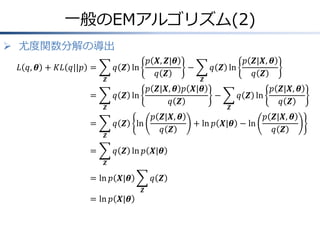
一般のEMアルゴリズム(2) 尤度関数分解の導出 𝐿 𝑞,
𝜽 + 𝐾𝐿 𝑞||𝑝 = 𝒁 = 𝒁 = 𝑝 𝑿, 𝒁|𝜽 𝑞 𝒁 ln 𝑞 𝒁 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑝 𝑿|𝜽 𝑞 𝒁 ln 𝑞 𝒁 𝑞 𝒁 ln 𝒁 = − 𝑝 𝒁|𝑿, 𝜽 𝑞 𝒁 𝑞 𝒁 ln 𝑝 𝑿|𝜽 𝒁 = ln 𝑝 𝑿|𝜽 = ln 𝑝 𝑿|𝜽 𝑞 𝒁 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑞 𝒁 ln 𝑞 𝒁 − 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑞 𝒁 ln 𝑞 𝒁 + ln 𝑝 𝑿|𝜽 − ln 𝑝 𝒁|𝑿, 𝜽 𝑞 𝒁
43.
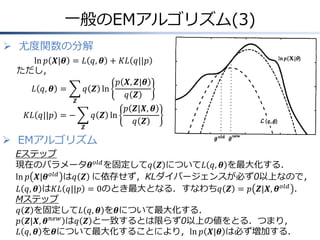
一般のEMアルゴリズム(3) 尤度関数の分解 ln 𝑝
𝑿|𝜽 = 𝐿 𝑞, 𝜽 + 𝐾𝐿 𝑞||𝑝 ただし, 𝑝 𝑿, 𝒁|𝜽 𝐿 𝑞, 𝜽 = 𝑞 𝒁 ln 𝑞 𝒁 𝒁 𝐾𝐿 𝑞||𝑝 = − 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑞 𝒁 ln 𝑞 𝒁 EMアルゴリズム Eステップ 現在のパラメータ𝜽 𝑜𝑙𝑑 を固定して𝑞 𝒁 について𝐿 𝑞, 𝜽 を最大化する. ln 𝑝 𝑿|𝜽 𝑜𝑙𝑑 は𝑞 𝒁 に依存せず,KLダイバージェンスが必ず0以上なので, 𝐿 𝑞, 𝜽 は𝐾𝐿 𝑞||𝑝 = 0のとき最大となる.すなわち𝑞 𝒁 = 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 . Mステップ 𝑞 𝒁 を固定して𝐿 𝑞, 𝜽 を𝜽について最大化する. 𝑝 𝒁|𝑿, 𝜽 𝑛𝑒𝑤 は𝑞 𝒁 と一致するとは限らず0以上の値をとる.つまり, 𝐿 𝑞, 𝜽 を𝜽について最大化することにより,ln 𝑝 𝑿|𝜽 は必ず増加する.
44.
一般のEMアルゴリズム(4) Mステップにおける𝐿 𝑞,
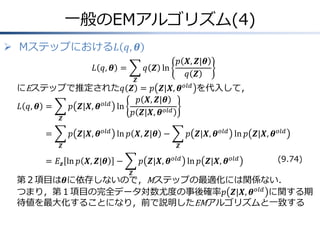
𝜽 𝐿 𝑞, 𝜽 = 𝒁 𝑝 𝑿, 𝒁|𝜽 𝑞 𝒁 ln 𝑞 𝒁 にEステップで推定された𝑞 𝒁 = 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 を代入して, 𝑝 𝑿, 𝒁|𝜽 𝑜𝑙𝑑 ln 𝐿 𝑞, 𝜽 = 𝑝 𝒁|𝑿, 𝜽 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 ln 𝑝 𝑿, 𝒁|𝜽 − = 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 ln 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 𝒁 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 ln 𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 = 𝐸 𝒛 ln 𝑝 𝑿, 𝒁|𝜽 − 𝒁 (9.74) 第2項目は𝜽に依存しないので,Mステップの最適化には関係ない. つまり,第1項目の完全データ対数尤度の事後確率𝑝 𝒁|𝑿, 𝜽 𝑜𝑙𝑑 に関する期 待値を最大化することになり,前で説明したEMアルゴリズムと一致する
45.
一般のEMアルゴリズム(5) Eステップにおける計算される事後確率 データ集合が独立同分布(i.i.d.)から得られている場合は, 𝑝 𝑿,
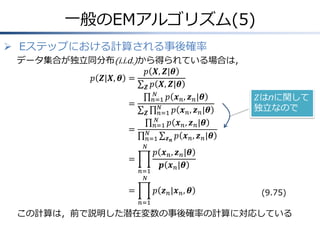
𝒁|𝜽 𝑝 𝒁|𝑿, 𝜽 = 𝒁 𝑝 𝑿, 𝒁|𝜽 𝑁 𝑛=1 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝜽 = 𝑁 𝑛=1 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝜽 𝒁 𝑁 𝑛=1 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝜽 = 𝑁 𝑛=1 𝒛 𝒏 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝜽 𝑁 = 𝑛=1 𝑁 = 𝑍はnに関して 独立なので 𝑝 𝒙 𝑛 , 𝒛 𝑛 |𝜽 𝒑 𝒙 𝑛 |𝜽 𝑝 𝒛 𝑛 |𝒙 𝑛 , 𝜽 (9.75) 𝑛=1 この計算は,前で説明した潜在変数の事後確率の計算に対応している
46.
まとめ 「第9章 混合モデルとEM」, C.M.ビショップ, パターン認識と学習(下), シュプリンガー・ジャパン,2007. • 混合ガウス分布に代表される潜在変数のモデルを説明した •
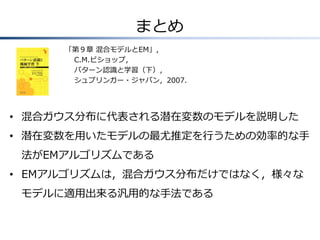
潜在変数を用いたモデルの最尤推定を行うための効率的な手 法がEMアルゴリズムである • EMアルゴリズムは,混合ガウス分布だけではなく,様々な モデルに適用出来る汎用的な手法である

 Most read
 Most read


![混合ベルヌーイ分布(2)
混合ベルヌーイ分布(潜在クラス分析)
ベルヌーイ分布の有限混合分布
𝐾
𝑝 𝒙|𝝁, 𝝅 =
𝐾
𝐷
𝜋 𝑘 𝑝 𝒙|𝝁 𝑘 =
𝑘=1
𝑥
𝜇 𝑘𝑖𝑖 1 − 𝜇 𝑘𝑖
𝜋𝑘
𝑘=1
1−𝑥 𝑖
(9.47)
𝑖=1
混合分布の期待値と分散は,
𝐾
𝑘=1
期待値:𝐸 𝒙 =
共分散:cov 𝒙 =
(9.49)
𝝅𝑘 𝝁𝑘
𝐾
𝑘=1
𝑇
𝝅 𝑘 𝚺 𝑘 + 𝝁 𝑘 𝝁 𝑘 − 𝐸 𝒙 𝐸 𝒙 𝑇]
(9.50)
対数尤度関数
𝑁
ln 𝑝 𝑿|𝝁, 𝝅 =
𝐾
ln
𝑛=1
𝜋 𝑘 𝑝 𝒙|𝝁 𝑘
𝑘=1
対数の中に和の形が現れ,最尤解を陽の形で求められない
→EMアルゴリズムで解く
(9.51)](https://image.slidesharecdn.com/20131113em-131115041121-phpapp02/85/EM-PRML-35-320.jpg)