Skip to main content
Recommended
PDF
PDF
PDF
Infer net wk77_110613-1523
PDF
PDF
Seminar on Quantum Computation & Quantum Information part19
PDF
PDF
PDF
Stochastic complexities of reduced rank regression証明概略
PDF
PDF
2014年度春学期 画像情報処理 第14回 逆投影法による再構成 (2014. 7. 23)
PDF
PDF
2021年度秋学期 画像情報処理 第10回 Radon変換と投影定理 (2021. 11. 19)
PDF
PDF
PDF
PDF
2018年度秋学期 画像情報処理 第11回 逆投影法による再構成 (2018. 12. 21)
PDF
introductino to persistent homology and topological data analysis
PDF
Introduction to Categorical Programming
PDF
2021年度秋学期 画像情報処理 第11回 逆投影法による再構成 (2021. 12. 3)
PDF
AtCoder Regular Contest 043 解説
PDF
Cvim tutorial2 03_06_wk77_110220-0546
PDF
Introduction to Categorical Programming (Revised)
PDF
PDF
半正定値計画問題と最大カット Sedemifinite Programming and Approximation Algorithm for Maxcu...
PDF
PDF
PDF
PDF
PPT
PDF
生物統計特論6資料 2006 abc法(bootstrap) isseing333
More Related Content
PDF
PDF
PDF
Infer net wk77_110613-1523
PDF
PDF
Seminar on Quantum Computation & Quantum Information part19
PDF
PDF
PDF
Stochastic complexities of reduced rank regression証明概略
What's hot
PDF
PDF
2014年度春学期 画像情報処理 第14回 逆投影法による再構成 (2014. 7. 23)
PDF
PDF
2021年度秋学期 画像情報処理 第10回 Radon変換と投影定理 (2021. 11. 19)
PDF
PDF
PDF
PDF
2018年度秋学期 画像情報処理 第11回 逆投影法による再構成 (2018. 12. 21)
PDF
introductino to persistent homology and topological data analysis
PDF
Introduction to Categorical Programming
PDF
2021年度秋学期 画像情報処理 第11回 逆投影法による再構成 (2021. 12. 3)
PDF
AtCoder Regular Contest 043 解説
PDF
Cvim tutorial2 03_06_wk77_110220-0546
PDF
Introduction to Categorical Programming (Revised)
PDF
PDF
半正定値計画問題と最大カット Sedemifinite Programming and Approximation Algorithm for Maxcu...
PDF
PDF
PDF
PDF
Similar to 研究室内PRML勉強会 8章1節
PPT
PDF
生物統計特論6資料 2006 abc法(bootstrap) isseing333
KEY
第5章 統計的仮説検定 (Rによるやさしい統計学)
PPT
PPT
PPT
PDF
PDF
PDF
Similarity functions in Lucene 4.0
PDF
PDF
PDF
PDF
PDF
PPTX
PPT
PDF
PRML 10.3, 10.4 (Pattern Recognition and Machine Learning)
PDF
PDF
Introduction to the particle filter
PDF
More from Koji Matsuda
PPTX
Reading Wikipedia to Answer Open-Domain Questions (ACL2017) and more...
PPTX
KB + Text => Great KB な論文を多読してみた
PPTX
Large-Scale Information Extraction from Textual Definitions �through Deep Syn...
PPTX
PDF
「今日から使い切る」�ための GNU Parallel�による並列処理入門
PDF
PPTX
Entity linking meets Word Sense Disambiguation: a unified approach(TACL 2014)の紹介
PDF
いまさら聞けない “モデル” の話 @DSIRNLP#5
PDF
Practical recommendations for gradient-based training of deep architectures
PDF
Align, Disambiguate and Walk : A Unified Approach forMeasuring Semantic Simil...
PDF
Joint Modeling of a Matrix with Associated Text via Latent Binary Features
PPTX
Vanishing Component Analysis
PDF
A Machine Learning Framework for Programming by Example
PDF
Information-Theoretic Metric Learning
PDF
Unified Expectation Maximization
PDF
Language Models as Representations for Weakly-Supervised NLP Tasks (CoNLL2011)
PDF
PDF
Word Sense Induction & Disambiguaon Using Hierarchical Random Graphs (EMNLP2010)
PPTX
Approximate Scalable Bounded Space Sketch for Large Data NLP
研究室内PRML勉強会 8章1節 1. 2. 2
Agenda
• グラフィカルモデル概論
• ベイジアンネットワーク
• グラフィカルモデル記述のルールについて
• 多項式曲線フィッティング
• 1章でみた多項式フィッティングをグラフィカルモデルで表
してみる
• (ここまで分かればたぶんOKです)
• 生成モデル
• 離散変数
• 複雑なモデルにおけるパラメータ数について
• 線形ガウスモデル
• 今日は省略
3. 3
グラフィカルモデル概論
• 確率モデルをグラフで表すことは有用
• 構造を可視化できる
• グラフの構造から、モデルの性質を調べることができ
る
• (HMMなどの)複雑なモデルにおける学習や推論を、
グラフ上の操作として表現できる
• グラフとは?
• ノード(node, vertex)
• 確率変数 もしくは確率変数の集合
• リンク(link, edge, arc)
• 確率変数間の関係
• の組
4. 5. 5
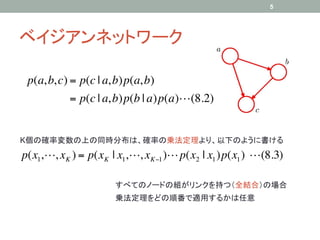
ベイジアンネットワーク
p(a, b, c) = p(c | a, b)p(a, b)
= p(c | a, b)p(b | a)p(a)!(8.2)
K個の確率変数の上の同時分布は、確率の乗法定理より、以下のように書ける
p(x1,!, xK ) = p(xK | x1,!, xK!1 )! p(x2 | x1 )p(x1 ) !(8.3)
すべてのノードの組がリンクを持つ(全結合)の場合
乗法定理をどの順番で適用するかは任意
6. 6
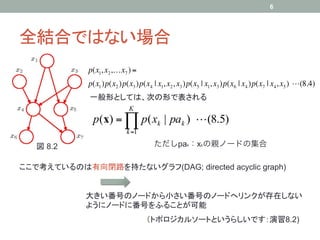
全結合ではない場合
p(x1, x2 ,…x7 ) =
p(x1 )p(x2 )p(x3 )p(x4 | x1, x2 , x3 )p(x5 | x1, x3 )p(x6 | x4 )p(x7 | x4 , x5 ) !(8.4)
一般形としては、次の形で表される
K
p(x) = ∏ p( xk | pak ) (8.5)
k =1
図 8.2
ただしpak:xkの親ノードの集合
ここで考えているのは有向閉路を持たないグラフ(DAG; directed acyclic graph)
大きい番号のノードから小さい番号のノードへリンクが存在しない
ようにノードに番号をふることが可能
(トポロジカルソートというらしいです:演習8.2)
7. 7
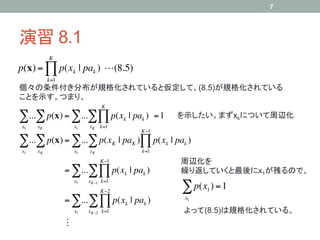
演習 8.1
K
p(x) = ! p(xk | pak ) !(8.5)
k=1
個々の条件付き分布が規格化されていると仮定して、(8.5)が規格化されている
ことを示す。つまり、
K
!...! p(x) = !...!" p(x k | pak ) = 1 を示したい。まずxkについて周辺化
x1 xK x1 xK k=1
K"1
!...! p(x) = !...! p(x K | paK )# p(xk | pak )
x1 xK x1 xK k=1
K"1 周辺化を
= !...! # p(xk | pak ) 繰り返していくと最後にx1が残るので、
x1 xK"1 k=1
K"2 ! p(x ) = 1
1
= !... ! # p(xk | pak ) x1
x1 xK"2 k=1 よって(8.5)は規格化されている。
!
8. 8
a
b
c
p(a,b,c)
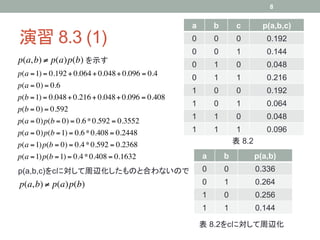
演習 8.3 (1)
0
0
0
0.192
0
0
1
0.144
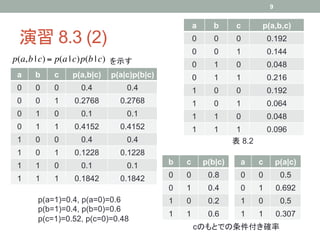
p(a, b) ! p(a)p(b) を示す
0
1
0
0.048
p(a = 1) = 0.192 + 0.064 + 0.048 + 0.096 = 0.4
0
1
1
0.216
p(a = 0) = 0.6
1
0
0
0.192
p(b = 1) = 0.048 + 0.216 + 0.048 + 0.096 = 0.408
1
0
1
0.064
p(b = 0) = 0.592
1
1
0
0.048
p(a = 0)p(b = 0) = 0.6 * 0.592 = 0.3552
p(a = 0)p(b = 1) = 0.6 * 0.408 = 0.2448 1
1
1
0.096
p(a = 1)p(b = 0) = 0.4 * 0.592 = 0.2368 表 8.2
p(a = 1)p(b = 1) = 0.4 * 0.408 = 0.1632 a
b
p(a,b)
p(a,b,c)をcに対して周辺化したものと合わないので
0
0
0.336
p(a, b) ! p(a)p(b) 0
1
0.264
1
0
0.256
1
1
0.144
表 8.2をcに対して周辺化
9. 9
a
b
c
p(a,b,c)
演習 8.3 (2)
0
0
0
0.192
0
0
1
0.144
p(a, b | c) = p(a | c)p(b | c) を示す
0
1
0
0.048
a
b
c
p(a,b|c)
p(a|c)p(b|c)
0
1
1
0.216
0
0
0
0.4
0.4 1
0
0
0.192
0
0
1
0.2768
0.2768
1
0
1
0.064
0
1
0
0.1
0.1
1
1
0
0.048
0
1
1
0.4152
0.4152
1
1
1
0.096
1
0
0
0.4
0.4
表 8.2
1
0
1
0.1228
0.1228
1
1
0
0.1
0.1
b
c
p(b|c)
a
c
p(a|c)
1
1
1
0.1842
0.1842
0
0
0.8
0
0
0.5
0
1
0.4
0
1
0.692
p(a=1)=0.4, p(a=0)=0.6 1
0
0.2
1
0
0.5
p(b=1)=0.4, p(b=0)=0.6
1
1
0.6
1
1
0.307
p(c=1)=0.52, p(c=0)=0.48
cのもとでの条件付き確率
10. 10
a
b
c
p(a,b,c)
演習 8.4
0
0
0
0.192
0
0
1
0.144
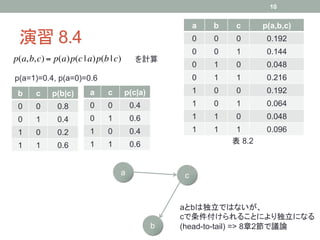
p(a, b, c) = p(a)p(c | a)p(b | c) を計算
0
1
0
0.048
p(a=1)=0.4, p(a=0)=0.6 0
1
1
0.216
b
c
p(b|c)
a
c
p(c|a)
1
0
0
0.192
0
0
0.8
0
0
0.4
1
0
1
0.064
0
1
0.4
0
1
0.6
1
1
0
0.048
1
0
0.2
1
0
0.4
1
1
1
0.096
1
1
0.6
表 8.2
1
1
0.6
a
c
aとbは独立ではないが、
cで条件付けられることにより独立になる
b
(head-to-tail) => 8章2節で議論
11. 12. 12
8.1.1 多項式曲線フィッティング
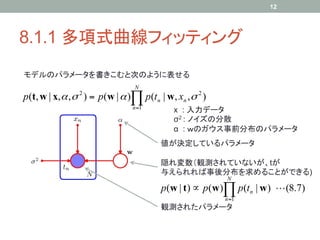
モデルのパラメータを書きこむと次のように表せる
N
p(t, w | x, α , σ ) = p(w | α )∏ p(t n | w, xn , σ 2 )
2
n =1
x : 入力データ
σ2 : ノイズの分散
α : wのガウス事前分布のパラメータ
値が決定しているパラメータ
隠れ変数(観測されていないが、tが
与えられれば事後分布を求めることができる)
N
p(w | t ) ∝ p(w )∏ p(t n | w ) (8.7)
n =1
観測されたパラメータ
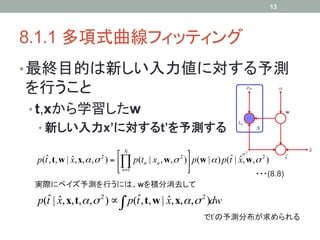
13. 13
8.1.1 多項式曲線フィッティング
• 最終目的は新しい入力値に対する予測
を行うこと
• t,xから学習したw
• 新しい入力x’に対するt’を予測する
ˆ ⎡ N ⎤ ˆ ˆ
p(t , t, w | x, x, α , σ ) = ⎢∏ p(tn | xn , w, σ 2 )⎥ p(w | α ) p(t | x, w, σ 2 )
ˆ 2
⎣ n=1 ⎦
・・・(8.8)
実際にベイズ予測を行うには、wを積分消去して
ˆ ˆ ˆ
p(t | x, x, t, α , σ 2 ) ∝ ∫ p(t , t, w | x, x,α ,σ 2 )dw
ˆ
でt’の予測分布が求められる
14. 14
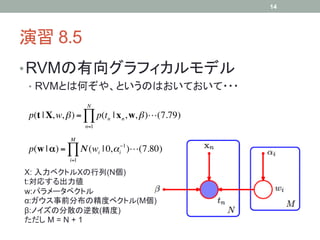
演習 8.5
• RVMの有向グラフィカルモデル
• RVMとは何ぞや、というのはおいておいて・・・
N
p(t | X, w, ! ) = ! p(tn | x n , w, ! )!(7.79)
n=1
M
p(w | !) = # ! (wi | 0, " i"1 )!(7.80)
i=1
X: 入力ベクトルXの行列(N個)
t:対応する出力値
w:パラメータベクトル
α:ガウス事前分布の精度ベクトル(M個)
β:ノイズの分散の逆数(精度)
ただし M = N + 1
15. 15
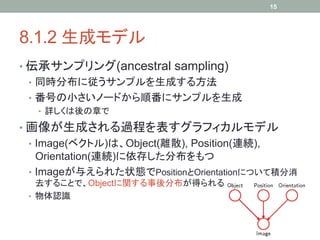
8.1.2 生成モデル
• 伝承サンプリング(ancestral sampling)
• 同時分布に従うサンプルを生成する方法
• 番号の小さいノードから順番にサンプルを生成
• 詳しくは後の章で
• 画像が生成される過程を表すグラフィカルモデル
• Image(ベクトル)は、Object(離散), Position(連続),
Orientation(連続)に依存した分布をもつ
• Imageが与えられた状態でPositionとOrientationについて積分消
去することで、Objectに関する事後分布が得られる
• 物体認識
16. 16
8.1.2 生成モデル
• 観測データと同じ分布に従う架空のデータを発
生させることができるモデル
• 架空のデータ:モデルの性質を理解する上で有用
• ほんとかな・・・?
• NLP的には・・・
• 言語モデル : p(w1,w2,….,wn)に対する生成モデル :
日本語っぽい文章を生成できる
• 文書モデル:文書は特定のトピックについて述べられ
ている、という仮定のもとでの生成モデル
• Generative-model vs Discriminative-model
• このへんにまつわる話は面白いので、研究に支障が
出ない範囲で調べてみると良いかも
17. 17
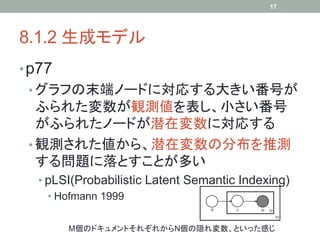
8.1.2 生成モデル
• p77
• グラフの末端ノードに対応する大きい番号が
ふられた変数が観測値を表し、小さい番号
がふられたノードが潜在変数に対応する
• 観測された値から、潜在変数の分布を推測
する問題に落とすことが多い
• pLSI(Probabilistic Latent Semantic Indexing)
• Hofmann 1999
M個のドキュメントそれぞれからN個の隠れ変数、といった感じ
18. 19. 19
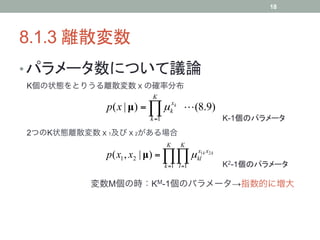
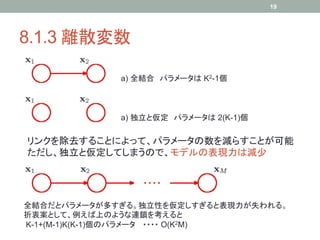
8.1.3 離散変数
a) 全結合 パラメータは K2-1個
a) 独立と仮定 パラメータは 2(K-1)個
リンクを除去することによって、パラメータの数を減らすことが可能
ただし、独立と仮定してしまうので、モデルの表現力は減少
全結合だとパラメータが多すぎる。独立性を仮定しすぎると表現力が失われる。
折衷案として、例えば上のような連鎖を考えると
K-1+(M-1)K(K-1)個のパラメータ ・・・・ O(K2M)
20. 20
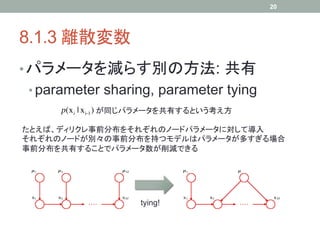
8.1.3 離散変数
• パラメータを減らす別の方法: 共有
• parameter sharing, parameter tying
p(x i | x i-1 ) が同じパラメータを共有するという考え方
たとえば、ディリクレ事前分布をそれぞれのノードパラメータに対して導入
それぞれのノードが別々の事前分布を持つモデルはパラメータが多すぎる場合
事前分布を共有することでパラメータ数が削減できる
tying!
21. 21
8.1.4 線形ガウスモデル
• 省略・・・ (最後のほうだけちょっと読みましょう)
ガウス変数xの平均µに関する共役事前分布はガウス分布
xおよびµ上の同時分布もガウス分布になる
µ上の分布の平均は事前分布を制御するパラメータなので,
超パラメータとみなされる.
超パラメータの値自体が未知なので,超パラメータにも事前分布を導入する.
(超事前分布)
これもガウス分布とすれば,ベイズ的取り扱いが可能
→階層ベイズモデルの一例
22.