Deep Learningによる
視覚・言語融合の最前線
東京大学 大学院情報理工学系研究科
牛久 祥孝
losnuevetoros
自己紹介
~2014.3 博士(情報理工学)、東京大学
• 画像説明文の自動生成
• 大規模画像分類
2014.4~2016.3 NTT コミュニケーション科学基礎研究所
2016.4~ 東京大学 大学院情報理工学系研究科
知能機械情報学専攻 講師 (原田・牛久研究室)
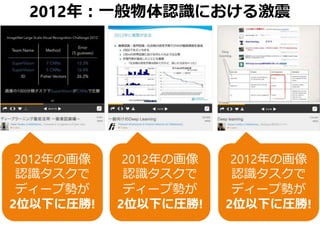
2012年:一般物体認識における激震
2012年の画像
認識タスクで
ディープ勢が
2位以下に圧勝!
2012年の画像
認識タスクで
ディープ勢が
2位以下に圧勝!
2012年の画像
認識タスクで
ディープ勢が
2位以下に圧勝!
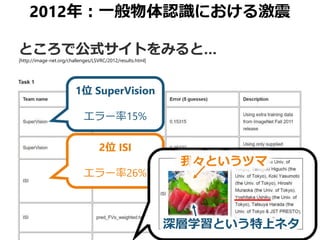
2012年:一般物体認識における激震
ところで公式サイトをみると…
1位 SuperVision
エラー率15%
2位 ISI
エラー率26%
我々というツマ
深層学習という特上ネタ
[http://image-net.org/challenges/LSVRC/2012/results.html]
ユーザー生成コンテンツの爆発的増加
特にコンテンツ投稿・共有サービスでは…
• Facebookに画像が2500億枚 (2013年9月時点)
• YouTubeにアップロードされる動画
1分間で計400時間分 (2015年7月時点)
Pōhutukawa blooms this
time of the year in New
Zealand. As the flowers
fall, the ground
underneath the trees look
spectacular.
画像/動画と
関連する文章の対
→大量に収集可能
入力
出力
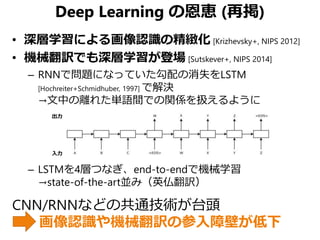
Deep Learning の恩恵
• 深層学習による画像認識の精緻化 [Krizhevsky+, NIPS 2012]
• 機械翻訳でも深層学習が登場 [Sutskever+, NIPS 2014]
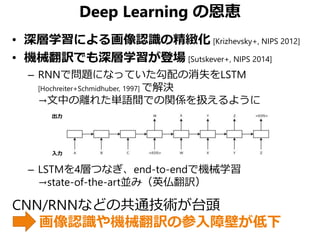
– RNNで問題になっていた勾配の消失をLSTM
[Hochreiter+Schmidhuber, 1997] で解決
→文中の離れた単語間での関係を扱えるように
– LSTMを4層つなぎ、end-to-endで機械学習
→state-of-the-art並み(英仏翻訳)
CNN/RNNなどの共通技術が台頭
画像認識や機械翻訳の参入障壁が低下
画像キャプション生成
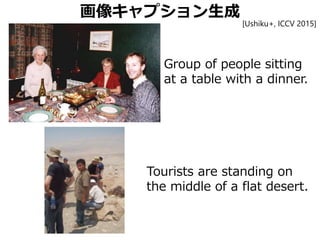
Group of people sitting
at a table with a dinner.
Tourists are standing on
the middle of a flat desert.
[Ushiku+, ICCV 2015]
動画キャプション生成
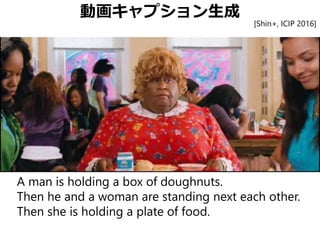
A man is holding a box of doughnuts.
Then he and a woman are standing next each other.
Then she is holding a plate of food.
[Shin+, ICIP 2016]
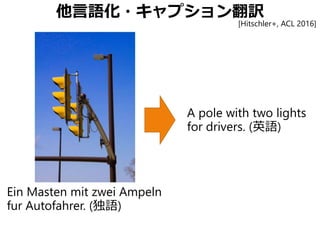
他言語化・キャプション翻訳
Ein Masten mit zwei Ampeln
fur Autofahrer. (独語)
A pole with two lights
for drivers. (英語)
[Hitschler+, ACL 2016]
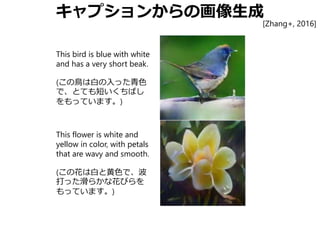
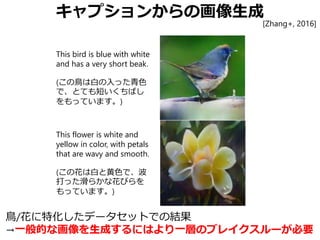
キャプションからの画像生成
This bird is blue with white
and has a very short beak.
(この鳥は白の入った青色
で、とても短いくちばし
をもっています。)
This flower is white and
yellow in color, with petals
that are wavy and smooth.
(この花は白と黄色で、波
打った滑らかな花びらを
もっています。)
[Zhang+, 2016]
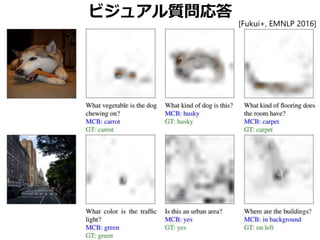
ビジュアル質問応答
[Fukui+, EMNLP 2016]
本講演の目的
視覚×言語の融合研究を俯瞰
• 各領域の歴史的な流れ
• Deep Learning 登場以前と以後の変化を説明
× Deep Learning で初めてこれらの研究が誕生
✓ Deep Learning でこれらの研究が精緻化
1. 画像キャプション生成
2. 動画キャプション生成
3. 言語横断
4. 画像に関する質問への応答
5. キャプションからの画像生成
視覚・言語融合の最前線1
画像キャプション生成
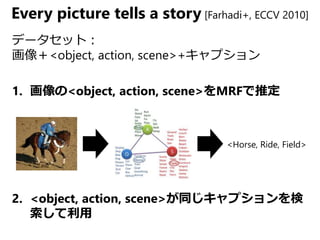
Every picture tells a story [Farhadi+, ECCV 2010]
データセット:
画像+<object, action, scene>+キャプション
1. 画像の<object, action, scene>をMRFで推定
2. <object, action, scene>が同じキャプションを検
索して利用
<Horse, Ride, Field>
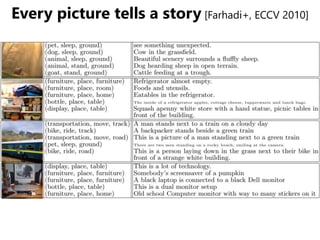
Every picture tells a story [Farhadi+, ECCV 2010]
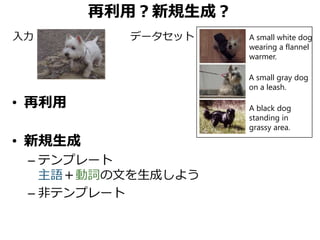
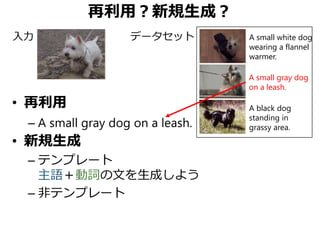
再利用?新規生成?
• 再利用
• 新規生成
– テンプレート
主語+動詞の文を生成しよう
– 非テンプレート
A small gray dog
on a leash.
A black dog
standing in
grassy area.
A small white dog
wearing a flannel
warmer.
入力 データセット
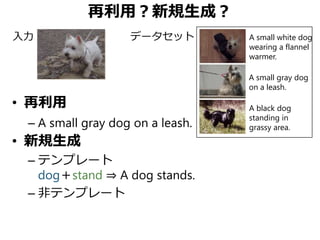
再利用?新規生成?
• 再利用
– A small gray dog on a leash.
• 新規生成
– テンプレート
主語+動詞の文を生成しよう
– 非テンプレート
A small gray dog
on a leash.
A black dog
standing in
grassy area.
A small white dog
wearing a flannel
warmer.
入力 データセット
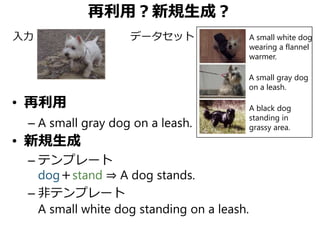
再利用?新規生成?
• 再利用
– A small gray dog on a leash.
• 新規生成
– テンプレート
dog+stand ⇒ A dog stands.
– 非テンプレート
A small gray dog
on a leash.
A black dog
standing in
grassy area.
A small white dog
wearing a flannel
warmer.
入力 データセット
再利用?新規生成?
• 再利用
– A small gray dog on a leash.
• 新規生成
– テンプレート
dog+stand ⇒ A dog stands.
– 非テンプレート
A small white dog standing on a leash.
A small gray dog
on a leash.
A black dog
standing in
grassy area.
A small white dog
wearing a flannel
warmer.
入力 データセット
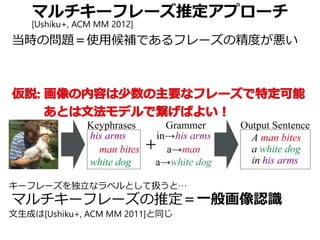
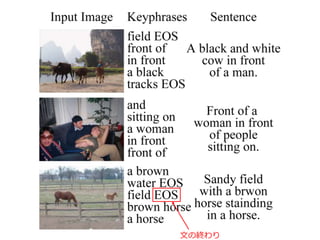
マルチキーフレーズ推定アプローチ
当時の問題=使用候補であるフレーズの精度が悪い
キーフレーズを独立なラベルとして扱うと…
マルチキーフレーズの推定=一般画像認識
文生成は[Ushiku+, ACM MM 2011]と同じ
[Ushiku+, ACM MM 2012]
文の終わり
入力
出力
Deep Learning の恩恵 (再掲)
• 深層学習による画像認識の精緻化 [Krizhevsky+, NIPS 2012]
• 機械翻訳でも深層学習が登場 [Sutskever+, NIPS 2014]
– RNNで問題になっていた勾配の消失をLSTM
[Hochreiter+Schmidhuber, 1997] で解決
→文中の離れた単語間での関係を扱えるように
– LSTMを4層つなぎ、end-to-endで機械学習
→state-of-the-art並み(英仏翻訳)
CNN/RNNなどの共通技術が台頭
画像認識や機械翻訳の参入障壁が低下
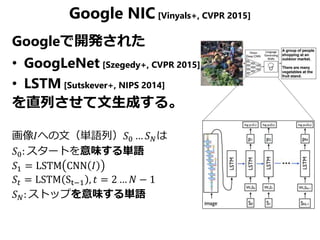
Google NIC [Vinyals+, CVPR 2015]
Googleで開発された
• GoogLeNet [Szegedy+, CVPR 2015]
• LSTM [Sutskever+, NIPS 2014]
を直列させて文生成する。
画像𝐼への文(単語列)𝑆0 … 𝑆 𝑁は
𝑆0: スタートを意味する単語
𝑆1 = LSTM CNN 𝐼
𝑆𝑡 = LSTM St−1 , 𝑡 = 2 … 𝑁 − 1
𝑆 𝑁: ストップを意味する単語
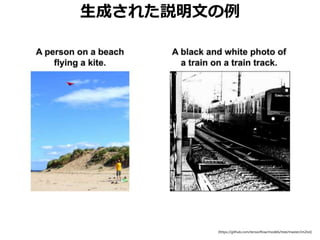
生成された説明文の例
[https://github.com/tensorflow/models/tree/master/im2txt]
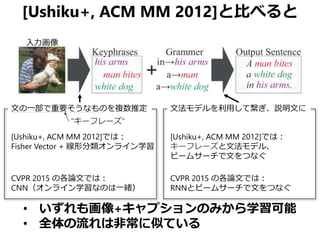
[Ushiku+, ACM MM 2012]と比べると
入力画像
[Ushiku+, ACM MM 2012]では:
Fisher Vector + 線形分類オンライン学習
CVPR 2015 の各論文では:
CNN(オンライン学習なのは一緒)
CVPR 2015 の各論文では:
RNNとビームサーチで文をつなぐ
[Ushiku+, ACM MM 2012]では:
キーフレーズと文法モデル、
ビームサーチで文をつなぐ
文の一部で重要そうなものを複数推定 文法モデルを利用して繋ぎ、説明文に
• いずれも画像+キャプションのみから学習可能
• 全体の流れは非常に似ている
“キーフレーズ”
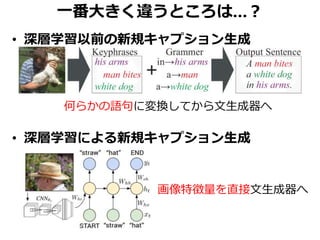
一番大きく違うところは…?
• 深層学習以前の新規キャプション生成
何らかの語句に変換してから文生成器へ
• 深層学習による新規キャプション生成
画像特徴量を直接文生成器へ
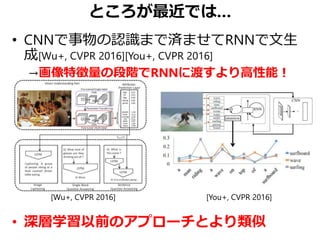
ところが最近では…
• CNNで事物の認識まで済ませてRNNで文生
成[Wu+, CVPR 2016][You+, CVPR 2016]
→画像特徴量の段階でRNNに渡すより高性能!
• 深層学習以前のアプローチとより類似
[You+, CVPR 2016][Wu+, CVPR 2016]
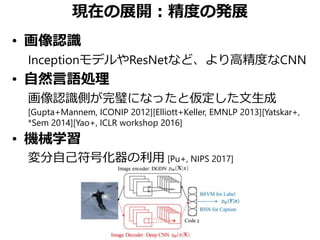
現在の展開:精度の発展
• 画像認識
InceptionモデルやResNetなど、より高精度なCNN
• 自然言語処理
画像認識側が完璧になったと仮定した文生成
[Gupta+Mannem, ICONIP 2012][Elliott+Keller, EMNLP 2013][Yatskar+,
*Sem 2014][Yao+, ICLR workshop 2016]
• 機械学習
変分自己符号化器の利用 [Pu+, NIPS 2017]
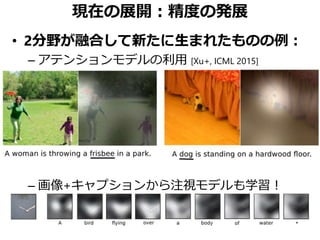
現在の展開:精度の発展
• 2分野が融合して新たに生まれたものの例:
– アテンションモデルの利用 [Xu+, ICML 2015]
– 画像+キャプションから注視モデルも学習!
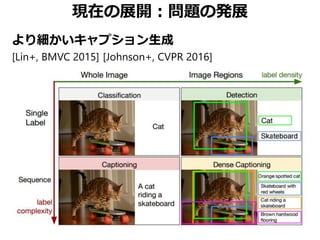
現在の展開:問題の発展
より細かいキャプション生成
[Lin+, BMVC 2015] [Johnson+, CVPR 2016]
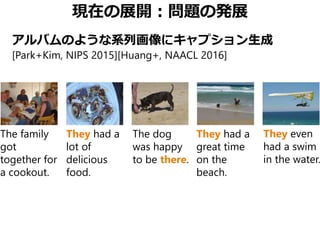
現在の展開:問題の発展
アルバムのような系列画像にキャプション生成
[Park+Kim, NIPS 2015][Huang+, NAACL 2016]
The family
got
together for
a cookout.
They had a
lot of
delicious
food.
The dog
was happy
to be there.
They had a
great time
on the
beach.
They even
had a swim
in the water.
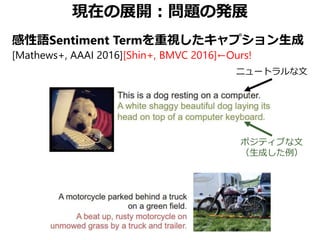
現在の展開:問題の発展
感性語Sentiment Termを重視したキャプション生成
[Mathews+, AAAI 2016][Shin+, BMVC 2016]←Ours!
ニュートラルな文
ポジティブな文
(生成した例)
視覚・言語融合の最前線2
動画キャプション生成
深層学習登場以前
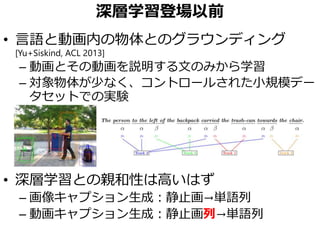
• 言語と動画内の物体とのグラウンディング
[Yu+Siskind, ACL 2013]
– 動画とその動画を説明する文のみから学習
– 対象物体が少なく、コントロールされた小規模デー
タセットでの実験
• 深層学習との親和性は高いはず
– 画像キャプション生成:静止画→単語列
– 動画キャプション生成:静止画列→単語列
深層学習によるend-to-endな学習
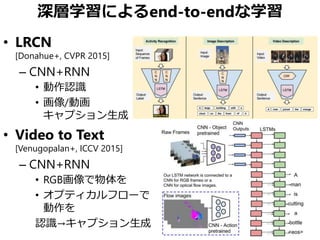
• LRCN
[Donahue+, CVPR 2015]
– CNN+RNN
• 動作認識
• 画像/動画
キャプション生成
• Video to Text
[Venugopalan+, ICCV 2015]
– CNN+RNN
• RGB画像で物体を
• オプティカルフローで
動作を
認識→キャプション生成
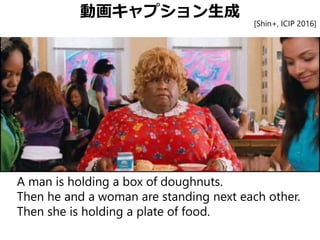
動画キャプション生成
A man is holding a box of doughnuts.
Then he and a woman are standing next each other.
Then she is holding a plate of food.
[Shin+, ICIP 2016]
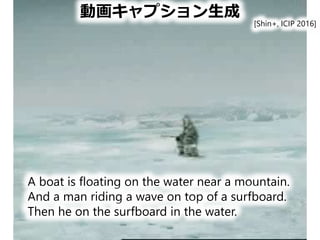
動画キャプション生成
A boat is floating on the water near a mountain.
And a man riding a wave on top of a surfboard.
Then he on the surfboard in the water.
[Shin+, ICIP 2016]
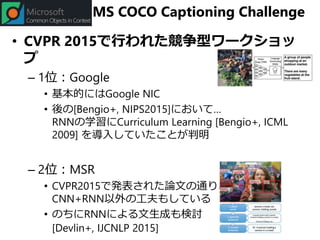
MS COCO Captioning Challenge
• CVPR 2015で行われた競争型ワークショッ
プ
– 1位:Google
• 基本的にはGoogle NIC
• 後の[Bengio+, NIPS2015]において…
RNNの学習にCurriculum Learning [Bengio+, ICML
2009] を導入していたことが判明
– 2位:MSR
• CVPR2015で発表された論文の通り、
CNN+RNN以外の工夫もしている
• のちにRNNによる文生成も検討
[Devlin+, IJCNLP 2015]
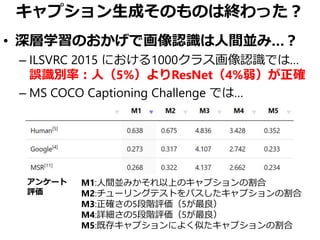
キャプション生成そのものは終わった?
• 深層学習のおかげで画像認識は人間並み…?
– ILSVRC 2015 における1000クラス画像認識では…
誤識別率:人(5%)よりResNet(4%弱)が正確
– MS COCO Captioning Challenge では…
M1:人間並みかそれ以上のキャプションの割合
M2:チューリングテストをパスしたキャプションの割合
M3:正確さの5段階評価(5が最良)
M4:詳細さの5段階評価(5が最良)
M5:既存キャプションによく似たキャプションの割合
アンケート
評価
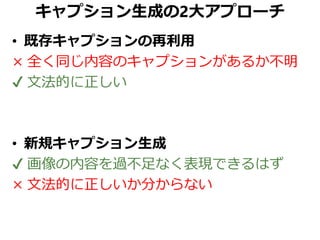
キャプション生成の2大アプローチ
• 既存キャプションの再利用
× 全く同じ内容のキャプションがあるか不明
✔ 文法的に正しい
• 新規キャプション生成
✔ 画像の内容を過不足なく表現できるはず
× 文法的に正しいか分からない
Deep Learning によって
• 既存キャプションの再利用
× 全く同じ内容のキャプションがあるか不明
✔ 文法的に正しい
✔ 詳細な記述をあてられる
• 新規キャプション生成
✔ 画像の内容を過不足なく表現できるはず
✔ 文法的に正しいか分からない正しい
× 曖昧な、最大公約数的な記述になる
視覚・言語融合の最前線3
他言語化・キャプション翻訳
他言語への展開
データセット
• IAPR TC12 [Grubinger+, 2006] 20,000画像+英独
• Multi30K [Elliot+, 2016] 30,000画像+英独
• STAIR Captions [吉川ら、 2017]
MS COCO (10万超画像+英語キャプション)
→すべてに日本語キャプションを付与
タスクとしての展開
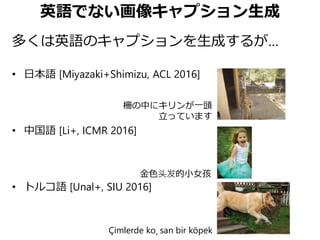
• 英語でない画像キャプション生成
• マルチモーダル機械翻訳/言語間文書検索
1. 入力:言語Aでのキャプション+画像
2. 入力:言語Aでのキャプション
→ 出力:言語Bでのキャプション(1.と2.で同じ)
英語でない画像キャプション生成
英語でない画像キャプション生成
多くは英語のキャプションを生成するが…
• 日本語 [Miyazaki+Shimizu, ACL 2016]
• 中国語 [Li+, ICMR 2016]
• トルコ語 [Unal+, SIU 2016]
Çimlerde ko¸ san bir köpek
金色头发的小女孩
柵の中にキリンが一頭
立っています
単にデータ集めを頑張るだけ?
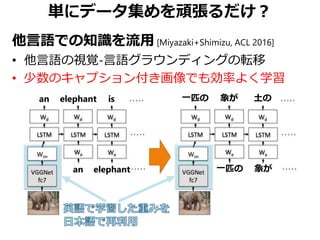
他言語での知識を流用 [Miyazaki+Shimizu, ACL 2016]
• 他言語の視覚-言語グラウンディングの転移
• 少数のキャプション付き画像でも効率よく学習
an elephant is
an elephant
一匹の 象が 土の
一匹の 象が
マルチモーダル機械翻訳
言語横断型の研究
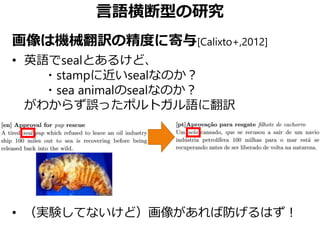
画像は機械翻訳の精度に寄与[Calixto+,2012]
• 英語でsealとあるけど、
・stampに近いsealなのか?
・sea animalのsealなのか?
がわからず誤ったポルトガル語に翻訳
• (実験してないけど)画像があれば防げるはず!
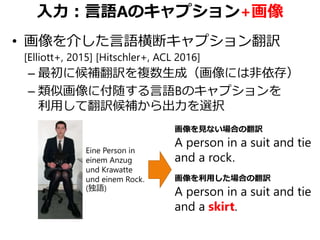
入力:言語Aのキャプション+画像
• 画像を介した言語横断キャプション翻訳
[Elliott+, 2015] [Hitschler+, ACL 2016]
– 最初に候補翻訳を複数生成(画像には非依存)
– 類似画像に付随する言語Bのキャプションを
利用して翻訳候補から出力を選択
Eine Person in
einem Anzug
und Krawatte
und einem Rock.
(独語)
画像を見ない場合の翻訳
A person in a suit and tie
and a rock.
画像を利用した場合の翻訳
A person in a suit and tie
and a skirt.
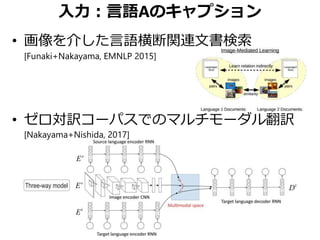
入力:言語Aのキャプション
• 画像を介した言語横断関連文書検索
[Funaki+Nakayama, EMNLP 2015]
• ゼロ対訳コーパスでのマルチモーダル翻訳
[Nakayama+Nishida, 2017]
視覚・言語融合の最前線4
画像に関する質問への応答
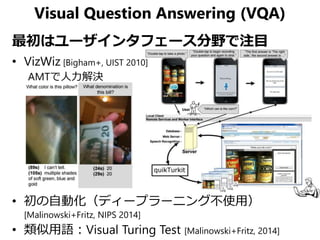
Visual Question Answering (VQA)
最初はユーザインタフェース分野で注目
• VizWiz [Bigham+, UIST 2010]
AMTで人力解決
• 初の自動化(ディープラーニング不使用)
[Malinowski+Fritz, NIPS 2014]
• 類似用語:Visual Turing Test [Malinowski+Fritz, 2014]
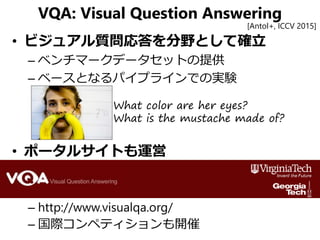
VQA: Visual Question Answering
• ビジュアル質問応答を分野として確立
– ベンチマークデータセットの提供
– ベースとなるパイプラインでの実験
• ポータルサイトも運営
– http://www.visualqa.org/
– 国際コンペティションも開催
[Antol+, ICCV 2015]
What color are her eyes?
What is the mustache made of?
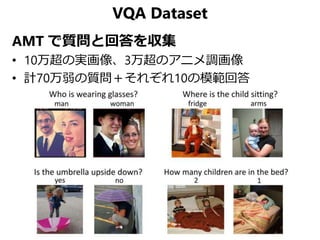
VQA Dataset
AMT で質問と回答を収集
• 10万超の実画像、3万超のアニメ調画像
• 計70万弱の質問+それぞれ10の模範回答
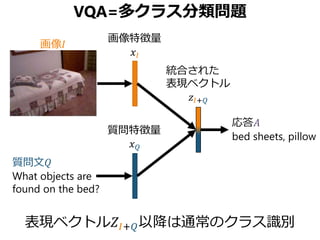
VQA=多クラス分類問題
表現ベクトル𝑍𝐼+𝑄以降は通常のクラス識別
質問文𝑄
What objects are
found on the bed?
応答𝐴
bed sheets, pillow
画像𝐼
画像特徴量
𝑥𝐼
質問特徴量
𝑥 𝑄
統合された
表現ベクトル
𝑧𝐼+𝑄
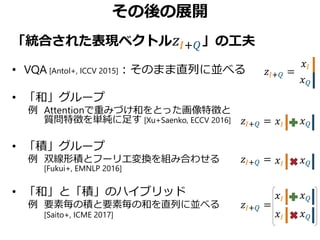
その後の展開
「統合された表現ベクトル 𝑧𝐼+𝑄」の工夫
• VQA [Antol+, ICCV 2015]:そのまま直列に並べる
• 「和」グループ
例 Attentionで重みづけ和をとった画像特徴と
質問特徴を単純に足す [Xu+Saenko, ECCV 2016]
• 「積」グループ
例 双線形積とフーリエ変換を組み合わせる
[Fukui+, EMNLP 2016]
• 「和」と「積」のハイブリッド
例 要素毎の積と要素毎の和を直列に並べる
[Saito+, ICME 2017]
𝑧𝐼+𝑄 =
𝑥𝐼
𝑥 𝑄
𝑥𝐼 𝑥 𝑄
𝑥𝐼 𝑥 𝑄𝑧𝐼+𝑄 =
𝑧𝐼+𝑄 =
𝑧𝐼+𝑄 =
𝑥𝐼 𝑥 𝑄
𝑥𝐼 𝑥 𝑄
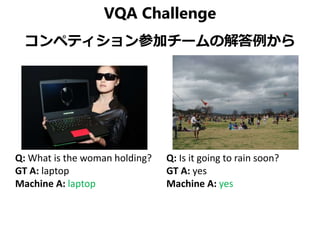
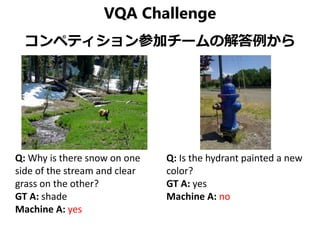
VQA Challenge
コンペティション参加チームの解答例から
Q: What is the woman holding?
GT A: laptop
Machine A: laptop
Q: Is it going to rain soon?
GT A: yes
Machine A: yes
VQA Challenge
コンペティション参加チームの解答例から
Q: Why is there snow on one
side of the stream and clear
grass on the other?
GT A: shade
Machine A: yes
Q: Is the hydrant painted a new
color?
GT A: yes
Machine A: no
視覚・言語融合の最前線5
キャプションからの画像生成
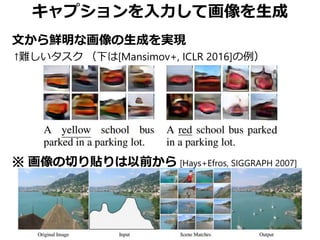
キャプションを入力して画像を生成
文から鮮明な画像の生成を実現
↑難しいタスク (下は[Mansimov+, ICLR 2016]の例)
※ 画像の切り貼りは以前から [Hays+Efros, SIGGRAPH 2007]
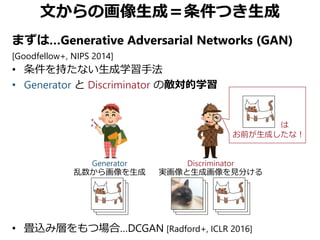
文からの画像生成=条件つき生成
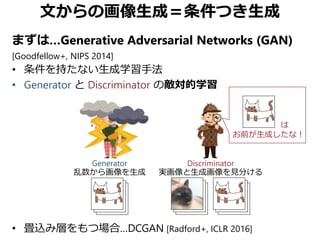
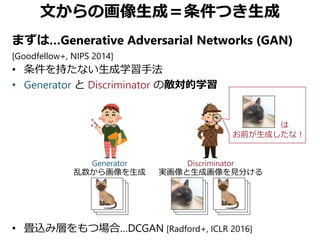
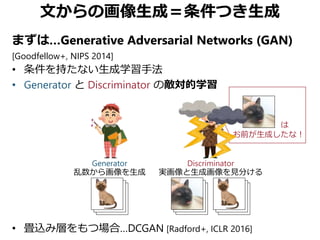
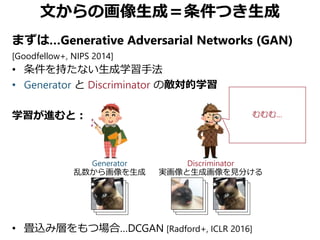
まずは…Generative Adversarial Networks (GAN)
[Goodfellow+, NIPS 2014]
• 条件を持たない生成学習手法
• Generator と Discriminator の敵対的学習
• 畳込み層をもつ場合…DCGAN [Radford+, ICLR 2016]
Generator
乱数から画像を生成
Discriminator
実画像と生成画像を見分ける
は
お前が生成したな!
文からの画像生成=条件つき生成
まずは…Generative Adversarial Networks (GAN)
[Goodfellow+, NIPS 2014]
• 条件を持たない生成学習手法
• Generator と Discriminator の敵対的学習
• 畳込み層をもつ場合…DCGAN [Radford+, ICLR 2016]
Generator
乱数から画像を生成
Discriminator
実画像と生成画像を見分ける
は
お前が生成したな!
文からの画像生成=条件つき生成
まずは…Generative Adversarial Networks (GAN)
[Goodfellow+, NIPS 2014]
• 条件を持たない生成学習手法
• Generator と Discriminator の敵対的学習
• 畳込み層をもつ場合…DCGAN [Radford+, ICLR 2016]
Generator
乱数から画像を生成
Discriminator
実画像と生成画像を見分ける
は
お前が生成したな!
文からの画像生成=条件つき生成
まずは…Generative Adversarial Networks (GAN)
[Goodfellow+, NIPS 2014]
• 条件を持たない生成学習手法
• Generator と Discriminator の敵対的学習
• 畳込み層をもつ場合…DCGAN [Radford+, ICLR 2016]
Generator
乱数から画像を生成
Discriminator
実画像と生成画像を見分ける
は
お前が生成したな!
文からの画像生成=条件つき生成
まずは…Generative Adversarial Networks (GAN)
[Goodfellow+, NIPS 2014]
• 条件を持たない生成学習手法
• Generator と Discriminator の敵対的学習
学習が進むと:
• 畳込み層をもつ場合…DCGAN [Radford+, ICLR 2016]
Generator
乱数から画像を生成
Discriminator
実画像と生成画像を見分ける
むむむ…
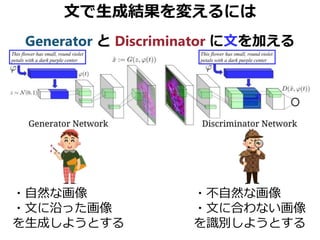
文で生成結果を変えるには
Generator と Discriminator に文を加える
・自然な画像
・文に沿った画像
を生成しようとする
・不自然な画像
・文に合わない画像
を識別しようとする
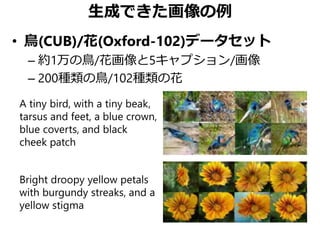
生成できた画像の例
• 鳥(CUB)/花(Oxford-102)データセット
– 約1万の鳥/花画像と5キャプション/画像
– 200種類の鳥/102種類の花
A tiny bird, with a tiny beak,
tarsus and feet, a blue crown,
blue coverts, and black
cheek patch
Bright droopy yellow petals
with burgundy streaks, and a
yellow stigma
その後の展開
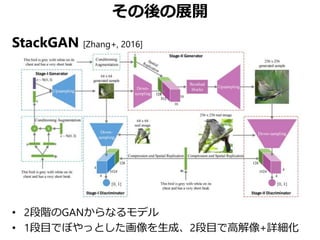
StackGAN [Zhang+, 2016]
• 2段階のGANからなるモデル
• 1段目でぼやっとした画像を生成、2段目で高解像+詳細化
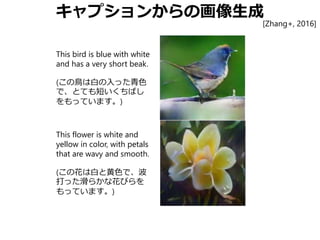
キャプションからの画像生成
This bird is blue with white
and has a very short beak.
(この鳥は白の入った青色
で、とても短いくちばし
をもっています。)
This flower is white and
yellow in color, with petals
that are wavy and smooth.
(この花は白と黄色で、波
打った滑らかな花びらを
もっています。)
[Zhang+, 2016]
キャプションからの画像生成
This bird is blue with white
and has a very short beak.
(この鳥は白の入った青色
で、とても短いくちばし
をもっています。)
This flower is white and
yellow in color, with petals
that are wavy and smooth.
(この花は白と黄色で、波
打った滑らかな花びらを
もっています。)
[Zhang+, 2016]
鳥/花に特化したデータセットでの結果
→一般的な画像を生成するにはより一層のブレイクスルーが必要
まとめ
• Deep Learning による視覚・言語融合を俯瞰
1. 画像キャプション生成
2. 動画キャプション生成
3. 言語横断
4. 画像に関する質問への応答
5. キャプションからの画像生成
• Deep Learning の貢献
– 上記研究課題自体は Deep Learning 以前も存在
– 画像、動画、自然言語処理技術の共通化
– 認識と生成の精緻化
視覚×言語の新たなステージへ