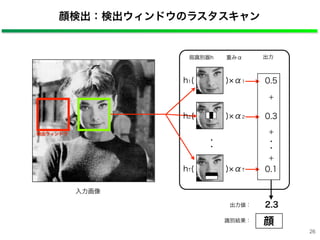
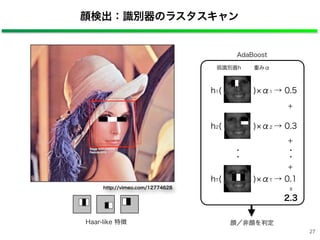
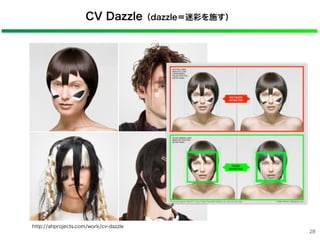
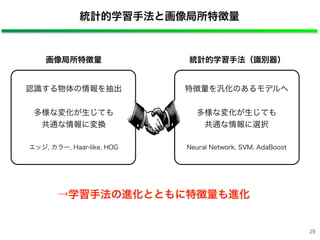
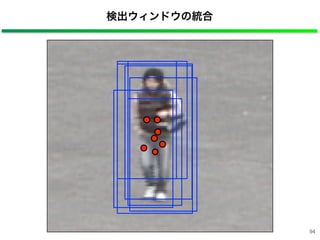
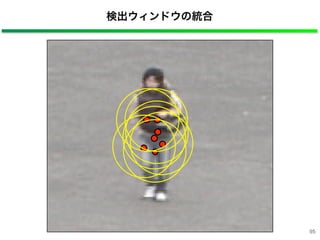
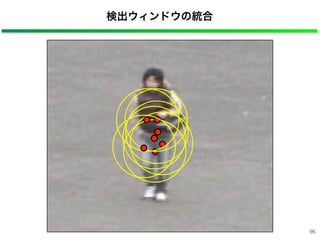
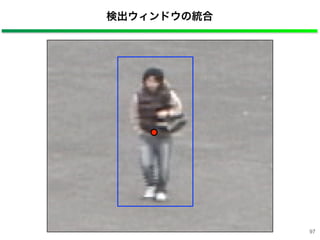
More Related Content

PDF
Introduction to YOLO detection model 
PDF
Deep Learningによる画像認識革命 ー歴史・最新理論から実践応用までー 
PPTX
CVPR2018 pix2pixHD論文紹介 (CV勉強会@関東) 
PPTX

PDF

PPTX
[DL輪読会]Object-Centric Learning with Slot Attention 
PPTX
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant... 
PDF
Active Learning の基礎と最近の研究 What's hot

PPTX
物体検出の歴史(R-CNNからSSD・YOLOまで) 
PDF
Generative Models(メタサーベイ ) 
PDF

PPTX

PPTX

PDF
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法 
PDF

PPTX
【DL輪読会】ViTPose: Simple Vision Transformer Baselines for Human Pose Estimation 
PDF

PDF
最近のDeep Learning (NLP) 界隈におけるAttention事情 
PDF
【DL輪読会】DINOv2: Learning Robust Visual Features without Supervision 
PPTX
【DL輪読会】ViT + Self Supervised Learningまとめ 
PPTX
StyleGAN解説 CVPR2019読み会@DeNA 
PPTX

PDF
Anomaly detection 系の論文を一言でまとめた 
PDF
Action Recognitionの歴史と最新動向 
PDF
画像局所特徴量と特定物体認識 - SIFTと最近のアプローチ - 
PDF
オープンワールド認識 (第34回全脳アーキテクチャ若手の会 勉強会) 
PDF

PDF
[DL輪読会]Deep Learning 第15章 表現学習 Viewers also liked

PDF
Opencv object detection_takmin 
PDF
Relational Binarized HOG特徴量とReal AdaBoostによるバイナリ選択を用いた物体検出 
PPTX

PPTX

PDF

PDF
TensorFlowとは? ディープラーニング (深層学習) とは? 
PDF
Pythonによる機械学習入門 ~SVMからDeep Learningまで~ 
PDF

PDF
女子の心をつかむUIデザインポイント - MERY編 - Similar to 局所特徴量と統計学習手法による物体検出

PDF

PDF

PDF
PRML 4.1 Discriminant Function 
PDF
統計的学習手法による物体検出の高精度化と効率化 -人検出の実用化に向けて- 
PDF

PDF

PPTX

PDF

PDF
オンライン凸最適化と線形識別モデル学習の最前線_IBIS2011 
PDF
Learning to Solve Hard Minimal Problems 
PDF
多数のグラフからの統計的機械学習 (2014.7.24 人工知能学会 第94回人工知能基本問題研究会 招待講演) 
PDF

PDF

PDF
(文献紹介) 画像復元:Plug-and-Play ADMM 
PDF

PPTX

PDF

PPTX
2015年12月PRMU研究会 対応点探索のための特徴量表現 
PDF
L0TV: a new method for image restoration in the presence of impulse noise 
PDF
More from MPRG_Chubu_University

PDF

PDF

PDF

PDF
距離情報に基づく局所特徴量によるリアルタイム人検出 
PDF

PDF
複数パスを考慮したRegression Forestsによるカメラのヨー角の推定 
PDF
Binary code-based Human Detection 
PDF
平滑化処理の繰り返しによる画像セグメンテーションのためのグラフカット 
PDF

PDF

PDF

PDF

PDF
局所特徴量と統計学習手法による物体検出
- 1.
1
局所特徴量と統計学習手法による物体検出
http://mprg.jp/tutorials
機械知覚&ロボティクス研究グループ(中部大学)
中部
工学
助手
中部大学
工学部 情報工学科
講師
大学
部 ロボット理工学科
中部大学
工学部ロボット理工学科
助手
山内 悠嗣
機械知覚&ロボティクスグル
487-8501
愛知県春日井市松本町120
Tel 0568-51-8249
Fax 0568-51-9409
yuu@vision.cs.chubu.ac.jp
http://vision.cs.chubu.ac.jp
MACHINE PERCEPTION AND
中部大学
工学部 情報工学科
講師
山下 隆義
機械知覚&ロボティクスグループ
487-8501
愛知県春日井市松本町1200
Tel 0568-51-9670
Fax 0568-51-1540
yamashita@cs.chubu.ac.jp
http://vision.cs.chubu.ac.jp
博士(工学)
MACHINE PERCEPTION AND ROBOTICS GROUP
中部大学
工学部 ロボット理工学科
教授
藤吉 弘亘
機械知覚&ロボティクスグループ
487-8501
愛知県春日井市松本町1200
Tel 0568-51-9096
Fax 0568-51-9409
hf@cs.chubu.ac.jp
http://vision.cs.chubu.ac.jp
博士(工学)
MACHINE PERCEPTION AND ROBOTICS GROUP
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
- 9.
- 10.
- 11.
- 12.
- 13.
- 14.
- 15.
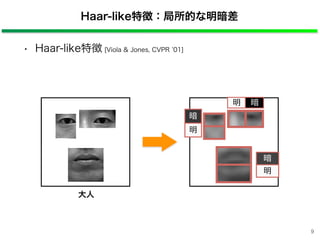
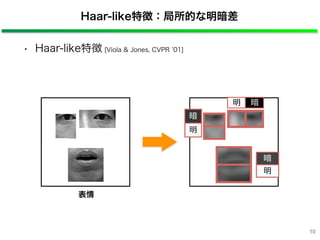
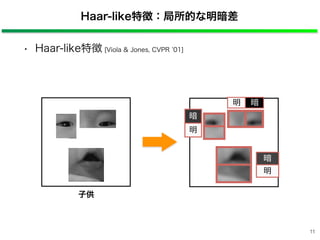
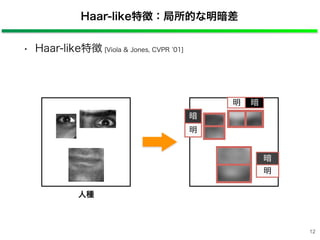
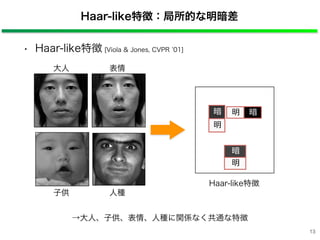
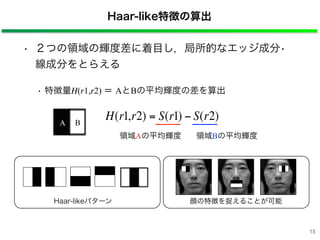
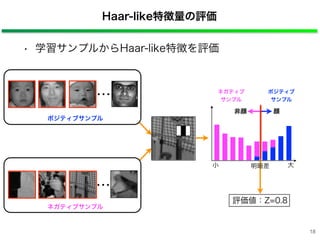
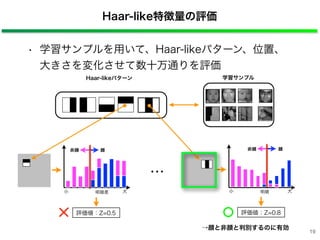
Haar-like特徴の算出
• 特徴量H(r1,r2) =AとBの平均輝度の差を算出
領域Aの平均輝度 領域Bの平均輝度
• 2つの領域の輝度差に着目し,局所的なエッジ成分•
線成分をとらえる
€
H(r1,r2) = S(r1) − S(r2)A B
Haar-likeパターン 顔の特徴を捉えることが可能
15
- 16.
- 17.
- 18.
- 19.
- 20.
- 21.
- 22.
- 23.
- 24.
- 25.
- 26.
- 27.
- 28.
- 29.
- 30.
- 31.
- 32.
- 33.
- 34.
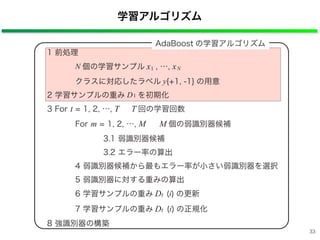
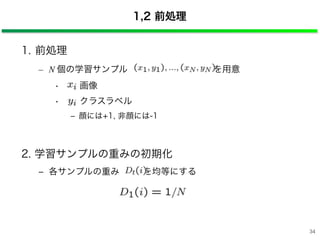
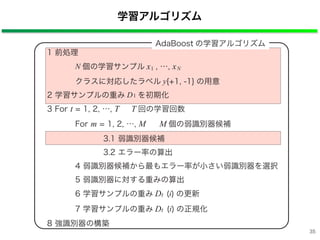
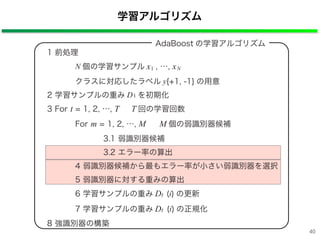
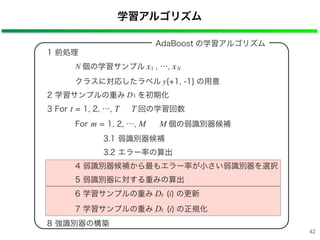
1,2 前処理
1. 前処理
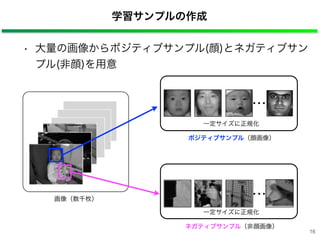
–N 個の学習サンプル を用意
• : 画像
• : クラスラベル
‒ 顔には+1, 非顔には-1
2. 学習サンプルの重みの初期化
‒ 各サンプルの重み を均等にする
34
- 35.
- 36.
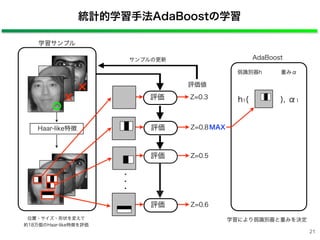
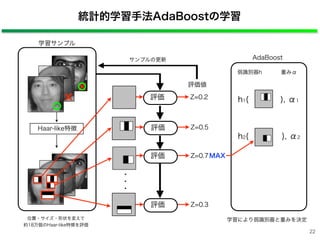
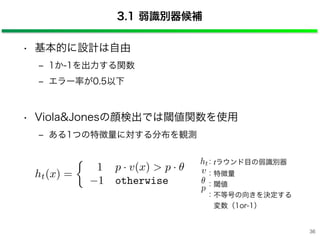
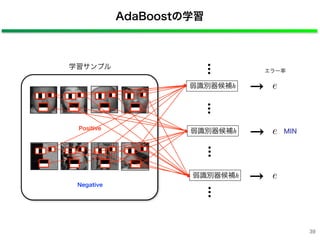
3.1 弱識別器候補
• 基本的に設計は自由
‒1か-1を出力する関数
‒ エラー率が0.5以下
• Viola&Jonesの顔検出では閾値関数を使用
‒ ある1つの特徴量に対する分布を観測
v
p
ht:tラウンド目の弱識別器
:特徴量
:閾値
:不等号の向きを決定する
変数(1or-1)
ht(x) =
1 p · v(x) > p ·
1 otherwise
36
- 37.
- 38.
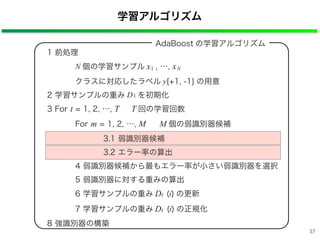
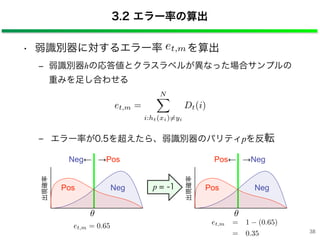
• 弱識別器に対するエラー率 を算出
‒弱識別器hの応答値とクラスラベルが異なった場合サンプルの
重みを足し合わせる
‒ エラー率が0.5を超えたら、弱識別器のパリティpを反転
3.2 エラー率の算出
et,m =
N
i:ht(xi)=yi
Dt(i)
Neg← →Pos
出現確率
p = -1
Pos← →Neg
出現確率
et,m
Pos Neg Pos Neg
et,m = 0.65 et,m = 1 (0.65)
= 0.35 38
- 39.
- 40.
- 41.
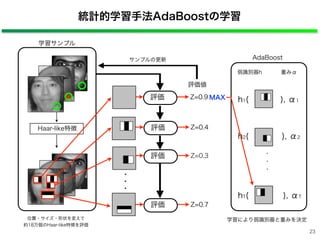
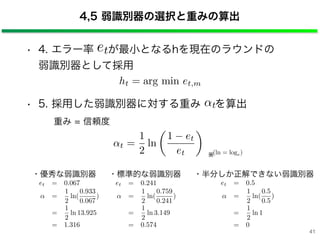
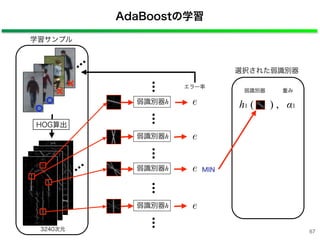
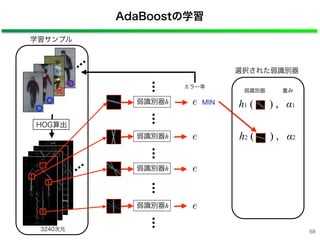
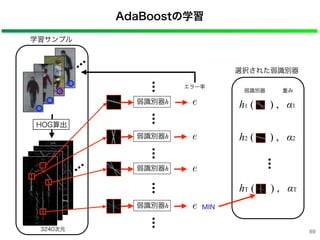
• 4. エラー率が最小となるhを現在のラウンドの
弱識別器として採用
• 5. 採用した弱識別器に対する重み を算出
重み = 信頼度
4,5 弱識別器の選択と重みの算出
ht = arg min et,m
t =
1
2
ln
1 et
et
⇥
t
(ln = loge)
※
et = 0.067
=
1
2
ln(
0.933
0.067
)
=
1
2
ln 13.925
= 1.316
・優秀な弱識別器
et = 0.241
=
1
2
ln(
0.759
0.241
)
=
1
2
ln 3.149
= 0.574
・標準的な弱識別器
et = 0.5
=
1
2
ln(
0.5
0.5
)
=
1
2
ln 1
= 0
・半分しか正解できない弱識別器
et
41
- 42.
- 43.
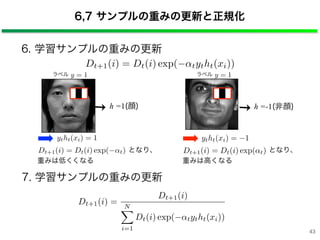
6. 学習サンプルの重みの更新
6,7 サンプルの重みの更新と正規化
Dt+1(i)= Dt(i) exp( tytht(xi))
Dt+1(i) =
Dt+1(i)
N
i=1
Dt(i) exp( tytht(xi))
h =1(顔) h =-1(非顔)
y = 1ラベルy = 1ラベル
ytht(xi) = 1 ytht(xi) = 1
となり、
重みは低くくなる
Dt+1(i) = Dt(i) exp( t) となり、
重みは高くなる
Dt+1(i) = Dt(i) exp( t)
43
7. 学習サンプルの重みの更新
- 44.
- 45.
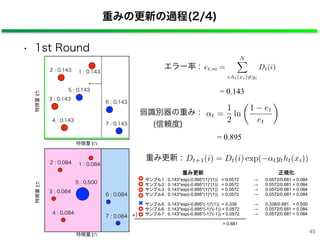
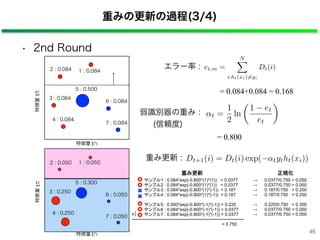
重みの更新の過程(2/4)
• 1st Round
1: 0.1432 : 0.143
3 : 0.143
4 : 0.143
5 : 0.143
6 : 0.143
7 : 0.143
et,m =
N
i:ht(xi)=yi
Dt(i)エラー率 :
= 0.143
t =
1
2
ln
1 et
et
⇥
弱識別器の重み :
(信頼度)
= 0.895
特徴量 1v
特徴量2v
1 : 0.0842 : 0.084
3 : 0.084
4 : 0.084
5 : 0.500
6 : 0.084
7 : 0.084
特徴量 1v
特徴量2v
Dt+1(i) = Dt(i) exp( tytht(xi))
サンプル1 : 0.143*exp(-0.895*(1)*(1)) = 0.0572
サンプル2 : 0.143*exp(-0.895*(1)*(1)) = 0.0572
サンプル3 : 0.143*exp(-0.895*(1)*(1)) = 0.0572
サンプル4 : 0.143*exp(-0.895*(1)*(1)) = 0.0572
サンプル5 : 0.143*exp(-0.895*(-1)*(1)) = 0.338
サンプル6 : 0.143*exp(-0.895*(-1)*(-1)) = 0.0572
サンプル7 : 0.143*exp(-0.895*(-1)*(-1)) = 0.0572
= 0.681
+)
→ 0.0572/0.681 = 0.084
→ 0.0572/0.681 = 0.084
→ 0.0572/0.681 = 0.084
→ 0.0572/0.681 = 0.084
→ 0.338/0.681 = 0.500
→ 0.0572/0.681 = 0.084
→ 0.0572/0.681 = 0.084
重み更新 :
重み更新 正規化
45
- 46.
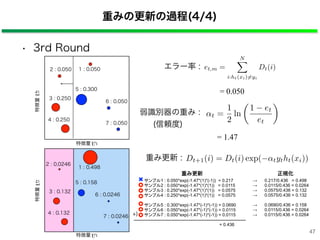
et,m =
N
i:ht(xi)=yi
Dt(i)エラー率 :
=0.084+0.084 = 0.168
t =
1
2
ln
1 et
et
⇥
弱識別器の重み :
(信頼度)
= 0.800
1 : 0.0842 : 0.084
3 : 0.084
4 : 0.084
5 : 0.500
6 : 0.084
7 : 0.084
特徴量 1v
特徴量2v
特徴量 1v
1 : 0.0502 : 0.050
3 : 0.250
4 : 0.250
5 : 0.300
6 : 0.050
7 : 0.050
特徴量2v
サンプル1 : 0.084*exp(-0.800*(1)*(1)) = 0.0377
サンプル2 : 0.084*exp(-0.800*(1)*(1)) = 0.0377
サンプル3 : 0.084*exp(-0.800*(1)*(-1)) = 0.187
サンプル4 : 0.084*exp(-0.800*(1)*(-1)) = 0.187
サンプル5 : 0.500*exp(-0.800*(-1)*(-1)) = 0.225
サンプル6 : 0.084*exp(-0.800*(-1)*(-1)) = 0.0377
サンプル7 : 0.084*exp(-0.800*(-1)*(-1)) = 0.0377
= 0.750
+)
→ 0.0377/0.750 = 0.050
→ 0.0377/0.750 = 0.050
→ 0.187/0.750 = 0.250
→ 0.187/0.750 = 0.250
→ 0.225/0.750 = 0.300
→ 0.0377/0.750 = 0.050
→ 0.0377/0.750 = 0.050
重み更新 正規化
重みの更新の過程(3/4)
46
• 2nd Round
Dt+1(i) = Dt(i) exp( tytht(xi))重み更新 :
- 47.
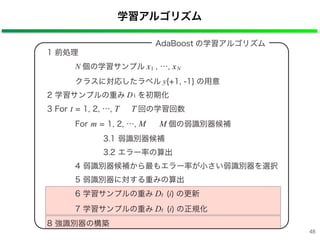
et,m =
N
i:ht(xi)=yi
Dt(i)エラー率 :
=0.050
t =
1
2
ln
1 et
et
⇥
弱識別器の重み :
(信頼度)
= 1.47
1 : 0.0502 : 0.050
3 : 0.250
4 : 0.250
5 : 0.300
6 : 0.050
7 : 0.050
特徴量 1v
特徴量2v
特徴量 1v
特徴量2v
1 : 0.498
2 : 0.0246
3 : 0.132
4 : 0.132
5 : 0.158
6 : 0.0246
7 : 0.0246
サンプル1 : 0.050*exp(-1.47*(1)*(-1)) = 0.217
サンプル2 : 0.050*exp(-1.47*(1)*(1)) = 0.0115
サンプル3 : 0.250*exp(-1.47*(1)*(1)) = 0.0575
サンプル4 : 0.250*exp(-1.47*(1)*(1)) = 0.0575
サンプル5 : 0.300*exp(-1.47*(-1)*(-1)) = 0.0690
サンプル6 : 0.050*exp(-1.47*(-1)*(-1)) = 0.0115
サンプル7 : 0.050*exp(-1.47*(-1)*(-1)) = 0.0115
= 0.436
+)
→ 0.217/0.436 = 0.498
→ 0.0115/0.436 = 0.0264
→ 0.0575/0.436 = 0.132
→ 0.0575/0.436 = 0.132
→ 0.0690/0.436 = 0.158
→ 0.0115/0.436 = 0.0264
→ 0.0115/0.436 = 0.0264
重み更新 正規化
重みの更新の過程(4/4)
47
• 3rd Round
Dt+1(i) = Dt(i) exp( tytht(xi))重み更新 :
- 48.
- 49.
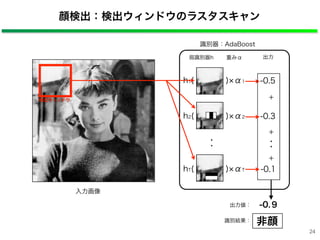
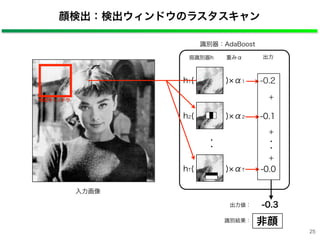
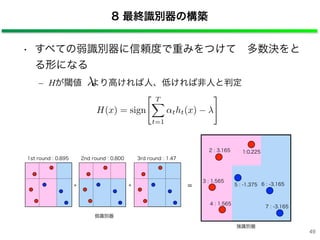
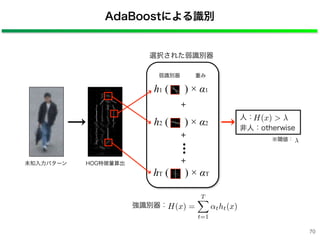
8 最終識別器の構築
• すべての弱識別器に信頼度で重みをつけて 多数決をと
る形になる
–Hが閾値 より高ければ人、低ければ非人と判定
H(x) = sign
T⇤
t=1
tht(x) ⇥
⇥
1st round : 0.895 2nd round : 0.800 3rd round : 1.47
1:0.2252 : 3.165
3 : 1.565
4 : 1.565
5 : -1.375 6 : -3.165
7 : -3.165
弱識別器
強識別器
+ + =
49
- 50.
- 51.
- 52.
- 53.
- 54.
- 55.
- 56.
- 57.
- 58.
- 59.
- 60.
- 61.
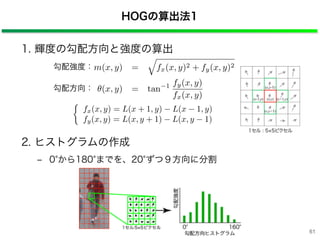
HOGの算出法1
1. 輝度の勾配方向と強度の算出
2. ヒストグラムの作成
‒0 から180 までを、20 ずつ9方向に分割
fx(x, y) = L(x + 1, y) L(x 1, y)
fy(x, y) = L(x, y + 1) L(x, y 1)
m(x, y) = fx(x, y)2 + fy(x, y)2
(x, y) = tan 1 fy(x, y)
fx(x, y)
勾配強度:
勾配方向:
61
- 62.
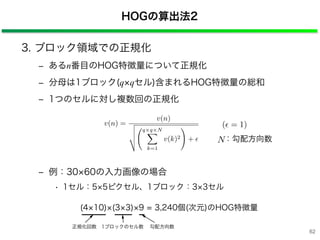
HOGの算出法2
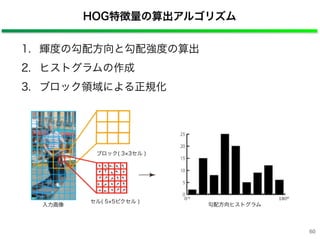
3. ブロック領域での正規化
‒ あるn番目のHOG特徴量について正規化
‒分母は1ブロック(q qセル)含まれるHOG特徴量の総和
‒ 1つのセルに対し複数回の正規化
‒ 例:30 60の入力画像の場合
• 1セル:5 5ピクセル、1ブロック:3 3セル
v(n) =
v(n)
⌃
⇧
⇧
⌅
q q N⇤
k=1
v(k)2
⇥
+
( = 1)
N:勾配方向数
(4 10) (3 3) 9 = 3,240個(次元)のHOG特徴量
正規化回数 1ブロックのセル数 勾配方向数
62
- 63.
- 64.
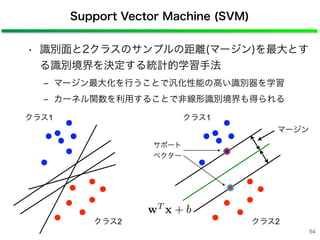
Support Vector Machine(SVM)
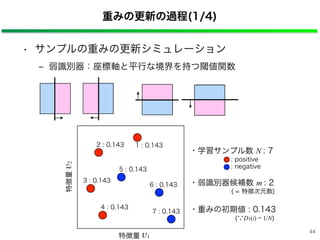
• 識別面と2クラスのサンプルの距離(マージン)を最大とす
る識別境界を決定する統計的学習手法
‒ マージン最大化を行うことで汎化性能の高い識別器を学習
‒ カーネル関数を利用することで非線形識別境界も得られる
64
クラス1
クラス2
クラス1
クラス2
マージン
サポート
ベクター
- 65.
- 66.
- 67.
- 68.
- 69.
- 70.
- 71.
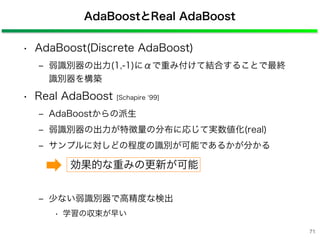
AdaBoostとReal AdaBoost
• AdaBoost(DiscreteAdaBoost)
‒ 弱識別器の出力(1,-1)にαで重み付けて結合することで最終
識別器を構築
• Real AdaBoost [Schapire 99]
‒ AdaBoostからの派生
‒ 弱識別器の出力が特徴量の分布に応じて実数値化(real)
‒ サンプルに対しどの程度の識別が可能であるかが分かる
‒ 少ない弱識別器で高精度な検出
• 学習の収束が早い
効果的な重みの更新が可能
71
- 72.
- 73.
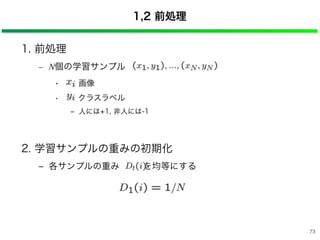
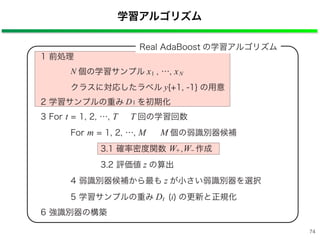
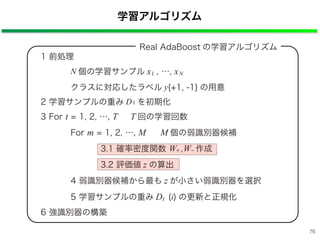
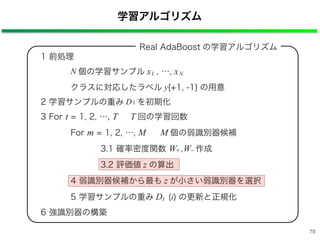
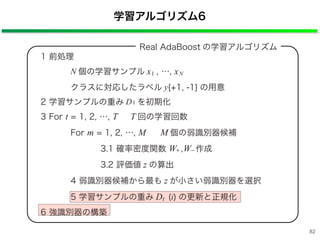
1,2 前処理
1. 前処理
–N個の学習サンプル
• : 画像
• : クラスラベル
‒ 人には+1, 非人には-1
2. 学習サンプルの重みの初期化
‒ 各サンプルの重み を均等にする
73
- 74.
- 75.
- 76.
- 77.
- 78.
- 79.
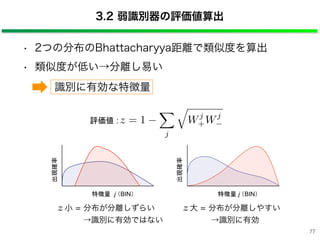
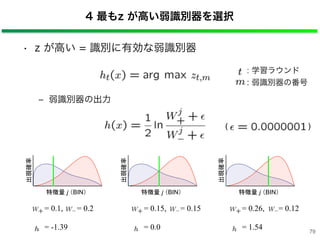
= 0.15, =0.15
= 0.0
4 最もz が高い弱識別器を選択
• z が高い = 識別に有効な弱識別器
‒ 弱識別器の出力
: 学習ラウンド
: 弱識別器の番号
( )
= 0.1, = 0.2
= -1.39
= 0.26, = 0.12
= 1.54
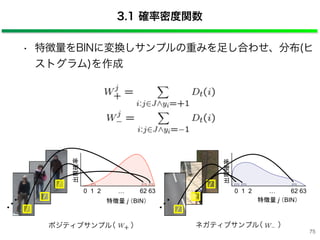
出現確率
特徴量 j (BIN)
出現確率
特徴量 j (BIN)
出現確率
特徴量 j (BIN)
79
- 80.
- 81.
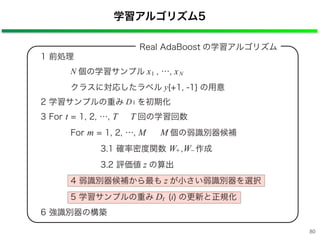
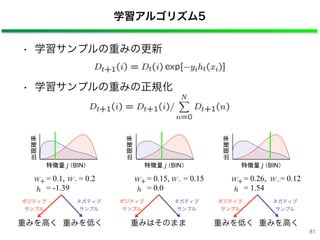
• 学習サンプルの重みの更新
• 学習サンプルの重みの正規化
学習アルゴリズム5
=0.15, = 0.15
= 0.0
= 0.1, = 0.2
= -1.39
= 0.26, = 0.12
= 1.54
出現確率
特徴量 j (BIN)
出現確率
特徴量 j (BIN)
出現確率
特徴量 j (BIN)
ポジティブ
サンプル
ネガティブ
サンプル
重みを高く 重みを低く
ポジティブ
サンプル
ネガティブ
サンプル
重みを低く 重みを高く
ポジティブ
サンプル
ネガティブ
サンプル
重みはそのまま
81
- 82.
- 83.
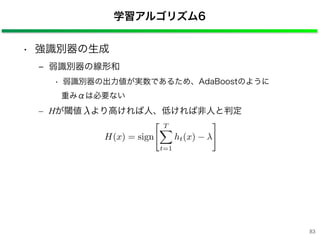
• 強識別器の生成
‒ 弱識別器の線形和
•弱識別器の出力値が実数であるため、AdaBoostのように
重みαは必要ない
– Hが閾値 より高ければ人、低ければ非人と判定
学習アルゴリズム6
H(x) = sign
T⇤
t=1
ht(x)
⇥
83
- 84.
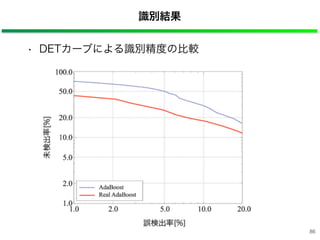
識別実験
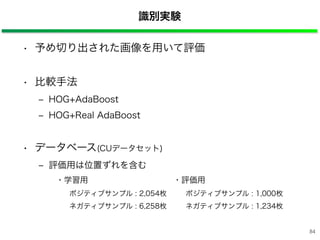
• 予め切り出された画像を用いて評価
• 比較手法
‒HOG+AdaBoost
‒ HOG+Real AdaBoost
• データベース(CUデータセット)
‒ 評価用は位置ずれを含む
・学習用 ・評価用
ポジティブサンプル : 2,054枚 ポジティブサンプル : 1,000枚
ネガティブサンプル : 6,258枚 ネガティブサンプル : 1,234枚
84
- 85.
評価方法
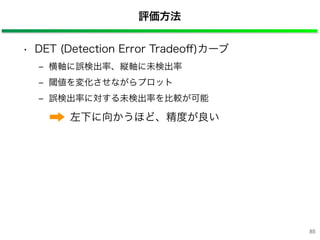
• DET (DetectionError Tradeoff)カーブ
‒ 横軸に誤検出率、縦軸に未検出率
‒ 閾値を変化させながらプロット
‒ 誤検出率に対する未検出率を比較が可能
左下に向かうほど、精度が良い
85
- 86.
- 87.
- 88.
- 89.
- 90.
- 91.
- 92.
- 93.
- 94.
- 95.
- 96.
- 97.
- 98.
- 99.
Real AdaBoostのソースコード
• RealAdaBoost + HOG
‒ URL : http://www.vision.cs.chubu.ac.jp/CVTutorial/
• 入力画像からHOG特徴量を算出し,2クラス識別器を構築
‒ Dataset : CU-Dataset
‒ 作成環境 : Visual Studio ver. 2005
‒ ライブラリ : OpenCV
99
- 100.