Skip to main content
Recommended
PDF
Active Learning の基礎と最近の研究
PDF
深層学習の不確実性 - Uncertainty in Deep Neural Networks -
PDF
Bayesian Neural Networks : Survey
PPTX
PDF
最近のDeep Learning (NLP) 界隈におけるAttention事情
PPTX
Curriculum Learning (関東CV勉強会)
PPTX
PDF
[DL輪読会]Understanding Black-box Predictions via Influence Functions
PDF
【メタサーベイ】基盤モデル / Foundation Models
PPTX
PPTX
PDF
PDF
PDF
PDF
PDF
PPTX
猫でも分かるVariational AutoEncoder
PDF
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法
PPTX
SSII2020SS: グラフデータでも深層学習 〜 Graph Neural Networks 入門 〜
PPTX
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
PPTX
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
PDF
SSII2021 [TS2] 深層強化学習 〜 強化学習の基礎から応用まで 〜
PDF
PDF
PPTX
[DL輪読会]Neural Ordinary Differential Equations
PPTX
【DL輪読会】ViT + Self Supervised Learningまとめ
PDF
PPTX
【DL輪読会】High-Resolution Image Synthesis with Latent Diffusion Models
PDF
PDF
More Related Content
PDF
Active Learning の基礎と最近の研究
PDF
深層学習の不確実性 - Uncertainty in Deep Neural Networks -
PDF
Bayesian Neural Networks : Survey
PPTX
PDF
最近のDeep Learning (NLP) 界隈におけるAttention事情
PPTX
Curriculum Learning (関東CV勉強会)
PPTX
PDF
[DL輪読会]Understanding Black-box Predictions via Influence Functions
What's hot
PDF
【メタサーベイ】基盤モデル / Foundation Models
PPTX
PPTX
PDF
PDF
PDF
PDF
PDF
PPTX
猫でも分かるVariational AutoEncoder
PDF
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法
PPTX
SSII2020SS: グラフデータでも深層学習 〜 Graph Neural Networks 入門 〜
PPTX
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
PPTX
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
PDF
SSII2021 [TS2] 深層強化学習 〜 強化学習の基礎から応用まで 〜
PDF
PDF
PPTX
[DL輪読会]Neural Ordinary Differential Equations
PPTX
【DL輪読会】ViT + Self Supervised Learningまとめ
PDF
PPTX
【DL輪読会】High-Resolution Image Synthesis with Latent Diffusion Models
Viewers also liked
PDF
PDF
PDF
PDF
Matrix Factorizationを使った評価予測
PDF
PPTX
PDF
PDF
PDF
Lyric Jumper:アーティストごとの歌詞トピックの傾向に基づく歌詞探索サービス
PPTX
Jap2017 ss65 優しいベイズ統計への導入法
PDF
PDF
多腕バンディット問題: 定式化と応用 (第13回ステアラボ人工知能セミナー)
PDF
日本音響学会2017秋 ビギナーズセミナー "深層学習を深く学習するための基礎"
PPTX
PDF
PDF
VentureCafe_第2回:SIerでのキャリアパスを考える_ござ先輩発表資料 V1.0
PPTX
PDF
PDF
PDF
Similar to Active Learning 入門
PDF
Active learning with efficient feature weighting methods for improving data q...
PPTX
Active Learning と Bayesian Neural Network
PDF
オンライン凸最適化と線形識別モデル学習の最前線_IBIS2011
PDF
PDF
no_bayes_no_life_nb_keep_evolving
PDF
正則化による尤度比推定法を応用した多値分類器の改良
PDF
Semi-supervised Active Learning Survey
PDF
Jubatusにおける大規模分散オンライン機械学習
PDF
PDF
PDF
PDF
Introduction to ensemble methods for beginners
PPTX
PPTX
[DL輪読会] “Asymmetric Tri-training for Unsupervised Domain Adaptation (ICML2017...
PDF
PDF
2013.07.15 はじパタlt scikit-learnで始める機械学習
PDF
PDF
PDF
PDF
More from Shuyo Nakatani
PDF
画像をテキストで検索したい!(OpenAI CLIP) - VRC-LT #15
PDF
Generative adversarial networks
PDF
無限関係モデル (続・わかりやすいパターン認識 13章)
PDF
Memory Networks (End-to-End Memory Networks の Chainer 実装)
PDF
PDF
RとStanでクラウドセットアップ時間を分析してみたら #TokyoR
PDF
PDF
[Yang, Downey and Boyd-Graber 2015] Efficient Methods for Incorporating Knowl...
PDF
PDF
PDF
言語処理するのに Python でいいの? #PyDataTokyo
PDF
Zipf? (ジップ則のひみつ?) #DSIRNLP
PDF
ACL2014 Reading: [Zhang+] "Kneser-Ney Smoothing on Expected Count" and [Pickh...
PDF
PDF
PDF
アラビア語とペルシャ語の見分け方 #DSIRNLP 5
PDF
どの言語でつぶやかれたのか、機械が知る方法 #WebDBf2013
PDF
数式を綺麗にプログラミングするコツ #spro2013
PDF
PDF
[Kim+ ICML2012] Dirichlet Process with Mixed Random Measures : A Nonparametri...
Active Learning 入門 1. 2. 3. References
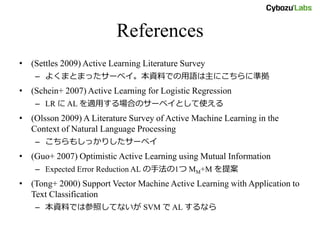
• (Settles 2009) Active Learning Literature Survey
– よくまとまったサーベイ。本資料での用語は主にこちらに準拠
• (Schein+ 2007) Active Learning for Logistic Regression
– LR に AL を適用する場合のサーベイとして使える
• (Olsson 2009) A Literature Survey of Active Machine Learning in the
Context of Natural Language Processing
– こちらもしっかりしたサーベイ
• (Guo+ 2007) Optimistic Active Learning using Mutual Information
– Expected Error Reduction AL の手法の1つ MM+M を提案
• (Tong+ 2000) Support Vector Machine Active Learning with Application to
Text Classification
– 本資料では参照してないが SVM で AL するなら
4. 5. 6. 7. Active Learning (能動学習)
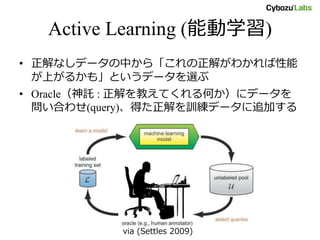
• 正解なしデータの中から「これの正解がわかれば性能
が上がるかも」というデータを選ぶ
• Oracle(神託 : 正解を教えてくれる何か)にデータを
問い合わせ(query)、得た正解を訓練データに追加する
via (Settles 2009)
8. 9. 10. 11. 12. 13. 14. Active Learning の分類 (Settles 2009)
• どこからデータを持ってくる?
– membership query synthesis
– stream-based selective sampling
– pool-based sampling
• どうやってデータを選ぶ?
– 戦略ごとに6つに分類
※ Active Learning の用語は必ずしもコンセンサスが取られていない。
論文によって異なる名前が使われていることもあるので注意
本資料は (Settles 2009) での名称を主に優先する
15. Active Learning のシナリオ
• membership query synthesis
– 正解を知りたいデータを新規に生成する
• stream-based selective sampling
– ストリームで流れてくるデータ1つ1つについて、
Oracle に問い合わせるかどうか判断する
• pool-based sampling
– 正解なしデータの pool から、次に問い合わせる
データを1つ選ぶ
16. query を選ぶ戦略
• 1. Uncertainly Sampling
• 2. Query-By-Committee
• 3. Expected Model Change
• 4. Expected Error Reduction
• 5. Variance Reduction
• 6. Density-Weighted Methods
1
2
3
4
17. 1. Uncertainly Sampling
• 「最も不確かなデータ」を選ぶ
– 現在のモデルでの予測確率が「あいまい」
– その正解がわかれば、モデルの不確かさは減るだ
ろう(期待感)
• 「不確かさ」をどうやって測る?
– 一番確率の高いラベルでも 0.5 しかない
– 一番確率の高いラベルと二番目との確率が近い
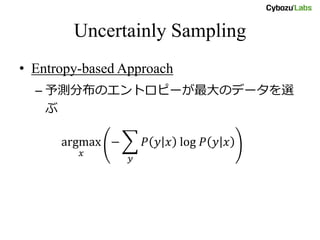
– エントロピー(不確かさの尺度)が大きい
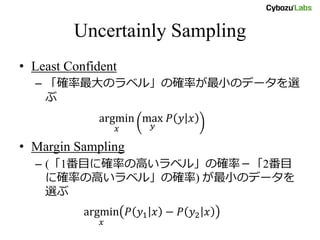
18. Uncertainly Sampling
• Least Confident
– 「確率最大のラベル」の確率が最小のデータを選
ぶ
argmin
𝑥
max
𝑦
𝑃 𝑦 𝑥
• Margin Sampling
– (「1番目に確率の高いラベル」の確率-「2番目
に確率の高いラベル」の確率) が最小のデータを
選ぶ
argmin
𝑥
𝑃 𝑦1 𝑥 − 𝑃 𝑦2 𝑥
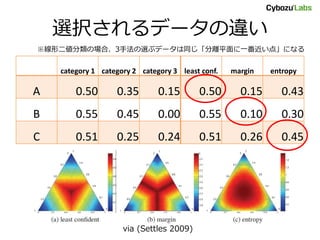
19. 20. 選択されるデータの違い
category 1 category 2 category 3 least conf. margin entropy
A 0.50 0.35 0.15 0.50 0.15 0.43
B 0.55 0.45 0.00 0.55 0.10 0.30
C 0.51 0.25 0.24 0.51 0.26 0.45
via (Settles 2009)
※線形二値分類の場合、3手法の選ぶデータは同じ「分離平面に一番近い点」になる
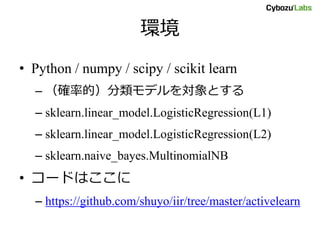
21. 22. 環境
• Python / numpy / scipy / scikit learn
– (確率的)分類モデルを対象とする
– sklearn.linear_model.LogisticRegression(L1)
– sklearn.linear_model.LogisticRegression(L2)
– sklearn.naive_bayes.MultinomialNB
• コードはここに
– https://github.com/shuyo/iir/tree/master/activelearn
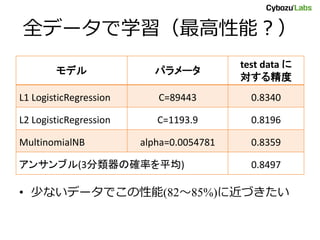
23. 24. 25. 全データで学習(最高性能?)
モデル パラメータ
test data に
対する精度
L1 LogisticRegression C=89443 0.8340
L2 LogisticRegression C=1193.9 0.8196
MultinomialNB alpha=0.0054781 0.8359
アンサンブル(3分類器の確率を平均) 0.8497
• 少ないデータでこの性能(82~85%)に近づきたい
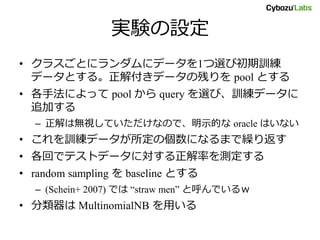
26. 実験の設定
• クラスごとにランダムにデータを1つ選び初期訓練
データとする。正解付きデータの残りを pool とする
• 各手法によって pool から query を選び、訓練データに
追加する
– 正解は無視していただけなので、明示的な oracle はいない
• これを訓練データが所定の個数になるまで繰り返す
• 各回でテストデータに対する正解率を測定する
• random sampling を baseline とする
– (Schein+ 2007) では “straw men” と呼んでいるw
• 分類器は MultinomialNB を用いる
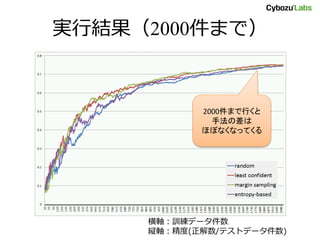
27. 28. 29. 30. 31. 32. 33. ぷちまとめ
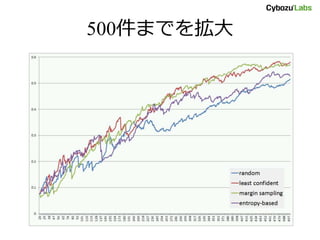
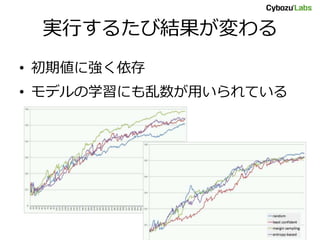
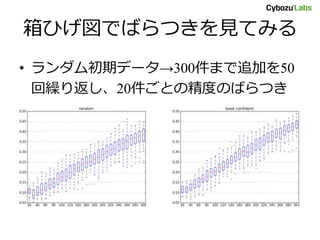
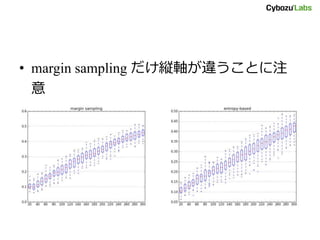
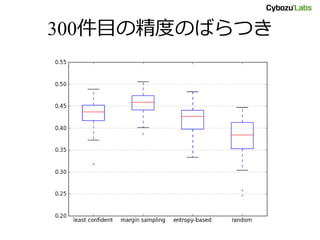
• margin sampling が安定かつ優秀
• entropy-based は期待はずれ
– random sampling を下回ることも
– 計算時間は一番多いのに……
• random sampling は総じて低調
– 瞬間風速なら他手法を圧倒することも
いろいろ伏線が……
34. 35. 36. 37. 実験の設定
• 基本は Uncertainly Sampling と同様
• 分類器は MultinomialNB, LogisticRegression
(L1 / L2) のアンサンブルとする
• random sampling と、平均分布に対する
margin sampling を baseline とする
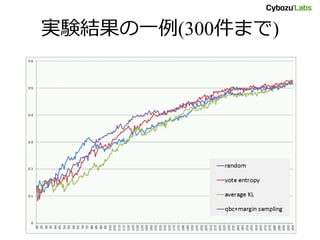
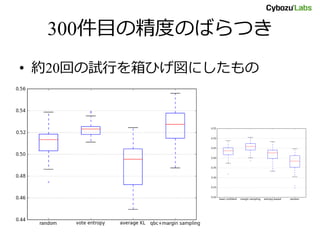
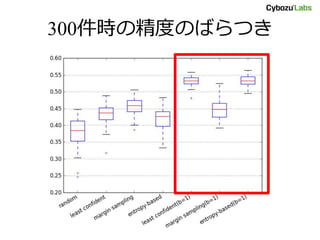
38. 39. 40. ぷちまとめ
• Uncertainly sampling よりばらつきが小さい
– でも random すら大幅に性能向上。ほぼアンサンブル
の恩恵か
– 分布の平均に対する margin sampling が最高性能……
– もう少し複雑な問題の方が効果が見込めるかも
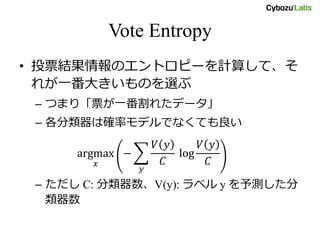
• Vote Entropy は確率モデルでなくてもOK
– 今回は試してないが SVM, Random Forest, ...
• Average KL Divergence が random より悪い
– バグ? 本質的な問題?(NB と LR の予測分布が似
てるわけない、みたいな)
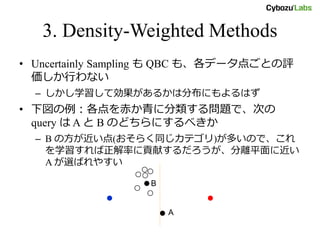
41. 3. Density-Weighted Methods
• Uncertainly Sampling も QBC も、各データ点ごとの評
価しか行わない
– しかし学習して効果があるかは分布にもよるはず
• 下図の例:各点を赤か青に分類する問題で、次の
query は A と B のどちらにするべきか
– B の方が近い点(おそらく同じカテゴリ)が多いので、これ
を学習すれば正解率に貢献するだろうが、分離平面に近い
A が選ばれやすい
A
B
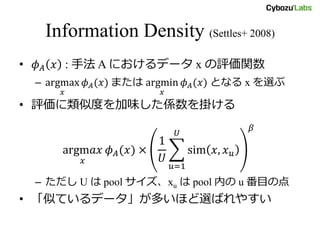
42. Information Density (Settles+ 2008)
• 𝜙 𝐴 𝑥 : 手法 A におけるデータ x の評価関数
– argmax
𝑥
𝜙 𝐴(𝑥) または argmin
𝑥
𝜙 𝐴(𝑥) となる x を選ぶ
• 評価に類似度を加味した係数を掛ける
argm𝑎𝑥
𝑥
𝜙 𝐴(𝑥) ×
1
𝑈
sim 𝑥, 𝑥 𝑢
𝑈
𝑢=1
𝛽
– ただし U は pool サイズ、xu は pool 内の u 番目の点
• 「似ているデータ」が多いほど選ばれやすい
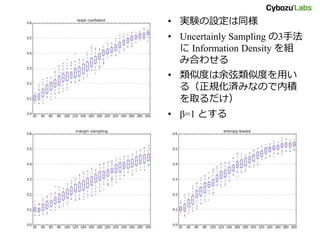
43. 44. 45. ぷちまとめ
• Information Density は低コストながら効果大
– 特に entropy-based と組み合わせたときの性能は目を
見張るものが
– 類似度を導入可能なら選択肢の一つに
• least confident + ID は、序盤は低性能だがある程度
データが増えると entropy-based 並に良くなる印象
• margin sampling + ID はなぜか良くない……
• βをどのように決めるかが課題か
46. 47. Active Learning への不満
• 瞬間的に random sampling が他の手法を上
回ることも決して珍しくない
– 「最適な query」を選べていない
• もし「最適な query 」を選び続けることが
できたら、どれくらいの性能が出るんだ
ろう?
– 正解と test data を知っていれば……!
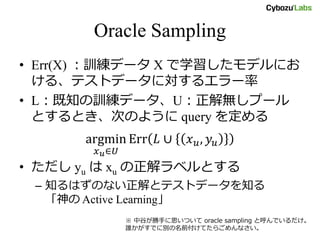
48. Oracle Sampling
• Err(X) :訓練データ X で学習したモデルにお
ける、テストデータに対するエラー率
• L:既知の訓練データ、U:正解無しプール
とするとき、次のように query を定める
argmin
𝑥 𝑢∈𝑈
Err 𝐿 ∪ 𝑥 𝑢, 𝑦𝑢
• ただし yu は xu の正解ラベルとする
– 知るはずのない正解とテストデータを知る
「神の Active Learning」
※ 中谷が勝手に思いついて oracle sampling と呼んでいるだけ。
誰かがすでに別の名前付けてたらごめんなさい。
49. 50. 51. 52. 53. 4. Expected Error Reduction
• 未知である正解とテストデータをどうするか
– test set と development set に分ける手もあるけど
• そもそも訓練データ不足だから active learning がしたい
• 貴重な正解をテストに回すのすらもったいない
• 置き換え
– テストデータの誤差 → 期待誤差(risk)
– 正解ラベル → 推定値 or 期待値
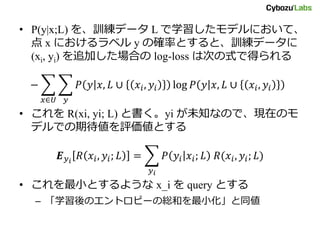
54. • P(y|x;L) を、訓練データ L で学習したモデルにおいて、
点 x におけるラベル y の確率とすると、訓練データに
(xi, yi) を追加した場合の log-loss は次の式で得られる
− 𝑃 𝑦 𝑥, 𝐿 ∪ 𝑥𝑖, 𝑦𝑖 log 𝑃 𝑦 𝑥, 𝐿 ∪ 𝑥𝑖, 𝑦𝑖
𝑦𝑥∈𝑈
• これを R(xi, yi; L) と書く。yi が未知なので、現在のモ
デルでの期待値を評価値とする
𝑬 𝑦 𝑖
𝑅 𝑥𝑖, 𝑦𝑖; 𝐿 = 𝑃 𝑦𝑖 𝑥𝑖; 𝐿 𝑅(𝑥𝑖, 𝑦𝑖; 𝐿)
𝑦 𝑖
• これを最小とするような x_i を query とする
– 「学習後のエントロピーの総和を最小化」と同値
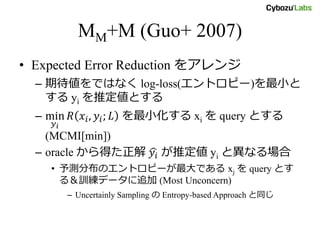
55. MM+M (Guo+ 2007)
• Expected Error Reduction をアレンジ
– 期待値をではなく log-loss(エントロピー)を最小と
する yi を推定値とする
– min
𝑦 𝑖
𝑅 𝑥𝑖, 𝑦𝑖; 𝐿 を最小化する xi を query とする
(MCMI[min])
– oracle から得た正解 𝑦𝑖 が推定値 yi と異なる場合
• 予測分布のエントロピーが最大である xj を query とす
る&訓練データに追加 (Most Unconcern)
– Uncertainly Sampling の Entropy-based Approach と同じ
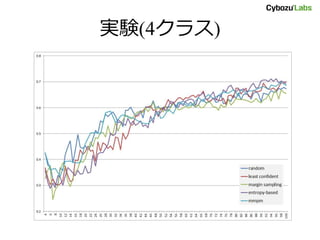
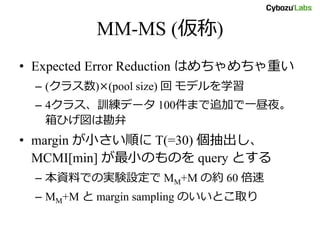
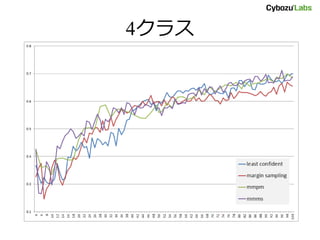
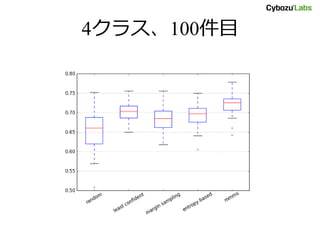
56. 57. MM-MS (仮称)
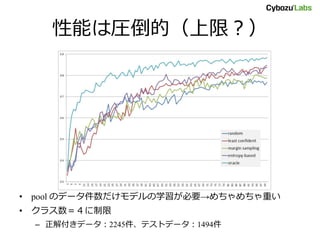
• Expected Error Reduction はめちゃめちゃ重い
– (クラス数)×(pool size) 回 モデルを学習
– 4クラス、訓練データ 100件まで追加で一昼夜。
箱ひげ図は勘弁
• margin が小さい順に T(=30) 個抽出し、
MCMI[min] が最小のものを query とする
– 本資料での実験設定で MM+M の約 60 倍速
– MM+M と margin sampling のいいとこ取り
58. 59. 60. まとめ
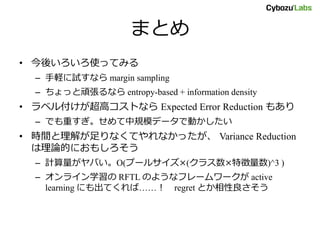
• 今後いろいろ使ってみる
– 手軽に試すなら margin sampling
– ちょっと頑張るなら entropy-based + information density
• ラベル付けが超高コストなら Expected Error Reduction もあり
– でも重すぎ。せめて中規模データで動かしたい
• 時間と理解が足りなくてやれなかったが、 Variance Reduction
は理論的におもしろそう
– 計算量がヤバい。O(プールサイズ×(クラス数×特徴量数)^3 )
– オンライン学習の RFTL のようなフレームワークが active
learning にも出てくれば……! regret とか相性良さそう

 Most read
 Most read