Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
sleepy_yoshi
PDF, PPTX
2,031 views
PRML復々習レーン#7 前回までのあらすじ
PRML復々習レーン#7 前回までのあらすじ の資料
Technology
◦
Read more
1
Save
Share
Embed
Save to Drive
Download now
Download as PDF, PPTX
1
/ 26
2
/ 26
3
/ 26
4
/ 26
5
/ 26
6
/ 26
7
/ 26
8
/ 26
9
/ 26
10
/ 26
11
/ 26
12
/ 26
13
/ 26
14
/ 26
15
/ 26
16
/ 26
17
/ 26
18
/ 26
19
/ 26
20
/ 26
More Related Content
PDF
PRML復々習レーン#9 前回までのあらすじ
by
sleepy_yoshi
29 slides
2.3K views
PDF
PRML復々習レーン#10 7.1.3-7.1.5
by
sleepy_yoshi
25 slides
2.8K views
PDF
PRML復々習レーン#3 3.1.3-3.1.5
by
sleepy_yoshi
21 slides
3.1K views
PDF
PRML4.3.3
by
sleepy_yoshi
41 slides
9.7K views
PDF
PRML復々習レーン#9 6.3-6.3.1
by
sleepy_yoshi
17 slides
2.4K views
PDF
ICML2013読み会: Distributed training of Large-scale Logistic models
by
sleepy_yoshi
33 slides
9.4K views
PDF
PRML復々習レーン#15 前回までのあらすじ
by
sleepy_yoshi
16 slides
4K views
PPTX
Back propagation
by
T2C_
19 slides
2.4K views
PRML復々習レーン#9 前回までのあらすじ
by
sleepy_yoshi
29 slides
2.3K views
PRML復々習レーン#10 7.1.3-7.1.5
by
sleepy_yoshi
25 slides
2.8K views
PRML復々習レーン#3 3.1.3-3.1.5
by
sleepy_yoshi
21 slides
3.1K views
PRML4.3.3
by
sleepy_yoshi
41 slides
9.7K views
PRML復々習レーン#9 6.3-6.3.1
by
sleepy_yoshi
17 slides
2.4K views
ICML2013読み会: Distributed training of Large-scale Logistic models
by
sleepy_yoshi
33 slides
9.4K views
PRML復々習レーン#15 前回までのあらすじ
by
sleepy_yoshi
16 slides
4K views
Back propagation
by
T2C_
19 slides
2.4K views
What's hot
PPTX
PRML Chapter 5
by
Masahito Ohue
50 slides
15.8K views
PDF
PRML_from5.1to5.3.1
by
禎晃 山崎
76 slides
377 views
PDF
SMO徹底入門 - SVMをちゃんと実装する
by
sleepy_yoshi
49 slides
32K views
PDF
PRML復々習レーン#2 2.3.6 - 2.3.7
by
sleepy_yoshi
59 slides
4K views
PDF
PRML 6.4-6.5
by
正志 坪坂
26 slides
3.6K views
PPTX
W8PRML5.1-5.3
by
Masahito Ohue
50 slides
6.7K views
PDF
PRML Chapter 14
by
Masahito Ohue
65 slides
7.7K views
PDF
Deeplearning4.4 takmin
by
Takuya Minagawa
57 slides
10.5K views
PPTX
RBMを応用した事前学習とDNN学習
by
Masayuki Tanaka
58 slides
6.1K views
PPTX
PRML第6章「カーネル法」
by
Keisuke Sugawara
61 slides
29.7K views
PDF
深層学習(講談社)のまとめ 第4章
by
okku apot
8 slides
580 views
PDF
prml_titech_9.0-9.2
by
Taikai Takeda
28 slides
1.1K views
PDF
PRML勉強会@長岡 第4章線形識別モデル
by
Shohei Okada
76 slides
4.8K views
PDF
(文献紹介) 画像復元:Plug-and-Play ADMM
by
Morpho, Inc.
31 slides
3.6K views
PDF
PRML 4.1 Discriminant Function
by
Shintaro Takemura
30 slides
5.4K views
PDF
(文献紹介)Deep Unrolling: Learned ISTA (LISTA)
by
Morpho, Inc.
40 slides
7.3K views
PDF
スパースモデリング、スパースコーディングとその数理(第11回WBA若手の会)
by
narumikanno0918
107 slides
135.2K views
PDF
(文献紹介)エッジ保存フィルタ:Side Window Filter, Curvature Filter
by
Morpho, Inc.
26 slides
2.9K views
PDF
Prml 10 1
by
正志 坪坂
42 slides
4.8K views
PDF
正則化つき線形モデル(「入門機械学習第6章」より)
by
Eric Sartre
36 slides
49.1K views
PRML Chapter 5
by
Masahito Ohue
50 slides
15.8K views
PRML_from5.1to5.3.1
by
禎晃 山崎
76 slides
377 views
SMO徹底入門 - SVMをちゃんと実装する
by
sleepy_yoshi
49 slides
32K views
PRML復々習レーン#2 2.3.6 - 2.3.7
by
sleepy_yoshi
59 slides
4K views
PRML 6.4-6.5
by
正志 坪坂
26 slides
3.6K views
W8PRML5.1-5.3
by
Masahito Ohue
50 slides
6.7K views
PRML Chapter 14
by
Masahito Ohue
65 slides
7.7K views
Deeplearning4.4 takmin
by
Takuya Minagawa
57 slides
10.5K views
RBMを応用した事前学習とDNN学習
by
Masayuki Tanaka
58 slides
6.1K views
PRML第6章「カーネル法」
by
Keisuke Sugawara
61 slides
29.7K views
深層学習(講談社)のまとめ 第4章
by
okku apot
8 slides
580 views
prml_titech_9.0-9.2
by
Taikai Takeda
28 slides
1.1K views
PRML勉強会@長岡 第4章線形識別モデル
by
Shohei Okada
76 slides
4.8K views
(文献紹介) 画像復元:Plug-and-Play ADMM
by
Morpho, Inc.
31 slides
3.6K views
PRML 4.1 Discriminant Function
by
Shintaro Takemura
30 slides
5.4K views
(文献紹介)Deep Unrolling: Learned ISTA (LISTA)
by
Morpho, Inc.
40 slides
7.3K views
スパースモデリング、スパースコーディングとその数理(第11回WBA若手の会)
by
narumikanno0918
107 slides
135.2K views
(文献紹介)エッジ保存フィルタ:Side Window Filter, Curvature Filter
by
Morpho, Inc.
26 slides
2.9K views
Prml 10 1
by
正志 坪坂
42 slides
4.8K views
正則化つき線形モデル(「入門機械学習第6章」より)
by
Eric Sartre
36 slides
49.1K views
Similar to PRML復々習レーン#7 前回までのあらすじ
PDF
PRML5
by
Hidekazu Oiwa
76 slides
8.5K views
PDF
PRML 5.2.1-5.3.3 ニューラルネットワークの学習 (誤差逆伝播) / Training Neural Networks (Backpropa...
by
Akihiro Nitta
41 slides
689 views
PDF
PRML Chapter 5 (5.0-5.4)
by
Shogo Nakamura
43 slides
135 views
PDF
Crfと素性テンプレート
by
Kei Uchiumi
50 slides
53.8K views
PDF
2013.12.26 prml勉強会 線形回帰モデル3.2~3.4
by
Takeshi Sakaki
39 slides
6K views
PDF
パターン認識と機械学習6章(カーネル法)
by
Yukara Ikemiya
30 slides
29.7K views
PDF
東京都市大学 データ解析入門 6 回帰分析とモデル選択 1
by
hirokazutanaka
41 slides
882 views
PDF
【Zansa】第12回勉強会 -PRMLからベイズの世界へ
by
Zansa
22 slides
8.5K views
PDF
FOBOS
by
Hidekazu Oiwa
43 slides
10K views
ZIP
今さら聞けないカーネル法とサポートベクターマシン
by
Shinya Shimizu
56 slides
132.5K views
PPTX
Prml 1.3~1.6 ver3
by
Toshihiko Iio
76 slides
9.7K views
PDF
PRML 10.4 - 10.6
by
Akira Miyazawa
74 slides
1.6K views
PDF
PRML輪読#4
by
matsuolab
43 slides
10.1K views
PDF
回帰
by
Shin Asakawa
21 slides
630 views
PDF
[DL輪読会]Scalable Training of Inference Networks for Gaussian-Process Models
by
Deep Learning JP
33 slides
3.7K views
PPTX
ラビットチャレンジレポート 機械学習
by
ssuserf4860b
46 slides
142 views
PDF
PRML ベイズロジスティック回帰
by
hagino 3000
21 slides
5.2K views
PDF
東京都市大学 データ解析入門 7 回帰分析とモデル選択 2
by
hirokazutanaka
37 slides
611 views
PPTX
SVM
by
Yuki Nakayama
23 slides
1.2K views
PDF
Unified Expectation Maximization
by
Koji Matsuda
23 slides
3K views
PRML5
by
Hidekazu Oiwa
76 slides
8.5K views
PRML 5.2.1-5.3.3 ニューラルネットワークの学習 (誤差逆伝播) / Training Neural Networks (Backpropa...
by
Akihiro Nitta
41 slides
689 views
PRML Chapter 5 (5.0-5.4)
by
Shogo Nakamura
43 slides
135 views
Crfと素性テンプレート
by
Kei Uchiumi
50 slides
53.8K views
2013.12.26 prml勉強会 線形回帰モデル3.2~3.4
by
Takeshi Sakaki
39 slides
6K views
パターン認識と機械学習6章(カーネル法)
by
Yukara Ikemiya
30 slides
29.7K views
東京都市大学 データ解析入門 6 回帰分析とモデル選択 1
by
hirokazutanaka
41 slides
882 views
【Zansa】第12回勉強会 -PRMLからベイズの世界へ
by
Zansa
22 slides
8.5K views
FOBOS
by
Hidekazu Oiwa
43 slides
10K views
今さら聞けないカーネル法とサポートベクターマシン
by
Shinya Shimizu
56 slides
132.5K views
Prml 1.3~1.6 ver3
by
Toshihiko Iio
76 slides
9.7K views
PRML 10.4 - 10.6
by
Akira Miyazawa
74 slides
1.6K views
PRML輪読#4
by
matsuolab
43 slides
10.1K views
回帰
by
Shin Asakawa
21 slides
630 views
[DL輪読会]Scalable Training of Inference Networks for Gaussian-Process Models
by
Deep Learning JP
33 slides
3.7K views
ラビットチャレンジレポート 機械学習
by
ssuserf4860b
46 slides
142 views
PRML ベイズロジスティック回帰
by
hagino 3000
21 slides
5.2K views
東京都市大学 データ解析入門 7 回帰分析とモデル選択 2
by
hirokazutanaka
37 slides
611 views
SVM
by
Yuki Nakayama
23 slides
1.2K views
Unified Expectation Maximization
by
Koji Matsuda
23 slides
3K views
More from sleepy_yoshi
PDF
KDD2014勉強会: Large-Scale High-Precision Topic Modeling on Twitter
by
sleepy_yoshi
29 slides
7.2K views
PDF
KDD2013読み会: Direct Optimization of Ranking Measures
by
sleepy_yoshi
25 slides
3.4K views
PDF
PRML復々習レーン#14 前回までのあらすじ
by
sleepy_yoshi
15 slides
2.7K views
PDF
PRML復々習レーン#13 前回までのあらすじ
by
sleepy_yoshi
18 slides
3.6K views
PDF
PRML復々習レーン#12 前回までのあらすじ
by
sleepy_yoshi
17 slides
4.4K views
PDF
SEXI2013読み会: Adult Query Classification for Web Search and Recommendation
by
sleepy_yoshi
30 slides
3K views
PDF
計算論的学習理論入門 -PAC学習とかVC次元とか-
by
sleepy_yoshi
29 slides
20.8K views
PDF
PRML復々習レーン#11 前回までのあらすじ
by
sleepy_yoshi
17 slides
2.4K views
PDF
PRML復々習レーン#10 前回までのあらすじ
by
sleepy_yoshi
12 slides
2.8K views
PDF
SIGIR2012勉強会 23 Learning to Rank
by
sleepy_yoshi
19 slides
2.3K views
PDF
DSIRNLP#3 LT: 辞書挟み込み型転置インデクスFIg4.5
by
sleepy_yoshi
23 slides
1.3K views
PDF
ICML2012読み会 Scaling Up Coordinate Descent Algorithms for Large L1 regularizat...
by
sleepy_yoshi
26 slides
2.5K views
PDF
PRML復々習レーン#3 前回までのあらすじ
by
sleepy_yoshi
18 slides
2.8K views
PDF
SVM実践ガイド (A Practical Guide to Support Vector Classification)
by
sleepy_yoshi
45 slides
134.2K views
PDF
WSDM2012読み会: Learning to Rank with Multi-Aspect Relevance for Vertical Search
by
sleepy_yoshi
51 slides
4.5K views
PDF
Collaborative Ranking: A Case Study on Entity Ranking (EMNLP2011読み会)
by
sleepy_yoshi
45 slides
1.3K views
PDF
SIGIR2011読み会 3. Learning to Rank
by
sleepy_yoshi
19 slides
3.7K views
PDF
TokyoNLP#7 きれいなジャイアンのカカカカ☆カーネル法入門-C++
by
sleepy_yoshi
87 slides
12.3K views
PDF
ACL2011読み会: Query Weighting for Ranking Model Adaptation
by
sleepy_yoshi
65 slides
1.7K views
PDF
DSIRNLP#1 ランキング学習ことはじめ
by
sleepy_yoshi
97 slides
35.8K views
KDD2014勉強会: Large-Scale High-Precision Topic Modeling on Twitter
by
sleepy_yoshi
29 slides
7.2K views
KDD2013読み会: Direct Optimization of Ranking Measures
by
sleepy_yoshi
25 slides
3.4K views
PRML復々習レーン#14 前回までのあらすじ
by
sleepy_yoshi
15 slides
2.7K views
PRML復々習レーン#13 前回までのあらすじ
by
sleepy_yoshi
18 slides
3.6K views
PRML復々習レーン#12 前回までのあらすじ
by
sleepy_yoshi
17 slides
4.4K views
SEXI2013読み会: Adult Query Classification for Web Search and Recommendation
by
sleepy_yoshi
30 slides
3K views
計算論的学習理論入門 -PAC学習とかVC次元とか-
by
sleepy_yoshi
29 slides
20.8K views
PRML復々習レーン#11 前回までのあらすじ
by
sleepy_yoshi
17 slides
2.4K views
PRML復々習レーン#10 前回までのあらすじ
by
sleepy_yoshi
12 slides
2.8K views
SIGIR2012勉強会 23 Learning to Rank
by
sleepy_yoshi
19 slides
2.3K views
DSIRNLP#3 LT: 辞書挟み込み型転置インデクスFIg4.5
by
sleepy_yoshi
23 slides
1.3K views
ICML2012読み会 Scaling Up Coordinate Descent Algorithms for Large L1 regularizat...
by
sleepy_yoshi
26 slides
2.5K views
PRML復々習レーン#3 前回までのあらすじ
by
sleepy_yoshi
18 slides
2.8K views
SVM実践ガイド (A Practical Guide to Support Vector Classification)
by
sleepy_yoshi
45 slides
134.2K views
WSDM2012読み会: Learning to Rank with Multi-Aspect Relevance for Vertical Search
by
sleepy_yoshi
51 slides
4.5K views
Collaborative Ranking: A Case Study on Entity Ranking (EMNLP2011読み会)
by
sleepy_yoshi
45 slides
1.3K views
SIGIR2011読み会 3. Learning to Rank
by
sleepy_yoshi
19 slides
3.7K views
TokyoNLP#7 きれいなジャイアンのカカカカ☆カーネル法入門-C++
by
sleepy_yoshi
87 slides
12.3K views
ACL2011読み会: Query Weighting for Ranking Model Adaptation
by
sleepy_yoshi
65 slides
1.7K views
DSIRNLP#1 ランキング学習ことはじめ
by
sleepy_yoshi
97 slides
35.8K views
PRML復々習レーン#7 前回までのあらすじ
1.
PRML復々習レーン#7 前回までのあらすじ
2012-12-15 Yoshihiko Suhara @sleepy_yoshi v.1.0
2.
前回のおさらい • 復々習レーンの復習を15分程度でやります –
得られた結論にポイントを絞る – 「よーするに」な内容 ポイントだよ • 好きなところをたくさん喋る • よくわからないところは誤魔化す • まちがってたら指摘してください • 目的 – 前回の復習 – 不参加の方に流れを伝えるため – 自分自身の勉強のため 2
3.
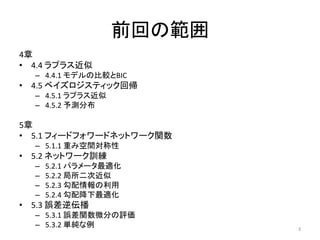
前回の範囲 4章 • 4.4 ラプラス近似
– 4.4.1 モデルの比較とBIC • 4.5 ベイズロジスティック回帰 – 4.5.1 ラプラス近似 – 4.5.2 予測分布 5章 • 5.1 フィードフォワードネットワーク関数 – 5.1.1 重み空間対称性 • 5.2 ネットワーク訓練 – 5.2.1 パラメータ最適化 – 5.2.2 局所二次近似 – 5.2.3 勾配情報の利用 – 5.2.4 勾配降下最適化 • 5.3 誤差逆伝播 – 5.3.1 誤差関数微分の評価 – 5.3.2 単純な例 3
4.
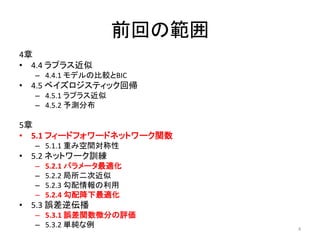
前回の範囲 4章 • 4.4 ラプラス近似
– 4.4.1 モデルの比較とBIC • 4.5 ベイズロジスティック回帰 – 4.5.1 ラプラス近似 – 4.5.2 予測分布 5章 • 5.1 フィードフォワードネットワーク関数 – 5.1.1 重み空間対称性 • 5.2 ネットワーク訓練 – 5.2.1 パラメータ最適化 – 5.2.2 局所二次近似 – 5.2.3 勾配情報の利用 – 5.2.4 勾配降下最適化 • 5.3 誤差逆伝播 – 5.3.1 誤差関数微分の評価 – 5.3.2 単純な例 4
5.
4.4 ラプラス近似
5
6.
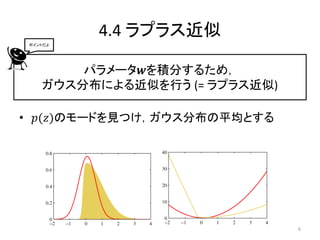
4.4 ラプラス近似 ポイントだよ
パラメータ𝒘を積分するため, ガウス分布による近似を行う (= ラプラス近似) • 𝑝(𝑧)のモードを見つけ,ガウス分布の平均とする 6
7.
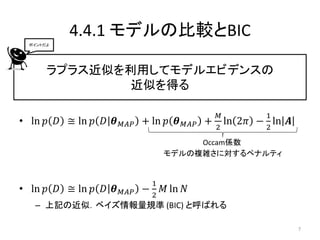
4.4.1 モデルの比較とBIC ポイントだよ
ラプラス近似を利用してモデルエビデンスの 近似を得る 𝑀 1 • ln 𝑝 𝐷 ≅ ln 𝑝 𝐷 𝜽 𝑀𝐴𝑃 + ln 𝑝 𝜽 𝑀𝐴𝑃 + ln 2𝜋 − ln 𝑨 2 2 Occam係数 モデルの複雑さに対するペナルティ 1 • ln 𝑝 𝐷 ≅ ln 𝑝 𝐷 𝜽 𝑀𝐴𝑃 − 2 𝑀 ln 𝑁 – 上記の近似.ベイズ情報量規準 (BIC) と呼ばれる 7
8.
4.5 ベイズロジスティック回帰
8
9.
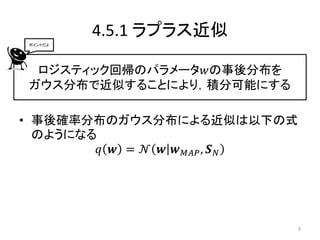
4.5.1 ラプラス近似 ポイントだよ
ロジスティック回帰のパラメータ𝑤の事後分布を ガウス分布で近似することにより,積分可能にする • 事後確率分布のガウス分布による近似は以下の式 のようになる 𝑞 𝒘 = 𝒩 𝒘 𝒘 𝑀𝐴𝑃 , 𝑺 𝑁 9
10.
※重畳 (ちょうじょう) 積分
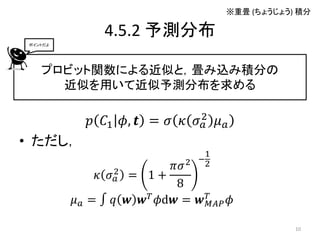
4.5.2 予測分布 ポイントだよ プロビット関数による近似と,畳み込み積分の 近似を用いて近似予測分布を求める 𝑝 𝐶1 𝜙, 𝒕 = 𝜎 𝜅 𝜎 2 𝜇 𝑎 𝑎 • ただし, 1 −2 𝜋𝜎 2 𝜅 𝜎2 = 1 + 𝑎 8 𝜇 𝑎 = ∫ 𝑞 𝒘 𝒘 𝑇 𝜙d𝒘 = 𝒘 𝑇𝑀𝐴𝑃 𝜙 10
11.
5章 ニューラルネットワーク
11
12.
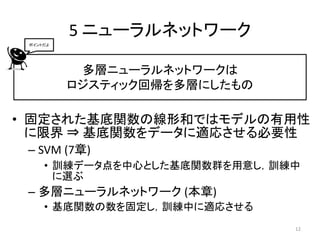
5 ニューラルネットワーク ポイントだよ
多層ニューラルネットワークは ロジスティック回帰を多層にしたもの • 固定された基底関数の線形和ではモデルの有用性 に限界 ⇒ 基底関数をデータに適応させる必要性 – SVM (7章) • 訓練データ点を中心とした基底関数群を用意し,訓練中 に選ぶ – 多層ニューラルネットワーク (本章) • 基底関数の数を固定し,訓練中に適応させる 12
13.
5.1 フィードフォワードネットワーク関数
13
14.
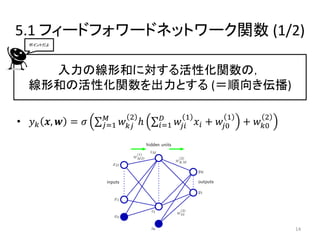
5.1 フィードフォワードネットワーク関数 (1/2)
ポイントだよ 入力の線形和に対する活性化関数の, 線形和の活性化関数を出力とする (=順向き伝播) 𝑀 2 𝐷 1 1 2 • 𝑦 𝑘 𝒙, 𝒘 = 𝜎 𝑗=1 𝑤 𝑘𝑗 ℎ 𝑖=1 𝑤𝑗𝑖 𝑥 𝑖 + 𝑤𝑗0 + 𝑤 𝑘0 14
15.
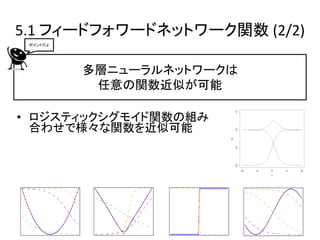
5.1 フィードフォワードネットワーク関数 (2/2)
ポイントだよ 多層ニューラルネットワークは 任意の関数近似が可能 • ロジスティックシグモイド関数の組み 合わせで様々な関数を近似可能 15
16.
5.1.1 重み空間対称性 ポイントだよ
一部の重みの符号を反転させても ネットワークの入出力関数は変化しない • 隠れユニット𝑀個 – すべての組み合わせ: 2 𝑀 • ある特定の隠れユニットへのすべての重みとバイアスの符号を反転しても, その隠れユニットの出力に対する重みをすべて反転すればよい – 隠れユニットの順番交換: 𝑀! • 隠れユニットの順番は出力に影響しないため – よって𝑀! 2 𝑀 個の等価な重みベクトルが存在 • あまり重要ではない – 考慮する必要がある状況は5.7節で 16
17.
5.2 ネットワーク訓練
17
18.
5.2 ネットワーク訓練 ポイントだよ
回帰問題および識別問題において 誤差関数を負の対数尤度で定義 • 誤差関数の出力ユニットによる勾配は,回帰 でも識別でも以下のとおりになる 𝜕 𝐸 𝒘 = 𝑦𝑘 − 𝑡𝑘 𝜕𝑎 𝑘 18
19.
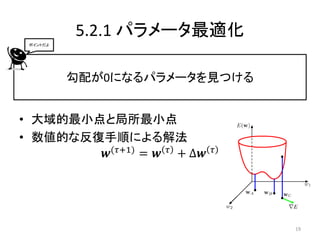
5.2.1 パラメータ最適化 ポイントだよ
勾配が0になるパラメータを見つける • 大域的最小点と局所最小点 • 数値的な反復手順による解法 𝒘(𝜏+1) = 𝒘 𝜏 + Δ𝒘 𝜏 19
20.
5.2.2 局所二次近似 ポイントだよ
誤差関数を局所的に二次近似し, ヘッセ行列を評価することで極小点を判断する 𝜕2 𝐸 • 1次元の場合, > 0 のとき極小点 𝜕𝑤 2 𝑤 ∗ – あらゆる方向に対して誤差が増える 20
21.
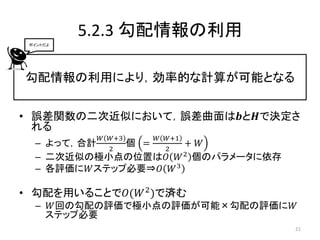
5.2.3 勾配情報の利用 ポイントだよ 勾配情報の利用により,効率的な計算が可能となる •
誤差関数の二次近似において,誤差曲面は𝒃と𝑯で決定さ れる 𝑊 𝑊+3 𝑊 𝑊+1 – よって,合計 個 = + 𝑊 2 2 – 二次近似の極小点の位置は𝑂 𝑊 2 個のパラメータに依存 – 各評価に𝑊ステップ必要⇒𝑂 𝑊 3 • 勾配を用いることで𝑂(𝑊 2 )で済む – 𝑊回の勾配の評価で極小点の評価が可能×勾配の評価に𝑊 ステップ必要 21
22.
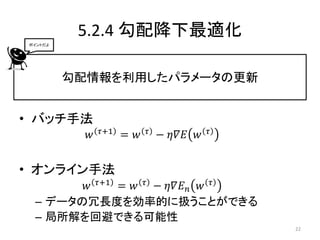
5.2.4 勾配降下最適化 ポイントだよ
勾配情報を利用したパラメータの更新 • バッチ手法 𝜏+1 𝜏 𝜏 𝑤 = 𝑤 − 𝜂𝛻𝐸 𝑤 • オンライン手法 𝑤 𝜏+1 = 𝑤 𝜏 − 𝜂𝛻𝐸 𝑛 𝑤 𝜏 – データの冗長度を効率的に扱うことができる – 局所解を回避できる可能性 22
23.
5.3 誤差逆伝播
23
24.
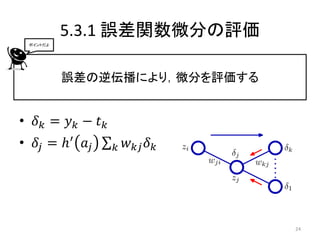
5.3.1 誤差関数微分の評価 ポイントだよ
誤差の逆伝播により,微分を評価する • 𝛿𝑘 = 𝑦𝑘 − 𝑡𝑘 • 𝛿 𝑗 = ℎ′ 𝑎 𝑗 𝑘 𝑤 𝑘𝑗 𝛿 𝑘 24
25.
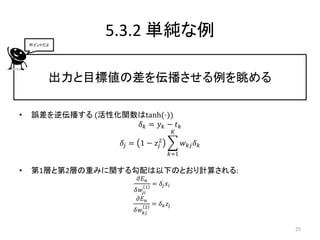
5.3.2 単純な例
ポイントだよ 出力と目標値の差を伝播させる例を眺める • 誤差を逆伝播する (活性化関数はtanh(⋅)) 𝛿𝑘 = 𝑦𝑘 − 𝑡𝑘 𝐾 𝛿𝑗 = 1 − 𝑧2 𝑗 𝑤 𝑘𝑗 𝛿 𝑘 𝑘=1 • 第1層と第2層の重みに関する勾配は以下のとおり計算される: 𝜕𝐸 𝑛 1 = 𝛿𝑗 𝑥 𝑖 𝛿𝑤𝑗𝑖 𝜕𝐸 𝑛 2 = 𝛿 𝑘 𝑧𝑗 𝛿𝑤 𝑘𝑗 25
26.
さぁ今日も一日 つづく
がんばるぞ 26