Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
Katsuya Ito
PDF, PPTX
7,900 views
最近強化学習の良記事がたくさん出てきたので勉強しながらまとめた
最近強化学習の良記事がたくさん出てきたので勉強しながらまとめた
Engineering
◦
Read more
7
Save
Share
Embed
Save to Drive
Download now
Download as PDF, PPTX
1
/ 36
2
/ 36
3
/ 36
4
/ 36
Most read
5
/ 36
6
/ 36
7
/ 36
8
/ 36
Most read
9
/ 36
10
/ 36
11
/ 36
12
/ 36
Most read
13
/ 36
14
/ 36
15
/ 36
16
/ 36
17
/ 36
18
/ 36
19
/ 36
20
/ 36
More Related Content
PDF
POMDP下での強化学習の基礎と応用
by
Yasunori Ozaki
32 slides
4.5K views
PDF
多様な強化学習の概念と課題認識
by
佑 甲野
38 slides
59.4K views
PDF
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法
by
SSII
48 slides
5.9K views
PDF
強化学習その2
by
nishio
82 slides
23.5K views
PDF
深層強化学習と実装例
by
Deep Learning Lab(ディープラーニング・ラボ)
44 slides
4.2K views
PDF
三次元点群を取り扱うニューラルネットワークのサーベイ
by
Naoya Chiba
180 slides
21.2K views
PDF
研究効率化Tips Ver.2
by
cvpaper. challenge
298 slides
27.9K views
PDF
【DL輪読会】Mastering Diverse Domains through World Models
by
Deep Learning JP
34 slides
970 views
POMDP下での強化学習の基礎と応用
by
Yasunori Ozaki
32 slides
4.5K views
多様な強化学習の概念と課題認識
by
佑 甲野
38 slides
59.4K views
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法
by
SSII
48 slides
5.9K views
強化学習その2
by
nishio
82 slides
23.5K views
深層強化学習と実装例
by
Deep Learning Lab(ディープラーニング・ラボ)
44 slides
4.2K views
三次元点群を取り扱うニューラルネットワークのサーベイ
by
Naoya Chiba
180 slides
21.2K views
研究効率化Tips Ver.2
by
cvpaper. challenge
298 slides
27.9K views
【DL輪読会】Mastering Diverse Domains through World Models
by
Deep Learning JP
34 slides
970 views
What's hot
PDF
トップカンファレンスへの論文採択に向けて(AI研究分野版)/ Toward paper acceptance at top conferences (AI...
by
JunSuzuki21
83 slides
16.1K views
PPTX
強化学習 DQNからPPOまで
by
harmonylab
45 slides
11.8K views
PPTX
[DL輪読会]Dream to Control: Learning Behaviors by Latent Imagination
by
Deep Learning JP
20 slides
2.7K views
PPTX
[DL輪読会] マルチエージェント強化学習と心の理論
by
Deep Learning JP
42 slides
5.6K views
PDF
分散学習のあれこれ~データパラレルからモデルパラレルまで~
by
Hideki Tsunashima
48 slides
5.5K views
PDF
DQNからRainbowまで 〜深層強化学習の最新動向〜
by
Jun Okumura
94 slides
95.8K views
PDF
【DL輪読会】マルチエージェント強化学習における近年の 協調的方策学習アルゴリズムの発展
by
Deep Learning JP
37 slides
9K views
PPTX
[DL輪読会]逆強化学習とGANs
by
Deep Learning JP
50 slides
9.4K views
PPTX
画像認識と深層学習
by
Yusuke Uchida
174 slides
18.1K views
PPTX
[DL輪読会]相互情報量最大化による表現学習
by
Deep Learning JP
43 slides
9.4K views
PDF
ドメイン適応の原理と応用
by
Yoshitaka Ushiku
50 slides
7.6K views
PPTX
猫でも分かるVariational AutoEncoder
by
Sho Tatsuno
51 slides
136.5K views
PPTX
モデルアーキテクチャ観点からの高速化2019
by
Yusuke Uchida
90 slides
18.1K views
PDF
最適輸送の計算アルゴリズムの研究動向
by
ohken
29 slides
11.6K views
PPTX
StyleGAN解説 CVPR2019読み会@DeNA
by
Kento Doi
34 slides
9K views
PPTX
【DL輪読会】論文解説:Offline Reinforcement Learning as One Big Sequence Modeling Problem
by
Deep Learning JP
14 slides
1.7K views
PDF
ブラックボックス最適化とその応用
by
gree_tech
15 slides
6.8K views
PPTX
畳み込みニューラルネットワークの高精度化と高速化
by
Yusuke Uchida
133 slides
66.3K views
PDF
SLAM開発における課題と対策の一例の紹介
by
miyanegi
37 slides
2.9K views
PDF
Minecraft による強化学習の実践 (MineRL)
by
Tusyoshi Matsuzaki
15 slides
2.8K views
トップカンファレンスへの論文採択に向けて(AI研究分野版)/ Toward paper acceptance at top conferences (AI...
by
JunSuzuki21
83 slides
16.1K views
強化学習 DQNからPPOまで
by
harmonylab
45 slides
11.8K views
[DL輪読会]Dream to Control: Learning Behaviors by Latent Imagination
by
Deep Learning JP
20 slides
2.7K views
[DL輪読会] マルチエージェント強化学習と心の理論
by
Deep Learning JP
42 slides
5.6K views
分散学習のあれこれ~データパラレルからモデルパラレルまで~
by
Hideki Tsunashima
48 slides
5.5K views
DQNからRainbowまで 〜深層強化学習の最新動向〜
by
Jun Okumura
94 slides
95.8K views
【DL輪読会】マルチエージェント強化学習における近年の 協調的方策学習アルゴリズムの発展
by
Deep Learning JP
37 slides
9K views
[DL輪読会]逆強化学習とGANs
by
Deep Learning JP
50 slides
9.4K views
画像認識と深層学習
by
Yusuke Uchida
174 slides
18.1K views
[DL輪読会]相互情報量最大化による表現学習
by
Deep Learning JP
43 slides
9.4K views
ドメイン適応の原理と応用
by
Yoshitaka Ushiku
50 slides
7.6K views
猫でも分かるVariational AutoEncoder
by
Sho Tatsuno
51 slides
136.5K views
モデルアーキテクチャ観点からの高速化2019
by
Yusuke Uchida
90 slides
18.1K views
最適輸送の計算アルゴリズムの研究動向
by
ohken
29 slides
11.6K views
StyleGAN解説 CVPR2019読み会@DeNA
by
Kento Doi
34 slides
9K views
【DL輪読会】論文解説:Offline Reinforcement Learning as One Big Sequence Modeling Problem
by
Deep Learning JP
14 slides
1.7K views
ブラックボックス最適化とその応用
by
gree_tech
15 slides
6.8K views
畳み込みニューラルネットワークの高精度化と高速化
by
Yusuke Uchida
133 slides
66.3K views
SLAM開発における課題と対策の一例の紹介
by
miyanegi
37 slides
2.9K views
Minecraft による強化学習の実践 (MineRL)
by
Tusyoshi Matsuzaki
15 slides
2.8K views
Similar to 最近強化学習の良記事がたくさん出てきたので勉強しながらまとめた
PPTX
深層強化学習入門
by
Core Concept Technologies
27 slides
1.1K views
PDF
Rainbow: Combining Improvements in Deep Reinforcement Learning (AAAI2018 unde...
by
Toru Fujino
38 slides
1.5K views
PDF
強化学習とは (MIJS 分科会資料 2016/10/11)
by
Akihiro HATANAKA
10 slides
1.5K views
PPTX
Batch Reinforcement Learning
by
Takuma Oda
32 slides
255 views
PDF
Study aiラビットチャレンジ 深層学習Day4
by
Naoki Nishikawa
7 slides
150 views
PPTX
1017 論文紹介第四回
by
Kohei Wakamatsu
50 slides
301 views
PDF
分散型強化学習手法の最近の動向と分散計算フレームワークRayによる実装の試み
by
SusumuOTA
68 slides
1.1K views
PDF
[DL輪読会]Reinforcement Learning with Deep Energy-Based Policies
by
Deep Learning JP
14 slides
1.9K views
PDF
SSII2021 [TS2] 深層強化学習 〜 強化学習の基礎から応用まで 〜
by
SSII
146 slides
5.5K views
PPTX
Reinforcement Learning(方策改善定理)
by
Masanori Yamada
17 slides
4.7K views
PDF
強化学習の基礎的な考え方と問題の分類
by
佑 甲野
43 slides
77.1K views
DOCX
レポート深層学習Day4
by
ssuser9d95b3
39 slides
150 views
PPTX
強化学習の基礎と深層強化学習(東京大学 松尾研究室 深層強化学習サマースクール講義資料)
by
Shota Imai
159 slides
358.3K views
PDF
未来画像予測モデルと時間重み付けを導入した価値関数に基づく強化学習
by
MILab
34 slides
257 views
PDF
NIPS2017読み会@PFN: Hierarchical Reinforcement Learning + α
by
佑 甲野
68 slides
5.9K views
PDF
Reinforcement Learning: An Introduction 輪読会第1回資料
by
Yasunori Ozaki
18 slides
1.2K views
PDF
[CV勉強会]Active Object Localization with Deep Reinfocement Learning
by
Takuya Minagawa
41 slides
6.4K views
PPTX
【最新ではありません。再度URL送付しています→https://www.slideshare.net/ssuserf4860b/day-250965207...
by
ssuserf4860b
29 slides
90 views
PPTX
【論文読み会】Deep Reinforcement Learning at the Edge of the Statistical Precipice
by
ARISE analytics
21 slides
949 views
PDF
ICLR2018読み会@PFN 論文紹介:Intrinsic Motivation and Automatic Curricula via Asymmet...
by
Jun Okumura
20 slides
1.4K views
深層強化学習入門
by
Core Concept Technologies
27 slides
1.1K views
Rainbow: Combining Improvements in Deep Reinforcement Learning (AAAI2018 unde...
by
Toru Fujino
38 slides
1.5K views
強化学習とは (MIJS 分科会資料 2016/10/11)
by
Akihiro HATANAKA
10 slides
1.5K views
Batch Reinforcement Learning
by
Takuma Oda
32 slides
255 views
Study aiラビットチャレンジ 深層学習Day4
by
Naoki Nishikawa
7 slides
150 views
1017 論文紹介第四回
by
Kohei Wakamatsu
50 slides
301 views
分散型強化学習手法の最近の動向と分散計算フレームワークRayによる実装の試み
by
SusumuOTA
68 slides
1.1K views
[DL輪読会]Reinforcement Learning with Deep Energy-Based Policies
by
Deep Learning JP
14 slides
1.9K views
SSII2021 [TS2] 深層強化学習 〜 強化学習の基礎から応用まで 〜
by
SSII
146 slides
5.5K views
Reinforcement Learning(方策改善定理)
by
Masanori Yamada
17 slides
4.7K views
強化学習の基礎的な考え方と問題の分類
by
佑 甲野
43 slides
77.1K views
レポート深層学習Day4
by
ssuser9d95b3
39 slides
150 views
強化学習の基礎と深層強化学習(東京大学 松尾研究室 深層強化学習サマースクール講義資料)
by
Shota Imai
159 slides
358.3K views
未来画像予測モデルと時間重み付けを導入した価値関数に基づく強化学習
by
MILab
34 slides
257 views
NIPS2017読み会@PFN: Hierarchical Reinforcement Learning + α
by
佑 甲野
68 slides
5.9K views
Reinforcement Learning: An Introduction 輪読会第1回資料
by
Yasunori Ozaki
18 slides
1.2K views
[CV勉強会]Active Object Localization with Deep Reinfocement Learning
by
Takuya Minagawa
41 slides
6.4K views
【最新ではありません。再度URL送付しています→https://www.slideshare.net/ssuserf4860b/day-250965207...
by
ssuserf4860b
29 slides
90 views
【論文読み会】Deep Reinforcement Learning at the Edge of the Statistical Precipice
by
ARISE analytics
21 slides
949 views
ICLR2018読み会@PFN 論文紹介:Intrinsic Motivation and Automatic Curricula via Asymmet...
by
Jun Okumura
20 slides
1.4K views
More from Katsuya Ito
PDF
ICML2021の連合学習の論文
by
Katsuya Ito
33 slides
2.2K views
PDF
金融時系列解析入門 AAMAS2021 著者発表会
by
Katsuya Ito
47 slides
1.6K views
PDF
西山計量経済学第8章 制限従属変数モデル
by
Katsuya Ito
21 slides
1.4K views
PDF
CF-FinML 金融時系列予測のための機械学習
by
Katsuya Ito
28 slides
2.6K views
PDF
非同期時系列のLead-lag効果推定のための新しい推定量
by
Katsuya Ito
26 slides
796 views
PDF
表明保証と補償責任
by
Katsuya Ito
21 slides
444 views
PDF
Gali3章Monetary Policy, Inflation, and the Business Cycle~the basic new keynes...
by
Katsuya Ito
23 slides
782 views
PDF
新問題研究 要件事実
by
Katsuya Ito
39 slides
2.5K views
PDF
Dynamic Time Warping を用いた高頻度取引データのLead-Lag 効果の推定
by
Katsuya Ito
26 slides
2.4K views
PDF
Convex Analysis and Duality (based on "Functional Analysis and Optimization" ...
by
Katsuya Ito
65 slides
2.2K views
PPTX
量子プログラミング入門
by
Katsuya Ito
31 slides
2.7K views
PDF
異常検知と変化検知で復習するPRML
by
Katsuya Ito
56 slides
3.1K views
PDF
ICLR 2018 Best papers 3本を紹介
by
Katsuya Ito
45 slides
2.8K views
PPTX
計算数学I TA小話①(TeXについて)
by
Katsuya Ito
30 slides
643 views
PPTX
Black-Scholesの面白さ
by
Katsuya Ito
84 slides
3.8K views
PDF
深層ニューラルネットワークの積分表現(Deepを定式化する数学)
by
Katsuya Ito
36 slides
4.8K views
PDF
Goodfellow先生おすすめのGAN論文6つを紹介
by
Katsuya Ito
70 slides
9.2K views
PDF
とぽろじー入門(画像なし版)
by
Katsuya Ito
46 slides
4.3K views
ICML2021の連合学習の論文
by
Katsuya Ito
33 slides
2.2K views
金融時系列解析入門 AAMAS2021 著者発表会
by
Katsuya Ito
47 slides
1.6K views
西山計量経済学第8章 制限従属変数モデル
by
Katsuya Ito
21 slides
1.4K views
CF-FinML 金融時系列予測のための機械学習
by
Katsuya Ito
28 slides
2.6K views
非同期時系列のLead-lag効果推定のための新しい推定量
by
Katsuya Ito
26 slides
796 views
表明保証と補償責任
by
Katsuya Ito
21 slides
444 views
Gali3章Monetary Policy, Inflation, and the Business Cycle~the basic new keynes...
by
Katsuya Ito
23 slides
782 views
新問題研究 要件事実
by
Katsuya Ito
39 slides
2.5K views
Dynamic Time Warping を用いた高頻度取引データのLead-Lag 効果の推定
by
Katsuya Ito
26 slides
2.4K views
Convex Analysis and Duality (based on "Functional Analysis and Optimization" ...
by
Katsuya Ito
65 slides
2.2K views
量子プログラミング入門
by
Katsuya Ito
31 slides
2.7K views
異常検知と変化検知で復習するPRML
by
Katsuya Ito
56 slides
3.1K views
ICLR 2018 Best papers 3本を紹介
by
Katsuya Ito
45 slides
2.8K views
計算数学I TA小話①(TeXについて)
by
Katsuya Ito
30 slides
643 views
Black-Scholesの面白さ
by
Katsuya Ito
84 slides
3.8K views
深層ニューラルネットワークの積分表現(Deepを定式化する数学)
by
Katsuya Ito
36 slides
4.8K views
Goodfellow先生おすすめのGAN論文6つを紹介
by
Katsuya Ito
70 slides
9.2K views
とぽろじー入門(画像なし版)
by
Katsuya Ito
46 slides
4.3K views
最近強化学習の良記事がたくさん出てきたので勉強しながらまとめた
1.
世の中に転がってる 強化学習の良記事を まとめたやつ 伊藤
2.
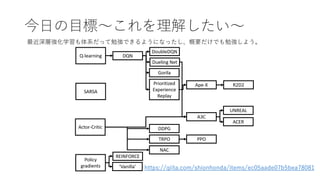
今日の目標~これを理解したい~ 最近深層強化学習も体系だって勉強できるようになったし、概要だけでも勉強しよう。 https://qiita.com/shionhonda/items/ec05aade07b5bea78081
3.
参考 • 良Qiita https://qiita.com/shionhonda/items/ec05aade07b5bea78081 • PFNの前田さんの良スライド https://www.slideshare.net/pfi/nlp2018-introduction-of-deep- reinforcement-learning •
DeepMindの良チュートリアルICML http://hunch.net/~beygel/deep_rl_tutorial.pdf • DQNを理解したので、Gopherくんの図を使って説明 https://qiita.com/ishizakiiii/items/5eff79b59bce74fdca0d • まとめてあるBlog http://blog.syundo.org/post/20180115-reinforcement-learning/
4.
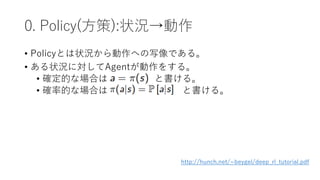
0. Policy(方策):状況→動作 • Policyとは状況から動作への写像である。 •
ある状況に対してAgentが動作をする。 • 確定的な場合は と書ける。 • 確率的な場合は と書ける。 http://hunch.net/~beygel/deep_rl_tutorial.pdf
5.
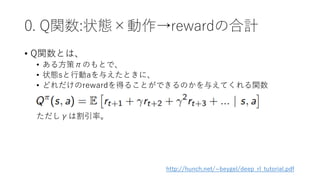
0. Q関数:状態×動作→rewardの合計 • Q関数とは、 •
ある方策πのもとで、 • 状態sと行動aを与えたときに、 • どれだけのrewardを得ることができるのかを与えてくれる関数 ただしγは割引率。 http://hunch.net/~beygel/deep_rl_tutorial.pdf
6.
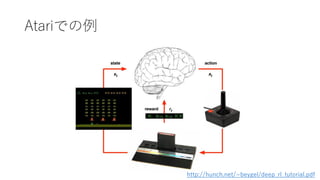
Atariでの例 http://hunch.net/~beygel/deep_rl_tutorial.pdf
7.
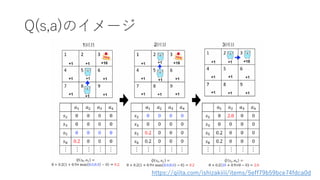
Q(s,a)のイメージ https://qiita.com/ishizakiiii/items/5eff79b59bce74fdca0d
8.
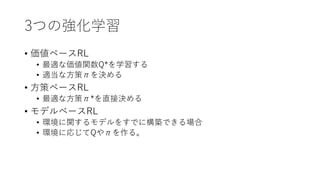
3つの強化学習 • 価値ベースRL • 最適な価値関数Q*を学習する •
適当な方策πを決める • 方策ベースRL • 最適な方策π*を直接決める • モデルベースRL • 環境に関するモデルをすでに構築できる場合 • 環境に応じてQやπを作る。
9.
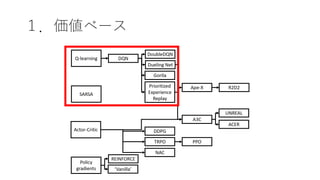
1.価値ベース
10.
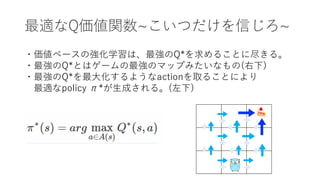
最適なQ価値関数~こいつだけを信じろ~ ・価値ベースの強化学習は、最強のQ*を求めることに尽きる。 ・最強のQ*とはゲームの最強のマップみたいなもの(右下) ・最強のQ*を最大化するようなactionを取ることにより 最適なpolicy π*が生成される。(左下)
11.
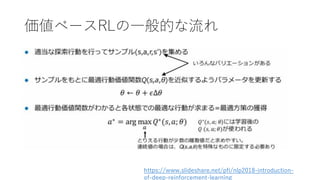
価値ベースRLの一般的な流れ https://www.slideshare.net/pfi/nlp2018-introduction- of-deep-reinforcement-learning
12.
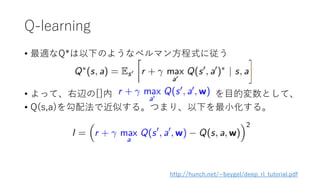
Q-learning • 最適なQ*は以下のようなベルマン方程式に従う • よって、右辺の[]内
を目的変数として、 • Q(s,a)を勾配法で近似する。つまり、以下を最小化する。 http://hunch.net/~beygel/deep_rl_tutorial.pdf
13.
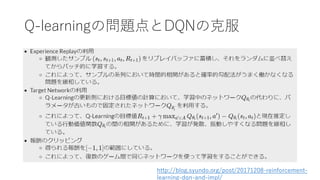
Q-learningの問題点とDQNの克服 http://blog.syundo.org/post/20171208-reinforcement- learning-dqn-and-impl/
14.
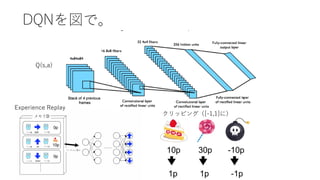
DQNを図で。 Experience Replay クリッピング([-1,1]に) Q(s,a)
15.
DQNの派生 • Dueling Net
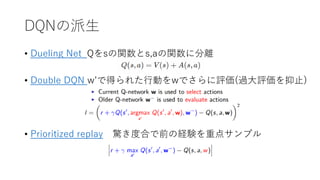
Qをsの関数とs,aの関数に分離 • Double DQN w’で得られた行動をwでさらに評価(過大評価を抑止) • Prioritized replay 驚き度合で前の経験を重点サンプル
16.
Gorilla (General Reinforcement
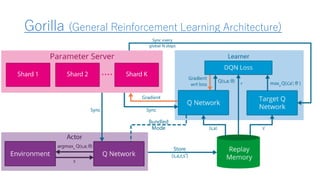
Learning Architecture)
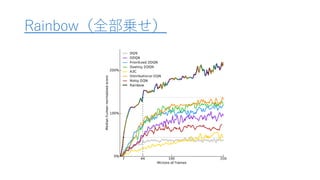
17.
Rainbow(全部乗せ)
18.
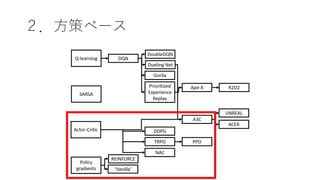
2.方策ベース
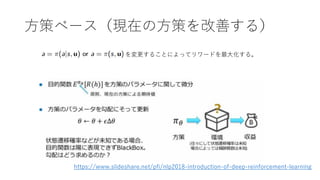
19.
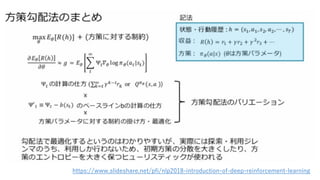
方策ベース(現在の方策を改善する) を変更することによってリワードを最大化する。 https://www.slideshare.net/pfi/nlp2018-introduction-of-deep-reinforcement-learning
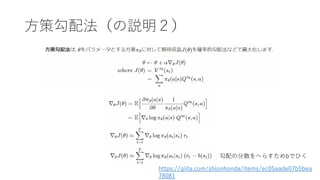
20.
方策勾配法(の説明2) 勾配の分散をへらすためbでひく https://qiita.com/shionhonda/items/ec05aade07b5bea 78081
21.
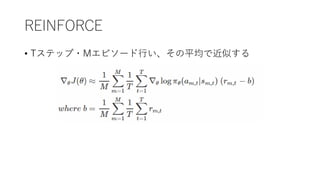
REINFORCE • Tステップ・Mエピソード行い、その平均で近似する
22.
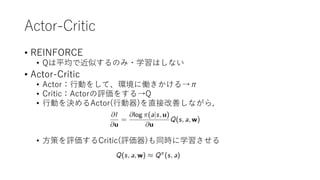
Actor-Critic • REINFORCE • Qは平均で近似するのみ・学習はしない •
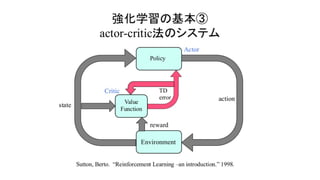
Actor-Critic • Actor:行動をして、環境に働きかける→π • Critic:Actorの評価をする→Q • 行動を決めるActor(行動器)を直接改善しながら, • 方策を評価するCritic(評価器)も同時に学習させる
24.
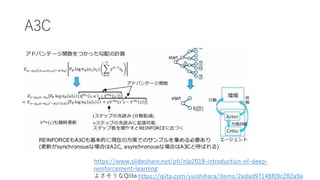
A3C https://qiita.com/yuishihara/items/2edad97148f09c282a9a https://www.slideshare.net/pfi/nlp2018-introduction-of-deep- reinforcement-learning よさそうなQiita
25.
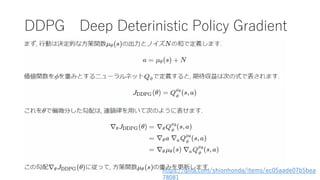
DDPG Deep Deterinistic
Policy Gradient https://qiita.com/shionhonda/items/ec05aade07b5bea 78081
26.
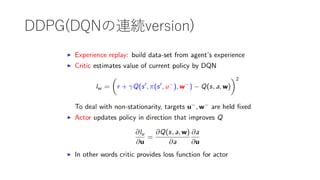
DDPG(DQNの連続version)
27.
DDPG DDPGについては、PFNインターンでいっしょだった石川さんの記事が勉強になるよ~ https://sykwer.hatenablog.jp/entry/2018/03/08/105711
28.
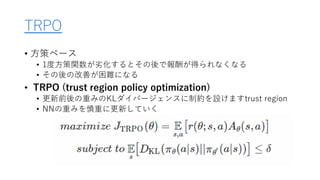
TRPO • 方策ベース • 1度方策関数が劣化するとその後で報酬が得られなくなる •
その後の改善が困難になる • TRPO (trust region policy optimization) • 更新前後の重みのKLダイバージェンスに制約を設けますtrust region • NNの重みを慎重に更新していく
29.
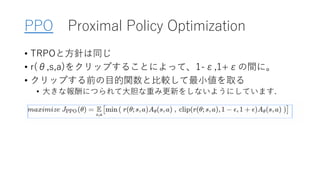
PPO Proximal Policy
Optimization • TRPOと方針は同じ • r(θ,s,a)をクリップすることによって、1-ε,1+εの間に。 • クリップする前の目的関数と比較して最小値を取る • 大きな報酬につられて大胆な重み更新をしないようにしています.
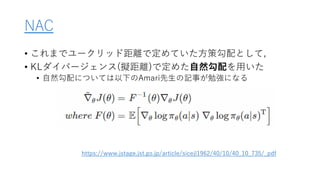
30.
NAC • これまでユークリッド距離で定めていた方策勾配として, • KLダイバージェンス(擬距離)で定めた自然勾配を用いた •
自然勾配については以下のAmari先生の記事が勉強になる https://www.jstage.jst.go.jp/article/sicejl1962/40/10/40_10_735/_pdf
31.
https://www.slideshare.net/pfi/nlp2018-introduction-of-deep-reinforcement-learning
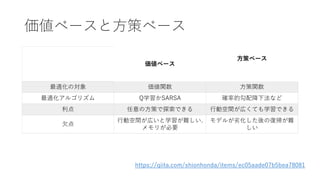
32.
価値ベースと方策ベース 価値ベース 方策ベース 最適化の対象 価値関数 方策関数 最適化アルゴリズム
Q学習かSARSA 確率的勾配降下法など 利点 任意の方策で探索できる 行動空間が広くても学習できる 欠点 行動空間が広いと学習が難しい. メモリが必要 モデルが劣化した後の復帰が難 しい https://qiita.com/shionhonda/items/ec05aade07b5bea78081
33.
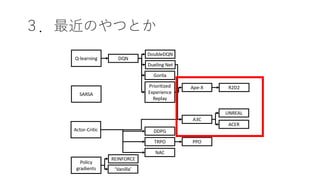
3.最近のやつとか
34.
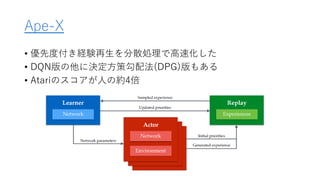
Ape-X • 優先度付き経験再生を分散処理で高速化した • DQN版の他に決定方策勾配法(DPG)版もある •
Atariのスコアが人の約4倍
35.
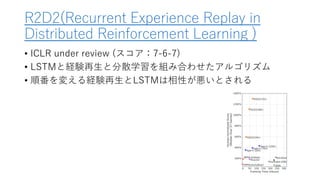
R2D2(Recurrent Experience Replay
in Distributed Reinforcement Learning ) • ICLR under review (スコア:7-6-7) • LSTMと経験再生と分散学習を組み合わせたアルゴリズム • 順番を変える経験再生とLSTMは相性が悪いとされる
36.
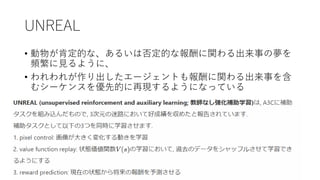
UNREAL • 動物が肯定的な、あるいは否定的な報酬に関わる出来事の夢を 頻繁に見るように、 • われわれが作り出したエージェントも報酬に関わる出来事を含 むシーケンスを優先的に再現するようになっている

 Most read
 Most read
 Most read