Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
DeNA	Co.,	Ltd.	
システム本部	
AI	システム部	AI	研究開発第⼆グループ	
甲野	佑
多様な強化学習の概念と課題認識
甲野	佑	
所属	:	株式会社ディー・エヌ・エー	AI	システム部	AI	研究開発第⼆グループ	
   	東京電機⼤学	理⼯学部	講師	(兼業)	
出⾝	:	東京電機⼤学	(学部〜博⼠)	
研究	:	強化学習	+	神経⽣理・認知モデル	
〜2017年3⽉:	⼤学で強化学習の研究してきました	
2017年4⽉〜:	強化学習を応⽤したゲーム	AI	の研究開発をしています	
2018年4⽉〜:	⺟校にて⼈⼯知能についての授業をしています	
⾃⼰紹介
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
2
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
3
強化学習の特性
第	1	節
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
4
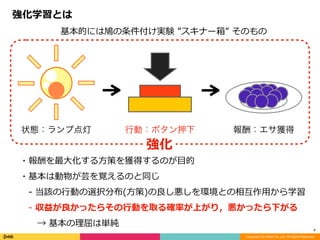
強化学習とは
・報酬を最⼤化する⽅策を獲得するのが⽬的	
・基本は動物が芸を覚えるのと同じ	
 -	当該の⾏動の選択分布(⽅策)の良し悪しを環境との相互作⽤から学習	
 -	収益が良かったらその⾏動を取る確率が上がり,悪かったら下がる	
  →	基本の理屈は単純
状態:ランプ点灯 行動:ボタン押下 報酬:エサ獲得
強化
基本的には鳩の条件付け実験	”スキナー箱”	そのもの
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
5
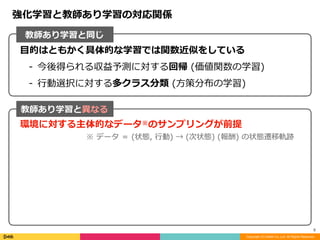
強化学習と教師あり学習の対応関係
教師あり学習と同じ
教師あり学習と異なる
⽬的はともかく具体的な学習では関数近似をしている	
- 今後得られる収益予測に対する回帰	(価値関数の学習)	
- ⾏動選択に対する多クラス分類	(⽅策分布の学習)
環境に対する主体的なデータ※のサンプリングが前提	
  ※	データ	=	(状態,	⾏動)	→	(次状態)	(報酬)	の状態遷移軌跡
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
6
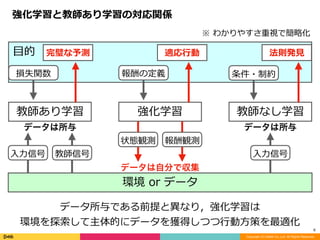
強化学習と教師あり学習の対応関係
⽬的
教師あり学習 強化学習 教師なし学習
環境	or	データ
教師信号⼊⼒信号
データは所与
報酬観測状態観測
データは自分で収集
⼊⼒信号
データは所与
損失関数 報酬の定義 条件・制約
法則発⾒適応⾏動完璧な予測
データ所与である前提と異なり,強化学習は	
環境を探索して主体的にデータを獲得しつつ⾏動⽅策を最適化
※	わかりやすさ重視で簡略化
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
7
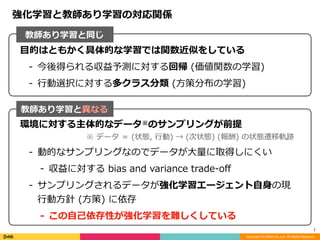
強化学習と教師あり学習の対応関係
教師あり学習と同じ
教師あり学習と異なる
⽬的はともかく具体的な学習では関数近似をしている	
- 今後得られる収益予測に対する回帰	(価値関数の学習)	
- ⾏動選択に対する多クラス分類	(⽅策分布の学習)
環境に対する主体的なデータ※のサンプリングが前提	
  ※	データ	=	(状態,	⾏動)	→	(次状態)	(報酬)	の状態遷移軌跡	
- 動的なサンプリングなのでデータが⼤量に取得しにくい	
- 収益に対する	bias	and	variance	trade-off	
- サンプリングされるデータが強化学習エージェント⾃⾝の現
⾏動⽅針	(⽅策)	に依存	
- この⾃⼰依存性が強化学習を難しくしている
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
8
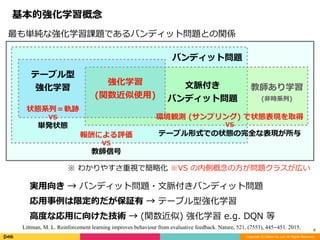
基本的強化学習概念
実⽤向き	→	バンディット問題・⽂脈付きバンディット問題	
応⽤事例は限定的だが保証有	→	テーブル型強化学習	
⾼度な応⽤に向けた技術	→	(関数近似)	強化学習	e.g.	DQN	等
⽂脈付き	
バンディット問題
バンディット問題
教師あり学習	
(⾮時系列)
強化学習	
(関数近似使⽤)
テーブル型	
強化学習
状態系列=軌跡	
VS	
単発状態
環境観測	(サンプリング)	で状態表現を取得		
VS	
テーブル形式での状態の完全な表現が所与報酬による評価	
VS	
教師信号
最も単純な強化学習課題であるバンディット問題との関係
※	わかりやすさ重視で簡略化	※VS	の内側概念の⽅が問題クラスが広い
Littman, M. L. Reinforcement learning improves behaviour from evaluative feedback. Nature, 521, (7553), 445-451. 2015.
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
9
強化学習と教師あり学習の対応関係のまとめ
⽬的はともかくやっていることは概ね回帰かクラス分類課題に落とし
込める	
- つまり深層ニューラルネット等の⾼度な関数近似を利⽤可能	
- 深層ニューラルネットを関数近似に利⽤した強化学習を深層強
化学習と呼ぶ	
教師あり学習を既に知っている強化学習の初学者にとって複雑に感じ
る点は以下による	
- データは⾃分で環境からサンプリングしなければいけない	
- ターゲット	(教師あり学習でいう教師信号)	が⾃⼰依存
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
10
・学習が難しい,学習コストが⾼い	
・シミュレータ開発コストが⾼い	
・リアリティーギャップ	
・タスク間の汎⽤性	
・マルチタスクが苦⼿	
・不完全情報	(不完全観測)	
・(本質的に)	時系列依存	
・マルチエージェント	
・[深層学習由来の問題]	価値関数の学習の困難さ	
すぐ思いつくだけでも沢⼭存在
現在の強化学習の主要な課題
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
11
現在の強化学習の主要な課題
・学習が難しい,学習コストが⾼い	
- [理由]	⾃ら環境からサンプリングしなければならないため	
- 学習データが主体的なサンプリング数に依存するため少データから学
習しなければならない	
- ターゲットの	variance	が⼤きい	or	ターゲットが⾃⼰依存的で	
bias	が⼤きい	
- サンプリングされたデータの再利⽤効率も低い
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
12
現在の強化学習の主要な課題
・シミュレータ開発コストが⾼い	
- 現実世界での学習は探索による危険性を伴うためシミュレーターが必
要だが,現実を再現したシミュレータ開発は⾮常に⾼コスト	
・リアリティーギャップ	
- [理由]	シミュレータが完全に現実を再現しない限り,理論的には別課
題になるので学習された⽅策が通⽤しないことが多い	
・汎⽤性がない	
- [理由]	学習が⾼コストなのに,タスクが少しでも変わると学習し直さ
なければならない	
- 他タスクへの転移学習の⼿法が確⽴していない	(対処例:	Distrall)	
・マルチタスクが苦⼿	
- タスクを同時に学習しない限りうまく学習できないが,そのためには
近似関数の表現能⼒に強く依存	
- 関数近似を使うと追加学習が困難になる	(対処例:	EWC)
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
13
現在の強化学習の主要な課題
・不完全情報	(不完全観測)	
- [理由]	強化学習の前提	(MDP)	が崩壊する	
・(本質的に)	時系列依存	
- MDP	による学習コストの削減を前提としているのが	TD	学習	
- なんらかの形で時系列をほぼ無視して	(⽂脈付き)	バンディット問題と
して扱った場合は⼀定の成功を得ている	
- もちろんそれでは複雑な課題は扱えない	
・マルチエージェント	
- [理由]	学習エージェントが存在すると⾮定常環境になるため		
- 他エージェントの⽅策が固定されているなら定常環境として扱える		
- マルチエージェントの関係は敵対だけでなく,協調など,様々なパター
ンがあるので更に複雑性が増す
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
14
現在の強化学習の主要な課題
・[深層学習由来の問題]	価値関数の学習の困難さ	
- ニューラルネットの学習の⼤前提である独⽴で同⼀な分布	(i.i.d.)	と
強化学習のオンラインな学習は相性が悪く,⼯夫して学習している	
- Experience	Replay	による経験軌跡のランダムサンプリング	
- A3C	による並列的な軌跡⽣成	
- 価値関数は状態空間の変化に対して不連続であり関数近似が困難	
- そのため通常の回帰問題と⽐較しても学習が困難	
- 状態空間⽅向の補完での安定化:		
- Neural	Episodic	Control	等	
- 時間⽅向の補完により安定化:		
- Rollout	系技術	(環境の先読み,動的な環境シミュレーション)	
- 価値関数の特性を解釈した安定的な近似関数の定義:		
- Natural	Value	Approximators	等
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
15
強化学習の特有概念と課題
第	2	節
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
16
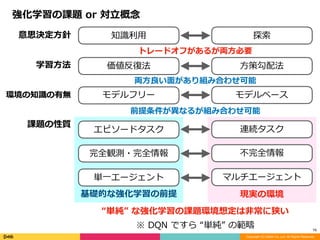
意思決定⽅針
強化学習の課題	or	対⽴概念
探索
学習⽅法
環境の知識の有無
課題の性質
知識利⽤
⽅策勾配法価値反復法
モデルベースモデルフリー
エピソードタスク
完全観測・完全情報
単⼀エージェント
基礎的な強化学習の前提
連続タスク
不完全情報
マルチエージェント
現実の環境
トレードオフがあるが両⽅必要
両⽅良い⾯があり組み合わせ可能
前提条件が異なるが組み合わせ可能
“単純”	な強化学習の課題環境想定は⾮常に狭い
※	DQN	ですら	“単純”	の範疇
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
17
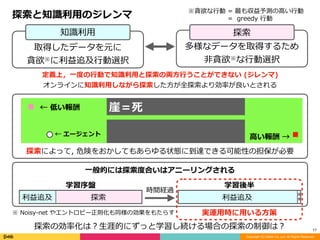
探索と知識利⽤のジレンマ
多様なデータを取得するため	
⾮貪欲※な⾏動選択
取得したデータを元に	
貪欲※に利益追及⾏動選択
利益追及 探索 利益追及
探
索
定義上,⼀度の⾏動で知識利⽤と探索の両⽅⾏うことができない	(ジレンマ)	
オンラインに知識利⽤しながら探索した⽅が全探索より効率が良いとされる
学習序盤 学習後半
実運⽤時に⽤いる⽅策※	Noisy-net	やエントロピー正則化も同様の効果をもたらす
時間経過
⼀般的には探索度合いはアニーリングされる
探索の効率化は?⽣涯的にずっと学習し続ける場合の探索の制御は?
崖=死←	低い報酬
←	エージェント
⾼い報酬	→
探索によって,	危険をおかしてもあらゆる状態に到達できる可能性の担保が必要
※貪欲な⾏動	=	最も収益予測の⾼い⾏動	
      	=		greedy	⾏動
知識利⽤ 探索
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
18
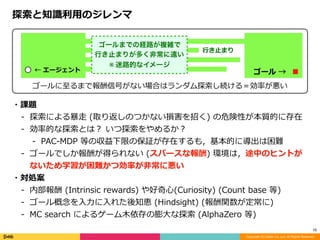
探索と知識利⽤のジレンマ
←	エージェント ゴール	→
ゴールに⾄るまで報酬信号がない場合はランダム探索し続ける=効率が悪い
・課題	
- 探索による暴⾛	(取り返しのつかない損害を招く)	の危険性が本質的に存在	
- 効率的な探索とは?	いつ探索をやめるか?	
- PAC-MDP	等の収益下限の保証が存在するも,基本的に導出は困難	
- ゴールでしか報酬が得られない	(スパースな報酬)	環境は,途中のヒントが
ないため学習が困難かつ効率が⾮常に悪い	
・対処案	
- 内部報酬	(Intrinsic	rewards)	や好奇⼼(Curiosity)	(Count	base	等)	
- ゴール概念を⼊⼒に⼊れた後知恵	(Hindsight)	(報酬関数が定常に)	
- MC	search	によるゲーム⽊依存の膨⼤な探索	(AlphaZero	等)	
ゴールまでの経路が複雑で	
行き止まりが多く非常に遠い	
※	迷路的なイメージ
⾏き⽌まり
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
19
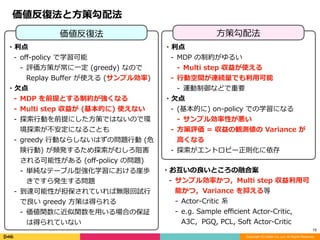
価値反復法と⽅策勾配法
⽅策勾配法価値反復法
・利点	
- off-policy	で学習可能	
- 評価⽅策が常に⼀定	(greedy)	なので	
Replay	Buffer	が使える	(サンプル効率)	
・⽋点	
- MDP	を前提とする制約が強くなる	
- Multi	step	収益が	(基本的に)	使えない	
- 探索⾏動を前提にした⽅策ではないので環
境探索が不安定になることも	
- greedy	⾏動ならしないはずの問題⾏動	(危
険⾏動)	が頻発するため探索がむしろ阻害
される可能性がある	(off-policy	の問題)	
- 単純なテーブル型強化学習における崖歩
きですら発⽣する問題	
- 到達可能性が担保されていれば無限回試⾏
で良い	greedy	⽅策は得られる	
- 価値関数に近似関数を⽤いる場合の保証
は得られていない
・利点	
- MDP	の制約がゆるい	
- Multi	step	収益が使える	
- ⾏動空間が連続量でも利⽤可能	
- 運動制御などで重要	
・⽋点	
- (基本的に)	on-policy	での学習になる	
- サンプル効率性が悪い	
- ⽅策評価	=	収益の観測値の	Variance	が
⾼くなる	
- 探索がエントロピー正則化に依存
・お互いの良いところの融合案	
- サンプル効率かつ,Multi	step	収益利⽤可
能かつ,Variance	を抑える等	
- Actor-Critic	系	
- e.g.	Sample	efficient	Actor-Critic,	
A3C,PGQ,	PCL,	Soft	Actor-Critic
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
20
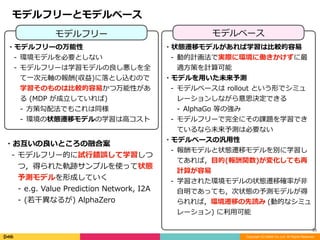
モデルベースモデルフリー
・モデルフリーの万能性	
- 環境モデルを必要としない	
- モデルフリーは学習モデルの良し悪しを全
て⼀次元軸の報酬(収益)に落とし込むので
学習そのものは⽐較的容易かつ万能性があ
る	(MDP	が成⽴していれば)	
- ⽅策勾配法でもこれは同様	
- 環境の状態遷移モデルの学習は⾼コスト
・状態遷移モデルがあれば学習は⽐較的容易	
- 動的計画法で実際に環境に働きかけずに最
適⽅策を計算可能	
・モデルを⽤いた未来予測	
- モデルベースは	rollout	という形でシミュ
レーションしながら意思決定できる	
- AlphaGo	等の強み	
- モデルフリーで完全にその課題を学習でき
ているなら未来予測は必要ない	
・モデルベースの汎⽤性	
- 報酬モデルと状態遷移モデルを別に学習し
てあれば,⽬的(報酬関数)が変化しても再
計算が容易	
- 学習された環境モデルの状態遷移確率が⾮
⾃明であっても,次状態の予測モデルが得
られれば,環境遷移の先読み	(動的なシミュ
レーション)	に利⽤可能
モデルフリーとモデルベース
・お互いの良いところの融合案	
- モデルフリー的に試⾏錯誤して学習しつ
つ,得られた軌跡サンプルを使って状態
予測モデルを形成していく	
- e.g.	Value	Prediction	Network,	I2A	
- (若⼲異なるが)	AlphaZero
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
21
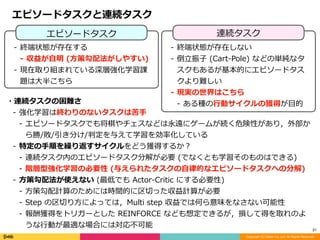
連続タスクエピソードタスク
- 終端状態が存在する	
- 収益が⾃明	(⽅策勾配法がしやすい)	
- 現在取り組まれている深層強化学習課
題は⼤半こちら
- 終端状態が存在しない	
- 倒⽴振⼦	(Cart-Pole)	などの単純なタ
スクもあるが基本的にエピソードタス
クより難しい	
- 現実の世界はこちら	
- ある種の⾏動サイクルの獲得が⽬的・連続タスクの困難さ	
- 強化学習は終わりのないタスクは苦⼿	
- エピソードタスクでも将棋やチェスなどは永遠にゲームが続く危険性があり,外部か
ら勝/敗/引き分け/判定を与えて学習を効率化している	
- 特定の⼿順を繰り返すサイクルをどう獲得するか?	
- 連続タスク内のエピソードタスク分解が必要	(でなくとも学習そのものはできる)	
- 階層型強化学習の必要性	(与えられたタスクの⾃律的なエピソードタスクへの分解)	
- ⽅策勾配法が使えない	(最低でも	Actor-Critic	にする必要性)	
- ⽅策勾配計算のためには時間的に区切った収益計算が必要	
- Step	の区切り⽅によっては,Multi	step	収益では何ら意味をなさない可能性	
- 報酬獲得をトリガーとした	REINFORCE	なども想定できるが,損して得を取れのよ
うな⾏動が最適な場合には対応不可能
エピソードタスクと連続タスク
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
22
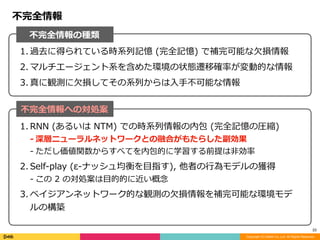
不完全情報の種類
不完全情報への対処案
1. 過去に得られている時系列記憶	(完全記憶)	で補完可能な⽋損情報	
2. マルチエージェント系を含めた環境の状態遷移確率が変動的な情報	
3. 真に観測に⽋損してその系列からは⼊⼿不可能な情報
不完全情報
1. RNN	(あるいは	NTM)	での時系列情報の内包	(完全記憶の圧縮)	
- 深層ニューラルネットワークとの融合がもたらした副効果	
- ただし価値関数からすべてを内包的に学習する前提は⾮効率	
2. Self-play	(ε-ナッシュ均衡を⽬指す),	他者の⾏為モデルの獲得		
- この	2	の対処案は⽬的的に近い概念	
3. ベイジアンネットワーク的な観測の⽋損情報を補完可能な環境モデ
ルの構築
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
23
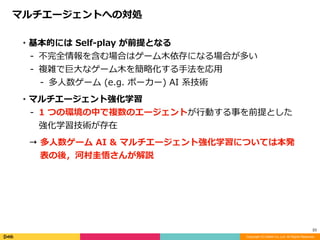
マルチエージェントへの対処
・基本的には	Self-play	が前提となる	
- 不完全情報を含む場合はゲーム⽊依存になる場合が多い	
- 複雑で巨⼤なゲーム⽊を簡略化する⼿法を応⽤	
- 多⼈数ゲーム	(e.g.	ポーカー)	AI	系技術	
・マルチエージェント強化学習	
- 1	つの環境の中で複数のエージェントが⾏動する事を前提とした
強化学習技術が存在	
→ 多⼈数ゲーム	AI	&	マルチエージェント強化学習については本発
表の後,河村圭悟さんが解説
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
24
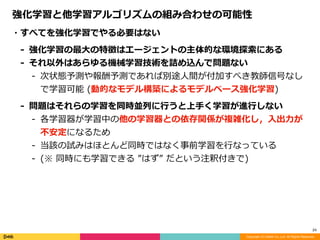
・すべてを強化学習でやる必要はない	
- 強化学習の最⼤の特徴はエージェントの主体的な環境探索にある	
- それ以外はあらゆる機械学習技術を詰め込んで問題ない	
- 次状態予測や報酬予測であれば別途⼈間が付加すべき教師信号なし
で学習可能	(動的なモデル構築によるモデルベース強化学習)	
- 問題はそれらの学習を同時並列に⾏うと上⼿く学習が進⾏しない	
- 各学習器が学習中の他の学習器との依存関係が複雑化し,⼊出⼒が
不安定になるため	
- 当該の試みはほとんど同時ではなく事前学習を⾏なっている	
- (※	同時にも学習できる	”はず”	だという注釈付きで)
強化学習と他学習アルゴリズムの組み合わせの可能性
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
25
・他学習器を利⽤した信号の抽象化	
- 状態抽象化	
- 強化学習のみでの	End-to-End	な学習に拘らず,別の状態⼊⼒抽象
化処理過程を導⼊	
- 状態⼊⼒の	disentangle	な表現への変換	(e.g.	World	model)	
- ⾃⽴構築可能なベイジアンネットワーク等	(学習は困難)	
- ⼈間の脳でも⼤脳⽪質	(ベイジアンネットワークと関連)	での状態
表現の変換を経てから線条体	(強化学習と関連)	に⼊⼒される	
- ⾏動表現の獲得	
- プリミティブな基本⾏動の探索を節約,探索の⾃由度を削減	
- カリキュラム学習,教師あり学習による⾏動の事前学習	
- ⾏動表現の埋め込み	(embedding)	
- 模倣学習	(imitation	learning,	e.g.	GAIL,	Deep	Mimic)	
- Macro-Action	などの⻑期⾏動プラン発⾏
強化学習と他学習アルゴリズムの組み合わせの可能性
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
26
多様な強化学習技術
第	3	節
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
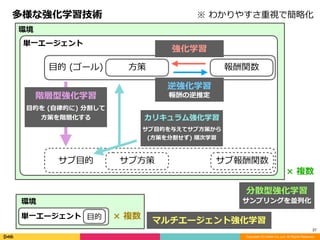
環境
単⼀エージェント
環境
27
⽬的	(ゴール)
サブ⽬的 サブ⽅策
単⼀エージェント ⽬的 ×	複数
マルチエージェント強化学習
×	複数
強化学習
⽅策 報酬報酬関数
カリキュラム強化学習
サブ⽬的を与えてサブ⽅策から	
(⽅策を分割せず)	順次学習
階層型強化学習
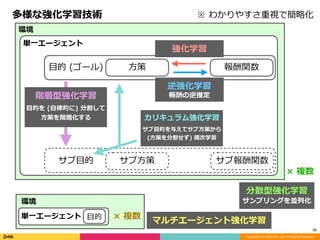
⽬的を	(⾃律的に)	分割して	
⽅策を階層化する
サブ報酬関数
分散型強化学習
サンプリングを並列化
逆強化学習
報酬の逆推定
※	わかりやすさ重視で簡略化多様な強化学習技術
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
28
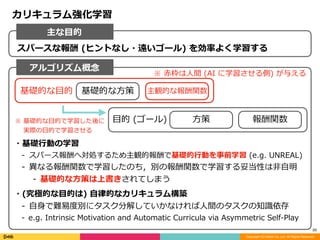
スパースな報酬	(ヒントなし・遠いゴール)	を効率よく学習する
カリキュラム強化学習
主な⽬的
アルゴリズム概念
⽬的	(ゴール) ⽅策 報酬関数
基礎的な⽅策 主観的な報酬関数基礎的な⽬的
※	⾚枠は⼈間	(AI	に学習させる側)	が与える
・基礎⾏動の学習	
- スパース報酬へ対処するため主観的報酬で基礎的⾏動を事前学習	(e.g.	UNREAL)	
- 異なる報酬関数で学習したのち,別の報酬関数で学習する妥当性は⾮⾃明	
- 基礎的な⽅策は上書きされてしまう	
・(究極的な⽬的は)	⾃律的なカリキュラム構築		
- ⾃⾝で難易度別にタスク分解していかなければ⼈間のタスクの知識依存	
- e.g.	Intrinsic	Motivation	and	Automatic	Curricula	via	Asymmetric	Self-Play	
※	基礎的な⽬的で学習した後に	
 	実際の⽬的で学習させる
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
29
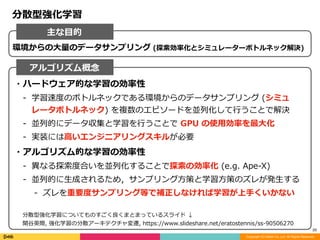
環境からの⼤量のデータサンプリング	(探索効率化とシミュレーターボトルネック解決)
・ハードウェア的な学習の効率性	
- 学習速度のボトルネックである環境からのデータサンプリング	(シミュ
レータボトルネック)	を複数のエピソードを並列化して⾏うことで解決	
- 並列的にデータ収集と学習を⾏うことで	GPU	の使⽤効率を最⼤化	
- 実装には⾼いエンジニアリングスキルが必要	
・アルゴリズム的な学習の効率性	
- 異なる探索度合いを並列化することで探索の効率化	(e.g.	Ape-X)	
- 並列的に⽣成されるため,サンプリング⽅策と学習⽅策のズレが発⽣する	
- ズレを重要度サンプリング等で補正しなければ学習が上⼿くいかない
主な⽬的
アルゴリズム概念
分散型強化学習
分散型強化学習についてものすごく良くまとまっているスライド	↓	
関⾕英爾,	強化学習の分散アーキテクチャ変遷,	https://www.slideshare.net/eratostennis/ss-90506270
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
30
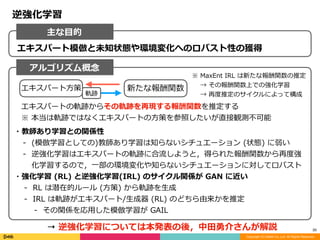
エキスパート模倣と未知状態や環境変化へのロバスト性の獲得
主な⽬的
アルゴリズム概念
逆強化学習
→ 逆強化学習については本発表の後,中⽥勇介さんが解説
エキスパート⽅策 新たな報酬関数
軌跡
エキスパートの軌跡からその軌跡を再現する報酬関数を推定する	
※	本当は軌跡ではなくエキスパートの⽅策を参照したいが直接観測不可能
※	MaxEnt	IRL	は新たな報酬関数の推定	
 	→	その報酬関数上での強化学習	
 	→	再度推定のサイクルによって構成
・教師あり学習との関係性	
- (模倣学習としての)教師あり学習は知らないシチュエーション	(状態)	に弱い	
- 逆強化学習はエキスパートの軌跡に合流しようと,得られた報酬関数から再度強
化学習するので,⼀部の環境変化や知らないシチュエーションに対してロバスト	
・強化学習	(RL)	と逆強化学習(IRL)	のサイクル関係が	GAN	に近い	
- RL	は潜在的ルール	(⽅策)	から軌跡を⽣成	
- IRL	は軌跡がエキスパート/⽣成器	(RL)	のどちら由来かを推定	
- その関係を応⽤した模倣学習が	GAIL
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
31
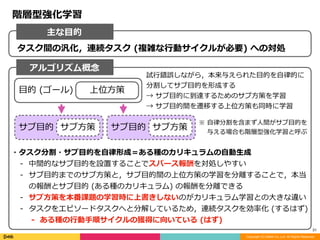
タスク間の汎化,連続タスク	(複雑な⾏動サイクルが必要)	への対処
主な⽬的
アルゴリズム概念
階層型強化学習
⽬的	(ゴール) 上位⽅策
サブ⽬的 サブ⽅策
試⾏錯誤しながら,本来与えられた⽬的を⾃律的に
分割してサブ⽬的を形成する	
→	サブ⽬的に到達するためのサブ⽅策を学習	
→	サブ⽬的間を遷移する上位⽅策も同時に学習
・タスク分割・サブ⽬的を⾃律形成=ある種のカリキュラムの⾃動⽣成	
- 中間的なサブ⽬的を設置することでスパース報酬を対処しやすい	
- サブ⽬的までのサブ⽅策と,サブ⽬的間の上位⽅策の学習を分離することで,本当
の報酬とサブ⽬的	(ある種のカリキュラム)	の報酬を分離できる	
- サブ⽅策を本番課題の学習時に上書きしないのがカリキュラム学習との⼤きな違い	
- タスクをエピソードタスクへと分解しているため,連続タスクを効率化	(するはず)	
- ある種の⾏動⼿順サイクルの獲得に向いている	(はず)
※	⾃律分割を含まず⼈間がサブ⽬的を	
 	与える場合も階層型強化学習と呼ぶ
サブ⽬的 サブ⽅策
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
32
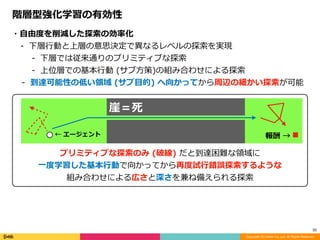
階層型強化学習の有効性
・⾃由度を削減した探索の効率化	
- 下層⾏動と上層の意思決定で異なるレベルの探索を実現	
- 下層では従来通りのプリミティブな探索	
- 上位層での基本⾏動	(サブ⽅策)の組み合わせによる探索	
- 到達可能性の低い領域	(サブ⽬的)	へ向かってから周辺の細かい探索が可能
崖=死
←	エージェント 報酬	→
プリミティブな探索のみ	(破線)	だと到達困難な領域に	
⼀度学習した基本⾏動で向かってから再度試⾏錯誤探索するような	
組み合わせによる広さと深さを兼ね備えられる探索
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
33
階層型強化学習の有効性
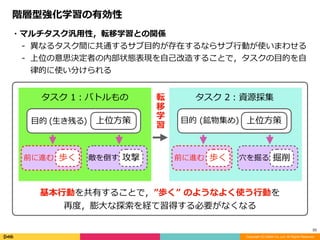
・マルチタスク汎⽤性,転移学習との関係	
- 異なるタスク間に共通するサブ⽬的が存在するならサブ⾏動が使いまわせる	
- 上位の意思決定者の内部状態表現を⾃⼰改造することで,タスクの⽬的を⾃
律的に使い分けられる
⽬的	(⽣き残る) 上位⽅策
前に進む 歩く 敵を倒す 攻撃
タスク	1:バトルもの
⽬的	(鉱物集め) 上位⽅策
前に進む 歩く ⽳を掘る 掘削
タスク	2:資源採集
基本⾏動を共有することで,”歩く”	のようなよく使う⾏動を	
再度,膨⼤な探索を経て習得する必要がなくなる
転
移
学
習
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
34
階層型強化学習の有効性
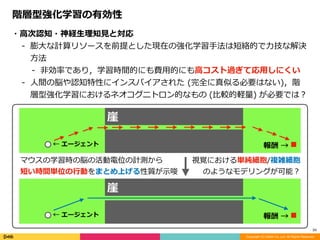
・⾼次認知・神経⽣理知⾒と対応	
- 膨⼤な計算リソースを前提とした現在の強化学習⼿法は短絡的で⼒技な解決
⽅法	
- ⾮効率であり,学習時間的にも費⽤的にも⾼コスト過ぎて応⽤しにくい	
- ⼈間の脳や認知特性にインスパイアされた	(完全に真似る必要はない),階
層型強化学習におけるネオコグニトロン的なもの	(⽐較的軽量)	が必要では?
崖
←	エージェント 報酬	→
崖
←	エージェント 報酬	→
マウスの学習時の脳の活動電位の計測から	
短い時間単位の⾏動をまとめ上げる性質が⽰唆
視覚における単純細胞/複雑細胞	
のようなモデリングが可能?
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
35
階層型強化学習の有効性
・現在提案されているコアな階層型強化学習アーキテクチャ	
- FeUdal-net,	Option-Critic	
- 現在,マルチタスクに対する⾃明な効果は発揮されていない	
- 学習そのものが困難で基礎研究の域を出ていない	
- まだまだ様々なアプローチが考えられる	
• 従来の深層強化学習的	
• 他の機械学習アルゴリズムとの組み合わせ	
• ⽣理的な脳・認知的な構造をインスパイア
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
環境
単⼀エージェント
環境
36
⽬的	(ゴール)
サブ⽬的 サブ⽅策
単⼀エージェント ⽬的 ×	複数
マルチエージェント強化学習
×	複数
強化学習
⽅策 報酬報酬関数
カリキュラム強化学習
サブ⽬的を与えてサブ⽅策から	
(⽅策を分割せず)	順次学習
階層型強化学習
⽬的を	(⾃律的に)	分割して	
⽅策を階層化する
サブ報酬関数
分散型強化学習
サンプリングを並列化
逆強化学習
報酬の逆推定
※	わかりやすさ重視で簡略化多様な強化学習技術
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
37
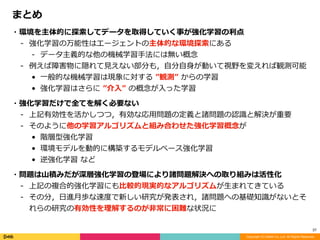
・環境を主体的に探索してデータを取得していく事が強化学習の利点	
- 強化学習の万能性はエージェントの主体的な環境探索にある	
- データ主義的な他の機械学習⼿法には無い概念	
- 例えば障害物に隠れて⾒えない部分も,⾃分⾃⾝が動いて視野を変えれば観測可能	
• ⼀般的な機械学習は現象に対する	”観測”	からの学習	
• 強化学習はさらに	”介⼊”	の概念が⼊った学習	
・強化学習だけで全てを解く必要ない	
- 上記有効性を活かしつつ,有効な応⽤問題の定義と諸問題の認識と解決が重要	
- そのように他の学習アルゴリズムと組み合わせた強化学習概念が	
• 階層型強化学習	
• 環境モデルを動的に構築するモデルベース強化学習	
• 逆強化学習	など	
・問題は⼭積みだが深層強化学習の登場により諸問題解決への取り組みは活性化	
- 上記の複合的強化学習にも⽐較的現実的なアルゴリズムが⽣まれてきている	
- その分,⽇進⽉歩な速度で新しい研究が発表され,諸問題への基礎知識がないとそ
れらの研究の有効性を理解するのが⾮常に困難な状況に
まとめ
Copyright (C) DeNA Co.,Ltd. All Rights Reserved.
引⽤⽂献	
38
[1] Sutton, R. S. and Barto, A. G. Reinforcement Learning: An Introduction. MIT Press, Cambridge, 1998.
[2] Littman, M. L. Reinforcement learning improves behaviour from evaluative feedback. Nature, 521, (7553), 445-451. 2015.
[3] Williams, R. J. Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning, 8(3-4), 229–256. 1992.
[4] V. Mnih, K. Kavukcuoglu, D. Silver, A. Rusu, J. Veness, M. Bellemare, A. Graves, M. Riedmiller. A. Fidjeland, G. Ostrovski, S. Petersen, C. Beattie, A. Sadik, I. Antonoglou, H. King, D. Kumaran, D. Wierstra, S. Legg,
and D. Hassabis. Human-level control through deep reinforcement learning. Nature 518 (7540): 529–533, 2015 http://dx.doi.org/10.1038/nature14236, (https://storage.googleapis.com/deepmind-media/dqn/
DQNNaturePaper.pdf).
[5] Hessel, Matteo, et al. "Rainbow: Combining Improvements in Deep Reinforcement Learning." arXiv preprint arXiv:1710.02298. 2017.
[6] Mnih, V., Mirza, M., Graves, A., Harley, T., Lillicrap, T. P., & Silver, D. Asynchronous Methods for Deep Reinforcement Learning. International Conference on Machine Learning (ICML 2016), 2016.
[7] Silver, D., Schrittwieser, J., Simonyan, K., Antonoglou, I., Huang, A., Hubert, T., Hassabis, D., et al.: Mastering the Game of Go without Human Knowledge. 2017.
[8] Jaderberg, M., Mnih, V., Czarnecki, W.M., Schaul, T., Leibo, J.Z., Silver, D., and Kavukcuoglu, K. Reinforcement learning with unsupervised auxiliary tasks. In International Conference on Learning Representations.
2017.
[9] Teh, Y. W., Bapst, V., Czarnecki, W. M., Quan, J., Kirkpatrick, J., Hadsell, R. Pascanu, R., et.al.: Distral : Robust Multitask Reinforcement Learning. NIPS. 2017.
[10] Bellemare, M. G., Schaul, T., Saxton, D., and Ostrovski, G. Unifying Count-Based Exploration and Intrinsic Motivation, NIPS. 2016.
[11] Ostrovski, G., Bellemare, M. G., Oord, V. D. O., Munon, R. Count-Based Exploration with Neural Density Models. NIPS. 2017.
[12] Weber, T., Racanière, S., Reichert, D. P., Buesing, L., et.al.: Imagination-Augmented Agents for Deep Reinforcement Learning. NIPS. 2017. arXiv. https://arxiv.org/pdf/1707.06203.pdf
[13] Vezhnevets, A., Mnih, V., Osindero, S., Graves, A., Vinyals, O., Agapiou, J., et al.: Strategic attentive writer for learning macro-actions. In: Advances in Neural Information Processing Systems, pp. 3486–3494 2016.
[FuN: Vezhnevets, 2017] Vezhnevets, A. S., Osindero, S., Schaul, T., Heess, N., Jaderberg, M., Silver, D., and Kavukcuoglu, K. FeUdal Networks for Hierarchical Reinforcement Learning. 2017. (http://arxiv.org/abs/
1703.01161)
[14] Bacon, P.-L., Harb, J., Precup, D. The option-critic architecture. Proceedings of AAAI, 1726–1734, 2017.
[15] Vezhnevets, A., Mnih, V., Agapiou, J., Osindero, S., Graves, A., Vinyals, O., Kavukcuoglu, K. Strategic Attentive Writer for Learning Macro-Actions. ArXiv. Retrieved from https://arxiv.org/abs/1606.04695, 2016.
[16] Vezhnevets, A. S., Osindero, S., Schaul, T., Heess, N., Jaderberg, M., Silver, D., and Kavukcuoglu, K. FeUdal Networks for Hierarchical Reinforcement Learning. ArXiv. Retrieved from http://arxiv.org/abs/1703.01161 ,
2017.
[17] Kulkarni, T. D., Narasimhan, K., Saeedi, A., Tenenbaum, J. B. Hierarchical Deep Reinforcement Learning: Integrating Temporal Abstraction and Intrinsic Motivation. Proceedings of the 30th Conference on Neural
Information Processing Systems (NIPS 2016), 2016.
[18] Florensa, C., Duan, Y., Abbeel, P. Stochastic Neural Networks for Hierarchical Reinforcement Learning. Proceedings of the International Conference on Learning Representations (ICLR 2017), 2017.
[19] Vezhnevets, A., Mnih, V., Agapiou, J., Osindero, S., Graves, A., Vinyals, O., Kavukcuoglu, K. Strategic Attentive Writer for Learning Macro-Actions. ArXiv. Retrieved from https://arxiv.org/abs/1606.04695, 2016.
[20] Andrychowicz, M., Wolski, F., Ray, A., Schneider, J., Fong, R., Welinder, P., McGrew, B., Tobin, J., Abbeel, P., Zaremba, W. Hindsight Experience Replay. Proceedings of the 31st Conference on Neural Information
Processing Systems (NIPS 2017), 2017.
[21] Mutz, F., Schmidhuber, J. Hindsight Policy Gradients. Proceedings of Hierarchical Reinforcement Learning Workshop at the 31st Conference on Neural Information Processing Systems (HRL@NIPS 2017), 2017.
[22] Barreto, A., Dabney, W., Munos, R., Hunt, J., J., Tom Schaul, Silver, D., Hasselt, H., P. Successor Features for Transfer in Reinforcement Learning. Proceedings of the 31st Conference on Neural Information Processing
Systems (NIPS 2017), 2017.
[23] Racanière, S., Weber, T., David Reichert, Buesing, L., Guez, A., Rezende, D. J., Badia, A. P., Vinyals, O., Heess, N., Li, Y., Pascanu, R. Battaglia, P., Hassabis, R., Silver, D., Wierstra, D. Imagination-Augmented Agents
for Deep Reinforcement Learning. Proceedings of the 31st Conference on Neural Information Processing Systems (NIPS 2017), 2017.
[24] Huang, V., Ley, T., Vlachou-Konchylaki, M., Hu, W. Enhanced Experience Replay Generation for Efficient Reinforcement Learning. ArXiv. Retrieved from https://arxiv.org/abs/1705.08245 , 2017.
[25] Fu, J., Co-Reyes, J., Levine, S. EX2 : Exploration with Exemplar Models for Deep Reinforcement Learning. Proceedings of the 31st Conference on Neural Information Processing Systems (NIPS 2017), 2017.
[26] Tang, H., Houthooft, R., Foote, D., Stooke, A., Chen, X., Duan, Y., Schulman, J., DeTurck, F., Abbeel, P. #Exploration: A Study of Count-Based Exploration for Deep Reinforcement Learning. Proceedings of the 31st
Conference on Neural Information Processing Systems (NIPS 2017), 2017.
[27] Xu, Z., Modayil, J., Hasselt, H., P., Barreto, A., Silver, D., Schaul, T. Natural Value Approximators: Learning when to Trust Past Estimates. Proceedings of the 31st Conference on Neural Information Processing Systems
(NIPS 2017), 2017.
[28] Lillicrap, T. P., Hunt, J. J., Pritzel, A., Heess, N., Erez, T., Tassa, Y., Silver, D., and Wierstra, D. Continuous control with deep reinforcement learning. arXiv preprint arXiv:1509.02971, 2015.
[29] Wang, Z., Bapst, V., Heess, N., Mnih, V., Munos, R., Kavukcuoglu, K., and de Freitas, N. (2016). Sample efficient actor-critic with experience replay. International Conference on Learning Representations (ICLR 2017),
2017.
[30] O’Donoghue, B., Munos, R., Kavukcuoglu, K., and Mnih, V. PGQ: Combining policy gradient and Q-learning. arXiv preprint arXiv:1611.01626, 2016.
[31] Nachum, O., Norouzi, M., Xu, K. and Schuurmans, D. Bridging the gap between value and policy based reinforcement learning. arXiv preprint arXiv:1702.08892, 2017.
[32] Haarnoja, T., Zhou, A., Abbeel, P. and Levine, S. Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor. International Conference on Machine Learning (ICML 2018),
2018
[33] Ha, D., Schmidhuber, J., World Models, 2018. https://arxiv.org/abs/1803.10122
[34] Ho, J. and Ermon, S. Generative adversarial imitation learning. In Advances in Neural Information Processing Systems (NIPS 2016), pp. 4565–4573. 2016.
[35] Peng, X.B., Abbeel, P., Levine, S., van de Panne, M. DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills. arXiv preprint arXiv:1804.02717. 2018.
[36] S, Sukhbaatar, et al. Intrinsic motivation and automatic curricula via asymmetric self-play. In ICLR. 2017. https://openreview.net/forum?id=SkT5Yg-RZ http://search.iclr2018.smerity.com/
[37] Horgan, D., Quan, J., Budden, D., Barth-Maron,G., Hessel, M., van Hasselt, H., and Silver, D. Distributed prioritized experience replay. International Conference on Learning Representations (ICLR 2018), 2018. https://
openreview.net/forum?id=H1Dy---0Z
[38] Kirkpatrick, J., Pascanu, R., Rabinowitz, N., Veness, J., Desjardins, G., Rusu, A.A., …. Overcoming catastrophic forgetting in neural networks. the National Academy of Sciences 114 (13), 3521-3526. 2017.
[39] Pritzel, A., Uria, B., Sriram Srinivasan, ‘Puig-dome’nech, A., Vinyals, O., Hassabis, D., Wierstra, D., and Blundell, C.. Neural Episodic Control. International Conference on Machine Learning (ICML 2017), 2017.
[41] Graves, A.,Wayne, G., Danihelka, I. Neural turing machines. arXiv preprint arXiv:1410.5401. 2014.
[42] Graves, A., Wayne, G., Reynolds, M., Harley, T., Danihelka, I., Grabska-Barwińska, A., ... & Badia, A. P. Hybrid computing using a neural network with dynamic external memory. Nature. 2016.
[43] https://www.kdnuggets.com/2017/03/next-challenges-reinforcement-learning.html
[44] Reinforcement Learning never worked, and 'deep' only helped a bit. FEBRUARY 23, 2018 ( http://bit.ly/2MdnMoV)