Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
Deep Learning JP
PPTX, PDF
892 views
【DL輪読会】BloombergGPT: A Large Language Model for Finance arxiv
2023/8/18 Deep Learning JP http://deeplearning.jp/seminar-2/
Technology
◦
Related topics:
Deep Learning
•
Read more
0
Save
Share
Embed
Save to Drive
Download now
Download to read offline
1
/ 18
2
/ 18
3
/ 18
4
/ 18
5
/ 18
6
/ 18
7
/ 18
8
/ 18
9
/ 18
10
/ 18
11
/ 18
12
/ 18
13
/ 18
14
/ 18
15
/ 18
16
/ 18
17
/ 18
18
/ 18
More Related Content
PPTX
【DL輪読会】AdaptDiffuser: Diffusion Models as Adaptive Self-evolving Planners
by
Deep Learning JP
28 slides
960 views
PPTX
【DL輪読会】事前学習用データセットについて
by
Deep Learning JP
20 slides
788 views
PPTX
【DL輪読会】 "Learning to render novel views from wide-baseline stereo pairs." CVP...
by
Deep Learning JP
26 slides
352 views
PPTX
【DL輪読会】Zero-Shot Dual-Lens Super-Resolution
by
Deep Learning JP
26 slides
328 views
PPTX
【DL輪読会】マルチモーダル LLM
by
Deep Learning JP
14 slides
501 views
PDF
【 DL輪読会】ToolLLM: Facilitating Large Language Models to Master 16000+ Real-wo...
by
Deep Learning JP
17 slides
174 views
PPTX
【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
by
Deep Learning JP
30 slides
646 views
PDF
【DL輪読会】Can Neural Network Memorization Be Localized?
by
Deep Learning JP
15 slides
695 views
【DL輪読会】AdaptDiffuser: Diffusion Models as Adaptive Self-evolving Planners
by
Deep Learning JP
28 slides
960 views
【DL輪読会】事前学習用データセットについて
by
Deep Learning JP
20 slides
788 views
【DL輪読会】 "Learning to render novel views from wide-baseline stereo pairs." CVP...
by
Deep Learning JP
26 slides
352 views
【DL輪読会】Zero-Shot Dual-Lens Super-Resolution
by
Deep Learning JP
26 slides
328 views
【DL輪読会】マルチモーダル LLM
by
Deep Learning JP
14 slides
501 views
【 DL輪読会】ToolLLM: Facilitating Large Language Models to Master 16000+ Real-wo...
by
Deep Learning JP
17 slides
174 views
【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
by
Deep Learning JP
30 slides
646 views
【DL輪読会】Can Neural Network Memorization Be Localized?
by
Deep Learning JP
15 slides
695 views
More from Deep Learning JP
PPTX
【DL輪読会】Hopfield network 関連研究について
by
Deep Learning JP
29 slides
3.9K views
PPTX
【DL輪読会】SimPer: Simple self-supervised learning of periodic targets( ICLR 2023 )
by
Deep Learning JP
14 slides
586 views
PDF
【DL輪読会】RLCD: Reinforcement Learning from Contrast Distillation for Language M...
by
Deep Learning JP
20 slides
370 views
PDF
【DL輪読会】"Secrets of RLHF in Large Language Models Part I: PPO"
by
Deep Learning JP
21 slides
1.4K views
PPTX
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
PPTX
【DL輪読会】Llama 2: Open Foundation and Fine-Tuned Chat Models
by
Deep Learning JP
38 slides
2.5K views
PDF
【DL輪読会】"Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware"
by
Deep Learning JP
12 slides
1.3K views
PPTX
【DL輪読会】Parameter is Not All You Need:Starting from Non-Parametric Networks fo...
by
Deep Learning JP
21 slides
678 views
PDF
【DL輪読会】Drag Your GAN: Interactive Point-based Manipulation on the Generative ...
by
Deep Learning JP
25 slides
1.1K views
PDF
【DL輪読会】Self-Supervised Learning from Images with a Joint-Embedding Predictive...
by
Deep Learning JP
26 slides
3.3K views
PPTX
【DL輪読会】Towards Understanding Ensemble, Knowledge Distillation and Self-Distil...
by
Deep Learning JP
21 slides
785 views
PPTX
【DL輪読会】VIP: Towards Universal Visual Reward and Representation via Value-Impl...
by
Deep Learning JP
17 slides
275 views
PDF
【DL輪読会】Deep Transformers without Shortcuts: Modifying Self-attention for Fait...
by
Deep Learning JP
32 slides
471 views
PPTX
【DL輪読会】マルチモーダル 基盤モデル
by
Deep Learning JP
38 slides
2K views
PPTX
【DL輪読会】TrOCR: Transformer-based Optical Character Recognition with Pre-traine...
by
Deep Learning JP
14 slides
1.4K views
PDF
【DL輪読会】HyperDiffusion: Generating Implicit Neural Fields withWeight-Space Dif...
by
Deep Learning JP
21 slides
385 views
PPTX
【DL輪読会】大量API・ツールの扱いに特化したLLM
by
Deep Learning JP
19 slides
1.6K views
PDF
【DL輪読会】DINOv2: Learning Robust Visual Features without Supervision
by
Deep Learning JP
15 slides
2.8K views
PDF
【DL輪読会】Poisoning Language Models During Instruction Tuning Instruction Tuning...
by
Deep Learning JP
18 slides
780 views
PDF
【DL輪読会】Egocentric Video Task Translation (CVPR 2023 Highlight)
by
Deep Learning JP
36 slides
732 views
【DL輪読会】Hopfield network 関連研究について
by
Deep Learning JP
29 slides
3.9K views
【DL輪読会】SimPer: Simple self-supervised learning of periodic targets( ICLR 2023 )
by
Deep Learning JP
14 slides
586 views
【DL輪読会】RLCD: Reinforcement Learning from Contrast Distillation for Language M...
by
Deep Learning JP
20 slides
370 views
【DL輪読会】"Secrets of RLHF in Large Language Models Part I: PPO"
by
Deep Learning JP
21 slides
1.4K views
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
【DL輪読会】Llama 2: Open Foundation and Fine-Tuned Chat Models
by
Deep Learning JP
38 slides
2.5K views
【DL輪読会】"Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware"
by
Deep Learning JP
12 slides
1.3K views
【DL輪読会】Parameter is Not All You Need:Starting from Non-Parametric Networks fo...
by
Deep Learning JP
21 slides
678 views
【DL輪読会】Drag Your GAN: Interactive Point-based Manipulation on the Generative ...
by
Deep Learning JP
25 slides
1.1K views
【DL輪読会】Self-Supervised Learning from Images with a Joint-Embedding Predictive...
by
Deep Learning JP
26 slides
3.3K views
【DL輪読会】Towards Understanding Ensemble, Knowledge Distillation and Self-Distil...
by
Deep Learning JP
21 slides
785 views
【DL輪読会】VIP: Towards Universal Visual Reward and Representation via Value-Impl...
by
Deep Learning JP
17 slides
275 views
【DL輪読会】Deep Transformers without Shortcuts: Modifying Self-attention for Fait...
by
Deep Learning JP
32 slides
471 views
【DL輪読会】マルチモーダル 基盤モデル
by
Deep Learning JP
38 slides
2K views
【DL輪読会】TrOCR: Transformer-based Optical Character Recognition with Pre-traine...
by
Deep Learning JP
14 slides
1.4K views
【DL輪読会】HyperDiffusion: Generating Implicit Neural Fields withWeight-Space Dif...
by
Deep Learning JP
21 slides
385 views
【DL輪読会】大量API・ツールの扱いに特化したLLM
by
Deep Learning JP
19 slides
1.6K views
【DL輪読会】DINOv2: Learning Robust Visual Features without Supervision
by
Deep Learning JP
15 slides
2.8K views
【DL輪読会】Poisoning Language Models During Instruction Tuning Instruction Tuning...
by
Deep Learning JP
18 slides
780 views
【DL輪読会】Egocentric Video Task Translation (CVPR 2023 Highlight)
by
Deep Learning JP
36 slides
732 views
【DL輪読会】BloombergGPT: A Large Language Model for Finance arxiv
1.
1 “BloombergGPT: A Large
Language Model for Finance” Yuta Sawada
2.
書誌情報 ● 論文: https://arxiv.org/abs/2303.17564 ●
発行: Mar 2023 ● 概要 ○ BloombergGPTは、金融特化型のデータを含む約5690億トークンのデータセッ トで学習された500億パラメータのLLM ○ 財務タスク、汎用的なLLMベンチマーク共に高い精度を誇る
3.
背景 汎用的なLLMがあふれる中で、ドメイン特化型のLLMを開発したい ● 1750億パラメータのGPT-3に続き、Gopher(2800億)、PaLM(5400億)、 Megatron(1兆)などの大規模言語モデル(LLM)が開発 ● いずれも幅広いトピックとドメインをカバーするデータセットでトレー ニングされた汎用的なLLMに焦点が当てられている ●
金融は、NLP技術が特に重要な分野であり、センチメント分析などの金 融固有のタスクが多く存在する ● 金融ドメインに焦点を当てたLLMはまだ開発・評価されていない
4.
BloombergGPT 汎用的かつ金融ドメインに特化したハイブリッドのLLM ● モデル: 金融ドメインと一般のデータソースの両方を使用して学習した500億 パラメータのLLM ●
学習データ:従来のwebスクレイピングのものとは異なり、信頼性のあるソー スからのキュレーションしたデータを大量に含む7000億トークンのコーパス ● 評価:金融NLPベンチマークと汎用的なLLMベンチマークの両方で高精度 ● モデル構築の課題:膨大な計算を最適化するために、GPT-3やBLOOMの 取り組みの一環として開発された既存のコードを活用
5.
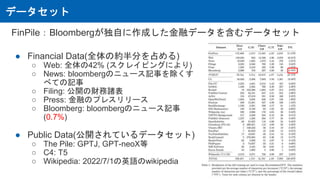
データセット FinPile:Bloombergが独自に作成した金融データを含むデータセット ● Financial Data(全体の約半分を占める) ○
Web: 全体の42% (スクレイピングにより) ○ News: bloombergのニュース記事を除くす べての記事 ○ Filing: 公開の財務諸表 ○ Press: 金融のプレスリリース ○ Bloomberg: bloombergのニュース記事 (0.7%) ● Public Data(公開されているデータセット) ○ The Pile: GPTJ, GPT-neoX等 ○ C4: T5 ○ Wikipedia: 2022/7/1の英語のwikipedia
6.
Tokenization Bloomberg Tokenizer: 金融データのため独自のトークナイザーを開発 ●
GPT-2など従来のトークナイザーの問題点 ○ 数字が、個別に認識されない ● Bloomberg Tokenizer ○ Unigramトークナイザーを実装し、The Pileを分割してトレーニング ○ 数字を個別に認識できる&マルチワードトークンに対応 ● Unigram トークナイザー ○ テキストを単語や文字などの独立した単位に分割するトークン化手法 (↔ BPEやWordPiece)
7.
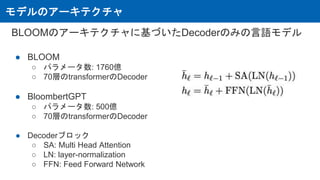
モデルのアーキテクチャ BLOOMのアーキテクチャに基づいたDecoderのみの言語モデル ● BLOOM ○ パラメータ数:
1760億 ○ 70層のtransformerのDecoder ● BloombertGPT ○ パラメータ数: 500億 ○ 70層のtransformerのDecoder ● Decoderブロック ○ SA: Multi Head Attention ○ LN: layer-normalization ○ FFN: Feed Forward Network
8.
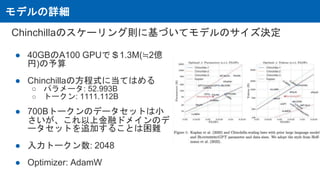
モデルの詳細 Chinchillaのスケーリング則に基づいてモデルのサイズ決定 ● 40GBのA100 GPUで$1.3M(≒2億 円)の予算 ●
Chinchillaの方程式に当てはめる ○ パラメータ: 52.993B ○ トークン: 1111.112B ● 700Bトークンのデータセットは小 さいが、これ以上金融ドメインのデ ータセットを追加することは困難 ● 入力トークン数: 2048 ● Optimizer: AdamW
9.
学習リソースと最適化手法 平均して102 TFLOPsを達成 ● 学習リソース(AWS
Sagemaker) ○ p4d.24xlarge instanceを使用 ○ 64 × 8 Nvidia 40GB A100 GPU → 合計512GPU ● 最適化手法 ○ ZeRO Optimization: 複数のGPUに分割 ○ MiCS: パブリッククラウド上で巨大なモデルをトレーニングする際の 低通信モデル並列戦略 ○ Activation Checkpointing: アクティベーションを削除 ○ Mixed Precision Training: 順方向および逆方向のパスはBF16, パラメー タはFP32 ○ Fused Kernels: 単一のGPUで複数の計算の共通化
10.
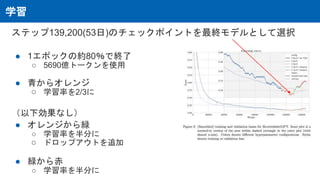
学習 ステップ139,200(53日)のチェックポイントを最終モデルとして選択 ● 1エポックの約80%で終了 ○ 5690億トークンを使用 ●
青からオレンジ ○ 学習率を2/3に (以下効果なし) ● オレンジから緑 ○ 学習率を半分に ○ ドロップアウトを追加 ● 緑から赤 ○ 学習率を半分に
11.
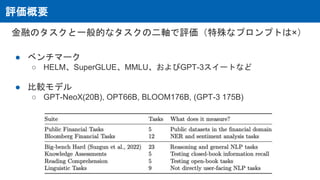
評価概要 金融のタスクと一般的なタスクの二軸で評価(特殊なプロンプトは×) ● ベンチマーク ○ HELM、SuperGLUE、MMLU、およびGPT-3スイートなど ●
比較モデル ○ GPT-NeoX(20B), OPT66B, BLOOM176B, (GPT-3 175B)
12.
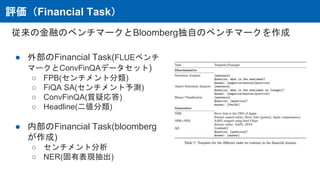
評価(Financial Task) 従来の金融のベンチマークとBloomberg独自のベンチマークを作成 ● 外部のFinancial
Task(FLUEベンチ マークとConvFinQAデータセット) ○ FPB(センチメント分類) ○ FiQA SA(センチメント予測) ○ ConvFinQA(質疑応答) ○ Headline(二値分類) ● 内部のFinancial Task(bloomberg が作成) ○ センチメント分析 ○ NER(固有表現抽出)
13.
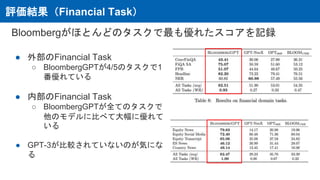
評価結果(Financial Task) Bloombergがほとんどのタスクで最も優れたスコアを記録 ● 外部のFinancial
Task ○ BloombergGPTが4/5のタスクで1 番優れている ● 内部のFinancial Task ○ BloombergGPTが全てのタスクで 他のモデルに比べて大幅に優れて いる ● GPT-3が比較されていないのが気にな る
14.
評価(Standard NLP Task) 4つの分野で一般的なタスクを評価するベンチマークを用意 ●
BIG-Bench Hard ○ BIG-benchの最も難しいタスクのサブセット ● 知識評価 ○ 学習した情報を用いて回答できるか ● 読解力 ○ プロンプトに含まれる情報に基づいて正しい回答を生成できるか ● 言語タスク ○ 曖昧性の解消、文法、含意を評価するタスクなど
15.
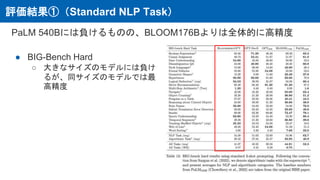
評価結果①(Standard NLP Task) PaLM
540Bには負けるものの、BLOOM176Bよりは全体的に高精度 ● BIG-Bench Hard ○ 大きなサイズのモデルには負け るが、同サイズのモデルでは最 高精度
16.
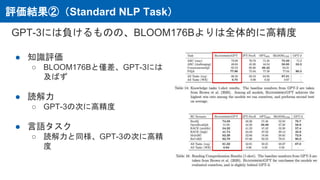
評価結果②(Standard NLP Task) GPT-3には負けるものの、BLOOM176Bよりは全体的に高精度 ●
知識評価 ○ BLOOM176Bと僅差、GPT-3には 及ばず ● 読解力 ○ GPT-3の次に高精度 ● 言語タスク ○ 読解力と同様、GPT-3の次に高精 度
17.
BloombergGPTの活用 金融ドメイン特化型のLLMならではの利点を生かした活用方法 ● Bloomberg Query
Language(BQL)の作成 ○ 自然言語をBQLに変換し、金融データにアクセスすることができる ● ニュース記事の見出しの提案 ○ ニュース記事の各セクションごとの短い見出しを作成 ● 金融に関する質問応答 ○ 例) 企業のCEOを正確に予測
18.
まとめ Bloombergが開発したドメイン特化型のLLM「BloombergGPT」 ● 金融ドメインを半分程含む7000億トークンの大規模データセット FinPileを作成 ● FinPileのための独自のトークナイザーを開発 ●
BLOOMのアーキテクチャをベースにモデルを53日間 512GPUで学習 ● 金融ドメインなタスク、汎用的なタスク共に高精度を誇る ● BQLの作成などドメイン特化LLMならではの応用が可能