Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
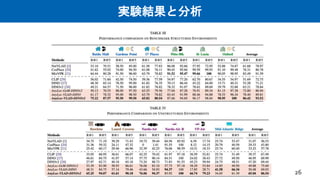
Retail
Sales
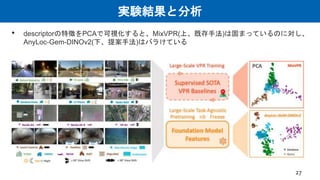
Services
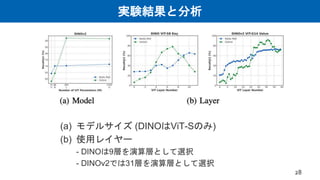
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
Deep Learning JP
PPTX, PDF
646 views
【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
2023/8/4 Deep Learning JP http://deeplearning.jp/seminar-2/
Technology
◦
Related topics:
Deep Learning
•
Read more
0
Save
Share
Embed
Save to Drive
Download now
Download to read offline
1
/ 30
2
/ 30
3
/ 30
4
/ 30
5
/ 30
6
/ 30
7
/ 30
8
/ 30
9
/ 30
10
/ 30
11
/ 30
12
/ 30
13
/ 30
14
/ 30
15
/ 30
16
/ 30
17
/ 30
18
/ 30
19
/ 30
20
/ 30
More Related Content
PPTX
ResNetの仕組み
by
Kota Nagasato
17 slides
65.2K views
PPTX
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
by
Deep Learning JP
34 slides
4.5K views
PPTX
Tensor コアを使った PyTorch の高速化
by
Yusuke Fujimoto
14 slides
9.1K views
PPTX
畳み込みニューラルネットワークの高精度化と高速化
by
Yusuke Uchida
133 slides
66.3K views
PDF
オープンソース SLAM の分類
by
Yoshitaka HARA
29 slides
35.3K views
PPTX
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
by
Deep Learning JP
24 slides
4.8K views
PPTX
【DL輪読会】マルチモーダル 基盤モデル
by
Deep Learning JP
38 slides
2K views
PPTX
近年のHierarchical Vision Transformer
by
Yusuke Uchida
46 slides
17.9K views
ResNetの仕組み
by
Kota Nagasato
17 slides
65.2K views
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
by
Deep Learning JP
34 slides
4.5K views
Tensor コアを使った PyTorch の高速化
by
Yusuke Fujimoto
14 slides
9.1K views
畳み込みニューラルネットワークの高精度化と高速化
by
Yusuke Uchida
133 slides
66.3K views
オープンソース SLAM の分類
by
Yoshitaka HARA
29 slides
35.3K views
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
by
Deep Learning JP
24 slides
4.8K views
【DL輪読会】マルチモーダル 基盤モデル
by
Deep Learning JP
38 slides
2K views
近年のHierarchical Vision Transformer
by
Yusuke Uchida
46 slides
17.9K views
What's hot
PDF
SSII2021 [TS1] Visual SLAM ~カメラ幾何の基礎から最近の技術動向まで~
by
SSII
72 slides
6.1K views
PDF
【DL輪読会】How Much Can CLIP Benefit Vision-and-Language Tasks?
by
Deep Learning JP
27 slides
1.8K views
PDF
Deep Learningによる画像認識革命 ー歴史・最新理論から実践応用までー
by
nlab_utokyo
112 slides
46.3K views
PPTX
ORB-SLAMの手法解説
by
Masaya Kaneko
39 slides
37.3K views
PPTX
Curriculum Learning (関東CV勉強会)
by
Yoshitaka Ushiku
43 slides
82.3K views
PDF
Data-Centric AIの紹介
by
Kazuyuki Miyazawa
39 slides
5.3K views
PPTX
[DL輪読会]BERT: Pre-training of Deep Bidirectional Transformers for Language Und...
by
Deep Learning JP
29 slides
21.2K views
PPTX
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets
by
Deep Learning JP
17 slides
4.6K views
PDF
SSII2022 [SS2] 少ないデータやラベルを効率的に活用する機械学習技術 〜 足りない情報をどのように補うか?〜
by
SSII
40 slides
5.5K views
PPTX
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
PDF
Visual slam
by
Takuya Minagawa
48 slides
18.9K views
PPTX
DeBERTaV3: Improving DeBERTa using ELECTRA-Style Pre-Training with Gradient-D...
by
harmonylab
36 slides
1.8K views
PDF
CVPR2018のPointCloudのCNN論文とSPLATNet
by
Takuya Minagawa
48 slides
11.8K views
PPTX
画像キャプションの自動生成
by
Yoshitaka Ushiku
101 slides
58.6K views
PPTX
Triplet Loss 徹底解説
by
tancoro
46 slides
13.3K views
PDF
敵対的生成ネットワーク(GAN)
by
cvpaper. challenge
50 slides
100.3K views
PDF
三次元点群を取り扱うニューラルネットワークのサーベイ
by
Naoya Chiba
180 slides
21.2K views
PPTX
【RSJ2021】LiDAR SLAMにおける高信頼なループ閉合の実装について
by
MobileRoboticsResear
7 slides
806 views
PDF
深層学習によるHuman Pose Estimationの基礎
by
Takumi Ohkuma
44 slides
3.9K views
PDF
ARM CPUにおけるSIMDを用いた高速計算入門
by
Fixstars Corporation
114 slides
10.9K views
SSII2021 [TS1] Visual SLAM ~カメラ幾何の基礎から最近の技術動向まで~
by
SSII
72 slides
6.1K views
【DL輪読会】How Much Can CLIP Benefit Vision-and-Language Tasks?
by
Deep Learning JP
27 slides
1.8K views
Deep Learningによる画像認識革命 ー歴史・最新理論から実践応用までー
by
nlab_utokyo
112 slides
46.3K views
ORB-SLAMの手法解説
by
Masaya Kaneko
39 slides
37.3K views
Curriculum Learning (関東CV勉強会)
by
Yoshitaka Ushiku
43 slides
82.3K views
Data-Centric AIの紹介
by
Kazuyuki Miyazawa
39 slides
5.3K views
[DL輪読会]BERT: Pre-training of Deep Bidirectional Transformers for Language Und...
by
Deep Learning JP
29 slides
21.2K views
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets
by
Deep Learning JP
17 slides
4.6K views
SSII2022 [SS2] 少ないデータやラベルを効率的に活用する機械学習技術 〜 足りない情報をどのように補うか?〜
by
SSII
40 slides
5.5K views
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
Visual slam
by
Takuya Minagawa
48 slides
18.9K views
DeBERTaV3: Improving DeBERTa using ELECTRA-Style Pre-Training with Gradient-D...
by
harmonylab
36 slides
1.8K views
CVPR2018のPointCloudのCNN論文とSPLATNet
by
Takuya Minagawa
48 slides
11.8K views
画像キャプションの自動生成
by
Yoshitaka Ushiku
101 slides
58.6K views
Triplet Loss 徹底解説
by
tancoro
46 slides
13.3K views
敵対的生成ネットワーク(GAN)
by
cvpaper. challenge
50 slides
100.3K views
三次元点群を取り扱うニューラルネットワークのサーベイ
by
Naoya Chiba
180 slides
21.2K views
【RSJ2021】LiDAR SLAMにおける高信頼なループ閉合の実装について
by
MobileRoboticsResear
7 slides
806 views
深層学習によるHuman Pose Estimationの基礎
by
Takumi Ohkuma
44 slides
3.9K views
ARM CPUにおけるSIMDを用いた高速計算入門
by
Fixstars Corporation
114 slides
10.9K views
Similar to 【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
PDF
【2015.08】(2/5)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
52 slides
4.4K views
PDF
R-SCoRe: Revisiting Scene Coordinate Regression for Robust Large-Scale Visual...
by
Takuya Minagawa
44 slides
52 views
PDF
大規模画像認識とその周辺
by
n_hidekey
36 slides
11.6K views
PDF
【2015.08】(3/5)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
53 slides
4.6K views
PPTX
Image Retrieval Overview (from Traditional Local Features to Recent Deep Lear...
by
Yusuke Uchida
37 slides
13.3K views
PDF
オープンワールド認識 (第34回全脳アーキテクチャ若手の会 勉強会)
by
Takuma Yagi
24 slides
5.8K views
PDF
Creating and Using Links between Data Objects
by
Mitsuo Yamamoto
14 slides
2.5K views
PDF
【2015.07】(2/2)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
108 slides
5.4K views
PPTX
【2016.11】cvpaper.challenge2016
by
cvpaper. challenge
60 slides
846 views
PDF
関西CVPRML勉強会 2012.2.18 (一般物体認識 - データセット)
by
Akisato Kimura
18 slides
2.9K views
PDF
【2015.08】(5/5)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
54 slides
4.9K views
PDF
【2016.01】(2/3)cvpaper.challenge2016
by
cvpaper. challenge
47 slides
3K views
PDF
20201010 personreid
by
Takuya Minagawa
53 slides
3.8K views
PDF
RobotPaperChallenge 2019-07
by
robotpaperchallenge
35 slides
626 views
PDF
【DLゼミ】XFeat: Accelerated Features for Lightweight Image Matching
by
harmonylab
23 slides
1.5K views
PDF
Towards Total Recall in Industrial Anomaly Detection
by
harmonylab
31 slides
1.7K views
PDF
MLP-Mixer: An all-MLP Architecture for Vision
by
harmonylab
25 slides
861 views
PDF
cvpaper.challenge -CVの動向とこれからの問題を作るために- (東京大学講演)
by
cvpaper. challenge
70 slides
7.7K views
PDF
【2015.07】(1/2)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
107 slides
6.2K views
PDF
【2015.06】cvpaper.challenge@CVPR2015
by
cvpaper. challenge
87 slides
10K views
【2015.08】(2/5)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
52 slides
4.4K views
R-SCoRe: Revisiting Scene Coordinate Regression for Robust Large-Scale Visual...
by
Takuya Minagawa
44 slides
52 views
大規模画像認識とその周辺
by
n_hidekey
36 slides
11.6K views
【2015.08】(3/5)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
53 slides
4.6K views
Image Retrieval Overview (from Traditional Local Features to Recent Deep Lear...
by
Yusuke Uchida
37 slides
13.3K views
オープンワールド認識 (第34回全脳アーキテクチャ若手の会 勉強会)
by
Takuma Yagi
24 slides
5.8K views
Creating and Using Links between Data Objects
by
Mitsuo Yamamoto
14 slides
2.5K views
【2015.07】(2/2)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
108 slides
5.4K views
【2016.11】cvpaper.challenge2016
by
cvpaper. challenge
60 slides
846 views
関西CVPRML勉強会 2012.2.18 (一般物体認識 - データセット)
by
Akisato Kimura
18 slides
2.9K views
【2015.08】(5/5)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
54 slides
4.9K views
【2016.01】(2/3)cvpaper.challenge2016
by
cvpaper. challenge
47 slides
3K views
20201010 personreid
by
Takuya Minagawa
53 slides
3.8K views
RobotPaperChallenge 2019-07
by
robotpaperchallenge
35 slides
626 views
【DLゼミ】XFeat: Accelerated Features for Lightweight Image Matching
by
harmonylab
23 slides
1.5K views
Towards Total Recall in Industrial Anomaly Detection
by
harmonylab
31 slides
1.7K views
MLP-Mixer: An all-MLP Architecture for Vision
by
harmonylab
25 slides
861 views
cvpaper.challenge -CVの動向とこれからの問題を作るために- (東京大学講演)
by
cvpaper. challenge
70 slides
7.7K views
【2015.07】(1/2)cvpaper.challenge@CVPR2015
by
cvpaper. challenge
107 slides
6.2K views
【2015.06】cvpaper.challenge@CVPR2015
by
cvpaper. challenge
87 slides
10K views
More from Deep Learning JP
PPTX
【DL輪読会】AdaptDiffuser: Diffusion Models as Adaptive Self-evolving Planners
by
Deep Learning JP
28 slides
960 views
PPTX
【DL輪読会】事前学習用データセットについて
by
Deep Learning JP
20 slides
788 views
PPTX
【DL輪読会】 "Learning to render novel views from wide-baseline stereo pairs." CVP...
by
Deep Learning JP
26 slides
352 views
PPTX
【DL輪読会】Zero-Shot Dual-Lens Super-Resolution
by
Deep Learning JP
26 slides
328 views
PPTX
【DL輪読会】BloombergGPT: A Large Language Model for Finance arxiv
by
Deep Learning JP
18 slides
892 views
PPTX
【DL輪読会】マルチモーダル LLM
by
Deep Learning JP
14 slides
501 views
PDF
【 DL輪読会】ToolLLM: Facilitating Large Language Models to Master 16000+ Real-wo...
by
Deep Learning JP
17 slides
174 views
PDF
【DL輪読会】Can Neural Network Memorization Be Localized?
by
Deep Learning JP
15 slides
695 views
PPTX
【DL輪読会】Hopfield network 関連研究について
by
Deep Learning JP
29 slides
3.9K views
PPTX
【DL輪読会】SimPer: Simple self-supervised learning of periodic targets( ICLR 2023 )
by
Deep Learning JP
14 slides
586 views
PDF
【DL輪読会】RLCD: Reinforcement Learning from Contrast Distillation for Language M...
by
Deep Learning JP
20 slides
370 views
PDF
【DL輪読会】"Secrets of RLHF in Large Language Models Part I: PPO"
by
Deep Learning JP
21 slides
1.4K views
PPTX
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
PPTX
【DL輪読会】Llama 2: Open Foundation and Fine-Tuned Chat Models
by
Deep Learning JP
38 slides
2.5K views
PDF
【DL輪読会】"Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware"
by
Deep Learning JP
12 slides
1.3K views
PPTX
【DL輪読会】Parameter is Not All You Need:Starting from Non-Parametric Networks fo...
by
Deep Learning JP
21 slides
678 views
PDF
【DL輪読会】Drag Your GAN: Interactive Point-based Manipulation on the Generative ...
by
Deep Learning JP
25 slides
1.1K views
PDF
【DL輪読会】Self-Supervised Learning from Images with a Joint-Embedding Predictive...
by
Deep Learning JP
26 slides
3.3K views
PPTX
【DL輪読会】Towards Understanding Ensemble, Knowledge Distillation and Self-Distil...
by
Deep Learning JP
21 slides
785 views
PPTX
【DL輪読会】VIP: Towards Universal Visual Reward and Representation via Value-Impl...
by
Deep Learning JP
17 slides
275 views
【DL輪読会】AdaptDiffuser: Diffusion Models as Adaptive Self-evolving Planners
by
Deep Learning JP
28 slides
960 views
【DL輪読会】事前学習用データセットについて
by
Deep Learning JP
20 slides
788 views
【DL輪読会】 "Learning to render novel views from wide-baseline stereo pairs." CVP...
by
Deep Learning JP
26 slides
352 views
【DL輪読会】Zero-Shot Dual-Lens Super-Resolution
by
Deep Learning JP
26 slides
328 views
【DL輪読会】BloombergGPT: A Large Language Model for Finance arxiv
by
Deep Learning JP
18 slides
892 views
【DL輪読会】マルチモーダル LLM
by
Deep Learning JP
14 slides
501 views
【 DL輪読会】ToolLLM: Facilitating Large Language Models to Master 16000+ Real-wo...
by
Deep Learning JP
17 slides
174 views
【DL輪読会】Can Neural Network Memorization Be Localized?
by
Deep Learning JP
15 slides
695 views
【DL輪読会】Hopfield network 関連研究について
by
Deep Learning JP
29 slides
3.9K views
【DL輪読会】SimPer: Simple self-supervised learning of periodic targets( ICLR 2023 )
by
Deep Learning JP
14 slides
586 views
【DL輪読会】RLCD: Reinforcement Learning from Contrast Distillation for Language M...
by
Deep Learning JP
20 slides
370 views
【DL輪読会】"Secrets of RLHF in Large Language Models Part I: PPO"
by
Deep Learning JP
21 slides
1.4K views
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
【DL輪読会】Llama 2: Open Foundation and Fine-Tuned Chat Models
by
Deep Learning JP
38 slides
2.5K views
【DL輪読会】"Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware"
by
Deep Learning JP
12 slides
1.3K views
【DL輪読会】Parameter is Not All You Need:Starting from Non-Parametric Networks fo...
by
Deep Learning JP
21 slides
678 views
【DL輪読会】Drag Your GAN: Interactive Point-based Manipulation on the Generative ...
by
Deep Learning JP
25 slides
1.1K views
【DL輪読会】Self-Supervised Learning from Images with a Joint-Embedding Predictive...
by
Deep Learning JP
26 slides
3.3K views
【DL輪読会】Towards Understanding Ensemble, Knowledge Distillation and Self-Distil...
by
Deep Learning JP
21 slides
785 views
【DL輪読会】VIP: Towards Universal Visual Reward and Representation via Value-Impl...
by
Deep Learning JP
17 slides
275 views
【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
1.
DL Hacks 2021
Introductory Session Alfredo Solano, Matsuo Laboratory 2023/08/04 Yuya TAKEDA, TMI M1 AnyLoc: Towards Universal Visual Place Recognition
2.
概要 • VPR(Visual Place
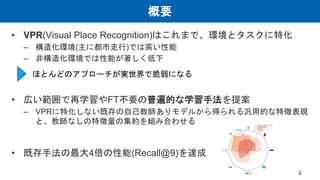
Recognition)はこれまで、環境とタスクに特化 – 構造化環境(主に都市走行)では高い性能 – 非構造化環境では性能が著しく低下 • 広い範囲で再学習やFT不要の普遍的な学習手法を提案 – VPRに特化しない既存の自己教師ありモデルから得られる汎用的な特徴表現 と、教師なしの特徴量の集約を組み合わせる • 既存手法の最大4倍の性能(Recall@9)を達成 2 ほとんどのアプローチが実世界で脆弱になる
3.
書誌情報 • 著者: Nikhil Keetha,
Avneesh Mishra, Jay Karhade, Krishna Murthy Jatavallabhula, Sebastian Scherer, Madhava Krishna, Sourav Garg • 発表:2023/08/01, arXiv • リンク – 論文 https://arxiv.org/abs/2308.00688 – コード https://github.com/AnyLoc/AnyLoc – サイト https://anyloc.github.io/ – その他 • https://colab.research.google.com/github/AnyLoc/AnyLoc/blob/main/demo/images_vlad_c lusters.ipynb • https://youtu.be/ITo8rMInatk 3
4.
背景 • VPRはしばしば画像検索問題として二つのフェーズに分けられる – インデックス作成段階 ロボットの車載カメラから、環境内をトラバース する際に参照マップ(画像データベース)を収集する –
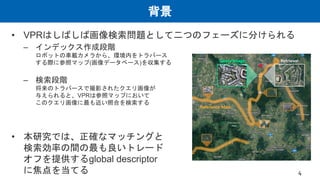
検索段階 将来のトラバースで撮影されたクエリ画像が 与えられると、VPRは参照マップにおいて このクエリ画像に最も近い照合を検索する • 本研究では、正確なマッチングと 検索効率の間の最も良いトレード オフを提供するglobal descriptor に焦点を当てる 4
5.
背景 • 最新のVPRアプローチで最も性能が良いのは、VPRに特化した データでの大規模な学習によるもの – NetVLADにおける弱教師あり対照学習は、深層学習とPitts-250kデータセッ トに代表されるように、古典的な手作業で作られた特徴量よりも大幅に改善 –
CosPlaceは分類ベー スの学習とGPSと方位を持つ4000万枚の画像からなる サンフランシスコXLデータセットを結合 – MixVPRはGSV-Citiesデータセット全世界の62,000箇所に及ぶ53万枚の画像 からなる大規模データセットで学習したMLPベースの特徴混合器を提案 5
6.
背景 • VPR学習のスケールアップの傾向 – 主に屋外環境で容易に利用できる測位データによってもたらされ、都市環境では SoTA達成につながる –
しかし、屋内や非構造な環境では一般的ではない – さらに、特徴空間内の狭い領域に集中し、学習分布外の環境における識別能力を低 下させる • 特定の課題に単独で対応しがち – シーン外観の極端な時間的変化やカメラ視点など – このようなデータおよびタスクに特化したアプローチは、そこから外れた適用性を 制限 – タスクに依存しない学習による緩和の可能性がある • そこで、本研究では、ウェブスケールの自己教師付き視覚表現を用いて VPRの設計空間を解析し、普遍的な解決策を開発 6
7.
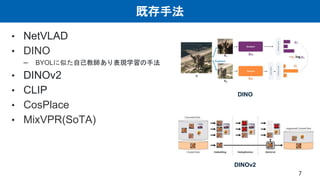
既存手法 7 • NetVLAD • DINO –
BYOLに似た自己教師あり表現学習の手法 • DINOv2 • CLIP • CosPlace • MixVPR(SoTA) DINO DINOv2
8.
手法 • 基盤モデルの特徴表現を通じてVPRソリューションの設計空間を 探索する際に現れた、2つの重要な洞察 – 既存のVPRソリューションは
タスクに特化しており、 学習分布外の環境で評価すると性能が低下(前述) – 基盤モデルの画素単位の特徴は顕著な視覚・意味的一貫性を示すが、 VPRにそのまま使用した場合、画像単位の特徴は最適でない • したがって、最近のアプローチが小規模な屋内環境や視覚言語の使 用例に限定されるなかで、これらの画素単位の不変性を画像レベル に変換し、場所を認識するためには、慎重な調査が必要 8
9.
手法 • AnyLocを設計するために、以下を調査 – VPRに最も適した基盤モデルは何か? •
視覚的特徴の抽出に最も適しているのは? – このような汎用モデルから、どのようにしてVPRに適した 局所特徴を抽出するか? • 事前学習された視覚変換器(ViT)からの抽出 – 局所特徴を集約して場所を記述するにはどうすればよいか? • パイプライン設計 – データセット間で汎化するボキャブラリーをどのように構築するか? 9
10.
手法 • AnyLocを設計するために、以下を調査 – VPRに最も適した基盤モデルは何か? •
視覚的特徴の抽出に最も適しているのは? – このような汎用モデルから、どのようにしてVPRに適した 局所特徴を抽出するか? • 事前学習された視覚変換器(ViT)からの抽出 – 局所特徴を集約して場所を記述するにはどうすればよいか? • パイプライン設計 – データセット間で汎化するボキャブラリーをどのように構築するか? 10
11.
手法 • タスクに依存しない視覚的特徴を抽出する自己教師ありの 基盤モデル – 共同埋め込み法
(DINO, DINOv2) • DINOはImageNetでグローバルな画像レベルの自己教師あり学習 • DINOv2は画像とトークンレベルの共同損失により、より大規模で慎重にキュレーション されたデ ータセットで学習 – 対照学習 (CLIP) – マスクドオートエンコーディング法 (MAE) • トークンレベルのMAEより他のモデルの方が良い性能を示す – 理論的には、ジョイントエンベディング手法で捉えられた長距離グローバル パターンを学習することの利点が強調されている AnyLoc では、DINO と DINOv2 を用いて視覚的特徴を抽出 11
12.
手法 • AnyLocを設計するために、以下を調査 – VPRに最も適した基盤モデルは何か? •
視覚的特徴の抽出に最も適しているのは? – このような汎用モデルから、どのようにしてVPRに適した 局所特徴を抽出するか? • 事前学習された視覚変換器(ViT)からの抽出 – 局所特徴を集約して場所を記述するにはどうすればよいか? • パイプライン設計 – データセット間で汎化するボキャブラリーをどのように構築するか? 12
13.
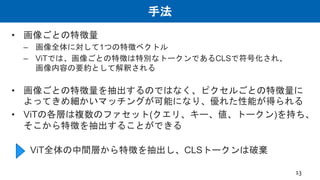
手法 • 画像ごとの特徴量 – 画像全体に対して1つの特徴ベクトル –
ViTでは、画像ごとの特徴は特別なトークンであるCLSで符号化され、 画像内容の要約として解釈される • 画像ごとの特徴量を抽出するのではなく、ピクセルごとの特徴量に よってきめ細かいマッチングが可能になり、優れた性能が得られる • ViTの各層は複数のファセット(クエリ、キー、値、トークン)を持ち、 そこから特徴を抽出することができる ViT全体の中間層から特徴を抽出し、CLSトークンは破棄 13
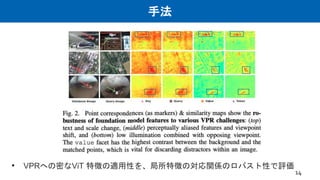
14.
手法 • VPRへの密なViT 特徴の適用性を、局所特徴の対応関係のロバスト性で評価 14
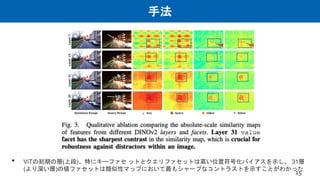
15.
手法 • ViTの初期の層(上段)、特にキーファセ ットとクエリファセットは高い位置符号化バイアスを示し、
31層 (より深い層)の値ファセットは類似性マップにおいて最もシャープなコントラストを示すことがわかった 15
16.
手法 • AnyLocを設計するために、以下を調査 – VPRに最も適した基盤モデルは何か? •
視覚的特徴の抽出に最も適しているのは? – このような汎用モデルから、どのようにしてVPRに適した 局所特徴を抽出するか? • 事前学習された視覚変換器(ViT)からの抽出 – 局所特徴を集約して場所を記述するにはどうすればよいか? • パイプライン設計 – データセット間で汎化するボキャブラリーをどのように構築するか? 16
17.
手法 • VPRパイプラインの設計では、画像の部分、ひいては環境を記述す るために、局所的な特徴がどのようにグループ化されるかを決定す る集約技術を選択することが必要 • 先行研究では画像検索にCLSトークンを直接利用しているが、 普遍的な検索設定(再学習やFTが禁止されている)では逆効果 •
複数の教師なし集計技術を包括的に探求 – グローバル平均プーリング(GAP) – グロ ーバル最大プーリング(GMP) – 一般化平均プーリング(GeM) – VLADのソフト&ハード割り当て変種 17
18.
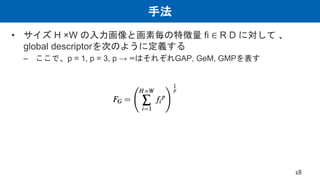
手法 • サイズ H
×W の入力画像と画素毎の特徴量 fi ∈ R D に対して 、 global descriptorを次のように定義する – ここで、p = 1, p = 3, p → ∞はそれぞれGAP, GeM, GMPを表す 18
19.
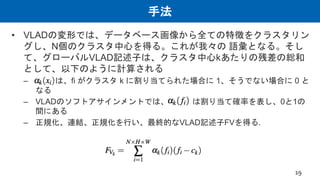
手法 • VLADの変形では、データベース画像から全ての特徴をクラスタリン グし、N個のクラスタ中心を得る。これが我々の 語彙となる。そし て、グローバルVLAD記述子は、クラスタ中心kあたりの残差の総和 として、以下のように計算される –
αk(xi)は、fi がクラスタ k に割り当てられた場合に 1、そうでない場合に 0 と なる – VLADのソフトアサインメントでは、 は割り当て確率を表し、0と1の 間にある – 正規化、連結、正規化を行い、最終的なVLAD記述子FVを得る. 19
20.
手法 • AnyLocを設計するために、以下を調査 – VPRに最も適した基盤モデルは何か? •
視覚的特徴の抽出に最も適しているのは? – このような汎用モデルから、どのようにしてVPRに適した 局所特徴を抽出するか? • 事前学習された視覚変換器(ViT)からの抽出 – 局所特徴を集約して場所を記述するにはどうすればよいか? • パイプライン設計 – データセット間で汎化するボキャブラリーをどのように構築するか? 20
21.
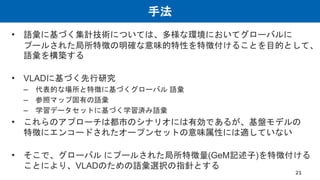
手法 • 語彙に基づく集計技術については、多様な環境においてグローバルに プールされた局所特徴の明確な意味的特性を特徴付けることを目的として、 語彙を構築する • VLADに基づく先行研究 –
代表的な場所と特徴に基づくグローバル 語彙 – 参照マップ固有の語彙 – 学習データセットに基づく学習済み語彙 • これらのアプローチは都市のシナリオには有効であるが、基盤モデルの 特徴にエンコードされたオープンセットの意味属性には適していない • そこで、グローバル にプールされた局所特徴量(GeM記述子)を特徴付ける ことにより、VLADのための語彙選択の指針とする 21
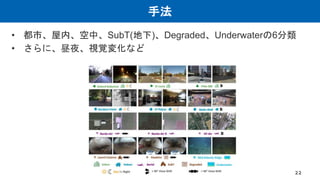
22.
手法 • 都市、屋内、空中、SubT(地下)、Degraded、Underwaterの6分類 • さらに、昼夜、視覚変化など 22
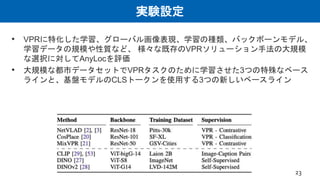
23.
実験設定 • VPRに特化した学習、グローバル画像表現、学習の種類、バックボーンモデル、 学習データの規模や性質など、 様々な既存のVPRソリューション手法の大規模 な選択に対してAnyLocを評価 •
大規模な都市データセットでVPRタスクのために学習させた3つの特殊なベース ラインと、基盤モデルのCLSトークンを使用する3つの新しいベースライン 23
24.
実験設定 • AnyLocの命名法 – AnyLoc-aggregation-model –
aggregationはVLAD, GeM – modelはDINO, DINOv2 • 語彙の指定 – データセット間で参照画像の頻度がほぼ同等になるように、Urbanの語彙に ついては、OxfordとSt Luciaのすべての画像を使用 – (はるかに大きな)Pitts-30kデータセットでは4番目の画像のみを使用 24
25.
実験結果と分析 • ベースライン手法との比較(26頁) – SoTAのVPR技術に対するAnyLocの評価 –
構造化環境と非構造化環境、視点シフト、時間的外観の変化に対する結果 • 語彙分析(27頁) • AnyLocデザインへの洞察(28頁) • 既存のVPR学習済みVITと自己教師ありのViTの比較(29頁) 25
26.
実験結果と分析 26
27.
実験結果と分析 • descriptorの特徴をPCAで可視化すると、MixVPR(上、既存手法)は固まっているのに対し、 AnyLoc-Gem-DINOv2(下、提案手法)はバラけている 27
28.
実験結果と分析 (a) モデルサイズ (DINOはViT-Sのみ) (b)
使用レイヤー - DINOは9層を演算層として選択 - DINOv2では31層を演算層として選択 28
29.
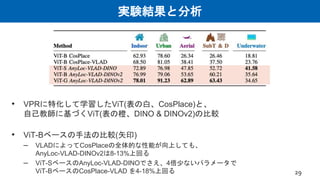
実験結果と分析 • VPRに特化して学習したViT(表の白、CosPlace)と、 自己教師に基づくViT(表の橙、DINO &
DINOv2)の比較 • ViT-Bベースの手法の比較(矢印) – VLADによってCosPlaceの全体的な性能が向上しても、 AnyLoc-VLAD-DINOv2は8-13%上回る – ViT-SベースのAnyLoc-VLAD-DINOでさえ、4倍少ないパラメータで ViT-BベースのCosPlace-VLAD を4-18%上回る 29
30.
まとめ • ユニバーサルVPRに向けた重要なステップであるAnyLocという 学習手法を提案 • 環境およびタスクに特化したVPRの限界と、基盤モデルから 抽出された画像単位の特徴の脆弱性に対し、 ピクセル単位の特徴と、VLADやGeMのような教師なし特徴集約技術 をブレンド •
非常に多様な環境セット(anywhere)、時間的変化(anytime)、 広範囲の視点変動(anyview)にわたって、普遍的なVPRを可能に – 適用範囲を拡張し、ひいては、野生のロボットナビゲーションのような下流 の能力を可能にするために極めて重要 30