ブラックボックスからXAI (説明可能なAI) へ
LIME (Local Interpretable Model-agnostic Explanations)
AIが出した予測結果の説明責任を果たす
機械学習における説明可能性 (解釈可能性)
● 高い予測精度であっても、重大な意
思決定がからむ場合には、予測結果
の「説明可能性」が重要となる (e.g.
医療現場)
● 機械学習は高い精度で予測は得意だ
が、予測の根拠などを示すのは不得
意 → ブラックボックス
● 現代の機械学習のモデルは複雑にな
りすぎて解釈が難しい → XAIが必要
● 説明可能性と解釈可能性については、
同文脈で使われることが多い
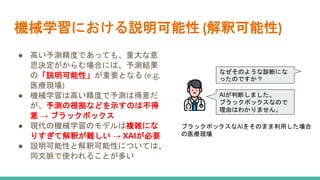
なぜそのような診断にな
ったのですか?
AIが判断しました。
ブラックボックスなので
理由はわかりません。
ブラックボックスなAIをそのまま利用した場合
の医療現場
大域的な説明と局所的な説明
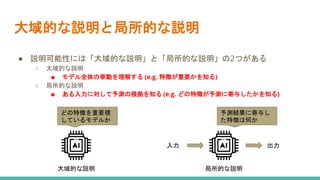
● 説明可能性には「大域的な説明」と「局所的な説明」の2つがある
○ 大域的な説明
■ モデル全体の挙動を理解する (e.g. 特徴が重要かを知る)
○ 局所的な説明
■ ある入力に対して予測の根拠を知る (e.g. どの特徴が予測に寄与したかを知る)
入力 出力
どの特徴を重要視
しているモデルか
予測結果に寄与し
た特徴は何か
大域的な説明 局所的な説明
今回紹介する論文
● “Why should I trust you?” Explaining the Predictions of Any Classifier
○ 著者: MT Ribeiro, S Singh, C Guestrin
○ 投稿: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge
Discovery and Data Mining. ACM. 2016, pp. 1135–1144.
○ 引用: 6147件 (2021/08/10 時点)
● 論文の内容
○ 人間がモデルを”信頼する”ための手法を提案
■ 予測時に何を重要視したか、局所的な説明をするためのアルゴリズムLIME
■ モデル全体を説明する、大域的な説明のためのSP-LIME
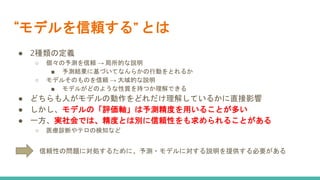
“モデルを信頼する” とは
● 2種類の定義
○ 個々の予測を信頼 → 局所的な説明
■ 予測結果に基づいてなんらかの行動をとれるか
○ モデルそのものを信頼 → 大域的な説明
■ モデルがどのような性質を持つか理解できる
● どちらも人がモデルの動作をどれだけ理解しているかに直接影響
● しかし、モデルの「評価軸」は予測精度を用いることが多い
● 一方、実社会では、精度とは別に信頼性をも求められることがある
○ 医療診断やテロの検知など
信頼性の問題に対処するために、予測・モデルに対する説明を提供する必要がある
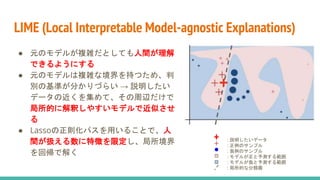
LIME (Local Interpretable Model-agnostic Explanations)
● 元のモデルが複雑だとしても人間が理解
できるようにする
● 元のモデルは複雑な境界を持つため、判
別の基準が分かりづらい → 説明したい
データの近くを集めて、その周辺だけで
局所的に解釈しやすいモデルで近似させ
る
● Lassoの正則化パスを用いることで、人
間が扱える数に特徴を限定し、局所境界
を回帰で解く
: 説明したいデータ
: 正例のサンプル
: 負例のサンプル
: モデルが正と予測する範囲
: モデルが負と予測する範囲
: 局所的な分類器
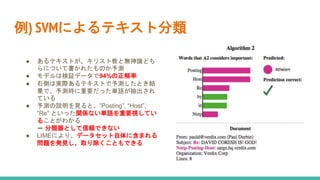
例) SVMによるテキスト分類
● あるテキストが、キリスト教と無神論どち
らについて書かれたものか予測
● モデルは検証データで94%の正解率
● 右側は実際あるテキストで予測したとき結
果で、予測時に重要だった単語が抽出され
ている
● 予測の説明を見ると、”Posting”, “Host”,
“Re” といった関係ない単語を重要視してい
ることがわかる
➡ 分類器として信頼できない
● LIMEにより、データセット自体に含まれる
問題を発見し、取り除くこともできる
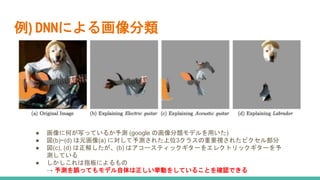
例) DNNによる画像分類
● 画像に何が写っているか予測 (google の画像分類モデルを用いた)
● 図(b)~(d) は元画像(a) に対して予測された上位3クラスの重要視されたピクセル部分
● 図(c), (d) は正解したが、(b) はアコースティックギターをエレクトリックギターを予
測している
● しかしこれは指板によるもの
→ 予測を誤ってもモデル自体は正しい挙動をしていることを確認できる
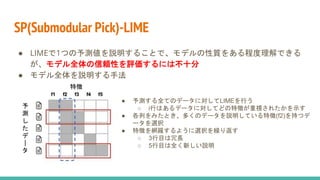
SP(Submodular Pick)-LIME
● LIMEで1つの予測値を説明することで、モデルの性質をある程度理解できる
が、モデル全体の信頼性を評価するには不十分
● モデル全体を説明する手法
予
測
し
た
デ
|
タ
特徴
● 予測する全てのデータに対してLIMEを行う
○ i行はあるデータに対してどの特徴が重視されたかを示す
● 各列をみたとき、多くのデータを説明している特徴(f2)を持つデ
ータを選択
● 特徴を網羅するように選択を繰り返す
○ 3行目は冗長
○ 5行目は全く新しい説明
論文内で検証されていること
論文では様々な切り口でLIMEの有効性を検証している
● 説明はモデルに忠実か
● 個々の予測が信頼できるか
● モデル自体を信頼できるか
● 最適なモデルを選択できるか
● 専門家でなくてもモデルを改善できるか
● 説明は洞察につながるか
それぞれの実験の詳細に関しては、概要欄にあるSlideShareを参照
まとめ
● 実世界では、機械学習は予測精度だけではなく、人がモデルを信頼
できるかどうかも重要になることがある → XAI (説明可能なAI)
● 機械学習の任意のモデルが信頼できるかを確認するための2つの手法
○ LIME: 個々の予測を説明 (局所的な説明)
○ SP-LIME: モデルの全体像を説明 (大域的な説明)
● 抽出された特徴を観察することで、モデルが信頼できる予測をできて
いるかを判断できた
● 予測に寄与するはずのない特徴などを発見でき、データセットから
不要なデータを省くこともできる
補足
● LIMEのPythonでの実装: https://github.com/marcotcr/lime
● 複雑なモデルを無理に解釈するのではなく、解釈可能なモデルを
最初から考えるべきという主張もある (SRudin, Cynthia. "Stop
explaining black box machine learning models for high stakes
decisions and use interpretable models instead." Nature
Machine Intelligence 1.5 (2019): 206-215.)
チャンネル紹介
● チャンネル名: 【経営xデータサイエンスx開発】西岡 賢一郎のチャンネル
● URL: https://www.youtube.com/channel/UCpiskjqLv1AJg64jFCQIyBg
● チャンネルの内容
○ 経営・データサイエンス・開発に関する情報を発信しています。
○ 例: アジャイル開発、データパイプライン構築、AIで使われるアルゴリズム4種類など
● noteでも情報発信しています → https://note.com/kenichiro
Appendix
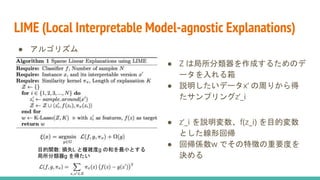
LIME (Local Interpretable Model-agnostic Explanations)
● アルゴリズム
● Z は局所分類器を作成するためのデ
ータを入れる箱
● 説明したいデータx’ の周りから得
たサンプリングz’_i
● z’_i を説明変数、f(z_i) を目的変数
とした線形回帰
● 回帰係数w でその特徴の重要度を
決める
目的関数: 損失L と複雑度g の和を最小とする
局所分類器g を得たい
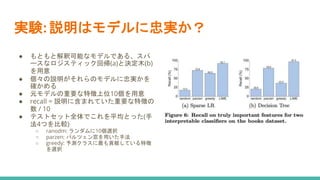
実験: 説明はモデルに忠実か?
● もともと解釈可能なモデルである、スパ
ースなロジスティック回帰(a)と決定木(b)
を用意
● 個々の説明がそれらのモデルに忠実かを
確かめる
● 元モデルの重要な特徴上位10個を用意
● recall = 説明に含まれていた重要な特徴の
数 / 10
● テストセット全体でこれを平均とった(手
法4つを比較)
○ ranodm: ランダムに10個選択
○ parzen: パルツェン窓を用いた手法
○ greedy: 予測クラスに最も貢献している特徴
を選択
実験: 個々の予測が信頼できるか?
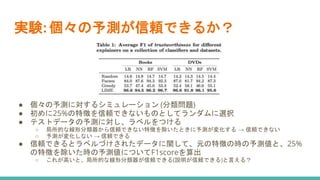
● 個々の予測に対するシミュレーション (分類問題)
● 初めに25%の特徴を信頼できないものとしてランダムに選択
● テストデータの予測に対し、ラベルをつける
○ 局所的な線形分類器から信頼できない特徴を除いたときに予測が変化する → 信頼できない
○ 予測が変化しない → 信頼できる
● 信頼できるとラベルづけされたデータに関して、元の特徴の時の予測値と、25%
の特徴を除いた時の予測値についてF1scoreを算出
○ これが高いと、局所的な線形分類器が信頼できる(説明が信頼できる)と言える?
実験: モデル自体を信頼できるか?
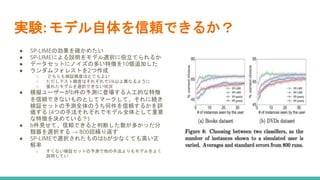
● SP-LIMEの効果を確かめたい
● SP-LIMEによる説明をモデル選択に役立てられるか
● データセットにノイズの多い特徴を10個追加した
● ランダムフォレストを2つ作成
○ どちらも検証精度はとてもよい
○ ただしテスト精度はそれぞれで5%以上異なるように
○ 優れたモデルを選択できない状況
● 模擬ユーザーがb件の予測に登場する人工的な特徴
を信頼できないものとしてマークして、それに続き
検証セットの予測全体のうち何件を信頼するかを評
価する (4つの手法それぞれでモデル全体として重要
な特徴を決めている?)
● b件見せて、信頼できると判断した数が多かった分
類器を選択する → 800回繰り返す
● SP-LIMEで選択されたものはbが少なくても高い正
解率
○ すくない検証セットの予測で他の手法よりもモデルをよく
説明してい
実験: 最適なモデルを選択できるか?
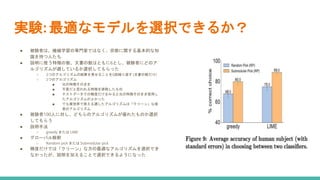
● 被験者は、機械学習の専門家ではなく、宗教に関する基本的な知
識を持つ人たち
● 説明に使う特徴の数、文書の数はともに6とし、被験者にどのア
ルゴリズムが適しているか選択してもらった
○ 2つのアルゴリズムの結果を見せることを6回繰り返す (文書の数だけ)
○ 2つのアルゴリズム
■ 元の特徴そのまま
■ 不要だと思われる特徴を排除したもの
■ テストデータでの精度だけをみると元の特徴そのまま使用し
たアルゴリズムがよかった
■ でも実世界で使える適したアルゴリズムは「クリーン」な後
者のアルゴリズム
● 被験者100人に対し、どちらのアルゴリズムが優れたものか選択
してもらう
● 説明手法
○ greedy または LIME
● グローバル解釈
○ Random pick または Submodular pick
● 精度だけでは「クリーン」な方の最適なアルゴリズムを選択でき
なかったが、説明を加えることで選択できるようになった
実験: 専門家でなくてもモデルを改善できるか?
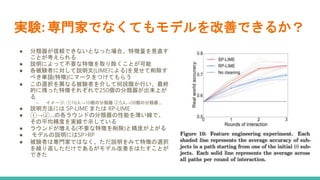
● 分類器が信頼できないとなった場合、特徴量を見直す
ことが考えられる
● 説明によって不要な特徴を取り除くことが可能
● 各被験者に対して説明文(LIMEによる)を見せて削除す
べき単語(特徴)にマークをつけてもらう
● この選択を異なる被験者を介して何段階か行い、最終
的に残った特徴それぞれで250個の分類器が出来上が
る
○ イメージ: ①10人→10個の分類器 ②5人→50個の分類器...
● 説明方法には SP-LIME または RP-LIME
● ①→②...の各ラウンドの分類器の性能を薄い線で、
その平均精度を実線で示している
● ラウンドが増える(不要な特徴を削除)と精度が上がる
● モデルの説明にはSP>RP
● 被験者は専門家ではなく、ただ説明をみて特徴の選択
を繰り返しただけであるがモデル改善をはたすことが
できた
実験: 説明は洞察につながるか?
● 収集したデータにはのぞましくないデータが入っていることがある
● これを生のデータや予測から見抜くことは難しい
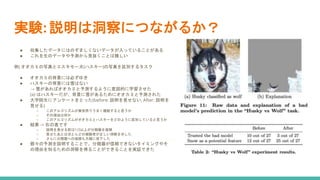
例) オオカミの写真とエスキモー犬(ハスキー)の写真を区別するタスク
● オオカミの背景には必ずゆき
● ハスキーの背景には雪はない
→ 雪があればオオカミと予測するように意図的に学習させた
(a) はハスキーだが、背景に雪があるためにオオカミと予測された
● 大学院生にアンケートをとった(before: 説明を見せない, After: 説明を
見せる)
○ このアルゴリズムが実世界でうまく機能すると思うか
○ その理由は何か
○ このアルゴリズムがオオカミとハスキーをどのように区別していると思うか
● 結果 -> 右の表です
○ 説明を見せる前は1/3以上が分類器を信頼
○ 見せたあとはほとんどの被験者が正しい洞察を示した
○ さらに分類器への信頼も大幅に低下した
● 個々の予測を説明することで、分類器が信頼できないタイミングやそ
の理由を知るための洞察を得ることができることを実証できた