Skip to main content
Recommended
PDF
PDF
Deep Learningによる画像認識革命 ー歴史・最新理論から実践応用までー
PDF
PDF
PDF
PDF
Tutorial-DeepLearning-PCSJ-IMPS2016
PPT
PDF
PPTX
MIRU2014 tutorial deeplearning
PDF
PDF
PDF
畳み込みニューラルネットワークが なぜうまくいくのか?についての手がかり
PDF
PDF
SSII2014 詳細画像識別 (FGVC) @OS2
PDF
Convolutional Neural Networks のトレンド @WBAFLカジュアルトーク#2
PDF
[論文紹介] Convolutional Neural Network(CNN)による超解像
PDF
鳥肌必至のニューラルネットワークによる近未来の画像認識技術を体験し、IoTの知られざるパワーを知る
PDF
DeepLearningDay2016Summer
PDF
PPTX
Image net classification with Deep Convolutional Neural Networks
PPTX
PDF
NVIDIA Seminar ディープラーニングによる画像認識と応用事例
PDF
PDF
Deep Learningと画像認識� �~歴史・理論・実践~
PPTX
多層NNの教師なし学習� コンピュータビジョン勉強会@関東 2014/5/26
PDF
最近のSingle Shot系の物体検出のアーキテクチャまとめ
PDF
PDF
DeepLearningDay2016Spring
PDF
K-means hashing (CVPR'13) とハッシング周り
PPTX
MS COCO Dataset Introduction
More Related Content
PDF
PDF
Deep Learningによる画像認識革命 ー歴史・最新理論から実践応用までー
PDF
PDF
PDF
PDF
Tutorial-DeepLearning-PCSJ-IMPS2016
PPT
PDF
What's hot
PPTX
MIRU2014 tutorial deeplearning
PDF
PDF
PDF
畳み込みニューラルネットワークが なぜうまくいくのか?についての手がかり
PDF
PDF
SSII2014 詳細画像識別 (FGVC) @OS2
PDF
Convolutional Neural Networks のトレンド @WBAFLカジュアルトーク#2
PDF
[論文紹介] Convolutional Neural Network(CNN)による超解像
PDF
鳥肌必至のニューラルネットワークによる近未来の画像認識技術を体験し、IoTの知られざるパワーを知る
PDF
DeepLearningDay2016Summer
PDF
PPTX
Image net classification with Deep Convolutional Neural Networks
PPTX
PDF
NVIDIA Seminar ディープラーニングによる画像認識と応用事例
PDF
PDF
Deep Learningと画像認識� �~歴史・理論・実践~
PPTX
多層NNの教師なし学習� コンピュータビジョン勉強会@関東 2014/5/26
PDF
最近のSingle Shot系の物体検出のアーキテクチャまとめ
PDF
PDF
DeepLearningDay2016Spring
Viewers also liked
PDF
K-means hashing (CVPR'13) とハッシング周り
PPTX
MS COCO Dataset Introduction
PDF
Microsoft Malware Classification Challenge 上位手法の紹介 (in Kaggle Study Meetup)
PDF
マルウェア分類に用いられる特徴量 Kaggle - Malware Classification Challenge勉強会
PPT
PDF
[DL輪読会]QUASI-RECURRENT NEURAL NETWORKS
PDF
(道具としての)データサイエンティストのつかい方
PDF
PDF
Fisher線形判別分析とFisher Weight Maps
PDF
Overview of Chainer and Its Features
PDF
PDF
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
PDF
Differences of Deep Learning Frameworks
PDF
PDF
PPTX
[DL輪読会]Wavenet a generative model for raw audio
PDF
PDF
PDF
PDF
Introduction to Chainer: A Flexible Framework for Deep Learning
Similar to 大規模画像認識とその周辺
PDF
関西CVPRML勉強会(特定物体認識) 2012.1.14
PPTX
Image Retrieval Overview (from Traditional Local Features to Recent Deep Lear...
PDF
20110904cvsaisentan(shirasy) 3 4_3
PDF
PDF
PDF
PDF
CVPR 2011 ImageNet Challenge 文献紹介
PDF
Opencv object detection_takmin
PDF
PDF
関西CVPRML勉強会 2012.2.18 (一般物体認識 - データセット)
PDF
PDF
PPTX
CVPR2018 pix2pixHD論文紹介 (CV勉強会@関東)
PDF
Deep residual learning for image recognition
PDF
コンピュータビジョンで作る未来の栽培技術POL共催セミナー_20220527
PDF
PDF
PDF
PDF
VIEW2013 Binarycode-based Object Recognition
PDF
A Study on the Generation of Clothing Captions Highlighting the Differences b...
大規模画像認識とその周辺 1. 2. Contents
} 大規模画像データで出来ることの例
} 一般物体認識の紹介
} 大規模化の流れと最近の手法について
} 大規模一般物体認識コンペティション
} 他分野との融合的領域など
3. 大規模画像データの時代
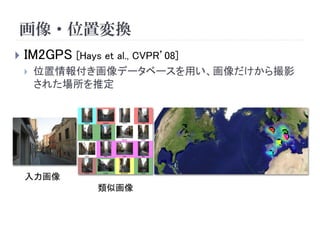
} Webサービスへの画像投稿は日常の一部
} Flickr: 60億枚の画像(2011年)
} Facebook: 毎年30億枚画像投稿
} Youtube: 毎日約8年分の動画がアップロード
} 何らかのメタ情報が付与される場合も多い
} タグ、コメント、EXIF、位置情報、・・・
} これらの大量のデータを用いることで、従来考えられ
なかったさまざまなアプリケーションが登場している
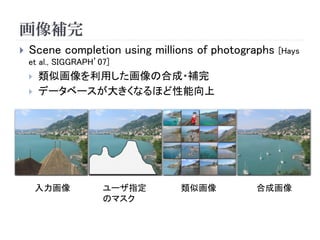
4. 画像補完
} Scene completion using millions of photographs [Hays
et al., SIGGRAPH 07]
} 類似画像を利用した画像の合成・補完
} データベースが大きくなるほど性能向上
入力画像
ユーザ指定 類似画像
合成画像
のマスク
5. 6. 三次元再構築
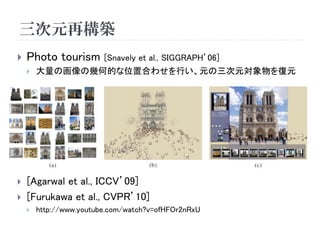
} Photo tourism [Snavely et al., SIGGRAPH 06]
} 大量の画像の幾何的な位置合わせを行い、元の三次元対象物を復元
} [Agarwal et al., ICCV 09]
} [Furukawa et al., CVPR 10]
} http://www.youtube.com/watch?v=ofHFOr2nRxU
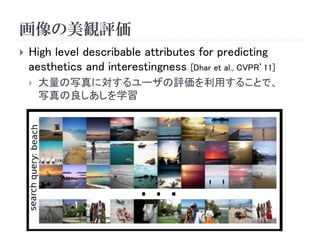
7. 画像の美観評価
} High level describable attributes for predicting
aesthetics and interestingness [Dhar et al., CVPR 11]
} 大量の写真に対するユーザの評価を利用することで、
写真の良しあしを学習
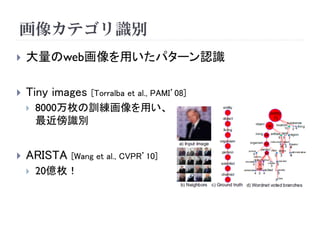
8. 画像カテゴリ識別
} 大量のweb画像を用いたパターン認識
} Tiny images [Torralba et al., PAMI 08]
} 8000万枚の訓練画像を用い、
最近傍識別
} ARISTA [Wang et al., CVPR 10]
} 20億枚!
9. 10. 一般画像認識(一般物体認識)
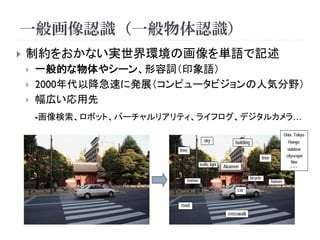
} 制約をおかない実世界環境の画像を単語で記述
} 一般的な物体やシーン、形容詞(印象語)
} 2000年代以降急速に発展(コンピュータビジョンの人気分野)
} 幅広い応用先
-画像検索、ロボット、バーチャルリアリティ、ライフログ、デジタルカメラ…
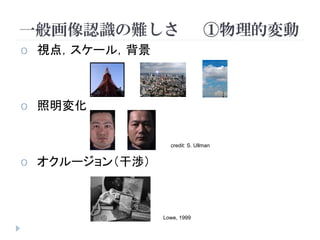
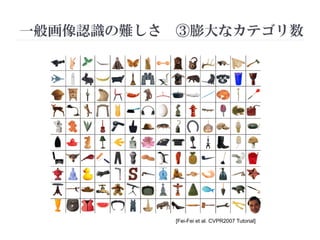
11. 一般画像認識の難しさ ①物理的変動
o 視点,スケール,背景
o 照明変化
credit: S. Ullman
o オクルージョン(干渉)
Lowe, 1999
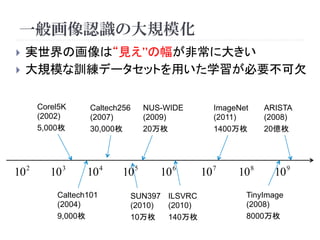
12. 13. 14. 一般画像認識の大規模化
} 実世界の画像は 見え”の幅が非常に大きい
} 大規模な訓練データセットを用いた学習が必要不可欠
Corel5K Caltech256 NUS-WIDE ImageNet ARISTA
(2002) (2007) (2009) (2011) (2008)
5,000枚
30,000枚
20万枚
1400万枚
20億枚
10 2 10 3 10 4 10 5 10 6 10 7 10 8 10 9
Caltech101 SUN397 ILSVRC TinyImage
(2004) (2010) (2010) (2008)
9,000枚
10万枚
140万枚
8000万枚
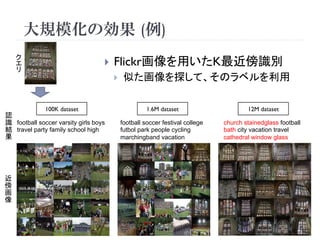
15. 大規模化の効果 (例)
} Flickr画像を用いたK最近傍識別
似た画像を探して、そのラベルを利用
}
100K dataset
1.6M dataset
12M dataset
認
識 football soccer varsity girls boys football soccer festival college church stainedglass football
結 travel party family school high
futbol park people cycling bath city vacation travel
果 marchingband vacation
cathedral window glass
近
傍
画
像
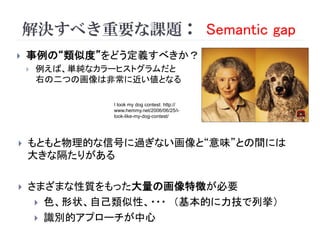
16. 解決すべき重要な課題: Semantic gap
} 事例の 類似度 をどう定義すべきか?
} 例えば、単純なカラーヒストグラムだと
右の二つの画像は非常に近い値となる
I look my dog contest: http://
www.hemmy.net/2006/06/25/i-
look-like-my-dog-contest/
} もともと物理的な信号に過ぎない画像と 意味 との間には
大きな隔たりがある
} さまざまな性質をもった大量の画像特徴が必要
} 色、形状、自己類似性、・・・ (基本的に力技で列挙)
} 識別的アプローチが中心
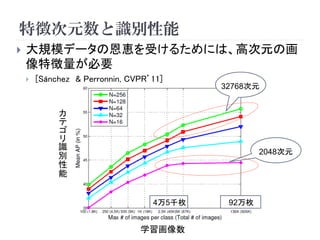
17. 特徴次元数と識別性能
} 大規模データの恩恵を受けるためには、高次元の画
像特徴量が必要
} [Sánchez & Perronnin, CVPR 11]
32768次元
識
2048次元
別
性
能
4万5千枚
92万枚
学習画像数
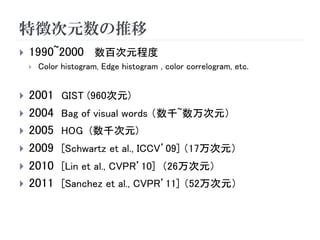
18. 特徴次元数の推移
} 1990~2000 数百次元程度
} Color histogram, Edge histogram , color correlogram, etc.
} 2001 GIST (960次元)
} 2004 Bag of visual words (数千~数万次元)
} 2005 HOG (数千次元)
} 2009 [Schwartz et al., ICCV 09] (17万次元)
} 2010 [Lin et al., CVPR 10] (26万次元)
} 2011 [Sanchez et al., CVPR 11] (52万次元)
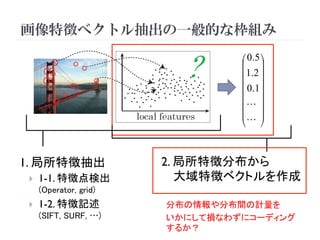
19. 画像特徴ベクトル抽出の一般的な枠組み
⎛ 0.5 ⎞
⎜ ⎟
⎜1.2 ⎟
⎜ 0.1 ⎟
⎜ ⎟
⎜ ⎟
⎜ ⎟
⎝ ⎠
1. 局所特徴抽出 2. 局所特徴分布から
} 1-1. 特徴点検出 大域特徴ベクトルを作成
(Operator, grid)
} 1-2. 特徴記述 分布の情報や分布間の計量を
(SIFT, SURF, )
いかにして損なわずにコーディング
するか?
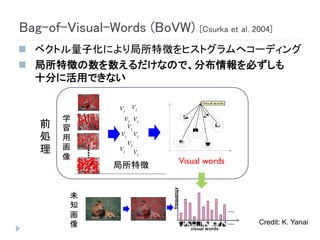
20. Bag-of-Visual-Words (BoVW) [Csurka et al. 2004]
n ベクトル量子化により局所特徴をヒストグラムへコーディング
n 局所特徴の数を数えるだけなので、分布情報を必ずしも
十分に活用できない
学
前 習
処 用
理
画
像
局所特徴
Visual words
未
知
画
像
Credit: K. Yanai
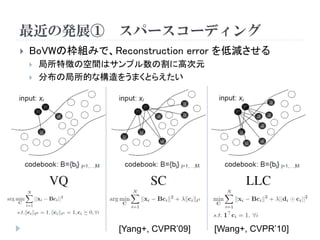
21. 最近の発展① スパースコーディング
} BoVWの枠組みで、Reconstruction error を低減させる
} 局所特徴の空間はサンプル数の割に高次元
} 分布の局所的な構造をうまくとらえたい
[Yang+, CVPR’09]
[Wang+, CVPR’10]
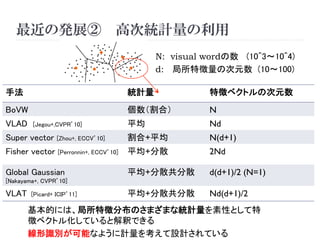
22. 最近の発展② 高次統計量の利用
N: visual wordの数 (10^3∼10^4)
d: 局所特徴量の次元数 (10∼100)
手法
統計量
特徴ベクトルの次元数
BoVW
個数(割合)
N
VLAD [Jegou+,CVPR 10]
平均
Nd
Super vector [Zhou+, ECCV 10]
割合+平均
N(d+1)
Fisher vector [Perronnin+, ECCV 10]
平均+分散
2Nd
Global Gaussian
平均+分散共分散
d(d+1)/2 (N=1)
[Nakayama+, CVPR 10]
VLAT [Picard+ ICIP 11]
平均+分散共分散
Nd(d+1)/2
基本的には、局所特徴分布のさまざまな統計量を素性として特
徴ベクトル化していると解釈できる
線形識別が可能なように計量を考えて設計されている
23. Key players
} Hervé Jégou (INRIA)
} VLAD, hamming embedding
} 類似画像検索
} Product quantization という量子化手法がかなり良いらしく、
注目されている
} Florent Perronnin (XRCE)
} Fisher vector
} 画像識別
} 最近はPQも応用している
} CVPR 2012 でチュートリアルやるそうです
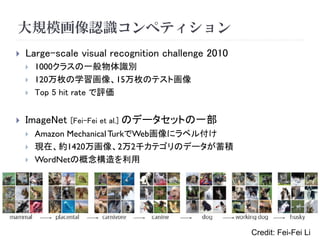
24. 大規模画像認識コンペティション
} Large-scale visual recognition challenge 2010
} 1000クラスの一般物体識別
} 120万枚の学習画像、15万枚のテスト画像
} Top 5 hit rate で評価
} ImageNet [Fei-Fei et al.] のデータセットの一部
} Amazon Mechanical TurkでWeb画像にラベル付け
} 現在、約1420万画像、2万2千カテゴリのデータが蓄積
} WordNetの概念構造を利用
Credit: Fei-Fei Li
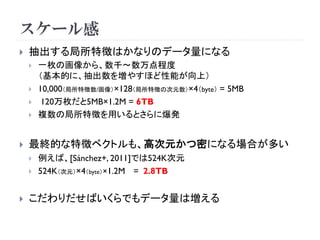
25. スケール感
} 抽出する局所特徴はかなりのデータ量になる
} 一枚の画像から、数千∼数万点程度
(基本的に、抽出数を増やすほど性能が向上)
} 10,000(局所特徴数/画像)×128(局所特徴の次元数)×4(byte) = 5MB
} 120万枚だと5MB×1.2M = 6TB
} 複数の局所特徴を用いるとさらに爆発
} 最終的な特徴ベクトルも、高次元かつ密になる場合が多い
} 例えば、[Sánchez+, 2011]では524K次元
} 524K(次元)×4(byte)×1.2M = 2.8TB
} こだわりだせばいくらでもデータ量は増える
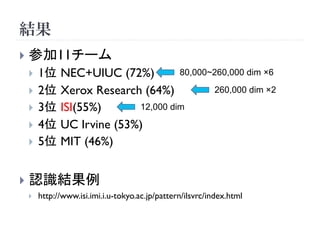
26. 結果
} 参加11チーム
} 1位 NEC+UIUC (72%) 80,000~260,000 dim ×6
} 2位 Xerox Research (64%) 260,000 dim ×2
} 3位 ISI(55%) 12,000 dim
} 4位 UC Irvine (53%)
} 5位 MIT (46%)
} 認識結果例
} http://www.isi.imi.i.u-tokyo.ac.jp/pattern/ilsvrc/index.html
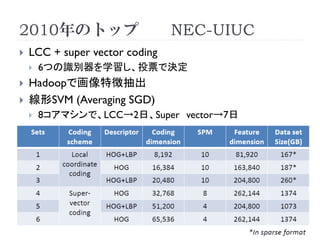
27. 2010年のトップ NEC-UIUC
} LCC + super vector coding
} 6つの識別器を学習し、投票で決定
} Hadoopで画像特徴抽出
} 線形SVM (Averaging SGD)
} 8コアマシンで、LCC→2日、Super vector→7日
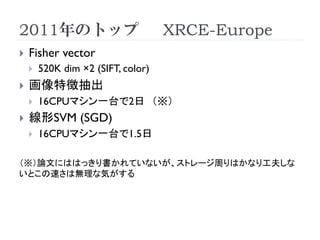
28. 2011年のトップ XRCE-Europe
} Fisher vector
} 520K dim ×2 (SIFT, color)
} 画像特徴抽出
} 16CPUマシン一台で2日 (※)
} 線形SVM (SGD)
} 16CPUマシン一台で1.5日
(※)論文にははっきり書かれていないが、ストレージ周りはかなり工夫しな
いとこの速さは無理な気がする
29. 大規模一般画像認識の現状
} 特徴抽出に関する手法的な準備は整いつつある
} 大規模な線形識別の問題に帰着 → オンライン学習など
} 今後、さらに高次元化が進むと予想される
} スパースコーディング(疎) vs Fisher vector(密)
} 処理する中間データは膨大
} 主にIOがボトルネックになる
} データ構造、ファイルシステム、ハードウェアなど含めた
トータルな実装力が必要
} 2011年のTRECVIDでは、東工大チームがTSUBAME 2.0を用い優勝
} 一般には、GPGPU+Hadoopによる特徴抽出が定番になりそう
} まだこのへんをちゃんと考えているものは少ない
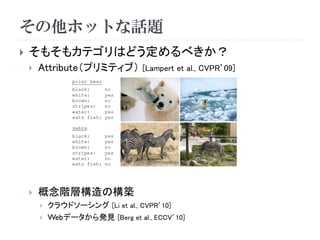
30. その他ホットな話題
} そもそもカテゴリはどう定めるべきか?
} Attribute(プリミティブ) [Lampert et al., CVPR 09]
} 概念階層構造の構築
} クラウドソーシング [Li et al., CVPR 10]
} Webデータから発見 [Berg et al., ECCV 10]
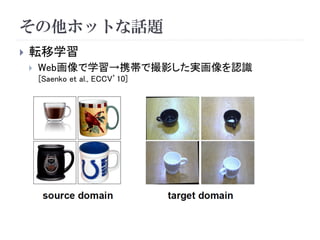
31. その他ホットな話題
} 転移学習
} Web画像で学習→携帯で撮影した実画像を認識
[Saenko et al., ECCV 10]
32. 33. 例1. CV + NLP
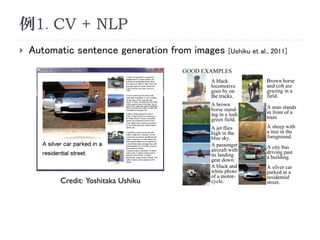
} Automatic sentence generation from images [Ushiku et al., 2011]
Credit: Yoshitaka Ushiku
34. 例1. CV + NLP
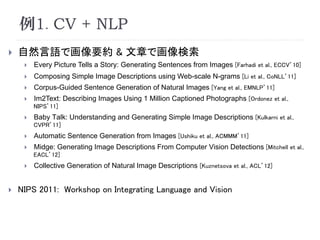
} 自然言語で画像要約 & 文章で画像検索
} Every Picture Tells a Story: Generating Sentences from Images [Farhadi et al., ECCV 10]
} Composing Simple Image Descriptions using Web-scale N-grams [Li et al., CoNLL 11]
} Corpus-Guided Sentence Generation of Natural Images [Yang et al., EMNLP 11]
} Im2Text: Describing Images Using 1 Million Captioned Photographs [Ordonez et al.,
NIPS 11]
} Baby Talk: Understanding and Generating Simple Image Descriptions [Kulkarni et al.,
CVPR 11]
} Automatic Sentence Generation from Images [Ushiku et al., ACMMM 11]
} Midge: Generating Image Descriptions From Computer Vision Detections [Mitchell et al.,
EACL 12]
} Collective Generation of Natural Image Descriptions [Kuznetsova et al., ACL 12]
} NIPS 2011: Workshop on Integrating Language and Vision
35. 36. マルチメディア情報処理:今後の展望
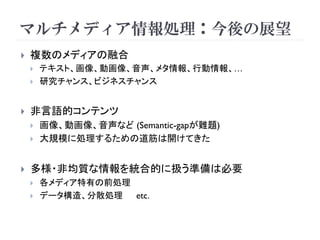
} 複数のメディアの融合
} テキスト、画像、動画像、音声、メタ情報、行動情報、…
} 研究チャンス、ビジネスチャンス
} 非言語的コンテンツ
} 画像、動画像、音声など (Semantic-gapが難題)
} 大規模に処理するための道筋は開けてきた
} 多様・非均質な情報を統合的に扱う準備は必要
} 各メディア特有の前処理
} データ構造、分散処理 etc.