Skip to main content More Related Content

PDF
【論文読み会】Deep Clustering for Unsupervised Learning of Visual Features 
PPTX
【DL輪読会】High-Resolution Image Synthesis with Latent Diffusion Models 
PDF
【メタサーベイ】基盤モデル / Foundation Models 
PPTX
【DL輪読会】ViT + Self Supervised Learningまとめ 
PPTX
Swin Transformer (ICCV'21 Best Paper) を完璧に理解する資料 
PDF
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv... 
PDF

PPTX
[DL輪読会]Flow-based Deep Generative Models What's hot

PDF
SSII2022 [TS1] Transformerの最前線〜 畳込みニューラルネットワークの先へ 〜 
PPTX

PDF
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法 
PDF
【メタサーベイ】Vision and Language のトップ研究室/研究者 
PDF

PPTX
【DL輪読会】Efficiently Modeling Long Sequences with Structured State Spaces 
PPTX
[DL輪読会]ドメイン転移と不変表現に関するサーベイ 
PPTX
[DL輪読会]NVAE: A Deep Hierarchical Variational Autoencoder 
PPTX
近年のHierarchical Vision Transformer 
PPTX
[DeepLearning論文読み会] Dataset Distillation 
PDF
[DL輪読会]Reward Augmented Maximum Likelihood for Neural Structured Prediction 
PPTX
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021) 
PDF

PDF

PPTX
Curriculum Learning (関東CV勉強会) 
PDF
深層学習によるHuman Pose Estimationの基礎 
PDF
DQNからRainbowまで 〜深層強化学習の最新動向〜 
PDF
SSII2022 [SS2] 少ないデータやラベルを効率的に活用する機械学習技術 〜 足りない情報をどのように補うか?〜 
PDF
Active Learning の基礎と最近の研究 
PPTX
More from Takahiro Kubo

PDF

PDF

PDF

PDF

PDF

PDF
arXivTimes Review: 2019年前半で印象に残った論文を振り返る 
PPTX

PDF
Expressing Visual Relationships via Language: 自然言語による画像編集を目指して 
PDF
Reinforcement Learning Inside Business 
PDF
あるべきESG投資の評価に向けた、自然言語処理の活用 
PDF
nlpaper.challenge NLP/CV交流勉強会 画像認識 7章 
PDF
Curiosity may drives your output routine. 
PDF

PPTX

PDF

PDF

PDF

PDF
TISにおける、研究開発の方針とメソッド 2018 
PDF

PDF
モデルではなく、データセットを蒸留する
- 1.
Copyright © TISInc. All rights reserved.
モデルではなく、データセットを蒸留する
戦略技術センター
久保隆宏
Dataset Distillation
- 2.
Copyright © TISInc. All rights reserved. 2
◼ 論文のサマリ
◼ 「蒸留」の種別
◼ データセットを蒸留する手順
◼ 評価
◼ 所感
◼ 参考資料
目次
- 3.
Copyright © TISInc. All rights reserved. 3
久保隆宏
TIS株式会社 戦略技術センター
◼ 化学系メーカーの業務コンサルタント出身
◼ 既存の技術では業務改善を行える範囲に限界があるとの実感から、戦
略技術センターへと異動
◼ 現在は会計/投資の現場で使える要約の実現を目指し、まとめる観点を
指定した要約の作成に関する研究を行う。
自己紹介
kintoneアプリ内にたまった
データを簡単に学習・活用
(@Cybozu Days 2016)
チュートリアル講演:深層学習
の判断根拠を理解するための研
究とその意義(@PRMU 2017)
機械学習をシステムに組み込む
際の依存性管理について
(@MANABIYA 2018)
- 4.
Copyright © TISInc. All rights reserved. 4
Dataset Distillation
◼ モデル側ではなく、データセット側を蒸留した研究
◼ MNISTでは10件のデータで94%、CIFAR-10では100件で54%の精度
を達成
◼ 転移学習、また敵対的サンプルにも使えることを確認
◼ 転移学習: 蒸留しておいたデータを、数件学習させるだけで転移さ
せる
◼ 敵対的サンプル: モデルを誤らせるデータを蒸留することで、数件
でも破壊的忘却を引き起こすデータを作成する(dataset
poisoning)
◼ ただモデルの初期値に対する依存が若干あるため、汎用的に使えるか
は今後の検証が必要。
論文のサマリ
- 5.
Copyright © TISInc. All rights reserved. 5
「蒸留」の種別 (1/2)
初期の「蒸留」の目的は、モデルのサイズの圧縮だった。「親」となるモ
デルを、より小さいサイズの「子」モデルへと変換するプロセスを「蒸
留」と呼んでいた。
その後、サイズの圧縮が目的でなくとも、「親」から「子」を作る手法が
全般的に「蒸留」と呼ばれるようになった。
◼ 「親」のモデルに手を加えて「子」を作る
◼ 枝刈り(Pruning)など
◼ 「親」を教師に「子」を学習する
◼ 半教師あり学習に近い形(親がつけたラベルで子を学習させる)
◼ 「親」からドメイン特化した「子」を作成する
◼ 転移学習に近い形
◼ 「親」から特定の性質を持つ「子」を作成する
◼ 敵対的サンプルへの抵抗力を上げるなど
- 6.
Copyright © TISInc. All rights reserved. 6
「蒸留」の種別 (2/2)
"Data Distillation: Towards Omni-Supervised Learning"という非常に
タイトルが近い論文があるが、こちらは半教師あり学習に近い話。
本研究には、Active Learningのような学習データを選択する手法が近し
い。ただ、本研究は学習データを「サンプリング」するのではなく、「生
成」するという点で異なる。
生成された学習データ(Figure1 (a)より)
- 7.
Copyright © TISInc. All rights reserved. 7
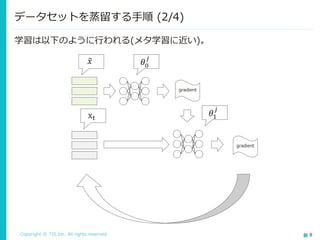
データセットを蒸留する手順 (1/4)
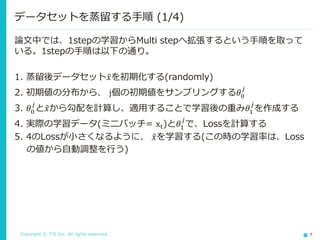
論文中では、1stepの学習からMulti stepへ拡張するという手順を取って
いる。1stepの手順は以下の通り。
1. 蒸留後データセット𝑥を初期化する(randomly)
2. 初期値の分布から、 j個の初期値をサンプリングする𝜃0
𝑗
3. 𝜃0
𝑗
と𝑥から勾配を計算し、適用することで学習後の重み𝜃1
𝑗
を作成する
4. 実際の学習データ(ミニバッチ= xt)と𝜃1
𝑗
で、Lossを計算する
5. 4のLossが小さくなるように、 𝑥を学習する(この時の学習率は、Loss
の値から自動調整を行う)
- 8.
Copyright © TISInc. All rights reserved. 8
データセットを蒸留する手順 (2/4)
𝑥 𝜃0
𝑗
𝜃1
𝑗
xt
学習は以下のように行われる(メタ学習に近い)。
gradient
gradient
- 9.
Copyright © TISInc. All rights reserved. 9
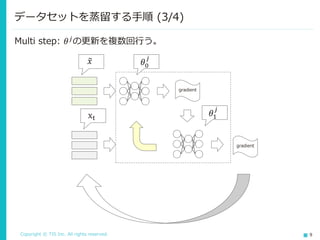
データセットを蒸留する手順 (3/4)
𝑥 𝜃0
𝑗
𝜃1
𝑗
xt
Multi step: 𝜃 𝑗
の更新を複数回行う。
gradient
gradient
- 10.
Copyright © TISInc. All rights reserved. 10
データセットを蒸留する手順 (4/4)
𝑥 𝜃0
𝑗
𝜃1
𝑗
xt
Multi epoch: 𝑥に対する更新を複数回行う。
gradient
gradient
- 11.
Copyright © TISInc. All rights reserved. 11
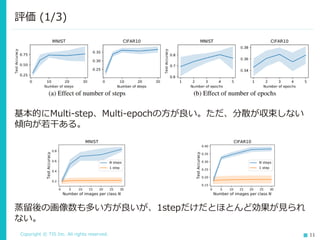
評価 (1/3)
基本的にMulti-step、Multi-epochの方が良い。ただ、分散が収束しない
傾向が若干ある。
蒸留後の画像数も多い方が良いが、1stepだけだとほとんど効果が見られ
ない。
- 12.
Copyright © TISInc. All rights reserved. 12
評価 (2/3)
同じ枚数で、ベースラインより高い精度が出せている。
ベースラインは、以下4つの手法。
◼ ランダムに選択した場合
◼ 学習効果の高かったTop20からランダムに選択
◼ k-meansでクラスタリングを行い、各クラスタのcentroidを使用
◼ 各カテゴリの画像の平均を取る
初期値は、ランダムに初期化する場合と、転移学習のようにFixされてい
る場合の2つで検証されている。
- 13.
Copyright © TISInc. All rights reserved. 13
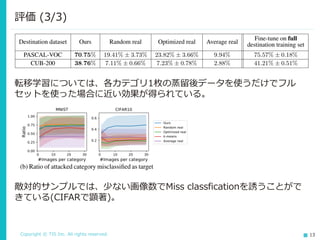
評価 (3/3)
転移学習については、各カテゴリ1枚の蒸留後データを使うだけでフル
セットを使った場合に近い効果が得られている。
敵対的サンプルでは、少ない画像数でMiss classficationを誘うことがで
きている(CIFARで顕著)。
- 14.
Copyright © TISInc. All rights reserved. 14
データセット側を蒸留するのは、学習の効率化という意味でも夢がある。
◼ 蒸留後データを使えば、CPUでも学習できる?
◼ ダウンサイズしたモデルを蒸留後データで学習させるなど
どこまで数を減らせるのかについては興味がある(一応検証はされていた
が、実体とあまりあっていなかった=式8)。
論文中でも述べられていたが、ImageNetのようなより大規模のデータ
セット、また言語や音声といった他ドメインのデータについても検証結果
が見てみたい。
所感
- 15.
- 16.


 Most read

 Most read
 Most read