Spark ベストプラクティスと 
Linear Regression with MLlib のチュートリアル 
株式会社リクルートテクノロジーズ 
アドバンスドテクノロジーラボ 
Yu Ishikawa 
1
自己紹介 
• 所属 
– 株式会社リクルートテクノロジーズ 
– アドバンスドテクノロジーラボ 
• 現在の業務 
– Apache Spark の機械学習ライブラリMLlib へのコントリ 
ビュート 
• バックグラウンド 
– 某SNS サービスの大規模データ分析基盤構築,サービス 
のデータマイニング,社内コンサルティングなど 
2
Apache Spark コミュニティと 
協力して取り組んでいること 
• Distributed Divisive Hierarchical Clustering 
• Distance Functions (Breeze) 
• kNN 
• Bootstrapping (Bag of Little Bootstraps) 
• Canopy K-mean 
• Bregman Divergence on K-means 
3
発表のねらい 
• Spark を扱う上での基本的な考え方を学ぶ 
• Logistic Regression をScala で処理する方法を学ぶ 
– アルゴリズムの詳細は解説はしません 
4
Agenda 
• Spark の基礎知識をおさらい 
• Spark ベストプラクティス 
• Logistic Regression with MLlib 
• Spark 1.2 のMLlib の動向 
5
RDD, Partition, Cache 
SPARK の基礎知識をおさらい 
6
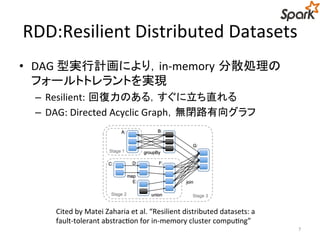
RDD:Resilient Distributed Datasets 
• DAG 型実行計画により,in-memory 分散処理の 
フォールトトレラントを実現 
– Resilient: 回復力のある,すぐに立ち直れる 
– DAG: Directed Acyclic Graph,無閉路有向グラフ 
7 
Cited by Matei Zaharia et al. “Resilient distributed datasets: a 
fault-tolerant abstraction for in-memory cluster computing”
Lazy Evaluation 
8 
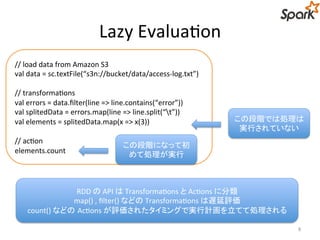
// load data from Amazon S3 
val data = sc.textFile(“s3n://bucket/data/access-log.txt”) 
// transformations 
val errors = data.filter(line => line.contains(“error”)) 
val splitedData = errors.map(line => line.split(“t”)) 
val elements = splitedData.map(x => x(3)) 
// action 
elements.count 
この段階では処理は 
実行されていない 
この段階になって初 
めて処理が実行 
RDD のAPI はTransformations とActions に分類 
map() , filter() などのTransformations は遅延評価 
count() などのActions が評価されたタイミングで実行計画を立てて処理される
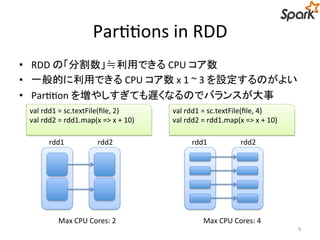
Partitions in RDD 
• RDD の「分割数」≒利用できるCPU コア数 
• 一般的に利用できるCPU コア数x 1 ~ 3 を設定するのがよい 
• Partition を増やしすぎても遅くなるのでバランスが大事 
val rdd1 = sc.textFile(file, 2) 
val rdd2 = rdd1.map(x => x + 10) 
rdd1 
9 
rdd2 
val rdd1 = sc.textFile(file, 4) 
val rdd2 = rdd1.map(x => x + 10) 
rdd1 rdd2 
Max CPU Cores: 2 Max CPU Cores: 4
Cacheとは? 
• クラスタ横断でメモリ上に処理データをキャッシュす 
ることができる 
• 繰り返し「再利用される」データに活用すると効率的 
に処理できる 
• 11000000 レコードのデータのカウント(160 cores) 
– キャッシュなし:7.48 [sec] 
– キャッシュあり:0.40 [sec] 
10 
Spark はCache の活用次第でパフォーマンスが 
大幅に変化するので注意!
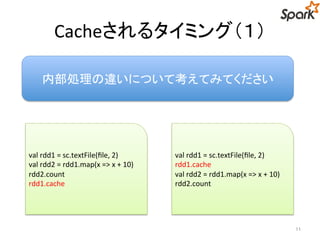
Cacheされるタイミング(1) 
11 
内部処理の違いについて考えてみてください 
val rdd1 = sc.textFile(file, 2) 
val rdd2 = rdd1.map(x => x + 10) 
rdd2.count 
rdd1.cache 
val rdd1 = sc.textFile(file, 2) 
rdd1.cache 
val rdd2 = rdd1.map(x => x + 10) 
rdd2.count
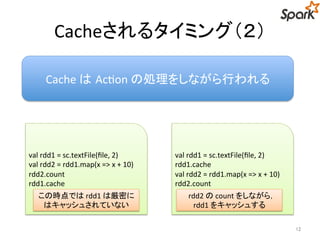
Cacheされるタイミング(2) 
12 
Cache はAction の処理をしながら行われる 
val rdd1 = sc.textFile(file, 2) 
val rdd2 = rdd1.map(x => x + 10) 
rdd2.count 
rdd1.cache 
val rdd1 = sc.textFile(file, 2) 
rdd1.cache 
val rdd2 = rdd1.map(x => x + 10) 
rdd2.count 
この時点ではrdd1 は厳密に 
はキャッシュされていない 
rdd2 のcount をしながら, 
rdd1 をキャッシュする
SPARK ベストプラクティス 
13
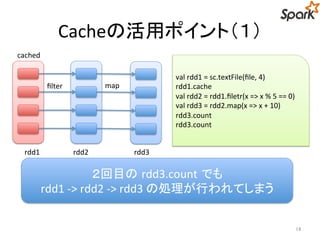
Cacheの活用ポイント(1) 
14 
cached 
filter 
val rdd1 = sc.textFile(file, 4) 
rdd1.cache 
val rdd2 = rdd1.filetr(x => x % 5 == 0) 
val rdd3 = rdd2.map(x => x + 10) 
rdd3.count 
rdd3.count 
map 
rdd1 rdd2 rdd3 
2回目のrdd3.count でも 
rdd1 -> rdd2 -> rdd3 の処理が行われてしまう
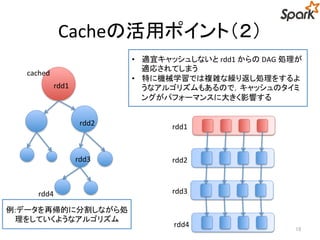
Cacheの活用ポイント(2) 
15 
cached 
rdd4 
rdd1 
rdd2 
rdd3 
• 適宜キャッシュしないとrdd1 からのDAG 処理が 
適応されてしまう 
• 特に機械学習では複雑な繰り返し処理をするよ 
うなアルゴリズムもあるので,キャッシュのタイミ 
ングがパフォーマンスに大きく影響する 
rdd1 
rdd2 
rdd3 
rdd4 
例:データを再帰的に分割しながら処 
理をしていくようなアルゴリズム
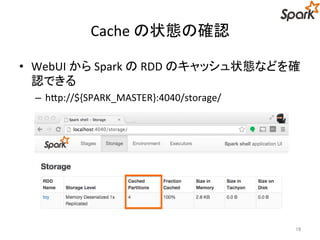
Cache の状態の確認 
• WebUI からSpark のRDD のキャッシュ状態などを確 
認できる 
– http://${SPARK_MASTER}:4040/storage/ 
16
利用データの圧縮形式 
• Gzip などで圧縮されたファイルをSpark で読み込む 
と,いくらPartition 数を増やしても1プロセスでしか 
処理することができない 
• Gzip の分割不可能の性質が原因 
– Hadoopをやったことある方にはお馴染み 
17 
• 元データを予め解凍するか 
• Spark で1回なめて,そのデータをキャッシュするなり書 
き出すなりする必要がある
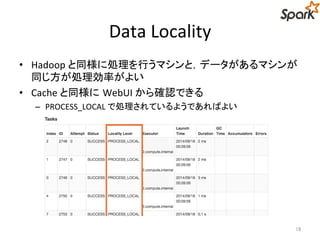
Data Locality 
• Hadoop と同様に処理を行うマシンと,データがあるマシンが 
同じ方が処理効率がよい 
• Cache と同様にWebUI から確認できる 
– PROCESS_LOCAL で処理されているようであればよい 
18
Master (Driver) に負荷を掛けない 
• RDD のcollect メソッドは,RDD をScala のコレクションに変換 
• 巨大なデータを集約しようとするとDriver が動いているマシ 
ンのメモリに乗り切らない 
• データを確認したいときは,take() やtakeSample() 
• 同様の理由で,countByKey(), countByValue(), collectAsMap() 
でも気をつける 
19 
Don't copy all elements of a large RDD to the driver!!
IntelliJ のimport 最適化問題 
• flatMap() などのTransforms メソッドは, 
org.apache.spark.SparkContext 以下に配置されてい 
る 
• IntelliJ のimport 最適化では, 
`org.apache.spark.SparkContest._` を自動追記してく 
れない 
• 手でimport 文を書く必要がある 
20 
import org.apache.spark.SparkContext._ 
rdd.flatMap(x => (1 to 10).map(i => x))
LOGISTIC REGRESSION 
CLASSIFICATION WITH MLLIB 
21
Logistic Regression with Spark 
• Logistic Regression (Classification) 
– 二項分類の予測モデルの一種 
– Regression のアルゴリズムも用意されている 
• Apache Spark 1.1 ではSGD (確率的勾配降下法) に対応したアルゴ 
リズムのみTop-Level API で利用できる 
– L-BFGS 法はTop-Level API として直接は扱えない 
• LogisticRegressionWithSGD のパラメータ(*: 必須パラメータ) 
– * Input: (ラベル,特徴量のベクトル)のRDD 
– * numIterations: Gradient Desent を実行する回数 
– stepSize(default: 1.0): SGD の 
– miniBatchFraction(default: 1.0): SGD の1回のiteration で利用するデータ 
の比率 
– initialWeights(default: ): 初期値の重みベクトル 
22
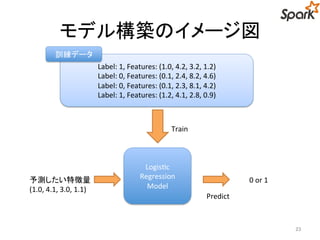
モデル構築のイメージ図 
23 
Logistic 
Regression 
Model 
予測したい特徴量 
(1.0, 4.1, 3.0, 1.1) 
Label: 1, Features: (1.0, 4.2, 3.2, 1.2) 
Label: 0, Features: (0.1, 2.4, 8.2, 4.6) 
Label: 0, Features: (0.1, 2.3, 8.1, 4.2) 
Label: 1, Features: (1.2, 4.1, 2.8, 0.9) 
Train 
訓練データ 
0 or 1 
Predict
二項分類器の評価方法 
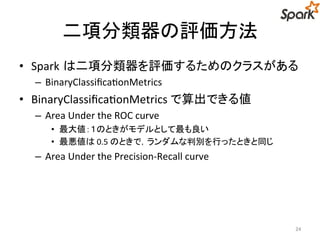
• Spark は二項分類器を評価するためのクラスがある 
– BinaryClassificationMetrics 
• BinaryClassificationMetrics で算出できる値 
– Area Under the ROC curve 
• 最大値:1のときがモデルとして最も良い 
• 最悪値は0.5 のときで,ランダムな判別を行ったときと同じ 
– Area Under the Precision-Recall curve 
24
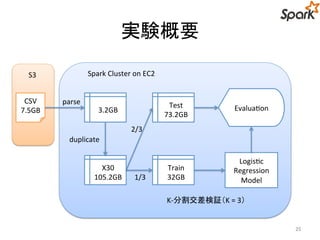
実験概要 
25 
S3 
CSV 
7.5GB 
Spark Cluster on EC2 
3.2GB 
parse 
duplicate 
X30 
105.2GB 
Test 
73.2GB 
Train 
32GB 
2/3 
1/3 
Evaluation 
Logistic 
Regression 
Model 
K-分割交差検証(K = 3)
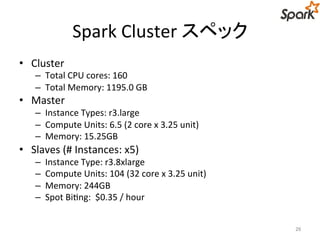
Spark Cluster スペック 
• Cluster 
– Total CPU cores: 160 
– Total Memory: 1195.0 GB 
• Master 
– Instance Types: r3.large 
– Compute Units: 6.5 (2 core x 3.25 unit) 
– Memory: 15.25GB 
• Slaves (# Instances: x5) 
– Instance Type: r3.8xlarge 
– Compute Units: 104 (32 core x 3.25 unit) 
– Memory: 244GB 
– Spot Biting: $0.35 / hour 
26
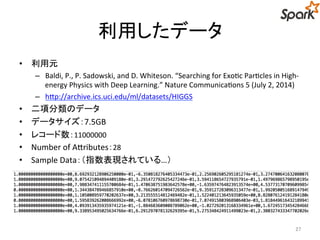
利用したデータ 
• 利用元 
– Baldi, P., P. Sadowski, and D. Whiteson. “Searching for Exotic Particles in High-energy 
Physics with Deep Learning.” Nature Communications 5 (July 2, 2014) 
– http://archive.ics.uci.edu/ml/datasets/HIGGS 
• 二項分類のデータ 
• データサイズ:7.5GB 
• レコード数:11000000 
• Number of Attributes:28 
• Sample Data:(指数表現されている…) 
27
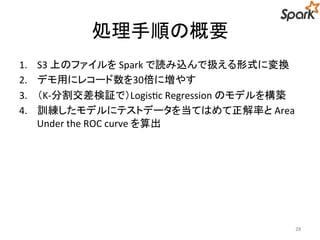
処理手順の概要 
1. S3 上のファイルをSpark で読み込んで扱える形式に変換 
2. デモ用にレコード数を30倍に増やす 
3. (K-分割交差検証で)Logistic Regression のモデルを構築 
4. 訓練したモデルにテストデータを当てはめて正解率とArea 
Under the ROC curve を算出 
28
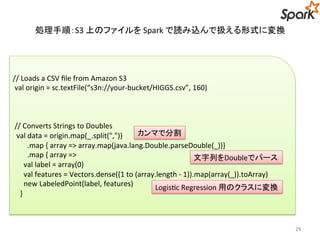
処理手順:S3 上のファイルをSpark で読み込んで扱える形式に変換 
29 
// Loads a CSV file from Amazon S3 
val origin = sc.textFile(“s3n://your-bucket/HIGGS.csv”, 160) 
// Converts Strings to Doubles 
val data = origin.map(_.split(",")) 
カンマで分割 
.map { array => array.map(java.lang.Double.parseDouble(_))} 
.map { array => 
val label = array(0) 
val features = Vectors.dense((1 to (array.length - 1)).map(array(_)).toArray) 
new LabeledPoint(label, features) 
} 
文字列をDoubleでパース 
Logistic Regression 用のクラスに変換
処理手順:デモ用にレコード数を30倍に増やす 
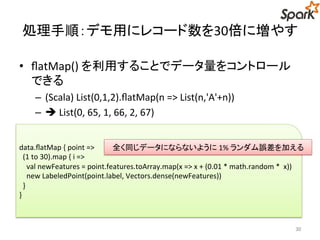
• flatMap() を利用することでデータ量をコントロール 
できる 
– (Scala) List(0,1,2).flatMap(n => List(n,'A'+n)) 
–  List(0, 65, 1, 66, 2, 67) 
全く同じデータにならないように1% ランダム誤差を加える 
30 
data.flatMap { point => 
(1 to 30).map { i => 
val newFeatures = point.features.toArray.map(x => x + (0.01 * math.random * x)) 
new LabeledPoint(point.label, Vectors.dense(newFeatures)) 
} 
}
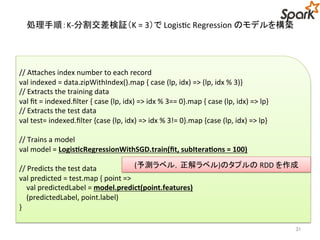
処理手順:K-分割交差検証(K = 3)でLogistic Regression のモデルを構築 
(予測ラベル,正解ラベル)のタプルのRDD を作成 
31 
// Attaches index number to each record 
val indexed = data.zipWithIndex().map { case (lp, idx) => (lp, idx % 3)} 
// Extracts the training data 
val fit = indexed.filter { case (lp, idx) => idx % 3== 0}.map { case (lp, idx) => lp} 
// Extracts the test data 
val test= indexed.filter {case (lp, idx) => idx % 3!= 0}.map {case (lp, idx) => lp} 
// Trains a model 
val model = LogisticRegressionWithSGD.train(fit, subIterations = 100) 
// Predicts the test data 
val predicted = test.map { point => 
val predictedLabel = model.predict(point.features) 
(predictedLabel, point.label) 
}
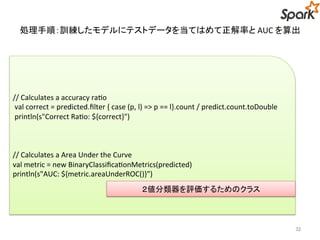
処理手順:訓練したモデルにテストデータを当てはめて正解率とAUC を算出 
32 
// Calculates a accuracy ratio 
val correct = predicted.filter { case (p, l) => p == l}.count / predict.count.toDouble 
println(s"Correct Ratio: ${correct}") 
// Calculates a Area Under the Curve 
val metric = new BinaryClassificationMetrics(predicted) 
println(s"AUC: ${metric.areaUnderROC()}") 
2値分類器を評価するためのクラス
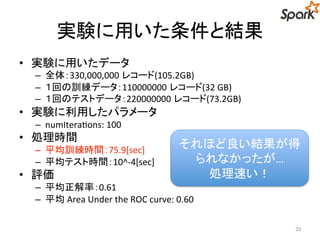
実験に用いた条件と結果 
• 実験に用いたデータ 
– 全体:330,000,000 レコード(105.2GB) 
– 1回の訓練データ:110000000 レコード(32 GB) 
– 1回のテストデータ:220000000 レコード(73.2GB) 
• 実験に利用したパラメータ 
– numIterations: 100 
• 処理時間 
– 平均訓練時間:75.9[sec] 
– 平均テスト時間:10^-4[sec] 
• 評価 
それほど良い結果が得 
– 平均正解率:0.61 
– 平均Area Under the ROC curve: 0.60 
33 
られなかったが… 
処理速い!
SPARK 1.2 のMLLIB の動向 
34
Spark MLlib の課題 
• Kmeans などの距離関数はEuclidean Distance のみ 
サポート 
– OpenNLP のScala 移植のBreeze で距離関数を実装 
• Top-Level API が一貫していない 
• アルゴリズムによって実装品質がバラバラ 
35 
リファクタリングと新規機能追加で 
卵が先か鶏が先かのような状況が起きているので 
コミュニティを主導して交通整理する必要がある
Spark 1.2 MLlib で注目のissue 
• [SPARK-3530] Pipeline and Parameters 
– scikit-learn の`fit`, `predict` のような一貫性API に向けた取り組み 
– 各アルゴリズムの対応は1.3 以降のマイルストーンになると思われる 
– [SPARK-1856] Standardize MLlib interfaces が1.3 のマイルストーン 
• [SPARK-1545] Add Random Forest algorithm to Mllib 
– Decision Tree に,ようやくRandom Forest が追加 
– 通常のDecision Tree はRandom Forest のnumTree = 1 で実装 
• [SPARK-3486] Add PySpark support for Word2Vec 
– 1.1 系のSpark のWord2Vec はスケールしにくいし,機能として不十 
分 
– 1.2 系以降で処理の改善と機能拡充が期待 
36
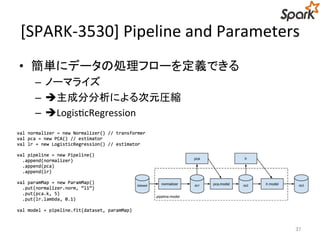
[SPARK-3530] Pipeline and Parameters 
• 簡単にデータの処理フローを定義できる 
– ノーマライズ 
– 主成分分析による次元圧縮 
– LogisticRegression 
37
今日最低限持って帰っていただきたいもの 
• Spark で処理を効率化するにあたって最低限知って 
おいていただきたいことは,RDD のPartition 数と 
Cache 
• Cache はタイミングが重要 
– Lazy Evaluation によりCache はRDD のActions API が実 
行されているときに行われる 
• MLlib なら数行程度で機械学習が使える 
– 大規模データも高速に処理できる 
38
Useful Resources 
• databricks/learning-spark 
– https://github.com/databricks/learning-spark 
– O’reilly のLearning Spark のサンプルコード 
• databricks/spark-knowledgebase 
– https://github.com/databricks/spark-knowledgebase 
– Spark のパフォーマンスチューニングなどの簡単な紹介がある 
39
リクルートテクノロジーズ 
アドバンスドテクノロジーラボでは 
人材を募集しています! 
興味のある方は懇親会でお声掛け下さい 
40
ご清聴ありがとうございました 
41
Q&A 
42