© 2021 NTT DATA Corporation
03/05/2021
Masatake Iwasaki
NTT DATA
BigtopでHadoopをビルドする
© 2021 NTT DATA Corporation 2
Apache Bigtopの取り組み紹介という切り口で以下の話題についてお話します
Hadoopエコシステムとはなにか
Javaミドルウェアのビルドシステム
Javaミドルウェアの互換性
多くのプロダクトはJavaで実装されていて、Java 8前提の話として聞いてください
ときどき出てくるBIGTOP-12345みたいなのはJIRAのissue keyです
はじめに
© 2021 NTT DATA Corporation 3
HadoopエコシステムとBigtop
© 2021 NTT DATA Corporation 4
大規模データ処理基盤
以下をセットで提供
分散ファイルシステム(HDFS)
計算リソース管理機構(YARN)
分散処理フレームワーク(MapReduce)
汎用的な(Linux)サーバ(〜10000台)でクラスタを構成する
大量のデータを格納し、並列分散処理する
2006年に登場
Googleが論文の形で紹介した技術を参考にして作られたOSS実装
Hadoopとは何か?
© 2021 NTT DATA Corporation 5
実用上、多種多様な周辺ミドルウェアと組み合わせて利用する
Spark: モダンな分散処理基盤/API (deprecating MapReduce)
Hive: SQL(ライクな)言語処理系
HBase: 分散KVS (like Bigtable)
Sqoop: データローダ
Oozie: ワークフロースケジューラ
Ranger: アクセス制御
...
プロダクト間の依存関係は複雑
バージョンアップで互換性に影響する変更がときどき入る
機能するバージョンの組み合わせを見つけるのは大変
Hadoopエコシステム
© 2021 NTT DATA Corporation 6
ディストリビューション: 機能する組み合わせでパッケージングしたもの
企業(ディストリビュータ)がビジネスとして提供する
パッケージング、継続的なupdate、テクニカルサポート
Linux(OS)の例として、Red Hat(IBM社)のRed Hat Enterprise Linux
ベースバージョンを(原則)固定してパッケージング
upstreamの機能追加やバグ修正をbackportしていく
互換性を壊す修正は入れないか、壊さないように直す
minor updateしても(原則)アプリケーションに影響を与えない
HadoopエコシステムではCloudera社がディストリビューションを提供
Red Hat同様のベースバージョン固定方式で互換性を維持
多種プロダクトの動く組み合わせをテストして提供
独自プロビジョニングツールによる運用が前提
(現在は)(CentOSのような)無償版はない
ディストリビューション
© 2021 NTT DATA Corporation 7
コミュニティベースの取り組み
Hadoopエコシステムのミドルウェアのパッケージングを提供
プロダクトとバージョンの組み合わせ選定
必要に応じてパッチ適用
.rpmおよび.debを作るための資材
# 過去に提供/公開されたCDH用の資材がベース
プロビジョニング資材
Dockerファイル/イメージ
クラスタ起動用docker-compose資材
Puppetマニフェスト
テストフレームワークとテストケース
以上をGradleタスクとして簡易に実行する枠組み
継続的なpatchのバックポートやminor updateは提供していない
テストはそれほど網羅的ではない
Apache Bigtop
© 2021 NTT DATA Corporation 8
Products:
Hadoop 2.10.1
Zookeeper 3.4.13
HBase 1.5.0
Phoenix 4.15.0-HBase-1.5
Hive 2.3.6
Spark 2.4.5
Kafka 2.4.0
...
Distros:
CentOS 7 and 8, Debian 9 and 10, Fedora 31, Ubuntu 16.04 and 18.04
Architectures:
x86_64, aarch64 # ppc64leは(マシンがなくて)テストされてない
Bigtop 1.5.0 (BIGTOP-3123)
© 2021 NTT DATA Corporation 9
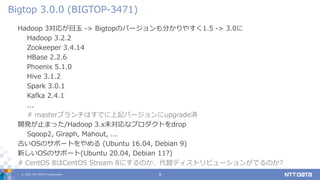
Hadoop 3対応が目玉 -> Bigtopのバージョンも分かりやすく1.5 -> 3.0に
Hadoop 3.2.2
Zookeeper 3.4.14
HBase 2.2.6
Phoenix 5.1.0
Hive 3.1.2
Spark 3.0.1
Kafka 2.4.1
...
# masterブランチはすでに上記バージョンにupgrade済
開発が止まった/Hadoop 3.x未対応なプロダクトをdrop
Sqoop2, Giraph, Mahout, ...
古いOSのサポートをやめる (Ubuntu 16.04, Debian 9)
新しいOSのサポート(Ubuntu 20.04, Debian 11?)
# CentOS 8はCentOS Stream 8にするのか、代替ディストリビューションがでるのか?
Bigtop 3.0.0 (BIGTOP-3471)
© 2021 NTT DATA Corporation 10
Compatibility
© 2021 NTT DATA Corporation 11
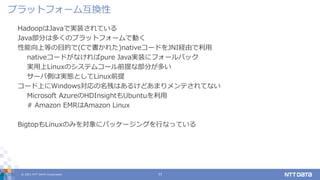
HadoopはJavaで実装されている
Java部分は多くのプラットフォームで動く
性能向上等の目的で(Cで書かれた)nativeコードをJNI経由で利用
nativeコードがなければpure Java実装にフォールバック
実用上Linuxのシステムコール前提な部分が多い
サーバ側は実態としてLinux前提
コード上にWindows対応の名残はあるけどあまりメンテされてない
Microsoft AzureのHDInsightもUbuntuを利用
# Amazon EMRはAmazon Linux
BigtopもLinuxのみを対象にパッケージングを行なっている
プラットフォーム互換性
© 2021 NTT DATA Corporation 12
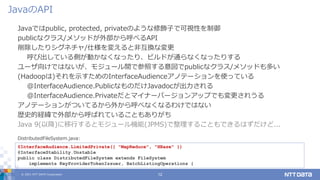
Javaではpublic, protected, privateのような修飾子で可視性を制御
publicなクラス/メソッドが外部から呼べるAPI
削除したりシグネチャ/仕様を変えると非互換な変更
呼び出している側が動かなくなったり、ビルドが通らなくなったりする
ユーザ向けではないが、モジュール間で参照する意図でpublicなクラス/メソッドも多い
(Hadoopは)それを示すためのInterfaceAudienceアノテーションを使っている
@InterfaceAudience.PublicなものだけJavadocが出力される
@InterfaceAudience.Privateだとマイナーバージョンアップでも変更されうる
アノテーションがついてるから外から呼べなくなるわけではない
歴史的経緯で外部から呼ばれていることもありがち
Java 9(以降)に移行するとモジュール機能(JPMS)で整理することもできるはずだけど...
JavaのAPI
@InterfaceAudience.LimitedPrivate({ "MapReduce", "HBase" })
@InterfaceStability.Unstable
public class DistributedFileSystem extends FileSystem
implements KeyProviderTokenIssuer, BatchListingOperations {
DistributedFileSystem.java:
© 2021 NTT DATA Corporation 13
Hadoopエコシステムのプロダクト(の多く)はMavenを利用
多くのプロダクトに依存し多くのプロダクトから依存される
ミドルウェア間で競合しがちなdependencies
SLF4J, Log4j
commons-logging, commons-cli, commons-httpclient
Jackson
Guava
Netty, Jetty, Jersey
protobuf-java
ZooKeeper, Curator
...
Mavenのdependency
© 2021 NTT DATA Corporation 14
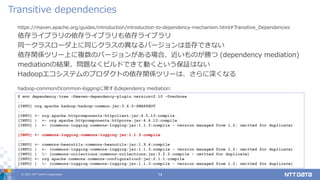
https://maven.apache.org/guides/introduction/introduction-to-dependency-mechanism.html#Transitive_Dependencies
依存ライブラリの依存ライブラリも依存ライブラリ
同一クラスローダ上に同じクラスの異なるバージョンは並存できない
依存関係ツリー上に複数のバージョンがある場合、近いものが勝つ (dependency mediation)
mediationの結果、問題なくビルドできて動くという保証はない
Hadoopエコシステムのプロダクトの依存関係ツリーは、さらに深くなる
Transitive dependencies
$ mvn dependency:tree -Dmaven-dependency-plugin.version=2.10 -Dverbose
...
[INFO] org.apache.hadoop:hadoop-common:jar:3.4.0-SNAPSHOT
...
[INFO] +- org.apache.httpcomponents:httpclient:jar:4.5.13:compile
[INFO] | +- org.apache.httpcomponents:httpcore:jar:4.4.13:compile
[INFO] | +- (commons-logging:commons-logging:jar:1.1.3:compile - version managed from 1.2; omitted for duplicate)
...
[INFO] +- commons-logging:commons-logging:jar:1.1.3:compile
...
[INFO] +- commons-beanutils:commons-beanutils:jar:1.9.4:compile
[INFO] | +- (commons-logging:commons-logging:jar:1.1.3:compile - version managed from 1.2; omitted for duplicate)
[INFO] | - (commons-collections:commons-collections:jar:3.2.2:compile - omitted for duplicate)
[INFO] +- org.apache.commons:commons-configuration2:jar:2.1.1:compile
[INFO] | - (commons-logging:commons-logging:jar:1.1.3:compile - version managed from 1.2; omitted for duplicate)
hadoop-commonのcommon-loggingに関するdependency mediation:
© 2021 NTT DATA Corporation 15
Javaで実装された(主に運用用の)APIを呼び出すモジュールを実行するシェルスクリプト
dependentがAPIではなくCLIを実行し、出力をparseすることもある
出力のフォーマットの変更や、warning出力の追加が問題になりがち (HADOOP-11257)
bash-3.0以上が前提 (HADOOP-9902)
CLI
© 2021 NTT DATA Corporation 16
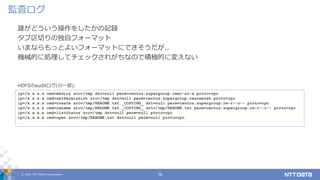
誰がどういう操作をしたかの記録
タブ区切りの独自フォーマット
いまならもっとよいフォーマットにできそうだが..
機械的に処理してチェックされがちなので積極的に変えない
監査ログ
ip=/x.x.x.x cmd=mkdirs src=/tmp dst=null perm=centos:supergroup:rwxr-xr-x proto=rpc
ip=/x.x.x.x cmd=setPermission src=/tmp dst=null perm=centos:supergroup:rwxrwxrwx proto=rpc
ip=/x.x.x.x cmd=create src=/tmp/README.txt._COPYING_ dst=null perm=centos:supergroup:rw-r--r-- proto=rpc
ip=/x.x.x.x cmd=rename src=/tmp/README.txt._COPYING_ dst=/tmp/README.txt perm=centos:supergroup:rw-r--r-- proto=rpc
ip=/x.x.x.x cmd=listStatus src=/tmp dst=null perm=null proto=rpc
ip=/x.x.x.x cmd=open src=/tmp/README.txt dst=null perm=null proto=rpc
...
HDFSのauditログ(の一部):
© 2021 NTT DATA Corporation 17
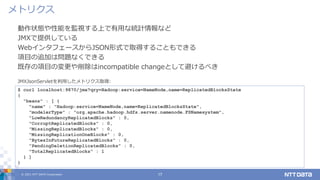
動作状態や性能を監視する上で有用な統計情報など
JMXで提供している
WebインタフェースからJSON形式で取得することもできる
項目の追加は問題なくできる
既存の項目の変更や削除はincompatible changeとして避けるべき
メトリクス
$ curl localhost:9870/jmx?qry=Hadoop:service=NameNode,name=ReplicatedBlocksState
{
"beans" : [ {
"name" : "Hadoop:service=NameNode,name=ReplicatedBlocksState",
"modelerType" : "org.apache.hadoop.hdfs.server.namenode.FSNamesystem",
"LowRedundancyReplicatedBlocks" : 0,
"CorruptReplicatedBlocks" : 0,
"MissingReplicatedBlocks" : 0,
"MissingReplicationOneBlocks" : 0,
"BytesInFutureReplicatedBlocks" : 0,
"PendingDeletionReplicatedBlocks" : 0,
"TotalReplicatedBlocks" : 1
} ]
}
JMXJsonServletを利用したメトリクス取得:
© 2021 NTT DATA Corporation 18
各プロダクトの開発者は(基本的には)それぞれ別の人
テストコードから外部向けではないAPIが使われがち
ライブラリを脆弱性起因でバージョンアップしたら非互換な変更もセットでついてきたり
互換性は意外とよく壊れる
© 2021 NTT DATA Corporation 19
building Hadoop
© 2021 NTT DATA Corporation 20
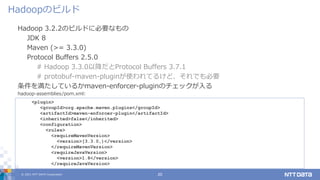
Hadoop 3.2.2のビルドに必要なもの
JDK 8
Maven (>= 3.3.0)
Protocol Buffers 2.5.0
# Hadoop 3.3.0以降だとProtocol Buffers 3.7.1
# protobuf-maven-pluginが使われてるけど、それでも必要
条件を満たしているかmaven-enforcer-pluginのチェックが入る
Hadoopのビルド
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-enforcer-plugin</artifactId>
<inherited>false</inherited>
<configuration>
<rules>
<requireMavenVersion>
<version>[3.3.0,)</version>
</requireMavenVersion>
<requireJavaVersion>
<version>1.8</version>
</requireJavaVersion>
hadoop-assemblies/pom.xml:
© 2021 NTT DATA Corporation 21
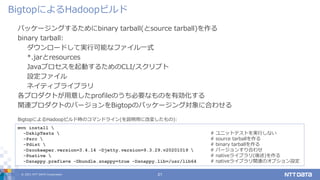
パッケージングするためにbinary tarball(とsource tarball)を作る
binary tarball:
ダウンロードして実行可能なファイル一式
*.jarとresources
Javaプロセスを起動するためのCLI/スクリプト
設定ファイル
ネイティブライブラリ
各プロダクトが用意したprofileのうち必要なものを有効化する
関連プロダクトのバージョンをBigtopのパッケージング対象に合わせる
BigtopによるHadoopビルド
mvn install 
-DskipTests  # ユニットテストを実行しない
-Psrc  # source tarballを作る
-Pdist  # binary tarballを作る
-Dzookeeper.version=3.4.14 -Djetty.version=9.3.29.v20201019  # バージョンすり合わせ
-Pnative  # nativeライブラリ(後述)を作る
-Dsnappy.prefix=x -Dbundle.snappy=true -Dsnappy.lib=/usr/lib64 # nativeライブラリ関連のオプション設定
BigtopによるHadoopビルド時のコマンドライン(を説明用に改変したもの):
© 2021 NTT DATA Corporation 22
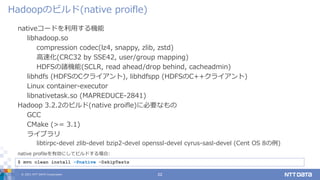
nativeコードを利用する機能
libhadoop.so
compression codec(lz4, snappy, zlib, zstd)
高速化(CRC32 by SSE42, user/group mapping)
HDFSの諸機能(SCLR, read ahead/drop behind, cacheadmin)
libhdfs (HDFSのCクライアント), libhdfspp (HDFSのC++クライアント)
Linux container-executor
libnativetask.so (MAPREDUCE-2841)
Hadoop 3.2.2のビルド(native proifle)に必要なもの
GCC
CMake (>= 3.1)
ライブラリ
libtirpc-devel zlib-devel bzip2-devel openssl-devel cyrus-sasl-devel (Cent OS 8の例)
Hadoopのビルド(native proifle)
$ mvn clean install –Pnative -DskipTests
native profileを有効にしてビルドする場合:
© 2021 NTT DATA Corporation 23
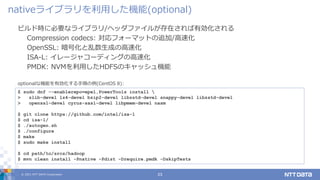
ビルド時に必要なライブラリ/ヘッダファイルが存在されば有効化される
Compression codecs: 対応フォーマットの追加/高速化
OpenSSL: 暗号化と乱数生成の高速化
ISA-L: イレージャコーディングの高速化
PMDK: NVMを利用したHDFSのキャッシュ機能
nativeライブラリを利用した機能(optional)
$ sudo dnf --enablerepo=epel,PowerTools install 
> zlib-devel lz4-devel bzip2-devel libzstd-devel snappy-devel libzstd-devel
> openssl-devel cyrus-sasl-devel libpmem-devel nasm
$ git clone https://github.com/intel/isa-l
$ cd isa-l/
$ ./autogen.sh
$ ./configure
$ make
$ sudo make install
$ cd path/to/srcs/hadoop
$ mvn clean install -Pnative -Pdist -Drequire.pmdk -DskipTests
optionalな機能を有効化する手順の例(CentOS 8):
© 2021 NTT DATA Corporation 24
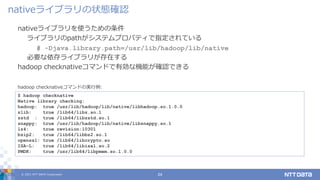
nativeライブラリを使うための条件
ライブラリのpathがシステムプロパティで指定されている
# -Djava.library.path=/usr/lib/hadoop/lib/native
必要な依存ライブラリが存在する
hadoop checknativeコマンドで有効な機能が確認できる
nativeライブラリの状態確認
$ hadoop checknative
Native library checking:
hadoop: true /usr/lib/hadoop/lib/native/libhadoop.so.1.0.0
zlib: true /lib64/libz.so.1
zstd : true /lib64/libzstd.so.1
snappy: true /usr/lib/hadoop/lib/native/libsnappy.so.1
lz4: true revision:10301
bzip2: true /lib64/libbz2.so.1
openssl: true /lib64/libcrypto.so
ISA-L: true /lib64/libisal.so.2
PMDK: true /usr/lib64/libpmem.so.1.0.0
hadoop checknativeコマンドの実行例:
© 2021 NTT DATA Corporation 25
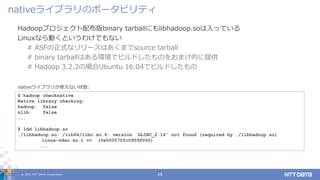
Hadoopプロジェクト配布版binary tarballにもlibhadoop.soは入っている
Linuxなら動くというわけでもない
# ASFの正式なリリースはあくまでsource tarball
# binary tarballはある環境でビルドしたものをおまけ的に提供
# Hadoop 3.2.2の場合Ubuntu 16.04でビルドしたもの
nativeライブラリのポータビリティ
$ hadoop checknative
Native library checking:
hadoop: false
zlib: false
...
$ ldd libhadoop.so
./libhadoop.so: /lib64/libc.so.6: version `GLIBC_2.14' not found (required by ./libhadoop.so)
linux-vdso.so.1 => (0x00007ffc0959f000)
...
nativeライブラリが使えない状態:
© 2021 NTT DATA Corporation 26
Bigtop basics
© 2021 NTT DATA Corporation 27
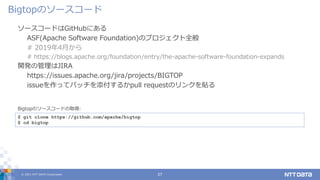
ソースコードはGitHubにある
ASF(Apache Software Foundation)のプロジェクト全般
# 2019年4月から
# https://blogs.apache.org/foundation/entry/the-apache-software-foundation-expands
開発の管理はJIRA
https://issues.apache.org/jira/projects/BIGTOP
issueを作ってパッチを添付するかpull requestのリンクを貼る
Bigtopのソースコード
$ git clone https://github.com/apache/bigtop
$ cd bigtop
Bigtopのソースコードの取得:
© 2021 NTT DATA Corporation 28
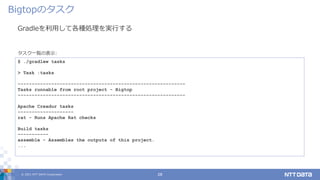
Gradleを利用して各種処理を実行する
Bigtopのタスク
$ ./gradlew tasks
> Task :tasks
------------------------------------------------------------
Tasks runnable from root project - Bigtop
------------------------------------------------------------
Apache Creadur tasks
--------------------
rat - Runs Apache Rat checks
Build tasks
-----------
assemble - Assembles the outputs of this project.
...
タスク一覧の表示:
© 2021 NTT DATA Corporation 29
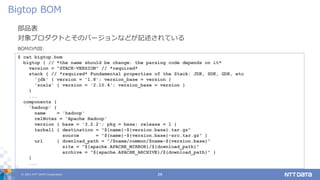
部品表
対象プロダクトとそのバージョンなどが記述されている
Bigtop BOM
$ cat bigtop.bom
bigtop { // *the name should be change: the parsing code depends on it*
version = "STACK-VERSION" // *required*
stack { // *required* Fundamental properties of the Stack: JDK, SDK, GDK, etc
'jdk' { version = '1.8'; version_base = version }
'scala' { version = '2.10.4'; version_base = version }
}
...
components {
'hadoop' {
name = 'hadoop'
relNotes = 'Apache Hadoop'
version { base = '3.2.2'; pkg = base; release = 1 }
tarball { destination = "${name}-${version.base}.tar.gz"
source = "${name}-${version.base}-src.tar.gz" }
url { download_path = "/$name/common/$name-${version.base}"
site = "${apache.APACHE_MIRROR}/${download_path}"
archive = "${apache.APACHE_ARCHIVE}/${download_path}" }
}
...
BOMの内容:
© 2021 NTT DATA Corporation 30
Bigtop toolchain
© 2021 NTT DATA Corporation 31
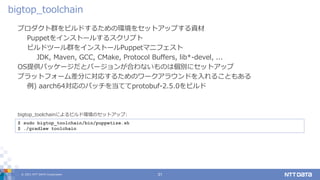
プロダクト群をビルドするための環境をセットアップする資材
Puppetをインストールするスクリプト
ビルドツール群をインストールPuppetマニフェスト
JDK, Maven, GCC, CMake, Protocol Buffers, lib*-devel, ...
OS提供パッケージだとバージョンが合わないものは個別にセットアップ
プラットフォーム差分に対応するためのワークアラウンドを入れることもある
例) aarch64対応のパッチを当ててprotobuf-2.5.0をビルド
bigtop_toolchain
$ sudo bigtop_toolchain/bin/puppetize.sh
$ ./gradlew toolchain
bigtop_toolchainによるビルド環境のセットアップ:
© 2021 NTT DATA Corporation 32
Bigtop packaging
© 2021 NTT DATA Corporation 33
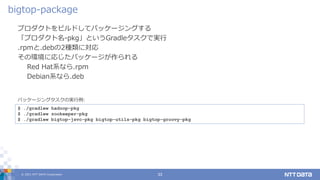
プロダクトをビルドしてパッケージングする
「プロダクト名-pkg」というGradleタスクで実行
.rpmと.debの2種類に対応
その環境に応じたパッケージが作られる
Red Hat系なら.rpm
Debian系なら.deb
bigtop-package
$ ./gradlew hadoop-pkg
$ ./gradlew zookeeper-pkg
$ ./gradlew bigtop-jsvc-pkg bigtop-utils-pkg bigtop-groovy-pkg
パッケージングタスクの実行例:
© 2021 NTT DATA Corporation 34
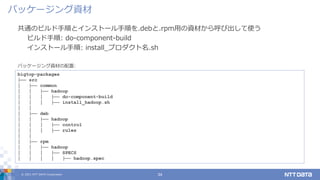
共通のビルド手順とインストール手順を.debと.rpm用の資材から呼び出して使う
ビルド手順: do-component-build
インストール手順: install_プロダクト名.sh
パッケージング資材
bigtop-packages
├── src
│ ├── common
│ │ ├── hadoop
│ │ │ ├── do-component-build
│ │ │ ├── install_hadoop.sh
│ │
│ ├── deb
│ │ ├── hadoop
│ │ │ ├── control
│ │ │ ├── rules
│ │
│ ├── rpm
│ │ ├── hadoop
│ │ │ ├── SPECS
│ │ │ │ ├── hadoop.spec
パッケージング資材の配置:
© 2021 NTT DATA Corporation 35
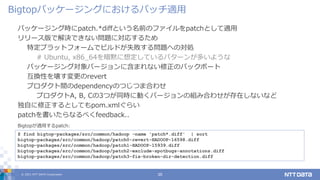
パッケージング時にpatch.*diffという名前のファイルをpatchとして適用
リリース版で解決できない問題に対応するため
特定プラットフォームでビルドが失敗する問題への対処
# Ubuntu, x86_64を暗黙に想定しているパターンが多いような
パッケージング対象バージョンに含まれない修正のバックポート
互換性を壊す変更のrevert
プロダクト間のdependencyのつじつま合わせ
プロダクトA, B, Cの3つが同時に動くバージョンの組み合わせが存在しないなど
独自に修正するとしてもpom.xmlぐらい
patchを書いたらなるべくfeedback..
Bigtopパッケージングにおけるパッチ適用
$ find bigtop-packages/src/common/hadoop -name 'patch*.diff' | sort
bigtop-packages/src/common/hadoop/patch0-revert-HADOOP-16598.diff
bigtop-packages/src/common/hadoop/patch1-HADOOP-15939.diff
bigtop-packages/src/common/hadoop/patch2-exclude-spotbugs-annotations.diff
bigtop-packages/src/common/hadoop/patch3-fix-broken-dir-detection.diff
Bigtopが適用するpatch:
© 2021 NTT DATA Corporation 36
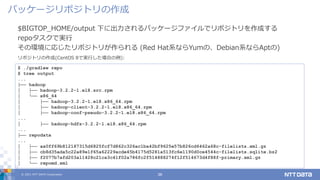
$BIGTOP_HOME/output 下に出力されるパッケージファイルでリポジトリを作成する
repoタスクで実行
その環境に応じたリポジトリが作られる (Red Hat系ならYumの、Debian系ならAptの)
パッケージリポジトリの作成
$ ./gradlew repo
$ tree output
...
├── hadoop
│ ├── hadoop-3.2.2-1.el8.src.rpm
│ └── x86_64
│ ├── hadoop-3.2.2-1.el8.x86_64.rpm
│ ├── hadoop-client-3.2.2-1.el8.x86_64.rpm
│ ├── hadoop-conf-pseudo-3.2.2-1.el8.x86_64.rpm
...
│ ├── hadoop-hdfs-3.2.2-1.el8.x86_64.rpm
...
├── repodata
...
│ ├── aa0ff69b812187315d6825fcf7d862c326ac1ba42bf9625e57b826cd6462a68c-filelists.xml.gz
│ ├── cb8d35ada5c22a89e1f65a62229acde45b4175d5281a513fc6e1190d0ce4544c-filelists.sqlite.bz2
│ ├── f2077b7afd203a11428c21ca3c41f02a786fc2f514888274f12f514673d4f88f-primary.xml.gz
│ └── repomd.xml
リポジトリの作成(CentOS 8で実行した場合の例):
© 2021 NTT DATA Corporation 37
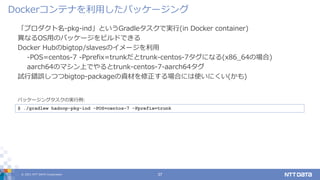
「プロダクト名-pkg-ind」というGradleタスクで実行(in Docker container)
異なるOS用のパッケージをビルドできる
Docker Hubのbigtop/slavesのイメージを利用
-POS=centos-7 -Pprefix=trunkだとtrunk-centos-7タグになる(x86_64の場合)
aarch64のマシン上でやるとtrunk-centos-7-aarch64タグ
試行錯誤しつつbigtop-packageの資材を修正する場合には使いにくい(かも)
Dockerコンテナを利用したパッケージング
$ ./gradlew hadoop-pkg-ind -POS=centos-7 -Pprefix=trunk
パッケージングタスクの実行例:
© 2021 NTT DATA Corporation 38
Bigtop provisioning
© 2021 NTT DATA Corporation 39
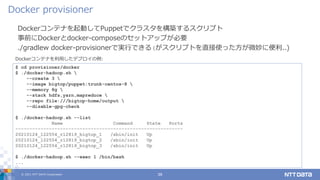
Dockerコンテナを起動してPuppetでクラスタを構築するスクリプト
事前にDockerとdocker-composeのセットアップが必要
./gradlew docker-provisionerで実行できる(がスクリプトを直接使った方が微妙に便利..)
Docker provisioner
$ cd provisioner/docker
$ ./docker-hadoop.sh 
--create 3 
--image bigtop/puppet:trunk-centos-8 
--memory 8g 
--stack hdfs,yarn,mapreduce 
--repo file:///bigtop-home/output 
--disable-gpg-check
$ ./docker-hadoop.sh --list
Name Command State Ports
------------------------------------------------------------
20210124_122554_r12819_bigtop_1 /sbin/init Up
20210124_122554_r12819_bigtop_2 /sbin/init Up
20210124_122554_r12819_bigtop_3 /sbin/init Up
$ ./docker-hadoop.sh --exec 1 /bin/bash
...
Dockerコンテナを利用したデプロイの例:
© 2021 NTT DATA Corporation 40
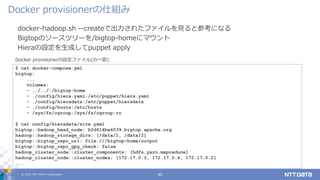
docker-hadoop.sh --createで出力されたファイルを見ると参考になる
Bigtopのソースツリーを/bigtop-homeにマウント
Hieraの設定を生成してpuppet apply
Docker provisionerの仕組み
$ cat docker-compose.yml
bigtop:
...
volumes:
- ../../:/bigtop-home
- ./config/hiera.yaml:/etc/puppet/hiera.yaml
- ./config/hieradata:/etc/puppet/hieradata
- ./config/hosts:/etc/hosts
- /sys/fs/cgroup:/sys/fs/cgroup:ro
$ cat config/hieradata/site.yaml
bigtop::hadoop_head_node: b2d614be6039.bigtop.apache.org
hadoop::hadoop_storage_dirs: [/data/1, /data/2]
bigtop::bigtop_repo_uri: file:///bigtop-home/output
bigtop::bigtop_repo_gpg_check: false
hadoop_cluster_node::cluster_components: [hdfs,yarn,mapreduce]
hadoop_cluster_node::cluster_nodes: [172.17.0.3, 172.17.0.4, 172.17.0.2]
...
Docker provisionerの設定ファイル(の一部):
© 2021 NTT DATA Corporation 41
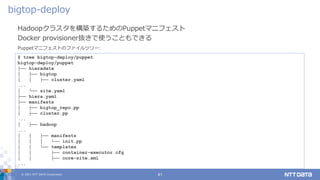
Hadoopクラスタを構築するためのPuppetマニフェスト
Docker provisioner抜きで使うこともできる
bigtop-deploy
$ tree bigtop-deploy/puppet
bigtop-deploy/puppet
├── hieradata
│ ├── bigtop
│ │ ├── cluster.yaml
...
│ └── site.yaml
├── hiera.yaml
├── manifests
│ ├── bigtop_repo.pp
│ ├── cluster.pp
...
│ ├── hadoop
...
│ │ ├── manifests
│ │ │ └── init.pp
│ │ └── templates
│ │ ├── container-executor.cfg
│ │ ├── core-site.xml
...
Puppetマニフェストのファイルツリー:
© 2021 NTT DATA Corporation 42
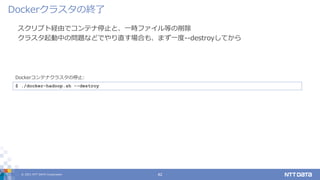
スクリプト経由でコンテナ停止と、一時ファイル等の削除
クラスタ起動中の問題などでやり直す場合も、まず一度--destroyしてから
Dockerクラスタの終了
$ ./docker-hadoop.sh --destroy
Dockerコンテナクラスタの停止:
© 2021 NTT DATA Corporation 43
Bigtop tests
© 2021 NTT DATA Corporation 44
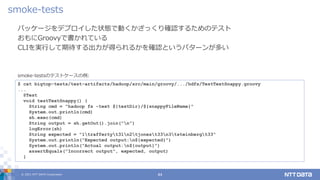
パッケージをデプロイした状態で動くかざっくり確認するためのテスト
おもにGroovyで書かれている
CLIを実行して期待する出力が得られるかを確認というパターンが多い
smoke-tests
$ cat bigtop-tests/test-artifacts/hadoop/src/main/groovy/.../hdfs/TestTextSnappy.groovy
...
@Test
void testTextSnappy() {
String cmd = "hadoop fs -text ${testDir}/${snappyFileName}"
System.out.println(cmd)
sh.exec(cmd)
String output = sh.getOut().join("n")
logError(sh)
String expected = "1traffertyt31n2tjonest33n3tsteinbergt33"
System.out.println("Expected output:n${expected}")
System.out.println("Actual output:n${output}")
assertEquals("Incorrect output", expected, output)
}
smoke-testsのテストケースの例:
© 2021 NTT DATA Corporation 45
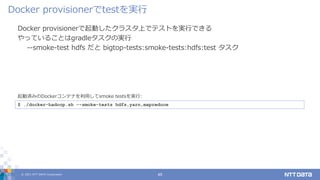
Docker provisionerで起動したクラスタ上でテストを実行できる
やっていることはgradleタスクの実行
--smoke-test hdfs だと bigtop-tests:smoke-tests:hdfs:test タスク
Docker provisionerでtestを実行
$ ./docker-hadoop.sh --smoke-tests hdfs,yarn,mapreduce
起動済みのDockerコンテナを利用してsmoke testsを実行:
© 2021 NTT DATA Corporation 46
Summary
© 2021 NTT DATA Corporation 47
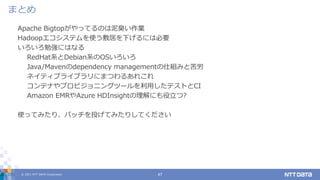
Apache Bigtopがやってるのは泥臭い作業
Hadoopエコシステムを使う敷居を下げるには必要
いろいろ勉強にはなる
RedHat系とDebian系のOSいろいろ
Java/Mavenのdependency managementの仕組みと苦労
ネイティブライブラリにまつわるあれこれ
コンテナやプロビジョニングツールを利用したテストとCI
Amazon EMRやAzure HDInsightの理解にも役立つ?
使ってみたり、パッチを投げてみたりしてください
まとめ
© 2021 NTT DATA Corporation
本資料に記載されている会社名、商品名、又はサービス名は、各社の登録商標又は商標です。