Hadoop –NameNode HAの仕組み-
2018/06 Ver.1.0
JBSテクノロジー株式会社 権田 祐樹
自己紹介
■所属/氏名
- JBSテクノロジー株式会社
- 権田 祐樹 (Yuki Gonda)
■略歴 ※2018/06現在
- Linux歴 9年 (運用保守3年、構築6年)
- 某通信会社のサーバ構築自動化など
- Hadoop歴 4カ月
- Hadoopの構築/運用/保守(150台規模)
- HDPのバージョンアップに向け準備中!
■趣味
- 写真 (Canon EOS 7D所有)
- 映画 (昔は年間100本くらい…)
- 読書 (月1冊程度)
会社紹介
名称
所在地
設立
社員数
事業拠点
JBSテクノロジー株式会社
虎ノ門ヒルズ森タワー16F
2004年6月1日
958名(2018年6月現在)
北海道事業所
中部事業所
西日本事業所
九州事業所
データの山からビジネスの種の
掘り起こしをお手伝い!
Hadoopには、2013年から
取り組んでいます。
有資格者を含めて10名以上
のHadoopエンジニアが
所属しています。
Cloudera on Azure
サービスも提供中
はじめに
本資料は、社内で実施したHadoopエンジニア育成研修の中で取り組んだ課
題のアウトプット資料です。
Hadoop (主に NameNode、DataNode、HDFS) についての基礎知識が
あり、NameNode HA について詳しく知りたい人向けの内容となっております。
見ていただいた方にとって、少しでもお役に立てれば幸いです。
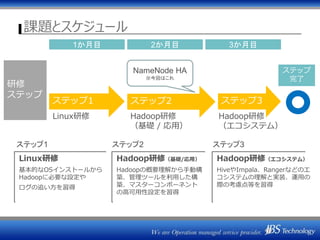
課題とスケジュール
研修
ステップ
1か月目 2か月目 3か月目
Linux研修
基本的なOSインストールから
Hadoopに必要な設定や
ログの追い方を習得
ステップ1
Hadoop研修(基礎/応用)
Hadoopの概要理解から手動構
築、管理ツールを利用した構
築、マスターコンポーネント
の高可用性設定を習得
ステップ2
Hadoop研修(エコシステム)
HiveやImpala、Rangerなどのエ
コシステムの理解と実装、運用の
際の考慮点等を習得
ステップ3
ステップ1 ステップ2 ステップ3
NameNode HA
※今回はこれ
Linux研修 Hadoop研修
(基礎 / 応用)
Hadoop研修
(エコシステム)
ステップ
完了
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
前提条件
NameNode HA化手順
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
前提条件
NameNode HA化手順
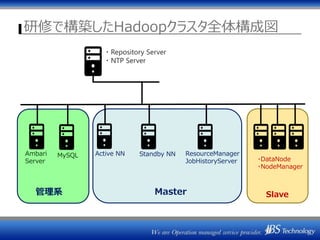
研修で構築したHadoopクラスタ全体構成図
Active NN ResourceManager
JobHistoryServer
Master
・DataNode
・NodeManager
・Repository Server
・NTP Server
Slave
Ambari
Server
MySQL
管理系
Standby NN
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
NameNode HA 化の必要性
NameNode
どのブロックがどの DataNode 上にあるか等のメタデータを管理しているため、故障した場合、
HDFSのすべてのデータ操作が行えない
Secondary NameNode の利用や edits,fsimage の出力先の冗長化による運用は、
fsimage のロード、edits の適用、ブロックレポート収集処理の都合上 NameNode
がダウンしてから復旧までに時間を要する
障害発生時に行われていた処理は基本的にエラーとなる
⇒ NameNodeのHA化が必要
NameNode を HA 構成にすることで、F/O を自動的に実施する Active-Standby
の構成となる。
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
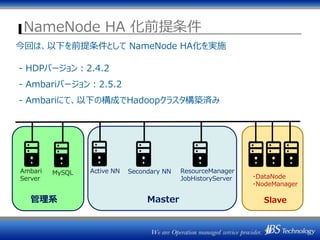
NameNode HA 化前提条件
今回は、以下を前提条件として NameNode HA化を実施
- HDPバージョン:2.4.2
- Ambariバージョン:2.5.2
- Ambariにて、以下の構成でHadoopクラスタ構築済み
Active NN ResourceManager
JobHistoryServer
Master
・DataNode
・NodeManager
Slave
Ambari
Server
MySQL
管理系
Secondary NN
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
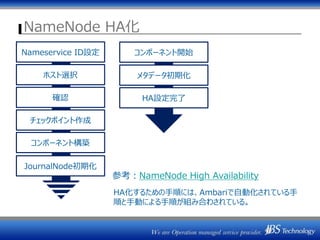
NameNode HA化
確認
チェックポイント作成
JournalNode初期化
コンポーネント開始
メタデータ初期化ホスト選択
Nameservice ID設定
コンポーネント構築
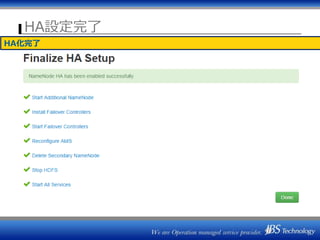
HA設定完了
参考:NameNode High Availability
HA化するための手順には、Ambariで自動化されている手
順と手動による手順が組み合わされている。
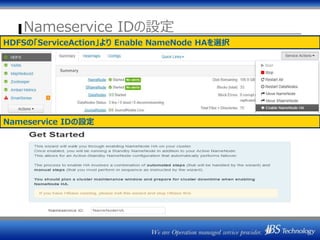
Nameservice IDの設定
HDFSの「ServiceAction」より Enable NameNode HAを選択
Nameservice IDの設定
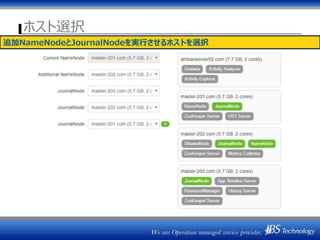
ホスト選択
追加NameNodeとJournalNodeを実行させるホストを選択
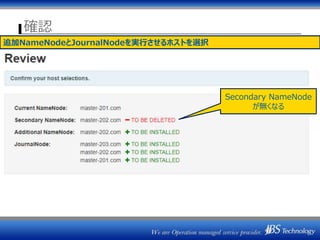
確認
追加NameNodeとJournalNodeを実行させるホストを選択
Secondary NameNode
が無くなる
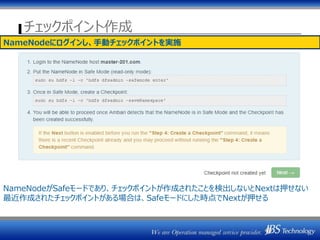
チェックポイント作成
NameNodeにログインし、手動チェックポイントを実施
NameNodeがSafeモードであり、チェックポイントが作成されたことを検出しないとNextは押せない
最近作成されたチェックポイントがある場合は、Safeモードにした時点でNextが押せる
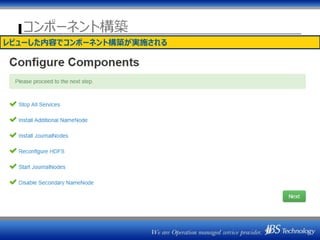
コンポーネント構築
レビューした内容でコンポーネント構築が実施される
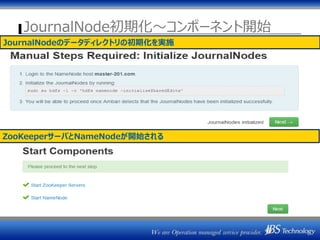
JournalNode初期化~コンポーネント開始
JournalNodeのデータディレクトリの初期化を実施
ZooKeeperサーバとNameNodeが開始される
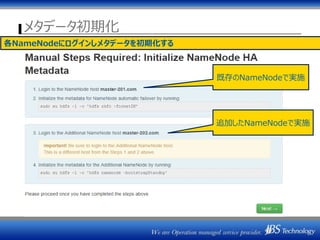
メタデータ初期化
既存のNameNodeで実施
追加したNameNodeで実施
各NameNodeにログインしメタデータを初期化する
HA設定完了
HA化完了
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
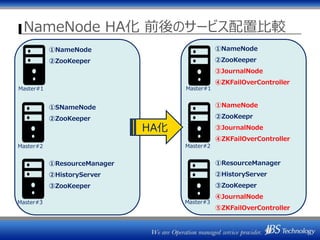
NameNode HA化 前後のサービス配置比較
①NameNode
②ZooKeeper
①ResourceManager
②HistoryServer
③ZooKeeper
①SNameNode
②ZooKeeper
①NameNode
②ZooKeeper
③JournalNode
④ZKFailOverController
①ResourceManager
②HistoryServer
③ZooKeeper
④JournalNode
⑤ZKFailOverController
①NameNode
②ZooKeepr
③JournalNode
④ZKFailOverController
HA化
Master#1
Master#2
Master#3
Master#1
Master#2
Master#3
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
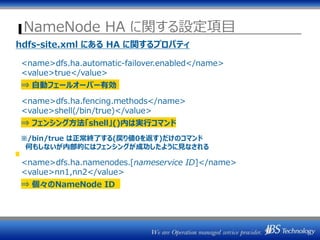
NameNode HA に関する設定項目
hdfs-site.xml にある HA に関するプロパティ
<name>dfs.ha.automatic-failover.enabled</name>
<value>true</value>
⇒ 自動フェールオーバー有効
<name>dfs.ha.fencing.methods</name>
<value>shell(/bin/true)</value>
⇒ フェンシング方法「shell」()内は実行コマンド
※/bin/true は正常終了する(戻り値0を返す)だけのコマンド
何もしないが内部的にはフェンシングが成功したように見なされる
<name>dfs.ha.namenodes.[nameservice ID]</name>
<value>nn1,nn2</value>
⇒ 個々のNameNode ID
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
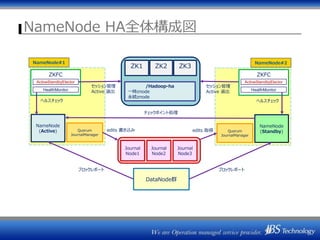
NameNode HA全体構成図
ZK1 ZK2 ZK3
NameNode
(Active) Quorum
JournalManager
Journal
Node1
ZKFC
DataNode群
NameNode
(Standby)Quorum
JournalManager
ブロックレポートブロックレポート
edits 書き込み
NameNode#1 NameNode#2
edits 取得
チェックポイント処理
ヘルスチェックヘルスチェック
Journal
Node2
Journal
Node3
セッション管理
Active 選出
セッション管理
Active 選出
/Hadoop-ha
一時znode
永続znode
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
Agenda
NameNode HA 化の必要性
NameNode HA 化前後の比較
NameNode HA 全体構成図
NameNode HA 構成の動き
Hadoopクラスタ全体構成図
NameNode HA に関する設定項目
NameNode HA 化前提条件
NameNode HA化手順
NameNode HA構成の動き
NameNode
(Active) Quorum
JournalManager
Journal
Node1
DataNode群
NameNode
(Standby)Quorum
JournalManager
①ブロックレポート①ブロックレポート
②edits 書き込み
NameNode#1 NameNode#2
③edits 取得
④チェックポイント処理
Journal
Node2
Journal
Node3
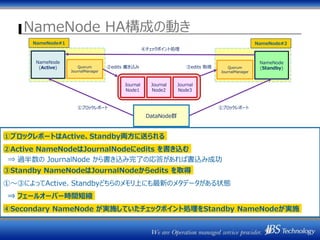
①ブロックレポートはActive、Standby両方に送られる
②Active NameNodeはJournalNodeにedits を書き込む
⇒ 過半数の JournalNode から書き込み完了の応答があれば書込み成功
③Standby NameNodeはJournalNodeからedits を取得
①~③によってActive、Standbyどちらのメモリ上にも最新のメタデータがある状態
⇒ フェールオーバー時間短縮
④Secondary NameNode が実施していたチェックポイント処理をStandby NameNodeが実施
NameNode HA構成の動き
3
1
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Standby)
NameNode#1 NameNode#2
⑤ヘルスチェック⑤ヘルスチェック
セッション管理
Active 選出
セッション管理
Active 選出
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
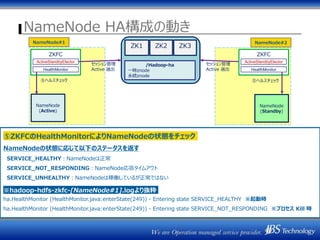
⑤ZKFCのHealthMonitorによりNameNodeの状態をチェック
NameNodeの状態に応じて以下のステータスを返す
SERVICE_HEALTHY:NameNodeは正常
SERVICE_NOT_RESPONDING:NameNode応答タイムアウト
SERVICE_UNHEALTHY:NameNodeは稼働しているが正常ではない
※hadoop-hdfs-zkfc-[NameNode#1].logより抜粋
ha.HealthMonitor (HealthMonitor.java:enterState(249)) - Entering state SERVICE_HEALTHY ※起動時
ha.HealthMonitor (HealthMonitor.java:enterState(249)) - Entering state SERVICE_NOT_RESPONDING ※プロセス Kill 時
/Hadoop-ha
一時znode
永続znode
NameNode HA構成の動き
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Standby)
NameNode#1 NameNode#2
⑤ヘルスチェック⑤ヘルスチェック
⑥セッション管理
⑦Active 選出
⑥セッション管理
⑦Active 選出
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
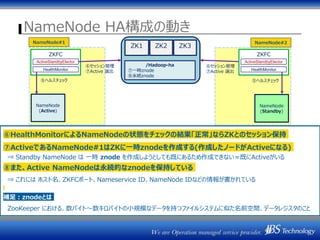
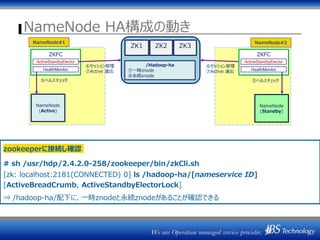
⑥HealthMonitorによるNameNodeの状態をチェックの結果「正常」ならZKとのセッション保持
⑦ActiveであるNameNode#1はZKに一時znodeを作成する(作成したノードがActiveになる)
⇒ Standby NameNode は 一時 znode を作成しようとしても既にあるため作成できない=既にActiveがいる
⑧また、Active NameNodeは永続的なznodeを保持している
⇒ これには ホスト名、ZKFCポート、Nameservice ID、NameNode IDなどの情報が書かれている
補足:znodeとは
ZooKeeper における、数バイト~数キロバイトの小規模なデータを持つファイルシステムに似た名前空間、データレジスタのこと
/Hadoop-ha
⑦一時znode
⑧永続znode
NameNode HA構成の動き
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Standby)
NameNode#1 NameNode#2
⑤ヘルスチェック⑤ヘルスチェック
⑥セッション管理
⑦Active 選出
⑥セッション管理
⑦Active 選出
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
/Hadoop-ha
⑦一時znode
⑧永続znode
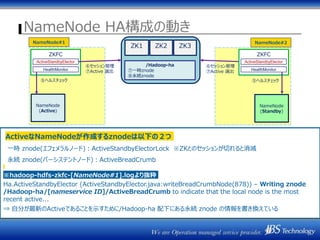
ActiveなNameNodeが作成するznodeは以下の2つ
一時 znode(エフェメラルノード):ActiveStandbyElectorLock ※ZKとのセッションが切れると消滅
永続 znode(パーシステントノード):ActiveBreadCrumb
※hadoop-hdfs-zkfc-[NameNode#1].logより抜粋
Ha.ActiveStandbyElector (ActiveStandbyElector.java:writeBreadCrumbNode(878)) – Writing znode
/Hadoop-ha/[nameservice ID]/ActiveBreadCrumb to indicate that the local node is the most
recent active...
⇒ 自分が最新のActiveであることを示すために/Hadoop-ha 配下にある永続 znode の情報を書き換えている
NameNode HA構成の動き
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Standby)
NameNode#1 NameNode#2
⑤ヘルスチェック⑤ヘルスチェック
⑥セッション管理
⑦Active 選出
⑥セッション管理
⑦Active 選出
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
/Hadoop-ha
⑦一時znode
⑧永続znode
zookeeperに接続し確認
# sh /usr/hdp/2.4.2.0-258/zookeeper/bin/zkCli.sh
[zk: localhost:2181(CONNECTED) 0] ls /hadoop-ha/[nameservice ID]
[ActiveBreadCrumb, ActiveStandbyElectorLock]
⇒ /hadoop-ha/配下に、一時znodeと永続znodeがあることが確認できる
NameNode HA構成の動き(F/O時)
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Standby
⇒ ⑥ Active)
NameNode#1 NameNode#2
ヘルスチェックヘルスチェック
⇒ SERVICE_NOT_RESPONDING
セッション管理
Active 選出
セッション管理
Active 選出
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
/Hadoop-ha
③一時znode ④一時znode
⑤永続znode
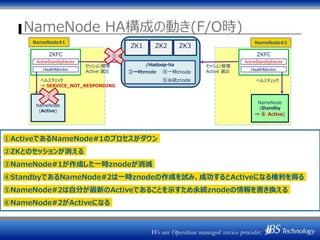
①ActiveであるNameNode#1のプロセスがダウン
②ZKとのセッションが消える
③NameNode#1が作成した一時znodeが消滅
④StandbyであるNameNode#2は一時znodeの作成を試み、成功するとActiveになる権利を得る
⑤NameNode#2は自分が最新のActiveであることを示すため永続znodeの情報を書き換える
⑥NameNode#2がActiveになる
①
②
NameNode HA構成の動き(F/O時)
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Standby
⇒ Active)
NameNode#1(192.168.1.1) NameNode#2(192.168.1.2)
ヘルスチェックヘルスチェック
⇒ SERVICE_HEALTHY
セッション管理
Active 選出
セッション管理
Active 選出
ActiveStandbyElector
HealthMonitor
ZKFC
ActiveStandbyElector
HealthMonitor
/Hadoop-ha
②一時znode ③一時znode
永続znode
①
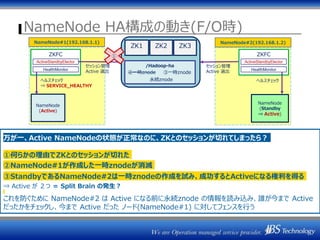
万が一、Active NameNodeの状態が正常なのに、ZKとのセッションが切れてしまったら?
①何らかの理由でZKとのセッションが切れた
②NameNode#1が作成した一時znodeが消滅
③StandbyであるNameNode#2は一時znodeの作成を試み、成功するとActiveになる権利を得る
⇒ Active が 2つ = Split Brain の発生?
これを防ぐために NameNode#2 は Active になる前に永続znode の情報を読み込み、誰が今まで Active
だったかをチェックし、今まで Active だった ノード(NameNode#1) に対してフェンスを行う
NameNode HA構成の動き(F/O時)
一時znode 一時znode
永続znode ← 情報書換
ZK1 ZK2 ZK3
NameNode
(Active)
ZKFC
NameNode
(Active)
ZKFC
Master-201 Master-202
⑤ヘルスチェック
状態切り替え
⑤ヘルスチェック
⇒ SERVICE_HEALTHY
⑥セッション管理
⑦Active NN 選出
⑥セッション管理
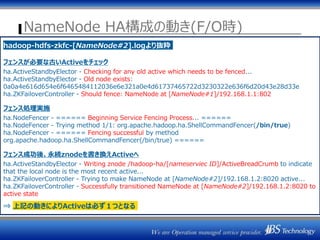
⑦Active NN 選出hadoop-hdfs-zkfc-[NameNode#2].logより抜粋
フェンスが必要な古いActiveをチェック
ha.ActiveStandbyElector - Checking for any old active which needs to be fenced...
ha.ActiveStandbyElector - Old node exists:
0a0a4e616d654e6f6465484112036e6e321a0e4d61737465722d3230322e636f6d20d43e28d33e
ha.ZKFailoverController - Should fence: NameNode at [NameNode#1]/192.168.1.1:802
フェンス処理実施
ha.NodeFencer - ====== Beginning Service Fencing Process... ======
ha.NodeFencer - Trying method 1/1: org.apache.hadoop.ha.ShellCommandFencer(/bin/true)
ha.NodeFencer - ====== Fencing successful by method
org.apache.hadoop.ha.ShellCommandFencer(/bin/true) ======
フェンス成功後、永続znodeを書き換えActiveへ
ha.ActiveStandbyElector - Writing znode /hadoop-ha/[nameserviec ID]/ActiveBreadCrumb to indicate
that the local node is the most recent active...
ha.ZKFailoverController - Trying to make NameNode at [NameNode#2]/192.168.1.2:8020 active...
ha.ZKFailoverController - Successfully transitioned NameNode at [NameNode#2]/192.168.1.2:8020 to
active state
⇒ 上記の動きによりActiveは必ず1つとなる
NameNode HA構成の動き
NameNode
(Active) Quorum
JournalManager
Journal
Node1
NameNode
(Standby)Quorum
JournalManager
②edits 書き込み ②edits 書き込み
Journal
Node2
Journal
Node3
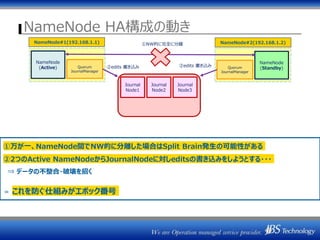
①万が一、NameNode間でNW的に分離した場合はSplit Brain発生の可能性がある
②2つのActive NameNodeからJournalNodeに対しeditsの書き込みをしようとする・・・
⇒ データの不整合・破壊を招く
= これを防ぐ仕組みがエポック番号
①NW的に完全に分離NameNode#1(192.168.1.1) NameNode#2(192.168.1.2)
NameNode HA構成の動き
NameNode#2NameNode#1
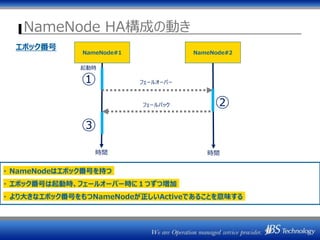
・ NameNodeはエポック番号を持つ
・ エポック番号は起動時、フェールオーバー時に1つずつ増加
・ より大きなエポック番号をもつNameNodeが正しいActiveであることを意味する
起動時
時間 時間
エポック番号
①
②
③
フェールオーバー
フェールバック
NameNode HA構成の動き
エポック番号:3
エポック番号:3
NameNode
(Active) Quorum
JournalManager
Journal
Node1
エポック番号:2
NameNode
(Standby)Quorum
JournalManager
②edits 書き込み ②edits 書き込み
Journal
Node2
Journal
Node3
①NW的に完全に分離NameNode#1(192.168.1.1) NameNode#2(192.168.1.2)
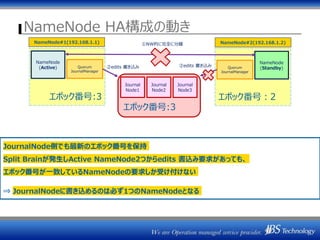
JournalNode側でも最新のエポック番号を保持
Split Brainが発生しActive NameNode2つからedits 書込み要求があっても、
エポック番号が一致しているNameNodeの要求しか受け付けない
⇒ JournalNodeに書き込めるのは必ず1つのNameNodeとなる
NameNode HA構成の動き
Master-202
NameNode
(Active) Quorum
JournalManager
Journal
Node1
NameNode
(Active)Quorum
JournalManager
②edits 書き込み
Master-201 ①NW的に完全に分離
Journal
Node2
Journal
Node3
②edits 書き込み
edits
最新エポック番号③
エポック番号②エポック番号③
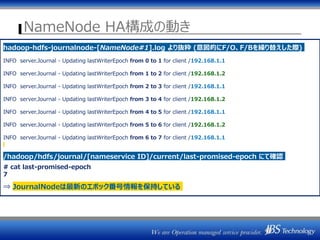
hadoop-hdfs-journalnode-[NameNode#1].log より抜粋 (意図的にF/O、F/Bを繰り替えした際)
INFO server.Journal - Updating lastWriterEpoch from 0 to 1 for client /192.168.1.1
INFO server.Journal - Updating lastWriterEpoch from 1 to 2 for client /192.168.1.2
INFO server.Journal - Updating lastWriterEpoch from 2 to 3 for client /192.168.1.1
INFO server.Journal - Updating lastWriterEpoch from 3 to 4 for client /192.168.1.2
INFO server.Journal - Updating lastWriterEpoch from 4 to 5 for client /192.168.1.1
INFO server.Journal - Updating lastWriterEpoch from 5 to 6 for client /192.168.1.2
INFO server.Journal - Updating lastWriterEpoch from 6 to 7 for client /192.168.1.1
/hadoop/hdfs/journal/[nameservice ID]/current/last-promised-epoch にて確認
# cat last-promised-epoch
7
⇒ JournalNodeは最新のエポック番号情報を保持している
お問い合わせ先
何かございましたら、下記よりお問い合わせください。
http://www.jbst.co.jp/contact/
Hadoop -NameNode HAの仕組み-