Arrow_Fdw
PostgreSQLで大量のログデータを処理するための
ハードウェア最適化アプローチ
HeteroDB,Inc
Chief Architect & CEO
KaiGai Kohei <kaigai@heterodb.com>
会社&自己紹介(1/2)
▌Who am I?
 名前: 海外 浩平(かいがい こうへい)
 所属: HeteroDB,Inc
 バックグラウンド
 Linux kernel(2003~; SELinux、JFFS2など)
 PostgreSQL(2006~; security、FDW、CustomScanなど)
 PG-Strom(2012~)
 IPA未踏ソフトウェア(2006年度、2017年度)
▌about HeteroDB
 商号 ヘテロDB株式会社
 創業 2017年7月4日
 拠点 品川区西大井1-1-2-206
 事業内容 高速データ処理製品の販売
GPU&DB領域の技術コンサルティング
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw2
会社&自己紹介(2/2)
どちらかというと、
こっち側の人間
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw3
本日のアジェンダ
▌PG-Stromとは?
▌Run faster, beyond the limitation
▌Pg2Arrow
▌Arrow_Fdw
▌今後のロードマップ
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw4
PG-Stromとは?
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw5
GPU CPU
モデル
NVIDIA
Tesla V100
Intel Xeon
Platinum 8180
世代 Volta Skylake
発表 Q2-2017 Q3-2017
トランジスタ数 21billion 8.0billion
コア数
5120
(simple)
28
(functional)
動作クロック
1.280GHz
~1.380GHz
2.50GHz
~3.80GHz
理論性能値
(FP64)
7 TFLOPS
2.2TFLOPS
(with AVX-512)
RAMサイズ 32GB (HBM2) max 768GB (DDR4)
メモリ帯域 900GB/s 119GB/s
消費電力 250W 205W
製造プロセ
ス
12nm 14nm
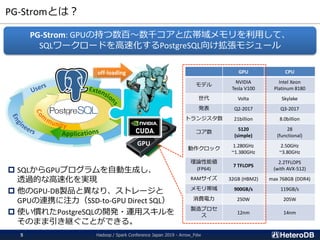
PG-Strom: GPUの持つ数百~数千コアと広帯域メモリを利用して、
SQLワークロードを高速化するPostgreSQL向け拡張モジュール
App
GPU
off-loading
 SQLからGPUプログラムを自動生成し、
透過的な高速化を実現
 他のGPU-DB製品と異なり、ストレージと
GPUの連携に注力(SSD-to-GPU Direct SQL)
 使い慣れたPostgreSQLの開発・運用スキルを
そのまま引き継ぐことができる。
PostgreSQLの共通インフラ
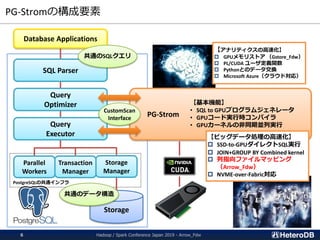
PG-Stromの構成要素
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw6
SQL Parser
Query
Optimizer
Query
Executor
Storage
PG-Strom
CustomScan
Interface
Database Applications
Storage
Manager
Transaction
Manager
Parallel
Workers
【ビッグデータ処理の高速化】
 SSD-to-GPUダイレクトSQL実行
 JOIN+GROUP BY Combined kernel
 列指向ファイルマッピング
(Arrow_Fdw)
 NVME-over-Fabric対応
【基本機能】
• SQL to GPUプログラムジェネレータ
• GPUコード実行時コンパイラ
• GPUカーネルの非同期並列実行
【アナリティクスの高速化】
 GPUメモリストア (Gstore_Fdw)
 PL/CUDA ユーザ定義関数
 Pythonとのデータ交換
 Microsoft Azure(クラウド対応)
共通のSQLクエリ
共通のデータ構造
データ処理とストレージ階層
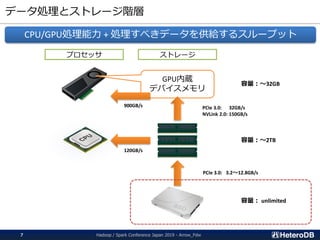
CPU/GPU処理能力 + 処理すべきデータを供給するスループット
プロセッサ ストレージ
GPU内蔵
デバイスメモリ
900GB/s
120GB/s
PCIe 3.0: 32GB/s
NVLink 2.0: 150GB/s
PCIe 3.0: 3.2~12.8GB/s
容量:~32GB
容量:~2TB
容量: unlimited
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw7
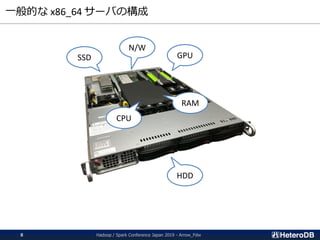
一般的な x86_64 サーバの構成
GPUSSD
CPU
RAM
HDD
N/W
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw8
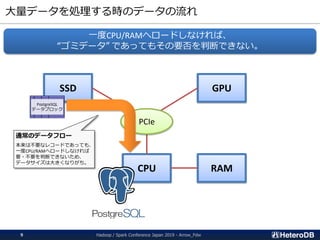
大量データを処理する時のデータの流れ
CPU RAM
SSD GPU
PCIe
PostgreSQL
データブロック
通常のデータフロー
本来は不要なレコードであっても、
一度CPU/RAMへロードしなければ
要・不要を判断できないため、
データサイズは大きくなりがち。
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw9
一度CPU/RAMへロードしなければ、
“ゴミデータ” であってもその要否を判断できない。
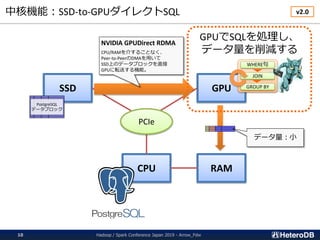
中核機能:SSD-to-GPUダイレクトSQL
CPU RAM
SSD GPU
PCIe
PostgreSQL
データブロック
NVIDIA GPUDirect RDMA
CPU/RAMを介することなく、
Peer-to-PeerのDMAを用いて
SSD上のデータブロックを直接
GPUに転送する機能。
WHERE句
JOIN
GROUP BY
GPUでSQLを処理し、
データ量を削減する
データ量:小
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw10
v2.0
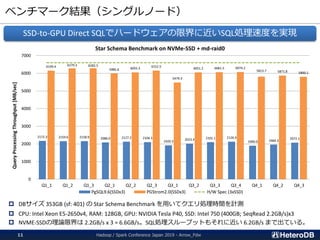
ベンチマーク結果(シングルノード)
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw11
2172.3 2159.6 2158.9 2086.0 2127.2 2104.3
1920.3
2023.4 2101.1 2126.9
1900.0 1960.3
2072.1
6149.4 6279.3 6282.5
5985.6 6055.3 6152.5
5479.3
6051.2 6061.5 6074.2
5813.7 5871.8 5800.1
0
1000
2000
3000
4000
5000
6000
7000
Q1_1 Q1_2 Q1_3 Q2_1 Q2_2 Q2_3 Q3_1 Q3_2 Q3_3 Q3_4 Q4_1 Q4_2 Q4_3
QueryProcessingThroughput[MB/sec]
Star Schema Benchmark on NVMe-SSD + md-raid0
PgSQL9.6(SSDx3) PGStrom2.0(SSDx3) H/W Spec (3xSSD)
SSD-to-GPU Direct SQLでハードウェアの限界に近いSQL処理速度を実現
 DBサイズ 353GB (sf: 401) の Star Schema Benchmark を用いてクエリ処理時間を計測
 CPU: Intel Xeon E5-2650v4, RAM: 128GB, GPU: NVIDIA Tesla P40, SSD: Intel 750 (400GB; SeqRead 2.2GB/s)x3
 NVME-SSDの理論限界は 2.2GB/s x 3 = 6.6GB/s。SQL処理スループットもそれに近い 6.2GB/s まで出ている。
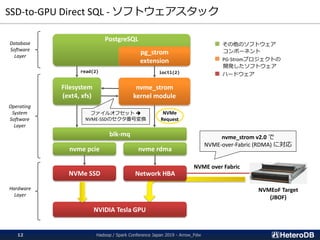
SSD-to-GPU Direct SQL - ソフトウェアスタック
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw12
Filesystem
(ext4, xfs)
nvme_strom
kernel module
NVMe SSD
NVIDIA Tesla GPU
PostgreSQL
pg_strom
extension
read(2) ioctl(2)
Hardware
Layer
Operating
System
Software
Layer
Database
Software
Layer
blk-mq
nvme pcie nvme rdma
Network HBA
ファイルオフセット 
NVME-SSDのセクタ番号変換
NVMEoF Target
(JBOF)
NVMe
Request
■ その他のソフトウェア
コンポーネント
■ PG-Stromプロジェクトの
開発したソフトウェア
■ ハードウェア
NVME over Fabric
nvme_strom v2.0 で
NVME-over-Fabric (RDMA) に対応
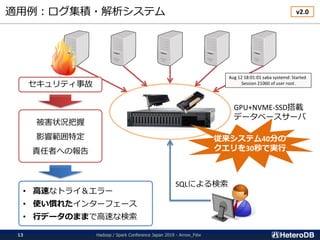
適用例:ログ集積・解析システム
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw13
GPU+NVME-SSD搭載
データベースサーバ
SQLによる検索
セキュリティ事故
被害状況把握
影響範囲特定
責任者への報告
• 高速なトライ&エラー
• 使い慣れたインターフェース
• 行データのままで高速な検索
従来システム40分の
クエリを30秒で実行
Aug 12 18:01:01 saba systemd: Started
Session 21060 of user root.
v2.0
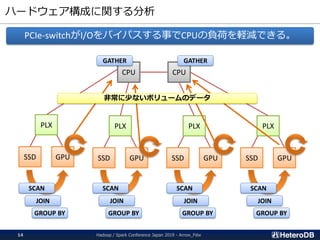
ハードウェア構成に関する分析
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw14
PCIe-switchがI/Oをバイパスする事でCPUの負荷を軽減できる。
CPU CPU
PLX
SSD GPU
PLX
SSD GPU
PLX
SSD GPU
PLX
SSD GPU
SCAN SCAN SCAN SCAN
JOIN JOIN JOIN JOIN
GROUP BY GROUP BY GROUP BY GROUP BY
非常に少ないボリュームのデータ
GATHER GATHER
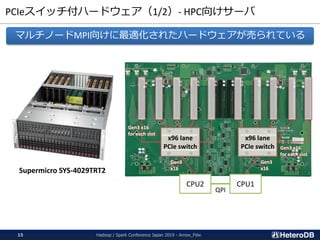
PCIeスイッチ付ハードウェア(1/2)- HPC向けサーバ
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw15
Supermicro SYS-4029TRT2
x96 lane
PCIe switch
x96 lane
PCIe switch
CPU2 CPU1
QPI
Gen3
x16
Gen3 x16
for each slot
Gen3 x16
for each slot
Gen3
x16
マルチノードMPI向けに最適化されたハードウェアが売られている
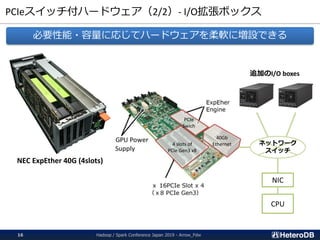
PCIeスイッチ付ハードウェア(2/2)- I/O拡張ボックス
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw16
NEC ExpEther 40G (4slots)
4 slots of
PCIe Gen3 x8
PCIe
Swich
40Gb
Ethernet ネットワーク
スイッチ
CPU
NIC
追加のI/O boxes
必要性能・容量に応じてハードウェアを柔軟に増設できる
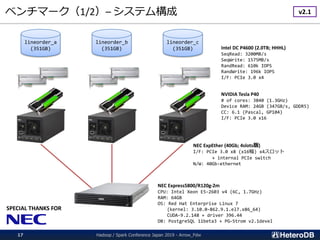
ベンチマーク(1/2)– システム構成
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw17
NEC Express5800/R120g-2m
CPU: Intel Xeon E5-2603 v4 (6C, 1.7GHz)
RAM: 64GB
OS: Red Hat Enterprise Linux 7
(kernel: 3.10.0-862.9.1.el7.x86_64)
CUDA-9.2.148 + driver 396.44
DB: PostgreSQL 11beta3 + PG-Strom v2.1devel
lineorder_a
(351GB)
lineorder_b
(351GB)
lineorder_c
(351GB)
NEC ExpEther (40Gb; 4slots版)
I/F: PCIe 3.0 x8 (x16幅) x4スロット
+ internal PCIe switch
N/W: 40Gb-ethernet
NVIDIA Tesla P40
# of cores: 3840 (1.3GHz)
Device RAM: 24GB (347GB/s, GDDR5)
CC: 6.1 (Pascal, GP104)
I/F: PCIe 3.0 x16
Intel DC P4600 (2.0TB; HHHL)
SeqRead: 3200MB/s
SeqWrite: 1575MB/s
RandRead: 610k IOPS
RandWrite: 196k IOPS
I/F: PCIe 3.0 x4
v2.1
SPECIAL THANKS FOR
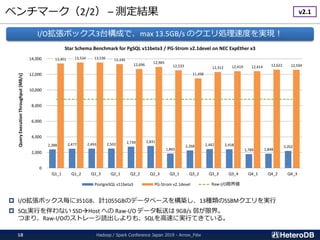
ベンチマーク(2/2) – 測定結果
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw18
 I/O拡張ボックス毎に351GB、計1055GBのデータベースを構築し、13種類のSSBMクエリを実行
 SQL実行を伴わない SSDHost への Raw-I/O データ転送は 9GB/s 弱が限界。
つまり、Raw-I/Oのストレージ読出しよりも、SQLを高速に実行てきている。
2,388 2,477 2,493 2,502 2,739 2,831
1,865
2,268 2,442 2,418
1,789 1,848
2,202
13,401 13,534 13,536 13,330
12,696
12,965
12,533
11,498
12,312 12,419 12,414 12,622 12,594
0
2,000
4,000
6,000
8,000
10,000
12,000
14,000
Q1_1 Q1_2 Q1_3 Q2_1 Q2_2 Q2_3 Q3_1 Q3_2 Q3_3 Q3_4 Q4_1 Q4_2 Q4_3
QueryExecutionThroughput[MB/s]
Star Schema Benchmark for PgSQL v11beta3 / PG-Strom v2.1devel on NEC ExpEther x3
PostgreSQL v11beta3 PG-Strom v2.1devel Raw-I/O限界値
I/O拡張ボックス3台構成で、max 13.5GB/s のクエリ処理速度を実現!
v2.1
Run faster, beyond the limitation
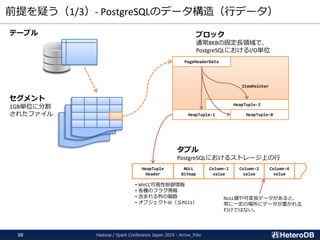
前提を疑う(1/3)- PostgreSQLのデータ構造(行データ)
テーブル
セグメント
1GB単位に分割
されたファイル
ブロック
通常8KBの固定長領域で、
PostgreSQLにおけるI/O単位
PageHeaderData
HeapTuple-0HeapTuple-1
HeapTuple-2
ItemPointer
HeapTuple
Header
• MVCC可視性制御情報
• 各種のフラグ情報
• 含まれる列の個数
• オブジェクトID(≦PG11)
NULL
Bitmap
Column-1
value
Column-2
value
Column-4
value
タプル
PostgreSQLにおけるストレージ上の行
NULL値や可変長データがあると、
常に一定の場所にデータが置かれる
わけではない。
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw20
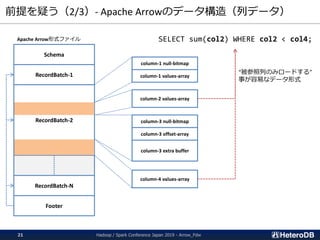
前提を疑う(2/3)- Apache Arrowのデータ構造(列データ)
Footer
Apache Arrow形式ファイル
RecordBatch-2
RecordBatch-N
RecordBatch-1
Schema
column-1 null-bitmap
column-1 values-array
column-2 values-array
column-3 null-bitmap
column-3 offset-array
column-3 extra buffer
column-4 values-array
SELECT sum(col2) WHERE col2 < col4;
“被参照列のみロードする”
事が容易なデータ形式
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw21
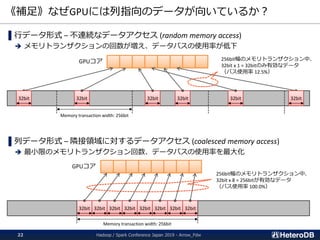
《補足》なぜGPUには列指向のデータが向いているか?
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw22
▌行データ形式 – 不連続なデータアクセス (random memory access)
 メモリトランザクションの回数が増え、データバスの使用率が低下
▌列データ形式 – 隣接領域に対するデータアクセス (coalesced memory access)
 最小限のメモリトランザクション回数、データバスの使用率を最大化
32bit
Memory transaction width: 256bit
32bit 32bit32bit 32bit 32bit
32bit 32bit 32bit 32bit 32bit 32bit 32bit 32bit
Memory transaction width: 256bit
256bit幅のメモリトランザクション中、
32bit x 8 = 256bitが有効なデータ
(バス使用率 100.0%)
256bit幅のメモリトランザクション中、
32bit x 1 = 32bitのみ有効なデータ
(バス使用率 12.5%)
GPUコア
GPUコア
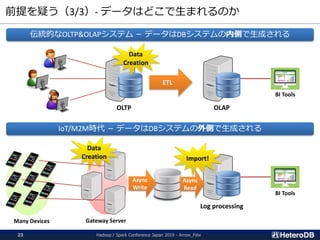
前提を疑う(3/3)- データはどこで生まれるのか
ETL
OLTP OLAP
伝統的なOLTP&OLAPシステム - データはDBシステムの内側で生成される
Data
Creation
IoT/M2M時代 - データはDBシステムの外側で生成される
Log processing
BI Tools
BI Tools
Gateway Server
Async
Write
Async
Read
Data
Creation
Many Devices
Import!
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw23
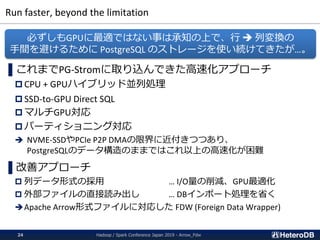
Run faster, beyond the limitation
▌これまでPG-Stromに取り込んできた高速化アプローチ
 CPU + GPUハイブリッド並列処理
 SSD-to-GPU Direct SQL
 マルチGPU対応
 パーティショニング対応
 NVME-SSDやPCIe P2P DMAの限界に近付きつつあり、
PostgreSQLのデータ構造のままではこれ以上の高速化が困難
▌改善アプローチ
 列データ形式の採用 … I/O量の削減、GPU最適化
 外部ファイルの直接読み出し … DBインポート処理を省く
Apache Arrow形式ファイルに対応した FDW (Foreign Data Wrapper)
必ずしもGPUに最適ではない事は承知の上で、行  列変換の
手間を避けるために PostgreSQL のストレージを使い続けてきたが…。
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw24
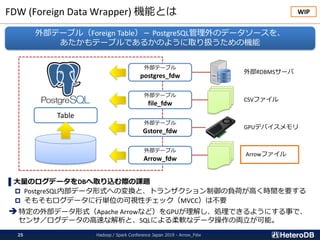
FDW (Foreign Data Wrapper) 機能とは
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw25
▌大量のログデータをDBへ取り込む際の課題
 PostgreSQL内部データ形式への変換と、トランザクション制御の負荷が高く時間を要する
 そもそもログデータに行単位の可視性チェック(MVCC)は不要
特定の外部データ形式(Apache Arrowなど)をGPUが理解し、処理できるようにする事で、
センサ/ログデータの高速な解析と、SQLによる柔軟なデータ操作の両立が可能。
外部テーブル(Foreign Table)- PostgreSQL管理外のデータソースを、
あたかもテーブルであるかのように取り扱うための機能
Table
外部テーブル
postgres_fdw
外部テーブル
file_fdw
外部テーブル
Gstore_fdw
外部テーブル
Arrow_fdw
外部RDBMSサーバ
CSVファイル
GPUデバイスメモリ
Arrowファイル
WIP
Pg2Arrow
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw26
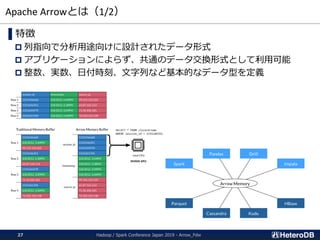
Apache Arrowとは(1/2)
▌特徴
 列指向で分析用途向けに設計されたデータ形式
 アプリケーションによらず、共通のデータ交換形式として利用可能
 整数、実数、日付時刻、文字列など基本的なデータ型を定義
NVIDIA GPU
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw27
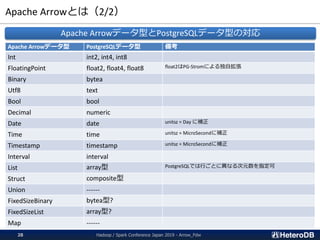
Apache Arrowとは(2/2)
Apache Arrowデータ型 PostgreSQLデータ型 備考
Int int2, int4, int8
FloatingPoint float2, float4, float8 float2はPG-Stromによる独自拡張
Binary bytea
Utf8 text
Bool bool
Decimal numeric
Date date unitsz = Day に補正
Time time unitsz = MicroSecondに補正
Timestamp timestamp unitsz = MicroSecondに補正
Interval interval
List array型 PostgreSQLでは行ごとに異なる次元数を指定可
Struct composite型
Union ------
FixedSizeBinary bytea型?
FixedSizeList array型?
Map ------
Apache Arrowデータ型とPostgreSQLデータ型の対応
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw28
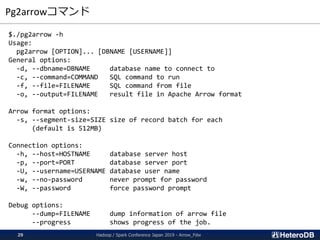
Pg2arrowコマンド
$./pg2arrow -h
Usage:
pg2arrow [OPTION]... [DBNAME [USERNAME]]
General options:
-d, --dbname=DBNAME database name to connect to
-c, --command=COMMAND SQL command to run
-f, --file=FILENAME SQL command from file
-o, --output=FILENAME result file in Apache Arrow format
Arrow format options:
-s, --segment-size=SIZE size of record batch for each
(default is 512MB)
Connection options:
-h, --host=HOSTNAME database server host
-p, --port=PORT database server port
-U, --username=USERNAME database user name
-w, --no-password never prompt for password
-W, --password force password prompt
Debug options:
--dump=FILENAME dump information of arrow file
--progress shows progress of the job.
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw29
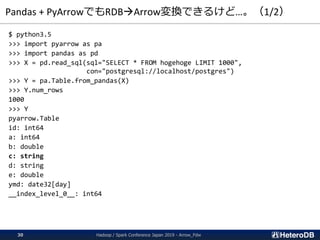
Pandas + PyArrowでもRDBArrow変換できるけど…。(1/2)
$ python3.5
>>> import pyarrow as pa
>>> import pandas as pd
>>> X = pd.read_sql(sql="SELECT * FROM hogehoge LIMIT 1000",
con="postgresql://localhost/postgres")
>>> Y = pa.Table.from_pandas(X)
>>> Y.num_rows
1000
>>> Y
pyarrow.Table
id: int64
a: int64
b: double
c: string
d: string
e: double
ymd: date32[day]
__index_level_0__: int64
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw30
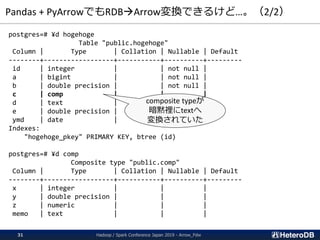
Pandas + PyArrowでもRDBArrow変換できるけど…。(2/2)
postgres=# ¥d hogehoge
Table "public.hogehoge"
Column | Type | Collation | Nullable | Default
--------+------------------+-----------+----------+---------
id | integer | | not null |
a | bigint | | not null |
b | double precision | | not null |
c | comp | | |
d | text | | |
e | double precision | | |
ymd | date | | |
Indexes:
"hogehoge_pkey" PRIMARY KEY, btree (id)
postgres=# ¥d comp
Composite type "public.comp"
Column | Type | Collation | Nullable | Default
--------+------------------+-----------+----------+---------
x | integer | | |
y | double precision | | |
z | numeric | | |
memo | text | | |
composite typeが
暗黙裡にtextへ
変換されていた
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw31
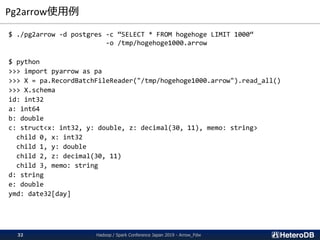
Pg2arrow使用例
$ ./pg2arrow -d postgres -c “SELECT * FROM hogehoge LIMIT 1000“
-o /tmp/hogehoge1000.arrow
$ python
>>> import pyarrow as pa
>>> X = pa.RecordBatchFileReader("/tmp/hogehoge1000.arrow").read_all()
>>> X.schema
id: int32
a: int64
b: double
c: struct<x: int32, y: double, z: decimal(30, 11), memo: string>
child 0, x: int32
child 1, y: double
child 2, z: decimal(30, 11)
child 3, memo: string
d: string
e: double
ymd: date32[day]
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw32
Arrow_Fdw
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw33
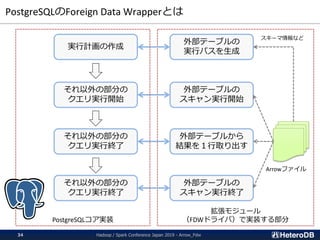
拡張モジュール
(FDWドライバ)で実装する部分
PostgreSQLのForeign Data Wrapperとは
実行計画の作成
それ以外の部分の
クエリ実行開始
それ以外の部分の
クエリ実行終了
それ以外の部分の
クエリ実行終了
外部テーブルの
スキャン実行開始
外部テーブルから
結果を1行取り出す
外部テーブルの
スキャン実行終了
外部テーブルの
実行パスを生成
PostgreSQLコア実装
Arrowファイル
スキーマ情報など
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw34
How to use Arrow_Fdw(1/3)
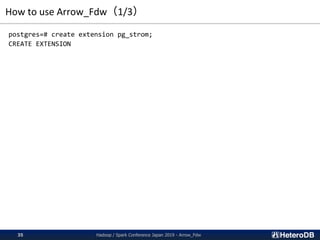
postgres=# create extension pg_strom;
CREATE EXTENSION
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw35
How to use Arrow_Fdw(2/3)
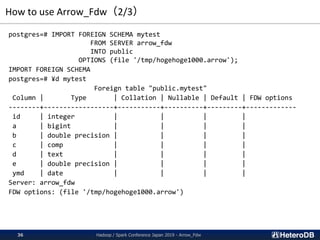
postgres=# IMPORT FOREIGN SCHEMA mytest
FROM SERVER arrow_fdw
INTO public
OPTIONS (file '/tmp/hogehoge1000.arrow');
IMPORT FOREIGN SCHEMA
postgres=# ¥d mytest
Foreign table "public.mytest"
Column | Type | Collation | Nullable | Default | FDW options
--------+------------------+-----------+----------+---------+-------------
id | integer | | | |
a | bigint | | | |
b | double precision | | | |
c | comp | | | |
d | text | | | |
e | double precision | | | |
ymd | date | | | |
Server: arrow_fdw
FDW options: (file '/tmp/hogehoge1000.arrow')
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw36
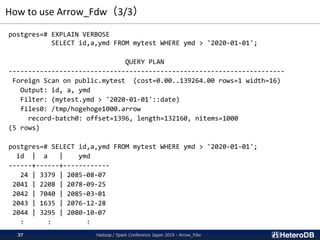
How to use Arrow_Fdw(3/3)
postgres=# EXPLAIN VERBOSE
SELECT id,a,ymd FROM mytest WHERE ymd > '2020-01-01';
QUERY PLAN
-----------------------------------------------------------------------
Foreign Scan on public.mytest (cost=0.00..139264.00 rows=1 width=16)
Output: id, a, ymd
Filter: (mytest.ymd > '2020-01-01'::date)
files0: /tmp/hogehoge1000.arrow
record-batch0: offset=1396, length=132160, nitems=1000
(5 rows)
postgres=# SELECT id,a,ymd FROM mytest WHERE ymd > '2020-01-01';
id | a | ymd
------+------+------------
24 | 3379 | 2085-08-07
2041 | 2208 | 2078-09-25
2042 | 7040 | 2085-03-01
2043 | 1635 | 2076-12-28
2044 | 3295 | 2080-10-07
: : :
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw37
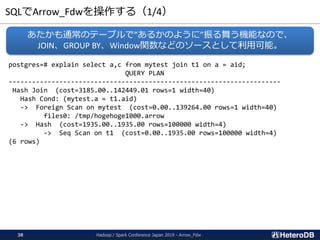
SQLでArrow_Fdwを操作する(1/4)
postgres=# explain select a,c from mytest join t1 on a = aid;
QUERY PLAN
----------------------------------------------------------------------
Hash Join (cost=3185.00..142449.01 rows=1 width=40)
Hash Cond: (mytest.a = t1.aid)
-> Foreign Scan on mytest (cost=0.00..139264.00 rows=1 width=40)
files0: /tmp/hogehoge1000.arrow
-> Hash (cost=1935.00..1935.00 rows=100000 width=4)
-> Seq Scan on t1 (cost=0.00..1935.00 rows=100000 width=4)
(6 rows)
あたかも通常のテーブルで”あるかのように”振る舞う機能なので、
JOIN、GROUP BY、Window関数などのソースとして利用可能。
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw38
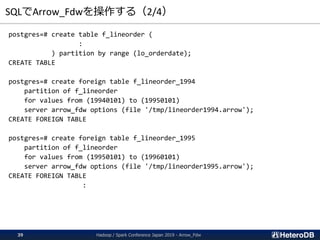
SQLでArrow_Fdwを操作する(2/4)
postgres=# create table f_lineorder (
:
) partition by range (lo_orderdate);
CREATE TABLE
postgres=# create foreign table f_lineorder_1994
partition of f_lineorder
for values from (19940101) to (19950101)
server arrow_fdw options (file '/tmp/lineorder1994.arrow');
CREATE FOREIGN TABLE
postgres=# create foreign table f_lineorder_1995
partition of f_lineorder
for values from (19950101) to (19960101)
server arrow_fdw options (file '/tmp/lineorder1995.arrow');
CREATE FOREIGN TABLE
:
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw39
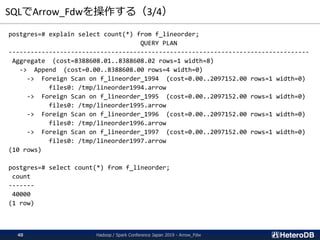
SQLでArrow_Fdwを操作する(3/4)
postgres=# explain select count(*) from f_lineorder;
QUERY PLAN
----------------------------------------------------------------------------------
Aggregate (cost=8388608.01..8388608.02 rows=1 width=8)
-> Append (cost=0.00..8388608.00 rows=4 width=0)
-> Foreign Scan on f_lineorder_1994 (cost=0.00..2097152.00 rows=1 width=0)
files0: /tmp/lineorder1994.arrow
-> Foreign Scan on f_lineorder_1995 (cost=0.00..2097152.00 rows=1 width=0)
files0: /tmp/lineorder1995.arrow
-> Foreign Scan on f_lineorder_1996 (cost=0.00..2097152.00 rows=1 width=0)
files0: /tmp/lineorder1996.arrow
-> Foreign Scan on f_lineorder_1997 (cost=0.00..2097152.00 rows=1 width=0)
files0: /tmp/lineorder1997.arrow
(10 rows)
postgres=# select count(*) from f_lineorder;
count
-------
40000
(1 row)
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw40
SQLでArrow_Fdwを操作する(4/4)
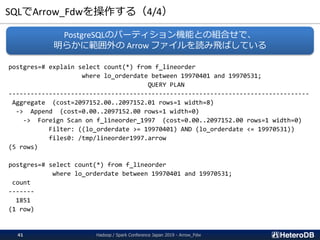
postgres=# explain select count(*) from f_lineorder
where lo_orderdate between 19970401 and 19970531;
QUERY PLAN
----------------------------------------------------------------------------------
Aggregate (cost=2097152.00..2097152.01 rows=1 width=8)
-> Append (cost=0.00..2097152.00 rows=1 width=0)
-> Foreign Scan on f_lineorder_1997 (cost=0.00..2097152.00 rows=1 width=0)
Filter: ((lo_orderdate >= 19970401) AND (lo_orderdate <= 19970531))
files0: /tmp/lineorder1997.arrow
(5 rows)
postgres=# select count(*) from f_lineorder
where lo_orderdate between 19970401 and 19970531;
count
-------
1851
(1 row)
PostgreSQLのパーティション機能との組合せで、
明らかに範囲外の Arrow ファイルを読み飛ばしている
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw41
今後のロードマップ
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw42
SSD-to-GPUダイレクトSQL への対応
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw43
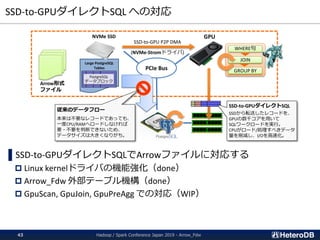
▌SSD-to-GPUダイレクトSQLでArrowファイルに対応する
 Linux kernelドライバの機能強化(done)
 Arrow_Fdw 外部テーブル機構(done)
 GpuScan, GpuJoin, GpuPreAgg での対応(WIP)
PCIe Bus
NVMe SSD GPU
SSD-to-GPU P2P DMA
(NVMe-Stromドライバ)
WHERE句
JOIN
GROUP BY
Large PostgreSQL
Tables
PostgreSQL
データブロック
SSD-to-GPUダイレクトSQL
SSDから転送したレコードを、
GPUの数千コアを用いて
SQLワークロードを実行。
CPUがロード/処理すべきデータ
量を削減し、I/Oを高速化。
従来のデータフロー
本来は不要なレコードであっても、
一度CPU/RAMへロードしなければ
要・不要を判断できないため、
データサイズは大きくなりがち。
Arrow形式
ファイル
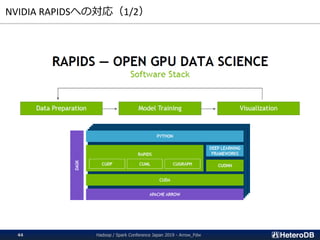
NVIDIA RAPIDSへの対応(1/2)
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw44
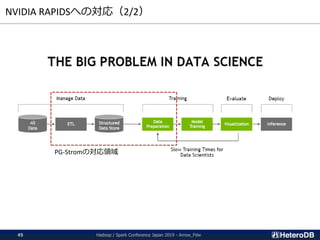
NVIDIA RAPIDSへの対応(2/2)
PG-Stromの対応領域
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw45
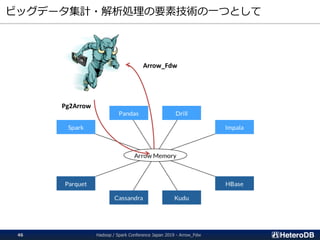
ビッグデータ集計・解析処理の要素技術の一つとして
Arrow_Fdw
Pg2Arrow
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw46
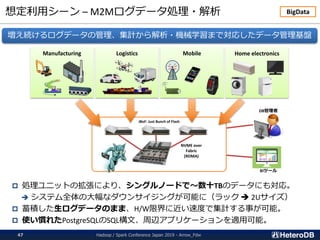
想定利用シーン – M2Mログデータ処理・解析
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw47
増え続けるログデータの管理、集計から解析・機械学習まで対応したデータ管理基盤
Manufacturing Logistics Mobile Home electronics
 処理ユニットの拡張により、シングルノードで~数十TBのデータにも対応。
 システム全体の大幅なダウンサイジングが可能に(ラック  2Uサイズ)
 蓄積した生ログデータのまま、H/W限界に近い速度で集計する事が可能。
 使い慣れたPostgreSQLのSQL構文、周辺アプリケーションを適用可能。
JBoF: Just Bunch of Flash
NVME over
Fabric
(RDMA)
DB管理者
BIツール
BigData
Any Questions?
▌e-mail: kaigai@heterodb.com
▌twitter: @kkaigai
Hadoop / Spark Conference Japan 2019 - Arrow_Fdw48
20190314 PGStrom Arrow_Fdw