Partly cloudy

Построение отказоустойчивых
систем в AWS минимальными
         средствами
Евгений Потапов

10 лет опыта веб-разработки

3 года опыта использования
облачных технологий

генеральный директор
компании «Сумма АйТи»
Поддержка высоконагруженных веб-сайтов
90 миллионов уникальных посетителей в сутки
113 инстансов на поддержке в Amazon AWS


Использовали AWS, Softlayer Cloudlayer,
             Rackspace Cloud, Scalaxy
Построение отказоустойчивых систем
 в AWS минимальными средствами

  Amazon Web Services с точки зрения
  эксплуатации
  Переход работающих проектов
  Использование особенностей облака
  минимальными средствами
Мы забываем


Реальную сущность облаков
Не думаем о стоимости внедрения
Верим в чудо
Владельцы хотят


Высокой надежности
Простой масштабируемости
Платить за используемые ресурсы
13
    новостей за сутки
Показывают яндекс.новости по запросу
«Облачные вычисления»
Ложные причины перехода в AWS


     Искажение реальности
     Потеря доверия к текущей
     хостинг-площадке
Полный переход в AWS


Решение станет дороже
Отказоустойчивости по умолчанию нет
Появляются новые проблемы
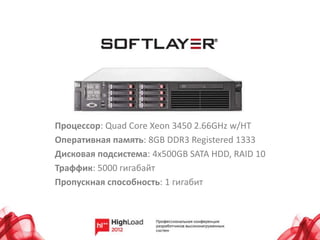
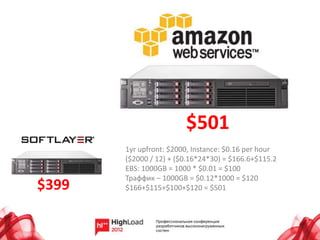
Процессор: Quad Core Xeon 3450 2.66GHz w/HT
Оперативная память: 8GB DDR3 Registered 1333
Дисковая подсистема: 4x500GB SATA HDD, RAID 10
Траффик: 5000 гигабайт
Пропускная способность: 1 гигабит
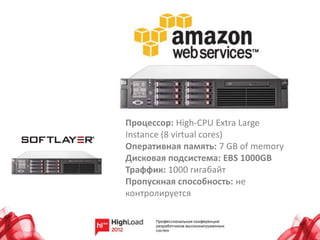
Процессор: High-CPU Extra Large
Instance (8 virtual cores)
Оперативная память: 7 GB of memory
Дисковая подсистема: EBS 1000GB
Траффик: 1000 гигабайт
Пропускная способность: не
контролируется
$501
       1yr upfront: $2000, Instance: $0.16 per hour
       ($2000 / 12) + ($0.16*24*30) = $166.6+$115.2
       EBS: 1000GB = 1000 * $0.01 = $100
       Траффик – 1000GB = $0.12*1000 = $120
$399   $166+$115+$100+$120 = $501
Но может быть AWS надёжнее?
Даунтайм: 53 часа (21 апреля 2011 года)
Причина: нарушение маршрутизации
Зона: US East
Начало аварии: 12:47 29.04.2011
Конец аварии: 18:15 23.04.2011
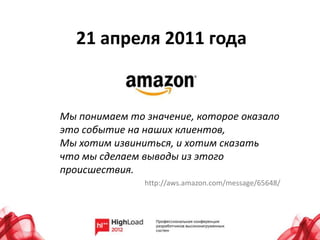
21 апреля 2011 года


Мы понимаем то значение, которое оказало
это событие на наших клиентов,
Мы хотим извиниться, и хотим сказать
что мы сделаем выводы из этого
происшествия.
               http://aws.amazon.com/message/65648/
Даунтайм: 36 часов (7 августа 2011 года)
Причина: отказ подстанции
Зона: EU West
Начало аварии: 10:41 07.08.2011
Конец аварии: 20:25 08.08.2011
7 августа 2011 года


Мы понимаем то значение, которое оказало
это событие на наших клиентов,
Мы хотим извиниться, и хотим сказать
что мы сделаем выводы из этого
происшествия.
              http://aws.amazon.com/message/2329B7/
Даунтайм: 7 часов (29 июня 2012 года)
Причина: отказ подстанции
Зона: US East
Начало аварии: 19:24 29.06.2012
Конец аварии: 02:45 30.06.2012
29 июня 2012 года


Мы извиняемся за те неудобства, которое
оказало это событие на наших клиентов…
Мы проведем много часов делая выводы из
этого происшествия.
              http://aws.amazon.com/message/2329B7/
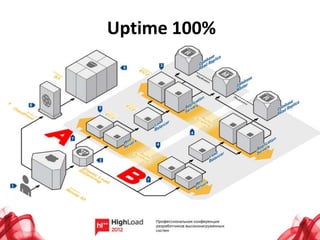
Uptime 100%
Во всех случаях авария затронула несколько
Availability зон в пределах одной географической
                      локации
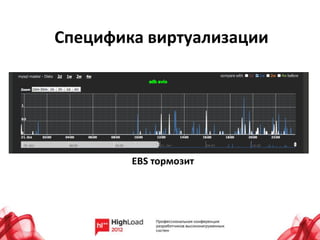
Специфика виртуализации


        EBS тормозит
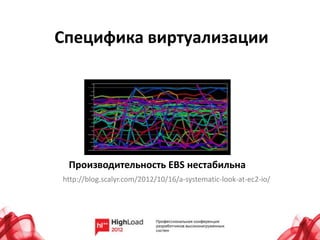
Специфика виртуализации


 Производительность EBS нестабильна
http://blog.scalyr.com/2012/10/16/a-systematic-look-at-ec2-io/
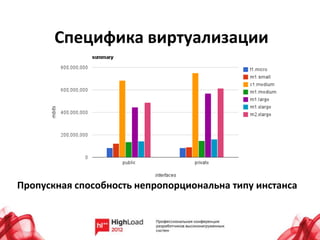
Специфика виртуализации


Пропускная способность непропорциональна типу инстанса
Но, хорошие решения существуют
1      Гибридный бэкап
             (показания к применению)


    Текущий хостинг в основном
    устраивает
    Допустим «откат» в данных на период
    последнего бэкапа
    Бюджет минимален
1      Гибридный бэкап
             (особенности решения)


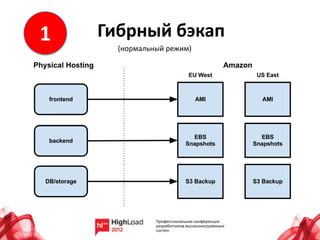
    Сайт находится на физическом
    хостинге все время, кроме аварийных
    ситуаций
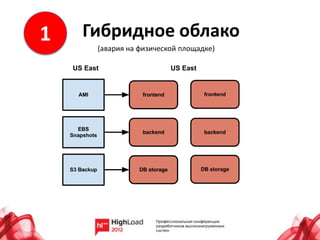
    В AWS находятся только образы
    подсистем проекта и регулярные
    бэкапы, которые поднимаются только
    в случае аварии
1   Гибрный бэкап
      (нормальный режим)
1   Гибридное облако
     (авария на физической площадке)
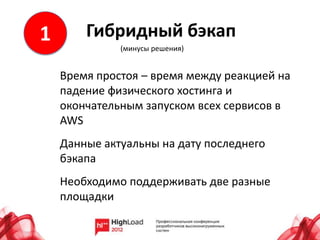
1       Гибридный бэкап
              (минусы решения)


    Время простоя – время между реакцией на
    падение физического хостинга и
    окончательным запуском всех сервисов в
    AWS
    Данные актуальны на дату последнего
    бэкапа
    Необходимо поддерживать две разные
    площадки
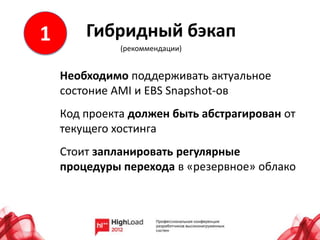
1       Гибридный бэкап
              (рекоммендации)


    Необходимо поддерживать актуальное
    состоние AMI и EBS Snapshot-ов
    Код проекта должен быть абстрагирован от
    текущего хостинга
    Стоит запланировать регулярные
    процедуры перехода в «резервное» облако
2     Бюджетное облако
             (показания к приминению)


    Текущий хостинг в основном
    устраивает
    При failover в резервную платформу
    данные должны быть актуальны
    Бюджет чуть менее минимален 
2      Бюджетное облако
            (особенности решения)

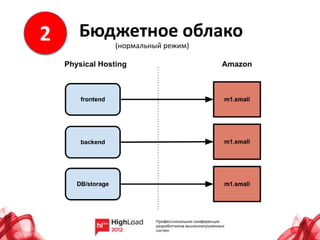
    Проект находится на физическом хостинге,
    но реплицируется на минимально
    возможную конфигурацию в Amazon
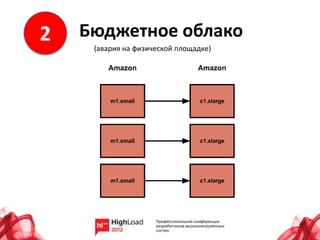
    Минимальная конфигурация
    масштабируется до необходимой в случае
    аварии
    Стоимость резервирования равна стоимости
    минимально выдерживающего процесс
    репликации инстанса
2   Бюджетное облако
       (нормальный режим)
2   Бюджетное облако
     (авария на физической площадке)
2        Бюджетное облако
                (минусы решения)


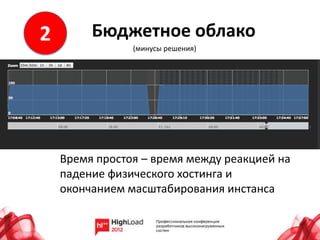
    Время простоя – время между реакцией на
    падение физического хостинга и
    окончанием масштабирования инстанса
2       Бюджетное облако
              (рекоммендации)


    «Минимальная конфигурация»
    должна быть способна выдержать
    входящий поток репликации
    За самим процессом репликации
    следует следить
Переход ради
    масштабирования

«Взять слабый инстанс и
автоматически масштабировать его
при росте нагрузок в пиковые
часы»
Переход ради
   масштабирования

Вертикальное масштабирование:
Апгрейд инстанса – 4-10 минут

Горизонтальное масштабирование:
Создание инстанса – 5-10 минут
Горизонтальное
3     масштабирование v.1
                (применение)


    Текущий хостинг всем устраивает, но
    нагрузка возрастает в сезонные периоды
    (т.е. праздники, выходные и т.д.)
    При появлении пиковой нагрузки можно
    некоторое время «потормозить»
    Бюджет сравним с «гибридным бэкапом»
Горизонтальное
3     масштабирование v.1
                (особенности решения)


    Вариация «Бюджетного клауда».
    Проект находится на физическом
    хостинге, реплика хранится в AWS
    При необходимости масштабирования
    необходимое количество инстансов
    запускается в AWS и синхронизируется с
    «минимального» инстанса.
Горизонтальное
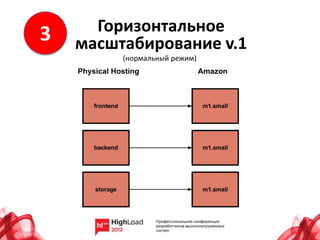
3   масштабирование v.1
         (нормальный режим)
Горизонтальное
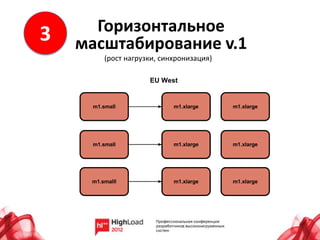
3   масштабирование v.1
       (рост нагрузки, синхронизация)
Горизонтальное
3   масштабирование v.1
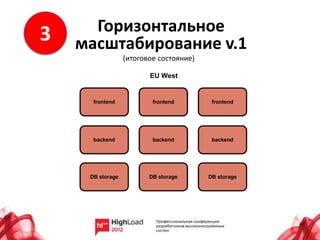
         (итоговое состояние)
Горизонтальное
3     масштабирование v.1
                (минусы решения)

    До запуска в AWS конфигурации способной
    выдержать текущую нагрузку скорость
    актуальность данных будет ограничиваться
    пингом между площадками
    Если до этого горизонтальное
    масштабирование не использовалось -
    большие усилия направленные на
    изменения архитектуры проекта
Горизонтальное
3     масштабирование v.1
                (рекомендации)

    При использовании решений не
    поддерживающих multi-master архитектуры
    необходимо учитывать наличие только
    одной (двух) мастер-машин (либо
    использовать циркулярную репликацию)
    Очень легко масштабировать чтение, очень
    сложно масштабировать запись
    (синхронизация данных при удалении
    инстанса)
Горизонтальное
4     масштабирование v.2
                (применение)


    Текущий хостинг всем устраивает, но
    нагрузка возрастает в короткий
    промежуток времени (часы)
    При появлении пиковой нагрузки нет
    времени на синхронизацию данных –
    данные должны быть актуальны
Горизонтальное
4     масштабирование v.2
                (плюсы решения)


    Проект целиком находится в AWS,
    классический облачный хостинг 
    Минимальный пинг между отдельными
    компонентами системы
    Для резервной конфигурации расходы
    остаются небольшими
Горизонтальное
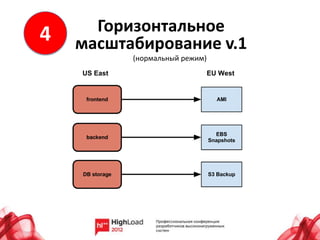
4   масштабирование v.1
          (нормальный режим)
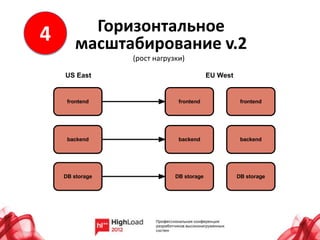
Горизонтальное
4   масштабирование v.2
          (рост нагрузки)
Специальные сервисы

EC2 Spot Instances
Amazon Route 53
Amazon ELB
Amazon Glacier
Специальные сервисы
Spot Instances:
Amazon позиционирует spot instances как
инструмент для cloud computing
Действительно, можно взять EC2-инстанс
высокой конфигурации за небольшие деньги.
Этот инстанс будет остановлен как только кто-то
предложит большую ставку при дефиците
инстансов.
Специальные сервисы
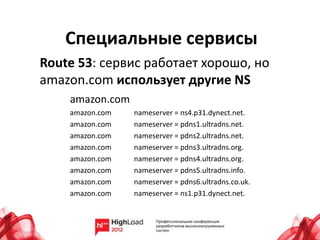
Route 53: сервис работает хорошо, но
amazon.com использует другие NS
    amazon.com
    amazon.com   nameserver = ns4.p31.dynect.net.
    amazon.com   nameserver = pdns1.ultradns.net.
    amazon.com   nameserver = pdns2.ultradns.net.
    amazon.com   nameserver = pdns3.ultradns.org.
    amazon.com   nameserver = pdns4.ultradns.org.
    amazon.com   nameserver = pdns5.ultradns.info.
    amazon.com   nameserver = pdns6.ultradns.co.uk.
    amazon.com   nameserver = ns1.p31.dynect.net.
Специальные сервисы
ELB: последнее падение затронуло ELB
Проекты которые полагались только
на ELB в пределах одного региона
оказались недоступны на весь период
времени
Специальные сервисы
Glacier: высокая стоимость
восстановления данных
    Дешевизна и надежность архивирования
    компенсируется стоимостью и скоростью
    выгрузки данных:

    «Стоимость выгрузки 3 терабайт данных может
    дойти до $22082»
     http://news.ycombinator.com/item?id=4412886
Точка зрения
Реально оценивайте пользу от облаков
Эффективные решения находятся в области
комбинирования подходов


Всегда читайте, что написано мелким шрифтом
Построение отказоустойчивых систем
 в AWS минимальными средствами


               Евгений Потапов

               http://itsumma.ru
               eapotapov@itsumma.ru
               http://twitter.com/eapotapov