Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
Deep Learning JP
PPTX, PDF
4,822 views
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
2021/12/03 Deep Learning JP: http://deeplearning.jp/seminar-2/
Technology
◦
Related topics:
Deep Learning
•
Read more
1
Save
Share
Embed
Save to Drive
Download now
Downloaded 62 times
1
/ 24
2
/ 24
3
/ 24
4
/ 24
5
/ 24
6
/ 24
7
/ 24
8
/ 24
9
/ 24
10
/ 24
11
/ 24
12
/ 24
13
/ 24
14
/ 24
15
/ 24
16
/ 24
17
/ 24
18
/ 24
19
/ 24
20
/ 24
More Related Content
PDF
最近のDeep Learning (NLP) 界隈におけるAttention事情
by
Yuta Kikuchi
76 slides
75.6K views
PPTX
Curriculum Learning (関東CV勉強会)
by
Yoshitaka Ushiku
43 slides
82.3K views
PPTX
[DL輪読会]相互情報量最大化による表現学習
by
Deep Learning JP
43 slides
9.4K views
PDF
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
by
Deep Learning JP
29 slides
19.7K views
PDF
【DL輪読会】How Much Can CLIP Benefit Vision-and-Language Tasks?
by
Deep Learning JP
27 slides
1.8K views
PDF
SSII2022 [OS3-02] Federated Learningの基礎と応用
by
SSII
38 slides
3.4K views
PPTX
画像キャプションの自動生成
by
Yoshitaka Ushiku
101 slides
58.6K views
PPTX
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
by
Deep Learning JP
34 slides
4.5K views
最近のDeep Learning (NLP) 界隈におけるAttention事情
by
Yuta Kikuchi
76 slides
75.6K views
Curriculum Learning (関東CV勉強会)
by
Yoshitaka Ushiku
43 slides
82.3K views
[DL輪読会]相互情報量最大化による表現学習
by
Deep Learning JP
43 slides
9.4K views
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
by
Deep Learning JP
29 slides
19.7K views
【DL輪読会】How Much Can CLIP Benefit Vision-and-Language Tasks?
by
Deep Learning JP
27 slides
1.8K views
SSII2022 [OS3-02] Federated Learningの基礎と応用
by
SSII
38 slides
3.4K views
画像キャプションの自動生成
by
Yoshitaka Ushiku
101 slides
58.6K views
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
by
Deep Learning JP
34 slides
4.5K views
What's hot
PDF
グラフニューラルネットワーク入門
by
ryosuke-kojima
65 slides
57.7K views
PDF
GAN(と強化学習との関係)
by
Masahiro Suzuki
77 slides
88K views
PDF
深層生成モデルと世界モデル
by
Masahiro Suzuki
57 slides
17.9K views
PPTX
PyTorchLightning ベース Hydra+MLFlow+Optuna による機械学習開発環境の構築
by
Kosuke Shinoda
19 slides
3.7K views
PDF
【メタサーベイ】基盤モデル / Foundation Models
by
cvpaper. challenge
63 slides
20.6K views
PDF
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法
by
SSII
48 slides
5.9K views
PDF
Active Learning 入門
by
Shuyo Nakatani
60 slides
54.1K views
PPTX
近年のHierarchical Vision Transformer
by
Yusuke Uchida
46 slides
17.9K views
PDF
[DL輪読会]Decision Transformer: Reinforcement Learning via Sequence Modeling
by
Deep Learning JP
25 slides
3.8K views
PDF
Data-Centric AIの紹介
by
Kazuyuki Miyazawa
39 slides
5.3K views
PPTX
[DL輪読会]Life-Long Disentangled Representation Learning with Cross-Domain Laten...
by
Deep Learning JP
42 slides
5.9K views
PPTX
[DL輪読会]When Does Label Smoothing Help?
by
Deep Learning JP
46 slides
11.7K views
PPTX
【DL輪読会】High-Resolution Image Synthesis with Latent Diffusion Models
by
Deep Learning JP
15 slides
3.2K views
PDF
多様な強化学習の概念と課題認識
by
佑 甲野
38 slides
59.4K views
PDF
モデルではなく、データセットを蒸留する
by
Takahiro Kubo
16 slides
8.8K views
PPTX
SSII2020SS: グラフデータでも深層学習 〜 Graph Neural Networks 入門 〜
by
SSII
44 slides
4.7K views
PPTX
[DL輪読会]Pay Attention to MLPs (gMLP)
by
Deep Learning JP
24 slides
18.9K views
PPTX
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
PPTX
Triplet Loss 徹底解説
by
tancoro
46 slides
13.3K views
PDF
深層学習によるHuman Pose Estimationの基礎
by
Takumi Ohkuma
44 slides
3.9K views
グラフニューラルネットワーク入門
by
ryosuke-kojima
65 slides
57.7K views
GAN(と強化学習との関係)
by
Masahiro Suzuki
77 slides
88K views
深層生成モデルと世界モデル
by
Masahiro Suzuki
57 slides
17.9K views
PyTorchLightning ベース Hydra+MLFlow+Optuna による機械学習開発環境の構築
by
Kosuke Shinoda
19 slides
3.7K views
【メタサーベイ】基盤モデル / Foundation Models
by
cvpaper. challenge
63 slides
20.6K views
SSII2021 [OS2-01] 転移学習の基礎:異なるタスクの知識を利用するための機械学習の方法
by
SSII
48 slides
5.9K views
Active Learning 入門
by
Shuyo Nakatani
60 slides
54.1K views
近年のHierarchical Vision Transformer
by
Yusuke Uchida
46 slides
17.9K views
[DL輪読会]Decision Transformer: Reinforcement Learning via Sequence Modeling
by
Deep Learning JP
25 slides
3.8K views
Data-Centric AIの紹介
by
Kazuyuki Miyazawa
39 slides
5.3K views
[DL輪読会]Life-Long Disentangled Representation Learning with Cross-Domain Laten...
by
Deep Learning JP
42 slides
5.9K views
[DL輪読会]When Does Label Smoothing Help?
by
Deep Learning JP
46 slides
11.7K views
【DL輪読会】High-Resolution Image Synthesis with Latent Diffusion Models
by
Deep Learning JP
15 slides
3.2K views
多様な強化学習の概念と課題認識
by
佑 甲野
38 slides
59.4K views
モデルではなく、データセットを蒸留する
by
Takahiro Kubo
16 slides
8.8K views
SSII2020SS: グラフデータでも深層学習 〜 Graph Neural Networks 入門 〜
by
SSII
44 slides
4.7K views
[DL輪読会]Pay Attention to MLPs (gMLP)
by
Deep Learning JP
24 slides
18.9K views
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
Triplet Loss 徹底解説
by
tancoro
46 slides
13.3K views
深層学習によるHuman Pose Estimationの基礎
by
Takumi Ohkuma
44 slides
3.9K views
Similar to 【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
PPTX
【DL輪読会】Non-Linguistic Supervision for Contrastive Learning of Sentence Embedd...
by
Deep Learning JP
27 slides
422 views
PPTX
[DL輪読会]Unsupervised Neural Machine Translation
by
Deep Learning JP
29 slides
1.5K views
PPTX
[PaperReading]Unsupervised Discrete Sentence Representation Learning for Inte...
by
Kazutoshi Shinoda
39 slides
286 views
PDF
Semantic_Matching_AAAI16_論文紹介
by
Masayoshi Kondo
33 slides
255 views
PDF
transformer解説~Chat-GPTの源流~
by
MasayoshiTsutsui
35 slides
338 views
PPT
[FUNAI輪講] BERT
by
Takanori Ebihara
14 slides
66 views
PDF
Deconvolutional paragraph representation learning
by
Yasuhide Miura
29 slides
1.2K views
PDF
Extract and edit
by
禎晃 山崎
29 slides
185 views
PDF
Contrastive learning 20200607
by
ぱんいち すみもと
47 slides
2.8K views
PDF
Deep Learningの基礎と応用
by
Seiya Tokui
39 slides
34.5K views
PDF
東京大学2020年度深層学習(Deep learning基礎講座) 第9回「深層学習と自然言語処理」(一部文字が欠けてます)
by
Hitomi Yanaka
69 slides
2.9K views
PDF
最先端NLP勉強会2017_ACL17
by
Masayoshi Kondo
45 slides
1.2K views
PDF
[最新版] JSAI2018 チュートリアル「"深層学習時代の" ゼロから始める自然言語処理」
by
Yuki Arase
80 slides
44.2K views
PDF
[DL輪読会]Deep Recurrent Generative Decoder For Abstractive Text Summarization(E...
by
Deep Learning JP
33 slides
2.6K views
PDF
文章生成の未解決問題
by
KCS Keio Computer Society
29 slides
577 views
PDF
CluBERT: A Cluster-Based Approach for Learning Sense Distributions in Multipl...
by
禎晃 山崎
32 slides
330 views
PPTX
東京大学2020年度深層学習(Deep learning基礎講座) 第9回「深層学習と自然言語処理」
by
Hitomi Yanaka
69 slides
5.2K views
PPTX
[DL輪読会]It's not just size that maters small language models are also few sho...
by
Deep Learning JP
26 slides
716 views
PDF
STAIR Lab Seminar 202105
by
Sho Takase
59 slides
1.7K views
PPTX
[DL輪読会]BERT: Pre-training of Deep Bidirectional Transformers for Language Und...
by
Deep Learning JP
29 slides
21.2K views
【DL輪読会】Non-Linguistic Supervision for Contrastive Learning of Sentence Embedd...
by
Deep Learning JP
27 slides
422 views
[DL輪読会]Unsupervised Neural Machine Translation
by
Deep Learning JP
29 slides
1.5K views
[PaperReading]Unsupervised Discrete Sentence Representation Learning for Inte...
by
Kazutoshi Shinoda
39 slides
286 views
Semantic_Matching_AAAI16_論文紹介
by
Masayoshi Kondo
33 slides
255 views
transformer解説~Chat-GPTの源流~
by
MasayoshiTsutsui
35 slides
338 views
[FUNAI輪講] BERT
by
Takanori Ebihara
14 slides
66 views
Deconvolutional paragraph representation learning
by
Yasuhide Miura
29 slides
1.2K views
Extract and edit
by
禎晃 山崎
29 slides
185 views
Contrastive learning 20200607
by
ぱんいち すみもと
47 slides
2.8K views
Deep Learningの基礎と応用
by
Seiya Tokui
39 slides
34.5K views
東京大学2020年度深層学習(Deep learning基礎講座) 第9回「深層学習と自然言語処理」(一部文字が欠けてます)
by
Hitomi Yanaka
69 slides
2.9K views
最先端NLP勉強会2017_ACL17
by
Masayoshi Kondo
45 slides
1.2K views
[最新版] JSAI2018 チュートリアル「"深層学習時代の" ゼロから始める自然言語処理」
by
Yuki Arase
80 slides
44.2K views
[DL輪読会]Deep Recurrent Generative Decoder For Abstractive Text Summarization(E...
by
Deep Learning JP
33 slides
2.6K views
文章生成の未解決問題
by
KCS Keio Computer Society
29 slides
577 views
CluBERT: A Cluster-Based Approach for Learning Sense Distributions in Multipl...
by
禎晃 山崎
32 slides
330 views
東京大学2020年度深層学習(Deep learning基礎講座) 第9回「深層学習と自然言語処理」
by
Hitomi Yanaka
69 slides
5.2K views
[DL輪読会]It's not just size that maters small language models are also few sho...
by
Deep Learning JP
26 slides
716 views
STAIR Lab Seminar 202105
by
Sho Takase
59 slides
1.7K views
[DL輪読会]BERT: Pre-training of Deep Bidirectional Transformers for Language Und...
by
Deep Learning JP
29 slides
21.2K views
More from Deep Learning JP
PPTX
【DL輪読会】AdaptDiffuser: Diffusion Models as Adaptive Self-evolving Planners
by
Deep Learning JP
28 slides
960 views
PPTX
【DL輪読会】事前学習用データセットについて
by
Deep Learning JP
20 slides
788 views
PPTX
【DL輪読会】 "Learning to render novel views from wide-baseline stereo pairs." CVP...
by
Deep Learning JP
26 slides
352 views
PPTX
【DL輪読会】Zero-Shot Dual-Lens Super-Resolution
by
Deep Learning JP
26 slides
328 views
PPTX
【DL輪読会】BloombergGPT: A Large Language Model for Finance arxiv
by
Deep Learning JP
18 slides
892 views
PPTX
【DL輪読会】マルチモーダル LLM
by
Deep Learning JP
14 slides
501 views
PDF
【 DL輪読会】ToolLLM: Facilitating Large Language Models to Master 16000+ Real-wo...
by
Deep Learning JP
17 slides
174 views
PPTX
【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
by
Deep Learning JP
30 slides
646 views
PDF
【DL輪読会】Can Neural Network Memorization Be Localized?
by
Deep Learning JP
15 slides
695 views
PPTX
【DL輪読会】Hopfield network 関連研究について
by
Deep Learning JP
29 slides
3.9K views
PPTX
【DL輪読会】SimPer: Simple self-supervised learning of periodic targets( ICLR 2023 )
by
Deep Learning JP
14 slides
586 views
PDF
【DL輪読会】RLCD: Reinforcement Learning from Contrast Distillation for Language M...
by
Deep Learning JP
20 slides
370 views
PDF
【DL輪読会】"Secrets of RLHF in Large Language Models Part I: PPO"
by
Deep Learning JP
21 slides
1.4K views
PPTX
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
PPTX
【DL輪読会】Llama 2: Open Foundation and Fine-Tuned Chat Models
by
Deep Learning JP
38 slides
2.5K views
PDF
【DL輪読会】"Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware"
by
Deep Learning JP
12 slides
1.3K views
PPTX
【DL輪読会】Parameter is Not All You Need:Starting from Non-Parametric Networks fo...
by
Deep Learning JP
21 slides
678 views
PDF
【DL輪読会】Drag Your GAN: Interactive Point-based Manipulation on the Generative ...
by
Deep Learning JP
25 slides
1.1K views
PDF
【DL輪読会】Self-Supervised Learning from Images with a Joint-Embedding Predictive...
by
Deep Learning JP
26 slides
3.3K views
PPTX
【DL輪読会】Towards Understanding Ensemble, Knowledge Distillation and Self-Distil...
by
Deep Learning JP
21 slides
785 views
【DL輪読会】AdaptDiffuser: Diffusion Models as Adaptive Self-evolving Planners
by
Deep Learning JP
28 slides
960 views
【DL輪読会】事前学習用データセットについて
by
Deep Learning JP
20 slides
788 views
【DL輪読会】 "Learning to render novel views from wide-baseline stereo pairs." CVP...
by
Deep Learning JP
26 slides
352 views
【DL輪読会】Zero-Shot Dual-Lens Super-Resolution
by
Deep Learning JP
26 slides
328 views
【DL輪読会】BloombergGPT: A Large Language Model for Finance arxiv
by
Deep Learning JP
18 slides
892 views
【DL輪読会】マルチモーダル LLM
by
Deep Learning JP
14 slides
501 views
【 DL輪読会】ToolLLM: Facilitating Large Language Models to Master 16000+ Real-wo...
by
Deep Learning JP
17 slides
174 views
【DL輪読会】AnyLoc: Towards Universal Visual Place Recognition
by
Deep Learning JP
30 slides
646 views
【DL輪読会】Can Neural Network Memorization Be Localized?
by
Deep Learning JP
15 slides
695 views
【DL輪読会】Hopfield network 関連研究について
by
Deep Learning JP
29 slides
3.9K views
【DL輪読会】SimPer: Simple self-supervised learning of periodic targets( ICLR 2023 )
by
Deep Learning JP
14 slides
586 views
【DL輪読会】RLCD: Reinforcement Learning from Contrast Distillation for Language M...
by
Deep Learning JP
20 slides
370 views
【DL輪読会】"Secrets of RLHF in Large Language Models Part I: PPO"
by
Deep Learning JP
21 slides
1.4K views
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
【DL輪読会】Llama 2: Open Foundation and Fine-Tuned Chat Models
by
Deep Learning JP
38 slides
2.5K views
【DL輪読会】"Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware"
by
Deep Learning JP
12 slides
1.3K views
【DL輪読会】Parameter is Not All You Need:Starting from Non-Parametric Networks fo...
by
Deep Learning JP
21 slides
678 views
【DL輪読会】Drag Your GAN: Interactive Point-based Manipulation on the Generative ...
by
Deep Learning JP
25 slides
1.1K views
【DL輪読会】Self-Supervised Learning from Images with a Joint-Embedding Predictive...
by
Deep Learning JP
26 slides
3.3K views
【DL輪読会】Towards Understanding Ensemble, Knowledge Distillation and Self-Distil...
by
Deep Learning JP
21 slides
785 views
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
1.
http://deeplearning.jp/ SimCSE: Simple Contrastive
Learning of Sentence Embeddings (EMNLP 2021) 山本 貴之 (ヤフー株式会社) DEEP LEARNING JP [DL Papers] 1
2.
書誌情報 SimCSE: Simple Contrastive
Learning of Sentence Embeddings https://arxiv.org/abs/2104.08821 タイトル: 著者: Tianyu Gao†* , Xingcheng Yao‡*, Danqi Chen † † プリンストン大学 コンピュータサイエンス学科 ‡ 清華大学 学際情報科学研究所 • BERTで文章の意味合いをより正しく埋め込み表現する、対照学習手法 • 教師なし、教師ありの2つの手法で両方ともSOTA 概要: 2 選定理由: 手法がシンプルな為、応用範囲の期待による (Accepted to EMNLP 2021) 公式実装: https://github.com/princeton-nlp/SimCSE
3.
アジェンダ 1. 導入 2. 先行研究 3.
手法 4. 実験 5. まとめ 3
4.
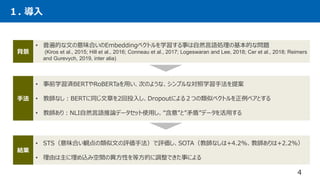
1. 導入 4 • 普遍的な文の意味合いのEmbeddingベクトルを学習する事は自然言語処理の基本的な問題 (Kiros
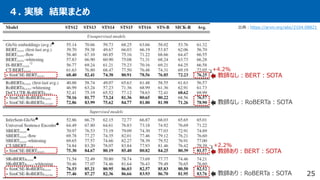
et al., 2015; Hill et al., 2016; Conneau et al., 2017; Logeswaran and Lee, 2018; Cer et al., 2018; Reimers and Gurevych, 2019, inter alia) • STS(意味合い観点の類似文の評価手法)で評価し、SOTA(教師なしは+4.2%、教師ありは+2.2%) • 理由は主に埋め込み空間の異方性を等方的に調整できた事による • 事前学習済BERTやRoBERTaを用い、次のような、シンプルな対照学習手法を提案 • 教師なし:BERTに同じ文章を2回投入し、Dropoutによる2つの類似ベクトルを正例ペアとする • 教師あり:NLI自然言語推論データセット使用し、”含意”と”矛盾”データを活用する 背景 手法 結果
5.
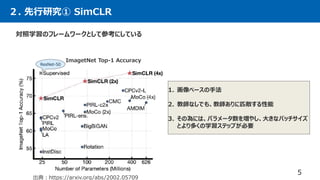
5 対照学習のフレームワークとして参考にしている 1. 画像ベースの手法 2. 教師なしでも、教師ありに匹敵する性能 3.
その為には、パラメータ数を増やし、大きなバッチサイズ とより多くの学習ステップが必要 出典:https://arxiv.org/abs/2002.05709 2. 先行研究① SimCLR ResNet-50 ImagetNet Top-1 Accuracy
6.
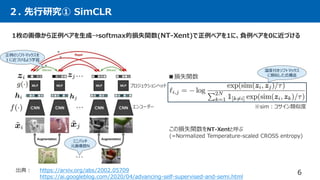
6 1枚の画像から正例ペアを生成→softmax的損失関数(NT-Xent)で正例ペアを1に、負例ペアを0に近づける 出典: https://arxiv.org/abs/2002.05709 https://ai.googleblog.com/2020/04/advancing-self-supervised-and-semi.html 2. 先行研究①
SimCLR エンコーダー プロジェクションヘッド ※sim:コサイン類似度 ■損失関数 この損失関数をNT-Xentと呼ぶ (=Normalized Temperature-scaled CROSS entropy) 温度付きソフトマックス に類似した式構造 ミニバッチ 元画像数N * * * 正例のソフトマックスを 1に近づけるよう学習
7.
8 • 従来のSOTA論文 • 文章のEmbeddingベクトルの表現学習をBERTを用い教師なしで行う(教師ありも実施) •
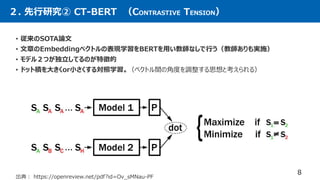
モデル2つが独立してるのが特徴的 • ドット積を大きくor小さくする対照学習。(ベクトル間の角度を調整する思想と考えられる) 出典: https://openreview.net/pdf?id=Ov_sMNau-PF 2. 先行研究② CT-BERT (CONTRASTIVE TENSION)
8.
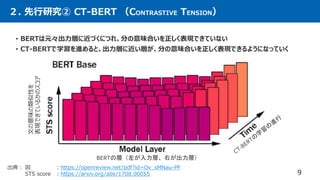
9 • BERTは元々出力層に近づくにつれ、分の意味合いを正しく表現できていない • CT-BERTで学習を進めると、出力層に近い層が、分の意味合いを正しく表現できるようになっていく 出典:
図 :https://openreview.net/pdf?id=Ov_sMNau-PF STS score :https://arxiv.org/abs/1708.00055 2. 先行研究② CT-BERT (CONTRASTIVE TENSION) 文の意味の類似性を 表現できているかのスコア BERTの層(左が入力層、右が出力層)
9.
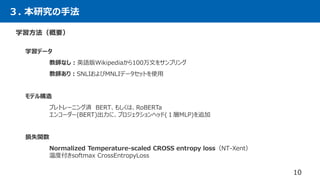
3. 本研究の手法 学習方法(概要) 10 学習データ 教師なし:英語版Wikipediaから100万文をサンプリング 教師あり:SNLIおよびMNLIデータセットを使用 モデル構造 プレトレーニング済 BERT、もしくは、RoBERTa エンコーダー(BERT)出力に、プロジェクションヘッド(1層MLP)を追加 損失関数 Normalized
Temperature-scaled CROSS entropy loss(NT-Xent) 温度付きsoftmax CrossEntropyLoss
10.
3. 手法 教師なし 教師なし手法の学習手法 11 1 2 1.
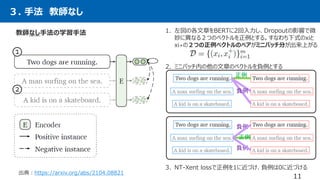
左図の各文章をBERTに2回入力し、Dropoutの影響で微 妙に異なる2つのベクトルを正例とする。すなわち下式のxiと xi+の2つの正例ベクトルのペアがミニバッチ分が出来上がる 2. ミニバッチ内の他の文章のベクトルを負例とする 3. NT-Xent lossで正例を1に近づけ、負例は0に近づける 出典:https://arxiv.org/abs/2104.08821 正例 負例 負例 負例 正例
11.
3. 手法 損失関数
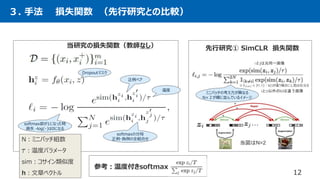
(先行研究との比較) 当研究の損失関数(教師なし) 12 参考:温度付きsoftmax 先行研究① SimCLR 損失関数 iとjは元同一画像 iと(i以外のk)は違う画像 当図はN=2 ミニバッチの考え方が異なる N×2が横に並んでいるイメージ 正例ペア softmaxの分母 正例・負例の全組合せ Dropoutマスク softmax部が1になった時 損失 -log(・)は0になる N:ミニバッチ組数 :温度パラメータ sim:コサイン類似度 h:文章ベクトル 温度
12.
3. 手法 損失関数の、cos類似度とsoftmax値の関係
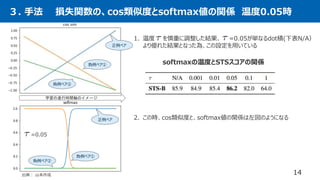
温度0.05時 14 出典: 山本作成 正例ペア 負例ペア① 負例ペア② 正例ペア 負例ペア① 負例ペア② 学習の進行時間軸のイメージ =0.05 softmaxの温度とSTSスコアの関係 1. 温度 を慎重に調整した結果、 =0.05が単なるdot積(下表N/A) より優れた結果となった為、この設定を用いている 2. この時、cos類似度と、softmax値の関係は左図のようになる
13.
3. 手法 損失関数の実装 15 ###
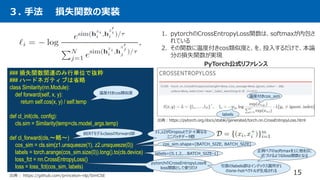
損失関数関連のみ行単位で抜粋 ### ハードネガティブは省略 class Similarity(nn.Module): def forward(self, x, y): return self.cos(x, y) / self.temp def cl_init(cls, config): cls.sim = Similarity(temp=cls.model_args.temp) def cl_forward(cls,~略~) cos_sim = cls.sim(z1.unsqueeze(1), z2.unsqueeze(0)) labels = torch.arange(cos_sim.size(0)).long().to(cls.device) loss_fct = nn.CrossEntropyLoss() loss = loss_fct(cos_sim, labels) 出典: https://github.com/princeton-nlp/SimCSE 温度付きcos類似度 BERTモデルclassのforward部 cos_sim.shape=[BATCH_SIZE, BATCH_SIZE] pytorchのCrossEntropyLossを loss関数として使うだけ 1. pytorchのCrossEntropyLoss関数は、softmaxが内包さ れている 2. その関数に温度付きcos類似度と、を、投入するだけで、本論 分の損失関数が実現 z1,z2がDropoutで少々異なる ミニバッチデータ群 出典:https://pytorch.org/docs/stable/generated/torch.nn.CrossEntropyLoss.html PyTorch公式リファレンス 引数のlabels部はインデックス箇所が1 のone-hotベクトルが生成される labels=[0,1,2,...BATCH_SIZE-1] 正例ぺアのsoftmaxを1に他を0に 近づけるようなloss関数となる labels 温度付きcos_sim
14.
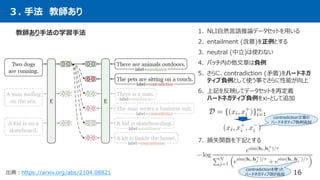
3. 手法 教師あり 教師あり手法の学習手法 16 1.
NLI自然言語推論データセットを用いる 2. entailment (含意)を正例とする 3. neutral (中立)は使わない 4. バッチ内の他文章は負例 5. さらに、contradiction (矛盾)をハードネガ ティブ負例として使う事でさらに性能が向上 6. 上記を反映してデータセットを再定義 ハードネガティブ負例をxi-として追加 7. 損失関数を下記とする contradictionを使った ハードネガティブ項が追加 contradiction文章の ハードネガティブ負例追加 出典:https://arxiv.org/abs/2104.08821
15.
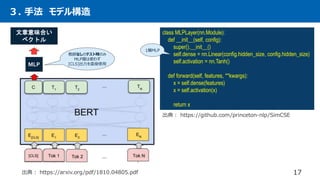
3. 手法 モデル構造 17 出典:
https://arxiv.org/pdf/1810.04805.pdf MLP 教師なしのテスト時のみ MLP層は使わず [CLS]出力を直接使用 文章意味合い ベクトル class MLPLayer(nn.Module): def __init__(self, config): super().__init__() self.dense = nn.Linear(config.hidden_size, config.hidden_size) self.activation = nn.Tanh() def forward(self, features, **kwargs): x = self.dense(features) x = self.activation(x) return x 1層MLP 出典: https://github.com/princeton-nlp/SimCSE
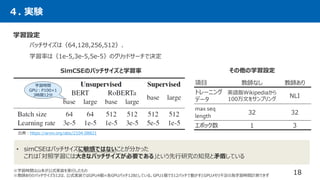
16.
学習設定 18 4. 実験 バッチサイズは{64,128,256,512}、 学習率は{1e-5,3e-5,5e-5}のグリッドサーチで決定 SimCSEのバッチサイズと学習率 • simCSEはバッチサイズに敏感ではないことが分かった これは「対照学習には大きなバッチサイズが必要である」という先行研究の知見と矛盾している 項目
教師なし 教師あり トレーニング データ 英語版Wikipediaから 100万文をサンプリング NLI max seq length 32 32 エポック数 1 3 その他の学習設定 学習時間 GPU:P100×1 3時間12分 ※学習時間は山本が公式実装を実行したもの ※教師ありのバッチサイズ512は、公式実装ではGPU4個×各GPUバッチ128としている。GPU1個で512バッチで動かすとGPUメモリ不足の為学習時間計測できず 出典:https://arxiv.org/abs/2104.08821
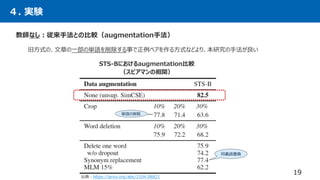
17.
教師なし:従来手法との比較(augmentation手法) 19 4. 実験 旧方式の、文章の一部の単語を削除する事で正例ペアを作る方式などより、本研究の手法が良い STS-Bにおけるaugmentation比較 (スピアマンの相関) 同義語置換 単語の削除 出典:https://arxiv.org/abs/2104.08821
18.
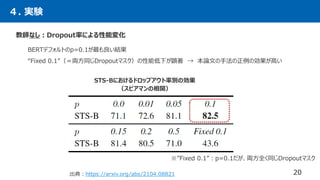
教師なし:Dropout率による性能変化 20 4. 実験 BERTデフォルトのp=0.1が最も良い結果 “Fixed 0.1”(=両方同じDropoutマスク)の性能低下が顕著
→ 本論文の手法の正例の効果が高い STS-Bにおけるドロップアウト率別の効果 (スピアマンの相関) ※”Fixed 0.1”:p=0.1だが、両方全く同じDropoutマスク 出典:https://arxiv.org/abs/2104.08821
19.
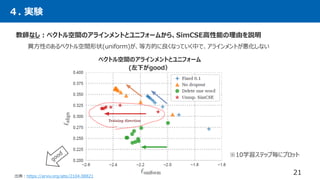
教師なし:ベクトル空間のアラインメントとユニフォームから、SimCSE高性能の理由を説明 21 4. 実験 異方性のあるベクトル空間形状(uniform)が、等方的に良くなっていく中で、アラインメントが悪化しない ※10学習ステップ毎にプロット ベクトル空間のアラインメントとユニフォーム (左下がgood) 出典:https://arxiv.org/abs/2104.08821
20.
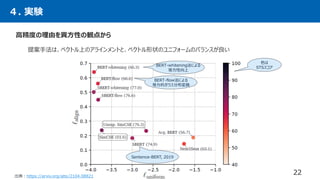
高精度の理由を異方性の観点から 22 4. 実験 提案手法は、ベクトル上のアラインメントと、ベクトル形状のユニフォームのバランスが良い BERT-flow法による 等方的ガウス分布変換 Sentence-BERT, 2019 BERT-whitening法による 等方性向上 色は STSスコア 出典:https://arxiv.org/abs/2104.08821
21.
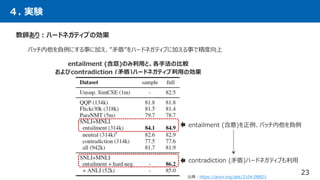
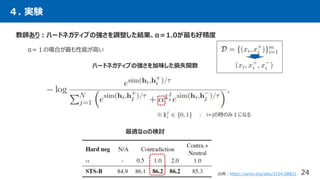
教師あり:ハードネガティブの効果 23 4. 実験 バッチ内他を負例にする事に加え、”矛盾”をハードネガティブに加える事で精度向上 entailment (含意)のみ利用と、各手法の比較 およびcontradiction
(矛盾)ハードネガティブ利用の効果 entailment (含意)を正例、バッチ内他を負例 contradiction (矛盾)ハードネガティブも利用 出典:https://arxiv.org/abs/2104.08821
22.
教師あり:ハードネガティブの強さを調整した結果、α=1.0が最も好精度 24 4. 実験 α=1の場合が最も性能が高い ハードネガティブの強さを加味した損失関数 ※ :
i=jの時のみ1になる 最適なαの検討 出典:https://arxiv.org/abs/2104.08821
23.
25 4. 実験 結果まとめ 教師なし:BERT:SOTA 教師なし:RoBERTa:SOTA 教師あり:BERT:SOTA 教師あり:RoBERTa:SOTA +4.2% +2.2% 出典:https://arxiv.org/abs/2104.08821
24.
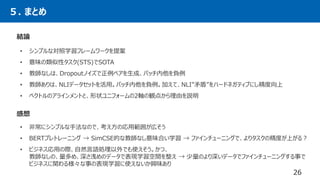
5. まとめ 結論 • シンプルな対照学習フレームワークを提案 •
意味の類似性タスク(STS)でSOTA • 教師なしは、Dropoutノイズで正例ペアを生成、バッチ内他を負例 • 教師ありは、NLIデータセットを活用。バッチ内他を負例。加えて、NLI”矛盾”をハードネガティブにし精度向上 • ベクトルのアラインメントと、形状ユニフォームの2軸の観点から理由を説明 26 感想 • 非常にシンプルな手法なので、考え方の応用範囲が広そう • BERTプレトレーニング → SimCSE的な教師なし意味合い学習 → ファインチューニングで、よりタスクの精度が上がる? • ビジネス応用の際、自然言語処理以外でも使えそう。かつ、 教師なしの、量多め、深さ浅めのデータで表現学習空間を整え → 少量のより深いデータでファインチューニングする事で ビジネスに関わる様々な事の表現学習に使えないか興味あり