© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
Junpei Ozono, Redshift Specialist Solution Architect
Amazon Web Services K. K.
2018.10.05
Amazon Redshift
パフォーマンスチューニングテクニ
ックと最新アップデート
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
2
自己紹介
大薗 純平(おおぞの じゅんぺい)
Redshift Specialist Solution Architect
経歴:
• DWH/BI/Big Data系エンジニア
• 列指向DBアーキテクト
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
3
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
4
AWS の Analytics サービス
インサイト
分析
データレイク
データ移行
QuickSight SageMaker
Glue
(ETL & Data Catalog)
S3/Glacier
(Storage)
Redshift EMR Athena
Elasticsearch Service Kinesis Data Analytics
Database Migration Service | Snowball | Snowmobile | Kinesis Data Firehose | Kinesis Data Streams
Real-time
Comprehend
DW Big data processing Interactive
Rekognition
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
5
アジェンダ
• Amazon Redshift 概要とアーキテクチャ
• Amazon Redshift パフォーマンスチューニングのポイント
• Amazon Redshift 最新アップデート
• まとめ
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
6
Amazon Redshift
概要とアーキテクチャ
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
7
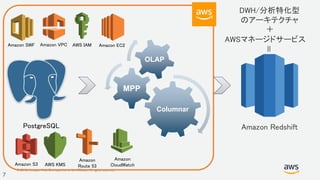
PostgreSQL
Columnar
MPP
OLAP
AWS IAMAmazon VPCAmazon SWF
Amazon S3 AWS KMS
Amazon
Route 53
Amazon
CloudWatch
Amazon EC2
Amazon Redshift
AWSマネージドサービス
DWH/分析特化型
のアーキテクチャ
+
=
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
8
Amazon Redshift
アーキテクチャ
クエリ
SELECT COUNT(*)
FROM S3.EXT_TABLE
GROUP BY …
Amazon
Redshift
JDBC/ODBC
AWS Glue
データカタログ
Amazon S3
エクサバイトスケールの
オブジェクトストレージ
Redshift Spectrum
スケールアウト型
サーバレスコンピューティング
Redshift
リーダーノード:クエリのエンドポイント
コンピュートノード:クエリの実行エンジン+データ
ストレージ
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
9
Amazon Redshift
アーキテクチャ
Amazon
Redshift
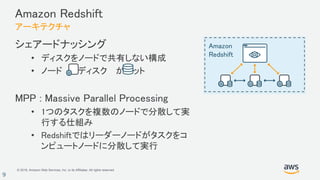
シェアードナッシング
• ディスクをノードで共有しない構成
• ノード  とディスク  がセット
MPP : Massive Parallel Processing
• 1つのタスクを複数のノードで分散して実
行する仕組み
• Redshiftではリーダーノードがタスクをコ
ンピュートノードに分散して実行
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
10
Amazon Redshift
アーキテクチャ
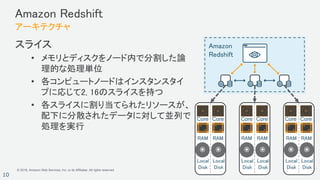
スライス
• メモリとディスクをノード内で分割した論
理的な処理単位
• 各コンピュートノードはインスタンスタイ
プに応じて2, 16のスライスを持つ
• 各スライスに割り当てられたリソースが、
配下に分散されたデータに対して並列で
処理を実行
Core
RAM
Local
Disk
RAM RAM RAM RAM RAM
Core Core Core Core Core
Local
Disk
Local
Disk
Local
Disk
Local
Disk
Local
Disk
Amazon
Redshift
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
11
Amazon Redshift
アーキテクチャ
• SSDベースのDC2とHDDベースのDS2から選択
• データは圧縮格納されるため、ストレージ総量より多くのデータが格納可能
• 最大128ノード:2ペタバイトまで拡張可能
• クラスタータイプとノード数は後から変更可能
DC2 - Dense Compute
vCPU メモリ(GB) ストレージ スライス ノード数 価格(※)
dc2.large 2 15 0.16TB NVMe SSD 2 1~32 $0.314 /1時間
dc2.8xlarge 32 244 2.56TB NVMe SSD 16 2~128 $6.095 /1時間
DS2 – Dense Storage
ds2.xlarge 4 31 2TB HDD 2 1~32 $1.190 /1時間
ds2.8xlarge 36 244 16TB HDD 16 2~128 $9.520 /1時間
※価格は東京リージョンにおいて2018年10月時点のものです
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
12
Amazon Redshift
アーキテクチャ
Amazon
Redshift
Amazon
Redshift
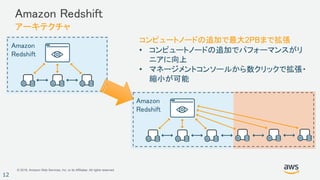
コンピュートノードの追加で最大2PBまで拡張
• コンピュートノードの追加でパフォーマンスがリ
ニアに向上
• マネージメントコンソールから数クリックで拡張・
縮小が可能
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
13
Amazon Redshift
アーキテクチャ
Spectrum
• 事前のデータロード不要で、S3上のデー
タに対して直接 SQL を実行
• Redshift と S3 それぞれに存在するデー
タを結合可能
• オープンファイルフォーマット対応
(Parquet, ORC, JSON, Grok, Avro, およ
びCSV等)
• スキャンしたデータ量(圧縮後サイズ)の
みの課金制
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
14
Amazon Redshift
アーキテクチャ
Redshift はDWH/分析特化型のアーキテクチャ
処理の並列分散とスケールアウトにより大容量データに対する
分析ワークロードを高速に処理
アーキテクチャや機能を踏まえたパフォーマンスチューニング
により、さらに快適な環境を作っていくことが可能
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
15
Amazon Redshift における
パフォーマンスチューニング
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
16
DWH/分析基盤におけるワークロードの特徴
多くのデータを読み込む
• 多くのディスクIOを伴う
複数のジョインやサブクエリを駆使しつつ、集計を行う
• 中間作業を含め、多くのリソースを必要とする
とはいえ、シンプルな集計や小規模データへの照会も存在
• 応答速度が求められる、ショートクエリと呼ばれるような処理
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
17
Redshift パフォーマンスチューニングのポイント
ディスクIOを削減する
• まずは読み出す範囲・サイズをいかに減らせるか
ノード間通信を削減する
• 通信しないようなデータ配置
クエリごとに必要なリソースを適切に割り当てる
• メモリ資源を効率的に利用
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
18
Redshift パフォーマンスチューニングのポイント
ディスクIOを削減する
• まずは読み出す範囲・サイズをいかに減らせるか
ノード間通信を削減する
• 通信しないようなデータ配置
クエリごとに必要なリソースを適切に割り当てる
• メモリ資源を効率的に利用
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
19
ディスク IO を削減する
列指向ストレージ
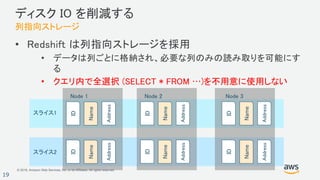
• Redshift は列指向ストレージを採用
• データは列ごとに格納され、必要な列のみの読み取りを可能にす
る
• クエリ内で全選択 (SELECT * FROM …)を不用意に使用しない
Node 2 Node 3
NameName
IDID
AddressAddress
NameName
IDID
AddressAddress
スライス1
スライス2
NameName
IDID
AddressAddress
Node 1
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
20
ディスク IO を削減する
データ圧縮
• 列の圧縮を行うことで、一度のディスクアクセスで読み込め
るデータ量が多くなり、速度の向上が見込める
• 圧縮のエンコード (アルゴリズム) が複数用意されており、
CREATE TABLEで各列に選択することが可能
• エンコードタイプ変更したいときには、テーブル再作成&
INSERT-SELECTで対応
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
21
圧縮エンコーディングの選び方
• ANALYZE COMPRESSION コマンドで推奨を確認する
ANALYZE COMPRESSION <テーブル名>;
• 先にデータの投入が必要
• ZSTDが選択される率が高い
• 選択に迷ったらまずはZSTDまたはLZO
• ZSTDは圧縮率が高く容量削減に有効であるケースが多いが、ク
エリ実行時の圧縮展開のオーバーヘッド(CPU負荷)が高め
• LZOは逆に圧縮率はZSTDに劣るが、パフォーマンス面では優れ
ているケースも
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
22
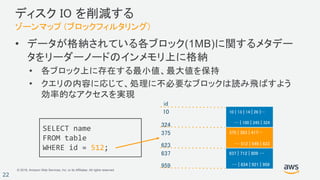
• データが格納されている各ブロック(1MB)に関するメタデー
タをリーダーノードのインメモリ上に格納
• 各ブロック上に存在する最小値、最大値を保持
• クエリの内容に応じて、処理に不必要なブロックは読み飛ばすよう
効率的なアクセスを実現
ディスク IO を削減する
ゾーンマップ (ブロックフィルタリング)
10 | 13 | 14 | 26 |…
… | 100 | 245 | 324
375 | 393 | 417…
… 512 | 549 | 623
637 | 712 | 809 …
… | 834 | 921 | 959
10
324
375
623
637
959
SELECT name 
FROM table
WHERE id = 512;
id
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
23
• ゾーンマップ機能を活用して ディスク IO を削減し、クエリ
パフォーマンスを向上させるため、データソートは重要なポ
イント
• データをどの列順にソートするかを、テーブルごとにソート
キーとして指定
• 頻繁に使われる絞り込み(WHERE句)条件キーが筆頭候補
• 一般的には日付などの時系列やIDが多い
• 実際のクエリパターンと処理優先度などから決定
ソートキー
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
24
ディスク IO の削減
ゾーンマップによる範囲限定スキャン
SELECT count(*) FROM deep_dive WHERE dt = '06-09-2018';
MIN: 01-JUNE-2018
MAX: 06-JUNE-2018
MIN: 07-JUNE-2018
MAX: 12-JUNE-2018
MIN: 13-JUNE-2018
MAX: 21-JUNE-2018
MIN: 21-JUNE-2018
MAX: 30-JUNE-2018
date列でソートされたテーブル
MIN: 01-JUNE-2018
MAX: 20-JUNE-2018
MIN: 08-JUNE-2018
MAX: 30-JUNE-2018
MIN: 12-JUNE-2018
MAX: 20-JUNE-2018
MIN: 02-JUNE-2018
MAX: 25-JUNE-2018
未ソートテーブル
データがソートされている場合、ピンポ
イントで必要なブロックに到達できる
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
25
ディスクIOを削減する
列サイズは可能な限り最小限に留める
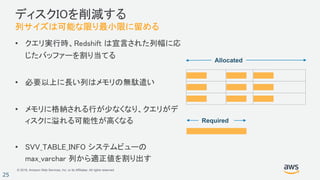
• クエリ実行時、Redshift は宣言された列幅に応
じたバッファーを割り当てる
• 必要以上に長い列はメモリの無駄遣い
• メモリに格納される行が少なくなり、クエリがデ
ィスクに溢れる可能性が高くなる
• SVV_TABLE_INFO システムビューの
max_varchar 列から適正値を割り出す
Allocated
Required
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
26
ディスクIOを削減する
まとめ
• 列指向ストレージの利点を最大限活かすため、SQLクエリに
は必要な列のみを使用
• テーブルの各列には圧縮エンコードタイプを指定
• ANALYZE COMPERESSIONの推奨値、ZSTD or LZO から検討
• 第一ソートキーは 圧縮しない
• ゾーンマップを効かせるため、ソートキーの指定を検討
• 頻繁に絞り込みに使用する列を先頭に
• 列サイズは可能な限り最小限に留める
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
27
Redshift パフォーマンスチューニングのポイント
ディスクIOを削減する
• まずは読み出す範囲・サイズをいかに減らせるか
ノード間通信を削減する
• 通信しないようなデータ配置
クエリごとに必要なリソースを適切に割り当てる
• メモリ資源を効率的に利用
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
28
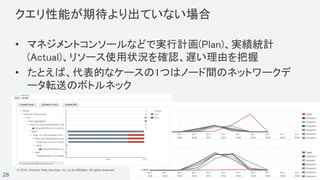
クエリ性能が期待より出ていない場合
• マネジメントコンソールなどで実行計画(Plan)、実績統計
(Actual)、リソース使用状況を確認、遅い理由を把握
• たとえば、代表的なケースの1つはノード間のネットワークデ
ータ転送のボトルネック
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
29
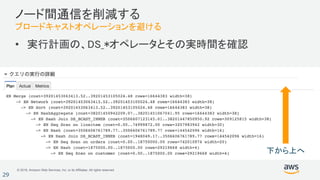
ノード間通信を削減する
ブロードキャストオペレーションを避ける
• 実行計画の、DS_*オペレータとその実時間を確認
下から上へ
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
30
ノード間通信を削減する
ブロードキャストオペレーションを避ける
• 実行計画の、DS_*オペレータとその実時間を確認
DS_BCAST_INNER により、ジョイン時の
内部表が全ノードにブロードキャストさ
れていることが分かる
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
31
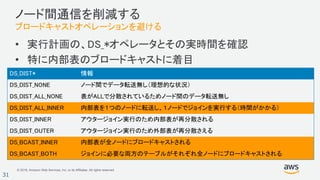
ノード間通信を削減する
ブロードキャストオペレーションを避ける
• 実行計画の、DS_*オペレータとその実時間を確認
• 特に内部表のブロードキャストに着目
DS_DIST* 情報
DS_DIST_NONE ノード間でデータ転送無し(理想的な状況)
DS_DIST_ALL_NONE 表がALLで分散されているためノード間のデータ転送無し
DS_DIST_ALL_INNER 内部表を1つのノードに転送し、1ノードでジョインを実行する(時間がかかる)
DS_DIST_INNER アウタージョイン実行のため内部表が再分散される
DS_DIST_OUTER アウタージョイン実行のため外部表が再分散さえる
DS_BCAST_INNER 内部表が全ノードにブロードキャストされる
DS_BCAST_BOTH ジョインに必要な両方のテーブルがそれぞれ全ノードにブロードキャストされる
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
32
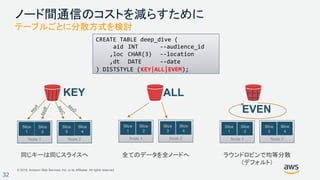
ノード間通信のコストを減らすために
テーブルごとに分散方式を検討
同じキーは同じスライスへ 全てのデータを全ノードへ ラウンドロビンで均等分散
(デフォルト)
KEY
Node 1
Slice
1
Slice
2
Node 2
Slice
3
Slice
4
keyA
keyB
keyC
keyD
Node 1
Slice
1
Slice
2
Node 2
Slice
3
Slice
4
EVEN
ALL
Node 1
Slice
1
Slice
2
Node 2
Slice
3
Slice
4
CREATE TABLE deep_dive (
     aid  INT  --audience_id
    ,loc  CHAR(3)  --location
    ,dt  DATE --date
) DISTSTYLE (KEY|ALL|EVEM);
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
33
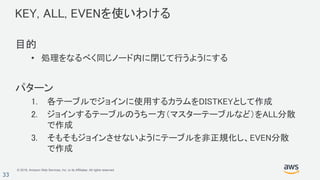
KEY, ALL, EVENを使いわける
目的
• 処理をなるべく同じノード内に閉じて行うようにする
パターン
1. 各テーブルでジョインに使用するカラムをDISTKEYとして作成
2. ジョインするテーブルのうち一方(マスターテーブルなど)をALL分散
で作成
3. そもそもジョインさせないようにテーブルを非正規化し、EVEN分散
で作成
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
34
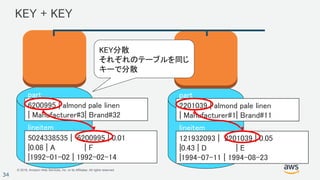
KEY + KEY
6200995 | almond pale linen
| Manufacturer#3| Brand#32
part
lineitem
5024338535 | 6200995 | 0.01
|0.08 | A | F
|1992-01-02 | 1992-02-14
2201039 | almond pale linen
| Manufacturer#1| Brand#11
part
lineitem
121932093 | 2201039 | 0.05
|0.43 | D | E
|1994-07-11 | 1994-08-23
KEY分散
それぞれのテーブルを同じ
キーで分散
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
35
ALL + KEY/EVEN
part
lineitem
part
lineitem
l_partkey   l_partkey
p_partkey p_partkey
ALL分散
更新:全ノードにレプリケーション
クエリー:ジョインはローカルで完結
KEYもしくは
EVENで分散
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
36
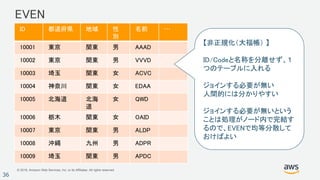
EVEN
ID 都道府県 地域 性
別
名前 …
10001 東京 関東 男 AAAD
10002 東京 関東 男 VVVD
10003 埼玉 関東 女 ACVC
10004 神奈川 関東 女 EDAA
10005 北海道 北海
道
女 QWD
10006 栃木 関東 女 OAID
10007 東京 関東 男 ALDP
10008 沖縄 九州 男 ADPR
10009 埼玉 関東 男 APDC
【非正規化(大福帳) 】
ID/Codeと名称を分離せず、1
つのテーブルに入れる
ジョインする必要が無い
人間的には分かりやすい
ジョインする必要が無いという
ことは処理がノード内で完結す
るので、EVENで均等分散して
おけばよい
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
37
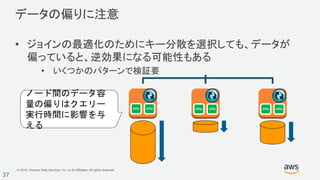
データの偏りに注意
• ジョインの最適化のためにキー分散を選択しても、データが
偏っていると、逆効果になる可能性もある
• いくつかのパターンで検証要
CPU CPU CPU CPU CPU CPU
ノード間のデータ容
量の偏りはクエリー
実行時間に影響を与
える
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
38
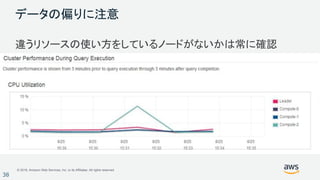
データの偏りに注意
違うリソースの使い方をしているノードがないかは常に確認
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
39
ノード間通信を削減する
まとめ
• 分散システムのため、ノード間通信によるネットワークボトル
ネックは注意を払うポイントの一つ
• 実行計画、実行統計、リソース状況をモニターし、DS_*オペ
レータの有無をチェック
• ノード間通信の発生を極力抑えるために適切なデータの分
散方式を検討
• データの偏りにも注意
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
40
Redshift パフォーマンスチューニングのポイント
ディスクIOを削減する
• まずは読み出す範囲・サイズをいかに減らせるか
ノード間通信を削減する
• 通信しないようなデータ配置
クエリごとに必要なリソースを適切に割り当てる
• メモリ資源を効率的に利用
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
41
クエリごとに必要なリソースを適切に割り当てる
WLMによる実行の制御:キューとスロット
長期実行されるクエリーは、短期実行クエリーをキュー内に待たせること
がある
想定されないパフォーマンス劣化により、ユーザー・エクスペリエンスが
下がる可能性がある
デフォルトでは、Redshiftクラスタは単一のキューで構成されている
RunningDefault queue
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
42
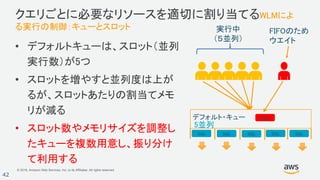
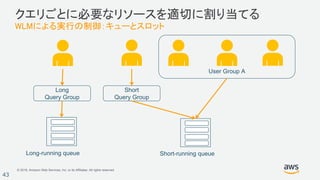
クエリごとに必要なリソースを適切に割り当てるWLMによ
る実行の制御:キューとスロット
• デフォルトキューは、スロット(並列
実行数)が5つ
• スロットを増やすと並列度は上が
るが、スロットあたりの割当てメモ
リが減る
• スロット数やメモリサイズを調整し
たキューを複数用意し、振り分け
て利用する
SQL
デフォルト・キュー
実行中
(5並列)
FIFOのため
ウエイト
SQL SQL SQL SQL
5並列
SQL
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
43
クエリごとに必要なリソースを適切に割り当てる
WLMによる実行の制御:キューとスロット
User Group A
Short-running queue
Short
Query Group
Long-running queue
Long
Query Group
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
44
クエリごとに必要なリソースを適切に割り当てる
WLM クエリキューホッピングの活用
• WLMのクエリキューホッピングは、多くのケースで効果が見
込まれる有効な選択肢
• クエリキューホッピングとは
• クエリのふるまい (実行時間、リソース使用率、スキャン行数など)
に応じて、自動的に次に条件マッチするキューにクエリーを投入
する機能
• 時間がかかり過ぎるクエリをインタラクティブなクエリから切り離
し、別キューでゆっくり実行させる事が可能
• クライアントにはエラーは返却されずに、次のキューに自動で再
投入
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
45
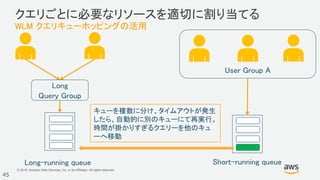
クエリごとに必要なリソースを適切に割り当てる
WLM クエリキューホッピングの活用
User Group A
Short-running queueLong-running queue
Long
Query Group
キューを複数に分け、タイムアウトが発生
したら、自動的に別のキューにて再実行。
時間が掛かりすぎるクエリーを他のキュ
ーへ移動
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
46
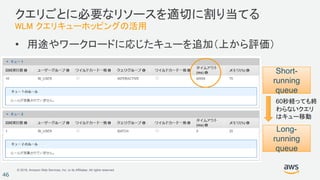
クエリごとに必要なリソースを適切に割り当てる
WLM クエリキューホッピングの活用
• 用途やワークロードに応じたキューを追加(上から評価)
Short-
running
queue
Long-
running
queue
60秒経っても終
わらないクエリ
はキュー移動
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
47
Query Monitoring Rules (QMR)
クエリに関するルールを25まで作成し、その
ルールに違反したクエリへのアクションが定
義可能に
ルール:CPU利用率、CPU時間、ブロック読み
取り数、ジョイン対象行数等多数
アクション:LOG(記録)、HOP(別キューに転
送)、ABORT(停止)
例)ジョイン対象の行数が10億行を超える場
合はキューをホッピング
例)CPUを80%以上消費した状態が10分(600
秒)以上続いたクエリはABORTする
https://aws.amazon.com/jp/about-aws/whats-new/2017/04/amazon-redshift-announces-query-monitoring-
rules-qmr-a-new-feature-that-automates-workload-management-and-a-new-function-to-calculate-percentiles/
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
48
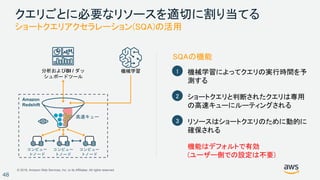
クエリごとに必要なリソースを適切に割り当てる
ショートクエリアクセラレーション(SQA)の活用
機械学習 機械学習によってクエリの実行時間を予
測する
1
ショートクエリと判断されたクエリは専用
の高速キューにルーティングされる
2
リソースはショートクエリのために動的に
確保される
3
SQAの機能
分析およびBI / ダッ
シュボードツール
コンピュー
トノード
コンピュー
トノード
コンピュー
トノード
Amazon
Redshift
高速キュー
機能はデフォルトで有効
(ユーザー側での設定は不要)
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
49
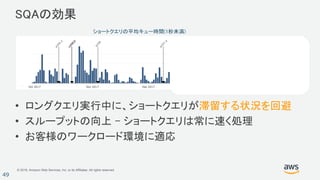
SQAの効果
• ロングクエリ実行中に、ショートクエリが滞留する状況を回避
• スループットの向上 – ショートクエリは常に速く処理
• お客様のワークロード環境に適応
ショートクエリの平均キュー時間(1秒未満)
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
50
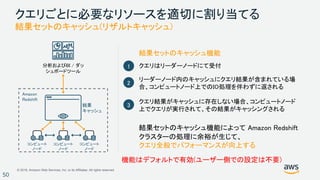
クエリごとに必要なリソースを適切に割り当てる
結果セットのキャッシュ(リザルトキャッシュ)
クエリはリーダーノードにて受付1
リーダーノード内のキャッシュにクエリ結果が含まれている場
合、コンピュートノード上でのIO処理を伴わずに返される
2
クエリ結果がキャッシュに存在しない場合、コンピュートノード
上でクエリが実行されて、その結果がキャッシングされる
3
結果セットのキャッシュ機能
結果セットのキャッシュ機能によって Amazon Redshift
クラスターの処理に余裕が生じて、
クエリ全般でパフォーマンスが向上するコンピュート
ノード
コンピュート
ノード
コンピュート
ノード
分析およびBI / ダッ
シュボードツール
Amazon
Redshift
結果
キャッシュ
機能はデフォルトで有効(ユーザー側での設定は不要)
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
51
結果セットのキャッシュの効果
• Amazon Redshiftを使用しているお客様では、ノードタイプや
構成を変えずに、クエリの処理量が平均で35%増加
• 1日あたり数万倍の計算時間が解放され、リソースを他のク
エリやデータ取り込みの処理に割り当てることが可能に
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
52
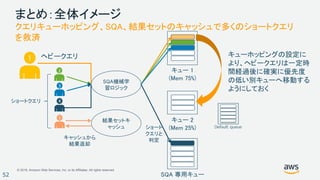
まとめ:全体イメージ
クエリキューホッピング、SQA、結果セットのキャッシュで多くのショートクエリ
を救済
キュー 1
(Mem 75%)
キュー 2
(Mem 25%)
SQA 専用キュー
1
2
3
4
SQA機械学
習ロジック
5
結果セットキ
ャッシュ
ヘビークエリ キューホッピングの設定に
より、ヘビークエリは一定時
間経過後に確実に優先度
の低い別キューへ移動する
ようにしておく
ショートクエリ
ショート
クエリと
判定キャッシュから
結果返却
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
53
Redshift 最新アップデート
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
54
継続的なパフォーマンス改善
常に進化を続けるRedshift
2013年
2018年
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
55
Redshift 機能の最新アップデート
リリース
月
概要
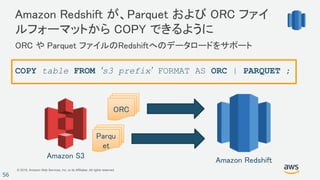
2018.6 Amazon Redshift が、Parquet および ORC ファイル
フォーマットから COPY できるように
2018.7 Amazon Redshift が Advisor 機能をリリース
2018.8 Amazon Redshift が、Redshift Spectrum を用いたネ
スト化されたデータへのサポートを発表
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
56
Amazon Redshift が、Parquet および ORC ファイ
ルフォーマットから COPY できるように
ORC や Parquet ファイルのRedshiftへのデータロードをサポート
COPY table FROM ‘s3 prefix’ FORMAT AS ORC | PARQUET ;
Amazon S3
Amazon Redshift
ORC
Parqu
et
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
57
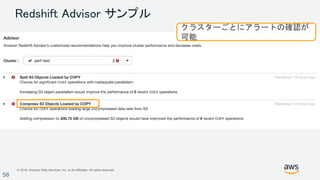
Amazon Redshift が Advisor 機能をリリース
• Redshift が自動でクラスターパフォーマンスや使用状況のメ
トリックを分析し、パフォーマンスの最適化や運用コストの削
減のためのリコメンデーションを提供
• マネージメントコンソール上 Advisor ペインより確認可能
• 提供されるリコメンデーションは、以下の7つの項目
1. テーブルデータが適切に圧縮されているか
2. COPYコマンドにてロードされるS3オブジェクトが適切に圧縮されているか
3. 複数のアクティブデータベースをクラスター隔離できるか
4. WLMのメモリ割り当ては適切か
5. COPY実行中に不要な圧縮分析がされていないか
6. COPYコマンドにてロードされるS3オブジェクトが適切に分割されているか
7. テーブル統計情報が正確か
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
58
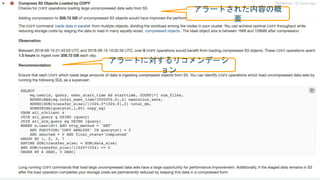
Redshift Advisor サンプル
クラスターごとにアラートの確認が
可能
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
59
アラートされた内容の概
要
アラートに対するリコメンデーシ
ョン
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
Amazon Redshift が、Redshift Spectrum を用いた
ネスト化されたデータへのサポートを発表
• ネスト化された半構造化データを、Redshift Spectrumの外
部表として指定することが可能に
• オープンファイルフォーマットをサポート: Parquet, ORC,
JSON, Ion
• サポートするComplex Data Type : struct, array, map
• 既存のSQLを拡張し、ネスト構造をドット表記で表現
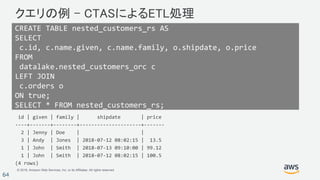
• CTASを用いて、ネスト化されたデータのETL (Redshift
Localテーブルへロード)が容易に
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
61
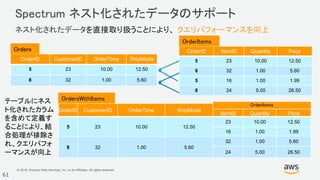
Spectrum ネスト化されたデータのサポート
ネスト化されたデータを直接取り扱うことにより、 クエリパフォーマンスを向上
OrderID CustomerID OrderTime ShipMode
5 23 10.00 12.50
8 32 1.00 5.60
OrdersWithItems
ItemID Quantity Price
23 10.00 12.50
16 1.00 1.99
32 1.00 5.60
24 5.00 26.50
OrderItems
OrderID ItemID Quantity Price
5 23 10.00 12.50
8 32 1.00 5.60
5 16 1.00 1.99
8 24 5.00 26.50
OrderID CustomerID OrderTime ShipMode
5 23 10.00 12.50
8 32 1.00 5.60
Orders
OrderItems
テーブルにネス
ト化されたカラム
を含めて定義す
ることにより、結
合処理が排除さ
れ、クエリパフォ
ーマンスが向上
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
62
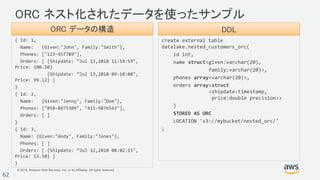
ORC ネスト化されたデータを使ったサンプル
{ Id: 1,
  Name:   {Given:"John", Family:"Smith"},
  Phones: ["123-457789"],
  Orders: [ {Shipdate: ”Jul 12,2018 11:59:59", 
Price: 100.50}
            {Shipdate: ”Jul 13,2018 09:10:00", 
Price: 99.12} ]
}
{ Id: 2,
  Name:   {Given:"Jenny", Family:"Doe"},
  Phones: ["858-8675309", "415-9876543"],
  Orders: [ ] 
}
{ Id: 3,
  Name: {Given:"Andy", Family:"Jones"},
  Phones: [ ]
  Orders: [ {Shipdate: ”Jul 12,2018 08:02:15", 
Price: 13.50} ] 
}
 
create external table 
datalake.nested_customers_orc(
    id int,
    name struct<given:varchar(20), 
                family:varchar(20)>, 
    phones array<varchar(20)>,
    orders array<struct
                <shipdate:timestamp,
                 price:double precision>>
    ) 
    STORED AS ORC
    LOCATION 's3://mybucket/nested_orc/'
;
ORC データの構造 DDL
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
63
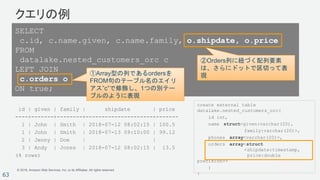
クエリの例
id | given | family | shipdate | price
----+-------+--------+---------------------+-------
1 | John | Smith | 2018-07-12 08:02:15 | 100.5
1 | John | Smith | 2018-07-13 09:10:00 | 99.12
2 | Jenny | Doe | |
3 | Andy | Jones | 2018-07-12 08:02:15 | 13.5
(4 rows)
SELECT
c.id, c.name.given, c.name.family, o.shipdate, o.price
FROM
datalake.nested_customers_orc c
LEFT JOIN
c.orders o
ON true;
①Array型の列であるordersを
FROM句のテーブル名のエイリ
アス”c”で修飾し、1つの別テー
ブルのように表現
②Orders列に紐づく配列要素
は、さらにドットで区切って表
現
create external table
datalake.nested_customers_orc(
id int,
name struct<given:varchar(20),
family:varchar(20)>,
phones array<varchar(20)>,
orders array<struct
<shipdate:timestamp,
price:double
precision>>
)
:
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
64
クエリの例 – CTASによるETL処理
 id | given | family |      shipdate       | price 
----+-------+--------+---------------------+-------
  2 | Jenny | Doe    |                     |      
  3 | Andy  | Jones  | 2018-07-12 08:02:15 |  13.5
  1 | John  | Smith  | 2018-07-13 09:10:00 | 99.12
  1 | John  | Smith  | 2018-07-12 08:02:15 | 100.5
(4 rows)
CREATE TABLE nested_customers_rs AS
SELECT
 c.id, c.name.given, c.name.family, o.shipdate, o.price
FROM
 datalake.nested_customers_orc c 
LEFT JOIN
 c.orders o 
ON true;
SELECT * FROM nested_customers_rs;
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
65
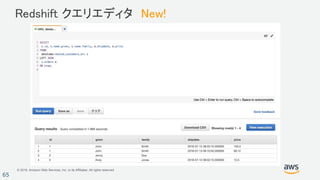
Redshift クエリエディタ New!
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
66
まとめ
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
67
Redshift パフォーマンスチューニングのポイント
ディスクIOを削減する
• 列指向、圧縮、ゾーンマップ(ソートキー)、データ型
ノード間通信を削減する
• ブロードキャストオペレーションを避ける分散方式の検討
クエリごとに必要なリソースを適切に割り当てる
• クエリキューホッピング、SQA、結果セットのキャッシュ
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
68
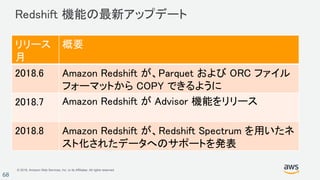
Redshift 機能の最新アップデート
リリース
月
概要
2018.6 Amazon Redshift が、Parquet および ORC ファイル
フォーマットから COPY できるように
2018.7 Amazon Redshift が Advisor 機能をリリース
2018.8 Amazon Redshift が、Redshift Spectrum を用いたネ
スト化されたデータへのサポートを発表
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
69
Amazon Redshift
Thank You!
https://aws.amazon.com/redshift/
© 2018, Amazon Web Services, Inc. or its Affiliates. All rights reserved.
70
参考資料
Amazon Redshift ホームページ
• https://aws.amazon.com/jp/redshift/
Amazon Redshift ドキュメント
• https://aws.amazon.com/jp/documentation/redshift/
Amazon Redshiftフォーラム(Q&Aや新機能の告知) ※要AWSアカウント
• https://forums.aws.amazon.com/forum.jspa?forumID=155
Amazon Redshift Release Notes(新機能、修正等)
• https://aws.amazon.com/releasenotes/Amazon-Redshift
Amazon Redshiftのパフォーマンスチューニングテクニック Top 10
• http://aws.typepad.com/sajp/2015/12/top-10-performance-tuning-techniques-for-amazon-redshift.html
Amazon Redshift Spectrum 10 のベストプラクティス
• https://aws.amazon.com/jp/blogs/news/10-best-practices-for-amazon-redshift-spectrum/
AWS Bigdata Blog
• https://aws.amazon.com/jp/blogs/big-data/
AWS Loft のイベントにご参加ください! #awsloft
9 (火) 18:30~ Machine Learning Night amzn.to/lofttokyo20181009
10 (水) 19:00~ AWS Startup Tech Meetup amzn.to/lofttokyo20181010
16 (火) 14:00~ UB Ventures 竹内氏による amzn.to/lofttokyo20181016
Startup Office Hour
19 (金) 19:00~ Amazon Tech Meetup #01 amzn.to/lofttokyo20181019
~Amazon Pay スペシャル!~
25 (木) 18:30~ [AWS Start-upゼミ] amzn.to/lofttokyo20181025
2018 秋季講習 秋のデモ祭り
26 (金) 18:00~ Code Happy Hour! amzn.to/lofttokyo20181026
AWS DevDay Tokyo 2018 申込受付中
AWS DevDay は、アプリケーション開発を行うデベロッパーの皆様
のための、グローバルテクノロジーイベントです。アプリ開発に関連
するAWSの実践的な情報はもちろん、国内外の事例を通じたベスト
プラクティスを、テクニカルセッション、ハンズオン、ハッカソン、ワー
クショップ、ライトニングトークなど様々な形でお届けします。
2018年10月29日 (月) 〜 11月2日 (金)
アマゾン ウェブ サービス ジャパン (東京・目黒)
https://amzn.to/devday2018
#AWSDev #AWSDevDay