AWSクラウドサービスツアー 
2014/12/17 
AWSサービスの紹介とその利用方法 
@a_hisame
2014/12/17 
Agenda 
● 概要 
● 「仮想マシン以外のクラウドサービス」ツアー 
– 現在AWS Management Consoleからみえるもの 
● AWS re:Invent 2014で発表された新サービス 
● 費用対効果が高いクラウドサービス 
– 実例とサンプルプログラム 
● クラウドサービスを利用したアーキテクチャ設計 
– 基本的な考え方
皆さん、仕事でクラウドを使っていますか? 
2014/12/17
クラウドを利用するといった場合、 
仮想マシンを利用しているだけでもクラウドを利用していると言う事ができます。 
2014/12/17 
クラウド=仮想マシン 
しかし、 
と言ってしまえるほど、 
クラウドの世界は狭くありません。
2014/12/17 
本当に? 
そんなこと言われても、 
仮想マシンだけで便利に仕事できているんだけれど。。。
2014/12/17 
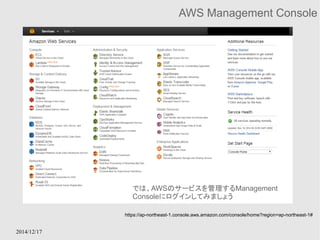
AWS Management Console 
では、AWSのサービスを管理するManagement 
Consoleにログインしてみましょう 
https://ap-northeast-1.console.aws.amazon.com/console/home?region=ap-northeast-1#
2014/12/17 
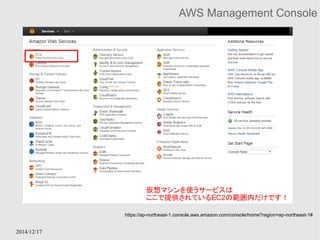
AWS Management Console 
仮想マシンを使うサービスは 
ここで提供されているEC2の範囲内だけです! 
https://ap-northeast-1.console.aws.amazon.com/console/home?region=ap-northeast-1#
知らずに、使っていない 
サービス多すぎ...? 
2014/12/17 
というか、何でそもそもこんなにサービスの数が多いの…?
2014/12/17 
こんなにサービスがあっても... 
● 良くある問題は一般に実装することが面倒くさい 
例: IAM = AWSサービスのユーザ管理 
● AWSサービスのアクセス権限を管理する仕組みを自分で 
作れなくは無いけれど、制御や管理の仕組みが面倒 
例: S3 = 汎用のファイルアップロードサーバー 
● 仮想マシンとボリュームを連携して、その上に例えばウェブ 
ページを構築して、サーバー上のファイル容量に常に気を 
つけて…… 
● AWSの場合「よくある問題」をサービス化し、それ 
を一般ユーザにも(安価に)利用可能にする 
– ユーザはこれらの提供されるサービスを「利用」して、 
新たなサービスを開発することに集中できる 
サービスの数とは言い換えると、 
「こんなのがあればいいのになあ」と考えられた数です。
2014/12/17 
では、どんなサービスがあるのか 
ツアーに出かけましょう!
2014/12/17 
1. 仮想マシンをより上手に 
利用するための仕組み 
注1: ここでは独自のサービスの分類をしています 
注2: サンプルは概念図であり、必ずしも実体と一致するわけではありません
2014/12/17 
Amazon EC2 (Elastic Compute Cloud) 
● 仮想マシンを提供するサービス 
● 仮想マシンに関しては、今回は省略
2014/12/17 
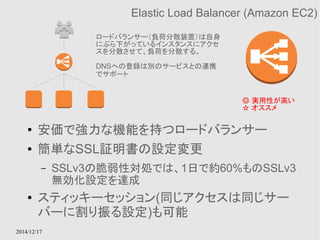
Elastic Load Balancer (Amazon EC2) 
ロードバランサー(負荷分散装置)は自身 
にぶら下がっているインスタンスにアクセ 
スを分散させて、負荷を分散する。 
DNSへの登録は別のサービスとの連携 
でサポート 
◎ 実用性が高い 
☆ オススメ 
● 安価で強力な機能を持つロードバランサー 
● 簡単なSSL証明書の設定変更 
– SSLv3の脆弱性対処では、1日で約60%ものSSLv3 
無効化設定を達成 
● スティッキーセッション(同じアクセスは同じサー 
バーに割り振る設定)も可能
2014/12/17 
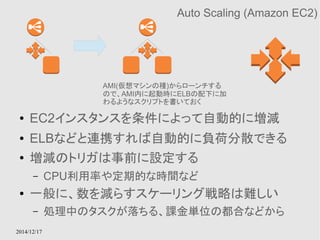
Auto Scaling (Amazon EC2) 
AMI(仮想マシンの種)からローンチする 
ので、AMI内に起動時にELBの配下に加 
わるようなスクリプトを書いておく 
● EC2インスタンスを条件によって自動的に増減 
● ELBなどと連携すれば自動的に負荷分散できる 
● 増減のトリガは事前に設定する 
– CPU利用率や定期的な時間など 
● 一般に、数を減らすスケーリング戦略は難しい 
– 処理中のタスクが落ちる、課金単位の都合などから
VPC subnet VPC subnet 
virtual private cloud ☆ オススメ 
2014/12/17 
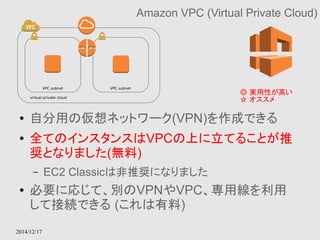
Amazon VPC (Virtual Private Cloud) 
◎ 実用性が高い 
● 自分用の仮想ネットワーク(VPN)を作成できる 
● 全てのインスタンスはVPCの上に立てることが推 
奨となりました(無料) 
– EC2 Classicは非推奨になりました 
● 必要に応じて、別のVPNやVPC、専用線を利用 
して接続できる (これは有料)
2014/12/17 
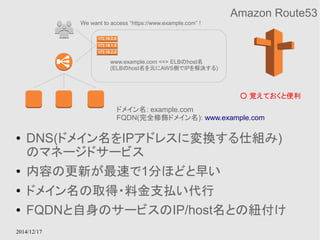
Amazon Route53 
○ 覚えておくと便利 
We want to access “https://www.example.com” ! 
www.example.com <=> ELBのhost名 
(ELBのhost名を元にAWS側でIPを解決する) 
ドメイン名: example.com 
FQDN(完全修飾ドメイン名): www.example.com 
● DNS(ドメイン名をIPアドレスに変換する仕組み) 
のマネージドサービス 
● 内容の更新が最速で1分ほどと早い 
● ドメイン名の取得・料金支払い代行 
● FQDNと自身のサービスのIP/host名との紐付け
2014/12/17 
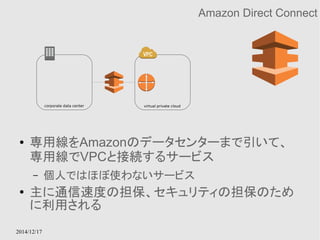
Amazon Direct Connect 
corporate data center virtual private cloud 
● 専用線をAmazonのデータセンターまで引いて、 
専用線でVPCと接続するサービス 
– 個人ではほぼ使わないサービス 
● 主に通信速度の担保、セキュリティの担保のため 
に利用される
2014/12/17 
2. データを読み書きするための仕組み 
補足: SimpleDBというサービスもあったのですが、 
表舞台から消えているので紹介はしません。 
だいたい、DynamoDBに容量制限とスケール制約がある代わりに 
検索の自由度が上がったKVSです。
2014/12/17 
Amazon EBS (Elastic Block Store) 
● 仮想マシンに付随してよく語られているので 
今回は省略
2014/12/17 
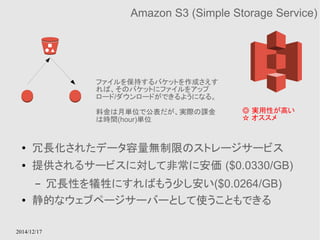
Amazon S3 (Simple Storage Service) 
◎ 実用性が高い 
☆ オススメ 
ファイルを保持するバケットを作成さえす 
れば、そのバケットにファイルをアップ 
ロード/ダウンロードができるようになる。 
料金は月単位で公表だが、実際の課金 
は時間(hour)単位 
● 冗長化されたデータ容量無制限のストレージサービス 
● 提供されるサービスに対して非常に安価 ($0.0330/GB) 
– 冗長性を犠牲にすればもう少し安い($0.0264/GB) 
● 静的なウェブページサーバーとして使うこともできる
2014/12/17 
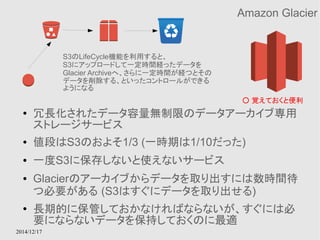
Amazon Glacier 
S3のLifeCycle機能を利用すると、 
S3にアップロードして一定時間経ったデータを 
Glacier Archiveへ、さらに一定時間が経つとその 
データを削除する、といったコントロールができる 
ようになる 
○ 覚えておくと便利 
● 冗長化されたデータ容量無制限のデータアーカイブ専用 
ストレージサービス 
● 値段はS3のおよそ1/3 (一時期は1/10だった) 
● 一度S3に保存しないと使えないサービス 
● Glacierのアーカイブからデータを取り出すには数時間待 
つ必要がある (S3はすぐにデータを取り出せる) 
● 長期的に保管しておかなければならないが、すぐには必 
要にならないデータを保持しておくのに最適
2014/12/17 
Amazon DynamoDB 
◎ 実用性が高い 
☆ オススメ 
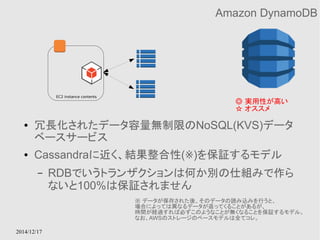
● 冗長化されたデータ容量無制限のNoSQL(KVS)データ 
ベースサービス 
● Cassandraに近く、結果整合性(※)を保証するモデル 
– RDBでいうトランザクションは何か別の仕組みで作ら 
ないと100%は保証されません 
※ データが保存された後、そのデータの読み込みを行うと、 
場合によっては異なるデータが返ってくることがあるが、 
時間が経過すれば必ずこのようなことが無くなることを保証するモデル。 
なお、AWSのストレージのベースモデルは全てコレ。 
EC2 instance contents
EC2 instance contents 
2014/12/17 
Amazon RDS (Relational Database Service) 
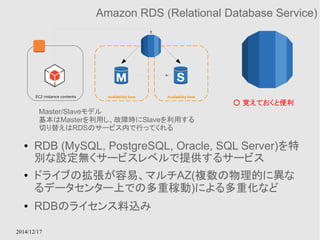
● RDB (MySQL, PostgreSQL, Oracle, SQL Server)を特 
別な設定無くサービスレベルで提供するサービス 
● ドライブの拡張が容易、マルチAZ(複数の物理的に異な 
るデータセンター上での多重稼動)による多重化など 
● RDBのライセンス料込み 
○ 覚えておくと便利 
Availability Zone Availability Zone 
Master/Slaveモデル 
基本はMasterを利用し、故障時にSlaveを利用する 
切り替えはRDSのサービス内で行ってくれる
US Japan 
US User Japan User 
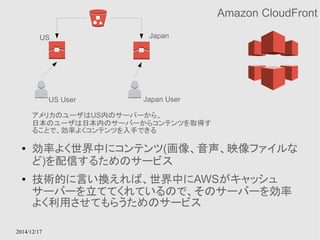
アメリカのユーザはUS内のサーバーから、 
日本のユーザは日本内のサーバーからコンテンツを取得す 
ることで、効率よくコンテンツを入手できる 
2014/12/17 
Amazon CloudFront 
● 効率よく世界中にコンテンツ(画像、音声、映像ファイルな 
ど)を配信するためのサービス 
● 技術的に言い換えれば、世界中にAWSがキャッシュ 
サーバーを立ててくれているので、そのサーバーを効率 
よく利用させてもらうためのサービス
corporate data center 
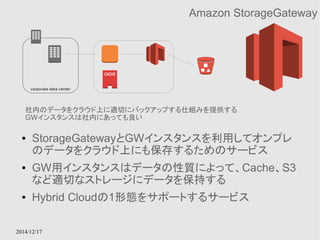
社内のデータをクラウド上に適切にバックアップする仕組みを提供する 
GWインスタンスは社内にあっても良い 
2014/12/17 
Amazon StorageGateway 
● StorageGatewayとGWインスタンスを利用してオンプレ 
のデータをクラウド上にも保存するためのサービス 
● GW用インスタンスはデータの性質によって、Cache、S3 
など適切なストレージにデータを保持する 
● Hybrid Cloudの1形態をサポートするサービス
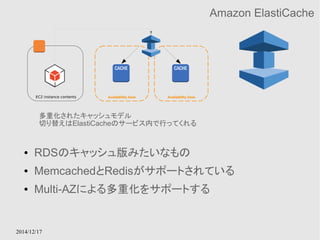
EC2 instance contents Availability Zone Availability Zone 
多重化されたキャッシュモデル 
切り替えはElastiCacheのサービス内で行ってくれる 
2014/12/17 
Amazon ElastiCache 
● RDSのキャッシュ版みたいなもの 
● MemcachedとRedisがサポートされている 
● Multi-AZによる多重化をサポートする
AppStream 
2014/12/17 
Amazon AppStream 
No Images 
(アイコンセット 
での提供がまだ) 
1. モバイルはAppStreamにストリーミングを要求 
2. AppStreamは動的な映像・音声を作成するインスタンスに 
要求を送り、モバイルとインスタンス間にセッションを張る 
3. インスタンスはセッションに対してストリーミング配信を行う 
● 転送先の情報を受け取り、その転送先に対してメディア 
ファイル(音声・映像)の情報をストリーミング形式で送信 
することをサポートするサービス
3. データを連携・転送・分析するための仕組み 
2014/12/17
2014/12/17 
Amazon SQS (Simple Queue Service) 
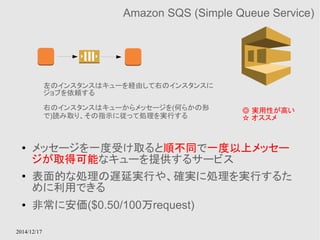
● メッセージを一度受け取ると順不同で一度以上メッセー 
ジが取得可能なキューを提供するサービス 
● 表面的な処理の遅延実行や、確実に処理を実行するた 
めに利用できる 
● 非常に安価($0.50/100万request) 
◎ 実用性が高い 
☆ オススメ 
左のインスタンスはキューを経由して右のインスタンスに 
ジョブを依頼する 
右のインスタンスはキューからメッセージを(何らかの形 
で)読み取り、その指示に従って処理を実行する
2014/12/17 
Amazon SNS (Simple Notification Service) 
◎ 実用性が高い 
☆ オススメ 
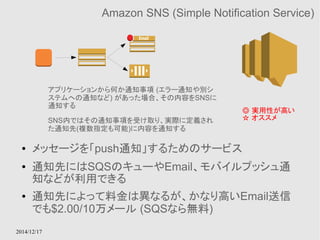
アプリケーションから何か通知事項 (エラー通知や別シ 
ステムへの通知など) があった場合、その内容をSNSに 
通知する 
SNS内ではその通知事項を受け取り、実際に定義され 
た通知先(複数指定も可能)に内容を通知する 
● メッセージを「push通知」するためのサービス 
● 通知先にはSQSのキューやEmail、モバイルプッシュ通 
知などが利用できる 
● 通知先によって料金は異なるが、かなり高いEmail送信 
でも$2.00/10万メール (SQSなら無料)
2014/12/17 
Amazon Kinesis 
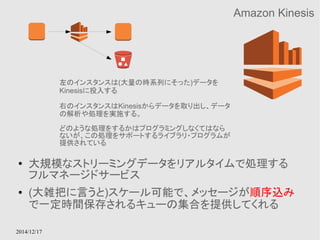
左のインスタンスは(大量の時系列にそった)データを 
Kinesisに投入する 
右のインスタンスはKinesisからデータを取り出し、データ 
の解析や処理を実施する。 
どのような処理をするかはプログラミングしなくてはなら 
ないが、この処理をサポートするライブラリ・プログラムが 
提供されている 
● 大規模なストリーミングデータをリアルタイムで処理する 
フルマネージドサービス 
● (大雑把に言うと)スケール可能で、メッセージが順序込み 
で一定時間保存されるキューの集合を提供してくれる
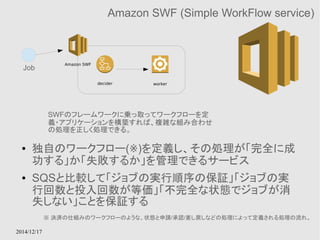
Amazon SWF Job 
2014/12/17 
Amazon SWF (Simple WorkFlow service) 
decider worker 
SWFのフレームワークに乗っ取ってワークフローを定 
義・アプリケーションを構築すれば、複雑な組み合わせ 
の処理を正しく処理できる。 
● 独自のワークフロー(※)を定義し、その処理が「完全に成 
功する」か「失敗するか」を管理できるサービス 
● SQSと比較して「ジョブの実行順序の保証」「ジョブの実 
行回数と投入回数が等価」「不完全な状態でジョブが消 
失しない」ことを保証する 
※ 決済の仕組みのワークフローのような、状態と申請/承認/差し戻しなどの処理によって定義される処理の流れ。
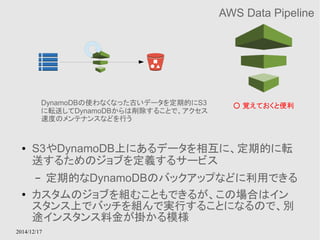
DynamoDBの使わなくなった古いデータを定期的にS3 
に転送してDynamoDBからは削除することで、アクセス 
速度のメンテナンスなどを行う 
2014/12/17 
AWS Data Pipeline 
○ 覚えておくと便利 
● S3やDynamoDB上にあるデータを相互に、定期的に転 
送するためのジョブを定義するサービス 
– 定期的なDynamoDBのバックアップなどに利用できる 
● カスタムのジョブを組むこともできるが、この場合はイン 
スタンス上でバッチを組んで実行することになるので、別 
途インスタンス料金が掛かる模様
2014/12/17 
Amazon Redshift 
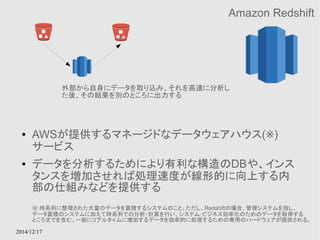
外部から自身にデータを取り込み、それを高速に分析し 
た後、その結果を別のところに出力する 
● AWSが提供するマネージドなデータウェアハウス(※) 
サービス 
● データを分析するためにより有利な構造のDBや、インス 
タンスを増加させれば処理速度が線形的に向上する内 
部の仕組みなどを提供する 
※ 時系列に整理された大量のデータを蓄積するシステムのこと。ただし、Redshiftの場合、管理システムを指し、 
データ蓄積のシステムに加えて時系列での分析・計算を行い、システム・ビジネス効率化のためのデータを取得する 
ところまでを含む。一般にリアルタイムに増加するデータを効率的に処理するための専用のハードウェアが提供される。
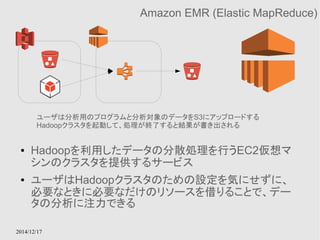
ユーザは分析用のプログラムと分析対象のデータをS3にアップロードする 
Hadoopクラスタを起動して、処理が終了すると結果が書き出される 
2014/12/17 
Amazon EMR (Elastic MapReduce) 
● Hadoopを利用したデータの分散処理を行うEC2仮想マ 
シンのクラスタを提供するサービス 
● ユーザはHadoopクラスタのための設定を気にせずに、 
必要なときに必要なだけのリソースを借りることで、デー 
タの分析に注力できる
2014/12/17 
4. サービスを構築するための仕組み
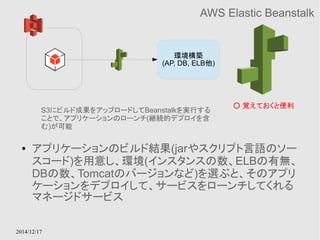
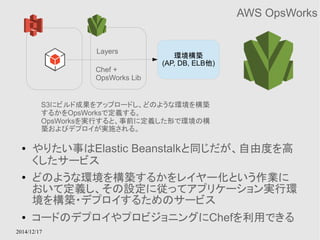
環境構築 
(AP, DB, ELB他) 
S3にビルド成果をアップロードしてBeanstalkを実行する 
ことで、アプリケーションのローンチ(継続的デプロイを含 
む)が可能 
2014/12/17 
AWS Elastic Beanstalk 
○ 覚えておくと便利 
● アプリケーションのビルド結果(jarやスクリプト言語のソー 
スコード)を用意し、環境(インスタンスの数、ELBの有無、 
DBの数、Tomcatのバージョンなど)を選ぶと、そのアプリ 
ケーションをデプロイして、サービスをローンチしてくれる 
マネージドサービス
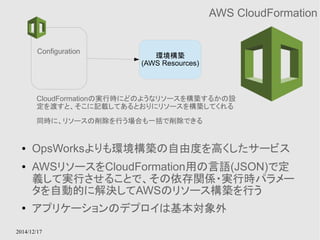
環境構築 
(AP, DB, ELB他) 
Layers 
Chef + 
OpsWorks Lib 
S3にビルド成果をアップロードし、どのような環境を構築 
するかをOpsWorksで定義する。 
OpsWorksを実行すると、事前に定義した形で環境の構 
築およびデプロイが実施される。 
2014/12/17 
AWS OpsWorks 
● やりたい事はElastic Beanstalkと同じだが、自由度を高 
くしたサービス 
● どのような環境を構築するかをレイヤー化という作業に 
おいて定義し、その設定に従ってアプリケーション実行環 
境を構築・デプロイするためのサービス 
● コードのデプロイやプロビジョニングにChefを利用できる
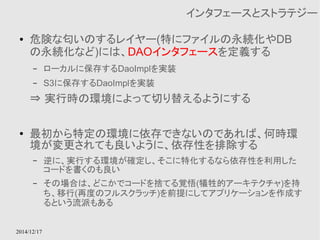
環境構築 
(AWS Resources) 
Configuration 
CloudFormationの実行時にどのようなリソースを構築するかの設 
定を渡すと、そこに記載してあるとおりにリソースを構築してくれる 
同時に、リソースの削除を行う場合も一括で削除できる 
2014/12/17 
AWS CloudFormation 
● OpsWorksよりも環境構築の自由度を高くしたサービス 
● AWSリソースをCloudFormation用の言語(JSON)で定 
義して実行させることで、その依存関係・実行時パラメー 
タを自動的に解決してAWSのリソース構築を行う 
● アプリケーションのデプロイは基本対象外
5. サービスを運用していくための仕組み 
2014/12/17
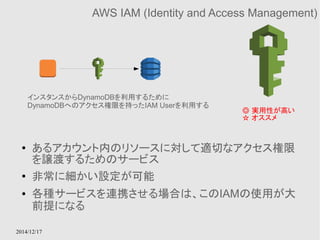
インスタンスからDynamoDBを利用するために 
DynamoDBへのアクセス権限を持ったIAM Userを利用する 
2014/12/17 
AWS IAM (Identity and Access Management) 
◎ 実用性が高い 
☆ オススメ 
● あるアカウント内のリソースに対して適切なアクセス権限 
を譲渡するためのサービス 
● 非常に細かい設定が可能 
● 各種サービスを連携させる場合は、このIAMの使用が大 
前提になる
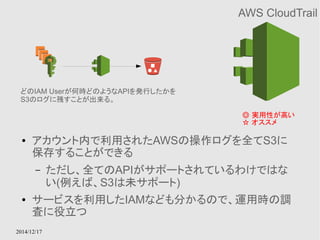
どのIAM Userが何時どのようなAPIを発行したかを 
S3のログに残すことが出来る。 
2014/12/17 
AWS CloudTrail 
◎ 実用性が高い 
☆ オススメ 
● アカウント内で利用されたAWSの操作ログを全てS3に 
保存することができる 
– ただし、全てのAPIがサポートされているわけではな 
い(例えば、S3は未サポート) 
● サービスを利用したIAMなども分かるので、運用時の調 
査に役立つ
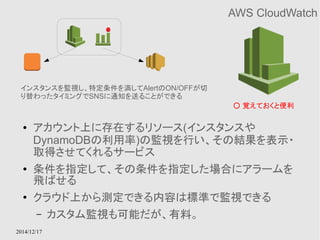
インスタンスを監視し、特定条件を満してAlertのON/OFFが切 
り替わったタイミングでSNSに通知を送ることができる 
2014/12/17 
AWS CloudWatch 
● アカウント上に存在するリソース(インスタンスや 
DynamoDBの利用率)の監視を行い、その結果を表示・ 
取得させてくれるサービス 
● 条件を指定して、その条件を指定した場合にアラームを 
飛ばせる 
● クラウド上から測定できる内容は標準で監視できる 
– カスタム監視も可能だが、有料。 
○ 覚えておくと便利
2014/12/17 
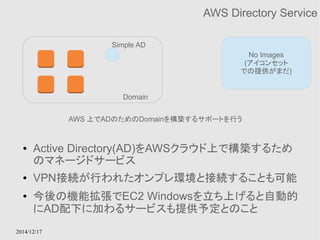
AWS Directory Service 
No Images 
(アイコンセット 
での提供がまだ) 
Simple AD 
Domain 
AWS 上でADのためのDomainを構築するサポートを行う 
● Active Directory(AD)をAWSクラウド上で構築するため 
のマネージドサービス 
● VPN接続が行われたオンプレ環境と接続することも可能 
● 今後の機能拡張でEC2 Windowsを立ち上げると自動的 
にAD配下に加わるサービスも提供予定とのこと
2014/12/17 
AWS Trusted Advisor 
No Images 
(アイコンセット 
での提供がまだ) 
● Amazon公式からAWSの利用方法に対して示唆を行っ 
てくれるサービス 
– ビジネス、およびエンタープライズレベルのサポート時のみ 
● コスト、パフォーマンス、セキュリティ、障害耐性などの観 
点でメッセージを送ってくれる
2014/12/17 
6. その他 (分類しづらいもの)
virtual private cloud 
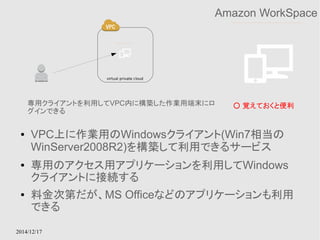
専用クライアントを利用してVPC内に構築した作業用端末にロ 
グインできる 
2014/12/17 
Amazon WorkSpace 
○ 覚えておくと便利 
● VPC上に作業用のWindowsクライアント(Win7相当の 
WinServer2008R2)を構築して利用できるサービス 
● 専用のアクセス用アプリケーションを利用してWindows 
クライアントに接続する 
● 料金次第だが、MS Officeなどのアプリケーションも利用 
できる
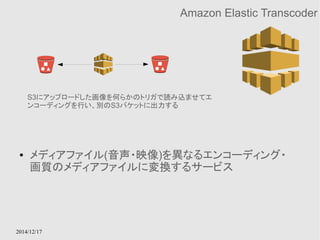
S3にアップロードした画像を何らかのトリガで読み込ませてエ 
ンコーディングを行い、別のS3バケットに出力する 
2014/12/17 
Amazon Elastic Transcoder 
● メディアファイル(音声・映像)を異なるエンコーディング・ 
画質のメディアファイルに変換するサービス
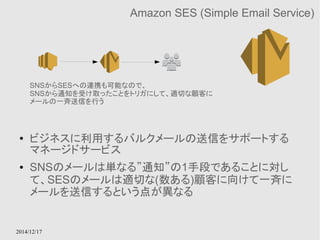
SNSからSESへの連携も可能なので、 
SNSから通知を受け取ったことをトリガにして、適切な顧客に 
メールの一斉送信を行う 
2014/12/17 
Amazon SES (Simple Email Service) 
● ビジネスに利用するバルクメールの送信をサポートする 
マネージドサービス 
● SNSのメールは単なる”通知”の1手段であることに対し 
て、SESのメールは適切な(数ある)顧客に向けて一斉に 
メールを送信するという点が異なる
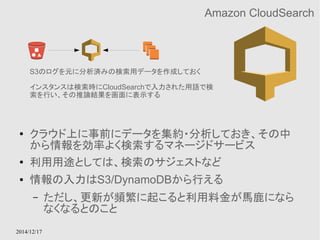
S3のログを元に分析済みの検索用データを作成しておく 
インスタンスは検索時にCloudSearchで入力された用語で検 
索を行い、その推論結果を画面に表示する 
2014/12/17 
Amazon CloudSearch 
● クラウド上に事前にデータを集約・分析しておき、その中 
から情報を効率よく検索するマネージドサービス 
● 利用用途としては、検索のサジェストなど 
● 情報の入力はS3/DynamoDBから行える 
– ただし、更新が頻繁に起こると利用料金が馬鹿になら 
なくなるとのこと
2014/12/17 
Amazon Cognito 
No Images 
(アイコンセット 
での提供がまだ) 
Cognito 
一人のユーザの複数の端末で作業やデータを共有・同期する 
ために必要なサービスを提供する 
マネージドな命令(同期させる)といったものもある 
● 一意なIDを元に、複数の端末でデータを共有・同期する 
ためのサービス
2014/12/17 
Amazon Mobile Analytics 
No Images 
(アイコンセット 
での提供がまだ) 
● モバイルアプリケーションを利用する上で、システム・ 
ユーザ体験を改善するための情報を収集・視覚化するた 
めのサービス 
– Google Ayalyticsと大体同じサービス 
– 異なるのは、他のAWSサービスとの連携が密であること
2014/12/17 
Amazon Zocalo 
No Images 
(アイコンセット 
での提供がまだ) 
● AWS上に構築されるマネージドでセキュアな文書・ファイ 
ルの保存共有サービス 
● 噛み砕いて説明すると、Subversion + コードレビュー支 
援ツールの組み合わせを一般的な文章ファイルに対して 
行えるようにしたもの
2014/12/17 
AWS re:Invent2014で 
発表された新サービスの紹介 
約40個サービスを紹介しましたが、まだまだ増加していきそうです。
Amazon Aurora 
– 外見はRDB(MySQL)だが、データ保持の内部構造をクラウドに 
最適化した新しい形のマネージドRDBサービス 
– RDSの一種として提供されるが、より安全で安価に提供される 
– 特に読み取りに対しては非常に高いスペックを持つ 
2014/12/17 
☆ オススメ 
AWS Config 
– AWS上で利用されているリソースの変更履歴を管理できるよう 
になる 
☆ オススメ 
– また、現時点のリソースの可視化や、変更による影響範囲の洗 
い出しが行えるようになる 
⇒ 誰かが設定を変えてトラブルが発生し、その原因調査に 
時間が掛かるということが事前にチェックできる/正しく動い 
ていた状態に戻せるようになる
Amazon CodeDeploy 
– EC2インスタンスに対して、ビルド成果をデプロイするための 
サービス 
– EC2/AutoScaling特有の事情を考え、これらに特化したデプロイ 
手法を提供 
– エージェントベースであり、エージェントに指令をすることでコード 
をデプロイできる仕組み 
AWS CodePipeline (2015年上旬Preview) 
– CIサービスや本番環境へのリリースを管理し、その結果を可視 
化できるサービス 
AWS CodeCommit (2015年上旬Preview) 
– クラウド上にソースコードのリポジトリを提供するサービス 
2014/12/17 
Amazon内では3つ合せてApolloと 
呼ばれているデプロイメントサービスだそうです。
AWS Key Management Service 
– 企業内のデータ暗号化に利用する鍵を一貫して扱うことができ 
るようになるサービス 
– 内部で使う鍵の持ち込みや、サードパーティ製ツールの鍵によ 
るデータの管理、全体の暗号化鍵をまとめて更新する処理など 
が実現可能になる 
AWS Service Catalog 
– あるユーザに事前に(CloudFormationで)定義したリソースのみ 
を実行可能にできるようにする 
– このことで、ユーザが個別にリソースを作るのではなく、必要な 
内容だけを利用できるようになる 
2014/12/17
Amazon EC2 Container Service 
– AWSの提供するDockerベースコンテナのマネジメントサービス 
– 事前にEC2によってクラスタを構築・コンテナをデプロイして使い 
始めると、事前に構築したクラスタの中でリソースの稼働率を最 
適化するようにコンテナの展開を行ってくれる 
2014/12/17 
☆ オススメ 
新しいEC2インスタンスとEBSボリューム 
– 計算最適化インスタンスc4系 
– SSDのEBSボリュームの最大サイズが16TBに 
● Magneticは変わらず2TBなことに注意
AWS Lambda 
– イベント駆動型コンピューティングサービス 
– イベントが発生した場合にどのような処理を行うかのコードを 
アップロードし、イベントと紐付けておくと、特別なインフラを用意 
しなくてもAWS上で発生したイベントをトリガにしてアップロードし 
たコードを実行できる 
– 課金は実際に実行された回数と使用したCPUリソースからなる 
– プログラムはJavaScript (Node.js)で記述する 
2014/12/17 
☆ 個人的な一押しの新サービス
2014/12/17 
費用対効果の高いクラウドサービス
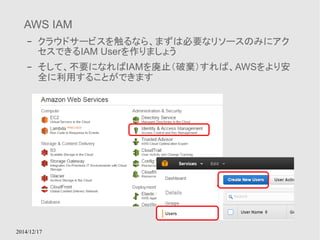
AWS IAM 
– クラウドサービスを触るなら、まずは必要なリソースのみにアク 
セスできるIAM Userを作りましょう 
– そして、不要になればIAMを廃止(破棄)すれば、AWSをより安 
全に利用することができます 
2014/12/17
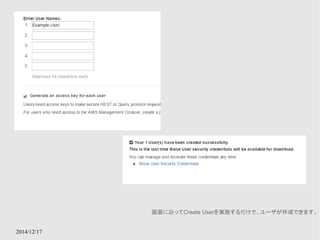
2014/12/17 
画面に沿ってCreate Userを実施するだけで、ユーザが作成できます。
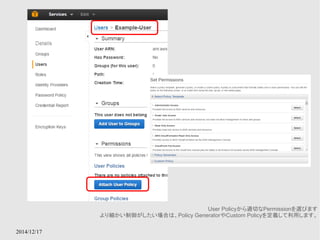
2014/12/17 
User Policyから適切なPermissionを選びます 
より細かい制御がしたい場合は、Policy GeneratorやCustom Policyを定義して利用します。
Amazon VPC 
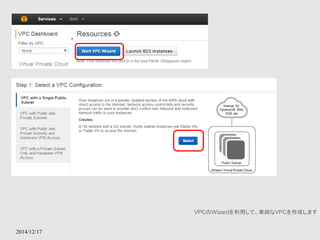
– 一見ネットワークの設定は難しそうですが、Wizardを利用すれ 
ばイメージどおりのVPCを作成できます 
– ここで説明している限りのVPCの使い方では、VPCに対しての 
課金要素は発生しません 
– EC2 ClassicとVPC内のインスタンスを比較した時、VPC内のイ 
ンスタンスが優れている点は以下の通りです 
2014/12/17 
● t2系インスタンスが利用できる (値段はLinuxの場合) 
m1.small: vCPU1, 1.7GB Mem, $0.061/hour 
t1.micro: vCPU1, 0.613GB Mem, $0.026/hour 
t2.micro: vCPU1, 1.0GB Mem, $0.020/hour 
t2.small: vCPU1, 2.0GB Mem, $0.040/hour 
加えて、t2系インスタンスはバースト性能があります 
● インスタンスをterminateしなくてもSecurityGroupの設定が 
変更できる
2014/12/17 
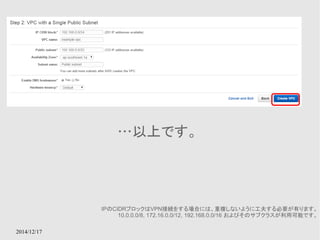
VPCのWizardを利用して、単純なVPCを作成します
2014/12/17 
…以上です。 
IPのCIDRブロックはVPN接続をする場合には、重複しないように工夫する必要が有ります。 
10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16 およびそのサブクラスが利用可能です。
2014/12/17 
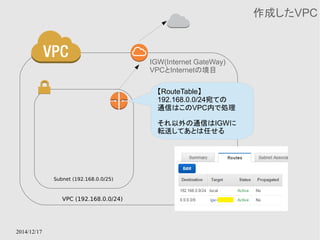
作成したVPC 
Subnet (192.168.0.0/25) 
VPC (192.168.0.0/24) 
IGW(Internet GateWay) 
VPCとInternetの境目 
【RouteTable】 
192.168.0.0/24宛ての 
通信はこのVPC内で処理 
それ以外の通信はIGWに 
転送してあとは任せる
2014/12/17 
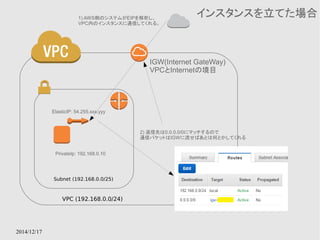
インスタンスを立てた場合 
1) AWS側のシステムがEIPを解析し、 
VPC内のインスタンスに通信してくれる。 
ElasticIP: 54.255.xxx.yyy 
Subnet (192.168.0.0/25) 
VPC (192.168.0.0/24) 
IGW(Internet GateWay) 
VPCとInternetの境目 
PrivateIp: 192.168.0.10 
2) 返信先は0.0.0.0/0にマッチするので 
通信パケットはIGWに流せばあとは何とかしてくれる
Amazon S3 
インスタンスを以下の用途で使っているならば、S3に置き換えで 
きないかを考えて見ましょう 
● 静的なHTMLファイルのみが置いてあるWebサーバー 
2014/12/17 
S3のWebsites設定を行うことで、アップロードしたHTML 
コンテンツをWebページとして閲覧することが可能です 
● ファイルサーバーとしてインスタンスを利用している 
インスタンス代金(最少で約$20/月) + EBSボリューム 
(GB数 × $0.05) 
S3なら、$33.4もあれば月に1TBものデータが 
99.999999999%の堅牢性のあるストレージを利用できる 
ただし、容量無制限なので、いくらでもデータを保持できる(=料 
金は青天井)ことに注意してください! 
● この容量限界をチェックしたい場合、プログラムを作成して実 
行するしかありません 
● 利用容量に対して(カスタムメトリクスの)CloudWatchを設定 
して、アラートを飛ばすことはできます
2014/12/17 
ファイル保存のためにS3を利用する 
AWS-CLI を利用するとローカルのファイルを扱うのと同じ 
手軽さでS3を利用できます 
どのような権限で操作するかのAccessKeyと 
SecretAccessKeyが必要になるので、作成して下さい 
AWS-CLIインストール方法 
– http://aws.amazon.com/jp/cli/ 
– Windowsならインストーラがあります
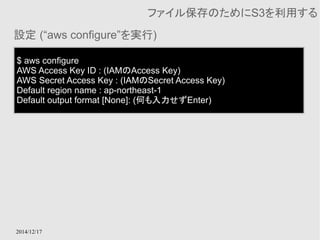
設定 (“aws configure”を実行) 
2014/12/17 
ファイル保存のためにS3を利用する 
$ aws configure 
AWS Access Key ID : (IAMのAccess Key) 
AWS Secret Access Key : (IAMのSecret Access Key) 
Default region name : ap-northeast-1 
Default output format [None]: (何も入力せずEnter)
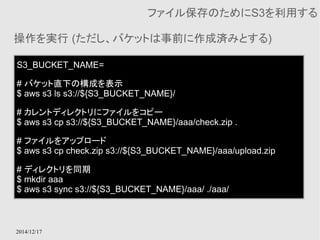
操作を実行 (ただし、バケットは事前に作成済みとする) 
2014/12/17 
ファイル保存のためにS3を利用する 
S3_BUCKET_NAME= 
# バケット直下の構成を表示 
$ aws s3 ls s3://${S3_BUCKET_NAME}/ 
# カレントディレクトリにファイルをコピー 
$ aws s3 cp s3://${S3_BUCKET_NAME}/aaa/check.zip . 
# ファイルをアップロード 
$ aws s3 cp check.zip s3://${S3_BUCKET_NAME}/aaa/upload.zip 
# ディレクトリを同期 
$ mkdir aaa 
$ aws s3 sync s3://${S3_BUCKET_NAME}/aaa/ ./aaa/
2014/12/17 
AWS-CLIについて (番外) 
● ここではS3を利用するために使いましたが、多くのリソー 
スがAWS-CLIからも利用できます (詳しくは”aws help”を 
実行してください) 
● s3以外を使った場合の結果は(デフォルトでは)JSONで 
返ってきます 
– シェルで頑張るならjqというプログラムを使ってJSONを 
パースするのがオススメです 
– さすがにawk単体などで頑張るのはオススメしません 
– シェルで頑張れないなら、Pythonのデプロイツールの1 
つである、Fabricが利用しやすいので紹介します
2014/12/17 
Fabric (番外) 
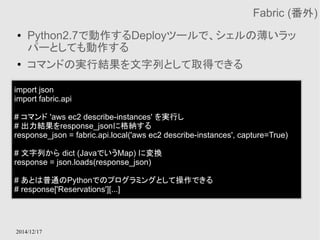
● Python2.7で動作するDeployツールで、シェルの薄いラッ 
パーとしても動作する 
● コマンドの実行結果を文字列として取得できる 
import json 
import fabric.api 
# コマンド 'aws ec2 describe-instances' を実行し 
# 出力結果をresponse_jsonに格納する 
response_json = fabric.api.local('aws ec2 describe-instances', capture=True) 
# 文字列から dict (JavaでいうMap) に変換 
response = json.loads(response_json) 
# あとは普通のPythonでのプログラミングとして操作できる 
# response['Reservations'][...]
2014/12/17 
クラウドサービスを利用した 
サンプルアプリケーションの実装 
実装にはPython2.7 + boto(AWS-Python-SDK)を利用しています。 
好きな言語で書きたい方は随時置き換えてください。
2014/12/17 
サンプルアプリケーションの実装 
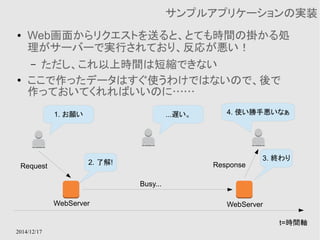
● Web画面からリクエストを送ると、とても時間の掛かる処 
理がサーバーで実行されており、反応が悪い! 
– ただし、これ以上時間は短縮できない 
● ここで作ったデータはすぐ使うわけではないので、後で 
作っておいてくれればいいのに…… 
1. お願い 
2. 了解! 
...遅い。 
4. 使い勝手悪いなぁ 
3. 終わり 
t=時間軸 
WebServer 
Request 
Busy... 
Response 
WebServer
2014/12/17 
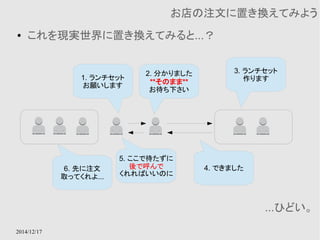
お店の注文に置き換えてみよう 
● これを現実世界に置き換えてみると...? 
1. ランチセット 
お願いします 
2. 分かりました 
**そのまま** 
お待ち下さい 
3. ランチセット 
作ります 
4. できました 
5. ここで待たずに 
後で呼んで 
くれればいいのに 
6. 先に注文 
取ってくれよ... 
...ひどい。
2014/12/17 
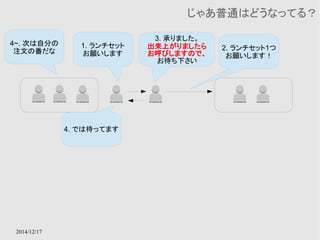
じゃあ普通はどうなってる? 
1. ランチセット 
お願いします 
3. 承りました。 
出来上がりましたら 
お呼びしますので、 
お待ち下さい 
2. ランチセット1つ 
お願いします! 
4~. 次は自分の 
注文の番だな 
4. では待ってます
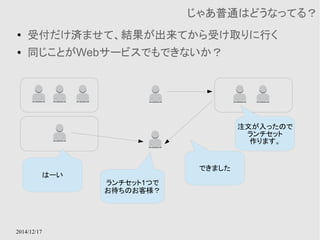
● 受付だけ済ませて、結果が出来てから受け取りに行く 
● 同じことがWebサービスでもできないか? 
2014/12/17 
じゃあ普通はどうなってる? 
注文が入ったので 
ランチセット 
作ります。 
ランチセット1つで 
お待ちのお客様? 
できました 
はーい
2014/12/17 
このようなケースを解決するための 
サービス(の1つ)が Amazon SQS
2014/12/17 
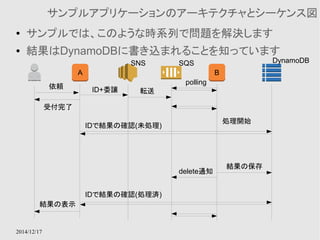
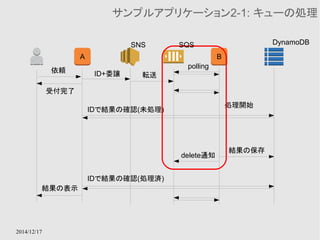
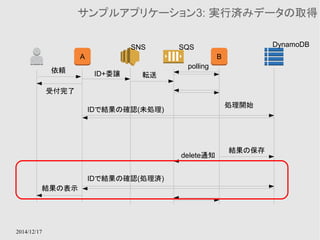
サンプルアプリケーションのアーキテクチャとシーケンス図 
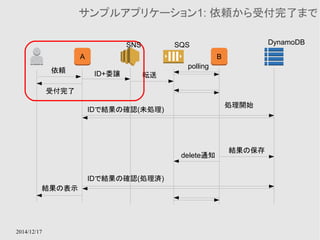
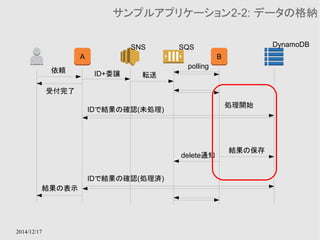
● サンプルでは、このような時系列で問題を解決します 
● 結果はDynamoDBに書き込まれることを知っています 
A B 
依頼ID+委譲 
受付完了 
転送 
polling 
処理開始 
delete通知 
結果の保存 
IDで結果の確認(未処理) 
IDで結果の確認(処理済) 
結果の表示 
SNS SQS DynamoDB
2014/12/17 
事前準備 
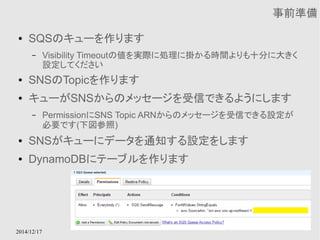
● SQSのキューを作ります 
– Visibility Timeoutの値を実際に処理に掛かる時間よりも十分に大きく 
設定してください 
● SNSのTopicを作ります 
● キューがSNSからのメッセージを受信できるようにします 
– PermissionにSNS Topic ARNからのメッセージを受信できる設定が 
必要です(下図参照) 
● SNSがキューにデータを通知する設定をします 
● DynamoDBにテーブルを作ります
2014/12/17 
サンプルアプリケーション1: 依頼から受付完了まで 
A B 
依頼ID+委譲 
受付完了 
転送 
polling 
処理開始 
delete通知 
結果の保存 
IDで結果の確認(未処理) 
IDで結果の確認(処理済) 
結果の表示 
SNS SQS DynamoDB
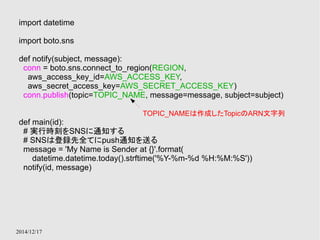
import datetime 
import boto.sns 
def notify(subject, message): 
conn = boto.sns.connect_to_region(REGION, 
aws_access_key_id=AWS_ACCESS_KEY, 
aws_secret_access_key=AWS_SECRET_ACCESS_KEY) 
conn.publish(topic=TOPIC_NAME, message=message, subject=subject) 
def main(id): 
# 実行時刻をSNSに通知する 
# SNSは登録先全てにpush通知を送る 
message = 'My Name is Sender at {}'.format( 
datetime.datetime.today().strftime('%Y-%m-%d %H:%M:%S')) 
notify(id, message) 
2014/12/17 
TOPIC_NAMEは作成したTopicのARN文字列
2014/12/17 
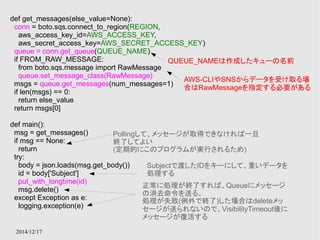
サンプルアプリケーション2-1: キューの処理 
A B 
依頼ID+委譲 
受付完了 
転送 
polling 
処理開始 
delete通知 
結果の保存 
IDで結果の確認(未処理) 
IDで結果の確認(処理済) 
結果の表示 
SNS SQS DynamoDB
def get_messages(else_value=None): 
conn = boto.sqs.connect_to_region(REGION, 
aws_access_key_id=AWS_ACCESS_KEY, 
aws_secret_access_key=AWS_SECRET_ACCESS_KEY) 
queue = conn.get_queue(QUEUE_NAME) 
if FROM_RAW_MESSAGE: 
from boto.sqs.message import RawMessage 
queue.set_message_class(RawMessage) 
msgs = queue.get_messages(num_messages=1) 
if len(msgs) == 0: 
return else_value 
return msgs[0] 
def main(): 
msg = get_messages() 
if msg == None: 
return 
try: 
body = json.loads(msg.get_body()) 
id = body['Subject'] 
put_with_longtime(id) 
msg.delete() 
except Exception as e: 
logging.exception(e) 
2014/12/17 
QUEUE_NAMEは作成したキューの名前 
AWS-CLIやSNSからデータを受け取る場 
合はRawMessageを指定する必要がある 
Pollingして、メッセージが取得できなければ一旦 
終了してよい 
(定期的にこのプログラムが実行されるため) 
Subjectで渡したIDをキーにして、重いデータを 
処理する 
正常に処理が終了すれば、Queueにメッセージ 
の消去命令を送る。 
処理が失敗(例外で終了)した場合はdeleteメッ 
セージが送られないので、VisibilityTimeout後に 
メッセージが復活する
2014/12/17 
サンプルアプリケーション2-2: データの格納 
A B 
依頼ID+委譲 
受付完了 
転送 
polling 
処理開始 
delete通知 
結果の保存 
IDで結果の確認(未処理) 
IDで結果の確認(処理済) 
結果の表示 
SNS SQS DynamoDB
def heavy_procedure(id): 
import uuid 
ids = [] 
for i in xrange(0,5): 
time.sleep(1) 
ids.append(str(uuid.uuid4())) 
return ':'.join(ids) 
def put_with_longtime(id): 
value = heavy_procedure(id) 
import boto.dynamodb2 
from boto.dynamodb2.table import Table 
conn = boto.dynamodb2.connect_to_region(REGION, 
aws_access_key_id=AWS_ACCESS_KEY, 
aws_secret_access_key=AWS_SECRET_ACCESS_KEY) 
table = Table(TABLE_NAME, connection=conn) 
table.put_item(data={ 
'id': id, 
'value': value 
}, overwrite=True) 
2014/12/17 
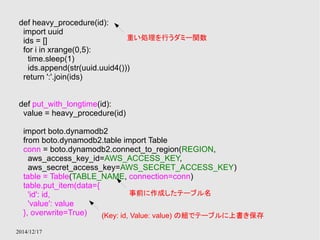
重い処理を行うダミー関数 
事前に作成したテーブル名 
(Key: id, Value: value) の組でテーブルに上書き保存
2014/12/17 
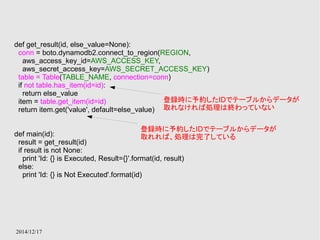
サンプルアプリケーション3: 実行済みデータの取得 
A B 
依頼ID+委譲 
受付完了 
転送 
polling 
処理開始 
delete通知 
結果の保存 
IDで結果の確認(未処理) 
IDで結果の確認(処理済) 
結果の表示 
SNS SQS DynamoDB
def get_result(id, else_value=None): 
conn = boto.dynamodb2.connect_to_region(REGION, 
aws_access_key_id=AWS_ACCESS_KEY, 
aws_secret_access_key=AWS_SECRET_ACCESS_KEY) 
table = Table(TABLE_NAME, connection=conn) 
if not table.has_item(id=id): 
return else_value 
item = table.get_item(id=id) 
return item.get('value', default=else_value) 
2014/12/17 
登録時に予約したIDでテーブルからデータが 
取れなければ処理は終わっていない 
登録時に予約したIDでテーブルからデータが 
取れれば、処理は完了している 
def main(id): 
result = get_result(id) 
if result is not None: 
print 'Id: {} is Executed, Result={}'.format(id, result) 
else: 
print 'Id: {} is Not Executed'.format(id)
2014/12/17 
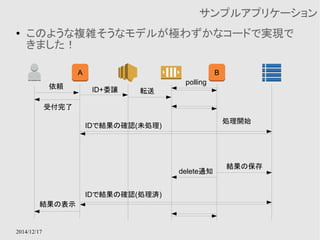
サンプルアプリケーション 
● このような複雑そうなモデルが極わずかなコードで実現で 
きました! 
A B 
依頼ID+委譲 
受付完了 
転送 
polling 
処理開始 
delete通知 
結果の保存 
IDで結果の確認(未処理) 
IDで結果の確認(処理済) 
結果の表示
クラウドサービスを利用したアーキテクチャ設計 
2014/12/17
2014/12/17 
クラウドサービスの特徴 
● Programmable 
– 設定をポチポチするのではなく、プログラミングによって制御可能 
– 今回のサンプルでは初期設定を手動で実施しましたが、これもプログ 
ラムで処理可能です 
● Composable 
– 組み合わせ容易 
– システム・サービスの入出力が明確であり、サービス間の結合が(一般 
に)疎である 
● サービスはSPOF(単一障害点)に成らない 
– 冗長化された形で提供される (S3, SQSなど) 
● 裏ではいくつも壊れているが、サービスは提供できている 
– 冗長化の方法が提供される (EC2 + ELB + AutoScalingなど)
クラウドのリソースは常に壊れる可能性がある!! 
2014/12/17 
アーキテクチャ設計の大前提 
● あるサーバー1台にデータを蓄積すると、そのサーバーが 
蓄積直後に壊れるかも知れない 
– 冗長構成のデータストレージが提供されているので、そ 
のサービスに依存して故障の可能性を減らす 
– 安定した信頼度のデータストレージを自前で作って運 
用するのは莫大なコストと時間が掛かるので、サービス 
の形で提供されている 
– 壊れてもいいなら、1台で動かすのも選択肢(安い)
2014/12/17 
【事実】 
プログラマへの要求 
アプリケーションがクラウドに対応できないと 
アーキテクチャをいくら頑張っても無理 
● 例えば、あるアプリケーションは一時的な処理をするため 
にローカルにファイルを出力するようにしました 
– 後続の処理がある場合、そのファイルを利用するためには同じAP 
サーバーにアクセスする必要がある 
– スティッキーセッションが必須となり、該当APが落ちた場合にはその 
ユーザの処理は完了しない 
● この場合はAPが落ちても大丈夫なように、ファイルをサー 
バー上に持たない設計にすべきだった
2014/12/17 
とはいえ、 
常にクラウドサービスを使えるとは限らないし、 
今は対応の必要が無いし...
2014/12/17 
とはいえ、 
常にクラウドサービスを使えるとは限らないし、 
今は対応の必要が無いし... 
後から対応できる方法を 
作っておこう
2014/12/17 
インタフェースとストラテジー 
● 危険な匂いのするレイヤー(特にファイルの永続化やDB 
の永続化など)には、DAOインタフェースを定義する 
– ローカルに保存するDaoImplを実装 
– S3に保存するDaoImplを実装 
⇒ 実行時の環境によって切り替えるようにする 
● 最初から特定の環境に依存できないのであれば、何時環 
境が変更されても良いように、依存性を排除する 
– 逆に、実行する環境が確定し、そこに特化するなら依存性を利用した 
コードを書くのも良い 
– その場合は、どこかでコードを捨てる覚悟(犠牲的アーキテクチャ)を持 
ち、移行(再度のフルスクラッチ)を前提にしてアプリケーションを作成す 
るという流派もある
2014/12/17 
【事実】 
プログラマへの要求 
アプリケーションがクラウドに対応できないと 
アーキテクチャをいくら頑張っても無理 
● 今後の方針が分からないなら、よりメンテナンスがしやすく 
環境の変更に対応しやすい、いわゆる「良い設計」に従っ 
たコードを書こう 
● ある環境に依存することを決めたなら、その環境の資産を 
十二分に利用してアプリケーションを設計しよう 
– この時、現在は最適であっても、未来にはそれが最適でないことを覚 
悟しよう
2014/12/17 
マイクロサービスアーキテクチャ 
● 今回のサンプルでは、本来1つだった機能を独立した3つ 
の機能に分けたとも考えられる 
PG1 - IN: Userの指示 / OUT: Queue 
PG2 - IN: Queue / OUT: DynamoDB 
PG3 - IN: DynamoDB / OUT: Userの手元 
● このようにクラウドサービスを中継点にサービスを分離す 
ることで”サービス単体”を小さく、シンプルにすることがで 
きる 
– アプリケーションの本質であるデータの流れを明確にできる 
– サービスが何をすればよいかが明確になる 
– サービスの結合度が低くなり、役割分担が容易になる 
– サービス単独で動作をさせることができるようになる