Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
Uploaded by
Yohei Azekatsu
PPTX, PDF
3,491 views
Parquetはカラムナなのか?
Presto は Parquet ファイルにカラムナなIOをしているか調べてみたメモ。
Technology
◦
Read more
More Related Content
PDF
Parquet Strata/Hadoop World, New York 2013
by
Julien Le Dem
27 slides
133.8K views
PDF
Apache Sparkに手を出してヤケドしないための基本 ~「Apache Spark入門より」~ (デブサミ 2016 講演資料)
by
NTT DATA OSS Professional Services
60 slides
53.9K views
PDF
Hadoop/Spark で Amazon S3 を徹底的に使いこなすワザ (Hadoop / Spark Conference Japan 2019)
by
Noritaka Sekiyama
61 slides
21.3K views
PDF
ストリーム処理を支えるキューイングシステムの選び方
by
Yoshiyasu SAEKI
42 slides
41.4K views
PDF
Dockerからcontainerdへの移行
by
Kohei Tokunaga
36 slides
19.4K views
PDF
KafkaとAWS Kinesisの比較
by
Yoshiyasu SAEKI
16 slides
15.4K views
PDF
Apache Hadoop YARNとマルチテナントにおけるリソース管理
by
Cloudera Japan
65 slides
12.5K views
PPTX
Elasticsearch as a Distributed System
by
Satoyuki Tsukano
53 slides
6.8K views
Parquet Strata/Hadoop World, New York 2013
by
Julien Le Dem
27 slides
133.8K views
Apache Sparkに手を出してヤケドしないための基本 ~「Apache Spark入門より」~ (デブサミ 2016 講演資料)
by
NTT DATA OSS Professional Services
60 slides
53.9K views
Hadoop/Spark で Amazon S3 を徹底的に使いこなすワザ (Hadoop / Spark Conference Japan 2019)
by
Noritaka Sekiyama
61 slides
21.3K views
ストリーム処理を支えるキューイングシステムの選び方
by
Yoshiyasu SAEKI
42 slides
41.4K views
Dockerからcontainerdへの移行
by
Kohei Tokunaga
36 slides
19.4K views
KafkaとAWS Kinesisの比較
by
Yoshiyasu SAEKI
16 slides
15.4K views
Apache Hadoop YARNとマルチテナントにおけるリソース管理
by
Cloudera Japan
65 slides
12.5K views
Elasticsearch as a Distributed System
by
Satoyuki Tsukano
53 slides
6.8K views
What's hot
PDF
入門 Kubeflow ~Kubernetesで機械学習をはじめるために~ (NTT Tech Conference #4 講演資料)
by
NTT DATA Technology & Innovation
56 slides
7.8K views
PDF
MySQL・PostgreSQLだけで作る高速あいまい全文検索システム
by
Kouhei Sutou
97 slides
10.7K views
PDF
HTTP/2 入門
by
Yahoo!デベロッパーネットワーク
33 slides
64.3K views
PDF
Vacuum徹底解説
by
Masahiko Sawada
51 slides
7.5K views
PDF
ホットペッパービューティーにおけるモバイルアプリ向けAPIのBFF/Backend分割
by
Recruit Lifestyle Co., Ltd.
82 slides
16.1K views
PDF
Kinesis + Elasticsearchでつくるさいきょうのログ分析基盤
by
Amazon Web Services Japan
42 slides
6.2K views
PDF
今からでも遅くないDBマイグレーション - Flyway と SchemaSpy の紹介 -
by
onozaty
30 slides
5.5K views
PDF
Apache Kuduを使った分析システムの裏側
by
Cloudera Japan
86 slides
8.5K views
PDF
Efficient Data Storage for Analytics with Apache Parquet 2.0
by
Cloudera, Inc.
40 slides
160.5K views
PPTX
Apache Avro vs Protocol Buffers
by
Seiya Mizuno
33 slides
6.9K views
PDF
Amazon S3 Best Practice and Tuning for Hadoop/Spark in the Cloud
by
Noritaka Sekiyama
60 slides
35.1K views
PDF
The Parquet Format and Performance Optimization Opportunities
by
Databricks
32 slides
9.9K views
PPTX
はじめてのElasticsearchクラスタ
by
Satoyuki Tsukano
63 slides
40.2K views
PDF
PostgreSQL 15の新機能を徹底解説
by
Masahiko Sawada
38 slides
2.3K views
PDF
Spark + Parquet In Depth: Spark Summit East Talk by Emily Curtin and Robbie S...
by
Spark Summit
76 slides
10K views
PPTX
Glue DataBrewでデータをクリーニング、加工してみよう
by
takeshi suto
20 slides
1.8K views
PDF
Data platformdesign
by
Ryoma Nagata
51 slides
1.8K views
PPTX
BuildKitによる高速でセキュアなイメージビルド
by
Akihiro Suda
27 slides
45.8K views
PDF
[261] 실시간 추천엔진 머신한대에 구겨넣기
by
NAVER D2
98 slides
46.8K views
PDF
Apache Sparkにおけるメモリ - アプリケーションを落とさないメモリ設計手法 -
by
Yoshiyasu SAEKI
62 slides
9.9K views
入門 Kubeflow ~Kubernetesで機械学習をはじめるために~ (NTT Tech Conference #4 講演資料)
by
NTT DATA Technology & Innovation
56 slides
7.8K views
MySQL・PostgreSQLだけで作る高速あいまい全文検索システム
by
Kouhei Sutou
97 slides
10.7K views
HTTP/2 入門
by
Yahoo!デベロッパーネットワーク
33 slides
64.3K views
Vacuum徹底解説
by
Masahiko Sawada
51 slides
7.5K views
ホットペッパービューティーにおけるモバイルアプリ向けAPIのBFF/Backend分割
by
Recruit Lifestyle Co., Ltd.
82 slides
16.1K views
Kinesis + Elasticsearchでつくるさいきょうのログ分析基盤
by
Amazon Web Services Japan
42 slides
6.2K views
今からでも遅くないDBマイグレーション - Flyway と SchemaSpy の紹介 -
by
onozaty
30 slides
5.5K views
Apache Kuduを使った分析システムの裏側
by
Cloudera Japan
86 slides
8.5K views
Efficient Data Storage for Analytics with Apache Parquet 2.0
by
Cloudera, Inc.
40 slides
160.5K views
Apache Avro vs Protocol Buffers
by
Seiya Mizuno
33 slides
6.9K views
Amazon S3 Best Practice and Tuning for Hadoop/Spark in the Cloud
by
Noritaka Sekiyama
60 slides
35.1K views
The Parquet Format and Performance Optimization Opportunities
by
Databricks
32 slides
9.9K views
はじめてのElasticsearchクラスタ
by
Satoyuki Tsukano
63 slides
40.2K views
PostgreSQL 15の新機能を徹底解説
by
Masahiko Sawada
38 slides
2.3K views
Spark + Parquet In Depth: Spark Summit East Talk by Emily Curtin and Robbie S...
by
Spark Summit
76 slides
10K views
Glue DataBrewでデータをクリーニング、加工してみよう
by
takeshi suto
20 slides
1.8K views
Data platformdesign
by
Ryoma Nagata
51 slides
1.8K views
BuildKitによる高速でセキュアなイメージビルド
by
Akihiro Suda
27 slides
45.8K views
[261] 실시간 추천엔진 머신한대에 구겨넣기
by
NAVER D2
98 slides
46.8K views
Apache Sparkにおけるメモリ - アプリケーションを落とさないメモリ設計手法 -
by
Yoshiyasu SAEKI
62 slides
9.9K views
Similar to Parquetはカラムナなのか?
PDF
僕とヤフーと時々Teradata #prestodb
by
Yahoo!デベロッパーネットワーク
47 slides
2.4K views
PDF
Guide to Cassandra for Production Deployments
by
smdkk
85 slides
5.1K views
PPTX
Hadoopソースコードリーディング8/MapRを使ってみた
by
Recruit Technologies
45 slides
5.4K views
PDF
Yahoo! JAPANにおけるApache Cassandraへの取り組み
by
Yahoo!デベロッパーネットワーク
51 slides
11.3K views
PDF
CouchDB JP & BigCouch
by
Yohei Sasaki
40 slides
1.8K views
PDF
最新版Hadoopクラスタを運用して得られたもの
by
cyberagent
38 slides
5.4K views
PDF
AWS で Presto を徹底的に使いこなすワザ
by
Noritaka Sekiyama
42 slides
1.7K views
PDF
141030ceph
by
OSSラボ株式会社
48 slides
2.6K views
PDF
Kyoto Tycoon Guide in Japanese
by
Mikio Hirabayashi
42 slides
25.1K views
PDF
Presto on YARNの導入・運用
by
cyberagent
31 slides
1.7K views
PDF
DeNAインフラの今とこれから - 今編 -
by
Tomoya Kabe
36 slides
5.6K views
PDF
Hadoop operation chaper 4
by
Yukinori Suda
30 slides
1.3K views
PDF
Lars George HBase Seminar with O'REILLY Oct.12 2012
by
Cloudera Japan
41 slides
2.5K views
PDF
We Should Know About in this SocialNetwork Era 2011_1112
by
Masahito Zembutsu
70 slides
1.1K views
PPTX
DeNA private cloud のその後 - OpenStack最新情報セミナー(2017年3月)
by
VirtualTech Japan Inc.
35 slides
1.8K views
PDF
人気番組との戦い! Javaシステムのパフォーマンスチューニング奮闘記
by
心 谷本
92 slides
6K views
PDF
Prestoで実現するインタラクティブクエリ - dbtech showcase 2014 Tokyo
by
Treasure AI
57 slides
11.8K views
PDF
Fluentdでログを集めてGlusterFSに保存してMapReduceで集計
by
maebashi
20 slides
2.4K views
PDF
20120117 13 meister-elasti_cache-public
by
Amazon Web Services Japan
51 slides
2.5K views
PDF
Hadoopのシステム設計・運用のポイント
by
Cloudera Japan
57 slides
35.1K views
僕とヤフーと時々Teradata #prestodb
by
Yahoo!デベロッパーネットワーク
47 slides
2.4K views
Guide to Cassandra for Production Deployments
by
smdkk
85 slides
5.1K views
Hadoopソースコードリーディング8/MapRを使ってみた
by
Recruit Technologies
45 slides
5.4K views
Yahoo! JAPANにおけるApache Cassandraへの取り組み
by
Yahoo!デベロッパーネットワーク
51 slides
11.3K views
CouchDB JP & BigCouch
by
Yohei Sasaki
40 slides
1.8K views
最新版Hadoopクラスタを運用して得られたもの
by
cyberagent
38 slides
5.4K views
AWS で Presto を徹底的に使いこなすワザ
by
Noritaka Sekiyama
42 slides
1.7K views
141030ceph
by
OSSラボ株式会社
48 slides
2.6K views
Kyoto Tycoon Guide in Japanese
by
Mikio Hirabayashi
42 slides
25.1K views
Presto on YARNの導入・運用
by
cyberagent
31 slides
1.7K views
DeNAインフラの今とこれから - 今編 -
by
Tomoya Kabe
36 slides
5.6K views
Hadoop operation chaper 4
by
Yukinori Suda
30 slides
1.3K views
Lars George HBase Seminar with O'REILLY Oct.12 2012
by
Cloudera Japan
41 slides
2.5K views
We Should Know About in this SocialNetwork Era 2011_1112
by
Masahito Zembutsu
70 slides
1.1K views
DeNA private cloud のその後 - OpenStack最新情報セミナー(2017年3月)
by
VirtualTech Japan Inc.
35 slides
1.8K views
人気番組との戦い! Javaシステムのパフォーマンスチューニング奮闘記
by
心 谷本
92 slides
6K views
Prestoで実現するインタラクティブクエリ - dbtech showcase 2014 Tokyo
by
Treasure AI
57 slides
11.8K views
Fluentdでログを集めてGlusterFSに保存してMapReduceで集計
by
maebashi
20 slides
2.4K views
20120117 13 meister-elasti_cache-public
by
Amazon Web Services Japan
51 slides
2.5K views
Hadoopのシステム設計・運用のポイント
by
Cloudera Japan
57 slides
35.1K views
More from Yohei Azekatsu
PPTX
SIGMOD 2022 Amazon Redshift Re-invented を読んで
by
Yohei Azekatsu
55 slides
71 views
PPTX
Using Lightweight Formal Methods to Validate a Key-Value Storage Node in Amaz...
by
Yohei Azekatsu
41 slides
43 views
PPTX
Linux Process Snapper Introduction
by
Yohei Azekatsu
19 slides
587 views
PPTX
CloudTrail ログの検索を爆速化してみた
by
Yohei Azekatsu
24 slides
638 views
PPTX
Linux Performance Analysis in 15 minutes
by
Yohei Azekatsu
37 slides
1.7K views
PDF
iostatの見方
by
Yohei Azekatsu
7 slides
2.6K views
PDF
シンプルでシステマチックな Oracle Database, Exadata 性能分析
by
Yohei Azekatsu
53 slides
9.5K views
PDF
シンプルでシステマチックな Linux 性能分析方法
by
Yohei Azekatsu
78 slides
11.6K views
PDF
簡単!AWRをEXCELピボットグラフで分析しよう♪
by
Yohei Azekatsu
34 slides
10.7K views
PPTX
Dbts2012 unconference wttrw_yazekatsu_publish
by
Yohei Azekatsu
41 slides
1.6K views
PPTX
私がPerlを使う理由
by
Yohei Azekatsu
20 slides
2.5K views
SIGMOD 2022 Amazon Redshift Re-invented を読んで
by
Yohei Azekatsu
55 slides
71 views
Using Lightweight Formal Methods to Validate a Key-Value Storage Node in Amaz...
by
Yohei Azekatsu
41 slides
43 views
Linux Process Snapper Introduction
by
Yohei Azekatsu
19 slides
587 views
CloudTrail ログの検索を爆速化してみた
by
Yohei Azekatsu
24 slides
638 views
Linux Performance Analysis in 15 minutes
by
Yohei Azekatsu
37 slides
1.7K views
iostatの見方
by
Yohei Azekatsu
7 slides
2.6K views
シンプルでシステマチックな Oracle Database, Exadata 性能分析
by
Yohei Azekatsu
53 slides
9.5K views
シンプルでシステマチックな Linux 性能分析方法
by
Yohei Azekatsu
78 slides
11.6K views
簡単!AWRをEXCELピボットグラフで分析しよう♪
by
Yohei Azekatsu
34 slides
10.7K views
Dbts2012 unconference wttrw_yazekatsu_publish
by
Yohei Azekatsu
41 slides
1.6K views
私がPerlを使う理由
by
Yohei Azekatsu
20 slides
2.5K views
Parquetはカラムナなのか?
1.
Parquet はカラムナなのか? Yohei Azekatsu Twitter:
@yoheia Dec, 2019
2.
アジェンダ • お話すること • クイズ •
カラムナフォーマット Parquet とは • Presto は Parquet をどのように読むか • Presto on EMR で検証してみた • まとめ • Appendix
3.
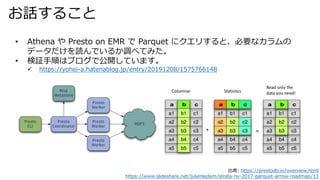
お話すること • Athena や
Presto on EMR で Parquet にクエリすると、必要なカラムの データだけを読んでいるか調べてみた。 • 検証手順はブログで公開しています。 https://yohei-a.hatenablog.jp/entry/20191208/1575766148 出典: https://prestodb.io/overview.html https://www.slideshare.net/julienledem/strata-ny-2017-parquet-arrow-roadmap/13
4.
クイズ
5.
どのクエリが一番速いでしょう? • Athena や
Presto で以下のクエリを実行すると、どれが一番速いでしょう? • データは S3や HDFS にある parquet ファイル。 1. select count(*) from amazon_reviews_parquet; 2. select count(product_title) from amazon_reviews_parquet; 3. select count(review_body) from amazon_reviews_parquet; 使用したデータ: https://registry.opendata.aws/amazon-reviews/
6.
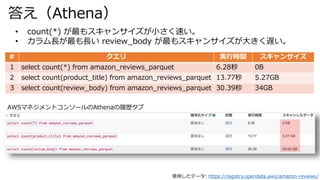
答え(Athena) 使用したデータ: https://registry.opendata.aws/amazon-reviews/ # クエリ
実行時間 スキャンサイズ 1 select count(*) from amazon_reviews_parquet 6.28秒 0B 2 select count(product_title) from amazon_reviews_parquet 13.77秒 5.27GB 3 select count(review_body) from amazon_reviews_parquet 30.39秒 34GB • count(*) が最もスキャンサイズが小さく速い。 • カラム長が最も長い review_body が最もスキャンサイズが大きく遅い。 AWSマネジメントコンソールのAthenaの履歴タブ
7.
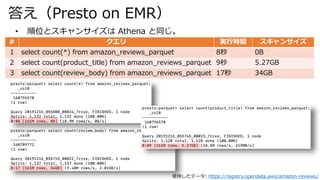
答え(Presto on EMR) 使用したデータ:
https://registry.opendata.aws/amazon-reviews/ # クエリ 実行時間 スキャンサイズ 1 select count(*) from amazon_reviews_parquet 8秒 0B 2 select count(product_title) from amazon_reviews_parquet 9秒 5.27GB 3 select count(review_body) from amazon_reviews_parquet 17秒 34GB • 順位とスキャンサイズは Athena と同じ。
8.
カラムナフォーマット Parquet とは
9.
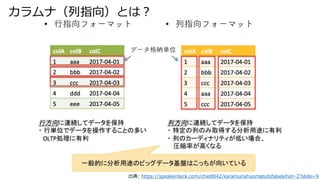
カラムナ(列指向)とは? 出典: https://speakerdeck.com/chie8842/karamunahuomatutofalsekihon-2?slide=9
10.
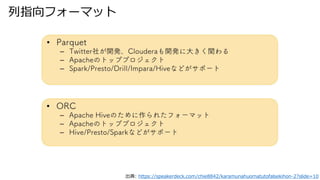
列指向フォーマット 出典: https://speakerdeck.com/chie8842/karamunahuomatutofalsekihon-2?slide=10
11.
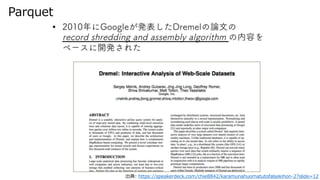
Parquet 出典: https://speakerdeck.com/chie8842/karamunahuomatutofalsekihon-2?slide=12
12.
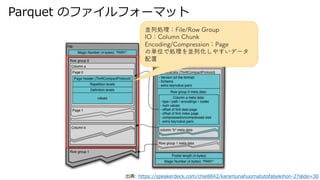
Parquet のファイルフォーマット 出典: https://speakerdeck.com/chie8842/karamunahuomatutofalsekihon-2?slide=30
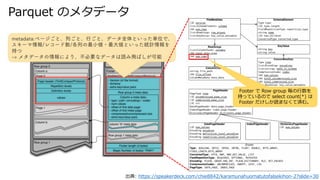
13.
Parquet のメタデータ 出典: https://speakerdeck.com/chie8842/karamunahuomatutofalsekihon-2?slide=30 Footer
で Row group 毎の行数を 持っているので select count(*) は Footer だけしか読まなくて済む。
14.
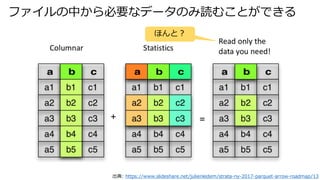
ファイルの中から必要なデータのみ読むことができる 出典: https://www.slideshare.net/julienledem/strata-ny-2017-parquet-arrow-roadmap/13 ほんと?
15.
Presto は Parquet
をどのように読むか
16.
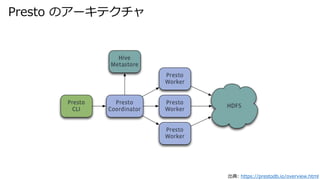
Presto のアーキテクチャ 出典: https://prestodb.io/overview.html
17.
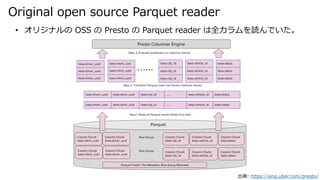
Original open source
Parquet reader 出典: https://eng.uber.com/presto/ • オリジナルの OSS の Presto の Parquet reader は全カラムを読んでいた。
18.
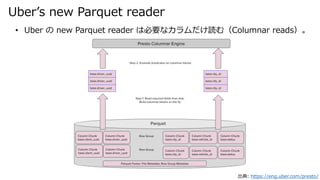
Uber’s new Parquet
reader 出典: https://eng.uber.com/presto/ • Uber の new Parquet reader は必要なカラムだけ読む(Columnar reads)。
19.
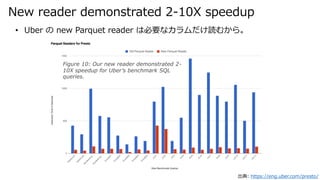
New reader demonstrated
2-10X speedup 出典: https://eng.uber.com/presto/ • Uber の new Parquet reader は必要なカラムだけ読むから。 Figure 10: Our new reader demonstrated 2- 10X speedup for Uber’s benchmark SQL queries.
20.
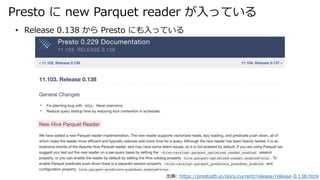
Presto に new
Parquet reader が入っている 出典: https://prestodb.io/docs/current/release/release-0.138.html • Release 0.138 から Presto にも入っている
21.
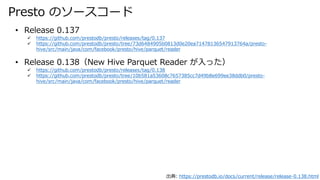
Presto のソースコード 出典: https://prestodb.io/docs/current/release/release-0.138.html •
Release 0.137 https://github.com/prestodb/presto/releases/tag/0.137 https://github.com/prestodb/presto/tree/73d6484905b0813d0e20ea71478136547913764a/presto- hive/src/main/java/com/facebook/presto/hive/parquet/reader • Release 0.138(New Hive Parquet Reader が入った) https://github.com/prestodb/presto/releases/tag/0.138 https://github.com/prestodb/presto/tree/10b581a53608c7657385cc7d49b8e699ee38ddb0/presto- hive/src/main/java/com/facebook/presto/hive/parquet/reader
22.
Presto on EMR
で検証してみた
23.
クエリを実行してみる presto:parquet> select count(review_body)
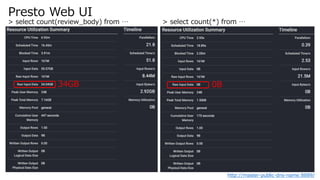
from amazon_reviews_parquet; _col0 ----------- 160789772 (1 row) Query 20191214_131823_00001_7rzxe, FINISHED, 1 node Splits: 1,137 total, 1,137 done (100.00%) 0:19 [161M rows, 34GB] [8.43M rows/s, 1.78GB/s] presto:parquet> select count(*) from amazon_reviews_parquet; _col0 ----------- 160796570 (1 row) Query 20191214_132223_00002_7rzxe, FINISHED, 1 node Splits: 1,136 total, 1,136 done (100.00%) 0:07 [161M rows, 0B] [21.5M rows/s, 0B/s]
24.
Presto Web UI http://master-public-dns-name:8889/ >
select count(review_body) from … > select count(*) from … 34GB 0B
25.
コールスタックを見ると
26.
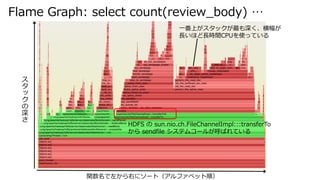
Flame Graph: select
count(review_body) … HDFS の sun.nio.ch.FileChannelImpl:::transferTo から sendfile システムコールが呼ばれている ス タ ッ ク の 深 さ 関数名で左から右にソート(アルファベット順) 一番上がスタックが最も深く、横幅が 長いほど長時間CPUを使っている
27.
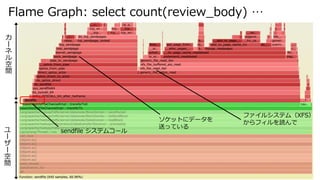
Flame Graph: select
count(review_body) … ユ ー ザ ー 空 間 カ ー ネ ル 空 間 sendfile システムコール ファイルシステム(XFS) からフィルを読んで ソケットにデータを 送っている
28.
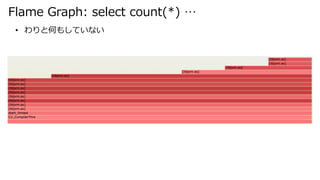
Flame Graph: select
count(*) … ス タ ッ ク の 深 さ • わりと何もしていない
29.
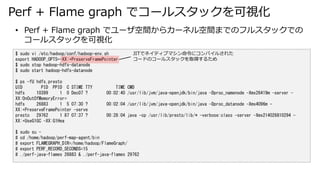
Perf + Flame
graph でコールスタックを可視化 $ sudo vi /etc/hadoop/conf/hadoop-env.sh export HADOOP_OPTS=-XX:+PreserveFramePointer $ sudo stop hadoop-hdfs-datanode $ sudo start hadoop-hdfs-datanode $ ps -fU hdfs,presto UID PID PPID C STIME TTY TIME CMD hdfs 10399 1 0 Dec07 ? 00:02:40 /usr/lib/jvm/java-openjdk/bin/java -Dproc_namenode -Xmx26419m -server - XX:OnOutOfMemoryError= hdfs 26883 1 5 07:30 ? 00:02:04 /usr/lib/jvm/java-openjdk/bin/java -Dproc_datanode -Xmx4096m - XX:+PreserveFramePointer -serve presto 29762 1 87 07:37 ? 00:28:04 java -cp /usr/lib/presto/lib/* -verbose:class -server -Xmx214026810294 - XX:+UseG1GC -XX:G1Hea $ sudo su - # cd /home/hadoop/perf-map-agent/bin # export FLAMEGRAPH_DIR=/home/hadoop/FlameGraph/ # export PERF_RECORD_SECONDS=15 # ./perf-java-flames 26883 & ./perf-java-flames 29762 • Perf + Flame graph でユーザ空間からカーネル空間までのフルスタックでの コールスタックを可視化 JITでネイティブマシン命令にコンパイルされた コードのコールスタックを取得するため
30.
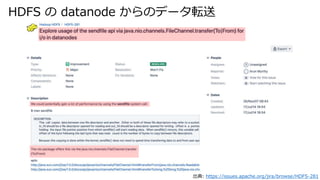
HDFS の datanode
からのデータ転送 出典: https://issues.apache.org/jira/browse/HDFS-281
31.
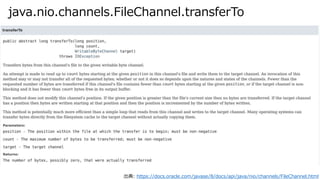
java.nio.channels.FileChannel.transferTo 出典: https://docs.oracle.com/javase/8/docs/api/java/nio/channels/FileChannel.html
32.
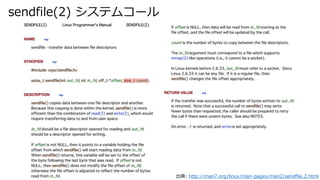
sendfile(2) システムコール 出典: http://man7.org/linux/man-pages/man2/sendfile.2.html
33.
strace で HDFS
のシステムコールトレースをとると $ sudo strace -fe sendfile -s 200 -p 10858 3434 sendfile(1003, 993, [68038656], 65536) = 65536 3546 sendfile(984, 1042, [16862208], 65536) = 65536 3438 sendfile(979, 1007, [86496768], 65536) = 65536 3422 sendfile(971, 1032, [101465600], 65536 <unfinished ...> • select count(review_body) from … sendfile システムコールで 64Kbyte(65536 byte) 単位で読んでいる。 $ sudo strace -fe sendfile -s 200 -p 10858 14928 sendfile(1057, 1112, [72695808], 275) = 275 14953 sendfile(1060, 1128, [47949312], 69) = 69 14954 sendfile(1041, 1112, [100519424], 489) = 489 14955 sendfile(1116, 1119, [94451200], 178) = 178 • select count(*) from … sendfile システムコールで読んでいるIOサ イズはバラバラ。
34.
システムコールレイヤーでのIOサイズとIO量 • strace で
sendfile(2) のシステムコールトレースを取得し、可視化すると、 IOサイズとIO量に差がある。 0 50,000 100,000 150,000 200,000 250,000 300,000 350,000 400,000 450,000 500,000 65536 165 177 279 24576 382 288 240 513 505 回数 IOサイズ 0 5 10 15 20 25 165 279 177 382 288 240 513 505 29861 29689 回数 IOサイズ > select count(review_body) from … > select count(*) from … $ perl -lane '$F[1]=~/^sendfile/ and ($s)=$F[4]=~/^(d+)/ and print $s' strace_hdfs_review_body.log|sort|uniq -c|sort -r|head -10
35.
iostat $ iostat -dx
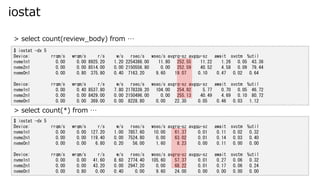
5 Device: rrqm/s wrqm/s r/s w/s rsec/s wsec/s avgrq-sz avgqu-sz await svctm %util nvme1n1 0.00 0.00 8925.20 1.20 2254386.00 11.80 252.55 11.22 1.26 0.05 43.36 nvme2n1 0.00 0.00 8514.00 0.00 2150556.80 0.00 252.59 40.52 4.58 0.09 79.44 nvme0n1 0.00 0.80 375.80 0.40 7163.20 9.60 19.07 0.10 0.47 0.02 0.64 Device: rrqm/s wrqm/s r/s w/s rsec/s wsec/s avgrq-sz avgqu-sz await svctm %util nvme1n1 0.00 0.40 8537.80 7.80 2178339.20 104.00 254.92 5.77 0.70 0.05 46.72 nvme2n1 0.00 0.00 8429.00 0.00 2150496.00 0.00 255.13 40.49 4.69 0.10 80.72 nvme0n1 0.00 0.00 369.00 0.00 8228.80 0.00 22.30 0.05 0.46 0.03 1.12 $ iostat -dx 5 Device: rrqm/s wrqm/s r/s w/s rsec/s wsec/s avgrq-sz avgqu-sz await svctm %util nvme1n1 0.00 0.00 127.20 1.00 7857.60 10.00 61.37 0.01 0.11 0.02 0.32 nvme2n1 0.00 0.00 119.40 0.00 7524.80 0.00 63.02 0.01 0.14 0.03 0.40 nvme0n1 0.00 0.00 6.80 0.20 56.00 1.60 8.23 0.00 0.11 0.00 0.00 Device: rrqm/s wrqm/s r/s w/s rsec/s wsec/s avgrq-sz avgqu-sz await svctm %util nvme1n1 0.00 0.00 41.60 8.60 2774.40 105.60 57.37 0.01 0.27 0.06 0.32 nvme2n1 0.00 0.00 43.20 0.00 2947.20 0.00 68.22 0.01 0.17 0.06 0.24 nvme0n1 0.00 0.80 0.00 0.40 0.00 9.60 24.00 0.00 0.00 0.00 0.00 > select count(review_body) from … > select count(*) from …
36.
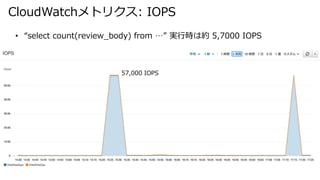
CloudWatchメトリクス: IOPS • “select
count(review_body) from …” 実行時は約 5,7000 IOPS 57,000 IOPS
37.
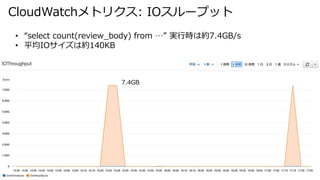
CloudWatchメトリクス: IOスループット • “select
count(review_body) from …” 実行時は約7.4GB/s • 平均IOサイズは約140KB 7.4GB
38.
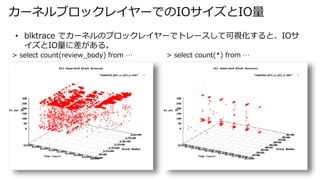
カーネルブロックレイヤーでのIOサイズとIO量 > select count(review_body)
from … > select count(*) from … • blktrace でカーネルのブロックレイヤーでトレースして可視化すると、IOサ イズとIO量に差がある。
39.
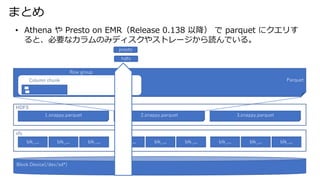
まとめ • Athena や
Presto on EMR(Release 0.138 以降) で parquet にクエリす ると、必要なカラムのみディスクやストレージから読んでいる。 presto hdfs 1.snappy.parquet 2.snappy.parquet 3.snappy.parquet HDFS xfs blk_... blk_... blk_... blk_... blk_... blk_... blk_... blk_... blk_... Block Device(/dev/sd*) Parquet Row group Column chunk
40.
Appendix
41.
Appendix.1 検証に使った EMR •
emr-5.28.0 Hadoop ディストリビューション: Amazon 2.8.5 アプリケーション: Hive 2.3.6, Pig 0.17.0, Hue 4.4.0, Presto 0.227, Ganglia 3.7.2 r5d.8xlarge、コア・マスターノードなし
42.
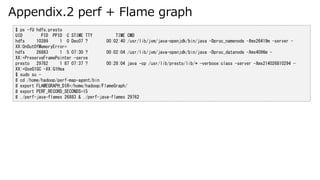
Appendix.2 perf +
Flame graph $ ps -fU hdfs,presto UID PID PPID C STIME TTY TIME CMD hdfs 10399 1 0 Dec07 ? 00:02:40 /usr/lib/jvm/java-openjdk/bin/java -Dproc_namenode -Xmx26419m -server - XX:OnOutOfMemoryError= hdfs 26883 1 5 07:30 ? 00:02:04 /usr/lib/jvm/java-openjdk/bin/java -Dproc_datanode -Xmx4096m - XX:+PreserveFramePointer -serve presto 29762 1 87 07:37 ? 00:28:04 java -cp /usr/lib/presto/lib/* -verbose:class -server -Xmx214026810294 - XX:+UseG1GC -XX:G1Hea $ sudo su - # cd /home/hadoop/perf-map-agent/bin # export FLAMEGRAPH_DIR=/home/hadoop/FlameGraph/ # export PERF_RECORD_SECONDS=15 # ./perf-java-flames 26883 & ./perf-java-flames 29762
43.
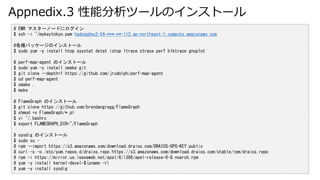
Appnedix.3 性能分析ツールのインストール # EMR
マスターノードにログイン $ ssh -i ~/mykeytokyo.pem hadoop@ec2-54-***-**-112.ap-northeast-1.compute.amazonaws.com #各種パッケージのインストール $ sudo yum -y install htop sysstat dstat iotop ltrace strace perf blktrace gnuplot # perf-map-agent のインストール $ sudo yum -y install cmake git $ git clone --depth=1 https://github.com/jrudolph/perf-map-agent $ cd perf-map-agent $ cmake . $ make # FlameGraph のインストール $ git clone https://github.com/brendangregg/FlameGraph $ chmod +x FlameGraph/*.pl $ vi ~/.bashrc $ export FLAMEGRAPH_DIR=~/FlameGraph # sysdig のインストール $ sudo su - # rpm --import https://s3.amazonaws.com/download.draios.com/DRAIOS-GPG-KEY.public # curl -s -o /etc/yum.repos.d/draios.repo https://s3.amazonaws.com/download.draios.com/stable/rpm/draios.repo # rpm -i https://mirror.us.leaseweb.net/epel/6/i386/epel-release-6-8.noarch.rpm # yum -y install kernel-devel-$(uname -r) # yum -y install sysdig
44.
Appnedix.4 JVM のオプションを設定 #
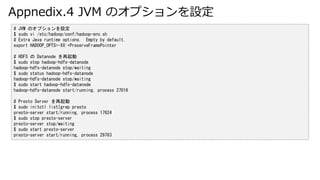
JVM のオプションを設定 $ sudo vi /etc/hadoop/conf/hadoop-env.sh # Extra Java runtime options. Empty by default. export HADOOP_OPTS=-XX:+PreserveFramePointer # HDFS の Datanode を再起動 $ sudo stop hadoop-hdfs-datanode hadoop-hdfs-datanode stop/waiting $ sudo status hadoop-hdfs-datanode hadoop-hdfs-datanode stop/waiting $ sudo start hadoop-hdfs-datanode hadoop-hdfs-datanode start/running, process 27016 # Presto Server を再起動 $ sudo initctl list|grep presto presto-server start/running, process 17624 $ sudo stop presto-server presto-server stop/waiting $ sudo start presto-server presto-server start/running, process 29763
45.
Appendix.5 strace +
perl ワンライナーで加工 $ ps -fU hdfs,presto UID PID PPID C STIME TTY TIME CMD hdfs 10399 1 0 Dec07 ? 00:02:40 /usr/lib/jvm/java-openjdk/bin/java -Dproc_namenode -Xmx26419m -server - XX:OnOutOfMemoryError= hdfs 26883 1 5 07:30 ? 00:02:04 /usr/lib/jvm/java-openjdk/bin/java -Dproc_datanode -Xmx4096m - XX:+PreserveFramePointer -serve presto 29762 1 87 07:37 ? 00:28:04 java -cp /usr/lib/presto/lib/* -verbose:class -server -Xmx214026810294 - XX:+UseG1GC -XX:G1Hea $ sudo strace -fe sendfile -s 200 -o strace_hdfs_review_body.log -p 10858 $ head -3 strace_hdfs_review_body.log 3546 sendfile(984, 1042, [16796672], 65536★ <unfinished ...> 3438 sendfile(979, 1007, [86431232], 65536 <unfinished ...> 3546<... sendfile resumed> ) = 65536 $ perl -lane '$F[1]=~/^sendfile/ and ($s)=$F[4]=~/^(d+)/ and print $s' strace_hdfs_review_body.log|sort|uniq -c|sort -r|head -10 465521 65536 24 165 22 177 21 279 20 382 20 288 20 24576 19 240 18 513 17 505
46.
Appendix.6 blktrace +
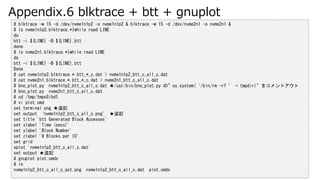
btt + gnuplot # blktrace -w 15 -d /dev/nvme1n1p2 -o nvme1n1p2 & blktrace -w 15 -d /dev/nvme2n1 -o nvme2n1 & # ls nvme1n1p2.blktrace.*|while read LINE do btt -i ${LINE} -B ${LINE}.btt done # ls nvme2n1.blktrace.*|while read LINE do btt -i ${LINE} -B ${LINE}.btt Done # cat nvme1n1p2.blktrace.*.btt_*_c.dat > nvme1n1p2_btt_c_all_c.dat # cat nvme2n1.blktrace.*.btt_*_c.dat > nvme2n1_btt_c_all_c.dat # bno_plot.py nvme1n1p2_btt_c_all_c.dat ★/usr/bin/bno_plot.py の”os.system(‘/bin/rm -rf ’ + tmpdir)”をコメントアウト # bno_plot.py nvme2n1_btt_c_all_c.dat # cd /tmp/tmpoSibdI # vi plot.cmd set terminal png ★追記 set output ‘nvme1n1p2_btt_c_all_c.png’ ★追記 set title 'btt Generated Block Accesses' set xlabel 'Time (secs)' set ylabel 'Block Number' set zlabel '# Blocks per IO' set grid splot 'nvme1n1p2_btt_c_all_c.dat' set output ★追記 # gnuplot plot.cmds # ls nvme1n1p2_btt_c_all_c_ast.png nvme1n1p2_btt_c_all_c.dat plot.cmds
47.
Appendix.7 参考情報 • Presto
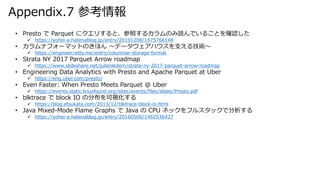
で Parquet にクエリすると、参照するカラムのみ読んでいることを確認した https://yohei-a.hatenablog.jp/entry/20191208/1575766148 • カラムナフォーマットのきほん 〜データウェアハウスを支える技術〜 https://engineer.retty.me/entry/columnar-storage-format • Strata NY 2017 Parquet Arrow roadmap https://www.slideshare.net/julienledem/strata-ny-2017-parquet-arrow-roadmap • Engineering Data Analytics with Presto and Apache Parquet at Uber https://eng.uber.com/presto/ • Even Faster: When Presto Meets Parquet @ Uber https://events.static.linuxfound.org/sites/events/files/slides/Presto.pdf • blktrace で block IO の分布を可視化する https://blog.etsukata.com/2013/12/blktrace-block-io.html • Java Mixed-Mode Flame Graphs で Java の CPU ネックをフルスタックで分析する https://yohei-a.hatenablog.jp/entry/20160506/1462536427
Editor's Notes
#4
Prestoはfacebookが開発したSQLエンジン HDFSやS3のファイルにSQLで問合せができる AthenaはPrestoのマネージド・サービス