Copyright©2016 NTT corp. All Rights Reserved.
トランザクションの設計と進化
NTT ソフトウェアイノベーションセンタ
熊崎宏樹
Copyright©2016 NTT corp. All Rights Reserved.
このスライドについて
話すこと
• 昔のDBの話
• トランザクションの基本
• 近代のDB界隈の潮流
• トランザクション技術の変遷
話さないこと
• 特定の商用DBの宣伝やF.U.D.
• OSS DBの実装の詳細
• 分散トランザクション
Copyright©2016 NTT corp. All Rights Reserved.
トランザクションの基本
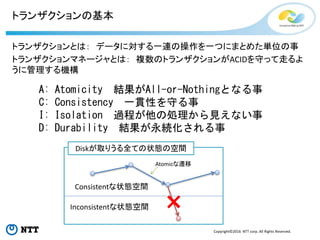
トランザクションとは: データに対する一連の操作を一つにまとめた単位の事
トランザクションマネージャとは: 複数のトランザクションがACIDを守って走るよ
うに管理する機構
A: Atomicity 結果がAll-or-Nothingとなる事
C: Consistency 一貫性を守る事
I: Isolation 過程が他の処理から見えない事
D: Durability 結果が永続化される事
Consistentな状態空間
Inconsistentな状態空間
Diskが取りうる全ての状態の空間
Atomicな遷移
Copyright©2016 NTT corp. All Rights Reserved.
何らかの実行順(スケジュール空間)
直列に実行した場合の結果
ACIDの実現手法
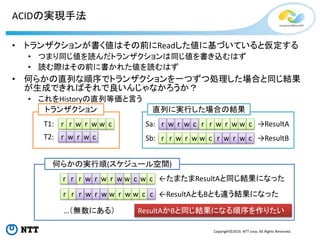
• トランザクションが書く値はその前にReadした値に基づいていると仮定する
• つまり同じ値を読んだトランザクションは同じ値を書き込むはず
• 読む際はその前に書かれた値を読むはず
• 何らかの直列な順序でトランザクションを一つずつ処理した場合と同じ結果
が生成できればそれで良いんじゃなかろうか?
• これをHistoryの直列等価と言う
r r w r w w cT1:
r w r w cT2:
r r w r w w cSa: r w r w c
r r w r w w cSb: r w r w c
r r w r w w cr w r w c
トランザクション
→ResultA
→ResultB
←たまたまResultAと同じ結果になった
r r w r w w cr w r w c ←ResultAともBとも違う結果になった
…(無数にある) ResultAかBと同じ結果になる順序を作りたい
Copyright©2016 NTT corp. All Rights Reserved.
スケジュールの空間
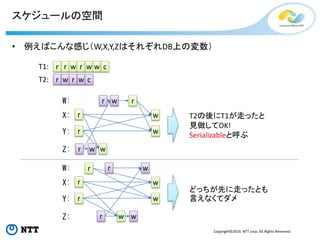
• 例えばこんな感じ(W,X,Y,ZはそれぞれDB上の変数)
r r w r w w cT1:
r w r w cT2:
r
r
w
r
w
w
W:
X:
Y:
Z: r w
r w
T2の後にT1が走ったと
見做してOK!
Serializableと呼ぶ
r
r
w
r
w
w
W:
X:
Y:
Z: r w
r w
どっちが先に走ったとも
言えなくてダメ
Copyright©2016 NTT corp. All Rights Reserved.
スケジュールの空間
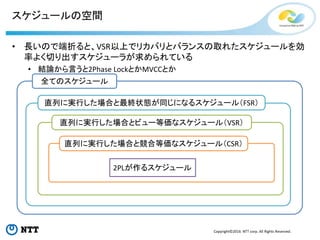
• 長いので端折ると、VSR以上でリカバリとバランスの取れたスケジュールを効
率よく切り出すスケジューラが求められている
• 結論から言うと2Phase LockとかMVCCとか
全てのスケジュール
直列に実行した場合と最終状態が同じになるスケジュール(FSR)
直列に実行した場合とビュー等価なスケジュール(VSR)
直列に実行した場合と競合等価なスケジュール(CSR)
2PLが作るスケジュール
Copyright©2016 NTT corp. All Rights Reserved.
リカバリ
• 障害時でもトランザクションのDurabilityを維持するための機能
• 大きく3つのシナリオが定義される
• トランザクション障害
• ユーザタイムアウトとかデッドロックとか自主的アボートとか…
• システム障害
• DBプロセスが突然殺されたとかOS落ちたとか電源抜けたとか…
• メディア障害
• ディスクが消し飛んだ。ログアーカイブから全部作り直すしかない
• これらの障害に耐えるようにディスク書き込みプロトコルを設計する
• 難しい事で有名だが、大量に研究が積まれている
• これからその詳細について
Copyright©2016 NTT corp. All Rights Reserved.
DB 基本構造
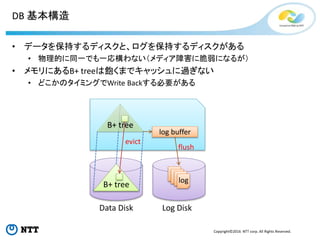
• データを保持するディスクと、ログを保持するディスクがある
• 物理的に同一でも一応構わない(メディア障害に脆弱になるが)
• メモリにあるB+ treeは飽くまでキャッシュに過ぎない
• どこかのタイミングでWrite Backする必要がある
Log DiskData Disk
B+ tree
B+ tree
log buffer
log
flush
evict
Copyright©2016 NTT corp. All Rights Reserved.
システム障害からのリカバリ
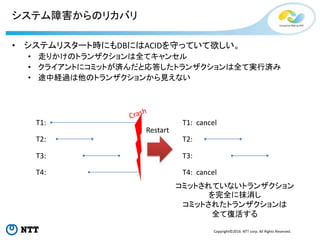
• システムリスタート時にもDBにはACIDを守っていて欲しい。
• 走りかけのトランザクションは全てキャンセル
• クライアントにコミットが済んだと応答したトランザクションは全て実行済み
• 途中経過は他のトランザクションから見えない
T1:
T2:
T3:
T4:
Restart
T1: cancel
T2:
T3:
T4: cancel
コミットされていないトランザクション
を完全に抹消し
コミットされたトランザクションは
全て復活する
Copyright©2016 NTT corp. All Rights Reserved.
バッファマネージャー
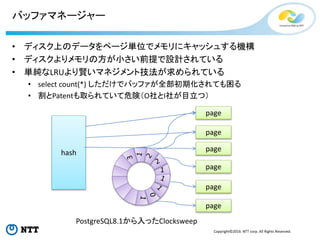
• ディスク上のデータをページ単位でメモリにキャッシュする機構
• ディスクよりメモリの方が小さい前提で設計されている
• 単純なLRUより賢いマネジメント技法が求められている
• select count(*) しただけでバッファが全部初期化されても困る
• 割とPatentも取られていて危険(O社とI社が目立つ)
hash
1
page
page
page
page
page
page
PostgreSQL8.1から入ったClocksweep
Copyright©2016 NTT corp. All Rights Reserved.
バッファマネージャー(Steal)
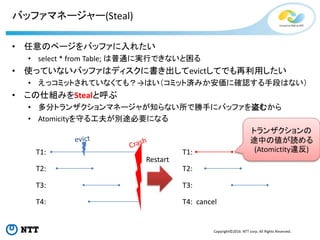
• 任意のページをバッファに入れたい
• select * from Table; は普通に実行できないと困る
• 使っていないバッファはディスクに書き出してevictしてでも再利用したい
• えっコミットされていなくても?→はい(コミット済みか安価に確認する手段はない)
• この仕組みをStealと呼ぶ
• 多分トランザクションマネージャが知らない所で勝手にバッファを盗むから
• Atomicityを守る工夫が別途必要になる
トランザクションの
途中の値が読める
(Atomictity違反)T1:
T2:
T3:
T4:
Restart
T1:
T2:
T3:
T4: cancel
Copyright©2016 NTT corp. All Rights Reserved.
バッファマネージャー(Force)
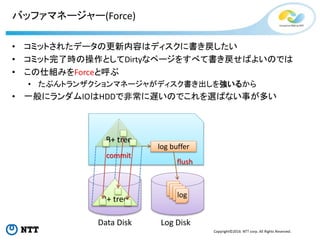
• コミットされたデータの更新内容はディスクに書き戻したい
• コミット完了時の操作としてDirtyなページをすべて書き戻せばよいのでは
• この仕組みをForceと呼ぶ
• たぶんトランザクションマネージャがディスク書き出しを強いるから
• 一般にランダムIOはHDDで非常に遅いのでこれを選ばない事が多い
Log DiskData Disk
B+ tree
B+ tree
log buffer
log
flush
commit
Copyright©2016 NTT corp. All Rights Reserved.
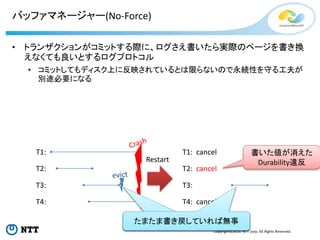
バッファマネージャー(No-Force)
• トランザクションがコミットする際に、ログさえ書いたら実際のページを書き換
えなくても良いとするログプロトコル
• コミットしてもディスク上に反映されているとは限らないので永続性を守る工夫が
別途必要になる
T1:
T2:
T3:
T4:
Restart
T1: cancel
T2: cancel
T3:
T4: cancel
書いた値が消えた
Durability違反
たまたま書き戻していれば無事
Copyright©2016 NTT corp. All Rights Reserved.
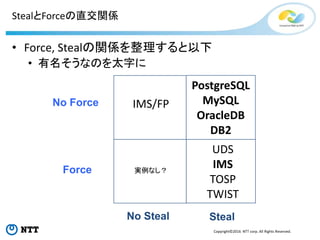
StealとForceの直交関係
• Force, Stealの関係を整理すると以下
• 有名そうなのを太字に
Force
No Force
No Steal Steal
PostgreSQL
MySQL
OracleDB
DB2
UDS
IMS
TOSP
TWIST
IMS/FP
実例なし?
Copyright©2016 NTT corp. All Rights Reserved.
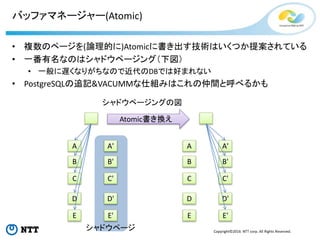
バッファマネージャー(Atomic)
• 複数のページを(論理的に)Atomicに書き出す技術はいくつか提案されている
• 一番有名なのはシャドウページング(下図)
• 一般に遅くなりがちなので近代のDBでは好まれない
• PostgreSQLの追記&VACUMMな仕組みはこれの仲間と呼べるかも
A
B
C
D
E
A'
B'
C'
D'
E'
A
B
C
D
E
A'
B'
C'
D'
E'
Atomic書き換え
シャドウページングの図
シャドウページ
Copyright©2016 NTT corp. All Rights Reserved.
チェックポイント
• No-forceなDBはジャーナルにRedoログが溜まっていくので、そのログの長さ
がクラッシュ後の再起動時間に大きく響いてしまう
• あまりに参照され続ける為一度もevictされないページが有ったらそこに影響を与
えるうるログの長さはDBの全ログにもなる
• 定期的にDirtyなページをディスクに書き出す事をチェックポイントと呼ぶ
• TOC: Transaction Oriented Checkpoint
• 常にForceしてればそもそもチェックポイント要らないよね(だが遅い)
• TCC: Transaction Consistent Checkpoint
• 定期的にチェックポイントシグナル発行して新規トランザクションの受付をしばらく止め
て全部のトランザクション終わるの待ってからディスクに全部書き出そうか(間欠停止)
• ACC: Action Consistent Checkpoint
• 定期的にチェックポイントシグナルしたらその瞬間のDirtyなページも含めて全部書きだ
しちゃえばいいよね(未コミットなデータも書き込むのでStealの一種だが無駄が多い)
• Fuzzy
• 定期的なチェックポイント時にDirtyになってるページ一覧のみを書き出せば充分リカバ
リコストを減らせるよね
• 亜種が多すぎるので詳細はまた今度…
Copyright©2016 NTT corp. All Rights Reserved.
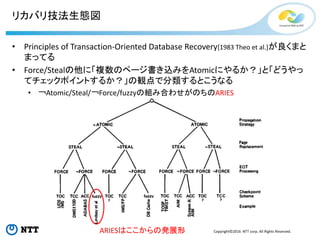
リカバリ技法生態図
• Principles of Transaction-Oriented Database Recovery[1983 Theo et al.]が良くまと
まってる
• Force/Stealの他に「複数のページ書き込みをAtomicにやるか?」と「どうやっ
てチェックポイントするか?」の観点で分類するとこうなる
• ¬Atomic/Steal/¬Force/fuzzyの組み合わせがのちのARIES
ARIESはここからの発展形
Copyright©2016 NTT corp. All Rights Reserved.
ログの種類と用法
• ログに含まれる情報は実装依存だが、その中でも着目すべき性質を持つロ
グの種類は「Undo」「Redo」の情報を含んでいるか否か。
• Undoログ:更新前のデータを保持するログ
• Redoログ:更新後のデータを保持するログ
• Undo-Redoログ:更新前と後両方のデータを保持するログ
• Stealの起きるデータベースでは必ずUndoログが必要となる
• ディスクに未コミットのデータが永続化されうるので、復旧時にそれを消去しない
といけない
• 複数ページをAtomicに書けないデータベースでForceする際もUndoログが必
要となる
• Force途中で落ちたら復旧しないといけないから
• Forceしないデータベースでは必ずRedoログが必要となる
• Atomicに複数ページを更新しない方式で行くなら、Steal時もForce時もページ
をevictする前に必ずログを書かないといけない
• これがいわゆるWrite Ahead Logging(WAL)の事。Stealより優先されるルール
Copyright©2016 NTT corp. All Rights Reserved.
リカバリ技法生態図もう一度
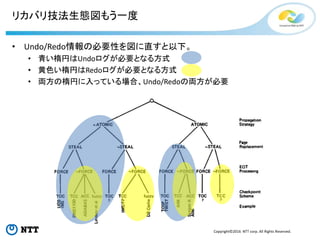
• Undo/Redo情報の必要性を図に直すと以下。
• 青い楕円はUndoログが必要となる方式
• 黄色い楕円はRedoログが必要となる方式
• 両方の楕円に入っている場合、Undo/Redoの両方が必要
Copyright©2016 NTT corp. All Rights Reserved.
リカバリの手順(Steal/No-Forceを例に)
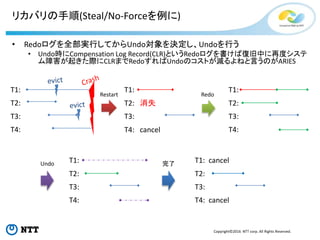
• Redoログを全部実行してからUndo対象を決定し、Undoを行う
• Undo時にCompensation Log Record(CLR)というRedoログを書けば復旧中に再度システ
ム障害が起きた際にCLRまでRedoすればUndoのコストが減るよねと言うのがARIES
T1:
T2:
T3:
T4:
Restart
T1:
T2: 消失
T3:
T4: cancel
T1:
T2:
T3:
T4:
Redo
Undo T1:
T2:
T3:
T4:
完了 T1: cancel
T2:
T3:
T4: cancel
Copyright©2016 NTT corp. All Rights Reserved.
リカバリつらい…
• だいたいStealとNon-atomic Updateのせい
• でもStealを禁じるとページをevictする為にトランザクションを待たないといけない
• しかもメモリ量を超えるページにいっぺんに触るトランザクションは実行不能になる
• 複数ページのUpdateをAtomicに行おうとすると無駄が多くて辛い
• PostgreSQLの追記&VACUMMはかなり上手くやっている例
• 「追記型DBだからシンプルな構造が実現されている」はPostgreSQLの常套句
• そもそもなんでStealが要るんだっけ?
• メモリ容量<<<<ディスク容量という前提があるから
Copyright©2016 NTT corp. All Rights Reserved.
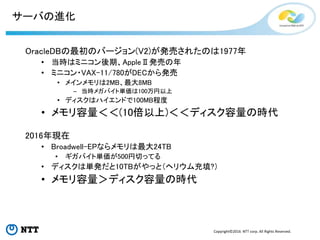
サーバの進化
OracleDBの最初のバージョン(V2)が発売されたのは1977年
• 当時はミニコン後期、AppleⅡ発売の年
• ミニコン・VAX-11/780がDECから発売
• メインメモリは2MB、最大8MB
– 当時メガバイト単価は100万円以上
• ディスクはハイエンドで100MB程度
• メモリ容量<<(10倍以上)<<ディスク容量の時代
2016年現在
• Broadwell-EPならメモリは最大24TB
• ギガバイト単価が500円切ってる
• ディスクは単発だと10TBがやっと(ヘリウム充填?)
• メモリ容量>ディスク容量の時代
Copyright©2016 NTT corp. All Rights Reserved.
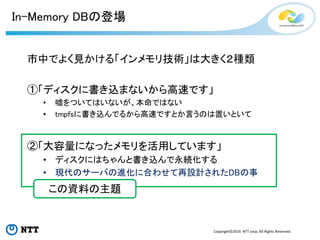
In-Memory DBの登場
市中でよく見かける「インメモリ技術」は大きく2種類
①「ディスクに書き込まないから高速です」
• 嘘をついてはいないが、本命ではない
• tmpfsに書き込んでるから高速ですとか言うのは置いといて
②「大容量になったメモリを活用しています」
• ディスクにはちゃんと書き込んで永続化する
• 現代のサーバの進化に合わせて再設計されたDBの事
この資料の主題
Copyright©2016 NTT corp. All Rights Reserved.
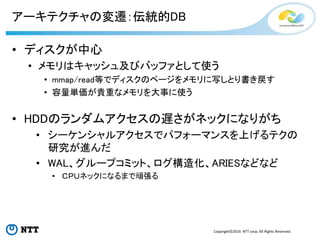
アーキテクチャの変遷:伝統的DB
• ディスクが中心
• メモリはキャッシュ及びバッファとして使う
• mmap/read等でディスクのページをメモリに写しとり書き戻す
• 容量単価が貴重なメモリを大事に使う
• HDDのランダムアクセスの遅さがネックになりがち
• シーケンシャルアクセスでパフォーマンスを上げるテクの
研究が進んだ
• WAL、グループコミット、ログ構造化、ARIESなどなど
• CPUネックになるまで頑張る
Copyright©2016 NTT corp. All Rights Reserved.
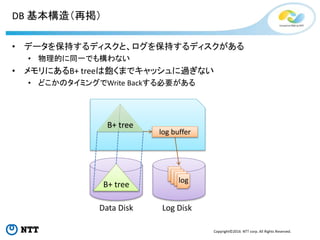
DB 基本構造(再掲)
• データを保持するディスクと、ログを保持するディスクがある
• 物理的に同一でも構わない
• メモリにあるB+ treeは飽くまでキャッシュに過ぎない
• どこかのタイミングでWrite Backする必要がある
Log DiskData Disk
B+ tree
B+ tree
log buffer
log
Copyright©2016 NTT corp. All Rights Reserved.
DB 基本構造
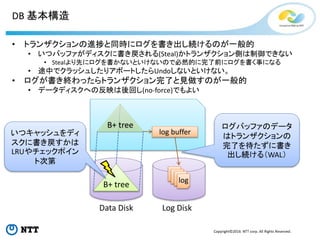
• トランザクションの進捗と同時にログを書き出し続けるのが一般的
• いつバッファがディスクに書き戻される(Steal)かトランザクション側は制御できない
• Stealより先にログを書かないといけないので必然的に完了前にログを書く事になる
• 途中でクラッシュしたりアボートしたらUndoしないといけない。
• ログが書き終わったらトランザクション完了と見做すのが一般的
• データディスクへの反映は後回し(no-force)でもよい
Log DiskData Disk
B+ tree
B+ tree
log buffer
log
ログバッファのデータ
はトランザクションの
完了を待たずに書き
出し続ける(WAL)
いつキャッシュをディ
スクに書き戻すかは
LRUやチェックポイン
ト次第
Copyright©2016 NTT corp. All Rights Reserved.
In-Memory DB 基本構造
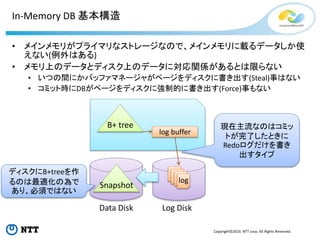
• メインメモリがプライマリなストレージなので、メインメモリに載るデータしか使
えない(例外はある)
• メモリ上のデータとディスク上のデータに対応関係があるとは限らない
• いつの間にかバッファマネージャがページをディスクに書き出す(Steal)事はない
• コミット時にDBがページをディスクに強制的に書き出す(Force)事もない
Log DiskData Disk
B+ tree
log buffer
log
現在主流なのはコミッ
トが完了したときに
Redoログだけを書き
出すタイプ
Snapshot
ディスクにB+treeを作
るのは最適化の為で
あり、必須ではない
Copyright©2016 NTT corp. All Rights Reserved.
アーキテクチャの変遷:In-Memory DB
• メモリがメインのデータ置き場であり作業場
• メモリに入りきらないデータはそもそも入らない
• ディスクは永続化を担当
• ログとスナップショットの保存
• In-MemoryDBはそもそもHDDからのキャッシュではないので
stealという概念が必要ない
• ディスクのキャッシュではないのでページという概念も存在しない
• 永続性とリカバリについてはこれまでと同等にしっかりサポート
Copyright©2016 NTT corp. All Rights Reserved.
In-Memory DB 基本構造
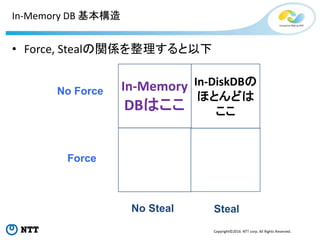
• Force, Stealの関係を整理すると以下
Force
No Force
No Steal Steal
In-DiskDBの
ほとんどは
ここ
In-Memory
DBはここ
Copyright©2016 NTT corp. All Rights Reserved.
In-Memory DB リカバリアーキテクチャ
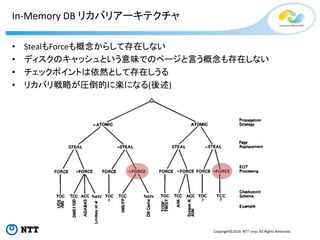
• StealもForceも概念からして存在しない
• ディスクのキャッシュという意味でのページと言う概念も存在しない
• チェックポイントは依然として存在しうる
• リカバリ戦略が圧倒的に楽になる(後述)
Copyright©2016 NTT corp. All Rights Reserved.
In-Memory DBのアドバンテージ
• メモリ上のデータレイアウトは必ずしもディスク上のものと対応しなくてもよく
なった→MassTree等の新しいデータ構造
• Stealが無くなったので、実行中のトランザクションがコミットまでログを書く必
要が無くなった(コミット時にLogをForceすればよい)
• 個々のログエントリの為にLSN(ログシーケンスナンバー)というユニークなIDを発
行するコストが要らなくなった
• 単一の単調増加する値をロックで守っていたのでボトルネックになりがちだった
• 従って、1トランザクション毎に1つIDがあればログが事足りるようになった
• Redoログにトランザクションの順序を表すIDが付いていればそれでよい
• 更にそのIDの発行も高速化したい →Silo
• ログの書き出しも並列化したい →Silo
Copyright©2016 NTT corp. All Rights Reserved.
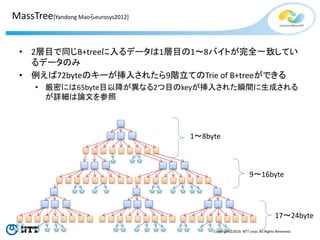
MassTree[Yandong Maoらeurosys2012]
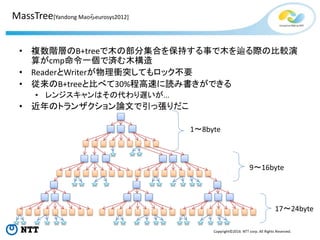
• 複数階層のB+treeで木の部分集合を保持する事で木を辿る際の比較演
算がcmp命令一個で済む木構造
• ReaderとWriterが物理衝突してもロック不要
• 従来のB+treeと比べて30%程高速に読み書きができる
• レンジスキャンはその代わり遅いが...
• 近年のトランザクション論文で引っ張りだこ
1~8byte
9~16byte
17~24byte
Copyright©2016 NTT corp. All Rights Reserved.
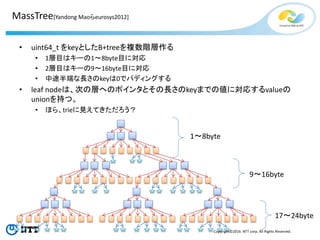
• uint64_t をkeyとしたB+treeを複数階層作る
• 1層目はキーの1~8byte目に対応
• 2層目はキーの9~16byte目に対応
• 中途半端な長さのkeyは0でパディングする
• leaf nodeは、次の層へのポインタとその長さのkeyまでの値に対応するvalueの
unionを持つ。
• ほら、trieに見えてきただろう?
1~8byte
9~16byte
17~24byte
MassTree[Yandong Maoらeurosys2012]
Copyright©2016 NTT corp. All Rights Reserved.
• 2層目で同じB+treeに入るデータは1層目の1~8バイトが完全一致してい
るデータのみ
• 例えば72byteのキーが挿入されたら9階立てのTrie of B+treeができる
• 厳密には65byte目以降が異なる2つ目のkeyが挿入された瞬間に生成される
が詳細は論文を参照
1~8byte
9~16byte
17~24byte
MassTree[Yandong Maoらeurosys2012]
Copyright©2016 NTT corp. All Rights Reserved.
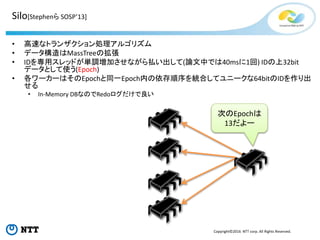
Silo[Stephenら SOSP’13]
• 高速なトランザクション処理アルゴリズム
• データ構造はMassTreeの拡張
• IDを専用スレッドが単調増加させながら払い出して(論文中では40msに1回) IDの上32bit
データとして使う(Epoch)
• 各ワーカーはそのEpochと同一Epoch内の依存順序を統合してユニークな64bitのIDを作り出
せる
• In-Memory DBなのでRedoログだけで良い
次のEpochは
13だよー
Copyright©2016 NTT corp. All Rights Reserved.
• MassTreeがOptimisticな一貫性制御をしているので、それを拡張する形で
Optimisticなトランザクションを設計
• Optimistic Concurrency Control(OCC)自体は [1981 Kung, H.T. ら On Optimistic
Methods for Concurrency Control]まで遡る
• …もっと昔からあったような気がする
• トランザクション実行中は共有データを一切汚さずに実行し最後に5ステップ
の処理をする(詳細は次のページ以降)
1. Write Lock
• 書き込み対象をロックしてここでTIDを生成
2. Read Validation
• バージョン番号をReadSetと比較する
3. Write
• メモリに書き込みを行う。書いたデータは即Unlockして良い。
4. Durable Write
• ログに書き込みを行う。Epoch内の全データが書かれるまで待つ。
5. Return
• ユーザに完了を報告する
Silo[Stephenら SOSP’13]
Copyright©2016 NTT corp. All Rights Reserved.
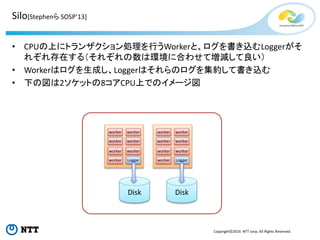
• CPUの上にトランザクション処理を行うWorkerと、ログを書き込むLoggerがそ
れぞれ存在する(それぞれの数は環境に合わせて増減して良い)
• Workerはログを生成し、Loggerはそれらのログを集約して書き込む
• 下の図は2ソケットの8コアCPU上でのイメージ図
worker
worker
worker
worker
worker
worker
worker
Logger
worker
worker
worker
worker
worker
worker
worker
Logger
Disk Disk
Silo[Stephenら SOSP’13]
Copyright©2016 NTT corp. All Rights Reserved.
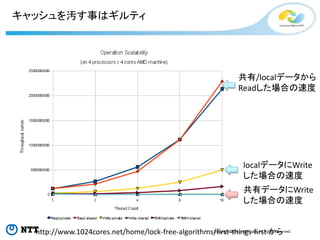
キャッシュを汚す事はギルティ
http://www.1024cores.net/home/lock-free-algorithms/first-things-first から
共有データにWrite
した場合の速度
localデータにWrite
した場合の速度
共有/localデータから
Readした場合の速度
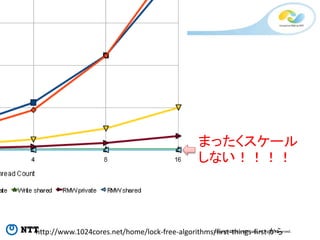
Copyright©2016 NTT corp. All Rights Reserved.http://www.1024cores.net/home/lock-free-algorithms/first-things-first から
まったくスケール
しない!!!!
Copyright©2016 NTT corp. All Rights Reserved.
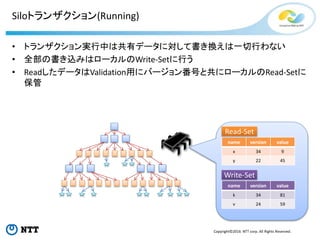
Siloトランザクション(Running)
• トランザクション実行中は共有データに対して書き換えは一切行わない
• 全部の書き込みはローカルのWrite-Setに行う
• ReadしたデータはValidation用にバージョン番号と共にローカルのRead-Setに
保管
Read-Set
name version value
x 34 9
y 22 45
Write-Set
name version value
k 34 81
v 24 59
Copyright©2016 NTT corp. All Rights Reserved.
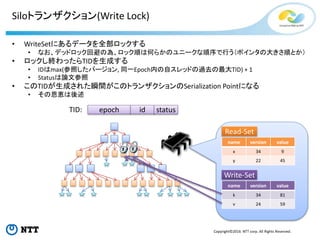
Siloトランザクション(Write Lock)
• WriteSetにあるデータを全部ロックする
• なお、デッドロック回避の為、ロック順は何らかのユニークな順序で行う(ポインタの大きさ順とか)
• ロックし終わったらTIDを生成する
• IDはmax(参照したバージョン, 同一Epoch内の自スレッドの過去の最大TID) + 1
• Statusは論文参照
• このTIDが生成された瞬間がこのトランザクションのSerialization Pointになる
• その恩恵は後述
Read-Set
name version value
x 34 9
y 22 45
Write-Set
name version value
k 34 81
v 24 59
epoch id statusTID:
Copyright©2016 NTT corp. All Rights Reserved.
Siloトランザクション(Read Validation)
Read-Set
name version value
x 34 9
y 22 45
Write-Set
name version value
k 34 81
v 24 59
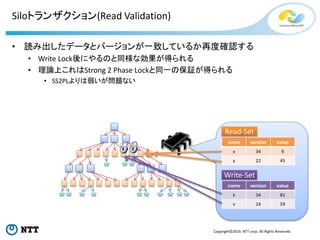
• 読み出したデータとバージョンが一致しているか再度確認する
• Write Lock後にやるのと同様な効果が得られる
• 理論上これはStrong 2 Phase Lockと同一の保証が得られる
• SS2PLよりは弱いが問題ない
Copyright©2016 NTT corp. All Rights Reserved.
Siloトランザクション(Write)
Redo Log
name version value
k 35 81
v 35 59
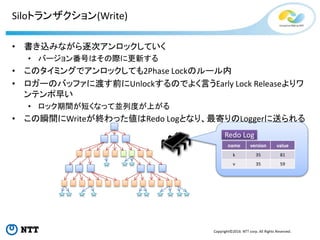
• 書き込みながら逐次アンロックしていく
• バージョン番号はその際に更新する
• このタイミングでアンロックしても2Phase Lockのルール内
• ロガーのバッファに渡す前にUnlockするのでよく言うEarly Lock Releaseよりワ
ンテンポ早い
• ロック期間が短くなって並列度が上がる
• この瞬間にWriteが終わった値はRedo Logとなり、最寄りのLoggerに送られる
Copyright©2016 NTT corp. All Rights Reserved.
Silo[Stephenら SOSP’13]
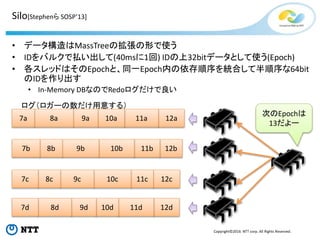
• データ構造はMassTreeの拡張の形で使う
• IDをバルクで払い出して(40msに1回) IDの上32bitデータとして使う(Epoch)
• 各スレッドはそのEpochと、同一Epoch内の依存順序を統合して半順序な64bit
のIDを作り出す
• In-Memory DBなのでRedoログだけで良い
次のEpochは
13だよー
12a
12b
12c
12d11d10d9d8d
11c
7d
11b10b9b8b7b
11a10a9a8a7a
10c9c8c7c
ログ(ロガーの数だけ用意する)
Copyright©2016 NTT corp. All Rights Reserved.
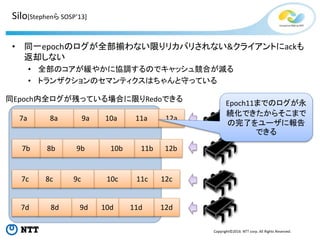
• 同一epochのログが全部揃わない限りリカバリされない&クライアントにackも
返却しない
• 全部のコアが緩やかに協調するのでキャッシュ競合が減る
• トランザクションのセマンティクスはちゃんと守っている
同Epoch内全ログが残っている場合に限りRedoできる
Silo[Stephenら SOSP’13]
12a
12b
12c
12d11d10d9d8d
11c
7d
11b10b9b8b7b
11a10a9a8a7a
10c9c8c7c
Epoch11までのログが永
続化できたからそこまで
の完了をユーザに報告
できる
Copyright©2016 NTT corp. All Rights Reserved.
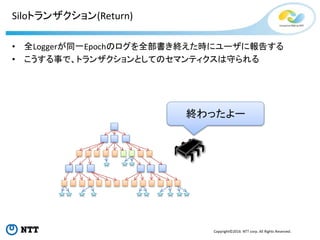
Siloトランザクション(Return)
• 全Loggerが同一Epochのログを全部書き終えた時にユーザに報告する
• こうする事で、トランザクションとしてのセマンティクスは守られる
終わったよー
Copyright©2016 NTT corp. All Rights Reserved.
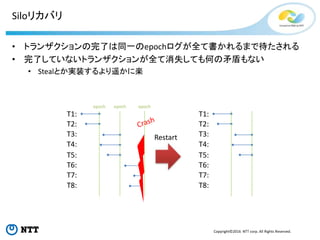
Siloリカバリ
• トランザクションの完了は同一のepochログが全て書かれるまで待たされる
• 完了していないトランザクションが全て消失しても何の矛盾もない
• Stealとか実装するより遥かに楽
T1:
T2:
T3:
T4:
T5:
T6:
T7:
T8:
Restart
T1:
T2:
T3:
T4:
T5:
T6:
T7:
T8:
epoch epoch epoch
Copyright©2016 NTT corp. All Rights Reserved.
In-Memory DB と Hybrid In-Memory DB
• SiloはPureなIn-Memory DB
• 再起動時はRedoログから完全なMassTree構造が復旧できるから永続化はできて
いる
• ログをまとめて木構造を作ってスナップショットにすれば高速になると論文中では
言っているが具体的な方法は未言及
• 商用DBとしてPureなIn-Memory DBは、どうやらSAP HANA?
• 永続性はもちろんちゃんと作り込んである様子
• メモリ内で圧縮する事で大きなデータも入る
• 最近の実装でどうなっているかは知らない…
• でもやっぱりディスクにもDB本体を入れたいという要望は根強い
Copyright©2016 NTT corp. All Rights Reserved.
Hybrid In-Memory DB
• Hekaton(SQL Server)
• ページという単位にデータ構造が縛られなくなったのでアグレッシブな最適化が
いくつも搭載されている
• 厳密にはDiskも併用しているが、どう併用しているかは未調査
• Anti-Caching(H-store)
• Stonebraker先生の研究室で作られたOLTP用ストレージエンジン
• Indexとキーだけをすべてmemoryに持ち、残りはDiskに書き出す
• テーブルを各コアに割り当てるためにテーブルを水平に切り分割統治
• Index数がそもそも巨大なデータに対してどうするつもりなのか…?
• Siberia
• Hekatonの改良の一つ。使われていない行をまるっとディスクに書き出してブルー
ムフィルタで存在を管理する
• ディスクに書き出したデータだけ列指向型に書き換える等ができる
• OLTPとOLAP両方に速いと主張
• ブルームフィルタ含むメタデータが巨大になるのでは…?
Copyright©2016 NTT corp. All Rights Reserved.
FOEDUS[H. Kimuraら SIGMOD 2015]
• レイテンシが低くてスループットが高いNVRAM向けに最適化
• Siloをベースにした楽観的並行制御
• Siloをベースにした並列ログとリカバリプロトコル
• グローバルカウンタが排除されてスケーラビリティ向上
• Log Gleanerによるスナップショットの並列作成
• Dual PageによるMemoryとNVMの連携
• NVMのデータが常にどこかの瞬間のフルスナップショットになる
• Snapshot Isolationレベルで良いトランザクションはNVMを読めば良い
• Split時のRetryコストを下げるMasterTreeと新しいコミットプロトコルによる低い
Abort率
Copyright©2016 NTT corp. All Rights Reserved.
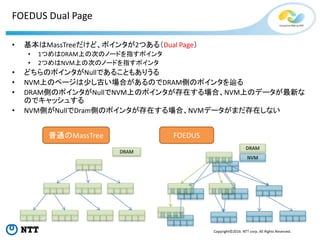
FOEDUS Dual Page
• 基本はMassTreeだけど、ポインタが2つある(Dual Page)
• 1つめはDRAM上の次のノードを指すポインタ
• 2つめはNVM上の次のノードを指すポインタ
• どちらのポインタがNullであることもありうる
• NVM上のページは少し古い場合があるのでDRAM側のポインタを辿る
• DRAM側のポインタがNullでNVM上のポインタが存在する場合、NVM上のデータが最新な
のでキャッシュする
• NVM側がNullでDram側のポインタが存在する場合、NVMデータがまだ存在しない
普通のMassTree FOEDUS
DRAM
NVM
DRAM
Copyright©2016 NTT corp. All Rights Reserved.
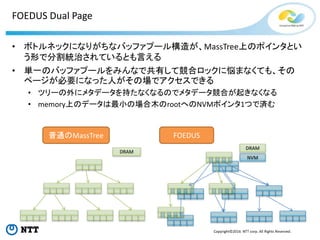
FOEDUS Dual Page
• ボトルネックになりがちなバッファプール構造が、MassTree上のポインタとい
う形で分割統治されているとも言える
• 単一のバッファプールをみんなで共有して競合ロックに悩まなくても、その
ページが必要になった人がその場でアクセスできる
• ツリーの外にメタデータを持たなくなるのでメタデータ競合が起きなくなる
• memory上のデータは最小の場合木のrootへのNVMポインタ1つで済む
普通のMassTree FOEDUS
DRAM
NVM
DRAM
Copyright©2016 NTT corp. All Rights Reserved.
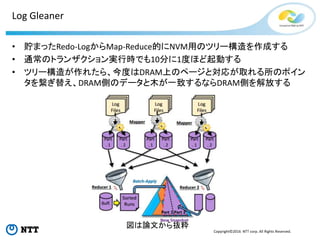
Log Gleaner
• 貯まったRedo-LogからMap-Reduce的にNVM用のツリー構造を作成する
• 通常のトランザクション実行時でも10分に1度ほど起動する
• ツリー構造が作れたら、今度はDRAM上のページと対応が取れる所のポイン
タを繋ぎ替え、DRAM側のデータと木が一致するならDRAM側を解放する
図は論文から抜粋
Copyright©2016 NTT corp. All Rights Reserved.
Log Gleaner
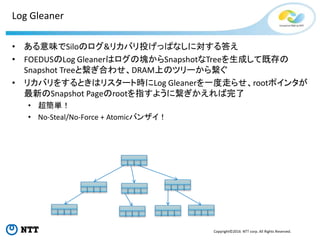
• ある意味でSiloのログ&リカバリ投げっぱなしに対する答え
• FOEDUSのLog Gleanerはログの塊からSnapshotなTreeを生成して既存の
Snapshot Treeと繋ぎ合わせ、DRAM上のツリーから繋ぐ
• リカバリをするときはリスタート時にLog Gleanerを一度走らせ、rootポインタが
最新のSnapshot Pageのrootを指すように繋ぎかえれば完了
• 超簡単!
• No-Steal/No-Force + Atomicバンザイ!
Copyright©2016 NTT corp. All Rights Reserved.
ベンチマーク
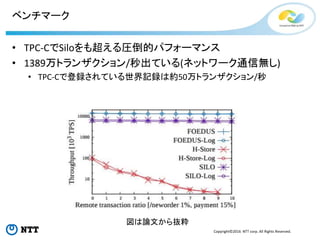
• TPC-CでSiloをも超える圧倒的パフォーマンス
• 1389万トランザクション/秒出ている(ネットワーク通信無し)
• TPC-Cで登録されている世界記録は約50万トランザクション/秒
図は論文から抜粋
Copyright©2016 NTT corp. All Rights Reserved.
NTT Confidential
開示先: 株式会社○○○○
予備スライド
Copyright©2016 NTT corp. All Rights Reserved.
In-Memory DBの世間的な需要
• 想定質問「そんな高性能で誰が欲しがるの?」
• サービスの高度化に伴いExaData等の高速DBの需要は伸びている
• NTTドコモ「ピーク時には300万SQL/秒捌かないといけない」
• NTTドコモの6600万顧客のリアルタイムビリング基盤「MoBills」を支えるデータ
ベース基盤とは
• http://www.atmarkit.co.jp/ait/articles/1601/20/news013_3.html
• 現状でもCassandra等の分散NoSQLエンジンの採用事例が増加している事か
らも「性能が出る永続DB」への需要は常にある
Copyright©2016 NTT corp. All Rights Reserved.
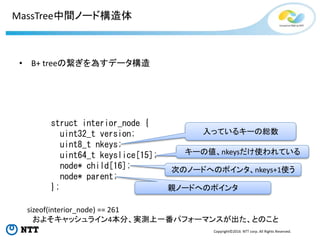
MassTree中間ノード構造体
• B+ treeの繋ぎを為すデータ構造
struct interior_node {
uint32_t version;
uint8_t nkeys;
uint64_t keyslice[15];
node* child[16];
node* parent;
};
入っているキーの総数
キーの値、nkeysだけ使われている
次のノードへのポインタ、nkeys+1使う
親ノードへのポインタ
sizeof(interior_node) == 261
およそキャッシュライン4本分、実測上一番パフォーマンスが出た、とのこと
Copyright©2016 NTT corp. All Rights Reserved.
MassTreeリーフノード構造体
• B+ treeの値を保持する構造体
struct border_node {
uint32_t version;
uint8_t nremoved;
uint8_t keylen[15];
uint64_t permutation;
uint64_t keyslice[15];
link_or_value lv[15];
border_node* next;
border_node* prev;
node* parent;
keysuffix_t suffix;
};
消されたキーの数
n番目のキーの長さ
複雑なので次のページで話す
次のB+treeへのポインタ、もしくは値への
ポインタ。どちらを意味しているかは
keylen[n]の最上位ビットでスイッチ
keysuffixのサイズはadaptivelyに決定するらしいので
それを除くと残りのサイズは286byte、こちらもおよそキャッシュ4本分
n番目のキー
左右及び親へのポインタ
Copyright©2016 NTT corp. All Rights Reserved.
permutation
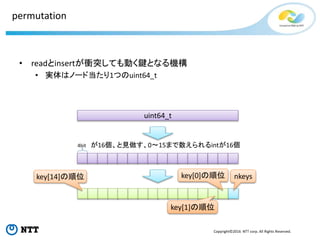
• readとinsertが衝突しても動く鍵となる機構
• 実体はノード当たり1つのuint64_t
uint64_t
4bit が16個、と見做す、0~15まで数えられるintが16個
nkeyskey[0]の順位
key[1]の順位
key[14]の順位
Copyright©2016 NTT corp. All Rights Reserved.
permutation
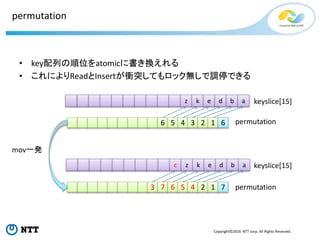
• key配列の順位をatomicに書き換えれる
• これによりReadとInsertが衝突してもロック無しで調停できる
z k e d b a keyslice[15]
6 5 4 3 2 1 6 permutation
keyslice[15]
3 7 6 5 4 2 1 7 permutation
c z k e d b a
mov一発