Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
NI
Uploaded by
NTT DATA Technology & Innovation
11,701 views
今こそ知りたいSpring Batch(Spring Fest 2020講演資料)
今こそ知りたいSpring Batch (Spring Fest 2020講演資料) 2020年12月17日 株式会社NTTデータ 公共・社会基盤事業推進部 橋本 直樹
Technology
◦
Read more
4
Save
Share
Embed
1
/ 53
2
/ 53
3
/ 53
4
/ 53
5
/ 53
6
/ 53
7
/ 53
8
/ 53
9
/ 53
10
/ 53
11
/ 53
12
/ 53
13
/ 53
14
/ 53
15
/ 53
Most read
16
/ 53
Most read
17
/ 53
18
/ 53
19
/ 53
20
/ 53
More Related Content
PDF
これからSpringを使う開発者が知っておくべきこと
by
土岐 孝平
32 slides
27.3K views
PDF
JVMのGCアルゴリズムとチューニング
by
佑哉 廣岡
96 slides
23.4K views
PPTX
モノリスからマイクロサービスへの移行 ~ストラングラーパターンの検証~(Spring Fest 2020講演資料)
by
NTT DATA Technology & Innovation
68 slides
5.8K views
PDF
Serverless時代のJavaについて
by
Amazon Web Services Japan
90 slides
13.6K views
PPTX
システム間連携を担うSpring Integrationのエンタープライズ開発での活用
by
apkiban
61 slides
6.5K views
PPTX
トランザクションの設計と進化
by
Kumazaki Hiroki
61 slides
74.5K views
PDF
入社1年目のプログラミング初心者がSpringを学ぶための手引き
by
土岐 孝平
60 slides
28.6K views
PDF
PostgreSQLの行レベルセキュリティと SpringAOPでマルチテナントの ユーザー間情報漏洩を防止する (JJUG CCC 2021 Spring)
by
Koichiro Matsuoka
73 slides
16.5K views
これからSpringを使う開発者が知っておくべきこと
by
土岐 孝平
32 slides
27.3K views
JVMのGCアルゴリズムとチューニング
by
佑哉 廣岡
96 slides
23.4K views
モノリスからマイクロサービスへの移行 ~ストラングラーパターンの検証~(Spring Fest 2020講演資料)
by
NTT DATA Technology & Innovation
68 slides
5.8K views
Serverless時代のJavaについて
by
Amazon Web Services Japan
90 slides
13.6K views
システム間連携を担うSpring Integrationのエンタープライズ開発での活用
by
apkiban
61 slides
6.5K views
トランザクションの設計と進化
by
Kumazaki Hiroki
61 slides
74.5K views
入社1年目のプログラミング初心者がSpringを学ぶための手引き
by
土岐 孝平
60 slides
28.6K views
PostgreSQLの行レベルセキュリティと SpringAOPでマルチテナントの ユーザー間情報漏洩を防止する (JJUG CCC 2021 Spring)
by
Koichiro Matsuoka
73 slides
16.5K views
What's hot
PDF
SQLアンチパターン 幻の第26章「とりあえず削除フラグ」
by
Takuto Wada
45 slides
174.7K views
PDF
怖くないSpring Bootのオートコンフィグレーション
by
土岐 孝平
39 slides
5.3K views
PDF
イミュータブルデータモデル(入門編)
by
Yoshitaka Kawashima
24 slides
197.2K views
PPTX
ぱぱっと理解するSpring Cloudの基本
by
kazuki kumagai
94 slides
21K views
PDF
ツール比較しながら語る O/RマッパーとDBマイグレーションの実際のところ
by
Y Watanabe
78 slides
17.9K views
PDF
SQLアンチパターン - 開発者を待ち受ける25の落とし穴 (拡大版)
by
Takuto Wada
89 slides
74.2K views
PDF
Where狙いのキー、order by狙いのキー
by
yoku0825
109 slides
44.9K views
PDF
Javaコードが速く実⾏される秘密 - JITコンパイラ⼊⾨(JJUG CCC 2020 Fall講演資料)
by
NTT DATA Technology & Innovation
84 slides
3.6K views
PPTX
Kafkaを活用するためのストリーム処理の基本
by
Sotaro Kimura
22 slides
8.5K views
PDF
例外設計における大罪
by
Takuto Wada
37 slides
76.9K views
PPTX
RLSを用いたマルチテナント実装 for Django
by
Takayuki Shimizukawa
49 slides
13.1K views
PDF
RDF Semantic Graph「RDF 超入門」
by
オラクルエンジニア通信
100 slides
11K views
PDF
イミュータブルデータモデル(世代編)
by
Yoshitaka Kawashima
16 slides
40.7K views
PPTX
KeycloakでAPI認可に入門する
by
Hitachi, Ltd. OSS Solution Center.
49 slides
5.1K views
PDF
マイクロにしすぎた結果がこれだよ!
by
mosa siru
32 slides
141K views
PDF
3分でわかるAzureでのService Principal
by
Toru Makabe
14 slides
31.7K views
PDF
オブジェクト指向できていますか?
by
Moriharu Ohzu
129 slides
243.2K views
PDF
Fluentdのお勧めシステム構成パターン
by
Kentaro Yoshida
43 slides
51.8K views
PDF
Cognitive Complexity でコードの複雑さを定量的に計測しよう
by
Shuto Suzuki
31 slides
12.2K views
PPTX
MongoDBが遅いときの切り分け方法
by
Tetsutaro Watanabe
46 slides
37.2K views
SQLアンチパターン 幻の第26章「とりあえず削除フラグ」
by
Takuto Wada
45 slides
174.7K views
怖くないSpring Bootのオートコンフィグレーション
by
土岐 孝平
39 slides
5.3K views
イミュータブルデータモデル(入門編)
by
Yoshitaka Kawashima
24 slides
197.2K views
ぱぱっと理解するSpring Cloudの基本
by
kazuki kumagai
94 slides
21K views
ツール比較しながら語る O/RマッパーとDBマイグレーションの実際のところ
by
Y Watanabe
78 slides
17.9K views
SQLアンチパターン - 開発者を待ち受ける25の落とし穴 (拡大版)
by
Takuto Wada
89 slides
74.2K views
Where狙いのキー、order by狙いのキー
by
yoku0825
109 slides
44.9K views
Javaコードが速く実⾏される秘密 - JITコンパイラ⼊⾨(JJUG CCC 2020 Fall講演資料)
by
NTT DATA Technology & Innovation
84 slides
3.6K views
Kafkaを活用するためのストリーム処理の基本
by
Sotaro Kimura
22 slides
8.5K views
例外設計における大罪
by
Takuto Wada
37 slides
76.9K views
RLSを用いたマルチテナント実装 for Django
by
Takayuki Shimizukawa
49 slides
13.1K views
RDF Semantic Graph「RDF 超入門」
by
オラクルエンジニア通信
100 slides
11K views
イミュータブルデータモデル(世代編)
by
Yoshitaka Kawashima
16 slides
40.7K views
KeycloakでAPI認可に入門する
by
Hitachi, Ltd. OSS Solution Center.
49 slides
5.1K views
マイクロにしすぎた結果がこれだよ!
by
mosa siru
32 slides
141K views
3分でわかるAzureでのService Principal
by
Toru Makabe
14 slides
31.7K views
オブジェクト指向できていますか?
by
Moriharu Ohzu
129 slides
243.2K views
Fluentdのお勧めシステム構成パターン
by
Kentaro Yoshida
43 slides
51.8K views
Cognitive Complexity でコードの複雑さを定量的に計測しよう
by
Shuto Suzuki
31 slides
12.2K views
MongoDBが遅いときの切り分け方法
by
Tetsutaro Watanabe
46 slides
37.2K views
Similar to 今こそ知りたいSpring Batch(Spring Fest 2020講演資料)
PDF
20170525 jsug バッチは地味だが役に立つ
by
Yuichi Hasegawa
72 slides
6.4K views
PPTX
バッチは地味だが役に立つ
by
apkiban
72 slides
3K views
PPTX
Batchは作ったことあるけど、 初めてSpring Batchを使ってみた
by
Hideyuki SASAKURA
72 slides
1.4K views
PDF
Jbatch実践入門 #jdt2015
by
Norito Agetsuma
73 slides
14.3K views
PDF
Java Batch 仕様 (Public Review時点)
by
Norito Agetsuma
73 slides
34.3K views
PDF
新しいTERASOLUNA Batch Frameworkとは
by
apkiban
49 slides
1.7K views
PDF
20160215 04 java ee7徹底入門 jbatch
by
Jun Inose
31 slides
4.4K views
PDF
Spring “BigData”
by
Recruit Technologies
32 slides
1.2K views
PDF
JSR 352 “Batch Applications for the Java Platform”
by
Norito Agetsuma
97 slides
13.9K views
PDF
JJavaプログラム実行の仕組みと、高速・安定動作に向けた取り組み
by
日本Javaユーザーグループ
60 slides
5.9K views
PPTX
Spring 5に備えるリアクティブプログラミング入門
by
Takuya Iwatsuka
88 slides
32.1K views
PDF
ストリームデータ分散処理基盤Storm
by
NTT DATA OSS Professional Services
62 slides
34.6K views
PPTX
今こそ知りたいSpring Web(Spring Fest 2020講演資料)
by
NTT DATA Technology & Innovation
55 slides
1.5K views
PDF
IoT時代におけるストリームデータ処理と急成長の Apache Flink
by
Takanori Suzuki
41 slides
28.4K views
PPTX
Containers + EC2 Spot: AWS Batch による大規模バッチ処理でのスポットインスタンス活用
by
Daisuke Miyamoto
35 slides
4.5K views
PDF
Spark SQL - The internal -
by
NTT DATA OSS Professional Services
63 slides
5.5K views
20170525 jsug バッチは地味だが役に立つ
by
Yuichi Hasegawa
72 slides
6.4K views
バッチは地味だが役に立つ
by
apkiban
72 slides
3K views
Batchは作ったことあるけど、 初めてSpring Batchを使ってみた
by
Hideyuki SASAKURA
72 slides
1.4K views
Jbatch実践入門 #jdt2015
by
Norito Agetsuma
73 slides
14.3K views
Java Batch 仕様 (Public Review時点)
by
Norito Agetsuma
73 slides
34.3K views
新しいTERASOLUNA Batch Frameworkとは
by
apkiban
49 slides
1.7K views
20160215 04 java ee7徹底入門 jbatch
by
Jun Inose
31 slides
4.4K views
Spring “BigData”
by
Recruit Technologies
32 slides
1.2K views
JSR 352 “Batch Applications for the Java Platform”
by
Norito Agetsuma
97 slides
13.9K views
JJavaプログラム実行の仕組みと、高速・安定動作に向けた取り組み
by
日本Javaユーザーグループ
60 slides
5.9K views
Spring 5に備えるリアクティブプログラミング入門
by
Takuya Iwatsuka
88 slides
32.1K views
ストリームデータ分散処理基盤Storm
by
NTT DATA OSS Professional Services
62 slides
34.6K views
今こそ知りたいSpring Web(Spring Fest 2020講演資料)
by
NTT DATA Technology & Innovation
55 slides
1.5K views
IoT時代におけるストリームデータ処理と急成長の Apache Flink
by
Takanori Suzuki
41 slides
28.4K views
Containers + EC2 Spot: AWS Batch による大規模バッチ処理でのスポットインスタンス活用
by
Daisuke Miyamoto
35 slides
4.5K views
Spark SQL - The internal -
by
NTT DATA OSS Professional Services
63 slides
5.5K views
More from NTT DATA Technology & Innovation
PDF
Apache Sparkのログ解析に苦しむ人々へ届けたい 〜AIによるボトルネック診断と Apache Icebergでの蓄積と再利用〜 (Open So...
by
NTT DATA Technology & Innovation
50 slides
8 views
PDF
言われてみたらこういうの欲しいとか思わないですか?え、思う?そうですよね!〜DebeziumとKafkaで実現するフルOSSのChange Data Ca...
by
NTT DATA Technology & Innovation
31 slides
34 views
PDF
PostgreSQLでデータレイクの選択肢 -pg_duckdb/pg_lake-(オープンソースカンファレンス2026 Kagawa)
by
NTT DATA Technology & Innovation
29 slides
114 views
PDF
JEP 529 Vector API (Eleventh Incubator) (JJUGナイトセミナー)
by
NTT DATA Technology & Innovation
23 slides
40 views
PDF
TIDを使ったスキャン ( 第56回 PostgreSQLアンカンファレンス )
by
NTT DATA Technology & Innovation
16 slides
77 views
PDF
Kubernetesネイティブな Gang Schedulingを試してみた (Open Source Conference 2026 Tokyo/Spr...
by
NTT DATA Technology & Innovation
63 slides
95 views
PDF
強化されたEKSのオブザーバビリティ(AWS re:Invent 2025 re:cap LT 大会 発表資料)
by
NTT DATA Technology & Innovation
12 slides
53 views
PDF
基礎から学ぶ PostgreSQL の性能監視 (PostgreSQL Conference Japan 2025 発表資料)
by
NTT DATA Technology & Innovation
62 slides
338 views
PDF
SAFe実践から見えた、フレームワークより大切な組織変革の道程(Scrum Fest Sendai 2025 発表資料)
by
NTT DATA Technology & Innovation
94 slides
431 views
PDF
開発中の新機能 Spark Declarative Pipeline に飛びついてみたが難しかった(JEDAI DAIS Recap#2 講演資料)
by
NTT DATA Technology & Innovation
36 slides
282 views
PDF
PostgreSQL18新機能紹介(db tech showcase 2025 発表資料)
by
NTT DATA Technology & Innovation
22 slides
490 views
PDF
PGConf.dev 2025 参加レポート (JPUG総会併設セミナー2025 発表資料)
by
NTT DATA Technology & Innovation
51 slides
356 views
PDF
Can We Use Rust to Develop Extensions for PostgreSQL? (POSETTE: An Event for ...
by
NTT DATA Technology & Innovation
35 slides
525 views
PDF
つくって壊して直して学ぶ Database on Kubernetes (CloudNative Days Summer 2025 発表資料)
by
NTT DATA Technology & Innovation
52 slides
1.2K views
PDF
2025年現在のNewSQL (最強DB講義 #36 発表資料)
by
NTT DATA Technology & Innovation
55 slides
11.4K views
PDF
Java in Japan: A Journey of Community, Culture, and Global Integration (JavaO...
by
NTT DATA Technology & Innovation
54 slides
285 views
PDF
Unveiling the Hidden Layers of Java Class Files: Beyond Bytecode (Devnexus 2025)
by
NTT DATA Technology & Innovation
66 slides
233 views
PDF
論理レプリケーションのアーキテクチャ (第52回 PostgreSQLアンカンファレンス@オンライン 発表資料)
by
NTT DATA Technology & Innovation
16 slides
333 views
PDF
実はアナタの身近にある!? Linux のチェックポイント/レストア機能 (NTT Tech Conference 2025 発表資料)
by
NTT DATA Technology & Innovation
41 slides
471 views
PDF
Apache Sparkに対するKubernetesのNUMAノードを意識したリソース割り当ての性能効果 (Open Source Conference ...
by
NTT DATA Technology & Innovation
35 slides
475 views
Apache Sparkのログ解析に苦しむ人々へ届けたい 〜AIによるボトルネック診断と Apache Icebergでの蓄積と再利用〜 (Open So...
by
NTT DATA Technology & Innovation
50 slides
8 views
言われてみたらこういうの欲しいとか思わないですか?え、思う?そうですよね!〜DebeziumとKafkaで実現するフルOSSのChange Data Ca...
by
NTT DATA Technology & Innovation
31 slides
34 views
PostgreSQLでデータレイクの選択肢 -pg_duckdb/pg_lake-(オープンソースカンファレンス2026 Kagawa)
by
NTT DATA Technology & Innovation
29 slides
114 views
JEP 529 Vector API (Eleventh Incubator) (JJUGナイトセミナー)
by
NTT DATA Technology & Innovation
23 slides
40 views
TIDを使ったスキャン ( 第56回 PostgreSQLアンカンファレンス )
by
NTT DATA Technology & Innovation
16 slides
77 views
Kubernetesネイティブな Gang Schedulingを試してみた (Open Source Conference 2026 Tokyo/Spr...
by
NTT DATA Technology & Innovation
63 slides
95 views
強化されたEKSのオブザーバビリティ(AWS re:Invent 2025 re:cap LT 大会 発表資料)
by
NTT DATA Technology & Innovation
12 slides
53 views
基礎から学ぶ PostgreSQL の性能監視 (PostgreSQL Conference Japan 2025 発表資料)
by
NTT DATA Technology & Innovation
62 slides
338 views
SAFe実践から見えた、フレームワークより大切な組織変革の道程(Scrum Fest Sendai 2025 発表資料)
by
NTT DATA Technology & Innovation
94 slides
431 views
開発中の新機能 Spark Declarative Pipeline に飛びついてみたが難しかった(JEDAI DAIS Recap#2 講演資料)
by
NTT DATA Technology & Innovation
36 slides
282 views
PostgreSQL18新機能紹介(db tech showcase 2025 発表資料)
by
NTT DATA Technology & Innovation
22 slides
490 views
PGConf.dev 2025 参加レポート (JPUG総会併設セミナー2025 発表資料)
by
NTT DATA Technology & Innovation
51 slides
356 views
Can We Use Rust to Develop Extensions for PostgreSQL? (POSETTE: An Event for ...
by
NTT DATA Technology & Innovation
35 slides
525 views
つくって壊して直して学ぶ Database on Kubernetes (CloudNative Days Summer 2025 発表資料)
by
NTT DATA Technology & Innovation
52 slides
1.2K views
2025年現在のNewSQL (最強DB講義 #36 発表資料)
by
NTT DATA Technology & Innovation
55 slides
11.4K views
Java in Japan: A Journey of Community, Culture, and Global Integration (JavaO...
by
NTT DATA Technology & Innovation
54 slides
285 views
Unveiling the Hidden Layers of Java Class Files: Beyond Bytecode (Devnexus 2025)
by
NTT DATA Technology & Innovation
66 slides
233 views
論理レプリケーションのアーキテクチャ (第52回 PostgreSQLアンカンファレンス@オンライン 発表資料)
by
NTT DATA Technology & Innovation
16 slides
333 views
実はアナタの身近にある!? Linux のチェックポイント/レストア機能 (NTT Tech Conference 2025 発表資料)
by
NTT DATA Technology & Innovation
41 slides
471 views
Apache Sparkに対するKubernetesのNUMAノードを意識したリソース割り当ての性能効果 (Open Source Conference ...
by
NTT DATA Technology & Innovation
35 slides
475 views
今こそ知りたいSpring Batch(Spring Fest 2020講演資料)
1.
© 2020 NTT
DATA Corporation 今こそ知りたいSpring Batch 2020/12/17 株式会社NTTデータ 公共・社会基盤事業推進部 橋本 直樹
2.
© 2020 NTT
DATA Corporation 2 0.はじめに -自己紹介- 橋本 直樹(Naoki Hashimoto) 株式会社NTTデータ 公共・社会基盤事業推進部 プロジェクト推進統括部 技術戦略担当 シニア・エキスパート • 開発経験 • 主に、Spring Framework(TERASOLUNA Framework)を用いたWebアプリケーション 開発 • OAuth2.0の仕様に沿った、API認可アプリケーション開発 • Spring Security OAuth(現在は、SpringSecurity5に統合)で実装 • 最近の開発 • AWS上のコンテナ環境で動作するSpring Batchアプリケーション開発
3.
© 2020 NTT
DATA Corporation 3 0.はじめに -想定聴講者- • これから、バッチアプリケーションを開発しなければならないが、そもそもバッチっ てなに? • Spring FrameworkでWebアプリを作ったことはあるけど、Spring Batch はつかったことがない・・・ ※サンプルコードはSpring Boot前提となります • Spring Batchのことは知ってるけど、アーキテクチャとかよくわからないし、使い 方もよくわからない・・・
4.
© 2020 NTT
DATA Corporation 4 アジェンダ 1. バッチ処理とは? 2. Spring Batchとは? 3. Spring Batchのアーキテクチャ 【基本編】 – ジョブの構成(Job、Step) – ビジネスロジックの実装(Tasklet、Chunk) – ジョブの起動 – ジョブ実行管理 【応用編】 – ジョブの再実行方式(リラン、リスタート) – フロー制御 – 並列処理 – 多重処理 4. クラウド環境でのSpring Batch (SpringBatchのアーキテクチャ 【番外編】) 5. さいごに
5.
© 2020 NTT
DATA Corporation バッチ処理とは? Spring Batchとは?
6.
© 2020 NTT
DATA Corporation 6 1.バッチ処理とは? ~バッチ処理の定義~ • データ処理におけるバッチ処理は、ひとまとまりのデータを一括して処理する 方式である • 逐次生み出されるデータを一定期間・一定量集めたものをバッチといい、この バッチ単位で処理をおこなう方式がバッチ処理である ※バッチ処理, Wikipedia, https://tinyurl.com/y43v4ulr, (参照2020-11-25)
7.
© 2020 NTT
DATA Corporation 7 1.バッチ処理とは? ~バッチ処理パターン~ • パターン1 あらかじめ登録した一連の処理を自動的に実行する処理方式(※処理 量は大小様々) • スケジュール起動 • イベント起動(ファイル格納等) • オンラインディレード(REST API起動) 企業等の業務システムではこちらのパターンであることが多い • パターン2 大量データに対する処理といった重い処理を、一括して実施する 大規模シミュレーターやAIの機械学習等
8.
© 2020 NTT
DATA Corporation 8 2.Spring Batchとは? • Spring Frameworkをベースとした、バッチアプリケーションを開発するためのアプリケーショ ンフレームワーク • 以下の機能を提供 処理の流れを定型化(tasklet、chunk) 様々なジョブ起動方式(コマンドライン、キュー等) 様々なデータ形式への入出力(ファイル、データべース等) ジョブの実行管理(実行状態管理、ジョブの再実行等) 処理の効率化(多重実行、並列実行等) ※Spring Batchのアーキテクチャ, TERASOLUNA Batch Framework for Java (5.x) Development Guideline,https://tinyurl.com/y5x477hg, (参照2020-11-25)
9.
© 2020 NTT
DATA Corporation Spring Batchのアーキテクチャ 【基本編】
10.
© 2020 NTT
DATA Corporation 10 3.Spring Batchのアーキテクチャ -ジョブの構成- Job1 Step1 Step2 StepN ・・・ JobRepository ・・・ JobN JobLauncher(or JobOperator)
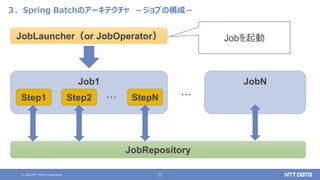
11.
© 2020 NTT
DATA Corporation 11 3.Spring Batchのアーキテクチャ -ジョブの構成- Job1 Step1 Step2 StepN ・・・ JobRepository ・・・ JobN JobLauncher(or JobOperator) Jobを起動
12.
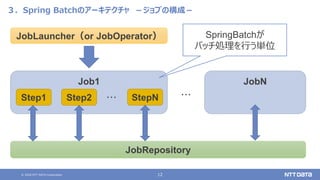
© 2020 NTT
DATA Corporation 12 3.Spring Batchのアーキテクチャ -ジョブの構成- Job1 Step1 Step2 StepN ・・・ JobRepository ・・・ JobN JobLauncher(or JobOperator) SpringBatchが バッチ処理を行う単位
13.
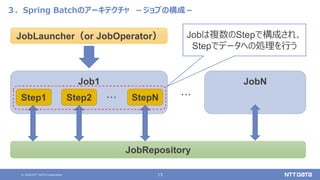
© 2020 NTT
DATA Corporation 13 3.Spring Batchのアーキテクチャ -ジョブの構成- Job1 Step1 Step2 StepN ・・・ JobRepository ・・・ JobN JobLauncher(or JobOperator) Jobは複数のStepで構成され、 Stepでデータへの処理を行う
14.
© 2020 NTT
DATA Corporation 14 3.Spring Batchのアーキテクチャ -ジョブの構成- Job1 Step1 Step2 StepN ・・・ JobRepository ・・・ JobN JobLauncher(or JobOperator) JobRepositoryでJob、Stepの 実行状態を管理する
15.
© 2020 NTT
DATA Corporation 15 3.Spring Batchのアーキテクチャ -ビジネスロジック実装- Chunk • 3つのインターフェースで構成されており、データを読み込み、業務処理、書きこみを実施 • フラットファイル(CSV等)、XMLファイル、JSONファイル、DBアクセスを扱うのを容 易にするために、サポートクラスも用意されている • 処理対象となるデータを1件ずつ処理するのではなく、一定件数のチャンクを単位とする • トランザクションは、チャンク単位の中間コミット方式となる Step ItemReader ItemProcessor ItemWriter Data Chunk Chunk Item Item Item Item
16.
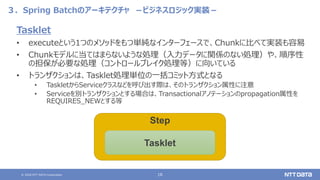
© 2020 NTT
DATA Corporation 16 3.Spring Batchのアーキテクチャ -ビジネスロジック実装- Tasklet • executeという1つのメソッドをもつ単純なインターフェースで、Chunkに比べて実装も容易 • Chunkモデルに当てはまらないような処理(入力データに関係のない処理)や、順序性 の担保が必要な処理(コントロールブレイク処理等)に向いている • トランザクションは、Tasklet処理単位の一括コミット方式となる • TaskletからServiceクラスなどを呼び出す際は、そのトランザクション属性に注意 • Serviceを別トランザクションとする場合は、Transactionalアノテーションのpropagation属性を REQUIRES_NEWとする等 Step Tasklet
17.
© 2020 NTT
DATA Corporation 17 3.Spring Batchのアーキテクチャ -ジョブの構成、ビジネスロジック実装- @Configuration @EnableBatchProcessing public class JobConfig extends DefaultBatchConfigurer { //omitted @Bean public Step step01() { return stepBuilderFactory.get(“step01”).tasklet(tasklet()).build(); } @Bean public Job job() throws Exception { return jobBuilderFactory.get(“job”) .incrementer(new RunIdIncrementer()) .listener(listener()) .start(step01()).build(); } //omitted } Job,Stepのサンプル(Configクラス)※Taskletの場合 Step01を実行するJob Tasklet01を実行する Step SpringBatchを有効にする
18.
© 2020 NTT
DATA Corporation 18 3.Spring Batchのアーキテクチャ -ジョブの構成、ビジネスロジック実装- Job,Stepのサンプル(Configクラス)※Chunkの場合 @Bean public Step step02() { return stepBuilderFactory.get("step02") .<String, String> chunk(10) .reader(itemReader()) .processor(itemProcessor()) .writer(itemWriter()) .build(); } @Bean public Job job() throws Exception { return jobBuilderFactory.get(“job”) .incrementer(new RunIdIncrementer()) .listener(listener()) .start(step02()).build(); } 1つのchunkで扱う アイテム数
19.
© 2020 NTT
DATA Corporation 19 3.Spring Batchのアーキテクチャ -ジョブの起動- • 実行時にジョブを順次起動 • デフォルトでは、Bean定義されたジョブが順次起動される • application.yml等でspring.batch.job.enabled = false とすると無効 • Javaコマンド引数により起動 • ShellScriptなどで、ComandLineJobRunnerを経由して起動する • 引数として、ジョブ起動設定ファイルパスやJobIDを設定する • キュー、DB等をポーリングして非同期実行 • 監視処理を作成し、キューやDBを監視(SpringBatchは監視処理をもっていない) • 監視処理から、JobOperator経由で起動する
20.
© 2020 NTT
DATA Corporation 20 3.Spring Batchのアーキテクチャ -ジョブの起動- Listener • JobやStepの実行前後やエラー発生時に処理を挿入するためのインターフェース • Listenerないで、開始終了ログの出力を行ったりする • 様々なListenerインターフェースがあるが、以下が一般的 • JobExecutionListener • StepExecutionListener • ChunkListener • ItemReadListener、ItemProcessListener、ItemWriteListener
21.
© 2020 NTT
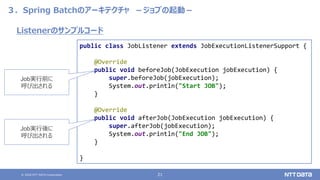
DATA Corporation 21 3.Spring Batchのアーキテクチャ -ジョブの起動- public class JobListener extends JobExecutionListenerSupport { @Override public void beforeJob(JobExecution jobExecution) { super.beforeJob(jobExecution); System.out.println("Start JOB"); } @Override public void afterJob(JobExecution jobExecution) { super.afterJob(jobExecution); System.out.println("End JOB"); } } Listenerのサンプルコード Job実行後に 呼び出される Job実行前に 呼び出される
22.
© 2020 NTT
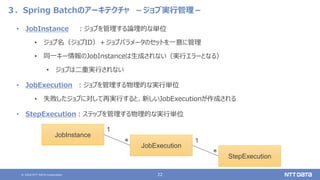
DATA Corporation 22 3.Spring Batchのアーキテクチャ -ジョブ実行管理- • JobInstance :ジョブを管理する論理的な単位 • ジョブ名(ジョブID)+ジョブパラメータのセットを一意に管理 • 同一キー情報のJobInstanceは生成されない(実行エラーとなる) • ジョブは二重実行されない • JobExecution :ジョブを管理する物理的な実行単位 • 失敗したジョブに対して再実行すると、新しいJobExecutionが作成される • StepExecution:ステップを管理する物理的な実行単位 JobInstance JobExecution StepExecution * * 1 1
23.
© 2020 NTT
DATA Corporation 23 3.Spring Batchのアーキテクチャ -ジョブ実行管理- JobRepositoryのメタデータスキーマ • ジョブ実行管理はDB等で実施 • デフォルトではインメモリで管理 • 永続化が必要な場合は、自身でDBと スキーマを用意する必要あり ※付録A:メタデータスキーマ, Spring Batch(Ver.4.3.0) - リファレンスドキュメント, https://tinyurl.com/y6cmdrrd, (参照2020-11-25)
24.
© 2020 NTT
DATA Corporation 24 3.Spring Batchのアーキテクチャ -ジョブ実行管理- ジョブの実行ステータス ステータス 説明 リスタート可否 COMPLETED 実行成功 × FAILED 実行失敗 ○ STARTED 実行中 × STARTING 開始前 × STOPPING 停止待ち × STOPPED 停止 ○ ABANDANED 失敗したが処理完了、再起動時スキップ × UNKNOWN 状態不明 × ※BatchStatus, Spring Batch(Ver.4.3.0) - APIドキュメント, https://spring.pleiades.io/spring-batch/docs/4.3.x/api/, (参照2020-11-25)
25.
© 2020 NTT
DATA Corporation Spring Batchのアーキテクチャ 【応用編】
26.
© 2020 NTT
DATA Corporation 26 3.Spring Batchのアーキテクチャ -ジョブの再実行方式- 再実行方式には大きく分けて、リラン、リスタートの2種類がある • リラン • ジョブを最初からやり直す方式 • Taskletモデルが適している • リスタート • ジョブが中断したところから処理を再開する方式 • 正常に処理できていたものをスキップし、未処理のものから処理を再開 • Chunkモデルが適している
27.
© 2020 NTT
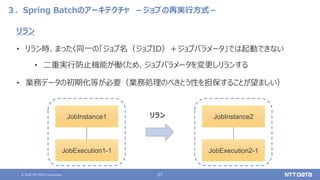
DATA Corporation 27 3.Spring Batchのアーキテクチャ -ジョブの再実行方式- リラン • リラン時、まったく同一の「ジョブ名(ジョブID)+ジョブパラメータ」では起動できない • 二重実行防止機能が働くため、ジョブパラメータを変更しリランする • 業務データの初期化等が必要(業務処理のべきとう性を担保することが望ましい) JobInstance1 JobExecution1-1 リラン JobInstance2 JobExecution2-1
28.
© 2020 NTT
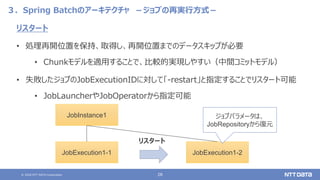
DATA Corporation 28 3.Spring Batchのアーキテクチャ -ジョブの再実行方式- リスタート • 処理再開位置を保持、取得し、再開位置までのデータスキップが必要 • Chunkモデルを適用することで、比較的実現しやすい(中間コミットモデル) • 失敗したジョブのJobExecutionIDに対して「-restart」と指定することでリスタート可能 • JobLauncherやJobOperatorから指定可能 JobInstance1 JobExecution1-1 リスタート JobExecution1-2 ジョブパラメータは、 JobRepositoryから復元
29.
© 2020 NTT
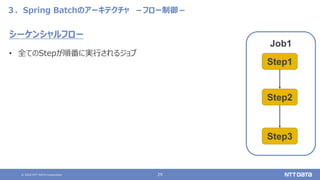
DATA Corporation 29 Job1 3.Spring Batchのアーキテクチャ -フロー制御- Step1 Step2 Step3 シーケンシャルフロー • 全てのStepが順番に実行されるジョブ
30.
© 2020 NTT
DATA Corporation 30 Job1 3.Spring Batchのアーキテクチャ -フロー制御- シーケンシャルフロー • 全てのStepが順番に実行されるジョブ • Step中の処理が異常終了した場合は、後続ステップを実行されない • Step2が失敗した場合、Step3は実行されない Step1 Step2 Step3 実行されない
31.
© 2020 NTT
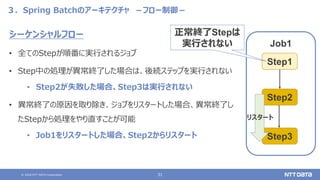
DATA Corporation 31 Job1 3.Spring Batchのアーキテクチャ -フロー制御- シーケンシャルフロー • 全てのStepが順番に実行されるジョブ • Step中の処理が異常終了した場合は、後続ステップを実行されない • Step2が失敗した場合、Step3は実行されない • 異常終了の原因を取り除き、ジョブをリスタートした場合、異常終了し たStepから処理をやり直すことが可能 • Job1をリスタートした場合、Step2からリスタート Step1 Step2 Step3 正常終了Stepは 実行されない リスタート
32.
© 2020 NTT
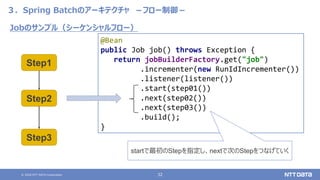
DATA Corporation 32 3.Spring Batchのアーキテクチャ -フロー制御- Jobのサンプル(シーケンシャルフロー) @Bean public Job job() throws Exception { return jobBuilderFactory.get("job") .incrementer(new RunIdIncrementer()) .listener(listener()) .start(step01()) .next(step02()) .next(step03()) .build(); } startで最初のStepを指定し、nextで次のStepをつなげていく Step1 Step2 Step3
33.
© 2020 NTT
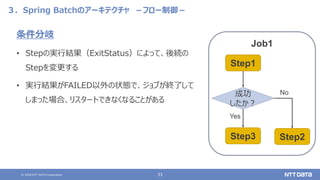
DATA Corporation 33 3.Spring Batchのアーキテクチャ -フロー制御- 条件分岐 • Stepの実行結果(ExitStatus)によって、後続の Stepを変更する • 実行結果がFAILED以外の状態で、ジョブが終了して しまった場合、リスタートできなくなることがある Job1 Step1 Step3 Step2 成功 したか? Yes No
34.
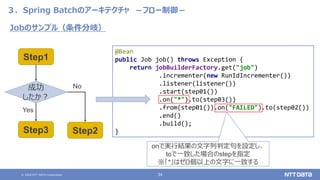
© 2020 NTT
DATA Corporation 34 3.Spring Batchのアーキテクチャ -フロー制御- Jobのサンプル(条件分岐) @Bean public Job job() throws Exception { return jobBuilderFactory.get("job") .incrementer(new RunIdIncrementer()) .listener(listener()) .start(step01()) .on("*").to(step03()) .from(step01()).on("FAILED").to(step02()) .end() .build(); } Step1 Step3 Step2 成功 したか? Yes No onで実行結果の文字列判定句を設定し、 toで一致した場合のstepを指定 ※「*」はゼロ個以上の文字に一致する
35.
© 2020 NTT
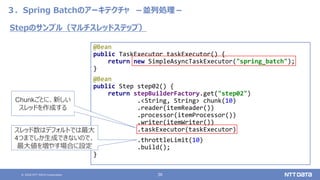
DATA Corporation 35 3.Spring Batchのアーキテクチャ -並列処理- マルチスレッドステップ • 単一プロセス上で、Step(チャンク)単位でスレッドを作成 • マルチスレッド化される際は、順序性が担保されないので、アイテムの処理に順序性が必 要な場合は、本ステップは採用できない 並行ステップ • 単一プロセス上で、スプリットフロー(複数のStepの連なり)単位でスレッドを作成
36.
© 2020 NTT
DATA Corporation 36 3.Spring Batchのアーキテクチャ -並列処理- @Bean public TaskExecutor taskExecutor() { return new SimpleAsyncTaskExecutor("spring_batch"); } @Bean public Step step02() { return stepBuilderFactory.get("step02") .<String, String> chunk(10) .reader(itemReader()) .processor(itemProcessor()) .writer(itemWriter()) .taskExecutor(taskExecutor) .throttleLimit(10) .build(); } Stepのサンプル(マルチスレッドステップ) Chunkごとに、新しい スレッドを作成する スレッド数はデフォルトでは最大 4つまでしか生成できないので、 最大値を増やす場合に設定
37.
© 2020 NTT
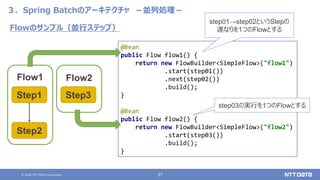
DATA Corporation 37 3.Spring Batchのアーキテクチャ -並列処理- Flowのサンプル(並行ステップ) @Bean public Flow flow1() { return new FlowBuilder<SimpleFlow>("flow1") .start(step01()) .next(step02()) .build(); } @Bean public Flow flow2() { return new FlowBuilder<SimpleFlow>("flow2") .start(step03()) .build(); } step01→step02というStepの 連なりを1つのFlowとする step03の実行を1つのFlowとする Flow1 Step1 Step2 Flow2 Step3
38.
© 2020 NTT
DATA Corporation 38 3.Spring Batchのアーキテクチャ -並列処理- Jobのサンプル(並行ステップ) @Bean public Job job() { return jobBuilderFactory.get("job") .start(splitFlow()) .next(step04()) .build() .build(); } @Bean public Flow splitFlow() { return new FlowBuilder<SimpleFlow>("splitFlow") .split(taskExecutor()) .add(flow1(), flow2()) .build(); } Flow1 Step1 Step2 Flow2 Step3 Step4 Flow1、Flow2を別スレッドで並走させる Flow1+Flow2の並走完了後、Step04を実行
39.
© 2020 NTT
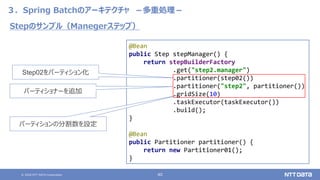
DATA Corporation 39 3.Spring Batchのアーキテクチャ -多重処理- パーティショニング • Stepの実行を分割してマルチスレッドで実行する • Manager内の処理を特定の件数ごとに、自動的に分割しWorkerを作成する • 全てのWorkerの処理が完了したら、ManagerのStepを完了とする Job1 Step1 Step2(Manager) Step3 Worker Worker Worker Worker Worker
40.
© 2020 NTT
DATA Corporation 40 3.Spring Batchのアーキテクチャ -多重処理- @Bean public Step stepManager() { return stepBuilderFactory .get("step2.manager") .partitioner(step02()) .partitioner("step2", partitioner()) .gridSize(10) .taskExecutor(taskExecutor()) .build(); } @Bean public Partitioner partitioner() { return new Partitioner01(); } Stepのサンプル(Manegerステップ) Step02をパーティション化 パーティショナーを追加 パーティションの分割数を設定
41.
© 2020 NTT
DATA Corporation 41 3.Spring Batchのアーキテクチャ -多重処理- public class Partitioner01 implements Partitioner { @Override public Map<String, ExecutionContext> partition(int gridSize) { Map<String, ExecutionContext> map = new HashMap<>(); int maxSize = 1000; // 実際は対象itemの件数を設定 int dataSize = maxSize / gridSize; // 1つのWorkerで扱うデータサイズ int offset = 0; // 初期位置からのオフセット for (int i = 0; i < gridSize; i++ ) { ExecutionContext context = new ExecutionContext(); context.putInt("dataSize", dataSize); context.putInt("offset", offset); offset += dataSize; map.put("partition:" + i, context); } return map; } } Partitionerのサンプル Partitonerインターフェースを実装 スレッドを識別する文字列と、スレッドに引き 渡したいパラメータ(ExecutionContext) をセットでMapに設定して返却 実際にItemReaderなどで 実施する処理に合わせて 変更する
42.
© 2020 NTT
DATA Corporation クラウド環境でのSpring Batch ※Spring Batchのアーキテクチャ 【番外編】
43.
© 2020 NTT
DATA Corporation 43 4.クラウド環境でのSpring Batch -クラウド環境におけるバッチアプリケーション開発- 以下のような理由から、バッチ処理はパブリッククラウドサービスと親和性が高い ① バッチ処理は決まった時間のみ起動すればよく、パブリッククラウドサービスを利用した場合、 コストメリットを得やすい インスタンスの種類や起動時間に対して課金されるため ② 大量データを扱う場合、容易にスケールアウト可能であるため、業務量に応じたリソース 設計が実現可能 余分なリソースを予め用意する必要がなく、コスト削減が狙える AWSにおける、バッチアーキテクチャに適したマネージドサービスを紹介し、 そのサービスでSpring Batchを利用する際の注意点を紹介する
44.
© 2020 NTT
DATA Corporation 44 4.クラウド環境でのSpring Batch -バッチアーキテクチャに適したサービス- AWS Cloud Auto Scaling group VPC ECS JobQueue AWS Batch JobDefinition ECR Cloud Watch Logs AWS Batchの利用 • AWS Batchの実態は、ECS(コンテナオーケストレーションサービス)と独自のキュー • ECSをそのまま構築する際に考慮する必要がある、クラスタやサービス等が自動構築されるので構築が容易 • キューにメッセージが送信されると、JobDefinitionに記載された定義の通りコンテナが起動する • コンテナはキューにメッセージが登録されてから起動するため、起動時間のバッファを考慮する必要あり ・・・ ・・・ コンテナイメージ メッセージ登録 ログ出力
45.
© 2020 NTT
DATA Corporation 45 4.クラウド環境でのSpring Batch -バッチアーキテクチャに適したサービス- ECS + SQSの利用 • 性能要件が厳しく、AWS Batchの起動時間が無視できない場合はECS + SQSの構成で対応 • AWS Batchの起動時間はコンテナイメージのつくりにより異なる • ECS上でコンテナを常時起動することで、起動コストが発生しないようにする(維持コストは上がる) • JobQueueの代わりにSQSを利用 • それぞれ個別に構築する必要があるので、構築コストは上がる AWS Cloud VPC SQS ECS バッチAP1 バッチAP2 バッチAP3 ・・・ キュー1 キュー2 ・・・ メッセージ登録
46.
© 2020 NTT
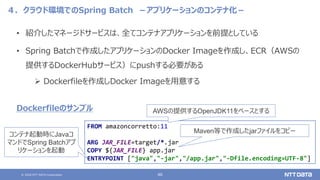
DATA Corporation 46 4.クラウド環境でのSpring Batch -アプリケーションのコンテナ化- • 紹介したマネージドサービスは、全てコンテナアプリケーションを前提としている • Spring Batchで作成したアプリケーションのDocker Imageを作成し、ECR(AWSの 提供するDockerHubサービス)にpushする必要がある Dockerfileを作成しDocker Imageを用意する FROM amazoncorretto:11 ARG JAR_FILE=target/*.jar COPY ${JAR_FILE} app.jar ENTRYPOINT ["java","-jar","/app.jar","-Dfile.encoding=UTF-8"] Dockerfileのサンプル AWSの提供するOpenJDK11をベースとする Maven等で作成したjarファイルをコピー コンテナ起動時にJavaコ マンドでSpring Batchアプ リケーションを起動
47.
© 2020 NTT
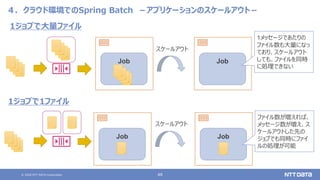
DATA Corporation 47 4.クラウド環境でのSpring Batch -アプリケーションのスケールアウト- • 紹介したマネージドサービスは、キューに滞留したメッセージの量によって、コンテナを新たに 起動することによって、スケールアウトを実現可能 • アプリケーションは、コンテナが増えた際にスケールアウト可能な単位でジョブを設計する必 要がある • 1ジョブで大量のファイルを取り扱う場合、複数のジョブから扱うファイルを重複させな いようにする制御は難しく、結局、1つのジョブでやり切る必要がある • 1ジョブ1ファイルといった単位で処理することで、ファイル量が増えればジョブの数を増 やし、ジョブの数が多くなれば(キューに滞留したメッセージ数が多い)コンテナを増 やしてスケールアウトすることが可能
48.
© 2020 NTT
DATA Corporation 48 4.クラウド環境でのSpring Batch -アプリケーションのスケールアウト- Job 1ジョブで大量ファイル スケールアウト Job Job 1ジョブで1ファイル スケールアウト Job 1メッセージであたりの ファイル数も大量になっ ており、スケールアウト しても、ファイルを同時 に処理できない ファイル数が増えれば、 メッセージ数が増え、ス ケールアウトした先の ジョブでも同時にファイ ルの処理が可能
49.
© 2020 NTT
DATA Corporation 49 4.クラウド環境でのSpring Batch -ジョブ管理テーブルの作成時の注意点- • RDS(RDBのマネージドサービス)上で、ジョブ管理テーブルを構築する必要がある • 前述の通り、コンテナ化したアプリがスケールアウトしていくと、RDSへのアクセス数が増加 し、コネクションプールが枯渇してしまう場合がある • Spring Batchを利用する場合は、業務アプリケーション上で利用しない場合でもRDS が必要となるので、性能試験を実施してコネクションプール枯渇やCPU使用率高騰等の 性能問題が発生しなか確認する必要がある
50.
© 2020 NTT
DATA Corporation おわりに
51.
© 2020 NTT
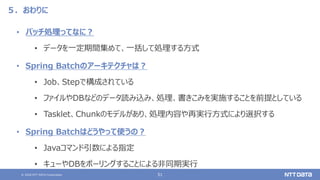
DATA Corporation 51 5.おわりに • バッチ処理ってなに? • データを一定期間集めて、一括して処理する方式 • Spring Batchのアーキテクチャは? • Job、Stepで構成されている • ファイルやDBなどのデータ読み込み、処理、書きこみを実施することを前提としている • Tasklet、Chunkのモデルがあり、処理内容や再実行方式により選択する • Spring Batchはどうやって使うの? • Javaコマンド引数による指定 • キューやDBをポーリングすることによる非同期実行
52.
© 2020 NTT
DATA Corporation 52 5.おわりに 参考情報 • Spring Batch - リファレンスドキュメント(バージョン 4.3.0) • https://spring.pleiades.io/spring-batch/docs/current/reference/html/ • TERASOLUNA Batch Framework for Java (5.x) Development Guideline(バージョン5.3.0) • https://terasoluna-batch.github.io/guideline/current/ja/single_index.html • Amazon SQSを使ったSpringアプリケーション(3)(4), IT Search+ • https://news.mynavi.jp/itsearch/article/devsoft/4713 • https://news.mynavi.jp/itsearch/article/devsoft/4756 • [AWS Black Belt Online Seminar] AWS Batch • https://aws.amazon.com/jp/blogs/news/webinar-bb-aws-batch-2019/
53.
© 2020 NTT
DATA Corporation ご静聴ありがとうございました 本資料に記載されている会社名、商品名、又はサービス名は、各社の登録商標又は商標です。



 Most read
 Most read