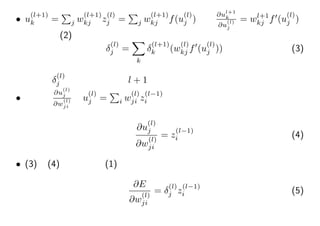ディープニューラルネット入門
安田裕介
1 きっかけ:猫事件
• おそらく一般の人に認知されるきっかけ
• 2012年、Google Brainチームが開発した自己符号化器ディープニュー
ラルネットが猫などの高次概念をラベルなしデータのみで認識した
Le et al. (2012) Building high-level features using large-scale unsupervised learning
2 歴史
• 1982年、Fukushimaらがディープニューラルネットの起源となるネオ
コグニトンを発表
• 1989年、LeCunらが誤差逆伝播アルゴリズムを適用し、5層からなる
ディープニューラルネットで手書き数字画像認識に成功
• 1990年代にはニューラルネットは下火となる。特に多層のディープ
ニューラルネットは、過学習や勾配消失問題といった問題に直面し、計
算コストも高く性能を引き出すのが困難だった。
• 2000年代半ばHintonらが、制約ボルツマンマシンという単層ネット
ワークに分離して事前学習することにより、効果的に学習できることを
発見したことがブレイクスルーとなる
• その後ディープニューラルネットは音声認識や画像認識のベンチマーク
テストで記録をぬり変えるようになる
• なんかみんなディープラーニングで騒ぎ始める
3 なぜ今ディープニューラルネットが再注目され
ているのか
昔からあったアルゴリズムなのになぜ?
• 単にコンピューターが速くなったから
• 主にGPGPUと分散処理の進化のおかげ
近年ディープニューラルネットは既存のベンチマークを更新し続けている
4 ディープニューラルネットとは
• ニューラルネットワークとは生物の神経細胞の構造を模した機械学習モ
デル
• ニューラルネットワークが多層になったモデルがディープニューラル
ネット
• 層数が3層以上でディープニューラルネットといえる
• 神経細胞の多層構造は生物にも見られる。例えば人間の大脳皮質の神経
細胞は6層構造になっている。
5 例題:手書き数字認識
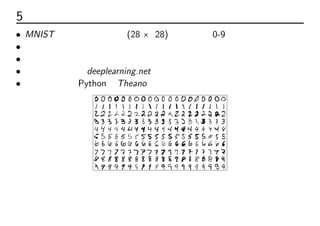
• MNIST の手書き数字画像(28 × 28)を認識し、0-9の数字に分類する
• はじめに2層の順伝播ネットワークを紹介
• 次に3層の多層パーセプトロンに発展させる
• 具体例と実装はdeeplearning.netを用いる
• ライブラリはPythonのTheanoを使っている
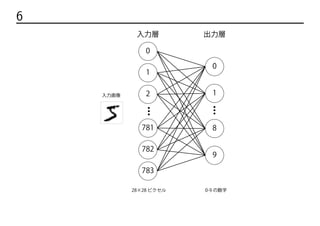
6 順伝播ネットワークの構造
0
0
1
2
781
782
783
1
8
9
入力層
28×28 ピクセル 0-9 の数字
出力層
入力画像
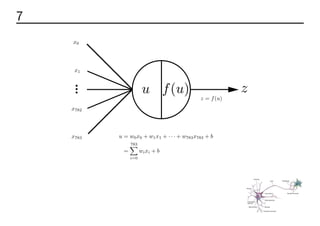
7 ニューロン
x0
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
i=0
wixi + b
x0
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
i=0
wixi + b
x0
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
i=0
wixi + b
x0
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
i=0
wixi + b
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
wixi + b
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x7
=
783
i=0
wixi + b
x0
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
i=0
wixi + b
x0
x1
x782
x783
u
f(u)
z
z = f(u)
u = w0x0 + w1x1 + · · · + w783x783 + b
=
783
i=0
wixi + b
神経細胞ニューロン
8 ソフトマックス分類器
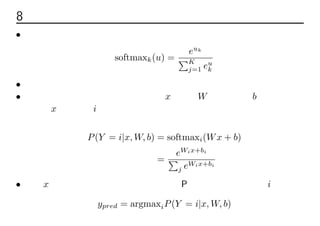
• 出力層の活性化関数にソフトマックス関数を使う
softmaxk(u) =
euk
∑K
j=1 eu
k
• 層中の各ユニットのソフトマックス関数の結果の合計は1になる
• ソフトマックス関数の結果は、入力x、重みW、バイアスbが与えられ
た時、xがクラスiに分類される確率を表すと解釈できる
P(Y = i|x, W, b) = softmaxi(Wx + b)
=
eWix+bi
∑
j eWix+bi
• 入力xが属するクラスの予測は条件確率Pを最大にするクラスiになる
ypred = argmaxiP(Y = i|x, W, b)
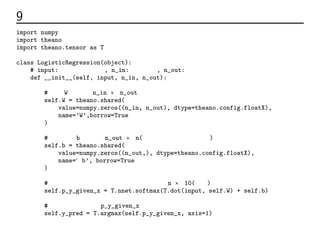
9 出力層のコード
import numpy
import theano
import theano.tensor as T
class LogisticRegression(object):
# input: 入力データ行列, n_in: 入力の数, n_out: 出力の数
def __init__(self, input, n_in, n_out):
# 重みW。次元はn_in × n_out。
self.W = theano.shared(
value=numpy.zeros((n_in, n_out), dtype=theano.config.floatX),
name=’W’,borrow=True
)
# バイアスb。次元はn_out × n(任意の大きさのデータ数)
self.b = theano.shared(
value=numpy.zeros((n_out,), dtype=theano.config.floatX),
name=‘b’, borrow=True
)
# 入力が各クラスに分類される確率。次元はn × 10(後述)
self.p_y_given_x = T.nnet.softmax(T.dot(input, self.W) + self.b)
# 出力層の中で確率p_y_given_xの値が最も大きいインデックスが予測クラス
self.y_pred = T.argmax(self.p_y_given_x, axis=1)
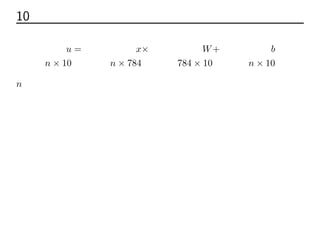
10 行列の次元に注意
u = x× W+ b
n × 10 n × 784 784 × 10 n × 10
nはデータ数
11 学習
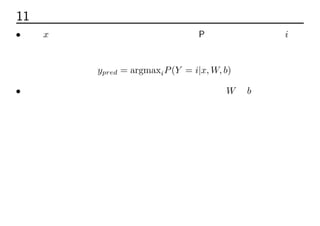
• 入力xが属するクラスの予測結果は条件確率Pを最大にするクラスi
だった
ypred = argmaxiP(Y = i|x, W, b)
• 学習とは予測クラスが正解クラスと一致するようにW とbを最適化す
ること
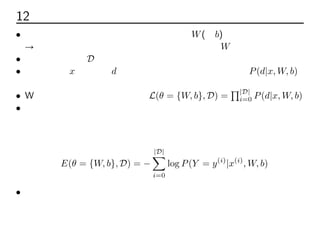
12 最尤推定法
• どうすればうまく分類できるパラメーターW(とb)を決められるのか?
→ 誤差関数を定義し、この関数の値を最小にするW を探す
• 訓練データ集合Dにおけるネットワーク全体の誤差を考える
• 入力データxの正解がdのとき、正解となった事後確率をP(d|x, W, b)
とする
• Wの訓練データに対する尤度はL(θ = {W, b}, D) =
∏|D|
i=0 P(d|x, W, b)
• 掛け算から足し算に変換するために対数をとり(対数関数は単調増加関
数なので結果に影響はない)、さらに最小化を考えるためにマイナスを
かけると
E(θ = {W, b}, D) = −
|D|
∑
i=0
log P(Y = y(i)
|x(i)
, W, b)
• この関数を誤差関数とし、最小化することを考える最尤推定法を使う
13 最尤推定法のコード
def negative_log_likelihood(self, y):
"""
:param y:各データの正解ラベル行列(n×10)
"""
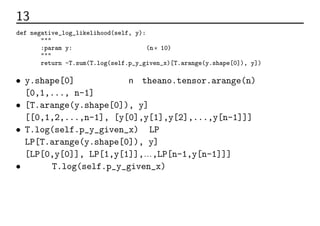
return -T.sum(T.log(self.p_y_given_x)[T.arange(y.shape[0]), y])
• y.shape[0]はデータの数n。theano.tensor.arange(n)で
[0,1,..., n-1]に展開。
• [T.arange(y.shape[0]), y]は
[[0,1,2,...,n-1], [y[0],y[1],y[2],...,y[n-1]]]
• T.log(self.p_y_given_x)をLPとすると
LP[T.arange(y.shape[0]), y]は
[LP[0,y[0]], LP[1,y[1]],…,LP[n-1,y[n-1]]]となる
• つまりT.log(self.p_y_given_x)の各データの正解ラベルの値だけ
抽出し、正解だったクラスの確率の対数を合計している
14 勾配降下法
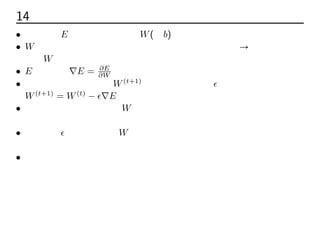
• 誤差関数E の値を最小にするW(とb)を求めたい
• W をどの方向に変更すれば誤差関数は小さくなるのか → それは誤差関
数のW に対する勾配が負となる方向
• E の勾配は∇E = ∂E
∂W
• 更新後のパラメーターW(t+1)
は勾配に学習係数ϵをかけた分修正する
W(t+1)
= W(t)
− ϵ∇E
• 勾配が急な学習初期ほどW は大きく修正され、速く極小値付近に近づ
いていく
• 学習係数ϵが大きいほどW は大きく修正され、速く学習できるが、その
分収束しない危険性が高まる
• 誤差が最小になるまで繰り返す
15 コード
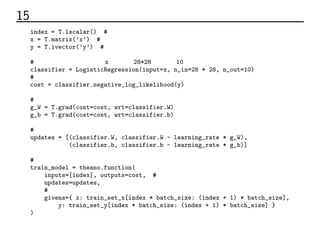
index = T.lscalar() # ミニバッチのインデックス
x = T.matrix(’x’) # 入力データ
y = T.ivector(’y’) # ラベルデータ
# 出力層。入力データ行列x、入力数28*28、出力数10。
classifier = LogisticRegression(input=x, n_in=28 * 28, n_out=10)
# 対数尤度誤差関数
cost = classifier.negative_log_likelihood(y)
# パラメーターの微分
g_W = T.grad(cost=cost, wrt=classifier.W)
g_b = T.grad(cost=cost, wrt=classifier.b)
# 勾配降下法によるパラメーターの更新
updates = [(classifier.W, classifier.W - learning_rate * g_W),
(classifier.b, classifier.b - learning_rate * g_b)]
# 学習関数
train_model = theano.function(
inputs=[index], outputs=cost, # 入力はミニバッチの番号。出力は誤差関数の値
updates=updates,
# ミニバッチデータの選択
givens={ x: train_set_x[index * batch_size: (index + 1) * batch_size],
y: train_set_y[index * batch_size: (index + 1) * batch_size] }
)
16 学習全体の流れ
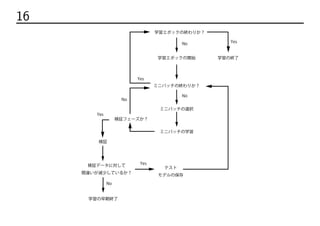
学習エポックの終わりか?
学習エポックの開始 学習の終了
ミニバッチの終わりか?
ミニバッチの選択
ミニバッチの学習
学習の早期終了
検証データに対して
間違いが減少しているか?
検証フェーズか?
検証
テスト
モデルの保存
No
No
No
No
Yes
Yes
Yes
Yes
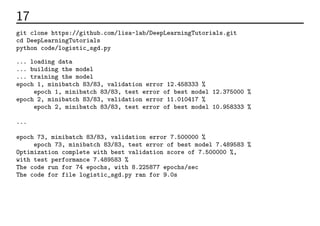
17 実行してみる
git clone https://github.com/lisa-lab/DeepLearningTutorials.git
cd DeepLearningTutorials
python code/logistic_sgd.py
... loading data
... building the model
... training the model
epoch 1, minibatch 83/83, validation error 12.458333 %
epoch 1, minibatch 83/83, test error of best model 12.375000 %
epoch 2, minibatch 83/83, validation error 11.010417 %
epoch 2, minibatch 83/83, test error of best model 10.958333 %
...
epoch 73, minibatch 83/83, validation error 7.500000 %
epoch 73, minibatch 83/83, test error of best model 7.489583 %
Optimization complete with best validation score of 7.500000 %,
with test performance 7.489583 %
The code run for 74 epochs, with 8.225877 epochs/sec
The code for file logistic_sgd.py ran for 9.0s
18 ディープニューラルネットへ
• 前回と同じ手書き数字認識の例題をディープニューラルネットで解く
• 前回と同じ入力層と出力層を使う
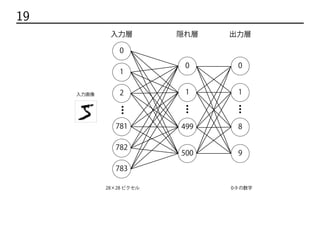
• 入力層と出力層の間に隠れ層という層を1つ入れて3層にする。この隠
れ層の存在によりマジックがおきる。
• このモデルを多層パーセプトロンという
• 1つでも隠れ層があれば多層パーセプトロンは万能近似器となる。つま
りあらゆる分類問題において境界を引くことができる。
19 多層パーセプトロンの構造
0
0
1
2
781
782
783
1
499
500
入力層
28×28 ピクセル
隠れ層
0
1
8
9
0-9 の数字
出力層
入力画像
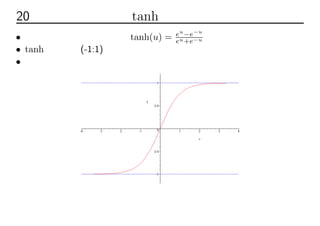
20 双曲線正接関数tanh
• 隠れ層の活性化関数としてtanh(u) = eu
−e−u
eu+e−u を使う
• tanhの値域は(-1:1)
• 神経細胞の電気信号伝達をモデル化したもの
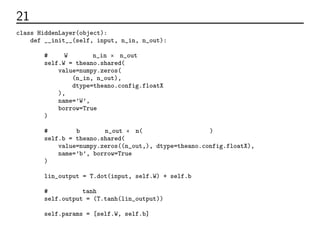
21 隠れ層のコード
class HiddenLayer(object):
def __init__(self, input, n_in, n_out):
# 重みW。次元はn_in × n_out。
self.W = theano.shared(
value=numpy.zeros(
(n_in, n_out),
dtype=theano.config.floatX
),
name=’W’,
borrow=True
)
# バイアスb。次元はn_out × n(任意の大きさのデータ数)。
self.b = theano.shared(
value=numpy.zeros((n_out,), dtype=theano.config.floatX),
name=’b’, borrow=True
)
lin_output = T.dot(input, self.W) + self.b
# 活性化関数tanhによる変換
self.output = (T.tanh(lin_output))
self.params = [self.W, self.b]
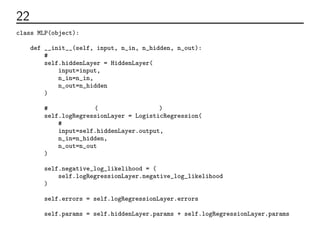
22 ネットワーク全体のコード
class MLP(object):
def __init__(self, input, n_in, n_hidden, n_out):
# 隠れ層をつくる
self.hiddenLayer = HiddenLayer(
input=input,
n_in=n_in,
n_out=n_hidden
)
# 出力層をつくる(実装は2層の時と同じ)
self.logRegressionLayer = LogisticRegression(
# 隠れ層の出力を入力に受け取る
input=self.hiddenLayer.output,
n_in=n_hidden,
n_out=n_out
)
self.negative_log_likelihood = (
self.logRegressionLayer.negative_log_likelihood
)
self.errors = self.logRegressionLayer.errors
self.params = self.hiddenLayer.params + self.logRegressionLayer.params
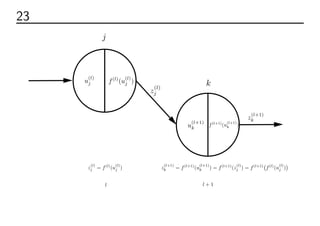
23 多層パーセプトロンのニューロンの関係構造
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
l
l + 1
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
= f(l+1)
(u
(l+1)
) = f(l+1)
(z
(l)
) = f(l+1)
f(l)
(u
(l)
)
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
uj
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(
l
l + 1
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
l
l + 1
j
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
l
l + 1
j
k
l + 1
j
k
1
l
l + 1
j
k
1
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
l
l + 1
u
(l)
j
f(l)
(u
(l)
j )
z
(l)
j
u
(l+1)
k
f(l+1)
(u
(l+1)
k )
z
(l+1)
k
z
(l)
j = f(l)
(u
(l)
j )
z
(l+1)
k = f(l+1)
(u
(l+1)
k ) = f(l+1)
(z
(l)
j ) = f(l+1)
f(l)
(u
(l)
j )
l
l + 1
j
24 ネストした活性化関数の計算量にどう対処す
るか
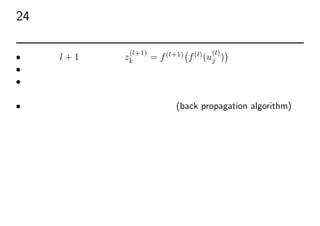
• 上図で、l + 1層の出力はz
(l+1)
k = f(l+1)
(
f(l)
(u
(l)
j )
)
だった
• この活性化関数のネストは層が多くなるほど深くなる
• 層が多くなるほど合成関数の微分を繰り返さなければならず、計算量が
増してしまう
• この問題に対処するため誤差逆伝播法 (back propagation algorithm)を
使う
25 誤差逆伝播法
i
j
k
l − 1
l
i
j
k
l − 1
l
i
j
k
l − 1
l
l − 1
l
l + 1
w
(l)
ji
w
(l+1)
kj
u
(l)
j
ul+1
k
z
(l)
j
δ
(l+1)
1
δ
(l+1)
k
k
l − 1
l
l + 1
w
(l)
ji
w
(l+1)
kj
u
(l)
j
ul+1
k
z
(l)
j
δ
(l+1)
i
j
k
l − 1
l
l + 1
i
j
k
l − 1
l
l + 1
w
(l)
ji
w
(l+1)
kj
i
j
k
l − 1
l
l + 1
w
(l)
ji
kj
u
(l)
j
ul+1
k
z
(l)
j
δ
(l+1)
1
δ
(l+1)
k
δ
(l+1)
k+1
δ
(l)
j
δ
(l+1)
1
δ
(l+1)
k
δ
(l+1)
k+1
δ
(l)
j 1
ul+1
k
z
(l)
j
δ
(l+1)
1
δ
(l+1)
k
δ
(l+1)
k+1
δ
(l)
j
25 誤差逆伝播法
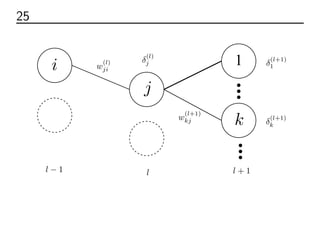
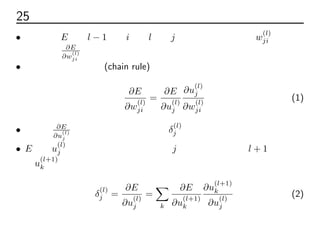
• 誤差関数E の第l − 1層のiと第l層のj ユニットの間の重みw
(l)
ji につい
ての微分 ∂E
∂w
(l)
ji
について考える
• 合成関数の微分法則(chain rule)より、
∂E
∂w
(l)
ji
=
∂E
∂u
(l)
j
∂u
(l)
j
∂w
(l)
ji
(1)
• 第1項 ∂E
∂u
(l)
j
を考える。これをデルタδ
(l)
j と定義する
• E へのu
(l)
j の変化の影響は、ユニットj に接続されているl + 1層の総入
力u
(l+1)
k の変化によって生じる。同様に合成関数の微分法則により、
δ
(l)
j =
∂E
∂u
(l)
j
=
∑
k
∂E
∂u
(l+1)
k
∂u
(l+1)
k
∂u
(l)
j
(2)
• u
(l+1)
k =
∑
j w
(l+1)
kj z
(l)
j =
∑
j w
(l+1)
kj f(u
(l)
j )より
∂ul+1
k
∂u
(l)
j
= wl+1
kj f′
(u
(l)
j )
なので、(2)は
δ
(l)
j =
∑
k
δ
(l+1)
k (w
(l)
kj f′
(u
(l)
j )) (3)
つまりδ
(l)
j は1つ上位の層l + 1のデルタから計算できる
• 第2項
∂u
(l)
j
∂w
(l)
ji
はu
(l)
j =
∑
i w
(l)
ji z
(l−1)
i より
∂u
(l)
j
∂w
(l)
ji
= z
(l−1)
i (4)
• (3)と(4)より目的の(1)は、
∂E
∂w
(l)
ji
= δ
(l)
j z
(l−1)
i (5)
25 誤差逆伝播法
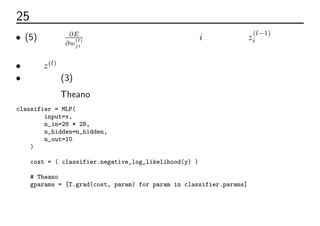
• (5)より、 ∂E
∂w
(l)
ji
は、1つ下位の層のユニットiからの出力z
(l−1)
i と、デ
ルタから計算できる
• 出力z(l)
は入力層から順に上位に向かって計算する(順伝播)
• デルタは(3)より出力層から順に下位に向かって計算する(逆伝播)
コードではTheanoの自動微分がよろしくやってくれる
classifier = MLP(
input=x,
n_in=28 * 28,
n_hidden=n_hidden,
n_out=10
)
cost = ( classifier.negative_log_likelihood(y) )
# Theanoの自動微分の機能を使い、各パラメーターについて微分を計算
gparams = [T.grad(cost, param) for param in classifier.params]
26 学習部分のコード
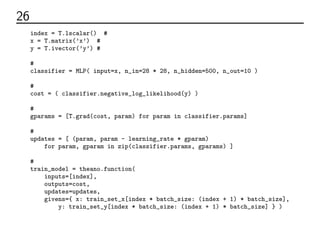
index = T.lscalar() # ミニバッチのインデックス
x = T.matrix(’x’) # 入力データ
y = T.ivector(’y’) # ラベルデータ
# 多層パーセプトロンをつくる
classifier = MLP( input=x, n_in=28 * 28, n_hidden=500, n_out=10 )
# 誤差関数
cost = ( classifier.negative_log_likelihood(y) )
# 各パラメーターの微分
gparams = [T.grad(cost, param) for param in classifier.params]
# パラメーターの更新
updates = [ (param, param - learning_rate * gparam)
for param, gparam in zip(classifier.params, gparams) ]
# 学習の関数
train_model = theano.function(
inputs=[index],
outputs=cost,
updates=updates,
givens={ x: train_set_x[index * batch_size: (index + 1) * batch_size],
y: train_set_y[index * batch_size: (index + 1) * batch_size] } )
27 実行してみる
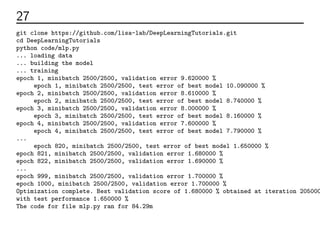
git clone https://github.com/lisa-lab/DeepLearningTutorials.git
cd DeepLearningTutorials
python code/mlp.py
... loading data
... building the model
... training
epoch 1, minibatch 2500/2500, validation error 9.620000 %
epoch 1, minibatch 2500/2500, test error of best model 10.090000 %
epoch 2, minibatch 2500/2500, validation error 8.610000 %
epoch 2, minibatch 2500/2500, test error of best model 8.740000 %
epoch 3, minibatch 2500/2500, validation error 8.000000 %
epoch 3, minibatch 2500/2500, test error of best model 8.160000 %
epoch 4, minibatch 2500/2500, validation error 7.600000 %
epoch 4, minibatch 2500/2500, test error of best model 7.790000 %
...
epoch 820, minibatch 2500/2500, test error of best model 1.650000 %
epoch 821, minibatch 2500/2500, validation error 1.680000 %
epoch 822, minibatch 2500/2500, validation error 1.690000 %
...
epoch 999, minibatch 2500/2500, validation error 1.700000 %
epoch 1000, minibatch 2500/2500, validation error 1.700000 %
Optimization complete. Best validation score of 1.680000 % obtained at iteration 205000
with test performance 1.650000 %
The code for file mlp.py ran for 84.29m
28 結果の比較
• 2層順伝播ネットワークはテスト誤差7.49%で学習時間9秒
• 3層パーセプトロンはテスト誤差1.65%で学習時間84分
• たった1層追加しただけで誤差激減
• その代わり学習時間激増