MySQLのパフォーマンスチューニン
グについて少々
2016/01/20
yoku0825の中の⼈
GMOアドパートナーズグループ勉強会
\こんにちは/
yoku0825@とある企業のDBA の中の⼈
オラクれない-
ポスグれない-
マイエスキューエる-
Twitter: @yoku0825
Blog: ⽇々の覚書
Oracle ACE Details
MySQL 5.7 Community Contributor Award
1/141
このスライド書いた中の⼈です
2/141
ちなみに
3/141
というわけで安⼼
して 地雷友達 5.7
使っていいです
よ :)
4/141
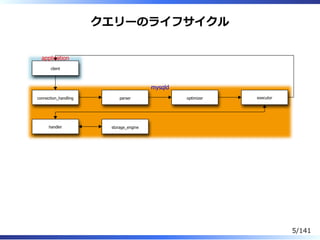
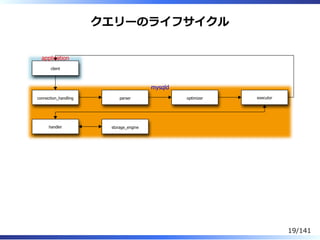
クエリーのライフサイクル
client
connection_handling parser optimizer executor
handler storage_engine
application
mysqld
5/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
6/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
7/141
Connection Handling
ソケット, ポートからの接続を待ち受ける
接続があったらclone(またはスレッドキャッシュから取り
出してディスパッチ)
⼀次認証
8/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
9/141
Parser
MySQLプロトコルのパース
SQL構⽂のパース
⼆次認証(データベース, テーブル単位のアクセス権限チ
ェック)
クエリーキャッシュ処理
ジェネラルログ
10/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
11/141
Optimizer
統計情報の取得(Storage Engine APIを叩いてるっぽい)
クエリーの書き換えを含めた実⾏計画の決定
12/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
13/141
Executor
オプティマイザーから渡された実⾏計画の通りにHandlerを
叩く
Handlerから戻ってきた結果を使って実⾏計画の残りを実⾏
Using where; Using filesort; Using temporary; はコ
イツが頑張ってる証拠
-
スローログ, バイナリーログ
14/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
15/141
Handler
ストレージエンジンの抽象化レイヤー
あんまり意識することはない
16/141
クエリーのライフサイクル
Connection Handling
Parser
Optimizer
Executor
Handler
Storage Engine
17/141
Storage Engine
実際にデータを格納するレイヤー
プラガブルアーキテクチャーなので、ほとんどの機能はこの
レイヤーで実装されている
ストレージエンジンごとにトランザクション対応が違う
とか
-
ストレージエンジンごとにロック粒度が違うとか-
ストレージエンジンごとにバッファが違うとか-
18/141
クエリーのライフサイクル
client
connection_handling parser optimizer executor
handler storage_engine
application
mysqld
19/141
どこが 遅
い︖
20/141
どこが遅い︖
connection_handling parser optimizer executor
handler storage_engine
mysqld
だいたいExecutor
たまにStorage Engine
21/141
Executorが遅い理由
MySQLの不得意なことをやろうとしている
⾊々パターンはあるけど、⼀⾔で⾔うならこれにあたる-
Executorに仕事をさせたら負け
22/141
MySQLの不得意なこと
複数のインデックスを使いこなす
相関サブクエリー
23/141
複数のインデックスに弱い理由
MySQLは原則1クエリー内で1つのテーブルあたり1つのイ
ンデックスしか使わない
インデックスマージという例外が⼀応あるにはあるが、
後付け
-
そもそもこういう設計思想なんだと思う-
テーブルスキャンに強い/弱いはストレージエンジンのレイ
ヤー
MyISAMはスキャンに強く、InnoDBは弱い-
関数演算、(インデックスで解決できない)フィルター、
(インデックスで解決できない)ソートはExecutorのお仕
事(= 遅い)
24/141
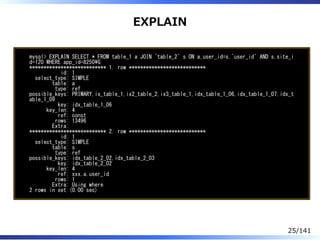
EXPLAIN
mysql> EXPLAIN SELECT * FROM table_1 a JOIN `table_2` s ON a.user_id=s.`user_id` AND s.site_i
d=120 WHERE app_id=8250G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: a
type: ref
possible_keys: PRIMARY,ix_table_1,ix2_table_2,ix3_table_1,idx_table_1_06,idx_table_1_07,idx_t
able_1_09
key: idx_table_1_06
key_len: 4
ref: const
rows: 13496
Extra:
*************************** 2. row ***************************
id: 1
select_type: SIMPLE
table: s
type: ref
possible_keys: idx_table_2_02,idx_table_2_03
key: idx_table_2_02
key_len: 4
ref: xxx.a.user_id
rows: 1
Extra: Using where
2 rows in set (0.00 sec)
25/141
いくつかのルール
Extra列はExecutorの都合
それ以外はオプティマイザー、ハンドラー(= ストレージエ
ンジン)の都合
key_len, rowsがヒントになる
26/141
type
ALLがダメなんて良く⾔う
ALL .. テーブルスキャン-
ref .. 非ユニークキーによる選択-
range .. レンジスキャン-
27/141
type
どの⽅法でアクセスさせるのが最速だと オプティマイザー
が ⾒積もった結果
特にInnoDBはクラスターインデックスなので、下⼿にセ
カンダリーインデックスを使うよりも本当に速いケース
もある
-
MyISAMもスキャンに強いので、本当に速いケースがあ
る
-
ダメなのはALLじゃなく、本当の最適なアクセスと違う時
rows, key_lenが判断の助けになる-
28/141
オプティマイザーが⾒誤る理由
InnoDBの統計情報がサンプリング1.
オプティマイザーはLIMIT句を正しくハンドリングできない2.
29/141
InnoDBの統計情報
InnoDBの統計情報は テーブル全体から⼀部の情報をランダ
ムに選び出し、全体を推測する サンプリング統計
5.5とそれ以前では1インデックスあたり8ページ(=
16kB * 8ページで128kB)でハードコード
-
5.6とそれ以降では1インデックスあたりデフォルト20ペ
ージ(innodb_stats_persistent_sample_pages)
CREATE TABLE, ALTER TABLEでテーブル単位でページ数
を指定することも可能
-
30/141
InnoDBの統計情報
サンプリングなので
統計情報の再計算はそこまで(MyISAMと⽐べれば)⼤
きくない
-
統計情報が間違っている(著しく実際のデータの分布と
乖離している)可能性が⾼い
-
31/141
LIMIT句のハンドリング
LIMIT句はORDER BY句の処理が終わってから実⾏される
ORDER BY句の処理は最終的にExecutorで終端するので-
つまりLIMIT句もExecutorの処理の範疇-
オプティマイザーは⾃分より後のExecutorの動作を正しく
⾒積もれない
なので、ORDER BY .. LIMIT ..で効率的にORDER BY狙い
のキーが使える場合でも、選んでくれないケースがある
-
5.7でLIMITありの場合のオプティマイズが効くようにな
っている
-
32/141
Extra: Using where; Using filesort;
ExecutorがWHEREをフィルターしている、ExecutorがORDER
BYのソートをしている
インデックスを使って⾼速化できるのは WHERE, ORDER BY,
GROUP BY, select_list
どうすればいいかと⾔われると、「インデックス使う」とし
か⾔いようがない
33/141
トランプの
話をします
34/141
Query As A Card
100枚のトランプが裏返して積まれた⼭があります
何組かのトランプを混ぜたもので何が何枚⼊ってるかはわか
りません
35/141
この⼭の中から
スペードのAを
探してください
36/141
どうするかというと
⼭の⼀番上のトランプをめくる1.
スートと番号を⾒る2.
スペードのAだったら⼿元に残す3.
スペードのAじゃなかったらどっかに置いておく4.
⼭の全てのカードに対して2, 3, 4を繰り返す
⼭にスペードのAが何枚あるかに関わらず、⼭の全てのカー
ドに対して繰り返す
5.
37/141
これがtype: ALLかつExtra: Using where
トランプをめくる .. ⾏をフェッチする
スートと番号を⾒る .. Executorでのフィルター処理
38/141
この⼭の中からス
ペードを全て探し
出して、K〜Aの順
で並べてください
39/141
どうするかというと
右⼿で ⼭の⼀番上のトランプをめくる1.
スートと番号を⾒る2.
スペードだったらそのカードを 左⼿に 残しておく3.
スペードじゃなかったらどっかに置いておく4.
⼭の全てのカードに対して2, 3, 4を繰り返す5.
⼭から全てのスペードが出揃ったら、⼿元のカードをK〜A
まで順番に並べる
6.
40/141
これがtype: ALLかつExtra: Using where; Using
filesort
トランプをめくる .. ⾏をフェッチする
トランプをめくった 右⼿ .. リードバッファー
スートを⾒る .. Executorでのフィルター処理
スートが⼀致した時にカードを⼊れた 左⼿ .. ソートバッフ
ァー
⼿元のカードを並べ替える .. Executorによるクイックソー
ト
41/141
KEY(suit)
suit 上から
club 3,5,13,14,16,18,19,20,37,44,45,55,57,
63,66,81,86,87,91,92,98,99,100
diamond 1,4,15,17,21,22,25,27,31,34,39,50,56,
58,60,65,68,70,72,73,78,97
heart 6,7,10,12,24,26,32,36,38,40,41,43,48,
51,52,61,62,67,74,75,84,85,88,89,90,9
3,95
spade 2,8,9,11,23,28,29,30,33,35,42,46,47,4
9,53,54,59,64,69,71,76,77,79,80,82,8
3,94,96
42/141
ここからスペードのAを探す
suit 上から
club 3,5,13,14,16,18,19,20,37,44,45,55,57,
63,66,81,86,87,91,92,98,99,100
diamond 1,4,15,17,21,22,25,27,31,34,39,50,56,
58,60,65,68,70,72,73,78,97
heart 6,7,10,12,24,26,32,36,38,40,41,43,48,
51,52,61,62,67,74,75,84,85,88,89,90,9
3,95
spade 2,8,9,11,23,28,29,30,33,35,42,46,47,4
9,53,54,59,64,69,71,76,77,79,80,82,8
3,94,96
43/141
スペードのAを探す
トランプの上から2, 8, 9, .. 枚目を順番にめくり1.
番号を⾒る(スペードのものだけめくってるんだから、スー
トは⾒る必要がない)
2.
Aだったらそのカードを残しておく3.
Aじゃなかったらどっかに置いておく4.
44/141
これがtype: ref, ref: const, Extra: Using where
インデックス上からスペードを探して「上から2番目」の情
報を得る
1.
上から2番目のカードをめくる .. ここまでha̲index̲read2.
Aかどうかを判定する .. Executorによるフィルター3.
インデックス上の全てのリーフをさらうまで繰り返す ..
ha̲index̲nextがHA̲ERR̲END̲OF̲FILEを返すまでルー
プ
4.
45/141
ここからスペードを全て探し出して、K〜Aの順で並べる
suit 上から
club 3,5,13,14,16,18,19,20,37,44,45,55,57,
63,66,81,86,87,91,92,98,99,100
diamond 1,4,15,17,21,22,25,27,31,34,39,50,56,
58,60,65,68,70,72,73,78,97
heart 6,7,10,12,24,26,32,36,38,40,41,43,48,
51,52,61,62,67,74,75,84,85,88,89,90,9
3,95
spade 2,8,9,11,23,28,29,30,33,35,42,46,47,4
9,53,54,59,64,69,71,76,77,79,80,82,8
3,94,96
46/141
スペードを全て探し出して、K〜Aの順で並べる
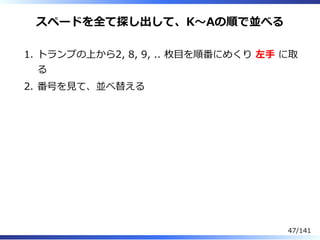
トランプの上から2, 8, 9, .. 枚目を順番にめくり 左⼿ に取
る
1.
番号を⾒て、並べ替える2.
47/141
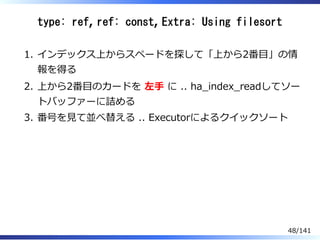
type: ref, ref: const, Extra: Using filesort
インデックス上からスペードを探して「上から2番目」の情
報を得る
1.
上から2番目のカードを 左⼿ に .. ha̲index̲readしてソー
トバッファーに詰める
2.
番号を⾒て並べ替える .. Executorによるクイックソート3.
48/141
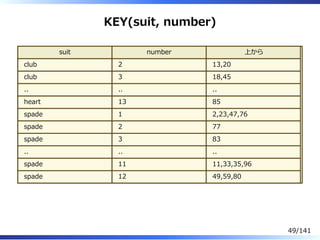
KEY(suit, number)
suit number 上から
club 2 13,20
club 3 18,45
.. .. ..
heart 13 85
spade 1 2,23,47,76
spade 2 77
spade 3 83
.. .. ..
spade 11 11,33,35,96
spade 12 49,59,80
49/141
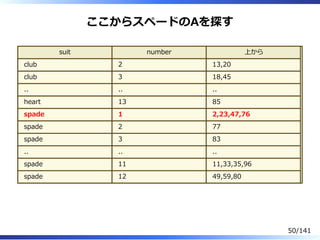
ここからスペードのAを探す
suit number 上から
club 2 13,20
club 3 18,45
.. .. ..
heart 13 85
spade 1 2,23,47,76
spade 2 77
spade 3 83
.. .. ..
spade 11 11,33,35,96
spade 12 49,59,80
50/141
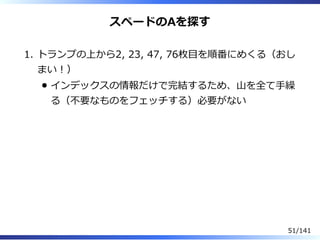
スペードのAを探す
トランプの上から2, 23, 47, 76枚目を順番にめくる(おし
まい︕)
インデックスの情報だけで完結するため、⼭を全て⼿繰
る(不要なものをフェッチする)必要がない
1.
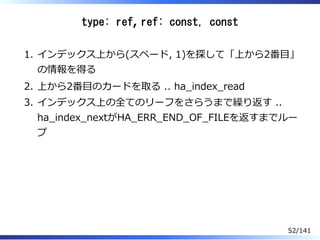
51/141
type: ref, ref: const, const
インデックス上から(スペード, 1)を探して「上から2番目」
の情報を得る
1.
上から2番目のカードを取る .. ha̲index̲read2.
インデックス上の全てのリーフをさらうまで繰り返す ..
ha̲index̲nextがHA̲ERR̲END̲OF̲FILEを返すまでルー
プ
3.
52/141
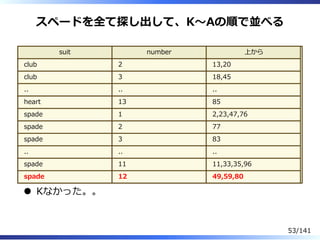
スペードを全て探し出して、K〜Aの順で並べる
suit number 上から
club 2 13,20
club 3 18,45
.. .. ..
heart 13 85
spade 1 2,23,47,76
spade 2 77
spade 3 83
.. .. ..
spade 11 11,33,35,96
spade 12 49,59,80
Kなかった。。
53/141
スペードを全て探し出して、K〜Aの順で並べる
トランプの上から49, 59, 80枚目を⼿に取る1.
トランプの上から11, 33, 35, 96枚目を⼿に取る2.
全てのスペードのカードぶん1, 2を繰り返す3.
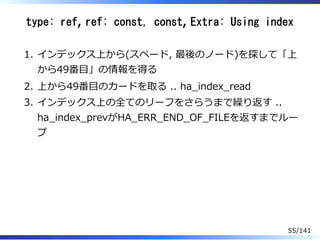
54/141
type: ref, ref: const, const, Extra: Using index
インデックス上から(スペード, 最後のノード)を探して「上
から49番目」の情報を得る
1.
上から49番目のカードを取る .. ha̲index̲read2.
インデックス上の全てのリーフをさらうまで繰り返す ..
ha̲index̲prevがHA̲ERR̲END̲OF̲FILEを返すまでルー
プ
3.
55/141
:(;゙゚ʼω゚ʼ): Extra: Using whereが消えなかった
たまに消えない
たぶんオプティマイザーのバグ(ORDER BYと混じると
Executorが仕事してなくてもUsing whereが消えない)
56/141
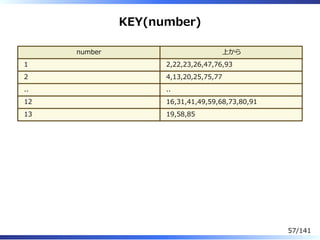
KEY(number)
number 上から
1 2,22,23,26,47,76,93
2 4,13,20,25,75,77
.. ..
12 16,31,41,49,59,68,73,80,91
13 19,58,85
57/141
ここからスペードのAを探す
インデックスからAを探して、「2, 22, 23, ..枚目」の情報
を得て
1.
ひっくり返してスペードかどうかを判定する2.
Aのリーフが全部終わったら終わり3.
type: ref, ref: const, Extra: Using where
58/141
スペードを全て探し出して、K〜Aの順で並べる
インデックスからKを探して19, 58, 85枚目を⼿に取る1.
スペードなら⼿元に、そうでなければよける2.
カードの⼭全てに対して1, 2を繰り返す3.
59/141
type: index, Extra: Using where
ただしこれはLIMITがない場合はテーブルスキャンを選んで
た
5.6の場合、LIMITがあってもテーブルスキャンを選ぶ-
そりゃ、結局全部のカードを裏返してるから、頭から全部ひ
っくり返した⽅が速い
LIMITがある= 「枚数が揃ったらそこでそれ以降の結果セ
ットは考慮する必要がない」
-
この条件にマッチした場合、フェッチする⾏数を⼤幅に
減らせる
-
60/141
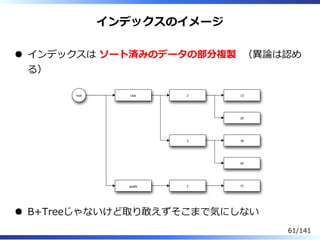
インデックスのイメージ
インデックスは ソート済みのデータの部分複製 (異論は認め
る)
root club
spade
2
3
2
13
20
18
45
77
B+Treeじゃないけど取り敢えずそこまで気にしない
61/141
インデックスのリーフ
root club
spade
2
3
2
13
20
18
45
77
MyISAMの場合はMYDファイルの先頭からのオフセットバイト
数
InnoDBの場合はクラスターインデックスの値 62/141
InnoDBのクラスターインデックスイメージ
root club
spade
3
5
13
14
2
23
root p3
p5
p13
p14
p2
p23
Club-A
Club-4
Club-2
Club-5
Spade-A
Spade-A
Secondary Index Clustered Index
63/141
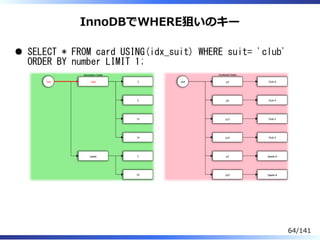
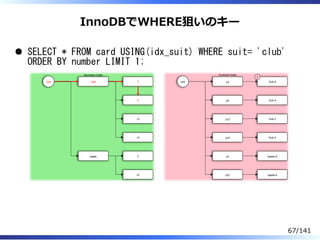
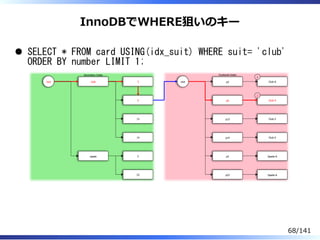
InnoDBでWHERE狙いのキー
SELECT * FROM card USING(idx_suit) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
3
5
13
14
2
23
root p3
p5
p13
p14
p2
p23
Club-A
Club-4
Club-2
Club-5
Spade-A
Spade-A
Secondary Index Clustered Index
64/141
InnoDBでWHERE狙いのキー
SELECT * FROM card USING(idx_suit) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
3
5
13
14
2
23
root p3
p5
p13
p14
p2
p23
Club-A
Club-4
Club-2
Club-5
Spade-A
Spade-A
Secondary Index Clustered Index
65/141
InnoDBでWHERE狙いのキー
SELECT * FROM card USING(idx_suit) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
3
5
13
14
2
23
root p3
p5
p13
p14
p2
p23
Club-A
1
Club-4
Club-2
Club-5
Spade-A
Spade-A
Secondary Index Clustered Index
66/141
InnoDBでWHERE狙いのキー
SELECT * FROM card USING(idx_suit) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
3
5
13
14
2
23
root p3
p5
p13
p14
p2
p23
Club-A
1
Club-4
Club-2
Club-5
Spade-A
Spade-A
Secondary Index Clustered Index
67/141
InnoDBでWHERE狙いのキー
SELECT * FROM card USING(idx_suit) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
3
5
13
14
2
23
root p3
p5
p13
p14
p2
p23
Club-A
1
Club-4
2
Club-2
Club-5
Spade-A
Spade-A
Secondary Index Clustered Index
68/141
InnoDBでWHERE狙いのキー
SELECT * FROM card USING(idx_suit) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
3
5
13
14
2
23
root p3
p5
p2
p23
p13
p14
Club-A
1
Club-4
2
Club-2
3
Club-5
4
Spade-A
Spade-A
Secondary Index Clustered Index
フェッチした⾏をクイックソートしてからLIMITを評価
69/141
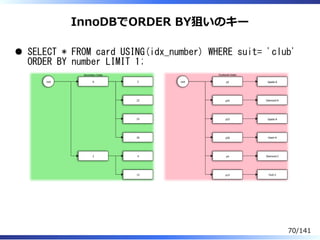
InnoDBでORDER BY狙いのキー
SELECT * FROM card USING(idx_number) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root A
2
2
22
23
26
4
13
root p2
p22
p23
p26
p4
p13
Spade-A
Diamond-A
Spade-A
Heart-A
Diamond-2
Club-2
Secondary Index Clustered Index
70/141
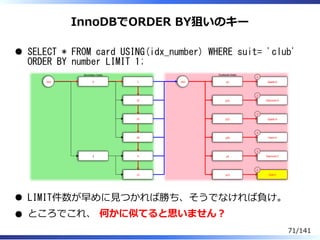
InnoDBでORDER BY狙いのキー
SELECT * FROM card USING(idx_number) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root A
2
2
22
23
26
4
13
root p2
p22
p23
p26
p4
p13
Spade-A
1
Diamond-A
2
Spade-A
3
Heart-A
4
Diamond-2
5
Club-2
6
Secondary Index Clustered Index
LIMIT件数が早めに⾒つかれば勝ち、そうでなければ負け。
ところでこれ、 何かに似てると思いません︖
71/141
InnoDBでcovering index
SELECT * FROM card USING(idx_number) WHERE suit= 'club'
ORDER BY number LIMIT 1;
root club
spade
2
3
A
13
20
18
45
2
23
root p13
p20
p18
p45
p2
p23
Club-2
1
Club-2
Club-3
Club-3
Spade-A
Spade-A
Secondary Index Clustered Index
72/141
WHERE狙いのキー, ORDER BY狙いのキー
WHEREとORDER BY .. LIMITを同時にカバーできるインデック
スが作成できない時に
WHEREをストレージエンジンに任せてフェッチする⾏を減
らしてファイルソートをExecutorにやらせるか
-
ORDER BY .. LIMITをストレージエンジンに任せて
ExecutorにフィルターさせつつLIMITでループを抜けるの
を期待するか
-
73/141
WHERE狙いのキー, ORDER BY狙いのキー
「JOINが遅い」はJOINが遅いんじゃなくてJOINの参照表で
ソートしようとしてExecutorがソートしちゃってるケース
あとはオプティマイザーにバグがあって、駆動表を
Executorがフィルターして参照表の参照回数が減る可能
性を考慮していない。
-
See also, http://www.slideshare.net/yoku0825/
whereorder-by
74/141
Executorに仕
事をさせたら
負け
75/141
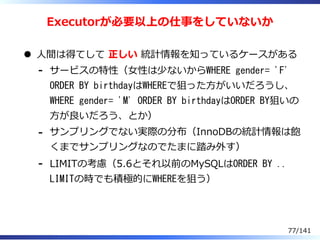
Executorが必要以上の仕事をしていないか
GROUP BYのケースを除いて、Rows_sent= Rows_examinedが⼀
番良い
MySQLにはヒストグラム統計がないので、WHERE狙いと
ORDER BY狙いのどちらが本当に速いのかMySQLは知らない
(憶えてない)
76/141
Executorが必要以上の仕事をしていないか
⼈間は得てして 正しい 統計情報を知っているケースがある
サービスの特性(⼥性は少ないからWHERE gender= 'F'
ORDER BY birthdayはWHEREで狙った⽅がいいだろうし、
WHERE gender= 'M' ORDER BY birthdayはORDER BY狙いの
⽅が良いだろう、とか)
-
サンプリングでない実際の分布(InnoDBの統計情報は飽
くまでサンプリングなのでたまに踏み外す)
-
LIMITの考慮(5.6とそれ以前のMySQLはORDER BY ..
LIMITの時でも積極的にWHEREを狙う)
-
77/141
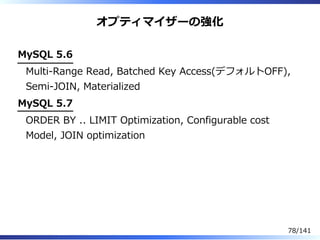
オプティマイザーの強化
MySQL 5.6
Multi-Range Read, Batched Key Access(デフォルトOFF),
Semi-JOIN, Materialized
MySQL 5.7
ORDER BY .. LIMIT Optimization, Configurable cost
Model, JOIN optimization
78/141
迷ったら最新(オ
プティマイザーに
関しては)
79/141
クエリーの最適化(5.5)
mysql55> EXPLAIN SELECT * FROM Country WHERE Continent = 'Asia' AND Code IN
io
n / 2);
+----+--------------------+---------+----------------+---------------+------
-------+---------+------+------+-------------+
e
y | key_len | ref | rows | Extra |
+----+--------------------+---------+----------------+---------------+------
-------+---------+------+------+-------------+
| 1 | PRIMARY | Country | ALL | NULL | NUL
L | NULL | NULL | 226 | Using where |
| 2 | DEPENDENT SUBQUERY | City | index_subquery | CountryCode | Count
ryCode | 3 | func | 7 | Using where |
+----+--------------------+---------+----------------+---------------+------
-------+---------+------+------+-------------+
2 rows in set (0.02 sec)
80/141
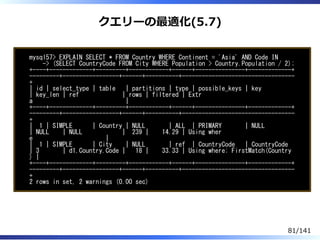
クエリーの最適化(5.7)
mysql57> EXPLAIN SELECT * FROM Country WHERE Continent = 'Asia' AND Code IN
-> (SELECT CountryCode FROM City WHERE Population > Country.Population / 2);
+----+-------------+---------+------------+------+---------------+-------------+
---------+-----------------+------+----------+----------------------------------
+
| id | select_type | table | partitions | type | possible_keys | key
| key_len | ref | rows | filtered | Extr
a |
+----+-------------+---------+------------+------+---------------+-------------+
---------+-----------------+------+----------+----------------------------------
+
| 1 | SIMPLE | Country | NULL | ALL | PRIMARY | NULL
| NULL | NULL | 239 | 14.29 | Using wher
e |
| 1 | SIMPLE | City | NULL | ref | CountryCode | CountryCode
| 3 | d1.Country.Code | 18 | 33.33 | Using where; FirstMatch(Country
) |
+----+-------------+---------+------------+------+---------------+-------------+
---------+-----------------+------+----------+----------------------------------
+
2 rows in set, 2 warnings (0.00 sec)
81/141
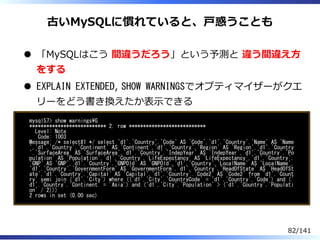
古いMySQLに慣れていると、⼾惑うことも
「MySQLはこう 間違うだろう」という予測と 違う間違え⽅
をする
EXPLAIN EXTENDED, SHOW WARNINGSでオプティマイザーがクエ
リーをどう書き換えたか表⽰できる
mysql57> show warningsG
*************************** 2. row ***************************
Level: Note
Code: 1003
Message: /* select#1 */ select `d1`.`Country`.`Code` AS `Code`,`d1`.`Country`.`Name` AS `Name
`,`d1`.`Country`.`Continent` AS `Continent`,`d1`.`Country`.`Region` AS `Region`,`d1`.`Country
`.`SurfaceArea` AS `SurfaceArea`,`d1`.`Country`.`IndepYear` AS `IndepYear`,`d1`.`Country`.`Po
pulation` AS `Population`,`d1`.`Country`.`LifeExpectancy` AS `LifeExpectancy`,`d1`.`Country`.
`GNP` AS `GNP`,`d1`.`Country`.`GNPOld` AS `GNPOld`,`d1`.`Country`.`LocalName` AS `LocalName`,
`d1`.`Country`.`GovernmentForm` AS `GovernmentForm`,`d1`.`Country`.`HeadOfState` AS `HeadOfSt
ate`,`d1`.`Country`.`Capital` AS `Capital`,`d1`.`Country`.`Code2` AS `Code2` from `d1`.`Count
ry` semi join (`d1`.`City`) where ((`d1`.`City`.`CountryCode` = `d1`.`Country`.`Code`) and (`
d1`.`Country`.`Continent` = 'Asia') and (`d1`.`City`.`Population` > (`d1`.`Country`.`Populati
on` / 2)))
2 rows in set (0.00 sec)
82/141
sysスキーマ
performance̲schema, information̲schemaのビューと、
performance̲schema関連の設定をゴニョるプロシージャ
の詰め合わせ
なのでperformance_schema= ONが⼤前提-
合わせて使いたいinnodb_monitor_enable= all-
5.6の場合はgitリポジトリーからcloneしてsqlスクリプト
実⾏
-
83/141
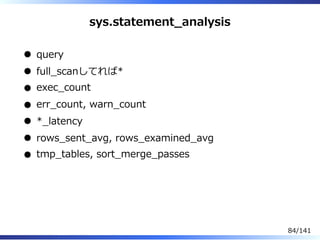
sys.statement̲analysis
query
full̲scanしてれば*
exec̲count
err̲count, warn̲count
*̲latency
rows̲sent̲avg, rows̲examined̲avg
tmp̲tables, sort̲merge̲passes
84/141
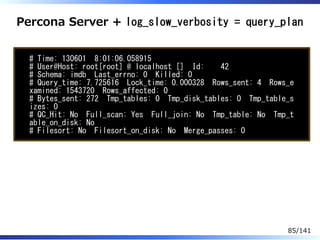
Percona Server + log_slow_verbosity = query_plan
# Time: 130601 8:01:06.058915
# User@Host: root[root] @ localhost [] Id: 42
# Schema: imdb Last_errno: 0 Killed: 0
# Query_time: 7.725616 Lock_time: 0.000328 Rows_sent: 4 Rows_e
xamined: 1543720 Rows_affected: 0
# Bytes_sent: 272 Tmp_tables: 0 Tmp_disk_tables: 0 Tmp_table_s
izes: 0
# QC_Hit: No Full_scan: Yes Full_join: No Tmp_table: No Tmp_t
able_on_disk: No
# Filesort: No Filesort_on_disk: No Merge_passes: 0
85/141
Anemometer
86/141
相関サブクエリー
外側のクエリーが内側のサブクエリーの条件になっているケ
ース
内側のサブクエリーが外側の条件になるケースはMySQL
⽤語では単にサブクエリーと呼ぶ(個⼈的には明確に区
別するために「キャッシャブルなサブクエリー」と呼ん
でる)
-
しかしWHERE INはキャッシャブルなサブクエリーのはず
でも相関サブクエリーになるというダメ仕様が5.5とそれ
以前にあってだな。。
-
87/141
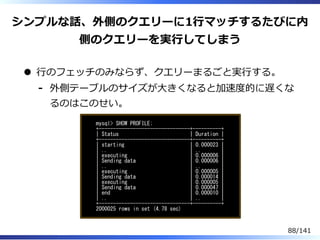
シンプルな話、外側のクエリーに1⾏マッチするたびに内
側のクエリーを実⾏してしまう
⾏のフェッチのみならず、クエリーまるごと実⾏する。
外側テーブルのサイズが⼤きくなると加速度的に遅くな
るのはこのせい。
-
mysql> SHOW PROFILE;
+--------------------------------+----------+
| Status | Duration |
+--------------------------------+----------+
| starting | 0.000023 |
| .. | .. |
| executing | 0.000006 |
| Sending data | 0.000006 |
| .. | .. |
| executing | 0.000005 |
| Sending data | 0.000014 |
| executing | 0.000005 |
| Sending data | 0.000047 |
| end | 0.000010 |
| .. | .. |
+--------------------------------+----------+
2000025 rows in set (4.78 sec)
88/141
相関サブクエリーの書き換え⽅
7割⽅JOINに書き換えられる
JOINに落とし込んでUSE INDEXまでつければ5.5とそれ以
前でも戦える
-
どうしてもロジックとしてJOINに書き換えられないケース
もある
CREATE TEMPORARY TABLEを使って落とし込むのがいい
テンポラリーテーブルはクラッシュアンセーフ( 更新
ステートメントには使わない︕ )
そもそもクラッシュアンセーフだから迷わずMyISAM
を選んでいい
⼤した量でなくてもインデックス張る。劇的に違う
-
のがいい、というか、SQLだけでやるにはそれしかない- 89/141
書き換える時に必要なもの
再帰テスト
無いと死ぬ-
ポジション上、返す結果が変わらないことの担保をしな
いといけない
パラメーター渡して、新旧クエリーの2パターン投げて
結果を⽐較するだけでも取り敢えずいいんだ
最近はコマンドラインクライアントで
REPEATABLE-READでトランザクション内でやればオ
ブジェクト⽐較するだけで済む
分布に極端な偏りがあるパラメーターはいくつかバリ
エーションを⽤意した⽅がいい(同じ形をしていても
パラメーターで実⾏計画は変わる)
-
90/141
ひとやす
み
91/141
Storage Engineが遅い理由
リソースが⾜りていない1.
パラメーターが適切でない2.
キャッシュミスヒット3.
ロックやmutexの競合(並列度が⾼すぎる)4.
バルク操作5.
92/141
リソースが⾜りていない
ホットデータが100GBあるのにInnoDBバッファプールが
16GBしかなかったら︖
物理メモリーが64GBしかないのに
innodb_buffer_pool_size= 128Gにしたら︖
50並列でクエリーを実⾏するのに8コアしかなかったら︖
秒間1000コミットあるのにIOPSが200しかなかったら︖
93/141
パラメーターが適切でない
innodb_buffer_pool_size
innodb_log_file_size * innodb_log_files_in_group
innodb_flush_method
innodb_log_buffer_size
innodb_flush_log_at_trx_commit
innodb_io_capacity, innodb_io_capacity_max
94/141
innodb̲buffer̲pool̲size
InnoDBの動作の要
個⼈的にはキャッシュじゃなくて データの本体-
⾜りてないとSELECTだけじゃなく全ての動作が遅い
ただしDROP TABLEとTRUNCATE TABLEはバッファプールが⼤き
ければ⼤きいほど遅くなる
95/141
InnoDBの動作の要
SELECTのとき
バッファプールを⾒る
あればそれを使う
なければテーブルスペースファイルを読んでバッファ
プールに載せる
バッファプールがいっぱいだったら⼀番古いのを追い
出してバッファプールに載せる
追い出そうとしたページがダーティーページだったら
フラッシュしてから追い出す
-
96/141
InnoDBの動作の要
INSERT, UPDATE, DELETEのとき
UNDOとログはちょっと省略
-
UPDATE, DELETEの時にPRIMARY KEY以外の属性で絞り込
む場合は、SELECTと同様にバッファプールを使って検索
する
-
97/141
InnoDBの動作の要
INSERT, UPDATE, DELETEのとき
データそのものの追加, 更新, 削除は最終的にクラスター
インデックスの値から、書き込むページ番号を特定する
バッファプールはCOMMIT前に更新される(COMMIT
されてるかどうかのフラグがある)
READ-UNCOMMITTEDはバッファプールから読んで
COMMITされてるかどうかのフラグを⾒ない
COMMITされてるかどうかに関わらず、古いファイル
はUNDOセグメントに移されて、そのページ番号がペ
ージに書き込まれる
-
98/141
対象のページがバッファプールに載っていれば
バッファプール上のデータを書き換える
InnoDBのDELETEは論理削除-
バッファプールのページに「delete mark」を付ける-
まだテーブルスペースファイルに反映されてないページ
のことを「ダーティーページ」と呼ぶ
ダーティーページはバッファプールから押し出される
時にテーブルスペースファイルにフラッシュされなけ
ればいけない
-
99/141