Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
ARISE analytics
PPTX, PDF
960 views
【論文読み会】MAUVE: Measuring the Gap Between Neural Text and Human Text using Divergence Frontiers
社内で行った「NeurIPS読み会」でまとめた資料です。
Data & Analytics
◦
Read more
0
Save
Share
Embed
Save to Drive
Download now
Download to read offline
1
/ 20
2
/ 20
3
/ 20
4
/ 20
5
/ 20
6
/ 20
7
/ 20
8
/ 20
9
/ 20
10
/ 20
11
/ 20
12
/ 20
13
/ 20
14
/ 20
15
/ 20
16
/ 20
17
/ 20
18
/ 20
19
/ 20
20
/ 20
More Related Content
PPTX
MAUVE: Measuring the Gap Between Neural Text and Human Text using Divergence ...
by
harmonylab
22 slides
647 views
PDF
深層学習の不確実性 - Uncertainty in Deep Neural Networks -
by
tmtm otm
137 slides
14.8K views
PDF
経験ベイズ木(IBIS 2017)
by
Masashi Sekino
12 slides
3.3K views
PDF
Word Tour: One-dimensional Word Embeddings via the Traveling Salesman Problem...
by
joisino
21 slides
5.8K views
PDF
cvpaper.challenge 研究効率化 Tips
by
cvpaper. challenge
204 slides
27.2K views
PDF
[DL輪読会]Decision Transformer: Reinforcement Learning via Sequence Modeling
by
Deep Learning JP
25 slides
3.8K views
PDF
【博士論文発表会】パラメータ制約付き特異モデルの統計的学習理論
by
Naoki Hayashi
74 slides
1.9K views
PDF
機械学習の理論と実践
by
Preferred Networks
98 slides
212.9K views
MAUVE: Measuring the Gap Between Neural Text and Human Text using Divergence ...
by
harmonylab
22 slides
647 views
深層学習の不確実性 - Uncertainty in Deep Neural Networks -
by
tmtm otm
137 slides
14.8K views
経験ベイズ木(IBIS 2017)
by
Masashi Sekino
12 slides
3.3K views
Word Tour: One-dimensional Word Embeddings via the Traveling Salesman Problem...
by
joisino
21 slides
5.8K views
cvpaper.challenge 研究効率化 Tips
by
cvpaper. challenge
204 slides
27.2K views
[DL輪読会]Decision Transformer: Reinforcement Learning via Sequence Modeling
by
Deep Learning JP
25 slides
3.8K views
【博士論文発表会】パラメータ制約付き特異モデルの統計的学習理論
by
Naoki Hayashi
74 slides
1.9K views
機械学習の理論と実践
by
Preferred Networks
98 slides
212.9K views
What's hot
PPTX
XAI (説明可能なAI) の必要性
by
西岡 賢一郎
20 slides
1.5K views
PDF
全力解説!Transformer
by
Arithmer Inc.
43 slides
12.8K views
PDF
ノンパラベイズ入門の入門
by
Shuyo Nakatani
33 slides
27.7K views
PDF
Optunaを使ったHuman-in-the-loop最適化の紹介 - 2023/04/27 W&B 東京ミートアップ #3
by
Preferred Networks
36 slides
3K views
PDF
【メタサーベイ】基盤モデル / Foundation Models
by
cvpaper. challenge
63 slides
20.6K views
PPTX
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets
by
Deep Learning JP
17 slides
4.6K views
PDF
Stan超初心者入門
by
Hiroshi Shimizu
156 slides
90.2K views
PDF
[DL輪読会]ICLR2020の分布外検知速報
by
Deep Learning JP
12 slides
6.2K views
PPTX
東京大学2020年度深層学習(Deep learning基礎講座) 第9回「深層学習と自然言語処理」
by
Hitomi Yanaka
69 slides
5.2K views
PPTX
[DL輪読会]Life-Long Disentangled Representation Learning with Cross-Domain Laten...
by
Deep Learning JP
42 slides
5.9K views
PDF
トピックモデルの評価指標 Perplexity とは何なのか?
by
hoxo_m
15 slides
47.1K views
PDF
グラフィカル Lasso を用いた異常検知
by
Yuya Takashina
35 slides
16.7K views
PDF
生成モデルの Deep Learning
by
Seiya Tokui
38 slides
48.6K views
PDF
【DL輪読会】Perceiver io a general architecture for structured inputs & outputs
by
Deep Learning JP
23 slides
1.9K views
PPTX
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
PDF
統計的因果推論への招待 -因果構造探索を中心に-
by
Shiga University, RIKEN
56 slides
29.1K views
PDF
LDA入門
by
正志 坪坂
39 slides
76.9K views
PDF
Transformer メタサーベイ
by
cvpaper. challenge
181 slides
31.4K views
PDF
数式からみるWord2Vec
by
Okamoto Laboratory, The University of Electro-Communications
37 slides
12.7K views
PDF
SSII2022 [OS3-02] Federated Learningの基礎と応用
by
SSII
38 slides
3.4K views
XAI (説明可能なAI) の必要性
by
西岡 賢一郎
20 slides
1.5K views
全力解説!Transformer
by
Arithmer Inc.
43 slides
12.8K views
ノンパラベイズ入門の入門
by
Shuyo Nakatani
33 slides
27.7K views
Optunaを使ったHuman-in-the-loop最適化の紹介 - 2023/04/27 W&B 東京ミートアップ #3
by
Preferred Networks
36 slides
3K views
【メタサーベイ】基盤モデル / Foundation Models
by
cvpaper. challenge
63 slides
20.6K views
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets
by
Deep Learning JP
17 slides
4.6K views
Stan超初心者入門
by
Hiroshi Shimizu
156 slides
90.2K views
[DL輪読会]ICLR2020の分布外検知速報
by
Deep Learning JP
12 slides
6.2K views
東京大学2020年度深層学習(Deep learning基礎講座) 第9回「深層学習と自然言語処理」
by
Hitomi Yanaka
69 slides
5.2K views
[DL輪読会]Life-Long Disentangled Representation Learning with Cross-Domain Laten...
by
Deep Learning JP
42 slides
5.9K views
トピックモデルの評価指標 Perplexity とは何なのか?
by
hoxo_m
15 slides
47.1K views
グラフィカル Lasso を用いた異常検知
by
Yuya Takashina
35 slides
16.7K views
生成モデルの Deep Learning
by
Seiya Tokui
38 slides
48.6K views
【DL輪読会】Perceiver io a general architecture for structured inputs & outputs
by
Deep Learning JP
23 slides
1.9K views
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
統計的因果推論への招待 -因果構造探索を中心に-
by
Shiga University, RIKEN
56 slides
29.1K views
LDA入門
by
正志 坪坂
39 slides
76.9K views
Transformer メタサーベイ
by
cvpaper. challenge
181 slides
31.4K views
数式からみるWord2Vec
by
Okamoto Laboratory, The University of Electro-Communications
37 slides
12.7K views
SSII2022 [OS3-02] Federated Learningの基礎と応用
by
SSII
38 slides
3.4K views
More from ARISE analytics
PDF
20260828_AriseUniversityTraning_生成AI講座_テックブログ
by
ARISE analytics
30 slides
1 view
PDF
ARISE analytics 会社紹介パンフレット ~2025年度版~ ご自由にダウンロードください。
by
ARISE analytics
10 slides
136 views
PDF
AgentOps:AIエージェント時代の幕開けとガバナンスについて ~AgentOpsの体系的な理解を目指して~
by
ARISE analytics
32 slides
749 views
PDF
【JSAI2024】学術論文の定量的評価と効果的な活用について Quantitative evaluation and effective utiliza...
by
ARISE analytics
1 slide
783 views
PDF
【JSAI2024】J-NER大規模言語モデルのための固有表現認識における拡張固有表現階層を考慮したベンチマークデータセット.pdf
by
ARISE analytics
1 slide
543 views
PDF
【JSAI2024】ブラックボックス大規模言語モデルにおけるHallucination検知手法の検討.pdf
by
ARISE analytics
1 slide
633 views
PDF
【JSAI2024】LLMエージェントの人間との対話における反芻的返答の親近感向上効果_v1.1.pdf
by
ARISE analytics
1 slide
501 views
PPTX
【第3回生成AIなんでもLT会資料】_動画生成AIと物理法則_v0.2.pptx
by
ARISE analytics
18 slides
797 views
PPTX
【第3回】生成AIなんでもLT会 2024_0304なんでも生成AI_sergicalsix.pptx
by
ARISE analytics
19 slides
1.3K views
PDF
めんどうな環境構築とはおさらば!Dockerの概要と使い方
by
ARISE analytics
23 slides
398 views
PDF
【論文レベルで理解しよう!】 欠測値処理編
by
ARISE analytics
19 slides
643 views
PDF
【論文レベルで理解しよう!】 大規模言語モデル(LLM)編
by
ARISE analytics
20 slides
1K views
PDF
【論文読み会】Signing at Scale: Learning to Co-Articulate Signs for Large-Scale Pho...
by
ARISE analytics
32 slides
444 views
PDF
Hierarchical Metadata-Aware Document Categorization under Weak Supervision (...
by
ARISE analytics
24 slides
254 views
PDF
教師なしGNNによるIoTデバイスの異常通信検知の検討
by
ARISE analytics
21 slides
1.8K views
PPTX
【論文読み会】Pyraformer_Low-Complexity Pyramidal Attention for Long-Range Time Seri...
by
ARISE analytics
18 slides
893 views
PPTX
【論文読み会】Analytic-DPM_an Analytic Estimate of the Optimal Reverse Variance in D...
by
ARISE analytics
17 slides
712 views
PPTX
【論文読み会】Autoregressive Diffusion Models.pptx
by
ARISE analytics
27 slides
6.7K views
PPTX
【論文読み会】BEiT_BERT Pre-Training of Image Transformers.pptx
by
ARISE analytics
29 slides
1.1K views
PPTX
【論文読み会】PiCO_Contrastive Label Disambiguation for Partial Label Learning.pptx
by
ARISE analytics
21 slides
811 views
20260828_AriseUniversityTraning_生成AI講座_テックブログ
by
ARISE analytics
30 slides
1 view
ARISE analytics 会社紹介パンフレット ~2025年度版~ ご自由にダウンロードください。
by
ARISE analytics
10 slides
136 views
AgentOps:AIエージェント時代の幕開けとガバナンスについて ~AgentOpsの体系的な理解を目指して~
by
ARISE analytics
32 slides
749 views
【JSAI2024】学術論文の定量的評価と効果的な活用について Quantitative evaluation and effective utiliza...
by
ARISE analytics
1 slide
783 views
【JSAI2024】J-NER大規模言語モデルのための固有表現認識における拡張固有表現階層を考慮したベンチマークデータセット.pdf
by
ARISE analytics
1 slide
543 views
【JSAI2024】ブラックボックス大規模言語モデルにおけるHallucination検知手法の検討.pdf
by
ARISE analytics
1 slide
633 views
【JSAI2024】LLMエージェントの人間との対話における反芻的返答の親近感向上効果_v1.1.pdf
by
ARISE analytics
1 slide
501 views
【第3回生成AIなんでもLT会資料】_動画生成AIと物理法則_v0.2.pptx
by
ARISE analytics
18 slides
797 views
【第3回】生成AIなんでもLT会 2024_0304なんでも生成AI_sergicalsix.pptx
by
ARISE analytics
19 slides
1.3K views
めんどうな環境構築とはおさらば!Dockerの概要と使い方
by
ARISE analytics
23 slides
398 views
【論文レベルで理解しよう!】 欠測値処理編
by
ARISE analytics
19 slides
643 views
【論文レベルで理解しよう!】 大規模言語モデル(LLM)編
by
ARISE analytics
20 slides
1K views
【論文読み会】Signing at Scale: Learning to Co-Articulate Signs for Large-Scale Pho...
by
ARISE analytics
32 slides
444 views
Hierarchical Metadata-Aware Document Categorization under Weak Supervision (...
by
ARISE analytics
24 slides
254 views
教師なしGNNによるIoTデバイスの異常通信検知の検討
by
ARISE analytics
21 slides
1.8K views
【論文読み会】Pyraformer_Low-Complexity Pyramidal Attention for Long-Range Time Seri...
by
ARISE analytics
18 slides
893 views
【論文読み会】Analytic-DPM_an Analytic Estimate of the Optimal Reverse Variance in D...
by
ARISE analytics
17 slides
712 views
【論文読み会】Autoregressive Diffusion Models.pptx
by
ARISE analytics
27 slides
6.7K views
【論文読み会】BEiT_BERT Pre-Training of Image Transformers.pptx
by
ARISE analytics
29 slides
1.1K views
【論文読み会】PiCO_Contrastive Label Disambiguation for Partial Label Learning.pptx
by
ARISE analytics
21 slides
811 views
【論文読み会】MAUVE: Measuring the Gap Between Neural Text and Human Text using Divergence Frontiers
1.
MAUVE: Measuring the
Gap Between Neural Text and Human Text using Divergence Frontiers Customer Analytics Division 奥井 恒 2022/03/10
2.
目次 ©2022 ARISE analytics
Reserved. 1 1. 導入 2. MAUVE 3. 実験 4. まとめ
3.
背景・目的 ©2022 ARISE analytics
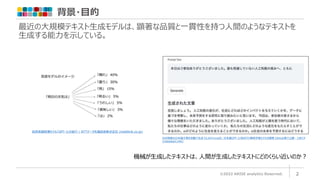
Reserved. 2 最近の大規模テキスト生成モデルは、顕著な品質と一貫性を持つ人間のようなテキストを 生成する能力を示している。 AIが高度な日本語文章を自動で生成 りんなのrinna社、日本語GPT-2/BERTの事前学習モデルを開発 GitHub等で公開 - ロボスタ (robotstart.info) 機械が生成したテキストは、人間が生成したテキストにどのくらい近いのか? 自然言語処理モデル「GPT-3」の紹介 | NTTデータ先端技術株式会社 (intellilink.co.jp)
4.
未解決問題 ©2022 ARISE analytics
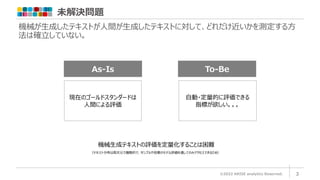
Reserved. 3 機械が生成したテキストが人間が生成したテキストに対して、どれだけ近いかを測定する方 法は確立していない。 機械生成テキストの評価を定量化することは困難 (テキスト分布は高次元で離散的で、サンプルや効果のモデル評価を通してのみアクセスできるため) To-Be 現在のゴールドスタンダードは 人間による評価 自動・定量的に評価できる 指標が欲しい。。。 As-Is
5.
©2022 ARISE analytics
Reserved. 4 1. 導入 2. MAUVE 3. 実験 4. まとめ
6.
MAUVE:概要 ©2022 ARISE analytics
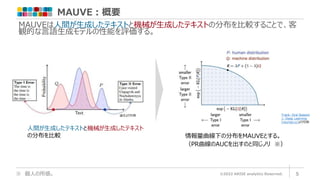
Reserved. 5 ※ 個人の所感。 MAUVEは人間が生成したテキストと機械が生成したテキストの分布を比較することで、客 観的な言語生成モデルの性能を評価する。 人間が生成したテキストと機械が生成したテキスト の分布を比較 情報量曲線下の分布をMAUVEとする。 (PR曲線のAUCを出すのと同じノリ ※) Track: Oral Session 1: Deep Learning (neurips.cc)より引用 論文より引用
7.
2種類のエラー ©2022 ARISE analytics
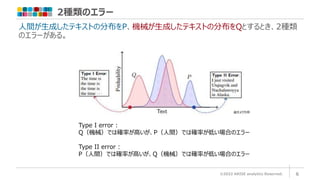
Reserved. 6 人間が生成したテキストの分布をP、機械が生成したテキストの分布をQとするとき、2種類 のエラーがある。 Type I error : Q(機械)では確率が高いが、P(人間)では確率が低い場合のエラー Type II error : P(人間)では確率が高いが、Q(機械)では確率が低い場合のエラー 論文より引用
8.
MAUVE ©2022 ARISE analytics
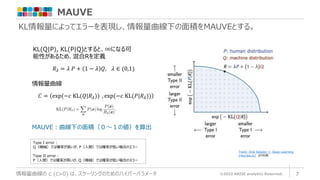
Reserved. 7 情報量曲線の c (c>0) は、スケーリングのためのハイパーパラメータ KL情報量によってエラーを表現し、情報量曲線下の面積をMAUVEとする。 Track: Oral Session 1: Deep Learning (neurips.cc) より引用 MAUVE:曲線下の面積(0~1の値)を算出 𝑅𝜆 = 𝜆 𝑃 + 1 − 𝜆 𝑄, 𝜆 ∈ (0,1) KL(Q|P), KL(P|Q)とすると、∞になる可 能性があるため、混合Rを定義 Type I error : Q(機械)では確率が高いが、P(人間)では確率が低い場合のエラー Type II error : P(人間)では確率が高いが、Q(機械)では確率が低い場合のえラー 𝐶 = exp(−𝑐 KL(𝑄|𝑅𝜆)) , exp(−𝑐 KL(𝑃|𝑅𝜆)) 情報量曲線
9.
©2022 ARISE analytics
Reserved. 8 1. 導入 2. MAUVE 3. 実験 4. まとめ
10.
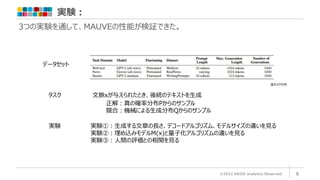
実験: ©2022 ARISE analytics
Reserved. 9 3つの実験を通して、MAUVEの性能が検証できた。 データセット タスク 文脈xが与えられたとき、後続のテキストを生成 正解:真の確率分布Pからのサンプル 競合:機械による生成分布Qからのサンプル 実験 実験①:生成する文章の長さ、デコードアルゴリズム、モデルサイズの違いを見る 実験②:埋め込みモデルM(x)と量子化アルゴリズムの違いを見る 実験③:人間の評価との相関を見る 論文より引用
11.
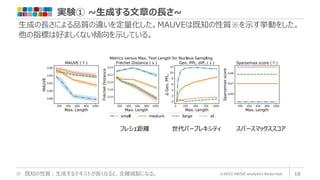
実験① ~生成する文章の長さ~ ©2022 ARISE
analytics Reserved. 10 ※ 既知の性質:生成するテキストが長くなると、支離滅裂になる。 生成の長さによる品質の違いを定量化した。MAUVEは既知の性質※を示す挙動をした。 他の指標は好ましくない傾向を示している。 フレシェ距離 世代パープレキシティ スパースマックススコア
12.
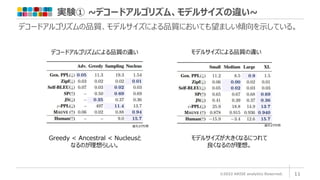
実験① ~デコードアルゴリズム、モデルサイズの違い~ ©2022 ARISE
analytics Reserved. 11 デコードアルゴリズムの品質、モデルサイズによる品質においても望ましい傾向を示している。 Greedy < Ancestral < Nucleusと なるのが理想らしい。 モデルサイズが大きくなるにつれて 良くなるのが理想。 デコードアルゴリズムによる品質の違い モデルサイズによる品質の違い 論文より引用 論文より引用
13.
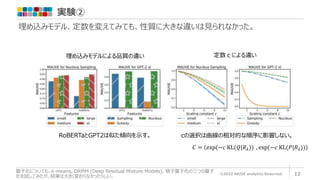
実験② ©2022 ARISE analytics
Reserved. 12 量子化についても、k-means, DRMM (Deep Residual Mixture Models), 格子量子化の三つの量子 化を試してみたが、結果は大きく変わらなかったらしい。 埋め込みモデル、定数を変えてみても、性質に大きな違いは見られなかった。 埋め込みモデルによる品質の違い RoBERTaとGPT2は似た傾向を示す。 cの選択は曲線の相対的な順序に影響しない。 定数cによる違い 𝐶 = exp(−𝑐 KL(𝑄|𝑅𝜆)) , exp(−𝑐 KL(𝑃|𝑅𝜆))
14.
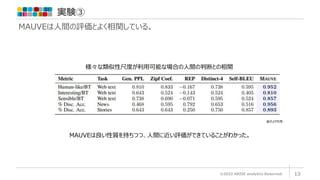
実験③ ©2022 ARISE analytics
Reserved. 13 MAUVEは人間の評価とよく相関している。 様々な類似性尺度が利用可能な場合の人間の判断との相関 MAUVEは良い性質を持ちつつ、人間に近い評価ができていることがわかった。 論文より引用
15.
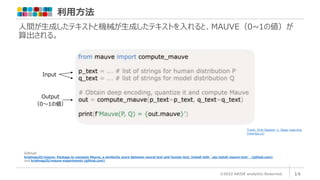
利用方法 ©2022 ARISE analytics
Reserved. 14 人間が生成したテキストと機械が生成したテキストを入れると、MAUVE(0~1の値)が 算出される。 Github krishnap25/mauve: Package to compute Mauve, a similarity score between neural text and human text. Install with `pip install mauve-text`. (github.com) and krishnap25/mauve-experiments (github.com) Input Output (0~1の値) Track: Oral Session 1: Deep Learning (neurips.cc)
16.
©2022 ARISE analytics
Reserved. 15 1. 導入 2. MAUVE 3. 実験 4. まとめ
17.
まとめ ©2022 ARISE analytics
Reserved. 16 論文サマリーの内容 • テキスト生成において、人間が作成したテキストと機械が作成したテキストがどれだけ近いのかを評価するための定量的 な指標を提案している。 • 人間の判断と相関もあり、先行研究による指標では捉えにくい、生成長・デコードアルゴリズム・モデルサイズによる品質 の違いも特定できた。 • 今後は、MAUVEを要約や翻訳などの特定タスクでの評価に使用できるか検討していきたいらしい。
18.
Best Partner for
innovation, Best Creator for the future.
19.
References ©2022 ARISE analytics
Reserved. 18 • Paper MAUVE: Measuring the Gap Between Neural Text and Human Text using Divergence Frontiers | OpenReview • Video in NeurIPS2021 Track: Oral Session 1: Deep Learning (neurips.cc) • Github • krishnap25/mauve: Package to compute Mauve, a similarity score between neural text and human text. Install with `pip install mauve-text`. (github.com) • krishnap25/mauve-experiments (github.com)
20.
おまけ ©2022 ARISE analytics
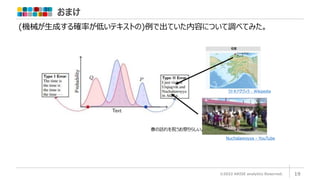
Reserved. 19 (機械が生成する確率が低いテキストの)例で出ていた内容について調べてみた。 ウトキアグヴィク - Wikipedia 春の訪れを祝うお祭りらしい。 Nuchalawoyya - YouTube