深層学習における予測の不確実性
@ottamm_190
はじめに
深層学習における予測の不確実性について以下の論文をベースに説明します.
A Survey of Uncertainty in Deep Neural Networks (https://arxiv.org/abs/2107.03342)
深層学習を用いている研究者,開発者の方に有益になると嬉しいです.
対象者:深層学習の予測の不確実性ってどこで役に立つの?
どうやって不確実性を定量化しているの?と思った人向け.
前提知識:確率・統計の基礎,機械(深層) 学習の教科書レベル,最近のMLトピック
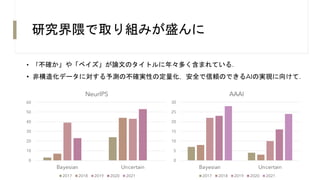
研究界隈で取り組みが盛んに
0
10
20
30
40
50
60
Bayesian Uncertain
NeurIPS
2017 2018 2019 2020 2021
0
5
10
15
20
25
30
Bayesian Uncertain
AAAI
2017 2018 2019 2020 2021
• 「不確か」や「ベイズ」が論文のタイトルに年々多く含まれている.
• 非構造化データに対する予測の不確実性の定量化,安全で信頼のできるAIの実現に向けて.
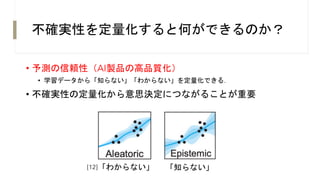
不確実性を定量化すると何ができるのか?
• 予測の信頼性(AI製品の高品質化)
• 学習データから「知らない」「わからない」を定量化できる.
• 不確実性の定量化から意思決定につながることが重要
「知らない」
「わからない」
[12]
どんな意思決定につながるか?
不確実性の定量化による意思決定(AI製品の場合)
• データ準備:大量にあるデータのどれにラベル付けするべきか
• 能動学習,ベイズ最適化
• 推論:予測結果をもとに施策を打つべきか(機械の制御等)
• キャリブレーション,モデルの不確実性,データの不確実性
• 運用:いつ再学習すべきか(学習時とデータの傾向の変化)
• OOD検知,データ分布シフト検知
サーベイをした感想
MLシステムに組み込むことを考えた不確実性の研究が増えていると思った.
不確実性:データ分布シフト,OODといった機械学習システムの運用時に必要な実用
的な不確実性が多い印象.
推定方法:アンサンブル方法の計算コストを削減するため,多様性のあるメンバーを選
ぶなど効率化に関する研究に目を引いた.
キャリブレーション:分類の信頼度が過信な傾向を抑制する方法にMixUpといったソフ
トラベルで学習すると効果的だと学べた.
補足:図や表に引用の明記がない場合,サーベイ論文A Survey of Uncertainty in Deep
Neural Networks から引用しています.
アジェンダ
• 不確実性の推定値を用いた実世界アプリケーション
• 不確実性の原因
• DNNにおける不確実性の分類
• 不確実性の推定方法
• 不確実性の評価指標と品質
• DNNのキャリブレーション
• 現在の課題と研究の方向性
予測の不確実性が役立つ場面
人命に関わるAIシステム
• 自動運転,医療画像解析,ロボット
ノイズの多いデータを扱う領域
• 地球観測データ,様々なセンサデータ
AIシステムの準備・運用
• データのラベル付け,コンセプトドリフト検知
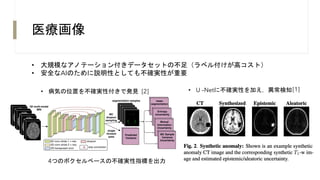
医療画像
• 病気の位置を不確実性付きで発見
4つのボクセルベースの不確実性指標を出力
• 大規模なアノテーション付きデータセットの不足(ラベル付けが高コスト)
• 安全なAIのために説明性としても不確実性が重要
• U –Netに不確実性を加え,異常検知[1]
[2]
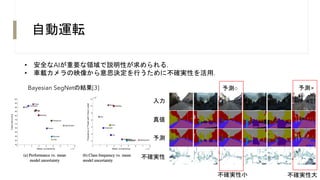
自動運転
• 安全なAIが重要な領域で説明性が求められる.
• 車載カメラの映像から意思決定を行うために不確実性を活用.
Bayesian SegNetの結果[3]
入力
真値
予測
不確実性
予測×
不確実性大
不確実性小
予測○
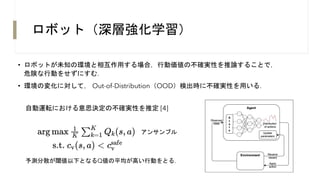
ロボット(深層強化学習)
• ロボットが未知の環境と相互作用する場合,行動価値の不確実性を推論することで,
危険な行動をせずにすむ.
• 環境の変化に対して, Out-of-Distribution(OOD)検出時に不確実性を用いる.
自動運転における意思決定の不確実性を推定 [4]
予測分散が閾値以下となるQ値の平均が高い行動をとる.
アンサンブル
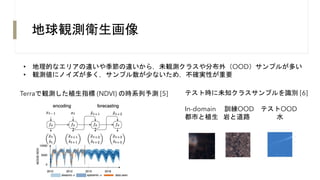
地球観測衛生画像
Terraで観測した植生指標 (NDVI) の時系列予測 [5]
• 地理的なエリアの違いや季節の違いから,未観測クラスや分布外(OOD)サンプルが多い
• 観測値にノイズが多く,サンプル数が少ないため,不確実性が重要
テスト時に未知クラスサンプルを識別 [6]
In-domain 訓練OOD テストOOD
都市と植生 岩と道路 水
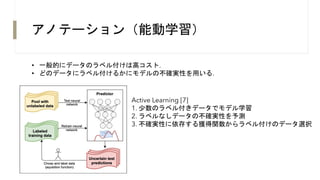
アノテーション(能動学習)
• 一般的にデータのラベル付けは高コスト.
• どのデータにラベル付けるかにモデルの不確実性を用いる.
Active Learning [7]
1. 少数のラベル付きデータでモデル学習
2. ラベルなしデータの不確実性を予測
3. 不確実性に依存する獲得関数からラベル付けのデータ選択
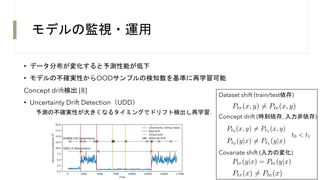
モデルの監視・運用
• データ分布が変化すると予測性能が低下
• モデルの不確実性からOODサンプルの検知数を基準に再学習可能
Concept drift検出 [8]
• Uncertainty Drift Detection(UDD)
予測の不確実性が大きくなるタイミングでドリフト検出し再学習.
Dataset shift (train/test依存)
Concept drift (時刻依存, 入力非依存)
Covariate shift (入力の変化)
<latexit sha1_base64="q3qPLDB+h6HWaBkKdK0c95ZgK7M=">AAACh3ichVE9S8NAGH6MXzV+tOoiuJQWRUHqpYOKU8XFsX5UhbaUJJ4amiYxuRZrcRf/gIOTgogIrrq7+Acc+hPEUcHFwTdpQFTU97i75557n/eeu9Mc0/AEY802qb2js6s70iP39vUPRGODQ+ueXXV1ntNt03Y3NdXjpmHxnDCEyTcdl6sVzeQbWnnR39+ocdczbGtN1B1erKg7lrFt6KogqhRLFPJyttQQ7uHE/lR9Ml6w+F7cJ3iLkAvFUizJUiyI+E+ghCCJMLJ27BIFbMGGjioq4LAgCJtQ4VHLQwGDQ1wRDeJcQkawz3EImbRVyuKUoRJbpnGHVvmQtWjt1/QCtU6nmNRdUsYxxh7ZFXthD+yaPbH3X2s1ghq+lzrNWkvLnVL0eGT17V9VhWaB3U/Vn54FtjEXeDXIuxMw/i30lr52cPKyOr8y1hhn5+yZ/J+xJrunG1i1V/1ima+cQqYPUL4/90+wnk4pMyllOZ3MzIVfEcEoEpig955FBkvIIkfnHuEGt7iTeqRpaUYKc6W2UDOMLyEtfACVpZVD</latexit>
Ptr(x, y) 6= Pte(x, y)
<latexit sha1_base64="dmodCR/dB6gaEcNPnf5oiC9N32Q=">AAACiXichVHLLgRBFD3au70GG4nNxCAkMrltwcRKYmM5HoNkZtLpboWOnu7WXTMxJn7AD1hYkYiIjS1bGz9g4RPEksTGwp2eTgTBrVTVqVP33DpVZfqOHUqixyaluaW1rb2jU+3q7untS/QPrIVeObBEzvIcL9gwjVA4tity0paO2PADYZRMR6ybuwv1/fWKCELbc1dl1RfFkrHt2lu2ZUim9MRoIa9m9ZrU6XBif6o6mSy4Yi8ZMVqDUQtFPZGiNEWR/Am0GKQQR9ZLXKCATXiwUEYJAi4kYwcGQm55aCD4zBVRYy5gZEf7AodQWVvmLMEZBrO7PG7zKh+zLq/rNcNIbfEpDveAlUmM0QNd0gvd0xU90fuvtWpRjbqXKs9mQyt8ve9oaOXtX1WJZ4mdT9WfniW2kIm82uzdj5j6LayGvnJw/LIytzxWG6czemb/p/RId3wDt/JqnS+J5ROo/AHa9+f+Cdam09pMWluaTs1n4q/owDBGMMHvPYt5LCKLHJ97hGvc4FbpUjQlo8w1UpWmWDOIL6EsfACBIZWf</latexit>
Pt0 (x, y) 6= Pt1 (x, y)
<latexit sha1_base64="O3rv97CguKhha/gwk6tWl1tqy3I=">AAACiXichVHLLgRBFD3au70GG4nNxCBsJrctmFhJbCzHY5DMTDrdrdDR0926aybG8AN+wMKKRERsbNna+AELnyCWJDYW7vR0IghupapOnbrn1qkq03fsUBI9NinNLa1t7R2dald3T29fon9gNfTKgSVylud4wbpphMKxXZGTtnTEuh8Io2Q6Ys3cma/vr1VEENqeuyKrviiWjC3X3rQtQzKlJ0YLeTWr16ROhxPVg73JZMEVu8mI0RqMWijqiRSlKYrkT6DFIIU4sl7iAgVswIOFMkoQcCEZOzAQcstDA8FnrogacwEjO9oXOITK2jJnCc4wmN3hcYtX+Zh1eV2vGUZqi09xuAesTGKMHuiSXuieruiJ3n+tVYtq1L1UeTYbWuHrfUdDy2//qko8S2x/qv70LLGJTOTVZu9+xNRvYTX0lf3jl+XZpbHaOJ3RM/s/pUe64xu4lVfrfFEsnUDlD9C+P/dPsDqV1qbT2uJUai4Tf0UHhjGCCX7vGcxhAVnk+NwjXOMGt0qXoikZZbaRqjTFmkF8CWX+A8n0lj8=</latexit>
Pt0 (y|x) 6= Pt1 (y|x)
<latexit sha1_base64="vQ+PrdtVsHlDrH+8tTh1pL7CQgI=">AAACg3ichVHLSsNAFD1GqzW+qm4EQYpFUYQyKaIiCAU3LuujWmhLSeKowTSJybRYS3eu/AEXrhRE1KX+gRt/wIWfIC4V3LjwJg2IinpDZs49c8+dMzOaYxqeYOyxRWpti7R3RDvlru6e3r5Y/8C6Z1dcnWd127TdnKZ63DQsnhWGMHnOcbla1ky+oe0u+usbVe56hm2tiZrDi2V12zK2DF0VRJViI4W8nCnVhduY2J+MFyy+F/dT7qdyoViKJViSBRH/CZQQJBBGxo5doIBN2NBRQRkcFgRhEyo8+vJQwOAQV0SdOJeQEaxzNCCTtkJVnCpUYndp3KYsH7IW5X5PL1DrtItJv0vKOMbYA7tkL+yeXbMn9v5rr3rQw/dSo1lrarlT6jsaWn37V1WmWWDnU/WnZ4EtzAVeDfLuBIx/Cr2prx4cv6zOr4zVx9kZeyb/p+yR3dEJrOqrfr7MV04g0wMo36/7J1hPJZWZpLKcSqTnwqeIYhijmKD7nkUaS8ggS/se4go3uJUi0pSUkqabpVJLqBnEl5AWPgBACZPR</latexit>
Ptr(x) 6= Pte(x)
<latexit sha1_base64="lbhwriPVxNzGg1sc//i1mE3EjLk=">AAAChHichVHLSsNAFD3Gd3xV3QguLJaKgpSJ4gNBEdy4rI+2QltKEqcaTJOQTIu1unTjD7hwpSAibvUL3PgDLvwEcVnBjQtv0oCoqDdk5twz99w5M6M5puEJxp6apOaW1rb2jk65q7unty/SP5D27LKr85Rum7a7pakeNw2Lp4QhTL7luFwtaSbPaHsr/nqmwl3PsK1NUXV4vqTuWEbR0FVBVCEyksvKyUJNuEfj1cP9iehi1M94I5Nz+UIkxhIsiOhPoIQghjCSduQKOWzDho4ySuCwIAibUOHRl4UCBoe4PGrEuYSMYJ3jCDJpy1TFqUIldo/GHcqyIWtR7vf0ArVOu5j0u6SMIs4e2TWrswd2w57Z+6+9akEP30uVZq2h5U6h72Ro4+1fVYlmgd1P1Z+eBYqYD7wa5N0JGP8UekNfOTitbyysx2tj7IK9kP9z9sTu6QRW5VW/XOPrZ5DpAZTv1/0TpKcSymxCWZuKLc+HT9GBYYxinO57DstYRRIp2vcYN7jFndQmTUrT0kyjVGoKNYP4EtLSB4AelGI=</latexit>
Ptr(y|x) = Pte(y|x)
<latexit sha1_base64="+CIw9X/o1fzL3yc4HI32nnvbCu4=">AAACdHichVHLSsNAFD2N7/ho1Y2gi2KpuCo3LlTEheDGpa9qoS0hidMaTJOQTAta/AF/wIUrRRHxM9z4Ay78BHGp6MaFt2lAtKg3TObMmXvunJlr+o4dSqLHhNLV3dPb1z+gDg4NjyRTo2M7oVcPLJG3PMcLCqYRCsd2RV7a0hEFPxBGzXTErnmw2trfbYggtD13Wx76olwzqq5dsS1DMqWnkqWiKnVKL6elrqmlsp7KUI6iSHcCLQYZxLHupa5Rwh48WKijBgEXkrEDAyF/RWgg+MyV0WQuYGRH+wLHUFlb5yzBGQazB/yv8qoYsy6vWzXDSG3xKQ6PgJVpZOmBbuiF7umWnujj11rNqEbLyyHPZlsrfD15MrH1/q+qxrPE/pfqT88SFSxGXm327kdM6xZWW984On3ZWtrMNmfogp7Z/zk90h3fwG28WlcbYvMMKjdA+/ncnWBnLqfN57SNuczKYtyKfkxiGrP83gtYwRrWkY96coZLXCXelCklo2TbqUoi1ozjWyi5T8KPjj4=</latexit>
t0 < t1
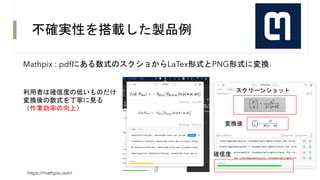
不確実性を搭載した製品例
https://mathpix.com/
Mathpix : pdfにある数式のスクショからLaTex形式とPNG形式に変換.
利用者は確信度の低いものだけ
変換後の数式を丁寧に見る
(作業効率の向上)
スクリーンショット
変換後
確信度
アジェンダ
• 不確実性の推定値を用いた実世界アプリケーション
• 不確実性の原因
• DNNにおける不確実性の分類
• 不確実性の推定方法
• 不確実性の評価指標と品質
• DNNのキャリブレーション
• 現在の課題と研究の方向性
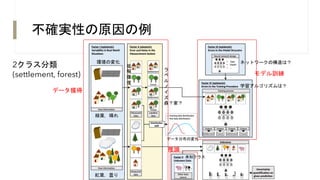
深層学習における予測の不確実性の原因
大きく3つのタイミングで不確実性が生まれる.
• データ獲得
- 実世界の状況の変化
- 測定システム固有の誤差
• モデル学習
- DNNのアーキテクチャ
- DNNの学習手順
• 推論
- 未知データ
不確実性の原因の例
データ獲得
モデル訓練
推論
環境の変化
緑葉,晴れ
紅葉,曇り
ラ
ベ
ル
ノ
イ
ズ
森?家?
データ分布の変化
低
解
像
度
未知クラス
ネットワークの構造は?
学習アルゴリズムは?
2クラス分類
(settlement, forest)
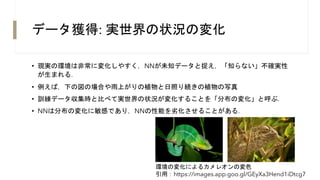
データ獲得: 実世界の状況の変化
• 現実の環境は非常に変化しやすく,NNが未知データと捉え,「知らない」不確実性
が生まれる.
• 例えば,下の図の場合や雨上がりの植物と日照り続きの植物の写真
• 訓練データ収集時と比べて実世界の状況が変化することを「分布の変化」と呼ぶ.
• NNは分布の変化に敏感であり,NNの性能を劣化させることがある.
写真 写真
環境の変化によるカメレオンの変色
引用:https://images.app.goo.gl/GEyXa3Hend1iDtcg7
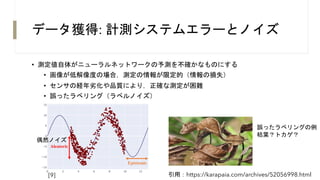
データ獲得: 計測システムエラーとノイズ
• 測定値自体がニューラルネットワークの予測を不確かなものにする
• 画像が低解像度の場合,測定の情報が限定的(情報の損失)
• センサの経年劣化や品質により,正確な測定が困難
• 誤ったラベリング(ラベルノイズ)
写真
[9]
誤ったラベリングの例
枯葉?トカゲ?
引用:https://karapaia.com/archives/52056998.html
偶然ノイズ
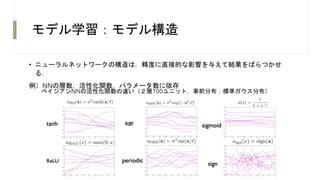
モデル学習:モデル構造
• ニューラルネットワークの構造は,精度に直接的な影響を与えて結果をばらつかせ
る.
例)NNの層数,活性化関数,パラメータ数に依存
ベイジアンNNの活性化関数の違い(2層100ユニット,事前分布:標準ガウス分布)
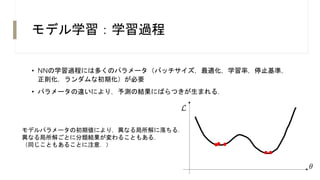
モデル学習:学習過程
• NNの学習過程には多くのパラメータ(バッチサイズ,最適化,学習率,停止基準,
正則化,ランダムな初期化)が必要
• パラメータの違いにより,予測の結果にばらつきが生まれる.
<latexit sha1_base64="qLEKdVMHqbHvy7HLF4psvLjBryk=">AAACcXichVHLSsNAFD2NrxpfVTeKm9KiCEKZuFBxVXDj0le10FRJ4qjBvEimhRr6A/6AgqsKIuJnuPEHXPgJ4rKCGxfepAHRot5hZs6cuefOmRnds8xAMPacknp6+/oH0oPy0PDI6FhmfGI3cGu+wUuGa7l+WdcCbpkOLwlTWLzs+VyzdYvv6adr0f5enfuB6To7ouHxqq0dO+aRaWiCqH21IoeqOOFCa8pq9SCTZwUWR7YbKAnII4kNN3MLFYdwYaAGGxwOBGELGgJqFShg8IirIiTOJ2TG+xxNyKStURanDI3YUxqPaVVJWIfWUc0gVht0ikXdJ2UWs+yJ3bE2e2T37IV9/ForjGtEXho06x0t9w7Gzqe23/9V2TQLnHyp/vQscISV2KtJ3r2YiW5hdPT1s4v29urWbDjHrtkr+W+xZ/ZAN3Dqb8bNJt+6gkwfoPx87m6wu1hQlgrK5mK+uJJ8RRozyGGe3nsZRaxjAyU618clWrhOtaVpKSvlOqlSKtFM4ltIC5/nsI7q</latexit>
✓
<latexit sha1_base64="FyiDinKr5A4n8xp91Pej709XSC4=">AAACd3ichVG7SgNBFD1ZX3F9JGojWBgMilWYtdBgFbCxsMjDqJCEsLuOurgvdifBGPID/oCFIChIFD/Dxh+wyCeIpYIIFt5sFkRFvcPMnDlzz50zM5prGr5grBOR+voHBoeiw/LI6Nh4LD4xueU7NU/nRd0xHW9HU31uGjYvCkOYfMf1uGppJt/WDte6+9t17vmGY2+KhssrlrpvG3uGrgqiqvHJckluli1VHOiqmdhoyeVKNZ5kKRZE4idQQpBEGFkn3kYZu3CgowYLHDYEYRMqfGolKGBwiaugSZxHyAj2OVqQSVujLE4ZKrGHNO7TqhSyNq27Nf1ArdMpJnWPlAnMswd2w57ZPbtlj+z911rNoEbXS4NmraflbjV2Ml14/Vdl0Sxw8Kn607PAHtKBV4O8uwHTvYXe09ePT58Lq/n55gK7ZE/k/4J12B3dwK6/6Fc5nj+DTB+gfH/un2BrKaUsp5TcUjKTDr8iihnMYZHeewUZrCOLIp17hHO0cR15k2alBWmxlypFQs0UvoSkfAB6RpBz</latexit>
L
モデルパラメータの初期値により,異なる局所解に落ちる.
異なる局所解ごとに分類結果が変わることもある.
(同じこともあることに注意.)
推論: 未知データ
機械学習の技術を搭載したシステムでは,訓練データ分布と異なるデータ分布からサン
プルされたデータを入力されることがある.
この時にNNは誤った結果を返す.
例えば,犬や猫の画像で学習したNNに,鳥の画像が送られる.
訓練データの分布と異なるデータ分布のサンプルを見極めることをOut-of-Distribution
検知という.
アジェンダ
• 不確実性の推定値を用いた実世界アプリケーション
• 不確実性の原因
• DNNにおける不確実性の分類
• 不確実性の推定方法
• 不確実性の評価指標と品質
• DNNのキャリブレーション
• 現在の課題と研究の方向性
不確実性の分類
• Predictive Uncertainty
• Data Uncertainty(aleatoric uncertainty )
• In-domain Uncertainty
• Model Uncertainty(epistemic uncertainty )
• In-domain Uncertainty
• Domain-shift Uncertainty
• Out-of-domain Uncertainty
• Distributional Uncertainty
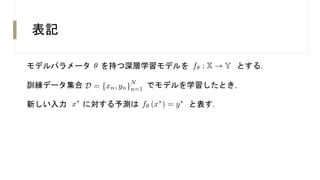
モデルパラメータ を持つ深層学習モデルを とする.
訓練データ集合 でモデルを学習したとき,
新しい入力 に対する予測は と表す.
表記
<latexit sha1_base64="dYSkRz+vwrfK/l3C2LvQ0O6pqek=">AAACmHichVHLThsxFD1MSwtTWkK7qegmagTqKvKARBGrSCza7iAQCMpEkWfqJBbzkscJglF+oD9QVaxAqirER7Dohn4ACz4BsQSJDQtuJiMQoLbXsn18fM/1se1Enow1Y6dDxpOnw8+ej4yaL8ZevhrPTbxei8OOckXFDb1QVR0eC08GoqKl9kQ1UoL7jifWnc3F/v56V6hYhsGq3o5E3eetQDalyzVRjdysXTObjcTWbaF5byFv+1y3HSep9vK2kq225kqFW7f0Rs+0641cgRVZGvnHwMpAAVkshblfsPEVIVx04EMggCbsgSOmVoMFhoi4OhLiFCGZ7gv0YJK2Q1mCMjixmzS2aFXL2IDW/ZpxqnbpFI+6ImUeU+yEHbALdswO2Rm7/mutJK3R97JNszPQiqgx/u3tytV/VT7NGu071T89azQxn3qV5D1Kmf4t3IG+u/P9YmWhPJVMs312Tv732Cn7TTcIupfuz2VR3oVJH2A9fO7HYG2maM0VreWZQmk++4oRvMN7fKD3/ogSPmMJFTr3B45wjD/GpFEyPhlfBqnGUKZ5g3thlG8A606dxw==</latexit>
f✓ : X ! Y
<latexit sha1_base64="OXLrbCdGoHEiIQTPm7jExD8SvaY=">AAACnXichVFNaxNBGH669nPVJq0XwUODoeJBwmwPbSgUCir0IKVfaQrZGHa3k2To7Ae7k2Bc9g/4BzwUCi2UIv4MPXjRm4f+hOKxghcPvrtZKLZU32XnfeaZ93nnmRk7kCJSjJ2PaHdGx8YnJqf0u/fuTxeKM7O7kd8LHV5zfOmHe7YVcSk8XlNCSb4XhNxybcnr9sHzdL3e52EkfG9HDQLedK2OJ9rCsRRRrWLVbOima6muY8n4RbJiSt5WZvymFXvJs9IgTWYoOl1lJoRXjOR1vJ6UdLPZKpZZhWVRugmMHJSRx4ZfPIOJffhw0IMLDg+KsISFiL4GDDAExDURExcSEtk6RwKdtD2q4lRhEXtAY4dmjZz1aJ72jDK1Q7tI+kNSljDPvrMP7JJ9YR/ZBft9a68465F6GVC2h1oetArvHm7/+q/KpazQvVL907NCG9XMqyDvQcakp3CG+v7b95fby1vz8RN2wn6Q/2N2zj7RCbz+T+d0k28dQqcHMK5f902wu1AxFivG5kJ5tZo/xSQe4TGe0n0vYRVr2ECN9j3CZ3zFN21Oe6m90taHpdpIrnmAv0Kr/wEPQJ/0</latexit>
D = {xn, yn}
N
n=1
<latexit sha1_base64="zYsiSB9UdgCdOSrtBKgszFOd77o=">AAACb3ichVHLSsNAFD2N7/iqulAQpFgquikTFyquBDcubbUPaEpJ4rQNpklIpgUt/oAfoAsXPkBE/Aw3/oALP0FcSQU3LrxNA6JFvcPMnDlzz50zM7prmb5g7Cki9fT29Q8MDsnDI6Nj49GJyazv1D2DZwzHcry8rvncMm2eEaaweN71uFbTLZ7T9zfb+7kG93zTsXfFgcuLNa1im2XT0ARRqlqQVVHlQpPVYikaZ0kWRKwbKCGII4xtJ3oDFXtwYKCOGjhsCMIWNPjUClDA4BJXRJM4j5AZ7HMcQSZtnbI4ZWjE7tNYoVUhZG1at2v6gdqgUyzqHiljSLBHdsta7IHdsWf28WutZlCj7eWAZr2j5W5p/Hhm5/1fVY1mgeqX6k/PAmWsBV5N8u4GTPsWRkffODxt7aynE80FdsVeyP8le2L3dAO78WZcp3j6DDJ9gPLzubtBdjmprCSV1HJ8Yy38ikHMYh6L9N6r2MAWtpGhc12c4BwXkVdpWpqTYp1UKRJqpvAtpKVPomuN3g==</latexit>
✓
<latexit sha1_base64="4PqDnW42zuJDrNtB1G8ivTf/Np4=">AAACbnichVHLSsNAFD2NrxpfVUEEEYtFERdl4kLFVcGNy/qoLaS1JHHUYF4kaVFDf8C9uBAUBRHxM9z4Ay78BHEjKLhx4U0aEBX1hsmcOXPPnTN3VMfQPZ+xh4TQ0trW3pHsFLu6e3r7Uv0D655dczVe0GzDdkuq4nFDt3jB132DlxyXK6Zq8KK6uxjuF+vc9XTbWvP3HV4xlW1L39I1xSdKLsvi3kYw3RDLlWoqw7IsivRPIMUggzjyduoKZWzChoYaTHBY8AkbUODRJ0MCg0NcBQFxLiE92udoQCRtjbI4ZSjE7tJ/m1ZyzFq0Dmt6kVqjUwwaLinTmGD37Jq9sDt2wx7Z+6+1gqhG6GWfZrWp5U6173B49e1flUmzj51P1Z+efWxhPvKqk3cnYsJbaE19/eD4ZXVhZSKYZBfsifyfswd2Szew6q/a5TJfOYFIDyB9b/dPsD6TlWaz0vJMJjcfP0USIxjHFPV7DjksIY9C1LEjnOIs8SwMCaPCWDNVSMSaQXwJYeoDhMGNWg==</latexit>
x⇤ <latexit sha1_base64="58SLPEGhowhpElekabwy9F7QGuM=">AAACjXicSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQtoxERzpcVXx5RkpJYk1sbkpKaVaFTEVWvVxhRlpmeUaNpWgjhcMbHxAsoGegZgoIDJMIQylBmgICBfYDlDDEMKQz5DMkMpQy5DKkMeQwmQncOQyFAMhNEMhgwGDAVAsViGaqBYEZCVCZZPZahl4ALqLQWqSgWqSASKZgPJdCAvGiqaB+SDzCwG604G2pIDxEVAnQoMqgZXDVYafDY4YbDa4KXBH5xmVYPNALmlEkgnQfSmFsTzd0kEfyeoKxdIlzBkIHThdXMJQxqDBditmUC3F4BFQL5Ihugvq5r+OdgqSLVazWCRwWug+xca3DQ4DPRBXtmX5KWBqUGzGbiAEWCIHtyYjDAjPUMzPcNAI2UHC2hUcDBIMygxaADD25zBgcGDIYAhFGhvH8MWhr0M+5j4mUyZbJjsIEqZGKF6hBlQAJM7AKtnmOU=</latexit>
f✓ (x⇤
) = y⇤
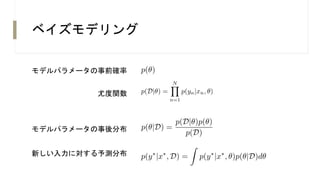
ベイズモデリング
モデルパラメータの事前確率
尤度関数
モデルパラメータの事後分布
新しい入力に対する予測分布
<latexit sha1_base64="MXGh1vAI7e8gPnbG6RmuL0YJAFI=">AAACdHichVHLTsJAFD3UF9YHqBsTXRAJBjdkykKJKxM3LlUETICQtg7QUNqmHUiQ+AP+gAtXGo0xfoYbf8AFn2BcYnTjwktpYtSot5nOmTP33DkzV3NMwxOM9ULSyOjY+ER4Up6anpmNROfm857dcnWe023Tdg811eOmYfGcMITJDx2Xq03N5AWtsT3YL7S56xm2dSA6Di831ZplVA1dFURVopFSUXaSJVHnQl2TS+VKNM5SzI/YT6AEII4gdu3oDUo4gg0dLTTBYUEQNqHCo68IBQwOcWV0iXMJGf4+xwlk0rYoi1OGSmyD/jVaFQPWovWgpuerdTrFpOGSMoYEe2S3rM8e2B17Yu+/1ur6NQZeOjRrQy13KpHTxezbv6omzQL1T9WfngWqyPheDfLu+MzgFvpQ3z4+62c39xPdVXbJnsn/Beuxe7qB1X7Rr/f4/jlkaoDy/bl/gnw6paynlL10fCsTtCKMJawgSe+9gS3sYBc5vyfnuMJ16FValuJSYpgqhQLNAr6ElPoAJ0mO7g==</latexit>
p(✓)
<latexit sha1_base64="ZBIBOCLN+rrV5pJv+9NmswDocnk=">AAACuXichVG7ThtBFD1sAoENDydpkGgsLJDdWLMuEpQoElIoKHkZkLyWNTuM8cK+tDu2RBb/QH4gBRVICCH+IG0afoCCLi1QgpSGguv1Il4C7mhm7pw5586ZGStw7EgxdtqjvXnb2/euf0B/Pzg0PJL58HE58puhkGXhO364avFIOrYny8pWjlwNQsldy5Er1uaPzv5KS4aR7XtLaiuQVZeve3bdFlwRVMssmRU9yJuqIRXfjk2Xq4bgTnamXfhu1kMu4iB/H93uMgu3kkL7EaHQ1s1qLZNjRZZE9mlipEkOacz5mQOYWIMPgSZcSHhQlDvgiKhVYIAhIKyKmLCQMjvZl2hDJ22TWJIYnNBNGtdpVUlRj9admlGiFnSKQz0kZRYT7IQdskt2zI7YGbt+tlac1Oh42aLZ6mplUBv5Nbr4/1WVS7NC4071omeFOqYSrzZ5DxKkcwvR1bd+/r5c/LowEU+yPXZB/nfZKftLN/BaV2J/Xi7sQKcPMB4/99NkuVQ0PheN+VJueir9in6MYRx5eu8vmMYs5lCmc//gH85wrn3TuNbQNrpUrSfVfMKD0KIbDx+qmw==</latexit>
p(✓|D) =
p(D|✓)p(✓)
p(D)
<latexit sha1_base64="l6daZv52TSeqydTQ4+dNg2Fm0y8=">AAACpXichVFNaxNBGH6yVduuH431UvCyGKoRJMz2oEUIBOzBi9KvpIVsXGa302bp7uywOwnGTf5A/4AHTwoq4s/w4sFrCv0JxWMFLx58s1kQLeo7zMwzz7zPO8/MeCoMUs3YScmYuXDx0uzcvHn5ytVrC+Xri6007iW+aPpxGCe7Hk9FGEjR1IEOxa5KBI+8UOx4h48m+zt9kaRBLLf1QIlOxA9ksB/4XBPllhtO21TVzIm47vo8tNZGQ0d3heZ3rbrlqCTeczNZt0fPsqcjS1UHrhw+d+W9Isd0Om65wmosD+s8sAtQQRHrcfk9HOwhho8eIghIaMIhOFJqbdhgUMR1kBGXEAryfYERTNL2KEtQBif2kMYDWrULVtJ6UjPN1T6dElJPSGlhmY3ZB3bGPrOP7JT9+GutLK8x8TKg2ZtqhXIXjpa2vv9XFdGs0f2l+qdnjX2s5l4D8q5yZnILf6rvv3h5tvVwczm7zd6wr+T/NTthn+gGsv/Nf7shNl/BpA+w/3zu86C1UrPv1+yNlUpjtfiKOdzELVTpvR+ggcdYR5POfYcvGOPYuGM8MbaN1jTVKBWaG/gtDPcn2lGh0g==</latexit>
p(D|✓) =
N
Y
n=1
p(yn|xn, ✓)
<latexit sha1_base64="NrDO7n/dfDcvPvmKjk8QfAQbKaY=">AAACuXichVG7ThtBFD1sHpAliU1oIqVZYYEMiqxZCkCJkJCgoAQbA5LXWLPLYA/sS7tjK47hB/gBCiqQIoTyB2nT5AdS0NFCSiKlScH17kqIoCR3tTNnzr3nzpkZO3RlrBi7GNAePX7ydHDomT78/MXLXH7k1XoctCNHVJ3ADaJNm8fClb6oKqlcsRlGgnu2KzbsvcV+fqMjolgG/prqhqLu8aYvd6TDFVGN/JpV08Nid2tq/8PW1Nue5XHVcrhrLB1MGvOGYUlfGXd5S7WE4pNhMQX79+q3U1K36o18gZVYEsZDYGaggCxWgvwZLGwjgIM2PAj4UIRdcMT01WCCISSujh5xESGZ5AUOoJO2TVWCKjixezQ2aVXLWJ/W/Z5xonZoF5f+iJQGxtl3ds5u2Df2mV2x33/t1Ut69L10abZTrQgbucPXlV//VXk0K7TuVP/0rLCDucSrJO9hwvRP4aT6zsejm8q78nhvgp2yH+T/hF2wr3QCv/PT+bQqysfQ6QHMP6/7IVifLpkzJXN1urAwlz3FEN5gDEW671ksYBkrqNK+X3CJK1xr7zWutbTdtFQbyDSjuBdafAvkDKjB</latexit>
p(y⇤
|x⇤
, D) =
Z
p(y⇤
|x⇤
, ✓)p(✓|D)d✓
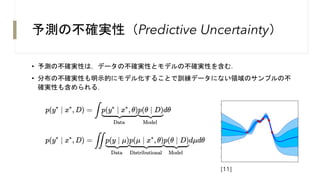
予測の不確実性(Predictive Uncertainty)
• 予測の不確実性は,データの不確実性とモデルの不確実性を含む.
• 分布の不確実性も明示的にモデル化することで訓練データにない領域のサンプルの不
確実性も含められる.
[11]
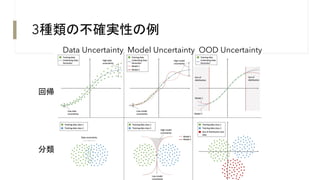
3種類の不確実性の例
回帰
分類
Data Uncertainty Model Uncertainty OOD Uncertainty
データの不確実性( Data Uncertainty )
• データに直接起因する不確実性(Aleatoric Uncertaintyともいう)
• 分類問題:分類境界付近のデータ
• 回帰問題:出力値にノイズが多いデータ
• 観測データを増やしてもデータの不確実性は減少しない
なぜ必要? 収集したデータ集合の限界が知れるから
意思決定の例:センサーを変える,データクリーニング
[12]
モデルの不確実性( Model Uncertainty )
データ不足やモデルの欠点によって生じる不確実性
• 学習手順,NNの構造,未知のサンプルや学習データの網羅性の低さによる知識不足
• 上記を改善することで(理論的には)モデルの不確実性が減少する
• モデルの不確実性は,In-domain Uncertainty,Domain-shift Uncertainty,Out-of-domain
Uncertainty を含む
なぜ必要? どのような訓練データを追加で取得する必要があるか分かる
過去のデータにない(モデルがまだ知らない),データを特定できるから
意思決定:データ収集,推論モデルの変更
[12]
モデルの不確実性(Model Uncertainty)
モデルの不確実性に含まれる3種類を紹介.
• In-domain Uncertainty
• Domain-shift Uncertainty
• Out-of-domain Uncertainty
ドメイン内不確実性(In-domain Uncertainty)[13]
• 訓練データ分布からサンプルされた入力の不確実性.
• 原因:ドメイン内の知識がないために,DNNがドメイン内のサンプルを説明できない
ことによる.
• 原因:データが少ないことやノイズの多さによって引き起こされる.
• 対策:ドメイン内不確実性の原因に応じて,訓練データや学習手続きの質を高めるこ
とで,不確実性を低減できる可能性がある [14].
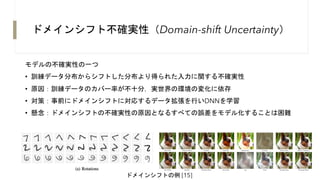
ドメインシフト不確実性(Domain-shift Uncertainty)
オクルージョンの対策図
ドメインシフトの例 [15]
モデルの不確実性の一つ
• 訓練データ分布からシフトした分布より得られた入力に関する不確実性
• 原因:訓練データのカバー率が不十分,実世界の環境の変化に依存
• 対策:事前にドメインシフトに対応するデータ拡張を行いDNNを学習
• 懸念:ドメインシフトの不確実性の原因となるすべての誤差をモデル化することは困難
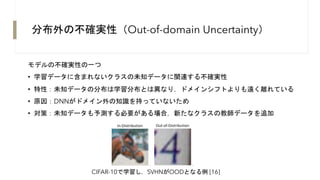
分布外の不確実性(Out-of-domain Uncertainty)
CIFAR-10で学習し,SVHNがOODとなる例 [16]
モデルの不確実性の一つ
• 学習データに含まれないクラスの未知データに関連する不確実性
• 特性:未知データの分布は学習分布とは異なり,ドメインシフトよりも遠く離れている
• 原因:DNNがドメイン外の知識を持っていないため
• 対策:未知データも予測する必要がある場合,新たなクラスの教師データを追加
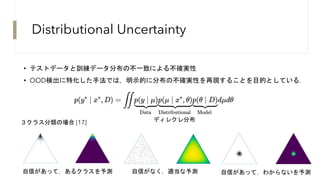
Distributional Uncertainty
• テストデータと訓練データ分布の不一致による不確実性
• OOD検出に特化した手法では,明示的に分布の不確実性を再現することを目的としている.
自信があって,あるクラスを予測
3クラス分類の場合 [17] ディレクレ分布
自信がなく,適当な予測 自信があって,わからないを予測
アジェンダ
• 不確実性の推定値を用いた実世界アプリケーション
• 不確実性の原因
• DNNにおける不確実性の分類
• 不確実性の推定方法
• 不確実性の評価指標と品質
• DNNのキャリブレーション
• 現在の課題と研究の方向性
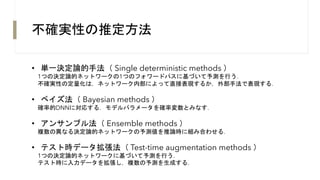
不確実性の推定方法
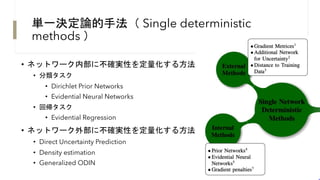
• 単一決定論的手法( Single deterministic methods )
1つの決定論的ネットワークの1つのフォワードパスに基づいて予測を行う.
不確実性の定量化は,ネットワーク内部によって直接表現するか,外部手法で表現する.
• ベイズ法( Bayesian methods )
確率的DNNに対応する.モデルパラメータを確率変数とみなす.
• アンサンブル法( Ensemble methods )
複数の異なる決定論的ネットワークの予測値を推論時に組み合わせる.
• テスト時データ拡張法( Test-time augmentation methods )
1つの決定論的ネットワークに基づいて予測を行う.
テスト時に入力データを拡張し,複数の予測を生成する.
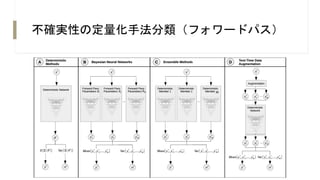
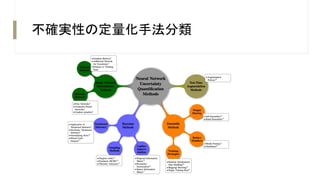
不確実性の定量化手法分類
不確実性の定量化手法分類(フォワードパス)
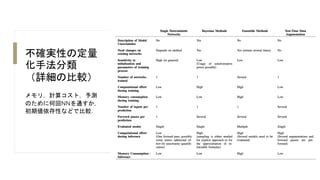
不確実性の定量
化手法分類
(詳細の比較)
メモリ,計算コスト,予測
のために何回NNを通すか,
初期値依存性などで比較.
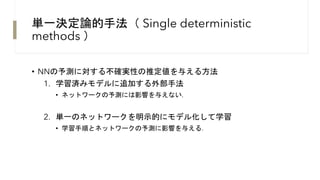
単一決定論的手法( Single deterministic
methods )
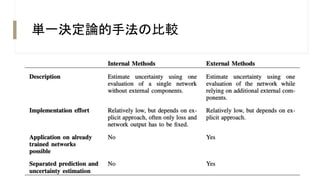
• NNの予測に対する不確実性の推定値を与える方法
1. 学習済みモデルに追加する外部手法
• ネットワークの予測には影響を与えない.
2. 単一のネットワークを明示的にモデル化して学習
• 学習手順とネットワークの予測に影響を与える.
単一決定論的手法の比較
単一決定論的手法( Single deterministic
methods )
• ネットワーク内部に不確実性を定量化する方法
• 分類タスク
• Dirichlet Prior Networks
• Evidential Neural Networks
• 回帰タスク
• Evidential Regression
• ネットワーク外部に不確実性を定量化する方法
• Direct Uncertainty Prediction
• Density estimation
• Generalized ODIN
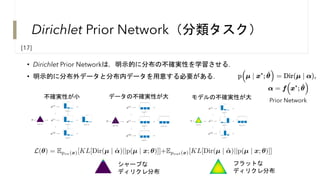
Dirichlet Prior Network(分類タスク)
• Dirichlet Prior Networkは,明示的に分布の不確実性を学習させる.
• 明示的に分布外データと分布内データを用意する必要がある.
<latexit sha1_base64="G9qe6JcBGJb/3NXzorZhIHwKvqo=">AAAEBnictVHNa9RAFH+bqK3rR7d6EbwEl0oXcZn00BZFKKgg2EM/3LaQhDDJTpuhkw+SyeI6zV38Bzx4UUFEBG/iVfDiP+Chf4J4rODFg2+zgbqt1UPxhcz7zXvv995vZrxE8EwSslvT9BMnT42Nn66fOXvu/ERj8sJaFuepzzp+LOJ0w6MZEzxiHcmlYBtJymjoCbbubd8e5Nd7LM14HD2Q/YQ5Id2K+Cb3qcSQO1l7blt1O6Qy8KlQi8W07cWim/VDdMqWAZO0aN0qCzxP3S1cVeI0VAliHo0SHhatwrpvLFp2nLCUyjiNaMjUHZ4eaBzmhWGHvGvYAZVqJEVFEtCiaO3sGPujjmKPzDZuGn9S7zjXftefuCrO5bF1Sy667L8rr9uO22iSNinNOAzMCjShsqW48Rps6EIMPuQQAoMIJGIBFDL8LDCBQIIxBxTGUkS8zDMooI7cHKsYVlCMbuO6hTurika4H/TMSraPUwT+KTINmCJfyBuyRz6Tt+Qr+XlkL1X2GGjpo/eGXJa4E08urf74JytELyHYZ/1Vs4RNmC+1ctSelJHBKfwhv/fo6d7qjZUpdZW8JN9Q/wuySz7hCaLed//VMlt5BnV8APPgdR8GazNtc7ZtLs80F+arpxiHy3AFpvG+52AB7sESdMDXxrTr2qw2pz/W3+nv9Q/DUq1WcS7CiOkffwGsrC9a</latexit>
L(✓) = Epin(x)[KL[Dir(µ | ˆ
↵)||p(µ | x; ✓)]]+Epout(x)[KL[Dir(µ | ˜
↵)||p(µ | x; ✓)]]
シャープな
ディリクレ分布
フラットな
ディリクレ分布
データの不確実性が大 モデルの不確実性が大
不確実性が小
Prior Network
[17]
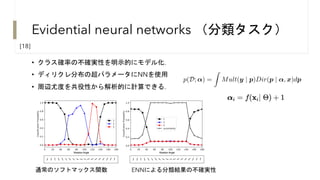
Evidential neural networks (分類タスク)
• クラス確率の不確実性を明示的にモデル化.
• ディリクレ分布の超パラメータにNNを使用
• 周辺尤度を共役性から解析的に計算できる.
通常のソフトマックス関数 ENNによる分類結果の不確実性
<latexit sha1_base64="vpWZoPjuqec62lff88FOugEfbDU=">AAADDXichVHPa9RAFH6Jv2rUdqsXoZfBpbIFWSal2KJUCu2hF6E/3LawWZbJ7LQ7dJIMyeziGvIPePHowVMLYsWzN/HiQf8BD/0TxGMFLz30bTZgt4v6QvK++d77vryZ8bWSiaH02LIvXb5y9drYdefGzVvjE6XJ21tJ1Im5qPFIRfGOzxKhZChqRholdnQsWOArse3vL/fr210RJzIKn5meFo2A7YVyV3JmkGqWjry6oysk9QJm2pwpspKRx8TzI9VKegGm1GNKt1k2s+jJ0JCnHWUq58u9jHiBbA1JdDZDVmRcGeZG+wrrB+c4kj5H8UU7x2s0S2VapXmQUeAWoAxFrEWld+BBCyLg0IEABIRgECtgkOBTBxcoaOQakCIXI5J5XUAGDmo72CWwgyG7j989XNULNsR13zPJ1Rz/ovCNUUlgmn6n7+kJ/UY/0B/09K9eae7Rn6WH2R9ohW5OvLy7+fu/qgCzgfYf1T9nNrALC/msEmfXOdPfBR/ouy9en2w+2phO79ND+hPnP6DH9AvuIOz+4m/XxcYbcPAC3IvHPQq2Zqvuw6q7PlteWiiuYgym4B5U8LznYQlWYQ1qwK1xa85atJ7Yr+yP9if786DVtgrNHRgK++sZv5bKnQ==</latexit>
p(D; ↵) =
Z
Mult(y | p)Dir(p | ↵, x)dp
[18]
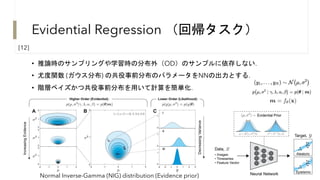
Evidential Regression (回帰タスク)
• 推論時のサンプリングや学習時の分布外(OD)のサンプルに依存しない.
• 尤度関数 (ガウス分布) の共役事前分布のパラメータをNNの出力とする.
• 階層ベイズかつ共役事前分布を用いて計算を簡単化.
Normal Inverse-Gamma (NIG) distribution (Evidence prior)
<latexit sha1_base64="j+I+TB7pIvOFYv7ar8xctgKcJvM=">AAACj3ichVE9SyNRFD2Ou+rO+hG1EWwGg6IW4Y2FCQtKwMbtTDQqZEKYGV+SIfPFzEvYOOQPWNlZWLmwLIu9rQvb7B+w8CeIpcI2Ft5MBhYV9Q7z7nnn3XPfee8Zvm2FgrHrAWnww8eh4ZFP8ufRsfGJ1OTUbui1ApOXTM/2gn1DD7ltubwkLGHzfT/gumPYfM9obvTW99o8CC3P3REdn1ccve5aNcvUBVHV1LJWljXDsw/CjkMpcrrKmlKrRppocKF3FyPNqCnfukuyVqmm0izD4lBeAjUBaSSx5aV+QsMBPJhowQGHC0HYho6QvjJUMPjEVRARFxCy4nWOLmTStqiKU4VObJPGOs3KCevSvNczjNUm7WLTH5BSwTy7Yr/YHfvLztkNe3i1VxT36HnpUDb6Wu5XJ45mtv+9q3IoCzT+q970LFBDLvZqkXc/ZnqnMPv69uHJ3faX4ny0wL6zW/J/xq7ZHzqB2743fxR48RQyPYD6/Lpfgt2VjLqaUQsr6XwueYoRzGIOi3TfWeSxiS2UaN9jXOASv6VJKSutS/l+qTSQaKbxJKSvjwV0mXM=</latexit>
m = f✓(x)
[12]
ネットワーク外部に不確実性を定量化する方法
不確実性の評価がモデルの予測に影響を与えない.
• 基本的な予測タスクから分離.
• 学習済みモデルを用いる.
• 以下3手法を紹介
• Direct Uncertainty Prediction
• Neighborhood Uncertainty Classifier
• Generalized ODIN
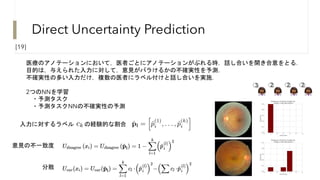
Direct Uncertainty Prediction
医療のアノテーションにおいて,医者ごとにアノテーションがぶれる時,話し合いを開き合意をとる.
目的は,与えられた入力に対して,意見がバラけるかの不確実性を予測.
不確実性の多い入力だけ,複数の医者にラベル付けと話し合いを実施.
2つのNNを学習
・予測タスク
・予測タスクNNの不確実性の予測
<latexit sha1_base64="77zYb11YlXry5LRFghalLTJLze8=">AAACwnichVHNTttAEP4wpQWXlhQuSFyiRiCQqmjNoUVISEhw4MhPA0ixG9lmk2yz/qm9iQTGL8ALcOAEEkJVH4NLX6AHHgH1RpB64cDEsagoajuWd2a+mW/2210nlCJWjF0NaIPPhp6/GB7RX46+ej1WeDO+HQftyOUVN5BBtOvYMZfC5xUllOS7YcRtz5F8x2mt9Oo7HR7FIvA/qv2QW57d8EVduLYiqFawzKpuNm2VmJ6tmk49CdO09pCINF0yJa+ratYTUkmkn5JZYy59VzTlXqBi8o9KrbnUjESjqSzdtGqFEiuzzIpPAyMPSshtPShcwMQeArhowwOHD0WxhI2YvioMMISEWUgIiygSWZ0jhU7cNnVx6rAJbdHaoKyaoz7lvZlxxnZpF0l/RMwiptkP9pV12Xf2jV2zu7/OSrIZPS375J0+l4e1saPJrV//ZXnkFZq/Wf/UrFDHQqZVkPYwQ3qncPv8zsFxd2txczqZYWfsJ+k/ZVfskk7gd27d8w2+eQKdHsD487qfBtvzZeN92diYLy0v5E8xjCm8xSzd9wcsYw3rqNC+l7jGDbraqvZZ+6LF/VZtIOdM4JFph/cqNbAR</latexit>
p̂i =
h
p̂
(1)
i , . . . , p̂
(k)
i
i
入力に対するラベル の経験的な割合
<latexit sha1_base64="vhBCn3txG636BlnqhrqRXwmyz6E=">AAACbHichVG7SgNBFD1Z3+sj8VEIQQiGBKswa6FiJdhYmmgekoSwu050yb7Y3QQ0+AO2FhZqoSAifoaNP2DhJ4hgE8HGwrubBdGg3mFmzpy5586ZGcXWNddj7Cki9PUPDA4Nj4ijY+MT0djkVMG1mo7K86qlW05JkV2uaybPe5qn85LtcNlQdF5UGuv+frHFHVezzG3vwOZVQ94ztbqmyh5RO5WyqNYaYqVaiyVZhgWR6AVSCJIIY9OK3aCCXVhQ0YQBDhMeYR0yXGplSGCwiauiTZxDSAv2OY4gkrZJWZwyZGIbNO7RqhyyJq39mm6gVukUnbpDygRS7JHdsg57YHfsmX38Wqsd1PC9HNCsdLXcrkWPZ7fe/1UZNHvY/1L96dlDHSuBV4282wHj30Lt6luHp52t1VyqnWZX7IX8X7Indk83MFtv6nWW584g0gdIP5+7FxQWM9JSRsouJtdWwq8YRhzzWKD3XsYaNrCJPJ1r4ATnuIi8CjNCXJjrpgqRUDONbyGkPwGc6Yx7</latexit>
ck
意見の不一致度
分散
[19]
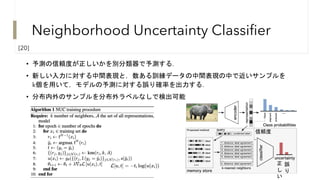
Neighborhood Uncertainty Classifier
信頼度
正
し
い
誤
り
[20]
• 予測の信頼度が正しいかを別分類器で予測する.
• 新しい入力に対する中間表現と,数ある訓練データの中間表現の中で近いサンプルを
k個を用いて,モデルの予測に対する誤り確率を出力する.
• 分布内外のサンプルを分布外ラベルなしで検出可能
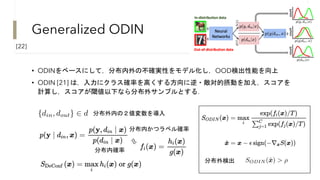
Generalized ODIN
• ODINをベースにして,分布内外の不確実性をモデル化し,OOD検出性能を向上
• ODIN [21] は,入力にクラス確率を高くする方向に逆・敵対的摂動を加え,スコアを
計算し,スコアが閾値以下なら分布外サンプルとする.
<latexit sha1_base64="GFQa5utuY6KhJWy9Cg5xJOiZ9T0=">AAACjnicSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQtoxkRzBcdX+7t4+tVqxGQkllTHJOXnpBRX5gKp6oraWk27mKKMfK6Y2HgBZQM9AzBQwGQYQhnKDFAQkC+wnCGGIYUhnyGZoZQhlyGVIY+hBMjOYUhkKAbCaAZDBgOGAqBYLEM1UKwIyMoEy6cy1DJwAfWWAlWlAlUkAkWzgWQ6kBcNFc0D8kFmFoN1JwNtyQHiIqBOBQZVg6sGKw0+G5wwWG3w0uAPTrOqwWaA3FIJpJMgelML4vm7JIK/E9SVC6RLGDIQuvC6uYQhjcEC7NZMoNsLwCIgXyRD9JdVTf8cbBWkWq1msMjgNdD9Cw1uGhwG+iCv7Evy0sDUoNkMXMAIMEQPbkxGmJGeoZmeYaCRsoMFNCo4GKQZlBg0gOFtzuDA4MEQwBAKtLefYSvDPob9TAJMZky2TPYQpUyMUD3CDCiAyQMArl+ZXA==</latexit>
SODIN (x̂) > ⇢
分布外検出
<latexit sha1_base64="EIot1Nd4FqE+4q0786V4Hh32Q38=">AAACgnichVHLSsNAFD3Gd3xV3QgiFIsiImVSQUVcCG5c+qoKTSlJOtbBNAnJtFBDV+78AReuFETEnX6CG3/AhZ8gLhXcuPA2DYiKekPmnjlzz50zM6Zni0Ay9tiitLa1d3R2das9vX39A4nBoe3ArfgWz1qu7fq7phFwWzg8K4W0+a7nc6Ns2nzHPFhprO9UuR8I19mSNY/ny0bJEXvCMiRRhcSYnlP1sFgIhVOfoeRWZF2v68JJFlU9X0ikWJpFkfwJtBikEMeam7iEjiJcWKigDA4HkrANAwF9OWhg8IjLIyTOJySidY46VNJWqIpThUHsAY0lmuVi1qF5o2cQqS3axabfJ2USE+yBXbEXds+u2RN7/7VXGPVoeKlRNpta7hUGjkc23/5VlSlL7H+q/vQssYeFyKsg717ENE5hNfXVw5OXzcWNiXCSnbNn8n/GHtkdncCpvloX63zjFCo9gPb9un+C7Uxam0tr65nU8kL8FF0YxTim6L7nsYxVrCFL+x7hCje4VdqUaUVTZpulSkusGcaXUJY+AJGZlIA=</latexit>
{din, dout} 2 d 分布外内の2値変数を導入
分布内確率
分布内かつラベル確率
<latexit
sha1_base64="K33SqBygRFj2NgZ5JkrKdY64Ckw=">AAACcHichVHLSsNAFD2NrxofrboRXPgoFXFRJl1ocVVw49JXVWiKJHGqQ9MkJmmxFn/AH3DhRgUR8TPc+AMu+gnizgpuXHiTBkRFvcPMnDlzz50zM7pjCs9nrBWTurp7evvi/fLA4NBwIjkyuuXZNdfgBcM2bXdH1zxuCosXfOGbfMdxuVbVTb6tV5aD/e06dz1hW5t+w+GlqrZvibIwNJ+oklqUVc1xXPtIVku7yRTLsDCmfgIlAilEsWonb6BiDzYM1FAFhwWfsAkNHrUiFDA4xJXQJM4lJMJ9jhPIpK1RFqcMjdgKjfu0KkasReugpheqDTrFpO6Scgpp9shuWZs9sDv2xN5/rdUMawReGjTrHS13dhOn4xtv/6qqNPs4+FT96dlHGbnQqyDvTsgEtzA6+vrxWXtjaT3dnGVX7Jn8X7IWu6cbWPVX43qNr59Dpg9Qvj/3T7CVzSgLGWUtm8rnoq+IYwIzmKP3XkQeK1hFgc49xBkucBl7kcalSWm6kyrFIs0YvoQ0/wHUm45s</latexit>
⇡
[22]
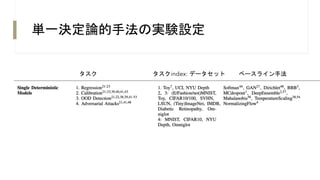
単一決定論的手法の実験設定
タスク タスクindex: データセット ベースライン手法
単一決定論的手法のまとめ
利点
• 学習と評価において計算効率が高い.
• 1つのNNを学習し,多くの場合,学習済みNNに適用可能.
• 他のアプローチで必要とされる予測数よりも効率的.
欠点
• 初期値・ハイパーパラメータ依存性が高い.
不確実性の推定方法
• 単一決定論的手法( Single deterministic methods )
決定論的ネットワーク内での1回のフォワードパスに基づいて予測を行う.
不確実性の定量化は,ネットワーク内部によって直接表現するか,外部手法で表現する.
• ベイズ法( Bayesian methods )
確率的DNNに対応する.モデルパラメータを確率変数とみなす.
• アンサンブル法( Ensemble methods )
複数の異なる決定論的ネットワークの予測値を推論時に組み合わせる.
• テスト時データ拡張法( Test-time augmentation methods )
1つの決定論的ネットワークに基づいて予測を行う.
テスト時に入力データを拡張し,複数の予測を生成する.
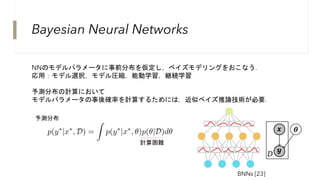
Bayesian Neural Networks
NNのモデルパラメータに事前分布を仮定し,ベイズモデリングをおこなう.
応用:モデル選択,モデル圧縮,能動学習,継続学習
予測分布の計算において
モデルパラメータの事後確率を計算するためには,近似ベイズ推論技術が必要.
<latexit sha1_base64="NrDO7n/dfDcvPvmKjk8QfAQbKaY=">AAACuXichVG7ThtBFD1sHpAliU1oIqVZYYEMiqxZCkCJkJCgoAQbA5LXWLPLYA/sS7tjK47hB/gBCiqQIoTyB2nT5AdS0NFCSiKlScH17kqIoCR3tTNnzr3nzpkZO3RlrBi7GNAePX7ydHDomT78/MXLXH7k1XoctCNHVJ3ADaJNm8fClb6oKqlcsRlGgnu2KzbsvcV+fqMjolgG/prqhqLu8aYvd6TDFVGN/JpV08Nid2tq/8PW1Nue5XHVcrhrLB1MGvOGYUlfGXd5S7WE4pNhMQX79+q3U1K36o18gZVYEsZDYGaggCxWgvwZLGwjgIM2PAj4UIRdcMT01WCCISSujh5xESGZ5AUOoJO2TVWCKjixezQ2aVXLWJ/W/Z5xonZoF5f+iJQGxtl3ds5u2Df2mV2x33/t1Ut69L10abZTrQgbucPXlV//VXk0K7TuVP/0rLCDucSrJO9hwvRP4aT6zsejm8q78nhvgp2yH+T/hF2wr3QCv/PT+bQqysfQ6QHMP6/7IVifLpkzJXN1urAwlz3FEN5gDEW671ksYBkrqNK+X3CJK1xr7zWutbTdtFQbyDSjuBdafAvkDKjB</latexit>
p(y⇤
|x⇤
, D) =
Z
p(y⇤
|x⇤
, ✓)p(✓|D)d✓
予測分布
計算困難
BNNs [23]
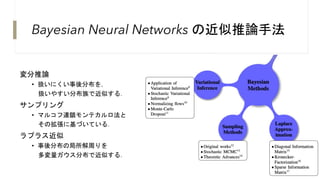
Bayesian Neural Networks の近似推論手法
変分推論
• 扱いにくい事後分布を,
扱いやすい分布族で近似する.
サンプリング
• マルコフ連鎖モンテカルロ法と
その拡張に基づいている.
ラプラス近似
• 事後分布の局所解周りを
多変量ガウス分布で近似する.
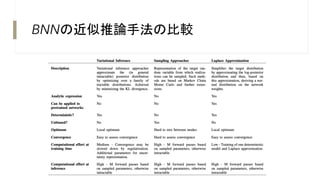
BNNの近似推論手法の比較
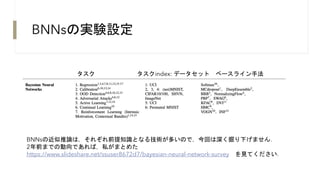
BNNsの実験設定
タスク タスクindex: データセット ベースライン手法
BNNsの近似推論は,それぞれ前提知識となる技術が多いので,今回は深く掘り下げません.
2年前までの動向であれば,私がまとめた
https://www.slideshare.net/ssuser8672d7/bayesian-neural-network-survey を見てください.
ベイズ手法のまとめ
ベイズ推論と深層学習の組み合わせ
主に事後分布がどのように計算されるかが焦点
研究動向
• 大規模で高次元なデータセットとNNの構造にも対応したベイズ推論に注目
• 近似ベイズ推論のミニバッチ方式,MC-dropoutやラプラス近似などの比較的単
純だがスケーラブルな手法の検討.
課題
• 意味のある事前分布の設計
• 予測の不確実性の計算を高速化
• 新しいベンチマーク,評価手続き,ソフトウェアツールの理解
• 現在の方法とその潜在的な応用の理解
不確実性の推定方法
• 単一決定論的手法( Single deterministic methods )
決定論的ネットワーク内での1回のフォワードパスに基づいて予測を行う.
不確実性の定量化は,ネットワーク内部によって直接表現するか,外部手法で表現する.
• ベイズ法( Bayesian methods )
モデルパラメータを確率変数とみなし,確率的DNNになる.
• アンサンブル法( Ensemble methods )
複数の異なる決定論的ネットワークの予測値を推論時に組み合わせる.
• テスト時データ拡張法( Test-time augmentation methods )
1つの決定論的ネットワークに基づいて予測を行う.
テスト時に入力データを拡張し,複数の予測を生成する.
アンサンブル法
• アンサンブルは精度向上に加え,予測のモデル不確実性を直感的に表現する方法
• 元々不確実性を扱う手法ではなかったが,NNの不確実性の推定に適していることがわ
かってきた
応用:バイオインフォマティクス,RL,リモートセンシング
複数のモデル(メンバー)の出力結果の平均
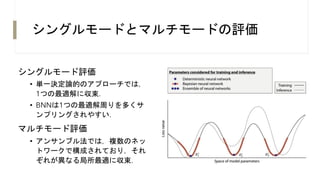
シングルモードとマルチモードの評価
シングルモード評価
• 単一決定論的のアプローチでは,
1つの最適解に収束.
• BNNは1つの最適解周りを多くサ
ンプリングされやすい.
マルチモード評価
• アンサンブル法では,複数のネッ
トワークで構成されており,それ
ぞれが異なる局所最適に収束.
アンサンブル手法
• 学習戦略
• Random Initialization/ Data Shuffling
• Bagging/Boosting
• メンバー数の削減
• Model Pruning
• Distillation
• 重み共有
• Sub-Ensembles
• Batch-Ensembles
アンサンブルの学習戦略
アンサンブルで重要なのは,NN間の振る舞いの多様性.
多様性を高めるアンサンプル方法を紹介
ランダムな初期化とデータシャッフル(Random Initialization/ Data Shuffling)
• ニューラルネットワークの初期化が異なると,一般的に異なる局所解に落ちる.
• 学習はミニバッチで行われるため,学習データの順序も最終結果に影響.
データ拡張
• 各メンバーに対して異なるデータ拡張戦略をとる.
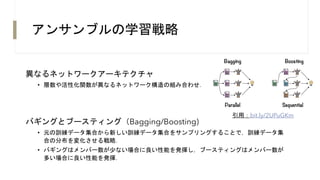
アンサンブルの学習戦略
異なるネットワークアーキテクチャ
• 層数や活性化関数が異なるネットワーク構造の組み合わせ.
バギングとブースティング(Bagging/Boosting)
• 元の訓練データ集合から新しい訓練データ集合をサンプリングすることで,訓練データ集
合の分布を変化させる戦略.
• バギングはメンバー数が少ない場合に良い性能を発揮し,ブースティングはメンバー数が
多い場合に良い性能を発揮.
引用:bit.ly/2UPuGKm
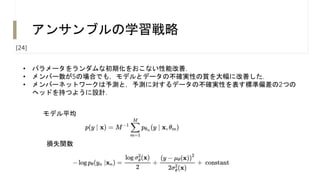
アンサンブルの学習戦略
• パラメータをランダムな初期化をおこない性能改善.
• メンバー数が5の場合でも,モデルとデータの不確実性の質を大幅に改善した.
• メンバーネットワークは予測と,予測に対するデータの不確実性を表す標準偏差の2つの
ヘッドを持つように設計.
モデル平均
損失関数
[24]
アンサンブル手法と不確実性の定量化
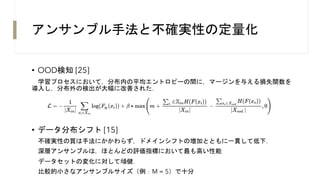
• OOD検知 [25]
学習プロセスにおいて,分布内の平均エントロピーの間に,マージンを与える損失関数を
導入し,分布外の検出が大幅に改善された.
• データ分布シフト [15]
不確実性の質は手法にかかわらず,ドメインシフトの増加とともに一貫して低下.
深層アンサンブルは,ほとんどの評価指標において最も高い性能
データセットの変化に対して頑健.
比較的小さなアンサンブルサイズ(例:M = 5)で十分
アンサンブル手法
• 学習戦略
• Random Initialization/ Data Shuffling
• Bagging/Boosting
• メンバー数の削減
• Model Pruning
• Distillation
• 重み共有
• Sub-Ensembles
• Batch-Ensembles
アンサンブル手法の効率化
• アンサンブル手法は,計算量が多くメモリ消費量が高い.
• アプリケーションにアンサンブルを導入する場合,利用可能なメモリと
計算能力には制限があることが多い.
• モデルの数を減らすことで,メモリや計算能力の消費を抑えられる.
• Pruning (枝刈り)
• Distillation(蒸留)
枝刈り手法
• メンバーを刈り込み,メンバー間の冗長性を減らす.
• 性能に大きな影響を与えることのないメンバーを除去.
• 異なる多様性尺度に基づくアプローチの開発.
枝刈り手法
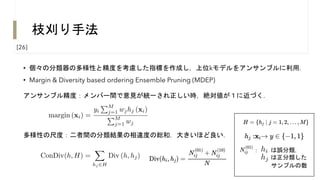
• 個々の分類器の多様性と精度を考慮した指標を作成し,上位kモデルをアンサンブルに利用.
• Margin & Diversity based ordering Ensemble Pruning (MDEP)
アンサンブル精度:メンバー間で意見が統一され正しい時,絶対値が1に近づく.
多様性の尺度:二者間の分類結果の相違度の総和.大きいほど良い.
<latexit sha1_base64="JBwThgzt4+dIgj+E+ogpOUVLmNM=">AAAC9HichVG7bhQxFL0z4RGGR5bQIKUZsSwKzcqTAqJIkSLR0CDlwSaR1svIM3h2ncxLHu8mG8s/QENJAQ2gCCEkfoKGH6DIJyDKgGgouDM7EoJAuJbt4+N7ro/tII9FoQg5suypM2fPnZ++4Fy8dPnKTOPq7GaRDWXIO2EWZ3I7YAWPRco7SqiYb+eSsySI+Vawe6/c3xpxWYgsfajGOe8lrJ+KSIRMIeU3ntKuQ7OcS6YymbKE64TJvkgNjXmk5mnC1CCI9L7xtTBUiv5A3V6mkWShHpeUS4th4uudZc880g+Mu4fYuINyPKWC0X+TGYf2/EaTtEkV7kng1aAJdaxmjTdA4TFkEMIQEuCQgkIcA4MCWxc8IJAj1wONnEQkqn0OBhzUDjGLYwZDdhfHPq66NZviuqxZVOoQT4mxS1S60CKfyFtyTD6Sd+Qz+fHPWrqqUXoZ4xxMtDz3Z55c3/j+X1WCs4LBL9WpnhVEsFh5Feg9r5jyFuFEPzp4dryxtN7St8gr8gX9vyRH5APeIB19DQ/X+PpzcPADvD+f+yTYXGh7d9re2kJzZbH+immYgxswj+99F1bgPqxCB8/9Zs1ZN62WPbJf2K/tw0mqbdWaa/Bb2O9/AsHYw7s=</latexit>
margin (xi) =
yi
PM
j=1 wjhj (xi)
PM
j=1 wj
<latexit sha1_base64="q6xXEtLf3da5c+rEsjxHGEnN2vc=">AAACwXichVHLahRBFD1pX7F9ZKIbwU3jEElAhuosNASEwLiYZR5OEpgamu62ZqZMd1VTXTMQm/kBf8CFKwUR8S904w+4yB8orjSCGxfe7mmQGNTbdN1bp865daoqyhKZW8aO5pwzZ8+dvzB/0b10+crVhcbitd1cj00surFOtNmPwlwkUomulTYR+5kRYRolYi86aJfrexNhcqnVQ3uYiX4aDpUcyDi0BAUNznsu15kwodVGhako2lo9kJPp8uiO11m5z/NxGhSjoHg89bhUXofSCXrJ5YkY2FJQ8biRw5FdcXk/aDRZi1XhnS78umiijk3deA2OR9CIMUYKAQVLdYIQOX09+GDICOujIMxQJat1gSlc0o6JJYgREnpA45BmvRpVNC975pU6pl0S+g0pPSyxj+wNO2Yf2Fv2mf38a6+i6lF6OaQczbQiCxae3tj58V9VStli9Fv1T88WA6xVXiV5zyqkPEU800+ePDveWd9eKm6zl+wL+X/Bjth7OoGafI9fbYnt53DpAfw/r/t0sbva8u+2/K3V5sZa/RTzuIlbWKb7vocNdLCJLu37Dp/wFd+ctiOdzDEzqjNXa67jRDjFL8rnris=</latexit>
ConDiv(h, H) =
X
hj 2H
Div (h, hj)
<latexit sha1_base64="lVgvZzoTuuDP+YvzLOKW92AzDLQ=">AAACbHichVG7SgNBFD1ZX3F9xUchBEEMilWYtVCxCthY5mGikoSwu47J4L7Y3QRi8AdsLSzUQkFE/Awbf8AinyCCjYKNhTebBVFR7zAzZ87cc+fMjOYYwvMZa0eknt6+/oHooDw0PDI6FhufKHh23dV5XrcN293WVI8bwuJ5X/gG33Zcrpqawbe0/fXO/laDu56wrU2/6fCyqVYtsSd01Sdqp1SUaxUhl8qVWIIlWRCzP4ESggTCSNuxa5SwCxs66jDBYcEnbECFR60IBQwOcWW0iHMJiWCf4xAyaeuUxSlDJXafxiqtiiFr0bpT0wvUOp1iUHdJOYt59sBu2Au7Z7fskb3/WqsV1Oh4adKsdbXcqYwdTefe/lWZNPuofar+9OxjD6uBV0HenYDp3ELv6hsHJy+5tex8a4Fdsifyf8Ha7I5uYDVe9asMz55Cpg9Qvj/3T1BYSirLSSWzlEithl8RRRxzWKT3XkEKG0gjT+eaOMYZziPP0pQUl2a6qVIk1EziS0gLH6L8jH4=</latexit>
hi は誤分類,
は正分類した
<latexit sha1_base64="TFU5ayjJqm738uGMQb3tDiJ/e7Y=">AAACbHichVG7SgNBFD1ZX3F9JD4KIQhiSLAKsxYarAI2liYxD0lC2F1HXd0Xu5tADP6ArYWFWiiIiJ9h4w9Y+Aki2ESwsfBmsyAq6h1m5syZe+6cmVFsXXM9xh5DQl//wOBQeFgcGR0bj0QnJouu1XBUXlAt3XLKiuxyXTN5wdM8nZdth8uGovOSsr/a3S81ueNqlrnhtWxeM+QdU9vWVNkjarNaEXfre2K1Vo/GWYr5MfcTSAGII4h1K3qNKrZgQUUDBjhMeIR1yHCpVSCBwSauhjZxDiHN3+c4hEjaBmVxypCJ3adxh1aVgDVp3a3p+mqVTtGpO6ScQ4I9sBvWYffslj2x919rtf0aXS8tmpWeltv1yNFM/u1flUGzh91P1Z+ePWwj7XvVyLvtM91bqD198+Ckk1/JJdpJdsmeyf8Fe2R3dAOz+apeZXnuFCJ9gPT9uX+C4mJKWkpJ2cV4Jh18RRgxzGOB3nsZGaxhHQU618AxznAeehGmhZgw20sVQoFmCl9CSH4ApP+Mfw==</latexit>
hj
サンプルの数
:
[26]
Distillation
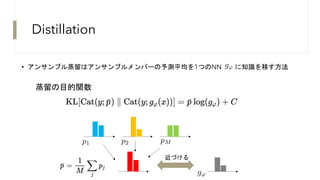
• アンサンブル蒸留はアンサンブルメンバーの予測平均を1つのNN に知識を移す方法
蒸留の目的関数
<latexit sha1_base64="vqe8wVtl01+YEmV1OH89BpQVNWY=">AAACbHichVG7SgNBFD1ZX3F9xUchBEEMilWYTaHBSrCxjMZEJQlhdx11cF/sTgIa/AFbCwu1UBARP8PGH7DIJ4hgo2Bj4c1mQVTUO8zMmTP33DkzY3iWCCRjzZjS0dnV3RPvVfv6BwaHEsMjxcCt+SYvmK7l+huGHnBLOLwghbT4hudz3TYsvm7sLbX21+vcD4TrrMl9j1dsfccR28LUJVGb5ZLqVTW1XKkmUizNwpj8CbQIpBBFzk1co4wtuDBRgw0OB5KwBR0BtRI0MHjEVdAgzickwn2OQ6ikrVEWpwyd2D0ad2hViliH1q2aQag26RSLuk/KSUyzB3bDXtg9u2WP7P3XWo2wRsvLPs1GW8u96tDReP7tX5VNs8Tup+pPzxLbyIZeBXn3QqZ1C7Otrx+cvOQXVqcbM+ySPZH/C9Zkd3QDp/5qXq3w1VOo9AHa9+f+CYqZtDaX1lYyqcVs9BVxJDGFWXrveSxiGTkU6FwbxzjDeexZGVOSykQ7VYlFmlF8CWXmA0J8jE4=</latexit>
p1
<latexit sha1_base64="ej4xZbKzjhMZhq+sj+TV/dYONVk=">AAACbHichVG7SgNBFD1Z3+sj8VEIQRBDxCrMptBgJdhYmsQkShLC7jrqkn2xuwlo8AdsLSzUQkFE/Awbf8AinyCCTQQbC+9uFkSDeoeZOXPmnjtnZhRb11yPsXZE6OsfGBwaHhFHx8YnorHJqaJrNRyVF1RLt5xtRXa5rpm84Gmezrdth8uGovOSUl/390tN7riaZW55hzavGvK+qe1pquwRtVMpi3YtLVaqtViCpVgQ871ACkECYWxasVtUsAsLKhowwGHCI6xDhkutDAkMNnFVtIhzCGnBPscxRNI2KItThkxsncZ9WpVD1qS1X9MN1CqdolN3SDmPJHtid6zDHtk9e2Yfv9ZqBTV8L4c0K10tt2vRk9n8+78qg2YPB1+qPz172EMm8KqRdztg/FuoXX3z6KyTX80lW4vsmr2Q/yvWZg90A7P5pt5kee4cIn2A9PO5e0ExnZKWU1I2nVjLhF8xjDgWsETvvYI1bGATBTrXwCkucBl5FWaEuDDXTRUioWYa30JY/AREf4xP</latexit>
p2
<latexit sha1_base64="KpVmGlrBCKiY+dLZa14vLO2pozY=">AAACbHichVG7SgNBFD1ZX3F9JD4KIQjBkGAVZlOoWAVsbARNjIkkIeyuoy7ZF7ubgAZ/wNbCQi0URMTPsPEHLPIJItgo2Fh4s1kQDeodZubMmXvunJlRbF1zPcbaIaGvf2BwKDwsjoyOjUeiE5NbrtVwVF5QLd1ySorscl0zecHTPJ2XbIfLhqLzolJf6ewXm9xxNcvc9A5sXjXkPVPb1VTZI2q7Uhbt2ppYqdaiCZZmfsR7gRSABIJYt6I3qGAHFlQ0YIDDhEdYhwyXWhkSGGziqmgR5xDS/H2OI4ikbVAWpwyZ2DqNe7QqB6xJ605N11erdIpO3SFlHEn2yG7ZK3tgd+yJffxaq+XX6Hg5oFnparldixzP5N//VRk0e9j/Uv3p2cMulnyvGnm3faZzC7Wrbx6evuaXc8lWil2xZ/J/ydrsnm5gNt/U6w2eO4NIHyD9fO5esJVJSwtpaSOTyC4FXxFGDHOYp/deRBarWEeBzjVwgnNchF6EaSEmzHZThVCgmcK3EFKfetCMag==</latexit>
pM
<latexit sha1_base64="S/hOqhQjqGRyvaa37DLu5d5Tn4g=">AAACdnichVHLSsNAFD2N7/iquhEEEUvVVblxoeJKcOPSqlWhLSWJ03ZomoQkrWjxB/wBF+JCQYv4GW78ARd+grhU0IULb9OAqKh3mJkzZ+65c2bGcC3pB0QPMaWjs6u7p7dP7R8YHBqOj4xu+07NM0XGdCzH2zV0X1jSFplABpbYdT2hVw1L7BiV1db+Tl14vnTsreDAFfmqXrJlUZp6wFQhPpLLqqVCI1fXPbcsj9RcvhBPUIrCmPoJtAgkEMW6E28ihz04MFFDFQI2AsYWdPjcstBAcJnLo8Gcx0iG+wJHUFlb4yzBGTqzFR5LvMpGrM3rVk0/VJt8isXdY+UUknRP1/RMd3RDj/T+a61GWKPl5YBno60VbmH4eHzz9V9VlecA5U/Vn54DFLEUepXs3Q2Z1i3Mtr5+ePK8ubyRbMzQBT2x/3N6oFu+gV1/MS/TYuMUKn+A9v25f4Lt+ZS2kNLS84mVpegrejGBaczxey9iBWtYR4bP3ccZrtCMvSmTSlKZbacqsUgzhi+h0AdkGpBz</latexit>
g'
<latexit sha1_base64="S/hOqhQjqGRyvaa37DLu5d5Tn4g=">AAACdnichVHLSsNAFD2N7/iquhEEEUvVVblxoeJKcOPSqlWhLSWJ03ZomoQkrWjxB/wBF+JCQYv4GW78ARd+grhU0IULb9OAqKh3mJkzZ+65c2bGcC3pB0QPMaWjs6u7p7dP7R8YHBqOj4xu+07NM0XGdCzH2zV0X1jSFplABpbYdT2hVw1L7BiV1db+Tl14vnTsreDAFfmqXrJlUZp6wFQhPpLLqqVCI1fXPbcsj9RcvhBPUIrCmPoJtAgkEMW6E28ihz04MFFDFQI2AsYWdPjcstBAcJnLo8Gcx0iG+wJHUFlb4yzBGTqzFR5LvMpGrM3rVk0/VJt8isXdY+UUknRP1/RMd3RDj/T+a61GWKPl5YBno60VbmH4eHzz9V9VlecA5U/Vn54DFLEUepXs3Q2Z1i3Mtr5+ePK8ubyRbMzQBT2x/3N6oFu+gV1/MS/TYuMUKn+A9v25f4Lt+ZS2kNLS84mVpegrejGBaczxey9iBWtYR4bP3ccZrtCMvSmTSlKZbacqsUgzhi+h0AdkGpBz</latexit>
g'
近づける
Ensemble Distribution Distillation
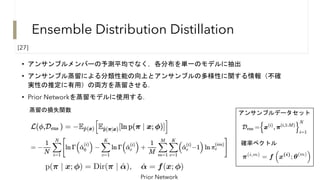
• アンサンブルメンバーの予測平均でなく,各分布を単一のモデルに抽出
• アンサンブル蒸留による分類性能の向上とアンサンブルの多様性に関する情報(不確
実性の推定に有用)の両方を蒸留させる.
• Prior Networkを蒸留モデルに使用する.
<latexit sha1_base64="g+CAlCgSD5q8Ylp3lz8MazNOXBY=">AAACz3ichVHPaxNBFP6y2lq3v1K9CF6CoSUBCbM9aKkIBS8em9a0hWwadreTZOzsD3Yn0bis9Fr/AQ+eFETEP8OLRy8e+ieIxxa9CPbtZqG/aH3DzHvzvfd982bGDqSIFGMHBe3a9bHxGxM39cmp6ZnZ4tytjcjvhw5vOL70wy3birgUHm8ooSTfCkJuubbkm/bukzS/OeBhJHzvmRoGvOVaXU90hGMpgtrF52ZTN21f7kRDl1xsBiLZjivivltNHp9OdBJT8o6qnMZeppXVJCk9Kp3RUD2urFSGRMxQdHuqqputdrHMaiyz0sXAyIMyclv1i59gYgc+HPThgsODoljCQkSjCQMMAWEtxISFFIksz5FAJ26fqjhVWITu0tqlXTNHPdqnmlHGdugUSTMkZgnz7Af7zA7ZN/aF/WR/L9WKM420lyF5e8TlQXv2zZ31P/9lueQVeiesK3tW6GAp61VQ70GGpLdwRvzBq7eH68tr8/EC+8B+Uf/v2QH7SjfwBkfOxzpfewedPsA4/9wXg43FmvGgZtQXyytL+VdM4C7uoULv/RAreIpVNOjc7/iNfwVode2F9lrbG5VqhZxzG2dM2z8GR420Uw==</latexit>
⇡(i,m)
= f
⇣
x(i)
; ✓(m)
⌘
確率ベクトル
蒸留の損失関数 アンサンブルデータセット
<latexit sha1_base64="PlX638GK/XI/EofmI7mcJ9lJ+2Q=">AAADS3ichVHPa9RAFH5JrdZU7VovgpfgUqkgy6SHWpRCQQ8ePPTXtoXNskyys83QmWSczC5dY/4B/wEPnhRExD/DixePHvoPCKXHFQTpwbfZgF3L1hcy78037/vmm5lACZ4aQo4se+rS9OUrM1ed2WvXb8xVbs7vpElXh6weJiLRewFNmeAxqxtuBNtTmlEZCLYbHDwZru/2mE55Em+bvmJNSfdj3uEhNQi1Kj/8huNLaiItM5Uv+kEi2mlfYsp8xXPXl7ztnkUPc/exm433RTzP76/6iWKamkTHVLLsKdcT5SJqxhWoUBFFjQeu/6JLL+hYPQt2xjeY6Mzxm61KldRIEe75wiuLKpSxnlQ+gg9tSCCELkhgEIPBWgCFFL8GeEBAIdaEDDGNFS/WGeTgILeLXQw7KKIHOO7jrFGiMc6HmmnBDnEXgb9GpgsL5Dv5RAbkK/lMjsnpRK2s0Bh66WMORlymWnOvb2/9+i9LYjYQ/WVd6NlAB1YKrxy9qwIZniIc8Xsv3wy2Hm0uZPfIe3KC/t+RI/IFTxD3foYfNtjmW3DwAbx/r/t8sbNU85Zr3sZSdW2lfIoZuAN3YRHv+yGswTNYhzqE1nNLW5n1yv5mD+zf9umo1bZKzi0Yi6npP5b75yk=</latexit>
p(⇡ | x; ) = Dir(⇡ | ˆ
↵), ˆ
↵ = f(x; )
Prior Network
[27]
Ensemble Distribution Distillationの一般化
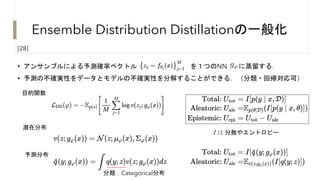
• アンサンブルによる予測確率ベクトル を1つのNN に蒸留する.
• 予測の不確実性をデータとモデルの不確実性を分解することができる.(分類・回帰対応可)
潜在分布
目的関数
予測分布
I は 分散やエントロピー
<latexit sha1_base64="S/hOqhQjqGRyvaa37DLu5d5Tn4g=">AAACdnichVHLSsNAFD2N7/iquhEEEUvVVblxoeJKcOPSqlWhLSWJ03ZomoQkrWjxB/wBF+JCQYv4GW78ARd+grhU0IULb9OAqKh3mJkzZ+65c2bGcC3pB0QPMaWjs6u7p7dP7R8YHBqOj4xu+07NM0XGdCzH2zV0X1jSFplABpbYdT2hVw1L7BiV1db+Tl14vnTsreDAFfmqXrJlUZp6wFQhPpLLqqVCI1fXPbcsj9RcvhBPUIrCmPoJtAgkEMW6E28ihz04MFFDFQI2AsYWdPjcstBAcJnLo8Gcx0iG+wJHUFlb4yzBGTqzFR5LvMpGrM3rVk0/VJt8isXdY+UUknRP1/RMd3RDj/T+a61GWKPl5YBno60VbmH4eHzz9V9VlecA5U/Vn54DFLEUepXs3Q2Z1i3Mtr5+ePK8ubyRbMzQBT2x/3N6oFu+gV1/MS/TYuMUKn+A9v25f4Lt+ZS2kNLS84mVpegrejGBaczxey9iBWtYR4bP3ccZrtCMvSmTSlKZbacqsUgzhi+h0AdkGpBz</latexit>
g'
分類:Categorical分布
[28]
アンサンブル手法
• 学習戦略
• Random Initialization/ Data Shuffling
• Bagging/Boosting
• メンバー数の削減
• Model Pruning
• Distillation
• 重み共有
• Sub-Ensembles
• Batch-Ensembles
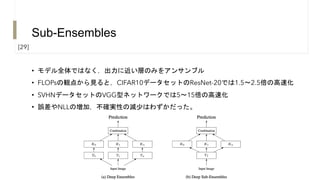
Sub-Ensembles
• モデル全体ではなく,出力に近い層のみをアンサンブル
• FLOPsの観点から見ると,CIFAR10データセットのResNet-20では1.5〜2.5倍の高速化
• SVHNデータセットのVGG型ネットワークでは5〜15倍の高速化
• 誤差やNLLの増加,不確実性の減少はわずかだった。
[29]
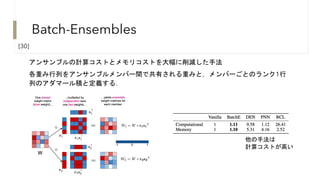
Batch-Ensembles
アンサンブルの計算コストとメモリコストを大幅に削減した手法
各重み行列をアンサンブルメンバー間で共有される重みと,メンバーごとのランク1行
列のアダマール積と定義する.
他の手法は
計算コストが高い
[30]
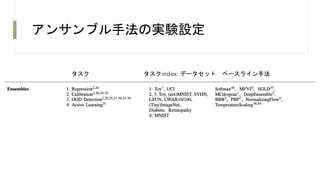
アンサンブル手法の実験設定
タスク タスクindex: データセット ベースライン手法
アンサンブルまとめ
アンサンブルのメンバー間に多様性を持たせ,不確実性の定量化
利点
• アンサンブルのメンバーは互いに独立して学習されるため,学習の並列化も
容易で実装しやすい.
• ランダムな初期化,データのシャッフル,データ拡張で精度,不確実性の定
量化,分布外の検出が有効だと確認されている.
欠点
• 必要なメモリと計算量は,学習と評価のためのメンバーの数に比例して増加.
• 計算能力やメモリが限られていたり,アプリケーションがタイムクリティカ
ルであったり,推論時間の長い非常に大きなNNが含まれていたりする多くの
実用的なアプリケーションでは,アンサンブルの展開が制限.
不確実性の推定方法
• 単一決定論的手法( Single deterministic methods )
決定論的ネットワーク内での1回のフォワードパスに基づいて予測を行う.
不確実性の定量化は,ネットワーク内部によって直接表現するか,外部手法で表現する.
• ベイズ法( Bayesian methods )
モデルパラメータを確率変数とみなし,確率的DNNになる.
• アンサンブル法( Ensemble methods )
複数の異なる決定論的ネットワークの予測値を推論時に組み合わせる.
• テスト時データ拡張法( Test-time augmentation methods )
1つの決定論的ネットワークに基づいて予測を行う.
テスト時に入力データを拡張し,複数の予測を生成する.
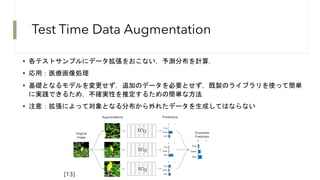
Test Time Data Augmentation
• 各テストサンプルにデータ拡張をおこない,予測分布を計算.
• 応用:医療画像処理
• 基礎となるモデルを変更せず,追加のデータを必要とせず,既製のライブラリを使って簡単
に実践できるため,不確実性を推定するための簡単な方法
• 注意:拡張によって対象となる分布から外れたデータを生成してはならない
<latexit sha1_base64="mCsecMy68IZB8deJ3cPEwEofzP4=">AAACbHichVG7SgNBFD1ZX3F9JD4KQQQxKFbhbgoVq4CNpa8kShLC7jrqkn2xu4lo8AdsLSzUQkFE/Awbf8DCTxDBRsHGwpvNgqiod5iZM2fuuXNmRnNNww+IHmJSW3tHZ1e8W+7p7etPJAcG875T83SR0x3T8dY11RemYYtcYASmWHc9oVqaKQpadaG5X6gLzzccey3Yc0XZUrdtY8vQ1YCpjVJR3q2QXCpXkilKUxjjP4ESgRSiWHKSVyhhEw501GBBwEbA2IQKn1sRCgguc2U0mPMYGeG+wAFk1tY4S3CGymyVx21eFSPW5nWzph+qdT7F5O6xchyTdE/X9EJ3dEOP9P5rrUZYo+llj2etpRVuJXE4svr2r8riOcDOp+pPzwG2MBd6Ndi7GzLNW+gtfX3/+GV1fmWyMUUX9MT+z+mBbvkGdv1Vv1wWKyeQ+QOU78/9E+QzaWUmrSxnUtm56CviGMUEpvm9Z5HFIpaQ43MtHOEUZ7FnaVgalcZaqVIs0gzhS0hTH06cjFQ=</latexit>
w0
<latexit sha1_base64="mCsecMy68IZB8deJ3cPEwEofzP4=">AAACbHichVG7SgNBFD1ZX3F9JD4KQQQxKFbhbgoVq4CNpa8kShLC7jrqkn2xu4lo8AdsLSzUQkFE/Awbf8DCTxDBRsHGwpvNgqiod5iZM2fuuXNmRnNNww+IHmJSW3tHZ1e8W+7p7etPJAcG875T83SR0x3T8dY11RemYYtcYASmWHc9oVqaKQpadaG5X6gLzzccey3Yc0XZUrdtY8vQ1YCpjVJR3q2QXCpXkilKUxjjP4ESgRSiWHKSVyhhEw501GBBwEbA2IQKn1sRCgguc2U0mPMYGeG+wAFk1tY4S3CGymyVx21eFSPW5nWzph+qdT7F5O6xchyTdE/X9EJ3dEOP9P5rrUZYo+llj2etpRVuJXE4svr2r8riOcDOp+pPzwG2MBd6Ndi7GzLNW+gtfX3/+GV1fmWyMUUX9MT+z+mBbvkGdv1Vv1wWKyeQ+QOU78/9E+QzaWUmrSxnUtm56CviGMUEpvm9Z5HFIpaQ43MtHOEUZ7FnaVgalcZaqVIs0gzhS0hTH06cjFQ=</latexit>
w0
<latexit sha1_base64="mCsecMy68IZB8deJ3cPEwEofzP4=">AAACbHichVG7SgNBFD1ZX3F9JD4KQQQxKFbhbgoVq4CNpa8kShLC7jrqkn2xu4lo8AdsLSzUQkFE/Awbf8DCTxDBRsHGwpvNgqiod5iZM2fuuXNmRnNNww+IHmJSW3tHZ1e8W+7p7etPJAcG875T83SR0x3T8dY11RemYYtcYASmWHc9oVqaKQpadaG5X6gLzzccey3Yc0XZUrdtY8vQ1YCpjVJR3q2QXCpXkilKUxjjP4ESgRSiWHKSVyhhEw501GBBwEbA2IQKn1sRCgguc2U0mPMYGeG+wAFk1tY4S3CGymyVx21eFSPW5nWzph+qdT7F5O6xchyTdE/X9EJ3dEOP9P5rrUZYo+llj2etpRVuJXE4svr2r8riOcDOp+pPzwG2MBd6Ndi7GzLNW+gtfX3/+GV1fmWyMUUX9MT+z+mBbvkGdv1Vv1wWKyeQ+QOU78/9E+QzaWUmrSxnUtm56CviGMUEpvm9Z5HFIpaQ43MtHOEUZ7FnaVgalcZaqVIs0gzhS0hTH06cjFQ=</latexit>
w0
[13]
テスト時データ拡張手法
• 拡張戦略
• 集約関数によるTTA戦略
• 損失予測によるTTA戦略
• 貪欲選択によるTTA戦略
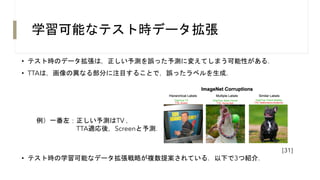
学習可能なテスト時データ拡張
• テスト時のデータ拡張は,正しい予測を誤った予測に変えてしまう可能性がある.
• TTAは,画像の異なる部分に注目することで,誤ったラベルを生成.
• テスト時の学習可能なデータ拡張戦略が複数提案されている.以下で3つ紹介.
例)一番左:正しい予測はTV ,
TTA適応後,Screenと予測.
[31]
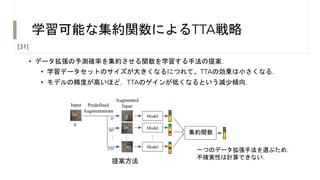
学習可能な集約関数によるTTA戦略
• データ拡張の予測確率を集約させる関数を学習する手法の提案.
• 学習データセットのサイズが大きくなるにつれて、TTAの効果は小さくなる.
• モデルの精度が高いほど,TTAのゲインが低くなるという減少傾向.
集約関数
提案方法
一つのデータ拡張手法を選ぶため,
不確実性は計算できない.
[31]
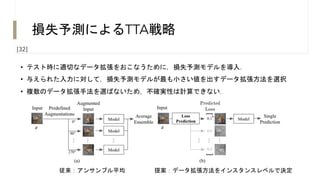
損失予測によるTTA戦略
• テスト時に適切なデータ拡張をおこなうために,損失予測モデルを導入.
• 与えられた入力に対して,損失予測モデルが最も小さい値を出すデータ拡張方法を選択
• 複数のデータ拡張手法を選ばないため,不確実性は計算できない.
従来:アンサンブル平均 提案:データ拡張方法をインスタンスレベルで決定
[32]
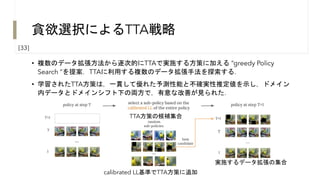
貪欲選択によるTTA戦略
• 複数のデータ拡張方法から逐次的にTTAで実施する方策に加える “greedy Policy
Search ”を提案.TTAに利用する複数のデータ拡張手法を探索する.
• 学習されたTTA方策は,一貫して優れた予測性能と不確実性推定値を示し,ドメイン
内データとドメインシフト下の両方で,有意な改善が見られた.
calibrated LL基準でTTA方策に追加
TTA方策の候補集合
実施するデータ拡張の集合
[33]
テスト時データ拡張の実験設定
タスク タスクindex: データセット ベースライン手法
テスト時データ拡張のまとめ
利点
• 簡単に実装ができ,不確実性も異なるデータ拡張の結果に基づいたアンサンブルから
計算できるため,アプリケーションに向いている.
欠点
• 推論時の計算コストが高い.
研究の方向性
• TTAに効果的なデータ拡張手法を求める手法が提案されている.
• これらの不確実性に対する影響はまだ議論されていない.
• TTAのメンバーに多様性が出るようなをデータ拡張手法を求める手法はまだない.
アジェンダ
• 不確実性の推定値を用いた実世界アプリケーション
• 不確実性の原因
• DNNにおける不確実性の分類
• 不確実性の推定方法
• 不確実性の評価指標と品質
• DNNのキャリブレーション
• 現在の課題と研究の方向性
不確かさの推定値の評価が困難な理由
• 不確かさの推定の質は,推定手法に依存
• ベイズ推論の異なる近似方法により,不確かさ推定の品質が異なる.
• 不確かさのグランドトゥルースを定義することが困難
• 統一された定量的な評価指標が存在しない
• 分類,セグメンテーション,回帰などの機械学習タスクごとに不確
実性の定義が異なる.
不確実性の推定値の評価
• 分類タスクにおける不確実性の評価尺度
• Data Uncertainty の尺度
• Model Uncertainty の尺度
• Distributional Uncertainty の尺度
• 回帰タスクにおける不確実性の評価尺度
• Data Uncertainty の尺度
• Model Uncertainty の尺度
• セグメンテーションにおける不確実性の評価尺度
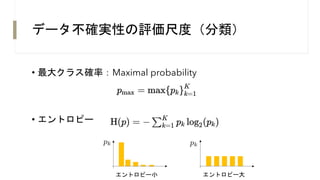
データ不確実性の評価尺度(分類)
• 最大クラス確率:Maximal probability
• エントロピー
エントロピー大
エントロピー小
<latexit sha1_base64="1G2nzcSV3QHBcQVKTOeTikPGca4=">AAACbHichVG7SgNBFD1Z3+sj8VEIQRBDxCrMptBgJdhYmsQkShLC7jrqkn2xuwlo8AdsLSzUQkFE/Awbf8AinyCCTQQbC+9uFkSDeoeZOXPmnjtnZhRb11yPsXZE6OsfGBwaHhFHx8YnorHJqaJrNRyVF1RLt5xtRXa5rpm84Gmezrdth8uGovOSUl/390tN7riaZW55hzavGvK+qe1pquwRtVMpi3atLlaqtViCpVgQ871ACkECYWxasVtUsAsLKhowwGHCI6xDhkutDAkMNnFVtIhzCGnBPscxRNI2KItThkxsncZ9WpVD1qS1X9MN1CqdolN3SDmPJHtid6zDHtk9e2Yfv9ZqBTV8L4c0K10tt2vRk9n8+78qg2YPB1+qPz172EMm8KqRdztg/FuoXX3z6KyTX80lW4vsmr2Q/yvWZg90A7P5pt5kee4cIn2A9PO5e0ExnZKWU1I2nVjLhF8xjDgWsETvvYI1bGATBTrXwCkucBl5FWaEuDDXTRUioWYa30JY/AS3KoyI</latexit>
pk
<latexit sha1_base64="1G2nzcSV3QHBcQVKTOeTikPGca4=">AAACbHichVG7SgNBFD1Z3+sj8VEIQRBDxCrMptBgJdhYmsQkShLC7jrqkn2xuwlo8AdsLSzUQkFE/Awbf8AinyCCTQQbC+9uFkSDeoeZOXPmnjtnZhRb11yPsXZE6OsfGBwaHhFHx8YnorHJqaJrNRyVF1RLt5xtRXa5rpm84Gmezrdth8uGovOSUl/390tN7riaZW55hzavGvK+qe1pquwRtVMpi3atLlaqtViCpVgQ871ACkECYWxasVtUsAsLKhowwGHCI6xDhkutDAkMNnFVtIhzCGnBPscxRNI2KItThkxsncZ9WpVD1qS1X9MN1CqdolN3SDmPJHtid6zDHtk9e2Yfv9ZqBTV8L4c0K10tt2vRk9n8+78qg2YPB1+qPz172EMm8KqRdztg/FuoXX3z6KyTX80lW4vsmr2Q/yvWZg90A7P5pt5kee4cIn2A9PO5e0ExnZKWU1I2nVjLhF8xjDgWsETvvYI1bGATBTrXwCkucBl5FWaEuDDXTRUioWYa30JY/AS3KoyI</latexit>
pk
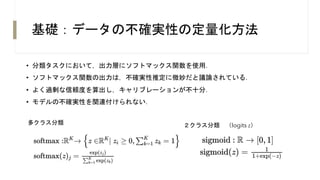
基礎:データの不確実性の定量化方法
• 分類タスクにおいて,出力層にソフトマックス関数を使用.
• ソフトマックス関数の出力は,不確実性推定に微妙だと議論されている.
• よく過剰な信頼度を算出し,キャリブレーションが不十分.
• モデルの不確実性を関連付けられない.
多クラス分類 2クラス分類 (logits z)
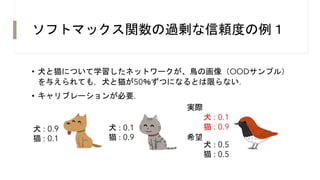
ソフトマックス関数の過剰な信頼度の例1
• 犬と猫について学習したネットワークが、鳥の画像(OODサンプル)
を与えられても,犬と猫が50%ずつになるとは限らない.
• キャリブレーションが必要.
犬 : 0.9
猫 : 0.1
犬 : 0.1
猫 : 0.9
犬 : 0.1
猫 : 0.9
犬 : 0.5
猫 : 0.5
実際
希望
ソフトマックス関数の過剰な信頼度の例2
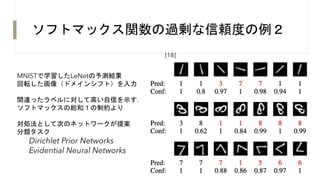
MNISTで学習したLeNetの予測結果
回転した画像(ドメインシフト)を入力
間違ったラベルに対して高い自信を示す.
ソフトマックスの総和1の制約より
対処法として次のネットワークが提案
分類タスク
Dirichlet Prior Networks
Evidential Neural Networks
[18]
モデル不確実性の評価尺度(分類)
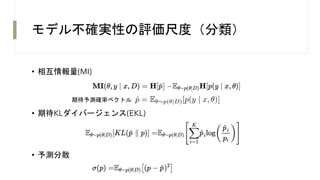
• 相互情報量(MI)
• 期待KLダイバージェンス(EKL)
• 予測分散
<latexit sha1_base64="kfTS/bb3puhlMdBB1y+byJ4RQOg=">AAACsXichVFNaxRBEH0ZoyYTNau5CLkMWSIbkKUnggZBCGgghxzytUlkZ1l7Jp1ss/PRzPQubob9A/6BHHJKQCTk5l/w4h8QkqPexGMELzmkdmZENKjVdHfVq3rVr7td5ctEM3Y2ZFwbvn7j5sioOXbr9p3x0t17G0nUiT1R8yI/irdcnghfhqKmpfbFlooFD1xfbLrt54P8ZlfEiYzCdd1TohHw3VDuSI9rgpqlJaduOi2uU9V/5gRct1w3Xeg3U0e3hOaWk8jAUpWfUSC3rRcz/bqq9PLg9UMrz800TKfRLJVZlWVmXXXswimjsOWo9A4OthHBQwcBBEJo8n1wJDTqsMGgCGsgJSwmT2Z5gT5M4naoSlAFJ7RN6y5F9QINKR70TDK2R6f4NGNiWphmn9gxO2cf2Qn7yi7+2ivNegy09Gh3c65QzfE399d+/JcV0K7R+sX6p2aNHcxlWiVpVxkyuIWX87t7++drT1en0wfsiH0j/YfsjH2gG4Td797bFbF6AJM+wP7zua86G7NV+3HVXpktz88VXzGCSUyhQu/9BPNYxDJqdO57nOIzvhiPjJfGK8PNS42hgjOB38xoXwIRQKZc</latexit>
p̂ = E✓⇠p(✓|D)[p(y | x, ✓)]
期待予測確率ベクトル
分布不確実性の評価尺度(分類)
分布の不確実性が必要な背景
• 先の不確実性指標は,BNNs,アンサンブル法,テスト時データ拡張法から得られる
複数の予測値間のばらつきを把握するために広く用いられている.
• 入力データの分布シフトや分布外の例を捉えることはできず,これが偏った推論結果
や過信につながる可能性がある.
• 例えば,すべての予測器が同じ偽のクラスラベルに高い確率で予測する場合,これは
推定値間のばらつきが小さく,確信度が高いと評価される.しかし,実際は誤り.
評価尺度
• Dirichlet Prior Network
データ不確実性の評価尺度(回帰)
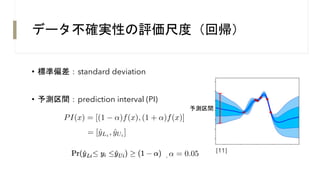
• 標準偏差:standard deviation
• 予測区間:prediction interval (PI)
<latexit sha1_base64="r5ciihKnp9FX5XwscyM5rEfDZjg=">AAACdnichVHLSsNAFD2NrxpfrW4EQcRSdVVuBLUIguDGpa/aQltKEqcaTJOQpJVa/AF/wIW4UFARP8ONP+DCTxCXCrpw4W0aEC3qHWbmzJl77pyZ0RzT8Hyix4jU0dnV3RPtlfv6BwaHYvHhbc+uurrI6LZpuzlN9YRpWCLjG74pco4r1Ipmiqy2v9Lcz9aE6xm2teXXHVGsqLuWUTZ01WeqFIsX8nJBNZ09dYlSNCcXiqVYglEQE+1ACUECYazZsWsUsAMbOqqoQMCCz9iECo9bHgoIDnNFNJhzGRnBvsARZNZWOUtwhsrsPo+7vMqHrMXrZk0vUOt8isndZeUEkvRAN/RC93RLT/Txa61GUKPppc6z1tIKpzR0PLr59q+qwrOPvS/Vn559lJEOvBrs3QmY5i30lr52ePKyubiRbEzRBT2z/3N6pDu+gVV71S/XxcYpZP4A5edzt4Pt2ZQyn1LWZxPL6fArohjDJGb4vRewjFWsIcPnHuAMV7iOvEvjUlKabqVKkVAzgm8h0SfZSo8x</latexit>
↵ = 0.05
<latexit sha1_base64="+NunsLBFYikxUu09fzIxdIgQ7wQ=">AAAClHichVHLSsNAFD3Gd3y0KojgJliUilonLlREQRBBN9KqVaEtJYlTDaZJSNJiLf6Ae3HhSkFE/ASXKvgDLvwEcangxoW3acAX6g2ZOffMPXfOzKi2obseYw81Qm1dfUNjU7PY0trWHgp3dK65VsHReFKzDMvZUBWXG7rJk57uGXzDdriSVw2+ru7MVdbXi9xxdctc9Uo2z+SVLVPP6ZriEZUNj6ZTYnwxujsozUipqDySVgx7WxmUckQNR+Whz3lGTGey4QiLMT+kn0AOQARBxK3wOdLYhAUNBeTBYcIjbECBS18KMhhs4jIoE+cQ0v11jn2IpC1QFacKhdgdGrcoSwWsSXmlp+urNdrFoN8hpYR+ds8u2DO7Y5fskb392qvs96h4KdGsVrXczoYOelZe/1Xlafaw/aH607OHHCZ9rzp5t32mcgqtqi/uHT2vTC33lwfYKXsi/yfsgV3TCczii3aW4MvHEOkB5O/X/ROsjcXk8ZicGIvMTgZP0YRe9CFK9z2BWSwgjiTte4gr3OBW6BamhTlhvloq1ASaLnwJYekdV2SXfQ==</latexit>
PI(x) = [(1 ↵)f(x), (1 + ↵)f(x)]
<latexit sha1_base64="OYP/AzCWAsamXQV9PjIHI0JAGt0=">AAACinicSyrIySwuMTC4ycjEzMLKxs7BycXNw8vHLyAoFFacX1qUnBqanJ+TXxSRlFicmpOZlxpaklmSkxpRUJSamJuUkxqelO0Mkg8vSy0qzszPCympLEiNzU1Mz8tMy0xOLAEKxQuoxkRz2SpEx2QkllRX1sZX+8Rn1urAeaFAXixXTGy8gLKBngEYKGAyDKEMZQYoCMgXWM4Qw5DCkM+QzFDKkMuQypDHUAJk5zAkMhQDYTSDIYMBQwFQLJahGihWBGRlguVTGWoZuIB6S4GqUoEqEoGi2UAyHciLhormAfkgM4vBupOBtuQAcRFQpwKDqsFVg5UGnw1OGKw2eGnwB6dZ1WAzQG6pBNJJEL2pBfH8XRLB3wnqygXSJQwZCF143VzCkMZgAXZrJtDtBWARkC+SIfrLqqZ/DrYKUq1WM1hk8Bro/oUGNw0OA32QV/YleWlgatBsBi5gBBiiBzcmI8xIz9BMzzDQSNnBAhoVHAzSDEoMGsDwNmdwYPBgCGAIBdrbzbCRYRfDbiYeJiMmSyZriFImRqgeYQYUwOQCAA8Il8w=</latexit>
= [ŷLi , ŷUi ]
予測区間
,
[11]
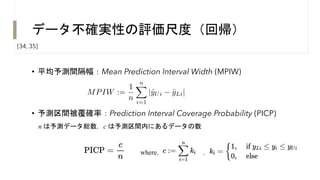
データ不確実性の評価尺度(回帰)
• 平均予測間隔幅:Mean Prediction Interval Width (MPIW)
• 予測区間被覆確率:Prediction Interval Coverage Probability (PICP)
n は予測データ総数,c は予測区間内にあるデータの数
<latexit sha1_base64="dqsIVi1+gT86yDy5U/FhOEIQ1Zc=">AAACrHichVFNS9xAGH5MrbVpq9t6KXgJLkovXSYerAiC4EGFCuvHusJmDUmc1cF8kcwubGP+gH/AgyeFIiL+Ci+9Fw9C+wNKjxZ66cE32dBSpfUNmXneZ97nnWdm7NAVsWTsuk951P944MngU/XZ8xdDw6WXrzbioB05vOYEbhBt2lbMXeHzmhTS5ZthxC3Pdnnd3pvP1usdHsUi8NdlN+RNz9rxRUs4liTKLC0YDXVZq2pLWn1m1mhFlpPoaeKnmhG3PTMRs3q6laX7xq4lk25qJjVNpG9/Z+8p21eNplkqswrLQ7sP9AKUUUQ1KJ3CwDYCOGjDA4cPSdiFhZi+BnQwhMQ1kRAXERL5OkcKlbRtquJUYRG7R+MOZY2C9SnPesa52qFdXPojUmoYZ1fsjN2wT+ycfWO//tkryXtkXro02z0tD83hg9drPx9UeTRL7P5R/dezRAvTuVdB3sOcyU7h9PSdD4c3azOr48kEO2Hfyf8xu2aXdAK/88P5uMJXj6DSA+h3r/s+2Jis6FMVfWWyPDddPMUgRjGGN3Tf7zCHRVRRo30v8Blf8FWpKOtKQ2n2SpW+QjOCv0Jp3QJH76UE</latexit>
MPIW :=
1
n
n
X
i=1
|ŷUi ŷLi|
where, ,
[34, 35]
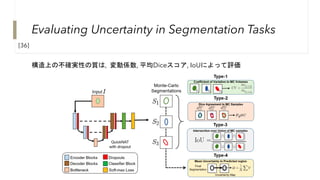
Evaluating Uncertainty in Segmentation Tasks
構造上の不確実性の質は, 変動係数, 平均Diceスコア, IoUによって評価
[36]