【論論⽂文紹介】  
階層モデルの分散パラメータ
の事前分布について
2016/03/11
@hoxo_̲m
1
本⽇日紹介する論論⽂文
•  “Prior distributions for variance
parameters in hierarchical models”
•  (階層モデルの分散パラメータの事前分布)
•  by Andrew Gelman
•  Bayesian Analysis 2006
https://projecteuclid.org/euclid.ba/1340371048
2
論論⽂文概要
•  【背景】
階層モデルの分散パラメータの事前分布と
して、⼀一般的に逆ガンマ分布が使⽤用されて
いる。
•  【結論論】
逆ガンマ分布は使ってはいけない。
グループ数が⼤大きいときは⼀一様分布を、  
⼩小さいときは弱い情報を持たせた半コー
シー分布を使うのが良良い。
3
この論論⽂文を読んだ理理由
•  ベイズモデルにおいて事前分布の選択は
重要である。
•  にもかかわらず、(⾃自分は)あんまりよく分
からずに適当に使っている。
•  Stan  のマニュアルに事前分布について、
最低限これ読んどけ的な論論⽂文が3つ紹介
されている。
•  そのうちの⼀一つ。
4
論論⽂文著者について
•  Andrew Gelman
– コロンビア⼤大学教授
– 実践的ベイジアン
– ⽶米国統計学会の賞を3回受賞
– 応⽤用統計学の巨⼈人
– Stan の開発者
https://en.wikipedia.org/wiki/Andrew_Gelman
5
発表の流流れ
1.  背景、使⽤用モデル
2.  ⽤用語説明
3.  理理論論的考察
4.  実際のデータに適⽤用
5.  結論論
6
1.  背景
•  階層モデルの各パラメータに対して事前
分布を与える必要がある。
•  本論論⽂文では階層分散パラメータに対して
どのような事前分布を使えば良良いかを調
査した。
7
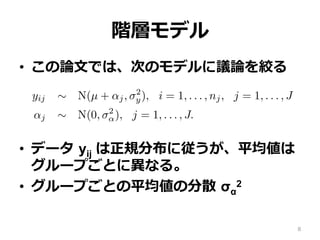
階層モデル
•  この論論⽂文では、次のモデルに議論論を絞る
•  データ  yij は正規分布に従うが、平均値は
グループごとに異異なる。
•  グループごとの平均値の分散  σα
2
e basic hierarchical model
ork with a simple two-level normal model of data yij with group
yij ∼ N(µ + αj, σ2
y), i = 1, . . . , nj, j = 1, . . . , J
αj ∼ N(0, σ2
α), j = 1, . . . , J.
discuss other hierarchical models in Section 7.2.
(1) has three hyperparameters—µ, σy, and σα—but in this paper
nly with the last of these. Typically, enough data will be avail
d σy that one can use any reasonable noninformative prior distri
(µ, σy) ∝ 1 or p(µ, log σy) ∝ 1.
noninformative prior distributions for σα have been suggested8
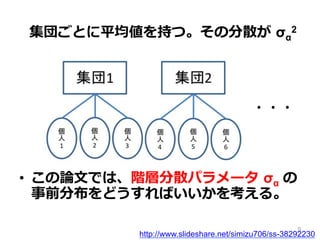
•  この論論⽂文では、階層分散パラメータ  σα の
事前分布をどうすればいいかを考える。
http://www.slideshare.net/simizu706/ss-38292230
・・・
集団ごとに平均値を持つ。その分散が  σα
2
9
発表の流流れ
1.  背景、使⽤用モデル
2.  ⽤用語説明
3.  理理論論的考察
4.  実際のデータに適⽤用
5.  結論論
10
2.  ⽤用語説明
•  基本的な⽤用語および次の 3 つを説明する。
(2-1) 条件付き共役事前分布
(2-2) Improper な事前分布
(2-3) 弱情報事前分布
11
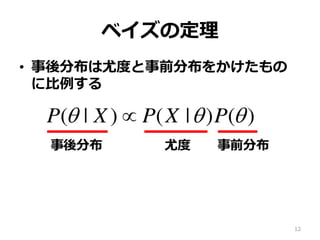
ベイズの定理理
•  事後分布は尤度度と事前分布をかけたもの
に⽐比例例する
12
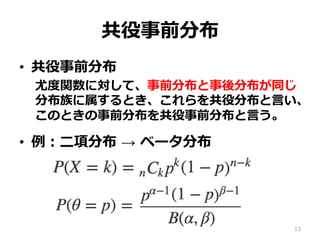
共役事前分布
•  共役事前分布
尤度度関数に対して、事前分布と事後分布が同じ
分布族に属するとき、これらを共役分布と⾔言い、
このときの事前分布を共役事前分布と⾔言う。
•  例例:⼆二項分布  →  ベータ分布
13
(2-1)  条件付き共役事前分布
•  条件付き共役事前分布
パラメータが複数ある場合、特定のパラメータ
に着⽬目し、それ以外を固定した尤度度関数に対し
て共役となるような事前分布を、そのパラメー
タに対する条件付き共役事前分布という。
•  分散に着⽬目した正規分布  →  逆ガンマ分布
Normal(σ ; µ) → InvGamma(α, β)
http://d.hatena.ne.jp/teramonagi/20141011/1412991275
14
(2-1)  条件付き共役事前分布
•  階層分散パラメータ  σα  には、シンプルな
共役分布は無い
Hill(1965), Tiao & Tan(1965)
•  なので、条件付き共役事前分布を使う
15
無情報事前分布
•  事後分布にできるだけ影響しないような
事前分布
•  事前知識識が無い場合は無情報事前分布を
使う
•  簡単そうに⾒見見えて、実は難しい概念念
http://ibisforest.org/index.php?無情報事前分布
16
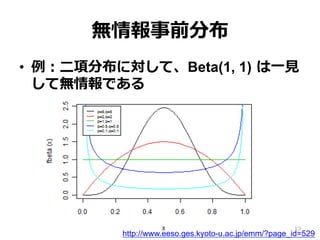
無情報事前分布
•  例例:⼆二項分布に対して、Beta(1, 1)  は⼀一⾒見見
して無情報である
http://www.eeso.ges.kyoto-u.ac.jp/emm/?page_id=529
17
無情報事前分布
•  これはある解釈のもとでは正しいが、    
変数変換により偏りが⽣生じてしまう
•  真に無情報と⾔言えるのは、Beta(0, 0) ?
•  しかし、これは improper である
•  無情報には様々な解釈がある
変数変換に強い無情報事前分布として  Jeffreys
事前分布 Beta(0.5, 0.5) が有名
http://ibisforest.org/index.php?Jeffreys事前分布
18
(2-2) Improper な事前分布
•  ベイズの定理理において、事前分布を定数倍し
ても事後分布に影響はない
•  すなわち、事前分布の積分は 1 でなくて良良い
•  さらに進めて、積分が発散するものを考える
•  積分が発散するとき  improper  な分布と呼ぶ
https://en.wikipedia.org/wiki/Prior_probability#Improper_priors
19
(2-2) Improper な事前分布
•  例例:
⼀一様分布   Uniform(-‐‑‒∞, ∞)
逆ガンマ分布    InvGamma(0, 0)
ベータ分布 Beta(0, 0)
•  ある意味、理理想的な無情報事前分布
•  ただし、improper な事前分布を使うと、
事後分布も improper となる可能性がある
20
(2-2) Improper な事前分布
•  ソフトウェアの制約により、improper  な
事前分布が使えない(※BUGSの場合。Stanでは使える)
•  Improper な事前分布の極限表現を使う。
•  例例:
⼀一様分布   Uniform(-A, A), A →  ⼤大
逆ガンマ分布    InvGamma(ε, ε), ε  →  ⼩小
(2-3) 弱情報事前分布
•  無情報事前分布に近いが、少しだけ情報
を持っている事前分布
•  実際、我々はどんな問題に対しても多少
は事前知識識を持っている
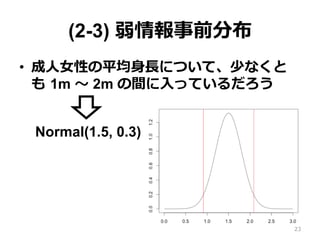
•  例例:  成⼈人⼥女女性の平均⾝身⻑⾧長について、少な
くとも 1m〜~2m の間に⼊入っているだろう
22
(2-3) 弱情報事前分布
•  成⼈人⼥女女性の平均⾝身⻑⾧長について、少なくと
も  1m 〜~ 2m の間に⼊入っているだろう
Normal(1.5, 0.3)
23
論論⽂文の流流れ①
•  階層分散パラメータの事前分布として、
良良いものを⾒見見つけたい。
•  無情報事前分布として、improper  な事前
分布の極限表現を調べる。
•  評価基準:
•  事後分布に対する影響が少ない
•  結論論①:⼀一様分布が良良い。
24
論論⽂文の流流れ②
•  グループ数が⼩小さい場合、⼀一様分布では  
事後分布への影響が⼤大きい。
•  弱情報事前分布を使うことを考える。
•  ⼀一様分布に弱情報を持たせても、事後分
布への影響は⼤大きいまま。
•  弱情報事前分布として、条件付き共役で
ある半コーシー分布を使うと良良い。
25
発表の流流れ
1.  背景、使⽤用モデル
2.  ⽤用語説明
3.  理理論論的考察
4.  実際のデータに適⽤用
5.  結論論
26
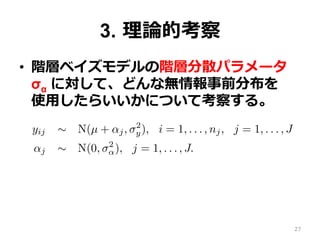
3.  理理論論的考察
•  階層ベイズモデルの階層分散パラメータ  
σα に対して、どんな無情報事前分布を  
使⽤用したらいいかについて考察する。
lly-conjugate family. We propose a half-t model and demonstra
nformative prior distribution and as a component in a hierarchic
arameters.
e basic hierarchical model
ork with a simple two-level normal model of data yij with group
yij ∼ N(µ + αj, σ2
y), i = 1, . . . , nj, j = 1, . . . , J
αj ∼ N(0, σ2
α), j = 1, . . . , J.
discuss other hierarchical models in Section 7.2.
(1) has three hyperparameters—µ, σy, and σα—but in this paper
nly with the last of these. Typically, enough data will be avail
d σy that one can use any reasonable noninformative prior distri
(µ, σ ) ∝ 1 or p(µ, log σ ) ∝ 1.
27
逆ガンマ分布
•  σα 〜~ InvGamma(ε, ε)
•  条件付き共役事前分布
•  昔からよく使われている
•  事後分布が  ε  の値に影響される
•  結論論:使えない
28
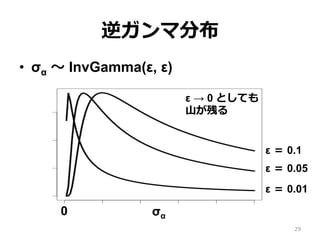
逆ガンマ分布
•  σα 〜~ InvGamma(ε, ε)
σα0
ε → 0 としても
⼭山が残る
ε = 0.01
ε = 0.05
ε = 0.1
29
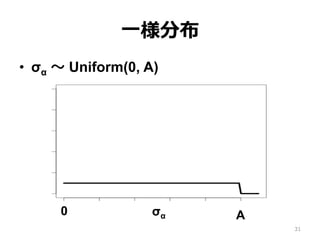
⼀一様分布
•  σα 〜~ Uniform(0, A)
•  先ほどのような問題が発⽣生しないので良良い
•  ただし、J=1,2 のとき事後分布が improper
•  J  が⼩小さいとき、miscalibration が⼤大きい
•  結論論:J が⼤大きいなら使える
30
⼀一様分布
•  σα 〜~ Uniform(0, A)
σα0 A
31
半コーシー分布
•  σα 〜~ HalfCauchy(A)
•  コーシー分布の正の範囲だけ
•  条件付き共役事前分布
•  σα = 0  で最⼤大値を取り、なだらかに減少
•  弱情報事前分布
•  J  が⼩小さい場合に良良さそう
32
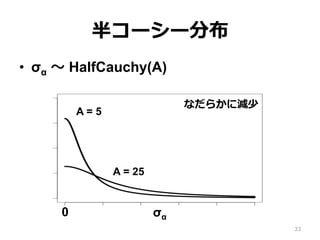
半コーシー分布
•  σα 〜~ HalfCauchy(A)
A = 5
A = 25
σα0
なだらかに減少
33
発表の流流れ
1.  背景、使⽤用モデル
2.  ⽤用語説明
3.  理理論論的考察
4.  実際のデータに適⽤用
5.  結論論
34
4.  実際のデータに適⽤用
•  8-schools データ
•  8 つの学校で⾏行行われた共通テストの点数
•  階層モデルにより学校間の得点差をモデル化
•  σα  に対して無情報事前分布を適⽤用してみる
lly-conjugate family. We propose a half-t model and demonstra
nformative prior distribution and as a component in a hierarchic
arameters.
e basic hierarchical model
ork with a simple two-level normal model of data yij with group
yij ∼ N(µ + αj, σ2
y), i = 1, . . . , nj, j = 1, . . . , J
αj ∼ N(0, σ2
α), j = 1, . . . , J.
discuss other hierarchical models in Section 7.2.
(1) has three hyperparameters—µ, σy, and σα—but in this paper
nly with the last of these. Typically, enough data will be avail
d σy that one can use any reasonable noninformative prior distri35
http://www.slideshare.net/simizu706/ss-38292230
・・・
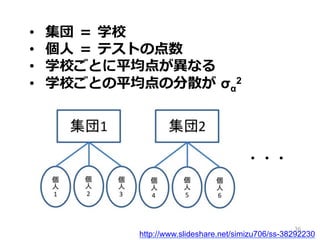
•  集団  =  学校
•  個⼈人  =  テストの点数
•  学校ごとに平均点が異異なる
•  学校ごとの平均点の分散が  σα
2
36
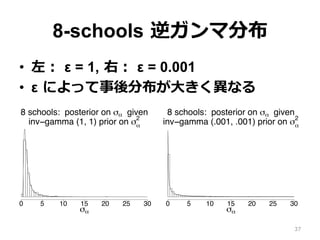
8-schools  逆ガンマ分布
•  左:  ε = 1,  右:  ε = 0.001
•  ε  によって事後分布が⼤大きく異異なる 523
30
n
σα
0 5 10 15 20 25 30
8 schools: posterior on σα given
inv−gamma (1, 1) prior on σα
2
σα
0 5 10 15 20 25 30
8 schools: posterior on σα given
inv−gamma (.001, .001) prior on σα
2
osterior simulations of the between-school standard deviation,37
8-schools  逆ガンマ分布
•  逆ガンマ分布にはピークがあり、ε を変更更
するとピークが移動する。
•  このピークの位置に依存して事後分布が
変わってしまう。
•  ε  をどれだけ⼩小さくしても、この状況は変
わらない(⼗十分⼩小さな  ε  が存在しない)
•  無情報事前分布としては不不適切切
38
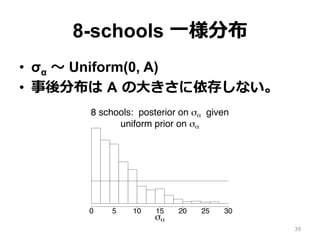
8-schools ⼀一様分布
•  σα 〜~ Uniform(0, A)
•  事後分布は  A  の⼤大きさに依存しない。Andrew Gelman
σα
0 5 10 15 20 25 30
8 schools: posterior on σα given
uniform prior on σα
σα
0 5 10 15
8 schools: poste
inv−gamma (1,
39
8-schools  ⼀一様分布
•  逆ガンマ分布とは異異なり、⼗十分⼤大きな  A  
を選べば、事後分布には影響しない。
•  無情報事前分布として良良い。
•  σα ≦ 20  にだいたい収まっている。
•  J=8 ではこれ以上の推定は困難。
(注:今は推定の良良さではなく、無情報事前分布としての良良
さを調べている)
40
3-schools データ  
•  グループ数が少ない場合はどうなるか?
•  8-schools データのうち最初の3つを抽出
•  J=3 に対して無情報事前分布を適⽤用する
41
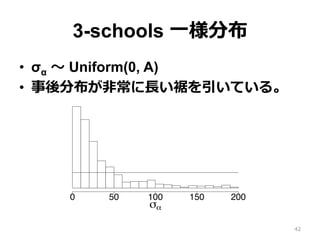
3-schools ⼀一様分布
•  σα 〜~ Uniform(0, A)
•  事後分布が⾮非常に⻑⾧長い裾を引いている。
24 Prior distributions for variance pa
σα
0 50 100 150 200
3 schools: posterior on σα given
uniform prior on σα
0
3
Figure 2: Histograms of posterior simulations of th42
3-schools  ⼀一様分布
•  事後分布が⾮非常に⻑⾧長い裾を引いている。
•  事前分布の影響が残っている。
•  無情報  =  事後分布に影響しない
•  無情報事前分布として不不適切切
43
3-schools  弱情報事前分布
•  3-schools 問題では、improper な⼀一様分
布は、無情報事前分布として使えない。
•  弱い事前情報を考える。
•  テストの点数は 200 〜~ 800点、平均は
500点程度度なので、標準偏差は 300  以下と
なる可能性が⾼高い。
•  A=300 としてみる。
44
3-schools 弱情報事前分布
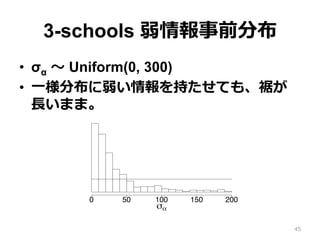
•  σα 〜~ Uniform(0, 300)
•  ⼀一様分布に弱い情報を持たせても、裾が
⻑⾧長いまま。
524 Prior distributions for variance param
σα
0 50 100 150 200
3 schools: posterior on σα given
uniform prior on σα
0
3 sch
hal
Figure 2: Histograms of posterior simulations of the b45
3-schools  弱情報事前分布
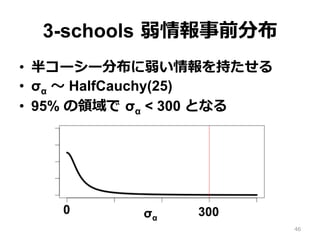
•  半コーシー分布に弱い情報を持たせる
•  σα 〜~ HalfCauchy(25)
•  95% の領領域で  σα < 300 となる
σα
0 300
46
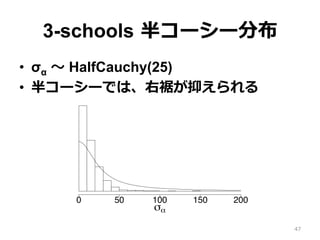
3-schools  半コーシー分布  
•  σα 〜~ HalfCauchy(25)
•  半コーシーでは、右裾が抑えられる
variance parameters in hierarchical models
00
n
σα
0 50 100 150 200
3 schools: posterior on σα given
half−Cauchy (25) prior on σα
ulations of the between-school standard deviation,47
発表の流流れ
1.  背景、使⽤用モデル
2.  ⽤用語説明
3.  理理論論的考察
4.  実際のデータに適⽤用
5.  結論論
48
5.  結論論
•  階層モデルの階層分散パラメータについ
て、無情報事前分布として何が良良いかを
調べた。
•  グループ数 J > 5 の場合は A を⼗十分⼤大き
くした⼀一様分布 Uniform(0, A) が良良い。
•  J = 3,4,5 の場合は半コーシー分布が良良い。
•  逆ガンマ分布は使ってはダメ。
49