Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
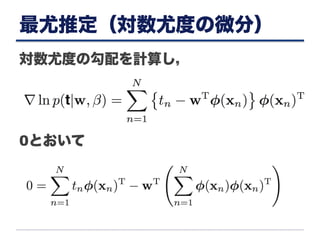
Social Media
Marketing
Technology
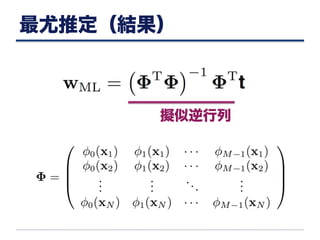
Art & Photos
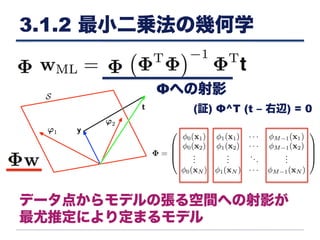
Career
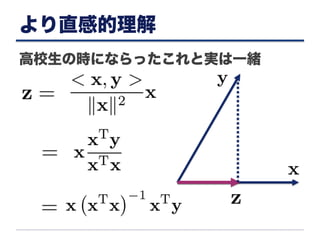
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
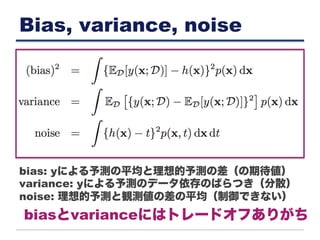
Leadership & Management
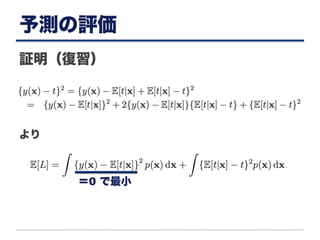
Automotive
Engineering
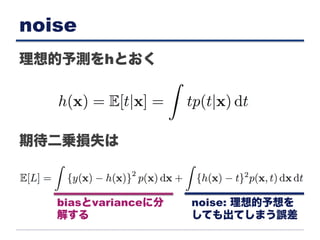
Software
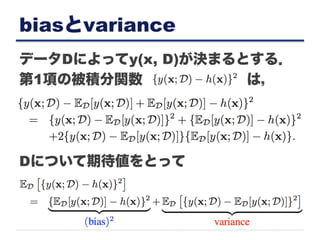
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
Sotetsu KOYAMADA(小山田創哲)
7,009 views
PRML第3章@京大PRML輪講
6/24京大PRML輪講(第3回)での発表資料. 第3章〜3.2まで
Data & Analytics
◦
Read more
12
Save
Share
Embed
Save to Drive
Download now
Downloaded 68 times
1
/ 28
2
/ 28
3
/ 28
Most read
4
/ 28
5
/ 28
6
/ 28
7
/ 28
8
/ 28
9
/ 28
10
/ 28
11
/ 28
12
/ 28
Most read
13
/ 28
Most read
14
/ 28
15
/ 28
16
/ 28
17
/ 28
18
/ 28
19
/ 28
20
/ 28
More Related Content
PDF
PRML8章
by
弘毅 露崎
75 slides
16.8K views
PDF
PRML輪読#2
by
matsuolab
36 slides
14.3K views
PDF
[PRML] パターン認識と機械学習(第3章:線形回帰モデル)
by
Ryosuke Sasaki
46 slides
3.7K views
PDF
PRML輪読#1
by
matsuolab
29 slides
31.5K views
PDF
PRML輪読#3
by
matsuolab
38 slides
12.4K views
PPTX
PRML 2.3 ガウス分布
by
KokiTakamiya
24 slides
719 views
PDF
2013.12.26 prml勉強会 線形回帰モデル3.2~3.4
by
Takeshi Sakaki
39 slides
6K views
PDF
Prml 2.3
by
Yuuki Saitoh
57 slides
11.4K views
PRML8章
by
弘毅 露崎
75 slides
16.8K views
PRML輪読#2
by
matsuolab
36 slides
14.3K views
[PRML] パターン認識と機械学習(第3章:線形回帰モデル)
by
Ryosuke Sasaki
46 slides
3.7K views
PRML輪読#1
by
matsuolab
29 slides
31.5K views
PRML輪読#3
by
matsuolab
38 slides
12.4K views
PRML 2.3 ガウス分布
by
KokiTakamiya
24 slides
719 views
2013.12.26 prml勉強会 線形回帰モデル3.2~3.4
by
Takeshi Sakaki
39 slides
6K views
Prml 2.3
by
Yuuki Saitoh
57 slides
11.4K views
What's hot
PDF
Prml2.1 2.2,2.4-2.5
by
Takuto Kimura
83 slides
10.9K views
PDF
PRML 3.3.3-3.4 ベイズ線形回帰とモデル選択 / Baysian Linear Regression and Model Comparison)
by
Akihiro Nitta
23 slides
668 views
PDF
PRML輪読#4
by
matsuolab
43 slides
10.1K views
PDF
PRML輪読#8
by
matsuolab
61 slides
8.5K views
PDF
PRML輪読#10
by
matsuolab
73 slides
9.9K views
PDF
PRML 6.1章 カーネル法と双対表現
by
hagino 3000
12 slides
5.2K views
PDF
PRML輪読#6
by
matsuolab
27 slides
6.8K views
PDF
PRML輪読#7
by
matsuolab
45 slides
7.5K views
PPTX
PRML第6章「カーネル法」
by
Keisuke Sugawara
61 slides
29.7K views
PDF
変分推論法(変分ベイズ法)(PRML第10章)
by
Takao Yamanaka
34 slides
32.6K views
PDF
PRML読書会#4資料+補足
by
Hiromasa Ohashi
64 slides
5.1K views
PPTX
パターン認識と機械学習(PRML)第2章 確率分布 2.3 ガウス分布
by
Nagayoshi Yamashita
46 slides
32.7K views
PDF
階層モデルの分散パラメータの事前分布について
by
hoxo_m
49 slides
37.3K views
PDF
PRML輪読#14
by
matsuolab
35 slides
12.8K views
PDF
PRML 2.4
by
kazunori sakai
36 slides
641 views
PDF
PRML 第4章
by
Akira Miyazawa
94 slides
14.5K views
PPTX
PRML 4.4-4.5.2 ラプラス近似
by
KokiTakamiya
35 slides
506 views
PDF
PRMLの線形回帰モデル(線形基底関数モデル)
by
Yasunori Ozaki
56 slides
46.7K views
PDF
PRML上巻勉強会 at 東京大学 資料 第1章後半
by
Ohsawa Goodfellow
34 slides
7.1K views
PDF
PRML 上 2.3.6 ~ 2.5.2
by
禎晃 山崎
67 slides
2.3K views
Prml2.1 2.2,2.4-2.5
by
Takuto Kimura
83 slides
10.9K views
PRML 3.3.3-3.4 ベイズ線形回帰とモデル選択 / Baysian Linear Regression and Model Comparison)
by
Akihiro Nitta
23 slides
668 views
PRML輪読#4
by
matsuolab
43 slides
10.1K views
PRML輪読#8
by
matsuolab
61 slides
8.5K views
PRML輪読#10
by
matsuolab
73 slides
9.9K views
PRML 6.1章 カーネル法と双対表現
by
hagino 3000
12 slides
5.2K views
PRML輪読#6
by
matsuolab
27 slides
6.8K views
PRML輪読#7
by
matsuolab
45 slides
7.5K views
PRML第6章「カーネル法」
by
Keisuke Sugawara
61 slides
29.7K views
変分推論法(変分ベイズ法)(PRML第10章)
by
Takao Yamanaka
34 slides
32.6K views
PRML読書会#4資料+補足
by
Hiromasa Ohashi
64 slides
5.1K views
パターン認識と機械学習(PRML)第2章 確率分布 2.3 ガウス分布
by
Nagayoshi Yamashita
46 slides
32.7K views
階層モデルの分散パラメータの事前分布について
by
hoxo_m
49 slides
37.3K views
PRML輪読#14
by
matsuolab
35 slides
12.8K views
PRML 2.4
by
kazunori sakai
36 slides
641 views
PRML 第4章
by
Akira Miyazawa
94 slides
14.5K views
PRML 4.4-4.5.2 ラプラス近似
by
KokiTakamiya
35 slides
506 views
PRMLの線形回帰モデル(線形基底関数モデル)
by
Yasunori Ozaki
56 slides
46.7K views
PRML上巻勉強会 at 東京大学 資料 第1章後半
by
Ohsawa Goodfellow
34 slides
7.1K views
PRML 上 2.3.6 ~ 2.5.2
by
禎晃 山崎
67 slides
2.3K views
Viewers also liked
PPT
Osaka prml reading_3.2-3.3.1
by
florets1
10 slides
1.3K views
PPTX
PRMLrevenge_3.3
by
Naoya Nakamura
14 slides
3K views
PDF
Prml sec3
by
Keisuke OTAKI
63 slides
1.5K views
PDF
Prml
by
syou6162
33 slides
3.8K views
PDF
【論文紹介】Reward Augmented Maximum Likelihood for Neural Structured Prediction
by
Sotetsu KOYAMADA(小山田創哲)
14 slides
1.8K views
PDF
正則化つき線形モデル(「入門機械学習第6章」より)
by
Eric Sartre
36 slides
49.1K views
PDF
Stan超初心者入門
by
Hiroshi Shimizu
156 slides
90.2K views
Osaka prml reading_3.2-3.3.1
by
florets1
10 slides
1.3K views
PRMLrevenge_3.3
by
Naoya Nakamura
14 slides
3K views
Prml sec3
by
Keisuke OTAKI
63 slides
1.5K views
Prml
by
syou6162
33 slides
3.8K views
【論文紹介】Reward Augmented Maximum Likelihood for Neural Structured Prediction
by
Sotetsu KOYAMADA(小山田創哲)
14 slides
1.8K views
正則化つき線形モデル(「入門機械学習第6章」より)
by
Eric Sartre
36 slides
49.1K views
Stan超初心者入門
by
Hiroshi Shimizu
156 slides
90.2K views
Similar to PRML第3章@京大PRML輪講
PDF
Prml 3 3.3
by
Arata Honda
70 slides
1K views
PDF
[PRML勉強会資料] パターン認識と機械学習 第3章 線形回帰モデル (章頭-3.1.5)(p.135-145)
by
Itaru Otomaru
17 slides
5.7K views
PDF
0712-2
by
RIKEN Center for Integrative Medical Science Center (IMS-RCAI)
21 slides
230 views
PDF
カステラ本勉強会 第三回
by
ke beck
45 slides
3.3K views
PDF
PRML セミナー
by
sakaguchi050403
73 slides
242 views
PPTX
統計的学習の基礎_3章
by
Shoichi Taguchi
81 slides
10.5K views
PPTX
一般線形モデル
by
MatsuiRyo
30 slides
2.3K views
PDF
統計的学習の基礎 3章前半
by
Kazunori Miyanishi
30 slides
804 views
PDF
カステラ本勉強会 第三回 補足
by
ke beck
12 slides
1.7K views
PDF
02 機械学習
by
CHIHIROGO
23 slides
90 views
PDF
PRML10-draft1002
by
Toshiyuki Shimono
13 slides
156 views
PDF
Study AIラビットチャレンジ 機械学習
by
Naoki Nishikawa
15 slides
156 views
PPTX
自然科学の統計学2.2 slideshare
by
wada, kazumi
18 slides
746 views
PDF
レポート1
by
YoshikazuHayashi3
48 slides
81 views
PDF
機械学習と深層学習の数理
by
Ryo Nakamura
52 slides
54.4K views
PDF
C06
by
anonymousouj
48 slides
70 views
PDF
Reggression①
by
Yuta Tomomatsu
54 slides
376 views
PDF
PRML復々習レーン#3 3.1.3-3.1.5
by
sleepy_yoshi
21 slides
3.1K views
PDF
20140512_水曜セミナードラフトv1
by
Tomoshige Nakamura
93 slides
2.5K views
PDF
統計的学習の基礎 3章後半
by
Kazunori Miyanishi
25 slides
357 views
Prml 3 3.3
by
Arata Honda
70 slides
1K views
[PRML勉強会資料] パターン認識と機械学習 第3章 線形回帰モデル (章頭-3.1.5)(p.135-145)
by
Itaru Otomaru
17 slides
5.7K views
0712-2
by
RIKEN Center for Integrative Medical Science Center (IMS-RCAI)
21 slides
230 views
カステラ本勉強会 第三回
by
ke beck
45 slides
3.3K views
PRML セミナー
by
sakaguchi050403
73 slides
242 views
統計的学習の基礎_3章
by
Shoichi Taguchi
81 slides
10.5K views
一般線形モデル
by
MatsuiRyo
30 slides
2.3K views
統計的学習の基礎 3章前半
by
Kazunori Miyanishi
30 slides
804 views
カステラ本勉強会 第三回 補足
by
ke beck
12 slides
1.7K views
02 機械学習
by
CHIHIROGO
23 slides
90 views
PRML10-draft1002
by
Toshiyuki Shimono
13 slides
156 views
Study AIラビットチャレンジ 機械学習
by
Naoki Nishikawa
15 slides
156 views
自然科学の統計学2.2 slideshare
by
wada, kazumi
18 slides
746 views
レポート1
by
YoshikazuHayashi3
48 slides
81 views
機械学習と深層学習の数理
by
Ryo Nakamura
52 slides
54.4K views
C06
by
anonymousouj
48 slides
70 views
Reggression①
by
Yuta Tomomatsu
54 slides
376 views
PRML復々習レーン#3 3.1.3-3.1.5
by
sleepy_yoshi
21 slides
3.1K views
20140512_水曜セミナードラフトv1
by
Tomoshige Nakamura
93 slides
2.5K views
統計的学習の基礎 3章後半
by
Kazunori Miyanishi
25 slides
357 views
More from Sotetsu KOYAMADA(小山田創哲)
PDF
【論文紹介】PGQ: Combining Policy Gradient And Q-learning
by
Sotetsu KOYAMADA(小山田創哲)
44 slides
7K views
PDF
【強化学習】Montezuma's Revenge @ NIPS2016
by
Sotetsu KOYAMADA(小山田創哲)
34 slides
2.9K views
PDF
KDD2016論文読み会資料(DeepIntent)
by
Sotetsu KOYAMADA(小山田創哲)
18 slides
2.3K views
PDF
強化学習勉強会・論文紹介(Kulkarni et al., 2016)
by
Sotetsu KOYAMADA(小山田創哲)
18 slides
1.8K views
PDF
強化学習勉強会・論文紹介(第22回)
by
Sotetsu KOYAMADA(小山田創哲)
23 slides
1.2K views
PDF
Principal Sensitivity Analysis
by
Sotetsu KOYAMADA(小山田創哲)
28 slides
2.2K views
PDF
KDD2015論文読み会
by
Sotetsu KOYAMADA(小山田創哲)
18 slides
1.4K views
PDF
KDD2014勉強会 発表資料
by
Sotetsu KOYAMADA(小山田創哲)
15 slides
3.8K views
PDF
知能型システム論(後半)
by
Sotetsu KOYAMADA(小山田創哲)
33 slides
1.9K views
PDF
EMアルゴリズム
by
Sotetsu KOYAMADA(小山田創哲)
55 slides
79.4K views
【論文紹介】PGQ: Combining Policy Gradient And Q-learning
by
Sotetsu KOYAMADA(小山田創哲)
44 slides
7K views
【強化学習】Montezuma's Revenge @ NIPS2016
by
Sotetsu KOYAMADA(小山田創哲)
34 slides
2.9K views
KDD2016論文読み会資料(DeepIntent)
by
Sotetsu KOYAMADA(小山田創哲)
18 slides
2.3K views
強化学習勉強会・論文紹介(Kulkarni et al., 2016)
by
Sotetsu KOYAMADA(小山田創哲)
18 slides
1.8K views
強化学習勉強会・論文紹介(第22回)
by
Sotetsu KOYAMADA(小山田創哲)
23 slides
1.2K views
Principal Sensitivity Analysis
by
Sotetsu KOYAMADA(小山田創哲)
28 slides
2.2K views
KDD2015論文読み会
by
Sotetsu KOYAMADA(小山田創哲)
18 slides
1.4K views
KDD2014勉強会 発表資料
by
Sotetsu KOYAMADA(小山田創哲)
15 slides
3.8K views
知能型システム論(後半)
by
Sotetsu KOYAMADA(小山田創哲)
33 slides
1.9K views
EMアルゴリズム
by
Sotetsu KOYAMADA(小山田創哲)
55 slides
79.4K views
PRML第3章@京大PRML輪講
1.
第3章 線形回帰モデル @ 京大PRML輪講 システム科学専攻
石井研 M2 小山田 創哲
2.
目次 1. 線形基底関数モデル 1. 最尤推定と最小二乗法 2. 最小二乗法の幾何学 3.
逐次学習 4. 正則化最小二乗法 5. 出力変数が多次元の場合 2. バイアス-バリアンス分解
3.
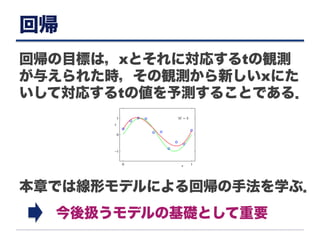
回帰 回帰の目標は,xとそれに対応するtの観測 が与えられた時,その観測から新しいxにた いして対応するtの値を予測することである. 本章では線形モデルによる回帰の手法を学ぶ. 今後扱うモデルの基礎として重要
4.
3.1 線形基底関数モデル
5.
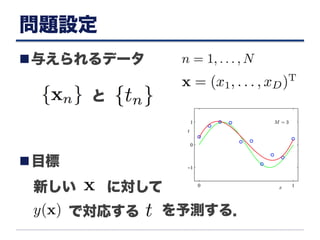
問題設定 n 与えられるデータ n 目標 新しい に対して で対応する を予測する. と
6.
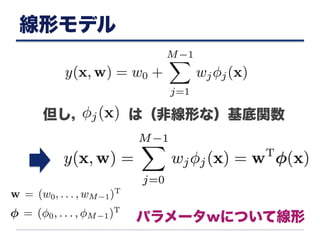
線形モデル 但し, は(非線形な)基底関数 パラメータwについて線形
7.
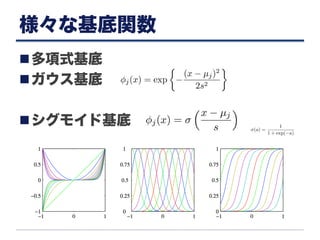
様々な基底関数 n 多項式基底 n ガウス基底 n シグモイド基底
8.
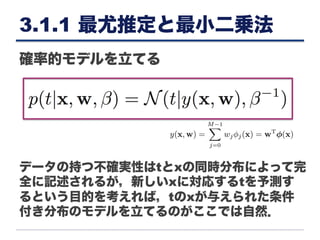
3.1.1 最尤推定と最小二乗法 確率的モデルを立てる データの持つ不確実性はtとxの同時分布によって完 全に記述されるが,新しいxに対応するtを予測す るという目的を考えれば,tのxが与えられた条件 付き分布のモデルを立てるのがここでは自然.
9.
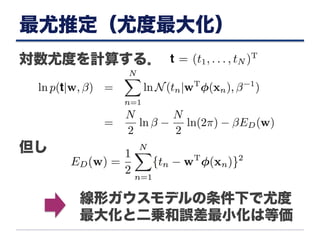
最尤推定(尤度最大化) 対数尤度を計算する. 但し 線形ガウスモデルの条件下で尤度 最大化と二乗和誤差最小化は等価
10.
最尤推定(対数尤度の微分) 対数尤度の勾配を計算し, 0とおいて
11.
最尤推定(結果) 擬似逆行列
12.
3.1.2 最小二乗法の幾何学 Φへの射影 データ点からモデルの張る空間への射影が 最尤推定により定まるモデル (証) Φ^T
(t – 右辺) = 0
13.
より直感的理解 高校生の時にならったこれと実は一緒
14.
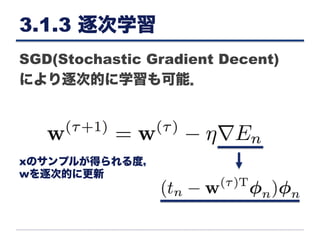
3.1.3 逐次学習 SGD(Stochastic Gradient
Decent) により逐次的に学習も可能. xのサンプルが得られる度, wを逐次的に更新
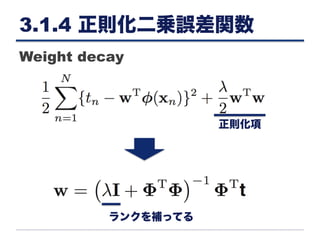
15.
3.1.4 正則化二乗誤差関数 正則化項 ランクを補ってる Weight decay
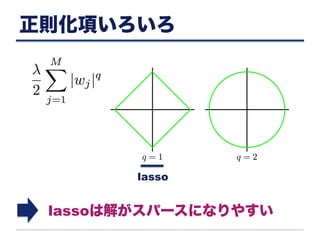
16.
正則化項いろいろ lasso lassoは解がスパースになりやすい
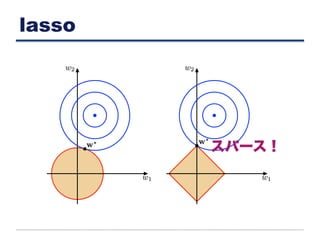
17.
lasso スパース!
18.
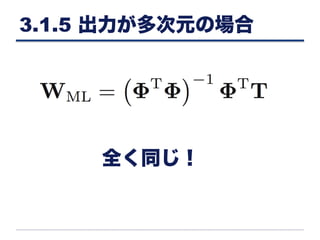
3.1.5 出力が多次元の場合 全く同じ!
19.
3.2 バイアス-バリアンス分解
20.
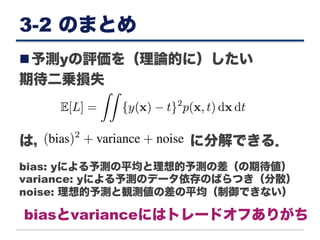
3-2 のまとめ n 予測yの評価を(理論的に)したい 期待二乗損失 は, に分解できる. bias:
yによる予測の平均と理想的予測の差(の期待値) variance: yによる予測のデータ依存のばらつき(分散) noise: 理想的予測と観測値の差の平均(制御できない) biasとvarianceにはトレードオフありがち
21.
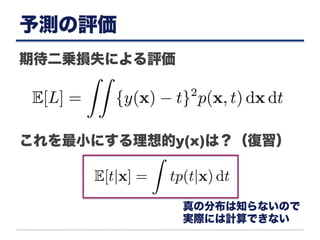
予測の評価 期待二乗損失による評価 これを最小にする理想的y(x)は?(復習) 真の分布は知らないので 実際には計算できない
22.
予測の評価 証明(復習) より =0 で最小
23.
noise 理想的予測をhとおく 期待二乗損失は noise: 理想的予想を しても出てしまう誤差 biasとvarianceに分 解する
24.
biasとvariance データDによってy(x, D)が決まるとする. 第1項の被積分関数 は, Dについて期待値をとって
25.
Bias, variance, noise bias:
yによる予測の平均と理想的予測の差(の期待値) variance: yによる予測のデータ依存のばらつき(分散) noise: 理想的予測と観測値の差の平均(制御できない) biasとvarianceにはトレードオフありがち
26.
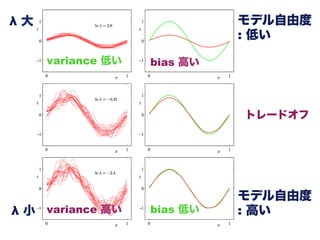
λ 大 λ 小 モデル自由度 :
高い モデル自由度 : 低い bias 高い variance 高い variance 低い bias 低い トレードオフ
27.
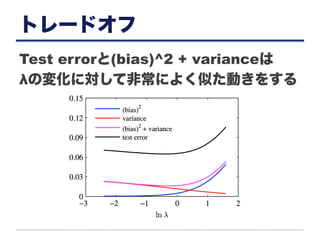
トレードオフ Test errorと(bias)^2 +
varianceは λの変化に対して非常によく似た動きをする
28.
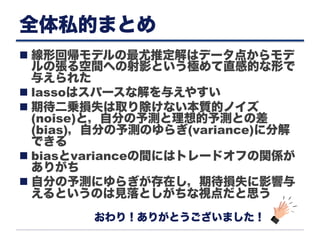
全体私的まとめ n 線形回帰モデルの最尤推定解はデータ点からモデ ルの張る空間への射影という極めて直感的な形で 与えられた n lassoはスパースな解を与えやすい n 期待二乗損失は取り除けない本質的ノイズ (noise)と,自分の予測と理想的予測との差 (bias),自分の予測のゆらぎ(variance)に分解 できる n biasとvarianceの間にはトレードオフの関係が ありがち n 自分の予測にゆらぎが存在し,期待損失に影響与 えるというのは見落としがちな視点だと思う おわり!ありがとうございました!
Editor's Notes
#27
100個のデータセット,それぞれN=25点,M=25,図示しているのは20/100個だけ

 Most read
 Most read
 Most read