Skip to main content
Recommended
PDF
PDF
PPTX
PDF
PRML上巻勉強会 at 東京大学 資料 第2章2.3.3 〜 2.3.6
PPTX
PDF
PDF
2013.12.26 prml勉強会 線形回帰モデル3.2~3.4
PDF
PPTX
PDF
[PRML] パターン認識と機械学習(第2章:確率分布)
PDF
PPTX
パターン認識と機械学習(PRML)第2章 確率分布 2.3 ガウス分布
PDF
PDF
PRML上巻勉強会 at 東京大学 資料 第1章後半
KEY
PDF
PDF
PPTX
PDF
PDF
PDF
PRML上巻勉強会 at 東京大学 資料 第1章前半
PDF
PDF
ガウス過程回帰の導出 ( GPR : Gaussian Process Regression )
PPTX
PDF
PRML復々習レーン#2 2.3.6 - 2.3.7
PPT
PDF
PDF
PDF
PDF
PRML_titech 2.3.1 - 2.3.7
More Related Content
PDF
PDF
PPTX
PDF
PRML上巻勉強会 at 東京大学 資料 第2章2.3.3 〜 2.3.6
PPTX
PDF
PDF
2013.12.26 prml勉強会 線形回帰モデル3.2~3.4
PDF
What's hot
PPTX
PDF
[PRML] パターン認識と機械学習(第2章:確率分布)
PDF
PPTX
パターン認識と機械学習(PRML)第2章 確率分布 2.3 ガウス分布
PDF
PDF
PRML上巻勉強会 at 東京大学 資料 第1章後半
KEY
PDF
PDF
PPTX
PDF
PDF
PDF
PRML上巻勉強会 at 東京大学 資料 第1章前半
PDF
PDF
ガウス過程回帰の導出 ( GPR : Gaussian Process Regression )
PPTX
PDF
PRML復々習レーン#2 2.3.6 - 2.3.7
PPT
PDF
PDF
Similar to Prml 2.3
PDF
PDF
PRML_titech 2.3.1 - 2.3.7
PDF
PPTX
PDF
PDF
PDF
PRML2.3.8~2.5 Slides in charge
PPT
PDF
PDF
PDF
Prml 1.2,4 5,1.3|輪講資料1120
PDF
PDF
PDF
20190721 gaussian process
PDF
PDF
PDF
PDF
PRML輪講用資料10章(パターン認識と機械学習,近似推論法)
PDF
PDF
PRML 10.3, 10.4 (Pattern Recognition and Machine Learning)
Prml 2.3 1. 2. はじめに
2
— この節で言いたいこと
「僕がガウス分布を使うnの理由」
3. ガウス分布(p76-78)
3
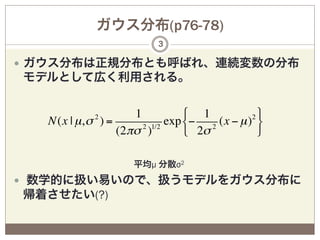
— ガウス分布は正規分布とも呼ばれ、連続変数の分布
モデルとして広く利用される。
2 1 " 1 2%
N(x | µ, σ ) = 2 1/2
exp #− 2 (x − µ ) &
(2πσ ) $ 2σ '
平均µ 分散σ2
— 数学的に扱い易いので、扱うモデルをガウス分布に
帰着させたい(?)
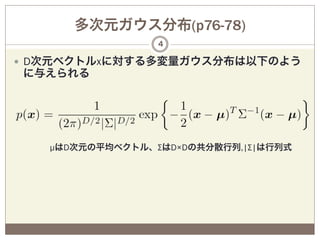
4. 多次元ガウス分布(p76-78)
4
— D次元ベクトルxに対する多変量ガウス分布は以下のよう
に与えられる
µはD次元の平均ベクトル、ΣはD×Dの共分散行列,|Σ|は行列式
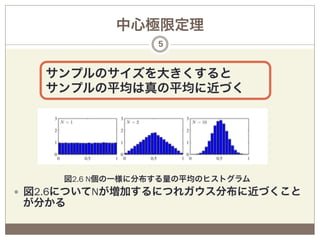
5. 中心極限定理
5
サンプルのサイズを大きくすると
サンプルの平均は真の平均に近づく
図2.6 N個の一様に分布する量の平均のヒストグラム
— 図2.6についてNが増加するにつれガウス分布に近づくこと
が分かる
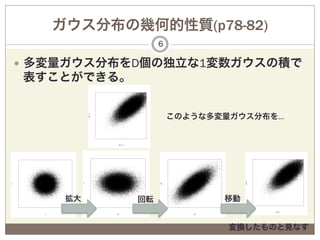
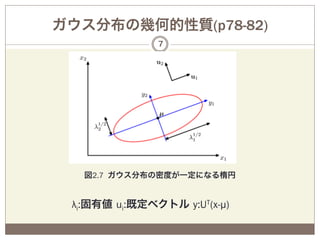
6. ガウス分布の幾何的性質(p78-82)
6
— 多変量ガウス分布をD個の独立な1変数ガウスの積で
表すことができる。
このような多変量ガウス分布を…
y2 + 2
x2 + 2
y2 + 2
y
y2
y
拡大 回転 移動
x2 + 2
x x2 x2
変換したものと見なす
7. 8. ガウス分布の1次モーメント(p80)
8
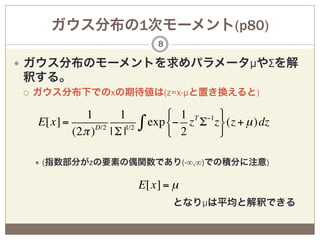
— ガウス分布のモーメントを求めパラメータµやΣを解
釈する。
¡ ガウス分布下でのxの期待値は(z=x-µと置き換えると)
1 1 # 1 T −1 &
E[x] = D/2
(2π ) | Σ |1/2 ∫ exp $− 2 z Σ z' (z + µ )dz
% (
÷ (指数部分がzの要素の偶関数であり(-∞,∞)での積分に注意)
E[x] = µ
となりµは平均と解釈できる
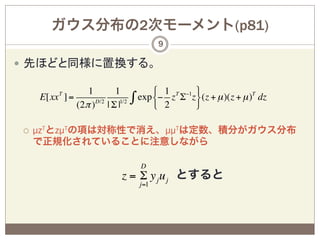
9. ガウス分布の2次モーメント(p81)
9
— 先ほどと同様に置換する。
T 1 1 # 1 T −1 &
E[xx ] = exp $− z Σ z ' (z + µ )(z + µ )T dz
∫ % 2
(2π )D/2 | Σ |1/2 (
¡ µzTとzµTの項は対称性で消え、µµTは定数、積分がガウス分布
で正規化されていることに注意しながら
D
z = Σ y j u j とすると
j=1
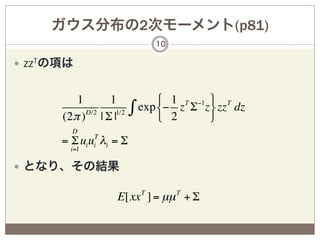
10. ガウス分布の2次モーメント(p81)
10
— zzTの項は
1 1 # 1 T −1 & T
(2π )D/2 | Σ |1/2
∫ exp $− 2 z Σ z' zz dz
% (
D
= Σ ui uiT λi = Σ
i=1
— となり、その結果
E[xx T ] = µµ T + Σ
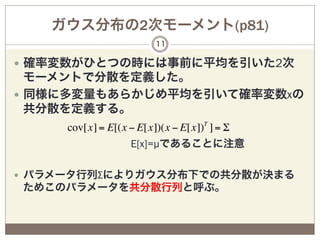
11. ガウス分布の2次モーメント(p81)
11
— 確率変数がひとつの時には事前に平均を引いた2次
モーメントで分散を定義した。
— 同様に多変量もあらかじめ平均を引いて確率変数xの
共分散を定義する。
cov[x] = E[(x − E[x])(x − E[x])T ] = Σ
E[x]=µであることに注意
— パラメータ行列Σによりガウス分布下での共分散が決まる
ためこのパラメータを共分散行列と呼ぶ。
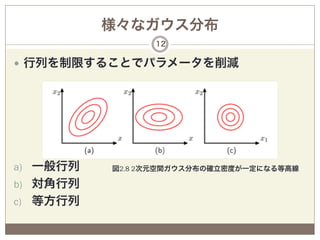
12. 様々なガウス分布
12
— 行列を制限することでパラメータを削減
a) 一般行列 図2.8 2次元空間ガウス分布の確立密度が一定になる等高線
b) 対角行列
c) 等方行列
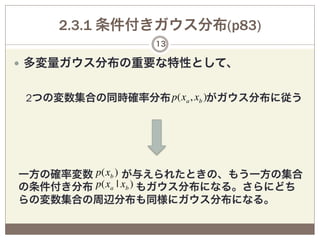
13. 2.3.1 条件付きガウス分布(p83)
13
— 多変量ガウス分布の重要な特性として、
2つの変数集合の同時確率分布 p(xa , xb )がガウス分布に従う
一方の確率変数 p(xb ) が与えられたときの、もう一方の集合
の条件付き分布 p(xa | xb ) もガウス分布になる。さらにどち
らの変数集合の周辺分布も同様にガウス分布になる。
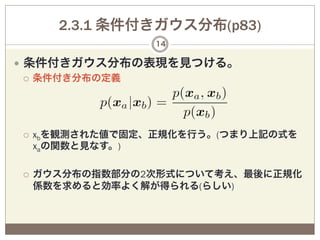
14. 2.3.1 条件付きガウス分布(p83)
14
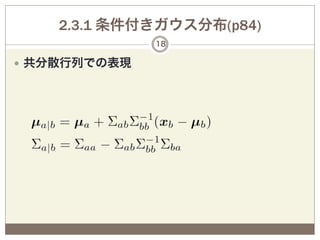
— 条件付きガウス分布の表現を見つける。
¡ 条件付き分布の定義
¡ xbを観測された値で固定、正規化を行う。(つまり上記の式を
xaの関数と見なす。)
¡ ガウス分布の指数部分の2次形式について考え、最後に正規化
係数を求めると効率よく解が得られる(らしい)
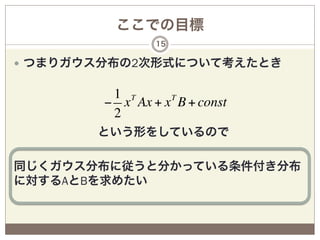
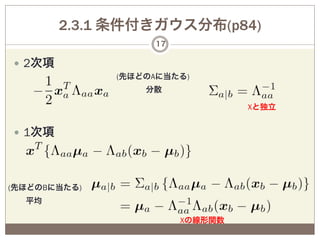
15. ここでの目標
15
— つまりガウス分布の2次形式について考えたとき
1 T
− x Ax + x T B + const
2
という形をしているので
同じくガウス分布に従うと分かっている条件付き分布
に対するAとBを求めたい
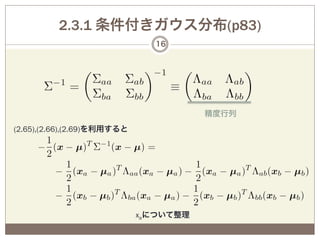
16. 17. 18. 19. 周辺ガウス分布(p86-p87)
19
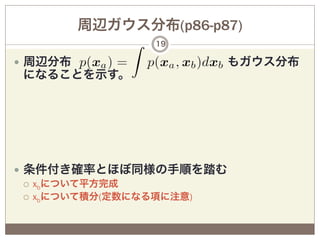
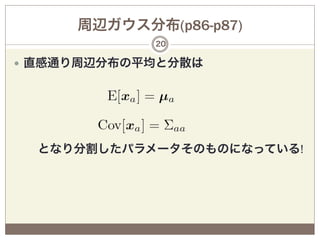
— 周辺分布 もガウス分布
になることを示す。
— 条件付き確率とほぼ同様の手順を踏む
¡ xbについて平方完成
¡ xbについて積分(定数になる項に注意)
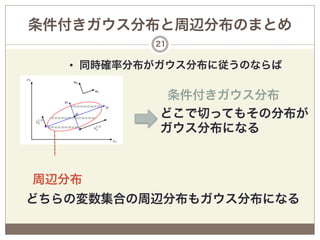
20. 21. 条件付きガウス分布と周辺分布のまとめ
21
• 同時確率分布がガウス分布に従うのならば
条件付きガウス分布
どこで切ってもその分布が
ガウス分布になる
周辺分布
どちらの変数集合の周辺分布もガウス分布になる
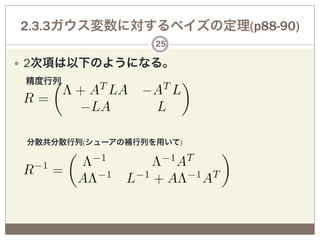
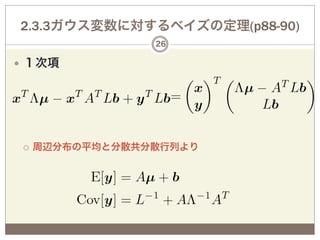
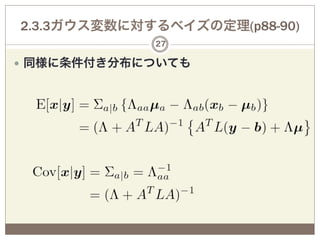
22. 2.3.3ガウス変数に対するベイズの定理(p88-90)
22
— 条件付き分布と周辺分布が与えられたときの同時分
布について考える。
p(y | x), p(x) p(x, y)
— これまでは同時分布が与えられたときの条件付き分
布と周辺確率について考察していた。
p(x, y) p(y | x), p(x)
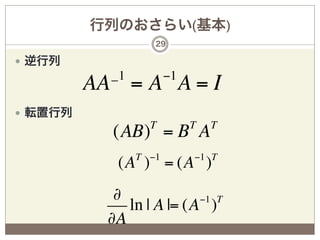
23. 24. 25. 26. 27. 28. 29. 行列のおさらい(基本)
29
— 逆行列
_1 −1
AA = A A = I
— 転置行列
T T T
(AB) = B A
T −1 −1 T
(A ) = (A )
∂ −1 T
ln | A |= (A )
∂A
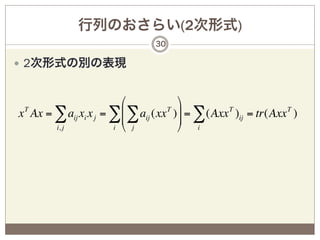
30. 行列のおさらい(2次形式)
30
— 2次形式の別の表現
" %
x Ax = ∑ aij xi x j = ∑$ ∑ aij (xx )' = ∑ (Axx T )ij = tr(Axx T )
T
$
T
'
i, j i # j & i
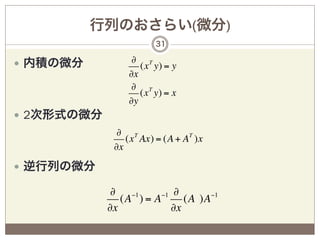
31. 行列のおさらい(微分)
31
— 内積の微分 ∂ T
(x y) = y
∂x
∂ T
(x y) = x
∂y
— 2次形式の微分
∂ T
(x Ax) = (A + AT )x
∂x
— 逆行列の微分
∂ −1 −1 ∂
(A ) = A (A )A −1
∂x ∂x
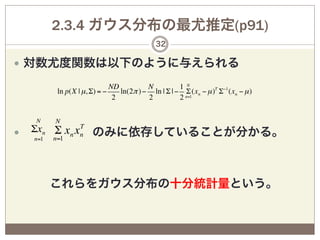
32. 2.3.4 ガウス分布の最尤推定(p91)
32
— 対数尤度関数は以下のように与えられる
ND N 1 N
ln p(X | µ, Σ) = − ln(2π ) − ln | Σ | − Σ (xn − µ )T Σ−1 (xn − µ )
2 2 2 n=1
N N
T
Σxn Σ xn xn のみに依存していることが分かる。
— n=1 n=1
これらをガウス分布の十分統計量という。
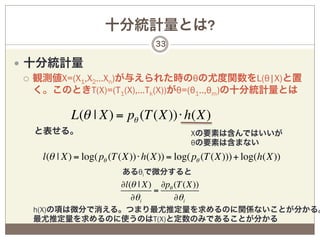
33. 十分統計量とは?
33
— 十分統計量
¡ 観測値X=(X1,X2…Xn)が与えられた時のθの尤度関数をL(θ|X)と置
く。このときT(X)=(T1(X),…Tk(X))がθ=(θ1..,θm)の十分統計量とは
L(θ | X) = pθ (T (X))⋅ h(X)
と表せる。 Xの要素は含んではいいが
θの要素は含まない
l(θ | X) = log( pθ (T (X))⋅ h(X)) = log( pθ (T (X))) + log(h(X))
あるθiで微分すると
∂l(θ | X) ∂pθ (T (X))
=
∂θ i ∂θ i
h(X)の項は微分で消える。つまり最尤推定量を求めるのに関係ないことが分かる。
最尤推定量を求めるのに使うのはT(X)と定数のみであることが分かる
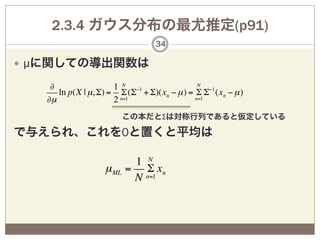
34. 2.3.4 ガウス分布の最尤推定(p91)
34
— µに関しての導出関数は
∂ 1 N −1 N
ln p(X | µ, Σ) = Σ (Σ + Σ)(xn − µ ) = Σ Σ−1 (xn − µ )
∂µ 2 n=1 n=1
この本だとΣは対称行列であると仮定している
で与えられ、これを0と置くと平均は
1 N
µ ML = Σ xn
N n=1
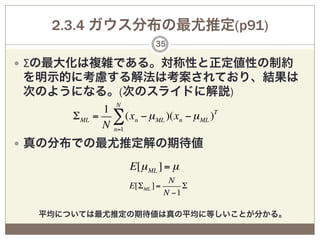
35. 2.3.4 ガウス分布の最尤推定(p91)
35
— Σの最大化は複雑である。対称性と正定値性の制約
を明示的に考慮する解法は考案されており、結果は
次のようになる。(次のスライドに解説)
1 N
Σ ML = ∑ (xn − µ ML )(xn − µ ML )T
N n=1
— 真の分布での最尤推定解の期待値
E[µ ML ] = µ
N
E[Σ ML ] = Σ
N −1
平均については最尤推定の期待値は真の平均に等しいことが分かる。
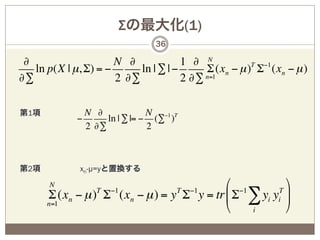
36. Σの最大化(1)
36
∂ N ∂ 1 ∂ N
ln p(X | µ, Σ) = − ln | ∑ | − Σ (xn − µ )T Σ−1 (xn − µ )
∂∑ 2 ∂∑ 2 ∂∑ n=1
第1項 N ∂ N −1 T
− ln | ∑ |= − (∑ )
2 ∂∑ 2
第2項 xn-µ=yと置換する
N $ −1 '
Σ (xn − µ ) Σ (xn − µ ) = y Σ y = tr & Σ ∑ yi yi )
T −1 T −1 T
n=1
% i (
37. Σの最大化(2)
37
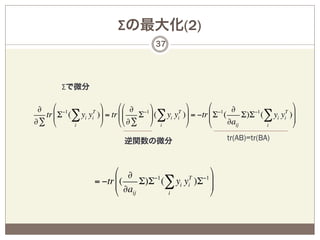
Σで微分
∂ % −1 ( %% ∂ −1 ( ( % ∂ (
tr ' Σ (∑ yi yi )* = tr ''
T
Σ * (∑ yi yi )* = −tr ' Σ (
T
'
−1
Σ)Σ (∑ yi yi )*
−1 T
*
∂∑ & i ) && ∂∑ ) i ) & ∂aij i )
逆関数の微分 tr(AB)=tr(BA)
% ∂ (
' ∂a Σ)Σ (∑ yi yi )Σ *
−1 T −1
= −tr ' ( *
& ij i )
38. Σの最大化(3)
38
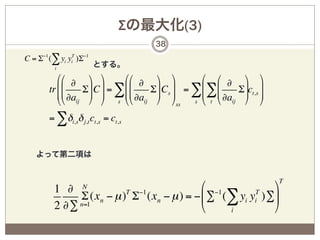
C = Σ−1 (∑ yi yiT )Σ−1
i
とする。
## ∂ & & ## ∂ & & # # ∂ & &
tr %%
%% ∂a Σ ( C ( = ∑%%
( ( %% Σ( Cs ( = ∑% ∑%
( ( % % Σ(ct,s (
( (
$$ ij ' ' s $$ ∂aij ' 'ss s $ t $ ∂aij ' '
= ∑δi,sδ j,t ct,s = ct,s
よって第二項は
T
1 ∂ N % −1 (
Σ (xn − µ ) Σ (xn − µ ) = − ' ∑ (∑ yi yi )∑*
T −1 T
2 ∂∑ n=1 & i )
39. Σの最大化(4)
39
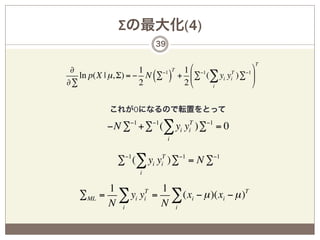
T
∂ 1 −1 T 1 % −1 (
ln p(X | µ, Σ) = − N (∑ ) + ' ∑ (∑ yi yi )∑ *
T −1
∂∑ 2 2& i )
これが0になるので転置をとって
−N ∑−1 +∑−1 (∑ yi yiT )∑−1 = 0
i
∑−1 (∑ yi yiT )∑−1 = N ∑−1
i
1 1
∑ML = ∑ yi yi = ∑ (xi − µ )(xi − µ )T
T
N i N i
40. 2.3.5 逐次推定(p-92-93)
40
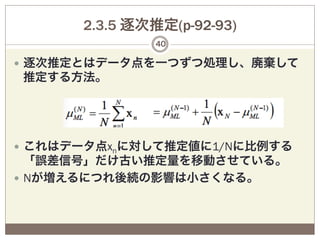
— 逐次推定とはデータ点を一つずつ処理し、廃棄して
推定する方法。
— これはデータ点xnに対して推定値に1/Nに比例する
「誤差信号」だけ古い推定量を移動させている。
— Nが増えるにつれ後続の影響は小さくなる。
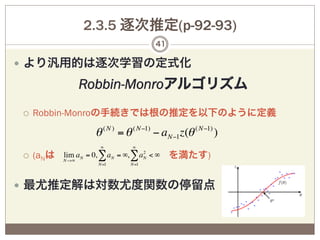
41. 2.3.5 逐次推定(p-92-93)
41
— より汎用的は逐次学習の定式化
Robbin-Monroアルゴリズム
¡ Robbin-Monroの手続きでは根の推定を以下のように定義
θ ( N ) = θ ( N−1) − aN−1z(θ ( N−1) )
∞ ∞
¡ (aNは N −>∞ aN = 0, ∑ aN = ∞, ∑ aN < ∞ を満たす)
lim 2
N=1 N=1
— 最尤推定解は対数尤度関数の停留点
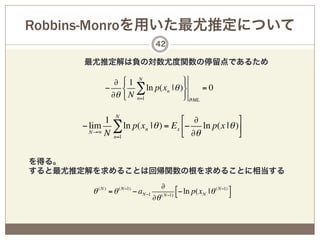
42. Robbins-Monroを用いた最尤推定について
42
最尤推定解は負の対数尤度関数の停留点であるため
∂ "1 N %
− # ∑ ln p(xn | θ )& =0
∂θ $ N n=1 ' ϑ ML
1 N & ∂ )
− lim ∑ ln p(xn | θ ) = E x (− ln p(x | θ )+
N→∞ N ' ∂θ *
n=1
を得る。
すると最尤推定解を求めることは回帰関数の根を求めることに相当する
∂ #− ln p(x N | θ ( N−1) %
θ ( N ) = θ ( N−1) − aN−1 ( N−1) $ &
∂θ
43. 44. 2.3.6 ガウス分布に対するベイズ推論
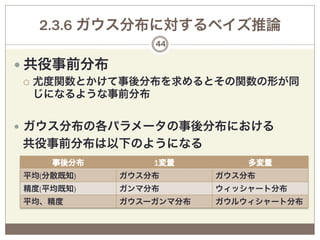
44
— 共役事前分布
¡ 尤度関数とかけて事後分布を求めるとその関数の形が同
じになるような事前分布
— ガウス分布の各パラメータの事後分布における
共役事前分布は以下のようになる
事後分布 1変量 多変量
平均(分散既知) ガウス分布 ガウス分布
精度(平均既知) ガンマ分布 ウィッシャート分布
平均、精度 ガウスーガンマ分布 ガウルウィシャート分布
45. 平均を推定(分散既知)の例
45
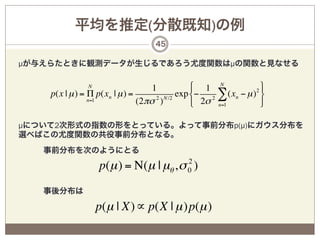
µが与えらたときに観測データが生じるであろう尤度関数はµの関数と見なせる
N
1 $ 1 N '
p(x | µ ) = Π p(xn | µ ) = 2 N /2
exp %− 2 ∑ (xn − µ ) (
2
n=1 (2πσ ) & 2σ n=1 )
µについて2次形式の指数の形をとっている。よって事前分布p(µ)にガウス分布を
選べばこの尤度関数の共役事前分布となる。
事前分布を次のようにとる
2
p(µ ) = Ν(µ | µθ , σ 0 )
事後分布は
p(µ | X) ∝ p(X | µ )p(µ )
46. 平均を推定(分散既知)の例
46
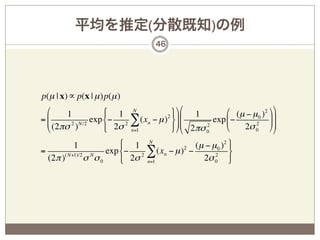
p(µ | x) ∝ p(x | µ )p(µ )
* 1 $ 1 N ' -* 1 * (µ − µ 0 ) 2 - -
, (2πσ 2 ) N /2 exp %− 2σ 2 ∑ (xn − µ ) ( /,
2 ,
=, / exp , − //
+ & n=1
2
) .+ 2πσ 0 + 2σ 0 ./
2
.
1 $ 1 N (µ − µ 0 ) 2 '
= ( N+1)/2 N
exp %− 2 ∑ (xn − µ ) −
2
2
(
(2π ) σ σ0 & 2σ n=1 2σ 0 )
47. 平均を推定(分散既知)の例
47
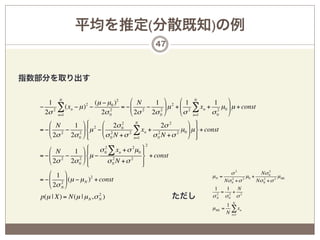
指数部分を取り出す
1 N (µ − µ 0 ) 2 # N 1 & 2 # 1 N 1 &
− 2 ∑ (xn − µ ) −
2
2
= − % 2 − 2 ( µ + % 2 ∑ xn + 2 µ 0 ( µ + const
2σ n=1 2σ 0 $ 2σ 2σ 0 ' $ σ n=1 σ0 '
# N 1 & ) 2 # 2σ 0
+ 2 N
2σ 2 & - +
= − % 2 − 2 ( *µ − % 2
$ 2σ 2σ 0 ' , 2 ∑ xn + σ 2 N + σ 2 µ0 ( µ . + const
+ $ σ 0 N + σ n=1 0 ' / +
2
# N ) σ 0 ∑ xn + σ 2 µ 0 -
2
1 &+ +
= − % 2 − 2 ( *µ − . + const
$ 2σ 2σ 0 ' +
, σ 0 N +σ 2 +
2
/
# 1 & σ2 Nσ 0 2
µN = µ0 + µ ML
= − % 2 ( (µ − µ N )2 + const Nσ 0 + σ 2
2
Nσ 0 + σ 2
2
$ 2σ N ' 1 1 N
= 2+ 2
2
p(µ | X) = N(µ | µ N , σ N ) ただし 2
σN σ0 σ
1 N
µ ML = ∑ xn
N n=1
48. 2.3.7 スチューデントのt分布(p100-103)
48
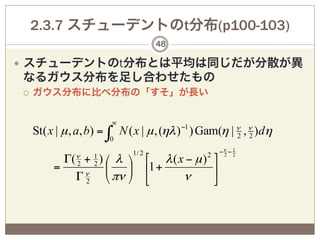
— スチューデントのt分布とは平均は同じだが分散が異
なるガウス分布を足し合わせたもの
¡ ガウス分布に比べ分布の「すそ」が長い
∞
St( x | µ , a, b) = ∫ N ( x | µ , (ηλ ) −1 ) Gam(η | ν , ν )dη
2 2
0
1/ 2 2 −ν − 1
Γ(ν + 1 ) ⎛ λ ⎞ ⎡ λ ( x − µ ) ⎤ 2 2
= 2 ν 2 ⎜ ⎟ ⎢1 + ⎥
Γ 2 ⎝ πν ⎠ ⎣ ν ⎦
49. 2.3.7 スチューデントのt分布(p100-103)
49
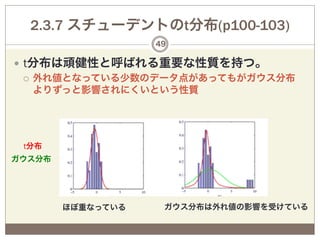
— t分布は頑健性と呼ばれる重要な性質を持つ。
¡ 外れ値となっている少数のデータ点があってもがガウス分布
よりずっと影響されにくいという性質
t分布
ガウス分布
ほぼ重なっている ガウス分布は外れ値の影響を受けている
50. 2.3.8 周期変数
50
— ガウス分布に対して周期変数を導入する。
¡ 例
÷ 24時間や1年といった時間的周期を持つもののモデル化に便利
— 単純にある方向に原点を選んだ周期関数を使ってガ
ウス分布を適用するだけではうまくいかない
¡ 特別な方法が必要
51. 2.3.8 周期変数
51
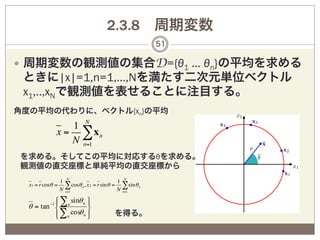
— 周期変数の観測値の集合D={θ1 … θn}の平均を求める
ときに|x|=1,n=1,…,Nを満たす二次元単位ベクトル
x1,..,xNで観測値を表せることに注目する。
角度の平均の代わりに、ベクトル{xn}の平均
1 N
x = ∑xn
N n=1
を求める。そしてこの平均に対応するθを求める。
観測値の直交座標と単純平均の直交座標から
1 N 1 N
x1 = r cosθ = ∑
N n=1
cosθ n , x 2 = r sin θ = ∑ sin θ n
N n=1
⎧ ∑n sinθ n ⎫
⎪
−1 ⎪
θ = tan ⎨ ⎬
⎪ ∑n cosθ n ⎪
⎩ ⎭ を得る。
52. 周期変数(フォン・ミーゼス分布)
52
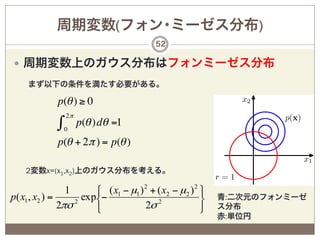
— 周期変数上のガウス分布はフォンミーゼス分布
まず以下の条件を満たす必要がある。
p(θ ) ≥ 0
2π
∫ 0
p(θ )dθ =1
p(θ + 2π ) = p(θ )
2変数x=(x1,x2)上のガウス分布を考える。
1 ⎧ ( x1 − µ1 ) 2 + ( x2 − µ2 ) 2 ⎫
p( x1 , x2 ) = 2
exp⎨− 2 ⎬ 青:二次元のフォンミーゼ
2πσ ⎩ 2σ ⎭ ス分布
赤:単位円
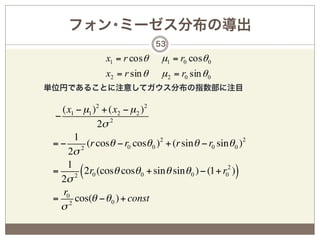
53. フォン・ミーゼス分布の導出
53
x1 = r cosθ µ1 = r0 cosθ 0
x2 = r sin θ µ 2 = r0 sin θ 0
単位円であることに注意してガウス分布の指数部に注目
(x1 − µ1 )2 + (x2 − µ 2 )2
−
2σ 2
1
= − 2 (r cosθ − r0 cosθ 0 )2 + (r sin θ − r0 sin θ 0 )2
2σ
1
=
2σ 2
(2r0 (cosθ cosθ0 + sinθ sinθ0 ) − (1+ r02 ))
r0
= 2 cos(θ − θ 0 ) + const
σ
54. フォン・ミーゼス分布の導出
54
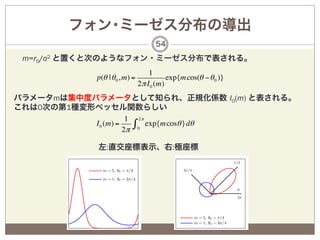
m=r0/σ2 と置くと次のようなフォン・ミーゼス分布で表される。
1
p(θ | θ 0 , m) = exp{m cos(θ − θ 0 )}
2π I 0 (m)
パラメータmは集中度パラメータとして知られ、正規化係数 I0(m) と表される。
これは0次の第1種変形ベッセル関数らしい
1 2π
I 0 (m) =
2π
∫ 0 exp{m cosθ }dθ
左:直交座標表示、右:極座標
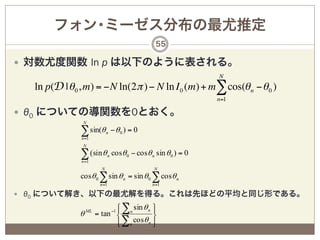
55. フォン・ミーゼス分布の最尤推定
55
— 対数尤度関数 ln p は以下のように表される。
N
ln p(D | θ 0 , m) = −N ln(2π ) − N ln I 0 (m) + m∑ cos(θ n − θ 0 )
n=1
— θ0 についての導関数を0とおく。
N
∑ sin(θ
n =1
n − θ0 ) = 0
N
∑ (sin θ
n =1
n cosθ 0 − cosθ n sin θ 0 ) = 0
N N
cosθ 0 ∑ sin θ n = sin θ 0 ∑ cosθ n
n =1 n =1
— θ0 について解き、以下の最尤解を得る。これは先ほどの平均と同じ形である。
ML
⎧ ∑n sin θ n ⎫
⎪ −1 ⎪
θ = tan ⎨ ⎬
⎪ ∑n cosθ n ⎪
⎩ ⎭
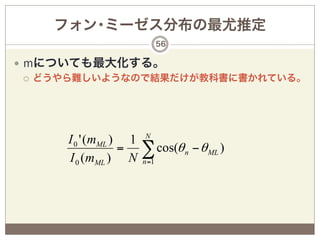
56. フォン・ミーゼス分布の最尤推定
56
— mについても最大化する。
¡ どうやら難しいようなので結果だけが教科書に書かれている。
N
I 0 ' (mML ) 1
I 0 (mML ) N
= ∑ cos(θ
n =1
n − θ ML )
57. 2.3.9 混合ガウス分布
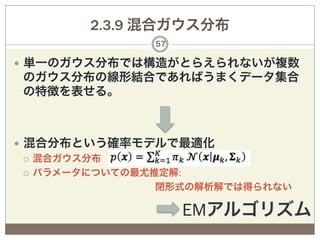
57
— 単一のガウス分布では構造がとらえられないが複数
のガウス分布の線形結合であればうまくデータ集合
の特徴を表せる。
— 混合分布という確率モデルで最適化
¡ 混合ガウス分布
¡ パラメータについての最尤推定解:
閉形式の解析解では得られない
EMアルゴリズム

 Most read
 Most read
 Most read