PRML読み会#1
2015/8/7 三木
目次
• PRMLの概要
• 第一章の概要
• 第一章
– 多項式曲線フィッティング(回帰)
– 確率論
– モデル選択
– 次元の呪い
– 決定理論
– 情報理論
2
PRML概要
• 少し古いが主要な手法が載っている
– 確率分布、線形回帰、線形識別、NN、カーネル法、
SVM、グラフィカルモデル、EMアルゴリズム、変分
ベイズ法、モンテカルロ法、次元削減、隠れマルコ
フモデル、アンサンブル
• 色々な所で読まれているのでWEBに情報たくさ
ん
• 「ベイズ理論による統計的予測」とあるが最尤
法も載っている
• ちょっと高い(上下合わせて1.5万)
3
第一章の概要
• 機械学習の用語を説明
• 確率論、決定理論、情報理論の基礎
4
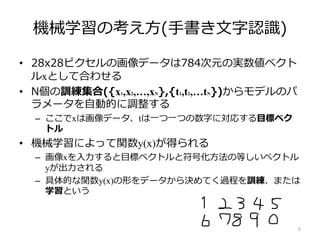
機械学習の考え方(手書き文字認識)
5
• 28x28ピクセルの画像データは784次元の実数値ベクト
ルxとして合わせる
• N個の訓練集合({x1,x2,…,xN},{t1,t2,…tN})からモデルのパ
ラメータを自動的に調整する
– ここでxは画像データ、tは一つ一つの数字に対応する目標ベク
トル
• 機械学習によって関数y(x)が得られる
– 画像xを入力すると目標ベクトルと符号化方法の等しいベクトル
yが出力される
– 具体的な関数y(x)の形をデータから決めてく過程を訓練、または
学習という
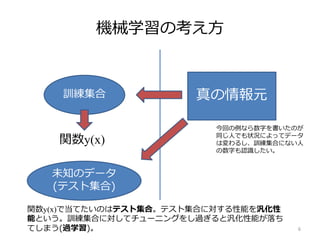
機械学習の考え方
6
真の情報元訓練集合
関数y(x)
未知のデータ
(テスト集合)
関数y(x)で当てたいのはテスト集合。テスト集合に対する性能を汎化性
能という。訓練集合に対してチューニングをし過ぎると汎化性能が落ち
てしまう(過学習)。
今回の例なら数字を書いたのが
同じ人でも状況によってデータ
は変わるし、訓練集合にない人
の数字も認識したい。
機械学習の考え方
• 応用ではほとんどの場合、前処理・特徴抽出が
行われる
– 文字認識なら回転・拡大縮小・並行移動・二値化し
て固定した枠に収まるようにし、文字を書いた状
況・人による多様性を減らす
– 性能を上げるためだけでなく、高速化のために行わ
れることもある
– ちなみにDeepLearnigは特徴抽出の自動化を行って
いる(と解釈してます)
7
機械学習の考え方
• 訓練データが入力ベクトルとそれに対応する目
標ベクトルで構成される問題(関数を獲得する)
は教師あり学習という
• 数字認識のような離散カテゴリに当てはめるクラス分類
• 連続変数を予測する回帰
• 訓練データが入力ベクトルのみで目標値が存在
しない問題を教師なし学習という
• 類似したグループに分類するクラスタリング
• 入力データの分布を求める密度推定
• 強化学習は省略(ABテスト周りの話はこの辺)
8
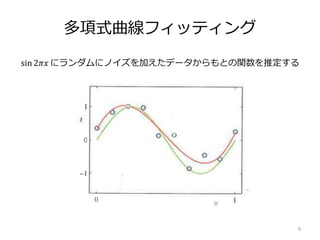
多項式曲線フィッティング
sin 2𝜋𝑥 にランダムにノイズを加えたデータからもとの関数を推定する
9
多項式曲線フィッティング
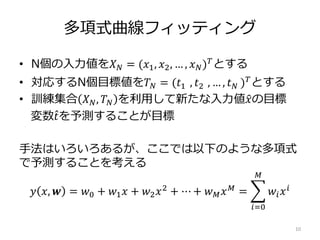
• N個の入力値を𝑋 𝑁 = (𝑥1, 𝑥2, … , 𝑥 𝑁) 𝑇
とする
• 対応するN個目標値を𝑇 𝑁 = (𝑡1 , 𝑡2 , … , 𝑡 𝑁 ) 𝑇とする
• 訓練集合 𝑋 𝑁, 𝑇 𝑁 を利用して新たな入力値 𝑥の目標
変数 𝑡を予測することが目標
手法はいろいろあるが、ここでは以下のような多項式
で予測することを考える
𝑦 𝑥, 𝒘 = 𝑤0 + 𝑤1 𝑥 + 𝑤2 𝑥2 + ⋯ + 𝑤 𝑀 𝑥 𝑀 =
𝑖=0
𝑀
𝑤𝑖 𝑥 𝑖
10
多項式曲線フィッティング
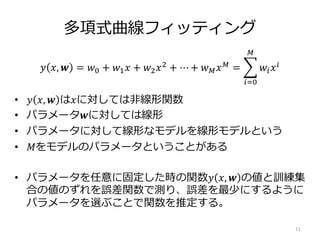
• 𝑦 𝑥, 𝒘 は𝑥に対しては非線形関数
• パラメータ𝒘に対しては線形
• パラメータに対して線形なモデルを線形モデルという
• 𝑀をモデルのパラメータということがある
• パラメータを任意に固定した時の関数𝑦 𝑥, 𝒘 の値と訓練集
合の値のずれを誤差関数で測り、誤差を最少にするように
パラメータを選ぶことで関数を推定する。
11
𝑦 𝑥, 𝒘 = 𝑤0 + 𝑤1 𝑥 + 𝑤2 𝑥2 + ⋯ + 𝑤 𝑀 𝑥 𝑀 =
𝑖=0
𝑀
𝑤𝑖 𝑥 𝑖
多項式曲線フィッティング
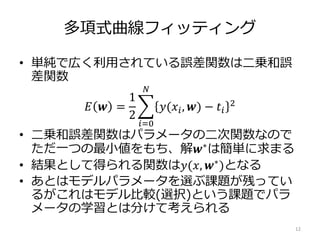
• 単純で広く利用されている誤差関数は二乗和誤
差関数
𝐸 𝒘 =
1
2
𝑖=0
𝑁
𝑦(𝑥𝑖, 𝒘) − 𝑡𝑖
2
• 二乗和誤差関数はパラメータの二次関数なので
ただ一つの最小値をもち、解𝒘∗は簡単に求まる
• 結果として得られる関数は𝑦(𝑥, 𝒘∗
)となる
• あとはモデルパラメータを選ぶ課題が残ってい
るがこれはモデル比較(選択)という課題でパラ
メータの学習とは分けて考えられる
12
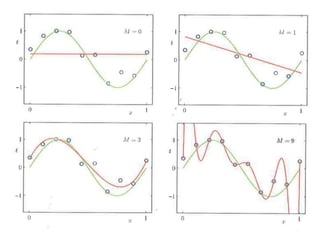
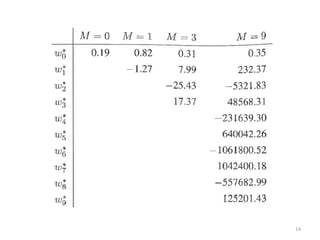
13
14
多項式曲線フィッティング
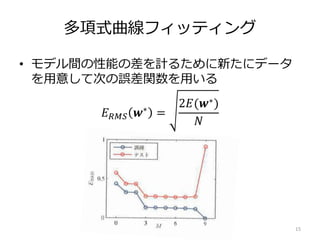
• モデル間の性能の差を計るために新たにデータ
を用意して次の誤差関数を用いる
𝐸 𝑅𝑀𝑆 𝒘∗ =
2𝐸(𝒘∗)
𝑁
15
多項式曲線フィッティング
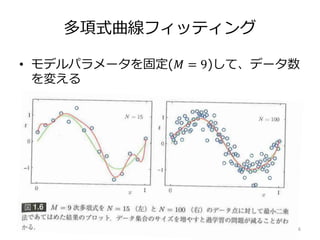
• モデルパラメータを固定(𝑀 = 9)して、データ数
を変える
16
多項式曲線フィッティング
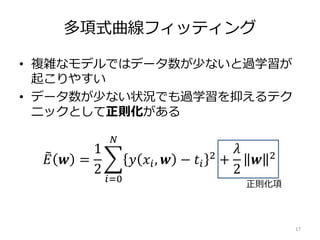
• 複雑なモデルではデータ数が少ないと過学習が
起こりやすい
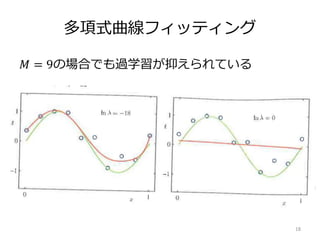
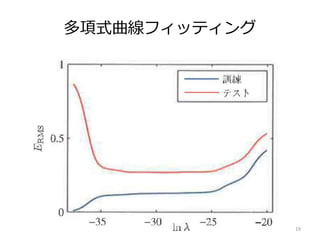
• データ数が少ない状況でも過学習を抑えるテク
ニックとして正則化がある
17
𝐸 𝒘 =
1
2
𝑖=0
𝑁
𝑦 𝑥𝑖, 𝒘 − 𝑡𝑖
2
+
𝜆
2
𝒘 2
正則化項
多項式曲線フィッティング
𝑀 = 9の場合でも過学習が抑えられている
18
多項式曲線フィッティング
19
確率論
20
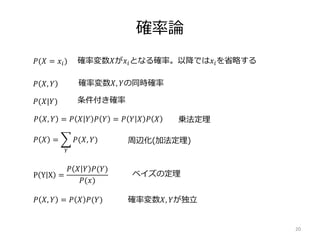
𝑃(𝑋 = 𝑥𝑖)
𝑃 𝑋, 𝑌
𝑃(𝑋|𝑌)
𝑃 𝑋 =
𝑌
𝑃(𝑋, 𝑌)
𝑃 𝑋, 𝑌 = 𝑃 𝑋 𝑌 𝑃 𝑌 = 𝑃 𝑌 𝑋 𝑃 𝑋
P Y X =
𝑃 𝑋 𝑌 𝑃(𝑌)
𝑃(𝑥)
確率変数𝑋が𝑥𝑖となる確率。以降では𝑥𝑖を省略する
確率変数𝑋, 𝑌の同時確率
乗法定理
条件付き確率
周辺化(加法定理)
ベイズの定理
𝑃 𝑋, 𝑌 = 𝑃 𝑋 𝑃(𝑌) 確率変数𝑋, 𝑌が独立
確率論
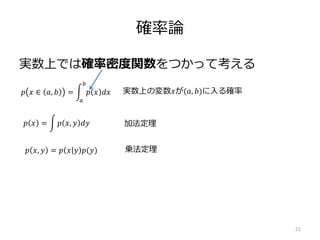
実数上では確率密度関数をつかって考える
21
𝑝 𝑥 ∈ 𝑎, 𝑏 =
𝑎
𝑏
𝑝 𝑥 𝑑𝑥 実数上の変数𝑥が(𝑎, 𝑏)に入る確率
𝑝 𝑥 = 𝑝 𝑥, 𝑦 𝑑𝑦 加法定理
𝑝 𝑥, 𝑦 = 𝑝 𝑥 𝑦 𝑝(𝑦) 乗法定理
期待値と分散
22
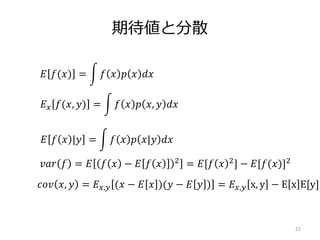
𝐸 𝑓(𝑥) = 𝑓 𝑥 𝑝 𝑥 𝑑𝑥
𝐸 𝑥 𝑓(𝑥, 𝑦) = 𝑓 𝑥 𝑝 𝑥, 𝑦 𝑑𝑥
𝐸 𝑓 𝑥 |𝑦 = 𝑓 𝑥 𝑝 𝑥|𝑦 𝑑𝑥
𝑣𝑎𝑟 𝑓 = 𝐸 𝑓 𝑥 − 𝐸 𝑓 𝑥 2 = 𝐸[𝑓 𝑥 2] − 𝐸[𝑓(𝑥)]2
𝑐𝑜𝑣 𝑥, 𝑦 = 𝐸 𝑥,𝑦 (𝑥 − 𝐸 𝑥 )(𝑦 − 𝐸 𝑦 ) = 𝐸 𝑥,𝑦 x, y − E x E[y]
ベイズ確率
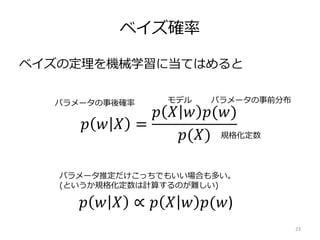
ベイズの定理を機械学習に当てはめると
23
𝑝 𝑤 𝑋 =
𝑝 𝑋 𝑤 𝑝(𝑤)
𝑝(𝑋)
𝑝 𝑤 𝑋 ∝ 𝑝 𝑋 𝑤 𝑝(𝑤)
パラメータの事後確率 モデル パラメータの事前分布
規格化定数
パラメータ推定だけこっちでもいい場合も多い。
(というか規格化定数は計算するのが難しい)
最尤推定
24
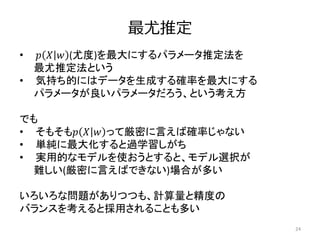
• 𝑝 𝑋 𝑤 (尤度)を最大にするパラメータ推定法を
最尤推定法という
• 気持ち的にはデータを生成する確率を最大にする
パラメータが良いパラメータだろう、という考え方
でも
• そもそも𝑝 𝑋 𝑤 って厳密に言えば確率じゃない
• 単純に最大化すると過学習しがち
• 実用的なモデルを使おうとすると、モデル選択が
難しい(厳密に言えばできない)場合が多い
いろいろな問題がありつつも、計算量と精度の
バランスを考えると採用されることも多い
正規分布での最尤推定
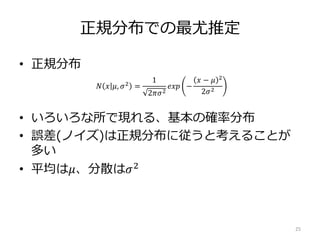
• 正規分布
• いろいろな所で現れる、基本の確率分布
• 誤差(ノイズ)は正規分布に従うと考えることが
多い
• 平均は𝜇、分散は𝜎2
25
𝑁 𝑥 𝜇, 𝜎2
=
1
2𝜋𝜎2
𝑒𝑥𝑝 −
𝑥 − 𝜇 2
2𝜎2
正規分布での最尤推定
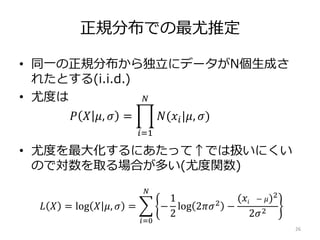
• 同一の正規分布から独立にデータがN個生成さ
れたとする(i.i.d.)
• 尤度は
• 尤度を最大化するにあたって↑では扱いにくい
ので対数を取る場合が多い(尤度関数)
26
𝑃 𝑋 𝜇, 𝜎 =
𝑖=1
𝑁
𝑁(𝑥𝑖|𝜇, 𝜎)
𝐿 𝑋 = log 𝑋 𝜇, 𝜎 =
𝑖=0
𝑁
−
1
2
log 2𝜋𝜎2
−
(𝑥𝑖 − 𝜇)2
2𝜎2
正規分布での最尤推定
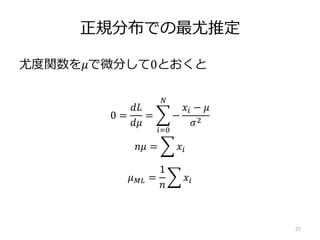
尤度関数を𝜇で微分して0とおくと
27
0 =
𝑑𝐿
𝑑𝜇
=
𝑖=0
𝑁
−
𝑥𝑖 − 𝜇
𝜎2
𝑛𝜇 = 𝑥𝑖
𝜇 𝑀𝐿 =
1
𝑛
𝑥𝑖
正規分布での最尤推定
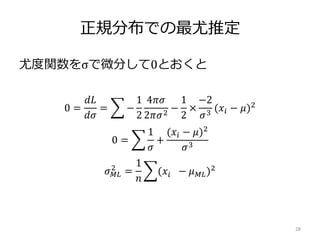
尤度関数をσで微分して0とおくと
28
0 =
𝑑𝐿
𝑑𝜎
= −
1
2
4𝜋𝜎
2𝜋𝜎2
−
1
2
×
−2
𝜎3
(𝑥𝑖 − 𝜇)2
0 =
1
𝜎
+
(𝑥𝑖 − 𝜇)2
𝜎3
𝜎 𝑀𝐿
2
=
1
𝑛
(𝑥𝑖 − 𝜇 𝑀𝐿)2
正規分布での最尤推定
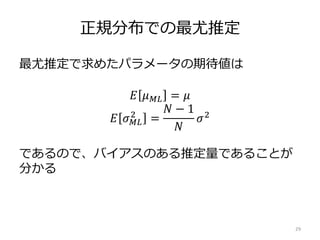
最尤推定で求めたパラメータの期待値は
であるので、バイアスのある推定量であることが
分かる
29
𝐸 𝜇 𝑀𝐿 = 𝜇
𝐸 𝜎 𝑀𝐿
2
=
𝑁 − 1
𝑁
𝜎2
多項式曲線フィッティング
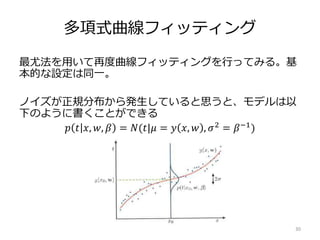
最尤法を用いて再度曲線フィッティングを行ってみる。基
本的な設定は同一。
ノイズが正規分布から発生していると思うと、モデルは以
下のように書くことができる
30
𝑝 𝑡 𝑥, 𝑤, 𝛽 = 𝑁(𝑡|𝜇 = 𝑦 𝑥, 𝑤 , 𝜎2 = 𝛽−1)
多項式曲線フィッティング
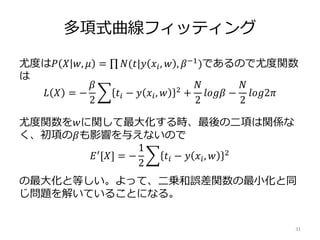
尤度は𝑃 𝑋 𝑤, 𝜇 = 𝑁(𝑡|𝑦 𝑥𝑖, 𝑤 , 𝛽−1)であるので尤度関数
は
尤度関数を𝑤に関して最大化する時、最後の二項は関係な
く、初項の𝛽も影響を与えないので
の最大化と等しい。よって、二乗和誤差関数の最小化と同
じ問題を解いていることになる。
31
𝐿 𝑋 = −
𝛽
2
𝑡𝑖 − 𝑦 𝑥𝑖, 𝑤 2 +
𝑁
2
𝑙𝑜𝑔𝛽 −
𝑁
2
𝑙𝑜𝑔2𝜋
𝐸′[𝑋] = −
1
2
𝑡𝑖 − 𝑦 𝑥𝑖, 𝑤 2
多項式曲線フィッティング
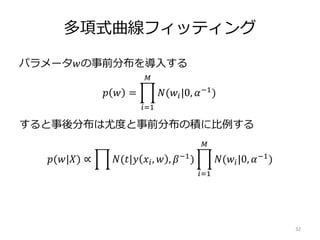
パラメータ𝑤の事前分布を導入する
すると事後分布は尤度と事前分布の積に比例する
32
𝑝 𝑤 =
𝑖=1
𝑀
𝑁(𝑤𝑖|0, 𝛼−1)
𝑝(𝑤|𝑋) ∝ 𝑁(𝑡|𝑦 𝑥𝑖, 𝑤 , 𝛽−1
)
𝑖=1
𝑀
𝑁(𝑤𝑖|0, 𝛼−1
)
多項式曲線フィッティング
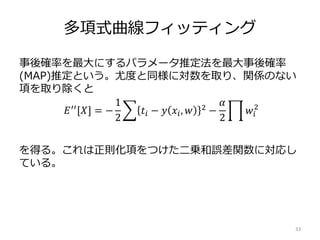
事後確率を最大にするパラメータ推定法を最大事後確率
(MAP)推定という。尤度と同様に対数を取り、関係のない
項を取り除くと
を得る。これは正則化項をつけた二乗和誤差関数に対応し
ている。
33
𝐸′′
[𝑋] = −
1
2
𝑡𝑖 − 𝑦 𝑥𝑖, 𝑤 2
−
𝛼
2
𝑤𝑖
2
モデル選択
• 新たなデータに対する性能(汎化性能)を上げた
い
• 複雑なモデルを選べば訓練集合に対する誤差は
いくらでも0に近づけるが、汎化性能が上がると
は限らない
• どうにかして新たなデータに対する誤差を推定
して、適切なモデルを選びたい
34
交差確認(クロスバリデーション)
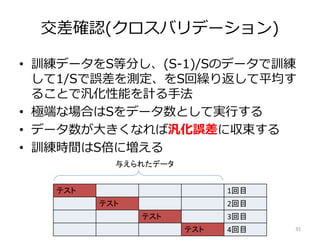
• 訓練データをS等分し、(S-1)/Sのデータで訓練
して1/Sで誤差を測定、をS回繰り返して平均す
ることで汎化性能を計る手法
• 極端な場合はSをデータ数として実行する
• データ数が大きくなれば汎化誤差に収束する
• 訓練時間はS倍に増える
35
テスト 1回目
テスト 2回目
テスト 3回目
テスト 4回目
与えられたデータ
情報量規準
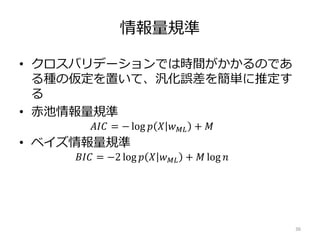
• クロスバリデーションでは時間がかかるのであ
る種の仮定を置いて、汎化誤差を簡単に推定す
る
• 赤池情報量規準
𝐴𝐼𝐶 = − log 𝑝 𝑋 𝑤 𝑀𝐿 + 𝑀
• ベイズ情報量規準
𝐵𝐼𝐶 = −2 log 𝑝 𝑋 𝑤 𝑀𝐿 + 𝑀 log 𝑛
36
決定理論
• 入力𝑥に対応する目標変数𝑡の同時分布𝑝(𝑥, 𝑡)は
事後分布などの各分布が得られるので、これら
の変数に関する不確実性を説明している
• 同時分布𝑝(𝑥, 𝑡)をデータから決めるのを推論と
いう(一般に難しい)
• 実際の応用では目標変数を予測したり、目標変
数が取る値に応じて特定の行動をとることが多
い
• 同時分布を用いて、ある基準のもとで最適な行
動を決定したい
37
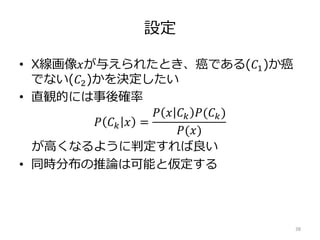
設定
• X線画像𝑥が与えられたとき、癌である(𝐶1)か癌
でない(𝐶2)かを決定したい
• 直観的には事後確率
𝑃 𝐶 𝑘 𝑥 =
𝑃 𝑥 𝐶 𝑘 𝑃(𝐶 𝑘)
𝑃(𝑥)
が高くなるように判定すれば良い
• 同時分布の推論は可能と仮定する
38
誤識別率の最小化
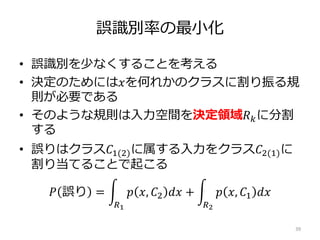
• 誤識別を少なくすることを考える
• 決定のためには𝑥を何れかのクラスに割り振る規
則が必要である
• そのような規則は入力空間を決定領域𝑅 𝑘に分割
する
• 誤りはクラス𝐶1(2)に属する入力をクラス𝐶2(1)に
割り当てることで起こる
𝑃 誤り =
𝑅1
𝑝 𝑥, 𝐶2 𝑑𝑥 +
𝑅2
𝑝 𝑥, 𝐶1 𝑑𝑥
39
期待損失の最小化
• 多くの応用では単に誤識別の数を減らすよりも
目的が複雑になる
• 癌の判定で言えば
– 癌でないのに癌と判定する
– 癌なのに癌でないと判定する
を比べると明らかに前者を増やしてでも後者の
誤りを減らすべき
• このような問題は損失関数を導入することで定
式化できる
40
期待損失の最小化
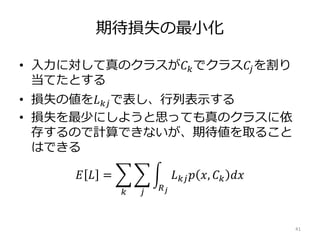
• 入力に対して真のクラスが𝐶 𝑘でクラス𝐶𝑗を割り
当てたとする
• 損失の値を𝐿 𝑘𝑗で表し、行列表示する
• 損失を最少にしようと思っても真のクラスに依
存するので計算できないが、期待値を取ること
はできる
𝐸 𝐿 =
𝑘 𝑗 𝑅 𝑗
𝐿 𝑘𝑗 𝑝 𝑥, 𝐶 𝑘 𝑑𝑥
41
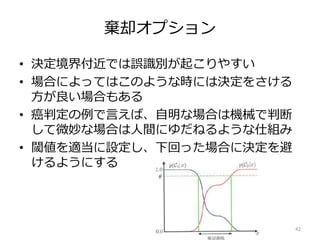
棄却オプション
• 決定境界付近では誤識別が起こりやすい
• 場合によってはこのような時には決定をさける
方が良い場合もある
• 癌判定の例で言えば、自明な場合は機械で判断
して微妙な場合は人間にゆだねるような仕組み
• 閾値を適当に設定し、下回った場合に決定を避
けるようにする
42
決定と推論
• まずモデル𝑝(𝑥|𝐶 𝑘)と事前確率を推論し、事後確
率を求めて決定を行うアプローチを生成モデル
という
• 事後確率を直接モデル化して推論し、決定を行
うアプローチを識別モデルという
• 推論から決定までのプロセスをまるごとモデル
化して入力から決定を行う関数を識別関数とい
う
43
回帰のための損失関数
• 真の値𝑡の推定値𝑦(𝑥)の損失は𝐿(𝑡, 𝑦 𝑥 )であると
すると期待損失は
𝐸 𝐿 = 𝐿 𝑡, 𝑦 𝑥 𝑝 𝑥, 𝑡 𝑑𝑥𝑑𝑡
となる
• 回帰で良く使われるのは二乗誤差
𝐿 𝑡, 𝑦 𝑥 = 𝑦 𝑥 − 𝑡 2
44
情報理論
• 明示的に使うことはあまりないが、手法の構築
や誤差の評価など機械学習の基礎をなす
• 情報量
• エントロピー
• KLダイバージェンス
45
情報量とエントロピー
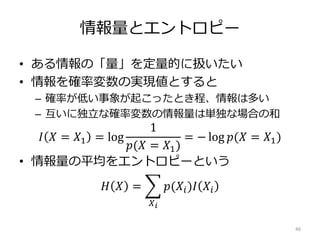
• ある情報の「量」を定量的に扱いたい
• 情報を確率変数の実現値とすると
– 確率が低い事象が起こったとき程、情報は多い
– 互いに独立な確率変数の情報量は単独な場合の和
𝐼 𝑋 = 𝑋1 = log
1
𝑝(𝑋 = 𝑋1)
= − log 𝑝(𝑋 = 𝑋1)
• 情報量の平均をエントロピーという
𝐻 𝑋 =
𝑋 𝑖
𝑝(𝑋𝑖)𝐼 𝑋𝑖
46
KLダイバージェンス
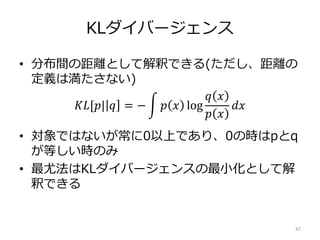
• 分布間の距離として解釈できる(ただし、距離の
定義は満たさない)
𝐾𝐿[𝑝| 𝑞 = − 𝑝 𝑥 log
𝑞 𝑥
𝑝 𝑥
𝑑𝑥
• 対象ではないが常に0以上であり、0の時はpとq
が等しい時のみ
• 最尤法はKLダイバージェンスの最小化として解
釈できる
47