More Related Content
What's hot

PDF

PDF

PDF

PDF

PDF

PDF

PDF

PDF

PDF

PPTX

PPTX

PDF

PPTX

PPTX

PDF

PPTX

PDF
[PRML] パターン認識と機械学習(第1章:序論) 
PDF
[PRML] パターン認識と機械学習(第3章:線形回帰モデル) 
PDF

PDF
Viewers also liked

PDF

PDF

PDF

PPTX

PDF

PDF
計算論的学習理論入門 -PAC学習とかVC次元とか- 
PDF

PDF

PDF

PDF

PPTX
Similar to PRMLrevenge 4.4

PDF
PRML上巻勉強会 at 東京大学 資料 第4章4.3.1 〜 4.5.2 
PPTX

PDF
Prml4.4 ラプラス近似~ベイズロジスティック回帰 
PDF

PDF

PDF

PDF
[DL輪読会]Scalable Training of Inference Networks for Gaussian-Process Models 
PPTX

PDF

PDF

PDF

PDF
PRML輪講用資料10章(パターン認識と機械学習,近似推論法) 
PDF

PDF

PDF

PDF

PDF

PDF

PDF
ML: Sparse regression CH.13 
PDF
PRMLrevenge 4.4
- 1.
- 2.
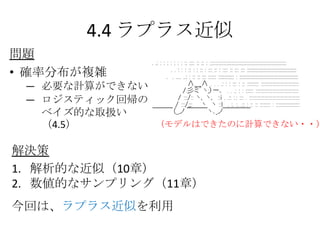
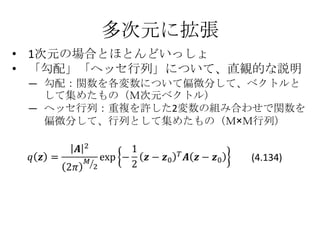
4.4 ラプラス近似
問題
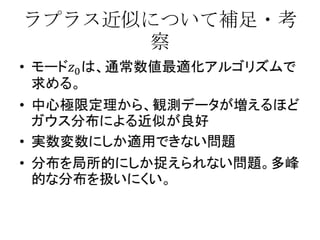
• 確率分布が複雑
― 必要な計算ができない
— ロジスティック回帰の
ベイズ的な取扱い
(4.5) (モデルはできたのに計算できない・・)
解決策
1. 解析的な近似(10章)
2. 数値的なサンプリング(11章)
今回は、ラプラス近似を利用
- 3.
- 4.
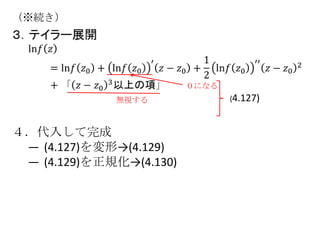
(※続き)
0になる
無視する (4.127)
4.代入して完成
— (4.127)を変形→(4.129)
— (4.129)を正規化→(4.130)
- 5.
注意点など
(4.130)
• ガウス分布による近似式(4.130)が適切に定義される
のは、A>0の場合のみ
• Aの値による関数の違い
— 上に凸→A>0
— 下に凸→A<0
モードとして使える点
- 6.
- 7.
- 8.
- 9.
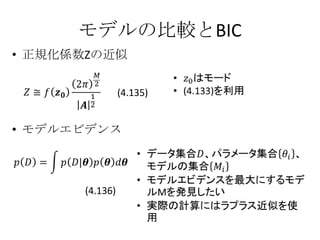
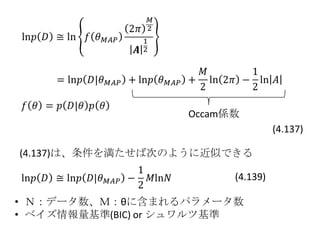
Occam係数
(4.137)
(4.137)は、条件を満たせば次のように近似できる
(4.139)
• N:データ数、M:θに含まれるパラメータ数
• ベイズ情報量基準(BIC) or シュワルツ基準
- 10.
BICの性質
• AICと比較して、BICはモデルの複雑さにより重いペ
ナルティを科している
• (4.139)の、Mが大きくなる(=モデルが複雑になる)ほ
ど、モデルエビデンスが小さくなる。AICと比較して、
BICの方が係数部分が大きい(AICは1、BICはlnN/2)
• 多くのパラメータが「well-determined」でないた
め、ヘッセ行列が非退化であるという仮定が多く
の場合妥当でない問題がある
• (4.137)を(4.139)のように近似することが妥当でない
• ニューラルネットワークの枠組みでは、(4.137)を使って、
もっと精度よくモデルエビデンスを推定できる