© 2026 NTT DATA Japan Corporation
PostgreSQLでデータレイクの選択肢
- pg_duckdb/ pg_lake -
2026/4/18
株式会社NTTデータ
小林 隆浩
© 2026 NTT DATA Japan Corporation 3
アジェンダ
1. HTAPデータベースとしてのPostgreSQL
2. pg_duckdb/DuckLakeの紹介
3. pg_lakeの紹介
4. まとめ
© 2026 NTT DATA Japan Corporation 4
1.
HTAPデータベースとしての
PostgreSQL
© 2026 NTT DATA Japan Corporation 5
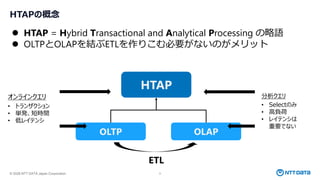
HTAPの概念
⚫ HTAP = Hybrid Transactional and Analytical Processing の略語
⚫ OLTPとOLAPを結ぶETLを作りこむ必要がないのがメリット
HTAP
OLTP OLAP
オンラインクエリ
• トランザクション
• 単発、短時間
• 低レイテンシ
ETL
分析クエリ
• Selectのみ
• 高負荷
• レイテンシは
重要でない
© 2026 NTT DATA Japan Corporation 6
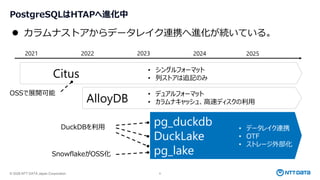
PostgreSQLはHTAPへ進化中
Citus
AlloyDB
pg_duckdb
DuckLake
pg_lake
• シングルフォーマット
• 列ストアは追記のみ
• デュアルフォーマット
• カラムナキャッシュ、高速ディスクの利用
• データレイク連携
• OTF
• ストレージ外部化
2021 2022 2023 2024 2025
⚫ カラムナストアからデータレイク連携へ進化が続いている。
OSSで展開可能
SnowflakeがOSS化
DuckDBを利用
© 2026 NTT DATA Japan Corporation 7
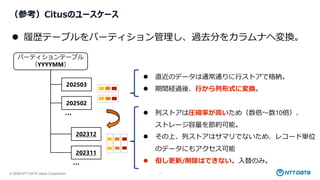
(参考)Citusのユースケース
⚫ 履歴テーブルをパーティション管理し、過去分をカラムナへ変換。
⚫ 直近のデータは通常通りに行ストアで格納。
⚫ 期間経過後、行から列形式に変換。
⚫ 列ストアは圧縮率が高いため(数倍~数10倍)、
ストレージ容量を節約可能。
⚫ その上、列ストアはサマリでないため、レコード単位
のデータにもアクセス可能
⚫ 但し更新/削除はできない。入替のみ。
パーティションテーブル
(YYYYMM)
202503
202502
202312
202311
…
…
© 2026 NTT DATA Japan Corporation 8
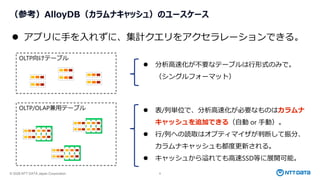
(参考)AlloyDB(カラムナキャッシュ)のユースケース
⚫ アプリに手を入れずに、集計クエリをアクセラレーションできる。
OLTP向けテーブル
OLTP/OLAP兼用テーブル
⚫ 分析高速化が不要なテーブルは行形式のみで。
(シングルフォーマット)
⚫ 表/列単位で、分析高速化が必要なものはカラムナ
キャッシュを追加できる(自動 or 手動)。
⚫ 行/列への読取はオプティマイザが判断して振分、
カラムナキャッシュも都度更新される。
⚫ キャッシュから溢れても高速SSD等に展開可能。
© 2026 NTT DATA Japan Corporation 9
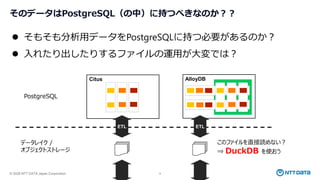
そのデータはPostgreSQL(の中)に持つべきなのか??
⚫ そもそも分析用データをPostgreSQLに持つ必要があるのか?
⚫ 入れたり出したりするファイルの運用が大変では?
Citus AlloyDB
PostgreSQL
データレイク /
オブジェクトストレージ
ETL ETL
このファイルを直接読めない?
⇒ DuckDB を使おう
© 2026 NTT DATA Japan Corporation 10
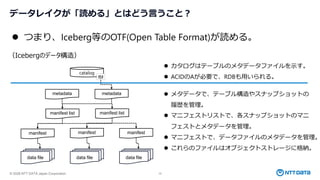
データレイクが「読める」とはどう言うこと?
⚫ つまり、Iceberg等のOTF(Open Table Format)が読める。
catalog
(Icebergのデータ構造)
metadata metadata
manifest list manifest list
manifest manifest
tbl
data file data file data file
manifest
⚫ カタログはテーブルのメタデータファイルを示す。
⚫ ACIDのAが必要で、RDBも用いられる。
⚫ メタデータで、テーブル構造やスナップショットの
履歴を管理。
⚫ マニフェストリストで、各スナップショットのマニ
フェストとメタデータを管理。
⚫ マニフェストで、データファイルのメタデータを管理。
⚫ これらのファイルはオブジェクトストレージに格納。
© 2026 NTT DATA Japan Corporation 11
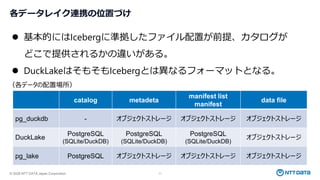
各データレイク連携の位置づけ
⚫ 基本的にはIcebergに準拠したファイル配置が前提、カタログが
どこで提供されるかの違いがある。
⚫ DuckLakeはそもそもIcebergとは異なるフォーマットとなる。
catalog metadeta
manifest list
manifest
data file
pg_duckdb - オブジェクトストレージ オブジェクトストレージ オブジェクトストレージ
DuckLake
PostgreSQL
(SQLite/DuckDB)
PostgreSQL
(SQLite/DuckDB)
PostgreSQL
(SQLite/DuckDB)
オブジェクトストレージ
pg_lake PostgreSQL オブジェクトストレージ オブジェクトストレージ オブジェクトストレージ
(各データの配置場所)
© 2026 NTT DATA Japan Corporation 12
2.
pg_duckdb/DuckLakeの紹介
© 2026 NTT DATA Japan Corporation 13
pg_duckdbとDuckLakeの概要
⚫ どちらもDuckDBがメインコンポーネントで、DuckDBの提供元
(に近い所)で開発が進んでいる。
⚫ pg_duckdb
➢ PostgreSQL(拡張)から、データレイクにSQLを実行できる。
➢ データレイクとして構築済みの(外部の)カタログを利用する。
⚫ DuckLake
➢ DuckDBから、データレイクにSQLを実行できる。
➢ 独自形式のカタログを自身で管理。Icebergとはフォーマットが異なる。
© 2026 NTT DATA Japan Corporation 14
pg_duckdbの紹介
PostgreSQL
データレイク
(S3,GCSなど)
通常テーブル(Heap)
CSV/Parquet/JSONなど
pg_duckdb(拡張)
書き込み 読み込み
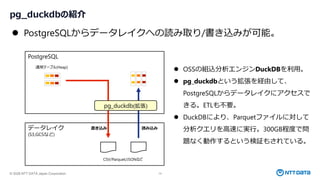
⚫ PostgreSQLからデータレイクへの読み取り/書き込みが可能。
⚫ OSSの組込分析エンジンDuckDBを利用。
⚫ pg_duckdbという拡張を経由して、
PostgreSQLからデータレイクにアクセスで
きる。ETLも不要。
⚫ DuckDBにより、Parquetファイルに対して
分析クエリを高速に実行。300GB程度で問
題なく動作するという検証もされている。
© 2026 NTT DATA Japan Corporation 15
(やってみる)pg_duckdb+オブジェクトストレージ
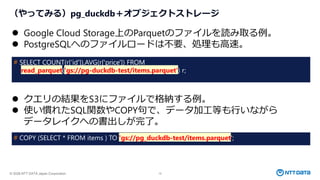
⚫ Google Cloud Storage上のParquetのファイルを読み取る例。
⚫ PostgreSQLへのファイルロードは不要、処理も高速。
# SELECT COUNT(r[‘id']),AVG(r['price']) FROM
read_parquet('gs://pg-duckdb-test/items.parquet') r;
⚫ クエリの結果をS3にファイルで格納する例。
⚫ 使い慣れたSQL関数やCOPY句で、データ加工等も行いながら
データレイクへの書出しが完了。
# COPY (SELECT * FROM items ) TO 'gs://pg_duckdb-test/items.parquet';
© 2026 NTT DATA Japan Corporation 16
pg_duckdbが出来ないこと
PostgreSQL
データレイク
(S3,GCSなど)
通常テーブル(Heap)
初期データ 差分データ
pg_duckdb(拡張)
OTF(Iceberg,Delta Lakeなど)
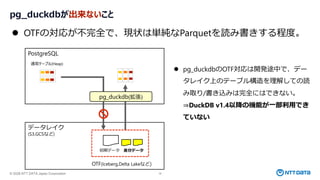
⚫ OTFの対応が不完全で、現状は単純なParquetを読み書きする程度。
⚫ pg_duckdbのOTF対応は開発途中で、デー
タレイク上のテーブル構造を理解しての読
み取り/書き込みは完全にはできない。
⇒DuckDB v1.4以降の機能が一部利用でき
ていない
© 2026 NTT DATA Japan Corporation 17
DuckLake
DuckLakeの紹介
PostgreSQL
データレイク
(S3,GCSなど)
data file(Parquet)
catalog
metadata
manifest list
manifest
metadata
manifest list
manifest
DuckDB
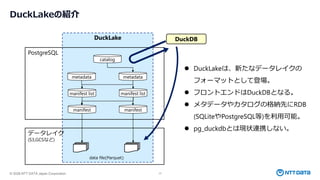
⚫ DuckLakeは、新たなデータレイクの
フォーマットとして登場。
⚫ フロントエンドはDuckDBとなる。
⚫ メタデータやカタログの格納先にRDB
(SQLiteやPostgreSQL等)を利用可能。
⚫ pg_duckdbとは現状連携しない。
© 2026 NTT DATA Japan Corporation 18
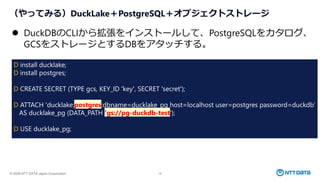
(やってみる)DuckLake+PostgreSQL+オブジェクトストレージ
⚫ DuckDBのCLIから拡張をインストールして、PostgreSQLをカタログ、
GCSをストレージとするDBをアタッチする。
D install ducklake;
D install postgres;
D CREATE SECRET (TYPE gcs, KEY_ID 'key', SECRET 'secret');
D ATTACH 'ducklake:postgres:dbname=ducklake_pg host=localhost user=postgres password=duckdb’
AS ducklake_pg (DATA_PATH 'gs://pg-duckdb-test’);
D USE ducklake_pg;
© 2026 NTT DATA Japan Corporation 19
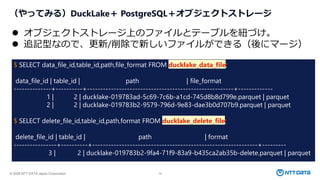
(やってみる)DuckLake+ PostgreSQL+オブジェクトストレージ
⚫ オブジェクトストレージ上のファイルとテーブルを紐づけ。
⚫ 追記型なので、更新/削除で新しいファイルができる(後にマージ)
$ SELECT data_file_id,table_id,path,file_format FROM ducklake_data_file;
data_file_id | table_id | path | file_format
--------------+----------+-------------------------------------------------------+-------------
1 | 2 | ducklake-019783ad-5c69-7c6b-a1cd-745d8b8d799e.parquet | parquet
2 | 2 | ducklake-019783b2-9579-796d-9e83-dae3b0d707b9.parquet | parquet
$ SELECT delete_file_id,table_id,path,format FROM ducklake_delete_file;
delete_file_id | table_id | path | format
----------------+----------+--------------------------------------------------------------+---------
3 | 2 | ducklake-019783b2-9fa4-71f9-83a9-b435ca2ab35b-delete.parquet | parquet
© 2026 NTT DATA Japan Corporation 20
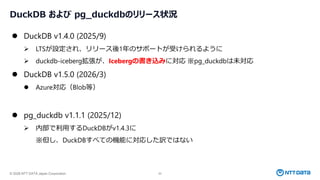
DuckDB および pg_duckdbのリリース状況
⚫ DuckDB v1.4.0 (2025/9)
➢ LTSが設定され、リリース後1年のサポートが受けられるように
➢ duckdb-iceberg拡張が、Icebergの書き込みに対応 ※pg_duckdbは未対応
⚫ DuckDB v1.5.0 (2026/3)
⚫ Azure対応(Blob等)
⚫ pg_duckdb v1.1.1 (2025/12)
➢ 内部で利用するDuckDBがv1.4.3に
※但し、DuckDBすべての機能に対応した訳ではない
© 2026 NTT DATA Japan Corporation 21
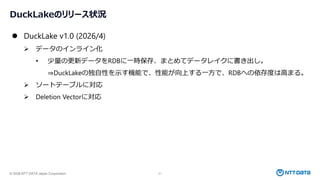
DuckLakeのリリース状況
⚫ DuckLake v1.0 (2026/4)
➢ データのインライン化
• 少量の更新データをRDBに一時保存、まとめてデータレイクに書き出し。
⇒DuckLakeの独自性を示す機能で、性能が向上する一方で、RDBへの依存度は高まる。
➢ ソートテーブルに対応
➢ Deletion Vectorに対応
© 2026 NTT DATA Japan Corporation 22
3.
pg_lakeの紹介
© 2026 NTT DATA Japan Corporation 23
pg_lakeの概要
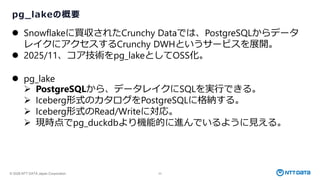
⚫ Snowflakeに買収されたCrunchy Dataでは、PostgreSQLからデータ
レイクにアクセスするCrunchy DWHというサービスを展開。
⚫ 2025/11、コア技術をpg_lakeとしてOSS化。
⚫ pg_lake
➢ PostgreSQLから、データレイクにSQLを実行できる。
➢ Iceberg形式のカタログをPostgreSQLに格納する。
➢ Iceberg形式のRead/Writeに対応。
➢ 現時点でpg_duckdbより機能的に進んでいるように見える。
© 2026 NTT DATA Japan Corporation 24
pg_lakeの紹介
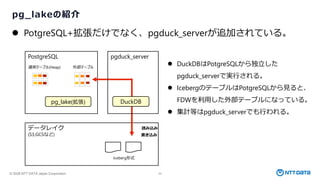
⚫ PotgreSQL+拡張だけでなく、pgduck_serverが追加されている。
PostgreSQL
データレイク
(S3,GCSなど)
通常テーブル(Heap)
Iceberg形式
pg_lake(拡張)
書き込み
読み込み
pgduck_server
外部テーブル
DuckDB
⚫ DuckDBはPotgreSQLから独立した
pgduck_serverで実行される。
⚫ IcebergのテーブルはPotgreSQLから見ると、
FDWを利用した外部テーブルになっている。
⚫ 集計等はpgduck_serverでも行われる。
© 2026 NTT DATA Japan Corporation 25
(やってみる)pg_lakeでIceberg
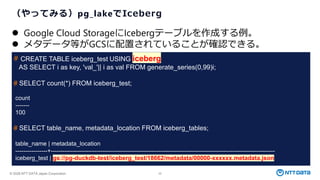
⚫ Google Cloud StorageにIcebergテーブルを作成する例。
⚫ メタデータ等がGCSに配置されていることが確認できる。
# CREATE TABLE iceberg_test USING iceberg
AS SELECT i as key, 'val_'|| i as val FROM generate_series(0,99)i;
# SELECT count(*) FROM iceberg_test;
count
-------
100
# SELECT table_name, metadata_location FROM iceberg_tables;
table_name | metadata_location
----------------+----------------------------------------------------------------------------------------------------------------
iceberg_test | gs://pg-duckdb-test/iceberg_test/18662/metadata/00000-xxxxxx.metadata.json
© 2026 NTT DATA Japan Corporation 26
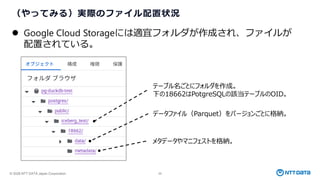
(やってみる)実際のファイル配置状況
⚫ Google Cloud Storageには適宜フォルダが作成され、ファイルが
配置されている。
データファイル(Parquet)をバージョンごとに格納。
メタデータやマニフェストを格納。
テーブル名ごとにフォルダを作成。
下の18662はPotgreSQLの該当テーブルのOID。
© 2026 NTT DATA Japan Corporation 27
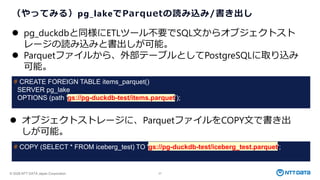
(やってみる)pg_lakeでParquetの読み込み/書き出し
⚫ pg_duckdbと同様にETLツール不要でSQL文からオブジェクトスト
レージの読み込みと書出しが可能。
⚫ Parquetファイルから、外部テーブルとしてPostgreSQLに取り込み
可能。
# CREATE FOREIGN TABLE items_parquet()
SERVER pg_lake
OPTIONS (path 'gs://pg-duckdb-test/items.parquet’);
⚫ オブジェクトストレージに、ParquetファイルをCOPY文で書き出
しが可能。
# COPY (SELECT * FROM iceberg_test) TO 'gs://pg-duckdb-test/iceberg_test.parquet';
© 2026 NTT DATA Japan Corporation 28
4.
まとめ
© 2026 NTT DATA Japan Corporation 29
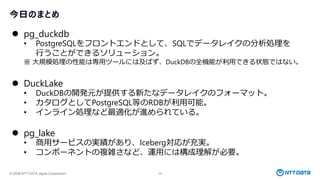
今日のまとめ
⚫ pg_duckdb
• PostgreSQLをフロントエンドとして、SQLでデータレイクの分析処理を
行うことができるソリューション。
※ 大規模処理の性能は専用ツールには及ばず、DuckDBの全機能が利用できる状態ではない。
⚫ DuckLake
• DuckDBの開発元が提供する新たなデータレイクのフォーマット。
• カタログとしてPostgreSQL等のRDBが利用可能。
• インライン処理など最適化が進められている。
⚫ pg_lake
• 商用サービスの実績があり、Iceberg対応が充実。
• コンポーネントの複雑さなど、運用には構成理解が必要。
PostgreSQLでデータレイクの選択肢 -pg_duckdb/pg_lake-(オープンソースカンファレンス2026 Kagawa)