Optimizing write
intensive DB workloads
MASTERCLASS
Strategies for Optimizing
Write Performance
WELCOME
MASTERCLASS
Ask the best 5 questions
in chat and win a copy of
Database Performance
at Scale
Optimizing Write-Intensive Database Workloads
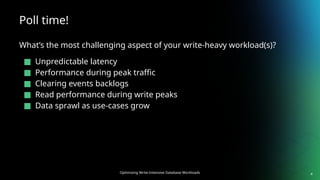
Poll time!
What’s the most challenging aspect of your write-heavy workload(s)?
■ Unpredictable latency
■ Performance during peak traffic
■ Clearing events backlogs
■ Read performance during write peaks
■ Data sprawl as use-cases grow
4
Optimizing Write-Intensive Database Workloads
Write Performance
is Multifactorial
Optimizing Write-Intensive Database Workloads
Write Performance
is Multifactorial
Optimizing Write-Intensive Database Workloads
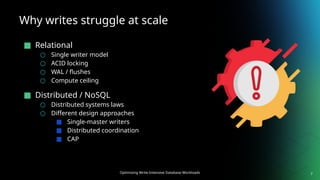
Why writes struggle at scale
■ Relational
○ Single writer model
○ ACID locking
○ WAL / flushes
○ Compute ceiling
■ Distributed / NoSQL
○ Distributed systems laws
○ Different design approaches
■ Single-master writers
■ Distributed coordination
■ CAP
7
Optimizing Write-Intensive Database Workloads
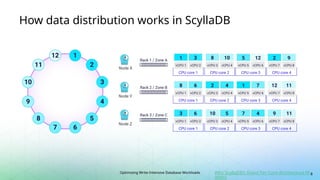
How data distribution works in ScyllaDB
8
Why ScyllaDB’s Shard Per Core Architecture M
atters
Optimizing Write-Intensive Database Workloads
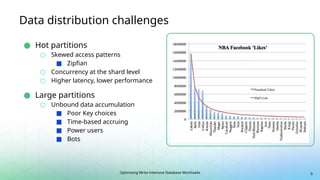
Data distribution challenges
● Hot partitions
○ Skewed access patterns
■ Zipfian
○ Concurrency at the shard level
○ Higher latency, lower performance
● Large partitions
○ Unbound data accumulation
■ Poor Key choices
■ Time-based accruing
■ Power users
■ Bots
9
Optimizing Write-Intensive Database Workloads
Design Decisions
for performance
Optimizing Write-Intensive Database Workloads
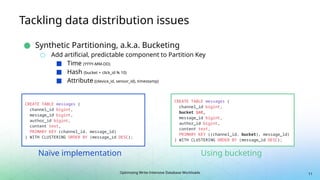
Tackling data distribution issues
● Synthetic Partitioning, a.k.a. Bucketing
○ Add artificial, predictable component to Partition Key
■ Time (YYYY-MM-DD)
■ Hash (bucket = click_id % 10)
■ Attribute ((device_id, sensor_id), timestamp)
11
CREATE TABLE messages (
channel_id bigint,
message_id bigint,
author_id bigint,
content text,
PRIMARY KEY (channel_id, message_id)
) WITH CLUSTERING ORDER BY (message_id DESC);
CREATE TABLE messages (
channel_id bigint,
bucket int,
message_id bigint,
author_id bigint,
content text,
PRIMARY KEY ((channel_id, bucket), message_id)
) WITH CLUSTERING ORDER BY (message_id DESC);
Naïve implementation Using bucketing
Optimizing Write-Intensive Database Workloads
Avoiding contention
● Don’t overuse LWTs
○ Add'l operations, RTT
● Design for idempotency instead
○ Append-only
○ Easier failure handling
○ Client-side timestamps
● What to avoid
○ Read-Modify-Write
○ Row locking
12
Optimizing Write-Intensive Database Workloads
Batching writes
Optimizing Write-Intensive Database Workloads
Why use batching?
■ Intensive writes from similar data points
○ IOT per-device metrics
○ Bulk user operations
○ Event streaming
■ Cuts per-statement overhead
○ RTT
○ Transactions
○ WAL flushes
■ Reduces handling of individual retries
○ But still retry if a single condition fails
■ All-or-nothing behaviour (*)
14
Optimizing Write-Intensive Database Workloads
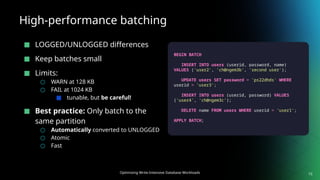
High-performance batching
■ LOGGED/UNLOGGED differences
■ Keep batches small
■ Limits:
○ WARN at 128 KB
○ FAIL at 1024 KB
■ tunable, but be careful!
■ Best practice: Only batch to the
same partition
○ Automatically converted to UNLOGGED
○ Atomic
○ Fast
15
BEGIN BATCH
INSERT INTO users (userid, password, name)
VALUES ('user2', 'ch@ngem3b', 'second user');
UPDATE users SET password = 'ps22dhds' WHERE
userid = 'user3';
INSERT INTO users (userid, password) VALUES
('user4', 'ch@ngem3c');
DELETE name FROM users WHERE userid = 'user1';
APPLY BATCH;
Optimizing Write-Intensive Database Workloads
Only batch to the
same partition
16
Optimizing Write-Intensive Database Workloads
Other considerations
Optimizing Write-Intensive Database Workloads
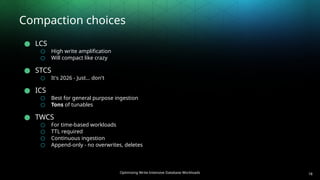
Compaction choices
● LCS
○ High write amplification
○ Will compact like crazy
● STCS
○ It's 2026 - Just… don't
● ICS
○ Best for general purpose ingestion
○ Tons of tunables
● TWCS
○ For time-based workloads
○ TTL required
○ Continuous ingestion
○ Append-only - no overwrites, deletes
18
Optimizing Write-Intensive Database Workloads
Compression tradeoffs
● Recent developments in compression
○ {LZ4,ZStd}WithDictsCompressor
○ Up to 90% compression, YMMV
○ ZStd is tunable - specify the effort required
■ 1 – 9, 3 is a great starting point
● For write-heavy
○ Find a good balance
■ Start at ZStdWithDicts, level 3
○ Check compression ratio
● Network compression also pays off
○ Especially on the Cloud $
19
Optimizing Write-Intensive Database Workloads
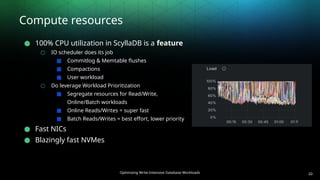
Compute resources
● 100% CPU utilization in ScyllaDB is a feature
○ IO scheduler does its job
■ Commitlog & Memtable flushes
■ Compactions
■ User workload
○ Do leverage Workload Prioritization
■ Segregate resources for Read/Write,
Online/Batch workloads
■ Online Reads/Writes = super fast
■ Batch Reads/Writes = best effort, lower priority
● Fast NICs
● Blazingly fast NVMes
20
Optimizing Write-Intensive Database Workloads
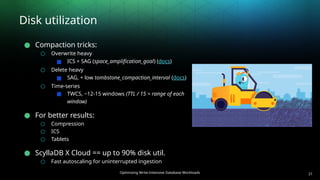
Disk utilization
● Compaction tricks:
○ Overwrite heavy
■ ICS + SAG (space_amplification_goal) (docs)
○ Delete heavy
■ SAG, + low tombstone_compaction_interval (docs)
○ Time-series
■ TWCS, ~12-15 windows (TTL / 15 = range of each
window)
● For better results:
○ Compression
○ ICS
○ Tablets
● ScyllaDB X Cloud == up to 90% disk util.
○ Fast autoscaling for uninterrupted ingestion
21
Optimizing Write-Intensive Database Workloads
Key Takeaways
22
Optimizing Write-Intensive Database Workloads
Key Takeaways
■ Write-heavy workloads are resource hungry
■ For performance:
○ Design for distribution
○ Don't overuse coordinator-heavy operations
○ Batch carefully
○ Tune Compaction and Compression to workload needs
○ Resource isolation FTW!
23
Optimizing Write-Intensive Database Workloads
Keep in touch!
Guilherme Nogueira (Gui)
Technical Director
ScyllaDB
guilherme.nogueira@scylladb.com
Optimizing Write-Intensive Database Workloads
25
EXAM TIME
bit.ly/3SMfL1Y
Pass the exam
and for a chance to win a
certificate and swag pack!
All Things Performance
A ScyllaDB
Community
Virtual Event | OCTOBER 21 +
22, 2026
Register now at
p99conf.io
Optimizing
write intensive
DB workloads
Masterclass
29
Submit an accepted
review of ScyllaDB on G2
and win a $50 gift card!*
*While supplies last.
Earn $50!