Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
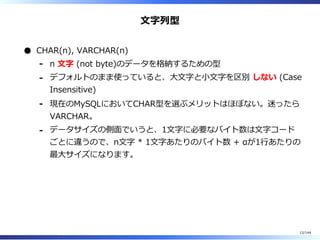
Design
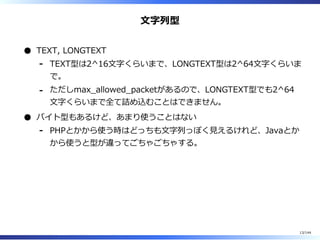
Education
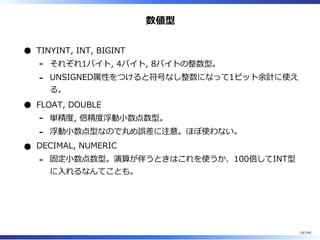
Presentations & Public Speaking
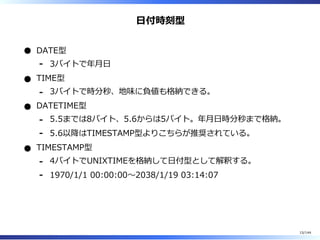
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
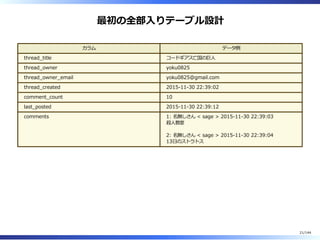
Engineering
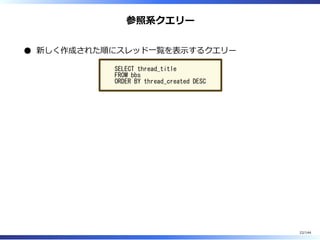
Software
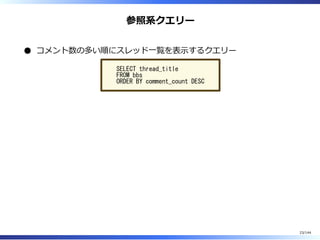
Recruiting & HR
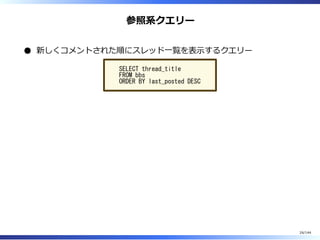
Retail
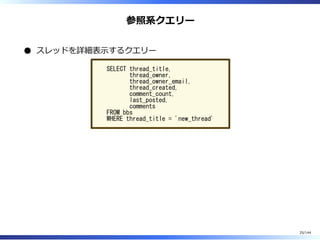
Sales
Services
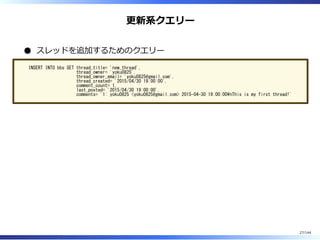
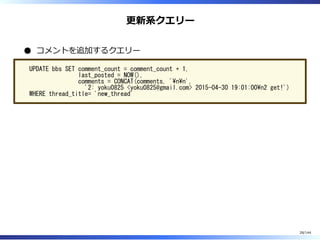
Science
Small Business & Entrepreneurship
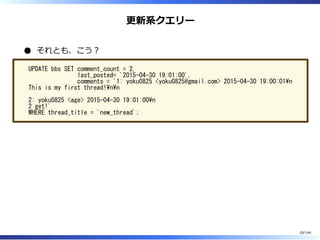
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
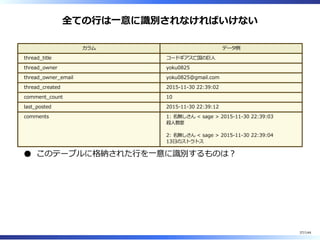
Travel
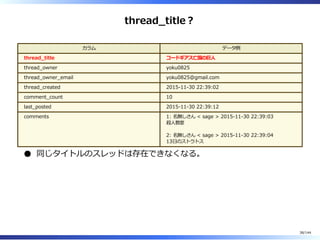
Self Improvement
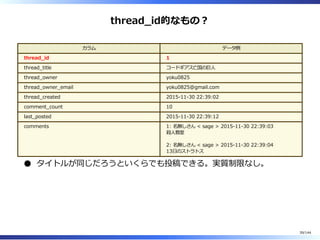
Real Estate
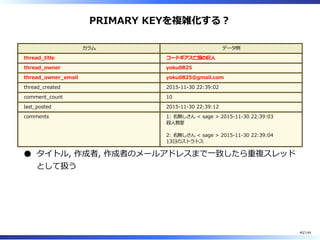
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
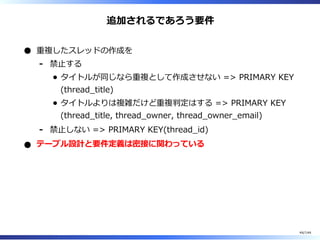
EN
Upload
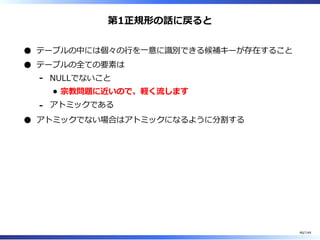
Download free for 30 days
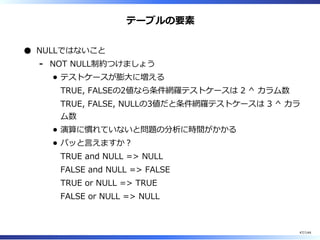
Sign in
Uploaded by
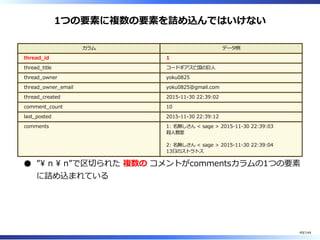
yoku0825
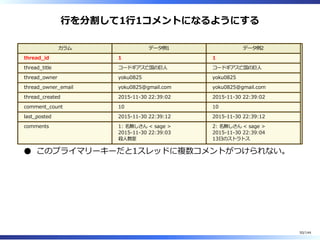
PDF, PPTX
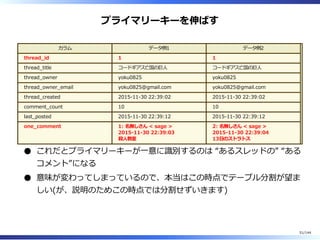
48,405 views
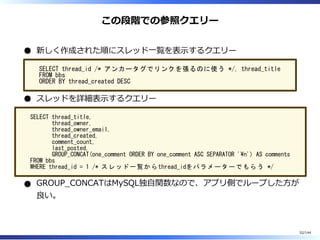
MySQLテーブル設計入門
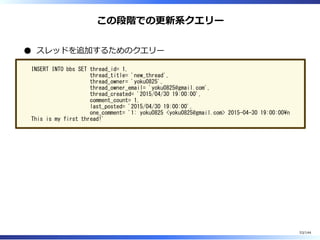
2015/04/30 schoo WEB-campus https://schoo.jp/class/2218
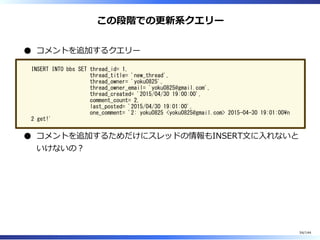
Technology
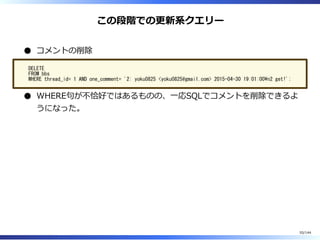
◦
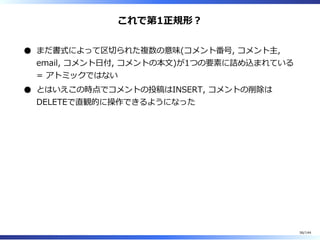
Read more
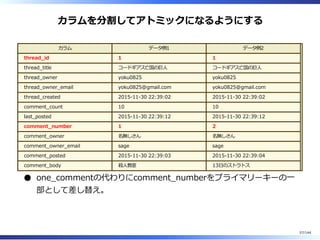
194
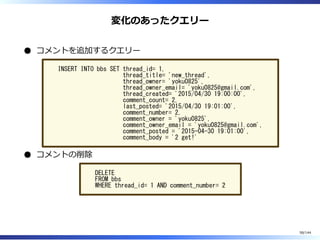
Save
Share
Embed
Save to Drive
Download now
Download as PDF, PPTX
1
/ 145
2
/ 145
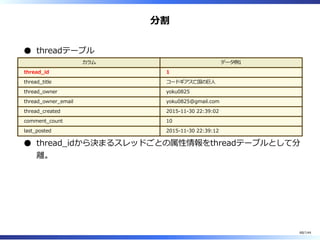
3
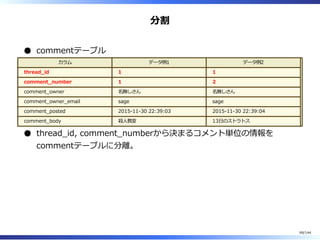
/ 145
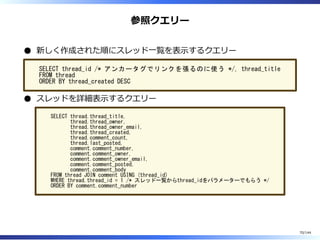
4
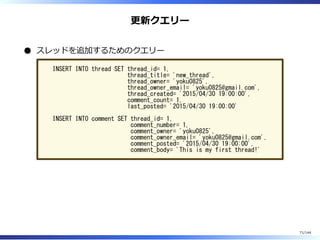
/ 145
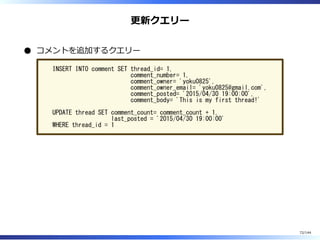
5
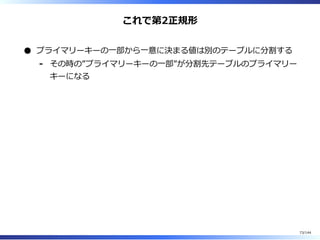
/ 145
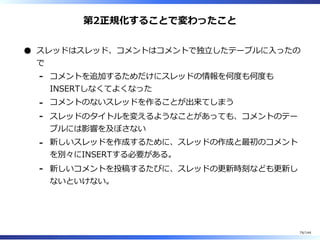
6
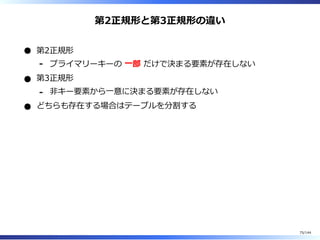
/ 145
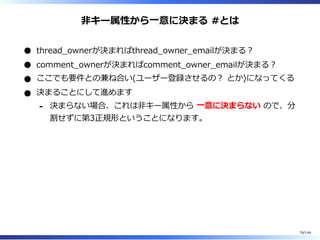
7
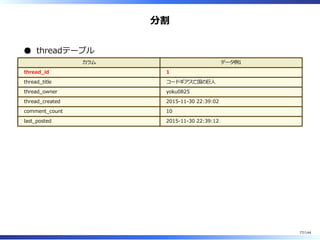
/ 145
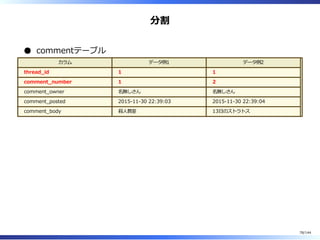
8
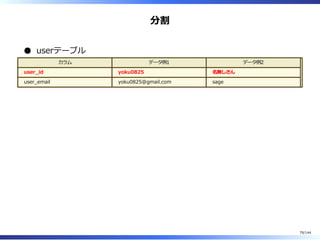
/ 145
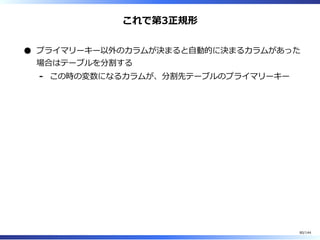
9
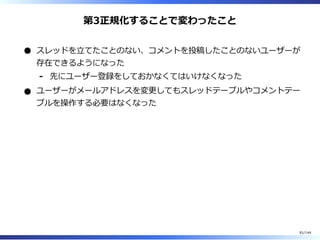
/ 145
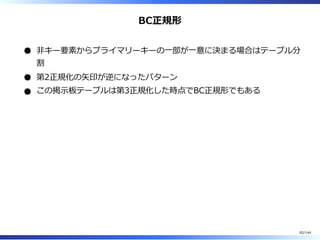
10
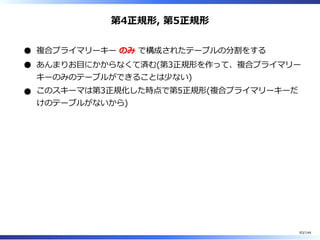
/ 145
11
/ 145
12
/ 145
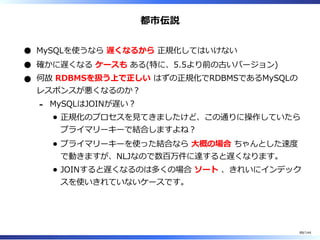
13
/ 145
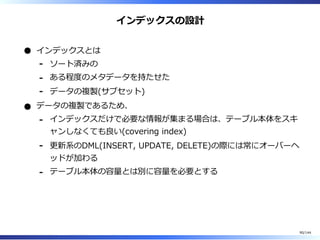
14
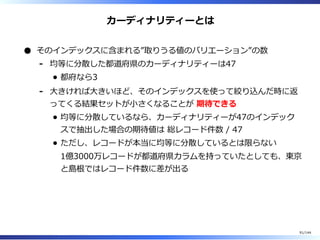
/ 145
15
/ 145
16
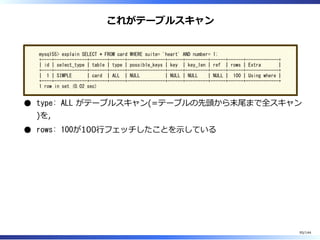
/ 145
17
/ 145
18
/ 145
19
/ 145
20
/ 145
More Related Content
PDF
MySQL 5.7 トラブルシューティング 性能解析入門編
by
Mikiya Okuno
57 slides
4.7K views
PDF
MySQL 8.0で憶えておいてほしいこと
by
yoku0825
37 slides
19.4K views
PDF
O/Rマッパーによるトラブルを未然に防ぐ
by
kwatch
61 slides
49K views
PDF
MySQL 5.7にやられないためにおぼえておいてほしいこと
by
yoku0825
173 slides
177.8K views
PDF
はじめてのKrylov部分空間法
by
tmaehara
10 slides
16.9K views
PDF
わかった気になるMySQL
by
yoku0825
106 slides
11.3K views
PDF
雑なMySQLパフォーマンスチューニング
by
yoku0825
142 slides
57.3K views
PDF
サーバーが完膚なきまでに死んでもMySQLのデータを失わないための表技
by
yoku0825
89 slides
24K views
MySQL 5.7 トラブルシューティング 性能解析入門編
by
Mikiya Okuno
57 slides
4.7K views
MySQL 8.0で憶えておいてほしいこと
by
yoku0825
37 slides
19.4K views
O/Rマッパーによるトラブルを未然に防ぐ
by
kwatch
61 slides
49K views
MySQL 5.7にやられないためにおぼえておいてほしいこと
by
yoku0825
173 slides
177.8K views
はじめてのKrylov部分空間法
by
tmaehara
10 slides
16.9K views
わかった気になるMySQL
by
yoku0825
106 slides
11.3K views
雑なMySQLパフォーマンスチューニング
by
yoku0825
142 slides
57.3K views
サーバーが完膚なきまでに死んでもMySQLのデータを失わないための表技
by
yoku0825
89 slides
24K views
What's hot
PPTX
【DL輪読会】ViT + Self Supervised Learningまとめ
by
Deep Learning JP
52 slides
6.8K views
PDF
Apache tinkerpopとグラフデータベースの世界
by
Yuki Morishita
50 slides
5.5K views
PDF
TensorFlow Lite Delegateとは?
by
Mr. Vengineer
32 slides
10.5K views
PDF
Apache Arrow - データ処理ツールの次世代プラットフォーム
by
Kouhei Sutou
90 slides
8.3K views
PDF
最近のSingle Shot系の物体検出のアーキテクチャまとめ
by
Yusuke Uchida
25 slides
41K views
PPTX
[DeepLearning論文読み会] Dataset Distillation
by
Ryutaro Yamauchi
11 slides
1.1K views
PDF
RDB技術者のためのNoSQLガイド NoSQLの必要性と位置づけ
by
Recruit Technologies
45 slides
60.4K views
PPTX
え!?データがオンプレにあるけどPower BI で BI したいの?
by
Yugo Shimizu
49 slides
17.5K views
PDF
プログラムを高速化する話
by
京大 マイコンクラブ
120 slides
268.3K views
PDF
片手間MySQLチューニング戦略
by
yoku0825
78 slides
21.5K views
PPTX
本当は恐ろしい分散システムの話
by
Kumazaki Hiroki
70 slides
753.9K views
PPTX
Istioサービスメッシュ入門
by
Yoichi Kawasaki
52 slides
39.8K views
PDF
こわくない Git
by
Kota Saito
186 slides
907.7K views
PDF
Visual SLAM: Why Bundle Adjust?の解説(第4回3D勉強会@関東)
by
Masaya Kaneko
48 slides
10.2K views
PDF
さいきんの InnoDB Adaptive Flushing (仮)
by
Takanori Sejima
62 slides
20.8K views
PDF
OpenStackで始めるクラウド環境構築入門(Horizon 基礎編)
by
VirtualTech Japan Inc.
90 slides
21.2K views
PPTX
【DL輪読会】HexPlaneとK-Planes
by
Deep Learning JP
20 slides
4K views
PPTX
近年のHierarchical Vision Transformer
by
Yusuke Uchida
46 slides
17.9K views
PDF
機械学習モデルのサービングとは?
by
Sho Tanaka
13 slides
1.7K views
PDF
MySQL 5.7の罠があなたを狙っている
by
yoku0825
75 slides
122.8K views
【DL輪読会】ViT + Self Supervised Learningまとめ
by
Deep Learning JP
52 slides
6.8K views
Apache tinkerpopとグラフデータベースの世界
by
Yuki Morishita
50 slides
5.5K views
TensorFlow Lite Delegateとは?
by
Mr. Vengineer
32 slides
10.5K views
Apache Arrow - データ処理ツールの次世代プラットフォーム
by
Kouhei Sutou
90 slides
8.3K views
最近のSingle Shot系の物体検出のアーキテクチャまとめ
by
Yusuke Uchida
25 slides
41K views
[DeepLearning論文読み会] Dataset Distillation
by
Ryutaro Yamauchi
11 slides
1.1K views
RDB技術者のためのNoSQLガイド NoSQLの必要性と位置づけ
by
Recruit Technologies
45 slides
60.4K views
え!?データがオンプレにあるけどPower BI で BI したいの?
by
Yugo Shimizu
49 slides
17.5K views
プログラムを高速化する話
by
京大 マイコンクラブ
120 slides
268.3K views
片手間MySQLチューニング戦略
by
yoku0825
78 slides
21.5K views
本当は恐ろしい分散システムの話
by
Kumazaki Hiroki
70 slides
753.9K views
Istioサービスメッシュ入門
by
Yoichi Kawasaki
52 slides
39.8K views
こわくない Git
by
Kota Saito
186 slides
907.7K views
Visual SLAM: Why Bundle Adjust?の解説(第4回3D勉強会@関東)
by
Masaya Kaneko
48 slides
10.2K views
さいきんの InnoDB Adaptive Flushing (仮)
by
Takanori Sejima
62 slides
20.8K views
OpenStackで始めるクラウド環境構築入門(Horizon 基礎編)
by
VirtualTech Japan Inc.
90 slides
21.2K views
【DL輪読会】HexPlaneとK-Planes
by
Deep Learning JP
20 slides
4K views
近年のHierarchical Vision Transformer
by
Yusuke Uchida
46 slides
17.9K views
機械学習モデルのサービングとは?
by
Sho Tanaka
13 slides
1.7K views
MySQL 5.7の罠があなたを狙っている
by
yoku0825
75 slides
122.8K views
Viewers also liked
PDF
運用に自動化を求めるのは間違っているだろうか
by
Masahito Zembutsu
195 slides
55.9K views
PPTX
Appium を使って iOS / Android の UI テストを共通化
by
Kenichi Tatsuhama
20 slides
8.1K views
PPTX
ゲームエンジニアのためのデータベース設計
by
sairoutine
32 slides
35K views
PDF
ソーシャルゲームのためのデータベース設計
by
Yoshinori Matsunobu
33 slides
129.9K views
PDF
偶然にも500万個のSSH公開鍵を手に入れた俺たちは
by
Yoshio Hanawa
21 slides
125.2K views
PDF
プログラム組んだら負け!実はHTML/CSSだけでできること2015夏
by
Yusuke Hirao
88 slides
82.4K views
PPTX
技術選択とアーキテクトの役割
by
Toru Yamaguchi
90 slides
42.2K views
PDF
「内積が見えると統計学も見える」第5回 プログラマのための数学勉強会 発表資料
by
Ken'ichi Matsui
96 slides
99.7K views
PDF
実践イカパケット解析
by
Yuki Mizuno
90 slides
120.5K views
PDF
ウェブパフォーマンスの基礎とこれから
by
Hiroshi Kawada
89 slides
111.8K views
PDF
オンラインゲームの仕組みと工夫
by
Yuta Imai
56 slides
889.1K views
PPTX
Webアプリケーション負荷試験実践入門
by
樽八 仲川
117 slides
53.7K views
PDF
「スプラトゥーン」リアルタイム画像解析ツール 「IkaLog」の裏側
by
Takeshi HASEGAWA
70 slides
133.8K views
PPTX
ちゃんとした C# プログラムを書けるようになる実践的な方法~ Visual Studio を使った 高品質・低コスト・保守性の高い開発
by
慎一 古賀
84 slides
87.2K views
PDF
SQLアンチパターン 幻の第26章「とりあえず削除フラグ」
by
Takuto Wada
45 slides
174.7K views
PDF
中の下のエンジニアを脱出するための仕事術
by
Noriaki Kadota
15 slides
46.9K views
PDF
SSL/TLSの基礎と最新動向
by
shigeki_ohtsu
118 slides
57.4K views
PDF
フーリエ変換と画像圧縮の仕組み
by
yuichi takeda
100 slides
244.6K views
PDF
エンジニアのための経営学
by
Michitaka Yumoto
75 slides
89.1K views
PDF
インフラエンジニアがUnityをやるべきたった一つの理由
by
axsh co., LTD.
44 slides
124K views
運用に自動化を求めるのは間違っているだろうか
by
Masahito Zembutsu
195 slides
55.9K views
Appium を使って iOS / Android の UI テストを共通化
by
Kenichi Tatsuhama
20 slides
8.1K views
ゲームエンジニアのためのデータベース設計
by
sairoutine
32 slides
35K views
ソーシャルゲームのためのデータベース設計
by
Yoshinori Matsunobu
33 slides
129.9K views
偶然にも500万個のSSH公開鍵を手に入れた俺たちは
by
Yoshio Hanawa
21 slides
125.2K views
プログラム組んだら負け!実はHTML/CSSだけでできること2015夏
by
Yusuke Hirao
88 slides
82.4K views
技術選択とアーキテクトの役割
by
Toru Yamaguchi
90 slides
42.2K views
「内積が見えると統計学も見える」第5回 プログラマのための数学勉強会 発表資料
by
Ken'ichi Matsui
96 slides
99.7K views
実践イカパケット解析
by
Yuki Mizuno
90 slides
120.5K views
ウェブパフォーマンスの基礎とこれから
by
Hiroshi Kawada
89 slides
111.8K views
オンラインゲームの仕組みと工夫
by
Yuta Imai
56 slides
889.1K views
Webアプリケーション負荷試験実践入門
by
樽八 仲川
117 slides
53.7K views
「スプラトゥーン」リアルタイム画像解析ツール 「IkaLog」の裏側
by
Takeshi HASEGAWA
70 slides
133.8K views
ちゃんとした C# プログラムを書けるようになる実践的な方法~ Visual Studio を使った 高品質・低コスト・保守性の高い開発
by
慎一 古賀
84 slides
87.2K views
SQLアンチパターン 幻の第26章「とりあえず削除フラグ」
by
Takuto Wada
45 slides
174.7K views
中の下のエンジニアを脱出するための仕事術
by
Noriaki Kadota
15 slides
46.9K views
SSL/TLSの基礎と最新動向
by
shigeki_ohtsu
118 slides
57.4K views
フーリエ変換と画像圧縮の仕組み
by
yuichi takeda
100 slides
244.6K views
エンジニアのための経営学
by
Michitaka Yumoto
75 slides
89.1K views
インフラエンジニアがUnityをやるべきたった一つの理由
by
axsh co., LTD.
44 slides
124K views
Similar to MySQLテーブル設計入門
PPT
PhpでMySqlを使う
by
pcod
23 slides
42.2K views
PDF
Sqlの書き方セミナー資料
by
Sadayoshi Ikushima
149 slides
1.5K views
PDF
【第3回初心者勉強会】データベースを使おう
by
Shuhei Iitsuka
25 slides
1.2K views
PPTX
Sql learning
by
Sadayoshi Ikushima
64 slides
524 views
PDF
データベース設計の基本編.pdf
by
Tezuka Masato
28 slides
420 views
PDF
データベース03 - SQL(CREATE, INSERT, DELETE, UPDATEなど)
by
Kenta Oku
36 slides
2.4K views
PDF
削除フラグのはなし
by
Shigetaka Yachi
83 slides
17K views
PDF
Wtm
by
Soudai Sone
126 slides
1.8K views
PhpでMySqlを使う
by
pcod
23 slides
42.2K views
Sqlの書き方セミナー資料
by
Sadayoshi Ikushima
149 slides
1.5K views
【第3回初心者勉強会】データベースを使おう
by
Shuhei Iitsuka
25 slides
1.2K views
Sql learning
by
Sadayoshi Ikushima
64 slides
524 views
データベース設計の基本編.pdf
by
Tezuka Masato
28 slides
420 views
データベース03 - SQL(CREATE, INSERT, DELETE, UPDATEなど)
by
Kenta Oku
36 slides
2.4K views
削除フラグのはなし
by
Shigetaka Yachi
83 slides
17K views
Wtm
by
Soudai Sone
126 slides
1.8K views
More from yoku0825
PDF
逝くぞ最新版、罠の貯蔵は十分か
by
yoku0825
45 slides
9.4K views
PDF
MySQLレプリケーションあれやこれや
by
yoku0825
64 slides
17.8K views
PDF
MySQLを割と一人で300台管理する技術
by
yoku0825
64 slides
53.2K views
PDF
MySQLステータスモニタリング
by
yoku0825
55 slides
12.5K views
PDF
わたしを支える技術
by
yoku0825
67 slides
7.4K views
PDF
MySQL 5.7の次のMySQL 8.0はどんなものになるだろう
by
yoku0825
61 slides
13.9K views
PDF
Dockerイメージで誰でも気軽にMroonga体験
by
yoku0825
23 slides
4.5K views
PDF
MySQLアンチパターン
by
yoku0825
43 slides
30.1K views
PDF
MySQLerの7つ道具 plus
by
yoku0825
99 slides
6.8K views
PDF
MySQL 5.7の次のMySQLは
by
yoku0825
55 slides
7.8K views
PDF
MySQLerの7つ道具
by
yoku0825
80 slides
6.5K views
PDF
MHAの次を目指す mikasafabric for MySQL
by
yoku0825
74 slides
2.9K views
PDF
5.7の次のMySQL
by
yoku0825
24 slides
4.3K views
PDF
mikasafabric for MySQL
by
yoku0825
56 slides
1.5K views
PDF
とあるイルカの近況報告
by
yoku0825
38 slides
5.4K views
PDF
MySQL Fabricでぼっこぼこにされたはなし
by
yoku0825
85 slides
8.3K views
PDF
MySQLと正規形のはなし
by
yoku0825
88 slides
6.4K views
PDF
MySQLおじさんの逆襲
by
yoku0825
137 slides
31K views
PDF
地雷職人の朝は早い
by
yoku0825
27 slides
3K views
PDF
ペパボ de MySQL
by
yoku0825
70 slides
8.8K views
逝くぞ最新版、罠の貯蔵は十分か
by
yoku0825
45 slides
9.4K views
MySQLレプリケーションあれやこれや
by
yoku0825
64 slides
17.8K views
MySQLを割と一人で300台管理する技術
by
yoku0825
64 slides
53.2K views
MySQLステータスモニタリング
by
yoku0825
55 slides
12.5K views
わたしを支える技術
by
yoku0825
67 slides
7.4K views
MySQL 5.7の次のMySQL 8.0はどんなものになるだろう
by
yoku0825
61 slides
13.9K views
Dockerイメージで誰でも気軽にMroonga体験
by
yoku0825
23 slides
4.5K views
MySQLアンチパターン
by
yoku0825
43 slides
30.1K views
MySQLerの7つ道具 plus
by
yoku0825
99 slides
6.8K views
MySQL 5.7の次のMySQLは
by
yoku0825
55 slides
7.8K views
MySQLerの7つ道具
by
yoku0825
80 slides
6.5K views
MHAの次を目指す mikasafabric for MySQL
by
yoku0825
74 slides
2.9K views
5.7の次のMySQL
by
yoku0825
24 slides
4.3K views
mikasafabric for MySQL
by
yoku0825
56 slides
1.5K views
とあるイルカの近況報告
by
yoku0825
38 slides
5.4K views
MySQL Fabricでぼっこぼこにされたはなし
by
yoku0825
85 slides
8.3K views
MySQLと正規形のはなし
by
yoku0825
88 slides
6.4K views
MySQLおじさんの逆襲
by
yoku0825
137 slides
31K views
地雷職人の朝は早い
by
yoku0825
27 slides
3K views
ペパボ de MySQL
by
yoku0825
70 slides
8.8K views
MySQLテーブル設計入門
1.
MySQL⼊門 7限目: テーブル設計について 2015/04/30 GMOメディア株式会社 yoku0825 schoo
WEB-campus
2.
\こんにちは/ yoku0825@GMOメディア株式会社 オラクれない- ポスグれない- マイエスキューエる- 家に帰ると 妻の夫- せがれの⽗- 娘の⽗- Twitter: @yoku0825 Blog: ⽇々の覚書 1/144
3.
アジェンダ 事前知識 DDLで使われる⽤語についてざっと説明します- データ型について説明します- カラム設計 デモケースとして掲⽰板⽤のデータモデリングをします- 非正規形のテーブルからスタートし、正規形にするまでの考え⽅を学 びます - インデックス設計 インデックスの動作の仕⽅についてトランプの例を⽤いて簡単に解説 します - 先の掲⽰板⽤のデータモデルにインデックスを作成します- 2/144
4.
質問 3/144
5.
今のあなたのレベル感を教えてください SQLもまだいまいち。。1. SQLならほぼわかるけど実務経験ガー2. テーブル設計経験者。でも破綻しちゃって。。3. バリバリサービスでやっててノウハウはあるけど、ちょっと理屈を聞いて みたくなった。 4. お前にマサカリを投げに来た5. 4/144
6.
1. SQLもまだいまいち。。 の⽅ そんなにたくさんSQLをゴリゴリ書くような授業ではないですので、気楽 に最後まで眺めてみてください。 暗記すること、憶えなければいけないことは基本何もありません。そうい えばこんな話聞いたな…というのが後から⽣きてくる、というのを弊社研 修⽣からは⽿にしています
:) SQLが判ればもっと⾯⽩くなると思いますので、SQLが⼿についてき たころに観返してみると違った発⾒があるかも知れません。 - 5/144
7.
2. SQLならほぼわかるけど実務経験ガー の⽅ 前半の正規形と設計のプロセスについて、疑問に思ったところはどんどん 聞いてください。 後半かなりアーキテクチャーに寄りますので、そちらはまた慣れてきたこ ろに観返していただけると幸いです。 6/144
8.
3. テーブル設計経験者。でも破綻しちゃって。。 の⽅ まずは前半で
“正規形” について誤解がないかどうか⼀緒に考えましょ う。 そして、 正規化 した/していない のに何故テーブルが破綻したのかの答 え(への⾜掛かり)を後半で探っていきます。 7/144
9.
4. バリバリサービスでやっててノウハウはある⽅ そんなあなたにこの授業の内容をそれっぽい⾔葉で説明すると 3NFまで1段階ずつ正規化していきます。- インデックスの使われ⽅(WHERE狙いのキー, ORDER
BY狙いのキー) の話をします。 - JOIN時における内部表と外部表の話とWHERE狙い, ORDER BY狙い の話が絡んできます。 - 楽しんでいただけそうですか︖ 8/144
10.
5. お前にマサカリを投げに来た お⼿柔らかにお願いします。。 9/144
11.
⽤語について インデックス (主に)データを検索するために使われる ソート済みのデータのサブセ ット - MySQLでは “キー”
と “インデックス” は同じもの(特に、セカンダリ ーキー)を指すことが多い リレーショナルモデル上では “キー” は “候補キー” - 10/144
12.
⽂字コードについて sjis 悪いことは⾔わないのでやめましょう。バグが多いです。- WindowsのSJISと 互換性がない ので、WindowsのSJISを使いたい のであればcp932を使ってください - ujis オススメはしませんがsjisよりはマシです。eucjpmsの⽅がいいで す。 - utf8 基本的にオススメですが、4バイト⽂字(絵⽂字)が⼊らないので、 utf8mb4にするべきかと思います。 - latin1 暗黙のデフォルト。- ⽇本語を⼊れると闇が⾒えます。- 11/144
13.
⽂字列型 CHAR(n), VARCHAR(n) n ⽂字
(not byte)のデータを格納するための型- デフォルトのまま使っていると、⼤⽂字と⼩⽂字を区別 しない (Case Insensitive) - 現在のMySQLにおいてCHAR型を選ぶメリットはほぼない。迷ったら VARCHAR。 - データサイズの側⾯でいうと、1⽂字に必要なバイト数は⽂字コード ごとに違うので、n⽂字 * 1⽂字あたりのバイト数 + αが1⾏あたりの 最⼤サイズになります。 - 12/144
14.
⽂字列型 TEXT, LONGTEXT TEXT型は2^16⽂字くらいまで、LONGTEXT型は2^64⽂字くらいま で。 - ただしmax̲allowed̲packetがあるので、LONGTEXT型でも2^64 ⽂字くらいまで全て詰め込むことはできません。 - バイト型もあるけど、あまり使うことはない PHPとかから使う時はどっちも⽂字列っぽく⾒えるけれど、Javaとか から使うと型が違ってごちゃごちゃする。 - 13/144
15.
数値型 TINYINT, INT, BIGINT それぞれ1バイト,
4バイト, 8バイトの整数型。- UNSIGNED属性をつけると符号なし整数になって1ビット余計に使え る。 - FLOAT, DOUBLE 単精度, 倍精度浮動⼩数点数型。- 浮動⼩数点型なので丸め誤差に注意。ほぼ使わない。- DECIMAL, NUMERIC 固定⼩数点数型。演算が伴うときはこれを使うか、100倍してINT型 に⼊れるなんてことも。 - 14/144
16.
⽇付時刻型 DATE型 3バイトで年⽉⽇- TIME型 3バイトで時分秒、地味に負値も格納できる。- DATETIME型 5.5までは8バイト、5.6からは5バイト。年⽉⽇時分秒まで格納。- 5.6以降はTIMESTAMP型よりこちらが推奨されている。- TIMESTAMP型 4バイトでUNIXTIMEを格納して⽇付型として解釈する。- 1970/1/1 00:00:00〜2038/1/19 03:14:07- 15/144
17.
その他テーブルの属性 AUTO̲INCREMENT 数値型(⼩数点型でもOK)そのカラムにインデックスがある場合にのみ 設定可能な属性。 - ⾃動でカウントアップされるDEFAULT属性みたいな感じ。- AUTO̲INCREMENTの次の値は int(そのカラムの最⼤値) +
1- DEFAULT そのカラムに値が指定されなかった時に、暗黙にこの値を設定する。- CURRENT̲TIMESTAMPの例外を除いてリテラルのみ指定可能で、関 数の結果はDEFAULTに指定できない。 - ストレージエンジン, 圧縮, その他.. 16/144
18.
本編 カラム設計のデモケースとして掲⽰板⽤のデータモデリングをします 非正規形のテーブルからスタートし、正規形にするまでの考え⽅を⾒てい きます 17/144
19.
⼀番最初に考えること あなたの 掲⽰板システムに必要なデータは何か︖ 18/144
20.
たとえば 掲⽰板にはスレッド単位で話題が上がって それに対してコメントが付く形- 1スレッドの上限コメント数は制限したい- スレッドを⽴てるにはメールアドレスを必須にしたい- スレッドの⼀覧出⼒機能をつけたい スレの作成順にソートしたい- 最終書き込み時刻でソートしたい- スレの書き込み数でもソートしたい- スレッドのタイトルの横にコメント数を表⽰したい- 19/144
21.
考え⽅の順番 まず最初に全部⼊りで考えてみる 正規化とか考えずに必要なものを全部テーブルに詰め込んでみる 正規化⼿順に沿って5NFまで持っていく もちろん慣れていれば3NFくらいからいきなり書き始められる 20/144
22.
最初の全部⼊りテーブル設計 カラム データ例 thread̲title コードギアス亡国の巨⼈ thread̲owner
yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス 21/144
23.
参照系クエリー 新しく作成された順にスレッド⼀覧を表⽰するクエリー SELECT thread_title FROM bbs ORDER
BY thread_created DESC 22/144
24.
参照系クエリー コメント数の多い順にスレッド⼀覧を表⽰するクエリー SELECT thread_title FROM bbs ORDER
BY comment_count DESC 23/144
25.
参照系クエリー 新しくコメントされた順にスレッド⼀覧を表⽰するクエリー SELECT thread_title FROM bbs ORDER
BY last_posted DESC 24/144
26.
参照系クエリー スレッドを詳細表⽰するクエリー SELECT thread_title, thread_owner, thread_owner_email, thread_created, comment_count, last_posted, comments FROM bbs WHERE
thread_title = 'new_thread' 25/144
27.
SELECTは特 に問題なさそ うに⾒える︖ 26/144
28.
更新系クエリー スレッドを追加するためのクエリー INSERT INTO bbs
SET thread_title= 'new_thread', thread_owner= 'yoku0825', thread_owner_email= 'yoku0825@gmail.com', thread_created= '2015/04/30 19:00:00', comment_count= 1, last_posted= '2015/04/30 19:00:00', comments= '1: yoku0825 <yoku0825@gmail.com> 2015-04-30 19:00:00nThis is my first thread!' 27/144
29.
更新系クエリー コメントを追加するクエリー UPDATE bbs SET
comment_count = comment_count + 1, last_posted = NOW(), comments = CONCAT(comments, 'nn', '2: yoku0825 <yoku0825@gmail.com> 2015-04-30 19:01:00n2 get!') WHERE thread_title= 'new_thread' 28/144
30.
更新系クエリー それとも、こう︖ UPDATE bbs SET
comment_count = 2, last_posted= '2015-04-30 19:01:00', comments = '1: yoku0825 <yoku0825@gmail.com> 2015-04-30 19:00:01n This is my first thread!nn 2: yoku0825 <age> 2015-04-30 19:01:00n 2 get!' WHERE thread_title = 'new_thread'; 29/144
31.
雲⾏きが怪し くなってきま したね :) 30/144
32.
コメントの削除 どうやる︖ アプリ側で⽂字列探査して目的のコメントを削除してUPDATEする (last̲postedもがんばる) そんなばかな 31/144
33.
第1非正規形 SELECTする分には特に問題なく⾒える というかとてもシンプルで良いようにすら⾒える JOINもGROUP BYも出てこない - 更新処理が破綻している ⽂字列操作で追加、削除- ⽂字列操作はSQL外の範疇になるので、RDBMSの利点をほとんど受 けられない - 32/144
34.
それでも正規化せ ずに使いますか︖ [No/いいえ] 33/144
35.
正規化とは テーブルを リレーショナルモデルのお作法に基づいた形 に作り変える作 業 SQLはリレーショナルモデルに基づいた操作を提供する⾔語 RDBMSの機能を(フルに)使うためにはSQLを使わなければいけない SQL(だけ)で綺麗に操作するためには正規化が必要 34/144
36.
なんて⾔ってても わかりづらいので 実際に正規化して みましょう 35/144
37.
第1正規形 テーブルの中には個々の⾏を⼀意に識別できる候補キーが存在すること テーブルの全ての要素は NULLでないこと 宗教問題に近いので、軽く流します - アトミックである- アトミックでない場合はアトミックになるように分割する 36/144
38.
全ての⾏は⼀意に識別されなければいけない カラム データ例 thread̲title コードギアス亡国の巨⼈ thread̲owner
yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス このテーブルに格納された⾏を⼀意に識別するものは︖ 37/144
39.
thread̲title︖ カラム データ例 thread̲title コードギアス亡国の巨⼈ thread̲owner
yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス 同じタイトルのスレッドは存在できなくなる。 38/144
40.
thread̲id的なもの︖ カラム データ例 thread̲id 1 thread̲title
コードギアス亡国の巨⼈ thread̲owner yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス タイトルが同じだろうといくらでも投稿できる。実質制限なし。 39/144
41.
PRIMARY KEYを複雑化する︖ カラム データ例 thread̲title
コードギアス亡国の巨⼈ thread̲owner yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス タイトル, 作成者, 作成者のメールアドレスまで⼀致したら重複スレッド として扱う 40/144
42.
どれが正解︖ 同じタイトルのスレッドは存在できない タイトルが同じでもいくらでも投稿できる ある程度の情報が⼀致したら重複として扱って投稿できない 正解はどれでも良くて、これは要件との兼ね合いになる。 41/144
43.
要件を思い出す 掲⽰板にはスレッド単位で話題が上がって それに対してコメントが付く形- 1スレッドの上限コメント数は制限したい- スレッドを⽴てるにはメールアドレスを必須にしたい- スレッドの⼀覧出⼒機能をつけたい スレの作成順にソートしたい- 最終書き込み時刻でソートしたい- スレの書き込み数でもソートしたい- スレッドのタイトルの横にコメント数を表⽰したい- 42/144
44.
スレッドの重複に関する要件はない でもどれかのプライマリーキーを選ばないと、同じタイトルのスレッドが 存在した時に機能が破綻する 要件を追加しなければならない 43/144
45.
追加されるであろう要件 重複したスレッドの作成を 禁⽌する タイトルが同じなら重複として作成させない => PRIMARY
KEY (thread̲title) タイトルよりは複雑だけど重複判定はする => PRIMARY KEY (thread̲title, thread̲owner, thread̲owner̲email) - 禁⽌しない => PRIMARY KEY(thread̲id)- テーブル設計と要件定義は密接に関わっている 44/144
46.
今回は重複スレッ ドを禁⽌しない (thread̲id⽅式) を選んでみる 45/144
47.
第1正規形の話に戻ると テーブルの中には個々の⾏を⼀意に識別できる候補キーが存在すること テーブルの全ての要素は NULLでないこと 宗教問題に近いので、軽く流します - アトミックである- アトミックでない場合はアトミックになるように分割する 46/144
48.
テーブルの要素 NULLではないこと NOT NULL制約つけましょう テストケースが膨⼤に増える TRUE, FALSEの2値なら条件網羅テストケースは
2 ^ カラム数 TRUE, FALSE, NULLの3値だと条件網羅テストケースは 3 ^ カラ ム数 演算に慣れていないと問題の分析に時間がかかる パッと⾔えますか︖ TRUE and NULL => NULL FALSE and NULL => FALSE TRUE or NULL => TRUE FALSE or NULL => NULL - 47/144
49.
テーブルの要素 アトミックであること 1つの⾏の1つのカラムに複数の要素を詰め込まない こと。- これからしばらく気持ち悪いテーブル構成が並びますが、正規化の途 中ということで⼤目に⾒てください。 - 48/144
50.
1つの要素に複数の要素を詰め込んではいけない カラム データ例 thread̲id 1 thread̲title
コードギアス亡国の巨⼈ thread̲owner yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス ” n n”で区切られた 複数の コメントがcommentsカラムの1つの要素 に詰め込まれている 49/144
51.
⾏を分割して1⾏1コメントになるようにする カラム データ例1 データ例2 thread̲id
1 1 thread̲title コードギアス亡国の巨⼈ コードギアス亡国の巨⼈ thread̲owner yoku0825 yoku0825 thread̲owner̲email yoku0825@gmail.com yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 2015-11-30 22:39:02 comment̲count 10 10 last̲posted 2015-11-30 22:39:12 2015-11-30 22:39:12 comments 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス このプライマリーキーだと1スレッドに複数コメントがつけられない。 50/144
52.
プライマリーキーを伸ばす カラム データ例1 データ例2 thread̲id
1 1 thread̲title コードギアス亡国の巨⼈ コードギアス亡国の巨⼈ thread̲owner yoku0825 yoku0825 thread̲owner̲email yoku0825@gmail.com yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 2015-11-30 22:39:02 comment̲count 10 10 last̲posted 2015-11-30 22:39:12 2015-11-30 22:39:12 one̲comment 1: 名無しさん < sage > 2015-11-30 22:39:03 殺⼈教室 2: 名無しさん < sage > 2015-11-30 22:39:04 13⽇のストラトス これだとプライマリーキーが⼀意に識別するのは “あるスレッドの” “ある コメント”になる 意味が変わってしまっているので、本当はこの時点でテーブル分割が望ま しい(が、説明のためこの時点では分割せずいきます) 51/144
53.
この段階での参照クエリー 新しく作成された順にスレッド⼀覧を表⽰するクエリー SELECT thread_id /*
アンカータグでリンクを張るのに使う */, thread_title FROM bbs ORDER BY thread_created DESC スレッドを詳細表⽰するクエリー SELECT thread_title, thread_owner, thread_owner_email, thread_created, comment_count, last_posted, GROUP_CONCAT(one_comment ORDER BY one_comment ASC SEPARATOR 'n') AS comments FROM bbs WHERE thread_id = 1 /* スレッド一覧からthread_idをパラメーターでもらう */ GROUP̲CONCATはMySQL独⾃関数なので、アプリ側でループした⽅が 良い。 52/144
54.
この段階での更新系クエリー スレッドを追加するためのクエリー INSERT INTO bbs
SET thread_id= 1, thread_title= 'new_thread', thread_owner= 'yoku0825', thread_owner_email= 'yoku0825@gmail.com', thread_created= '2015/04/30 19:00:00', comment_count= 1, last_posted= '2015/04/30 19:00:00', one_comment= '1: yoku0825 <yoku0825@gmail.com> 2015-04-30 19:00:00n This is my first thread!' 53/144
55.
この段階での更新系クエリー コメントを追加するクエリー INSERT INTO bbs
SET thread_id= 1, thread_title= 'new_thread', thread_owner= 'yoku0825', thread_owner_email= 'yoku0825@gmail.com', thread_created= '2015/04/30 19:00:00', comment_count= 2, last_posted= '2015/04/30 19:01:00', one_comment= '2: yoku0825 <yoku0825@gmail.com> 2015-04-30 19:01:00n 2 get!' コメントを追加するためだけにスレッドの情報もINSERT⽂に⼊れないと いけないの︖ 54/144
56.
この段階での更新系クエリー コメントの削除 DELETE FROM bbs WHERE thread_id=
1 AND one_comment= '2: yoku0825 <yoku0825@gmail.com> 2015-04-30 19:01:00n2 get!'; WHERE句が不恰好ではあるものの、⼀応SQLでコメントを削除できるよ うになった。 55/144
57.
これで第1正規形︖ まだ書式によって区切られた複数の意味(コメント番号, コメント主, email, コメント⽇付,
コメントの本⽂)が1つの要素に詰め込まれている = アトミックではない とはいえこの時点でコメントの投稿はINSERT, コメントの削除は DELETEで直観的に操作できるようになった 56/144
58.
カラムを分割してアトミックになるようにする カラム データ例1 データ例2 thread̲id
1 1 thread̲title コードギアス亡国の巨⼈ コードギアス亡国の巨⼈ thread̲owner yoku0825 yoku0825 thread̲owner̲email yoku0825@gmail.com yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 2015-11-30 22:39:02 comment̲count 10 10 last̲posted 2015-11-30 22:39:12 2015-11-30 22:39:12 comment̲number 1 2 comment̲owner 名無しさん 名無しさん comment̲owner̲email sage sage comment̲posted 2015-11-30 22:39:03 2015-11-30 22:39:04 comment̲body 殺⼈教室 13⽇のストラトス one̲commentの代わりにcomment̲numberをプライマリーキーの⼀ 部として差し替え。 57/144
59.
変化のあったクエリー コメントを追加するクエリー INSERT INTO bbs
SET thread_id= 1, thread_title= 'new_thread', thread_owner= 'yoku0825', thread_owner_email= 'yoku0825@gmail.com', thread_created= '2015/04/30 19:00:00', comment_count= 2, last_posted= '2015/04/30 19:01:00', comment_number= 2, comment_owner = 'yoku0825', comment_owner_email = 'yoku0825@gmail.com', comment_posted = '2015-04-30 19:01:00', comment_body = '2 get!' コメントの削除 DELETE FROM bbs WHERE thread_id= 1 AND comment_number= 2 58/144
60.
これで第1正規形 レコードが⼀意に識別できる 要素にNULLを含まない 要素がアトミックである 59/144
61.
第1正規化することで変わったこと コメントの削除が(SQLで)できるようになった コメントの投稿がシンプルなINSERT⽂に その気になればコメントの内容をUPDATEで編集することもできる コメント追加のINSERTのために、スレッド本体の情報も持たせないとい けないの︖ スレッドのタイトルが編集できたとしたら、たくさんの⾏を更新しないと いけなくない︖ 60/144
62.
正規化とは(再掲) テーブルを リレーショナルモデルのお作法に基づいた形 に作り変える作 業 SQLはリレーショナルモデルに基づいた操作を提供する⾔語 RDBMSの機能を(フルに)使うためにはSQLを使わなければいけない SQL(だけ)で綺麗に操作するためには正規化が必要 61/144
63.
RDBMSの機能 トランザクションによるACID保証 制約によるデータの保証 集計関数 RDBMSの恩恵を しっかり受けるために 正規化する RDBMS
の外側 でやるところには正規化という概念はない 62/144
64.
ひとやす み 63/144
65.
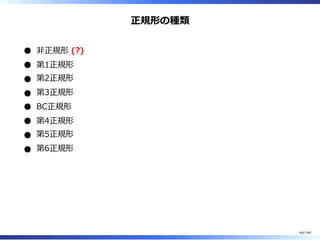
正規形の種類 非正規形 (?) 第1正規形 第2正規形 第3正規形 BC正規形 第4正規形 第5正規形 第6正規形 64/144
66.
第2正規形と第3正 規形の違いを知っ ていますか︖ [Yes/No] 65/144
67.
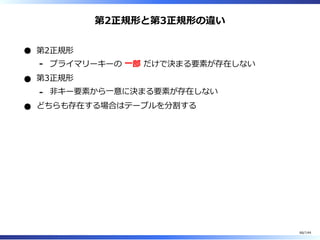
第2正規形と第3正規形の違い 第2正規形 プライマリーキーの ⼀部 だけで決まる要素が存在しない- 第3正規形 非キー要素から⼀意に決まる要素が存在しない- どちらも存在する場合はテーブルを分割する 66/144
68.
プライマリーキーの ⼀部 #とは プライマリーキーが単⼀カラムで構成されている場合、
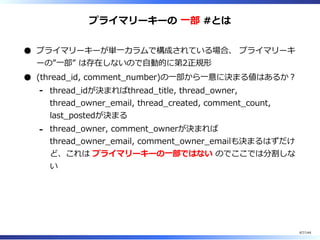
プライマリーキ ーの”⼀部” は存在しないので⾃動的に第2正規形 (thread̲id, comment̲number)の⼀部から⼀意に決まる値はあるか︖ thread̲idが決まればthread̲title, thread̲owner, thread̲owner̲email, thread̲created, comment̲count, last̲postedが決まる - thread̲owner, comment̲ownerが決まれば thread̲owner̲email, comment̲owner̲emailも決まるはずだけ ど、これは プライマリーキーの⼀部ではない のでここでは分割しな い - 67/144
69.
分割 threadテーブル カラム データ例1 thread̲id 1 thread̲title
コードギアス亡国の巨⼈ thread̲owner yoku0825 thread̲owner̲email yoku0825@gmail.com thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 thread̲idから決まるスレッドごとの属性情報をthreadテーブルとして分 離。 68/144
70.
分割 commentテーブル カラム データ例1 データ例2 thread̲id
1 1 comment̲number 1 2 comment̲owner 名無しさん 名無しさん comment̲owner̲email sage sage comment̲posted 2015-11-30 22:39:03 2015-11-30 22:39:04 comment̲body 殺⼈教室 13⽇のストラトス thread̲id, comment̲numberから決まるコメント単位の情報を commentテーブルに分離。 69/144
71.
参照クエリー 新しく作成された順にスレッド⼀覧を表⽰するクエリー SELECT thread_id /*
アンカータグでリンクを張るのに使う */, thread_title FROM thread ORDER BY thread_created DESC スレッドを詳細表⽰するクエリー SELECT thread.thread_title, thread.thread_owner, thread.thread_owner_email, thread.thread_created, thread.comment_count, thread.last_posted, comment.comment_number, comment.comment_owner, comment.comment_owner_email, comment.comment_posted, comment.comment_body FROM thread JOIN comment USING (thread_id) WHERE thread.thread_id = 1 /* スレッド一覧からthread_idをパラメーターでもらう */ ORDER BY comment.comment_number 70/144
72.
更新クエリー スレッドを追加するためのクエリー INSERT INTO thread
SET thread_id= 1, thread_title= 'new_thread', thread_owner= 'yoku0825', thread_owner_email= 'yoku0825@gmail.com', thread_created= '2015/04/30 19:00:00', comment_count= 1, last_posted= '2015/04/30 19:00:00' INSERT INTO comment SET thread_id= 1, comment_number= 1, comment_owner= 'yoku0825', comment_owner_email= 'yoku0825@gmail.com', comment_posted= '2015/04/30 19:00:00', comment_body= 'This is my first thread!' 71/144
73.
更新クエリー コメントを追加するクエリー INSERT INTO comment
SET thread_id= 1, comment_number= 1, comment_owner= 'yoku0825', comment_owner_email= 'yoku0825@gmail.com', comment_posted= '2015/04/30 19:00:00', comment_body= 'This is my first thread!' UPDATE thread SET comment_count= comment_count + 1, last_posted = '2015/04/30 19:00:00' WHERE thread_id = 1 72/144
74.
これで第2正規形 プライマリーキーの⼀部から⼀意に決まる値は別のテーブルに分割する その時の”プライマリーキーの⼀部”が分割先テーブルのプライマリー キーになる - 73/144
75.
第2正規化することで変わったこと スレッドはスレッド、コメントはコメントで独⽴したテーブルに⼊ったの で コメントを追加するためだけにスレッドの情報を何度も何度も INSERTしなくてよくなった - コメントのないスレッドを作ることが出来てしまう- スレッドのタイトルを変えるようなことがあっても、コメントのテー ブルには影響を及ぼさない - 新しいスレッドを作成するために、スレッドの作成と最初のコメント を別々にINSERTする必要がある。 - 新しいコメントを投稿するたびに、スレッドの更新時刻なども更新し ないといけない。 - 74/144
76.
第2正規形と第3正規形の違い 第2正規形 プライマリーキーの ⼀部 だけで決まる要素が存在しない- 第3正規形 非キー要素から⼀意に決まる要素が存在しない- どちらも存在する場合はテーブルを分割する 75/144
77.
非キー属性から⼀意に決まる #とは thread̲ownerが決まればthread̲owner̲emailが決まる︖ comment̲ownerが決まればcomment̲owner̲emailが決まる︖ ここでも要件との兼ね合い(ユーザー登録させるの︖ とか)になってくる 決まることにして進めます 決まらない場合、これは非キー属性から
⼀意に決まらない ので、分 割せずに第3正規形ということになります。 - 76/144
78.
分割 threadテーブル カラム データ例1 thread̲id 1 thread̲title
コードギアス亡国の巨⼈ thread̲owner yoku0825 thread̲created 2015-11-30 22:39:02 comment̲count 10 last̲posted 2015-11-30 22:39:12 77/144
79.
分割 commentテーブル カラム データ例1 データ例2 thread̲id
1 1 comment̲number 1 2 comment̲owner 名無しさん 名無しさん comment̲posted 2015-11-30 22:39:03 2015-11-30 22:39:04 comment̲body 殺⼈教室 13⽇のストラトス 78/144
80.
分割 userテーブル カラム データ例1 データ例2 user̲id
yoku0825 名無しさん user̲email yoku0825@gmail.com sage 79/144
81.
これで第3正規形 プライマリーキー以外のカラムが決まると⾃動的に決まるカラムがあった 場合はテーブルを分割する この時の変数になるカラムが、分割先テーブルのプライマリーキー- 80/144
82.
第3正規化することで変わったこと スレッドを⽴てたことのない、コメントを投稿したことのないユーザーが 存在できるようになった 先にユーザー登録をしておかなくてはいけなくなった- ユーザーがメールアドレスを変更してもスレッドテーブルやコメントテー ブルを操作する必要はなくなった 81/144
83.
BC正規形 非キー要素からプライマリーキーの⼀部が⼀意に決まる場合はテーブル分 割 第2正規化の⽮印が逆になったパターン この掲⽰板テーブルは第3正規化した時点でBC正規形でもある 82/144
84.
第4正規形, 第5正規形 複合プライマリーキー のみ
で構成されたテーブルの分割をする あんまりお目にかからなくて済む(第3正規形を作って、複合プライマリー キーのみのテーブルができることは少ない) このスキーマは第3正規化した時点で第5正規形(複合プライマリーキーだ けのテーブルがないから) 83/144
85.
個⼈的テーブル設計まとめ 必要なものを全部洗いだしてから分割していく⽅が楽 プライマリーキーに着目して、 このテーブルでは”何を主体として扱うのか”- その属性は”どの主体の属性なのか”- でテーブルを振り分ける- 84/144
86.
正規化の話おしまい ここからこの掲⽰板の 話はしばらく忘れます 85/144
87.
だいじなこと ⼀番⼤事なのは 第1正規化 カラムの中⾝を関数処理して取り出さないといけないようなものはあらか じめカラムを分けて設計すること 関数処理を通すとインデックスが最適な形で使えない- アトミックでないものを⼊れるなら、検索条件にしたり集計対象にしたり してはいけない 単にDurabilityを保証できるBLOBとして使うのも(オススメしないけ ど)ありといえばあり - 常にアプリケーション側でデシリアライズするならJSONとかが⼊っ ててもいい - 86/144
88.
ひとやす み 87/144
89.
都市伝説 MySQLを使うなら 遅くなるから 正規化してはいけない 確かに遅くなる
ケースも ある(特に、5.5より前の古いバージョン) 何故 RDBMSを扱う上で正しい はずの正規化でRDBMSであるMySQLの レスポンスが悪くなるのか︖ MySQLはJOINが遅い︖ 正規化のプロセスを⾒てきましたけど、この通りに操作していたら プライマリーキーで結合しますよね︖ プライマリーキーを使った結合なら ⼤概の場合 ちゃんとした速度 で動きますが、NLJなので数百万件に達すると遅くなります。 JOINすると遅くなるのは多くの場合 ソート 、きれいにインデック スを使いきれていないケースです。 - 88/144
90.
前提 判りやすく説明するために多少の嘘を含んでいます。 MySQLは原則 1つのテーブルにつき同時に1つのインデックスしか使えま せん。 MySQLはおばかさんだと⾔われる所以。。- 他のDBMSは知りませんが、使えるらしいです。- 説明のモデルは5.5がベースです。 5.6, 5.7とオプティマイザーはかなりよくなっています。- 89/144
91.
インデックスの設計 インデックスとは ソート済みの- ある程度のメタデータを持たせた- データの複製(サブセット)- データの複製であるため、 インデックスだけで必要な情報が集まる場合は、テーブル本体をスキ ャンしなくても良い(covering index) - 更新系のDML(INSERT, UPDATE,
DELETE)の際には常にオーバーヘ ッドが加わる - テーブル本体の容量とは別に容量を必要とする- 90/144
92.
カーディナリティーとは そのインデックスに含まれる”取りうる値のバリエーション”の数 均等に分散した都道府県のカーディナリティーは47 都府なら3 - ⼤きければ⼤きいほど、そのインデックスを使って絞り込んだ時に返 ってくる結果セットが⼩さくなることが 期待できる 均等に分散しているなら、カーディナリティーが47のインデック スで抽出した場合の期待値は 総レコード件数
/ 47 ただし、レコードが本当に均等に分散しているとは限らない 1億3000万レコードが都道府県カラムを持っていたとしても、東京 と島根ではレコード件数に差が出る - 91/144
93.
インデックスを張っていないカラムでWHEREした時の動作をトラ ンプでたとえてみると ここに100枚のトランプの束があります 何が何枚あるかはわかりません ⼊ってない札があるかもしれません この中からハートのAを全て⾒つけ出してください SQLで書くと、SELECT * FROM
card WHERE suite= 'heart' AND number= 1 92/144
94.
どうや る︖ 93/144
95.
こうやる トランプの⼀番上の札をめくって それがハートのAかどうか確認して ハートのAなら左⼿にとっておいて 違ったらテーブルに伏せておいて それを100枚目まで繰り返す 94/144
96.
これがテーブルスキャン mysql55> explain SELECT
* FROM card WHERE suite= 'heart' AND number= 1; +----+-------------+-------+------+---------------+------+---------+------+------+-------------+ | id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra | +----+-------------+-------+------+---------------+------+---------+------+------+-------------+ | 1 | SIMPLE | card | ALL | NULL | NULL | NULL | NULL | 100 | Using where | +----+-------------+-------+------+---------------+------+---------+------+------+-------------+ 1 row in set (0.02 sec) type: ALL がテーブルスキャン(=テーブルの先頭から末尾まで全スキャン )を, rows: 100が100⾏フェッチしたことを⽰している 95/144
97.
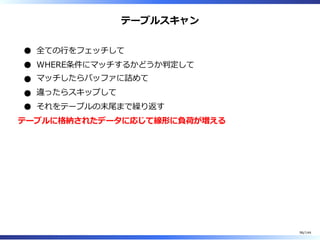
テーブルスキャン 全ての⾏をフェッチして WHERE条件にマッチするかどうか判定して マッチしたらバッファに詰めて 違ったらスキップして それをテーブルの末尾まで繰り返す テーブルに格納されたデータに応じて線形に負荷が増える 96/144
98.
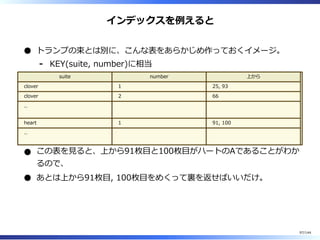
インデックスを例えると トランプの束とは別に、こんな表をあらかじめ作っておくイメージ。 KEY(suite, number)に相当- suite number
上から clover 1 25, 93 clover 2 66 .. heart 1 91, 100 .. この表を⾒ると、上から91枚目と100枚目がハートのAであることがわか るので、 あとは上から91枚目, 100枚目をめくって裏を返せばいいだけ。 97/144
99.
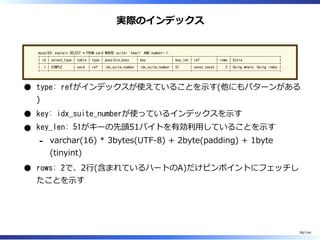
実際のインデックス mysql55> explain SELECT
* FROM card WHERE suite= 'heart' AND number= 1; +----+-------------+-------+------+------------------+------------------+---------+-------------+------+--------------------------+ | id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra | +----+-------------+-------+------+------------------+------------------+---------+-------------+------+--------------------------+ | 1 | SIMPLE | card | ref | idx_suite_number | idx_suite_number | 51 | const,const | 2 | Using where; Using index | +----+-------------+-------+------+------------------+------------------+---------+-------------+------+--------------------------+ type: refがインデックスが使えていることを⽰す(他にもパターンがある ) key: idx_suite_numberが使っているインデックスを⽰す key_len: 51がキーの先頭51バイトを有効利⽤していることを⽰す varchar(16) * 3bytes(UTF-8) + 2byte(padding) + 1byte (tinyint) - rows: 2で、2⾏(含まれているハートのA)だけピンポイントにフェッチし たことを⽰す 98/144
100.
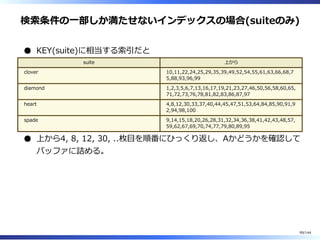
検索条件の⼀部しか満たせないインデックスの場合(suiteのみ) KEY(suite)に相当する索引だと suite 上から clover 10,11,22,24,25,29,35,39,49,52,54,55,61,63,66,68,7 5,88,93,96,99 diamond
1,2,3,5,6,7,13,16,17,19,21,23,27,46,50,56,58,60,65, 71,72,73,76,78,81,82,83,86,87,97 heart 4,8,12,30,33,37,40,44,45,47,51,53,64,84,85,90,91,9 2,94,98,100 spade 9,14,15,18,20,26,28,31,32,34,36,38,41,42,43,48,57, 59,62,67,69,70,74,77,79,80,89,95 上から4, 8, 12, 30, ..枚目を順番にひっくり返し、Aかどうかを確認して バッファに詰める。 99/144