深層⽣生成モデルによる表現学習
Preferred  Networks
岡野原 ⼤大輔
hillbig@preferred.jp
2016/9/29
IIBMP2016(第五回⽣生命医薬情報学連合⼤大会)
ディープラーニング(深層学習)とは
l 層が深く、幅も広いニューラルネットワーク
を利利⽤用した機械学習⼿手法
l 2012年年の⼤大ブレーク以来、研究コミュニティ
のみならず産業界に多く使われてきた
– 2014〜~2015年年中に出された関連論論⽂文数は1500を超える*
l 画像認識識、⾳音声認識識などで劇的な精度度向上を果たし、そ
の多くが既に実⽤用化されている
l ディープラーニングは⾮非線型かつ階層的な
⽣生成モデルとしても利利⽤用することができる
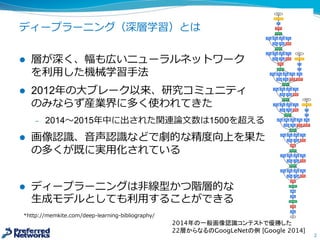
2
2014年の一般画像認識コンテストで優勝した
22層からなるのGoogLeNetの例 [Google 2014]
*http://memkite.com/deep-‐‑‒learning-‐‑‒bibliography/
ディープラーニングの基本計算
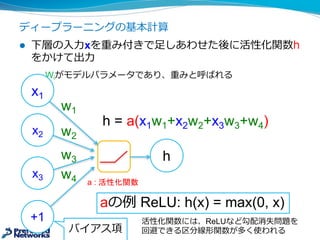
l 下層の⼊入⼒力力xを重み付きで⾜足しあわせた後に活性化関数h
をかけて出⼒力力
– Wiがモデルパラメータであり、重みと呼ばれる
x1
x2
x3
+1
w1
w2
w3
w4
h  =  a(x1w1+x2w2+x3w3+w4)
h
aの例例 ReLU:  h(x)  =  max(0,  x)
a  :  活性化関数
バイアス項
活性化関数には、ReLUなど勾配消失問題を
回避できる区分線形関数が多く使われる
ディープラーニングの基本計算
4
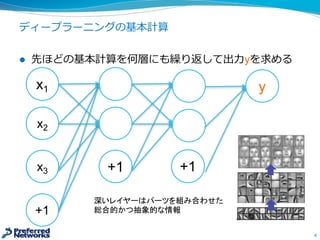
l 先ほどの基本計算を何層にも繰り返して出⼒力力yを求める
x1
x2
x3
+1
+1 +1
y
深いレイヤーはパーツを組み合わせた
総合的かつ抽象的な情報
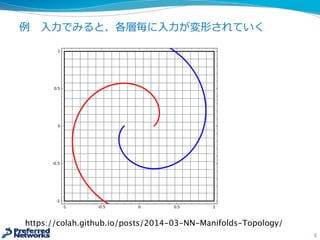
例例 ⼊入⼒力力でみると、各層毎に⼊入⼒力力が変形されていく
5
https://colah.github.io/posts/2014-03-NN-Manifolds-Topology/
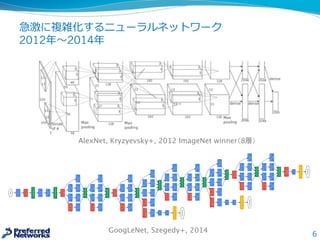
急激に複雑化するニューラルネットワーク
2012年年〜~2014年年
6
AlexNet, Kryzyevsky+, 2012 ImageNet winner(8層)
GoogLeNet, Szegedy+, 2014
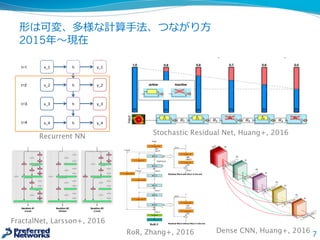
形は可変、多様な計算⼿手法、つながり⽅方
2015年年〜~現在
x_1 h y_1
x_2 h y_2
x_3 h y_3
	
x_4 h y_4
BPTT	length	=	3
Input	word OutputRecurrent	state
Stochastic Residual Net, Huang+, 2016
Recurrent NN
FractalNet, Larsson+, 2016
RoR, Zhang+, 2016 7
Dense CNN, Huang+, 2016
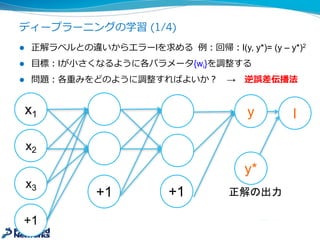
ディープラーニングの学習 (1/4)
l 正解ラベルとの違いからエラーlを求める 例例:回帰:l(y,  y*)=  (y  – y*)2
l ⽬目標:Iが⼩小さくなるように各パラメータ{wi}を調整する
l 問題:各重みをどのように調整すればよいか? → 誤差逆伝播法
x1
x2
x3
+1
+1 +1 正解の出力
ly
y*
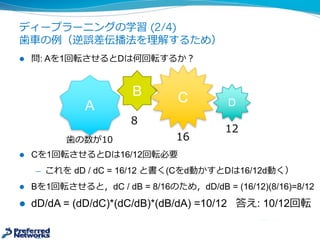
ディープラーニングの学習 (2/4)
⻭歯⾞車車の例例(誤差逆伝播法を理理解するため)
l 問:  Aを1回転させるとDは何回転するか?
l Cを1回転させるとDは16/12回転
̶— これを dD /  dC =  16/12  と書く(Cをd動かすとDは16/12d動く)
l Bを1回転させると,dC /  dB  =  8/16のため,dD/dB  =  (16/12)(8/16)=8/12
l dD/dA =  (dD/dC)*(dC/dB)*(dB/dA)  =10/12      答え:  10/12回転
A
B C
⻭歯の数が10
8
16
D
12
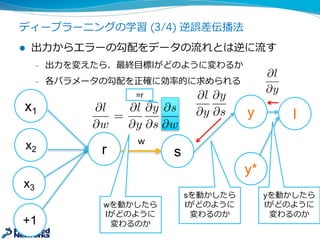
ディープラーニングの学習 (3/4) 誤差逆伝播法
l 出⼒力力からエラーの勾配をデータの流流れとは逆に流流す
– 出⼒力力を変えたら、最終⽬目標lがどのように変わるか
– 各パラメータについての勾配を正確に求められる
x1
x2
x3
+1
r s
ly
y*
@l
@y
@l
@y
@y
@s
yを動かしたら
lがどのように
変わるのか
sを動かしたら
lがどのように
変わるのか
wを動かしたら
lがどのように
変わるのか
w
@l
@w
=
@l
@y
@y
@s
@s
@w
=r
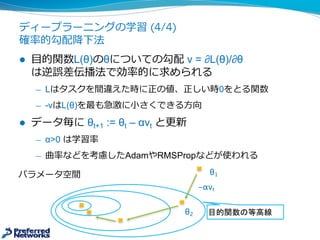
ディープラーニングの学習 (4/4)
確率率率的勾配降降下法
l ⽬目的関数L(θ)のθについての勾配 v  =  ∂L(θ)/∂θ
は誤差逆伝播法で効率率率的に求められる
̶— Lはタスクを間違えた時に正の値、正しい時0をとる関数
̶— -­vはL(θ)を最も急激に⼩小さくできる⽅方向
l データ毎に θt+1 :=  θt – αvt と更更新
̶— α>0  は学習率率率
̶— 曲率率率などを考慮したAdamやRMSPropなどが使われる
パラメータ空間
目的関数の等高線
-αv1
θ1
θ2
誤差逆伝播法は強⼒力力
l 誤差逆伝播法は最終的な⽬目的関数の各パラメータや⼊入⼒力力
についての勾配を正確に求められる
̶— ある⽬目的関数の値を変えるために各パラメータをどれだけ動か
せばよいのかが正確にわかる
l 誤差逆伝播法は前向き計算と同じ計算量量
̶— パラメータ数に対して計算量量は線形
l どれだけ複雑な計算グラフであっても計算できる
̶— 1000層を超えても,ループがあっても、分岐があっても⼤大丈夫
l 確率率率層,つまり確率率率変数のサンプリングを含んでも誤差
逆伝播法を使って勾配を求められる⇒次章以降降
なぜディープラーニングがうまくいくのか?
Linの仮説 [Lin+ 16]
l なぜディープラーニングがこれほど世の中の多くの問題にうまく適
⽤用(特に認識識)できるのか?
l ⇒世の中の問題に次の特徴がみられるから
1. 低次性
̶— 知られている物理理現象の変数間の相互作⽤用の次数は2〜~4
2. 局所相互作⽤用性
̶— 相互作⽤用の数は変数の数に対して線形にしか増えない
3. 対称性
̶— 画像の対称性、化学反応の対称性などで変数の⾃自由度度が低い
4. マルコフ性
̶— ⽣生成過程は直前の状態のみに依存する
13/50
認識識と⽣生成 (1/2)
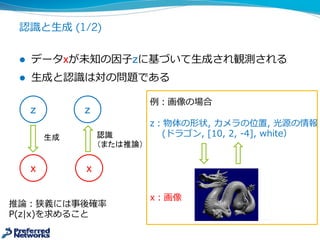
l データxが未知の因⼦子zに基づいて⽣生成され観測される
l ⽣生成と認識識は対の問題である
z
x
例例:画像の場合
z:物体の形状,  カメラの位置,  光源の情報
(ドラゴン,  [10,  2,  -‐‑‒4],  white)
x:画像
生成
z
x
認識
(または推論)
推論論:狭義には事後確率率率
P(z|x)を求めること
認識識と⽣生成(2/2)
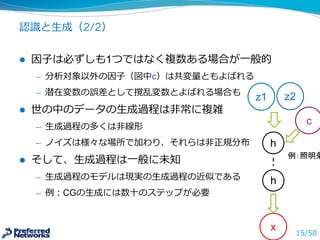
l 因⼦子は必ずしも1つではなく複数ある場合が⼀一般的
̶— 分析対象以外の因⼦子(図中c)は共変量量ともよばれる
̶— 潜在変数の誤差として撹乱変数とよばれる場合も
l 世の中のデータの⽣生成過程は⾮非常に複雑
̶— ⽣生成過程の多くは⾮非線形
̶— ノイズは様々な場所で加わり、それらは⾮非正規分布
l そして、⽣生成過程は⼀一般に未知
̶— ⽣生成過程のモデルは現実の⽣生成過程の近似である
̶— 例例:CGの⽣生成には数⼗十のステップが必要
15/50
z1
x
c
h
z2
h
例例:⽣生物情報における⽣生成と推論論問題
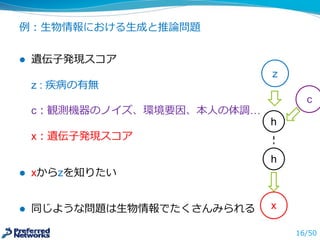
l 疾病と遺伝⼦子発現スコアの関係
z  :  疾病の有無
c:観測機器のノイズ、環境要因、本⼈人の体調…
x:遺伝⼦子発現スコア
l xからzを知りたい
l 同じような問題は⽣生物情報でたくさんみられる
16/50
z
c
h
h
x
なぜ⽣生成モデルを扱うのか
l より正確な認識識,推論論をするため
̶— ⽣生成過程が分かっていれば、認識識、推論論をより正確にできる
̶— 「作ってみせることができなければ理理解したとはいえない」
リチャード・ファインマン
̶— 「画像認識識をしたければまずレンダリングを勉強せよ」
ジェフリー・ヒントン
l そして、⼤大量量の教師なしデータxを活⽤用することができる
̶— ⽣生成過程の学習(獲得)はxだけを使って実現可能
̶— その過程を逆向きにたどれば,xからzを推定できる
17/50
⽣生物情報にみられる問題
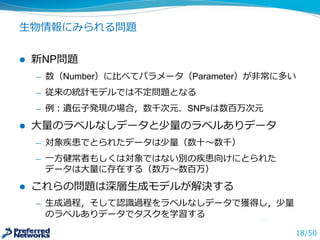
l 新NP問題
̶— 数(Number)に⽐比べてパラメータ(Parameter)が⾮非常に多い
̶— 従来の統計モデルでは不不定問題となる
̶— 例例:遺伝⼦子発現の場合,数千次元.SNPsは数百万次元
l ⼤大量量のラベルなしデータと少量量のラベルありデータ
̶— 対象疾患でとられたデータは少量量(数⼗十〜~数千)
̶— ⼀一⽅方健常者もしくは対象ではない別の疾患向けにとられた
データは⼤大量量に存在する(数万〜~数百万)
l これらの問題は深層⽣生成モデルが解決する
̶— ⽣生成過程,そして認識識過程をラベルなしデータで獲得し,少量量
のラベルありデータでタスクを学習する
18/50
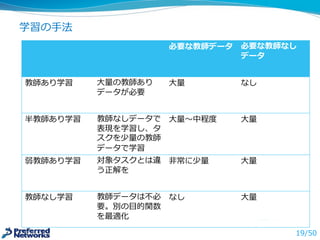
学習の⼿手法
19/50
必要な
教師データ
必要な
教師なし
データ
教師あり学習 ⼤大量量の教師ありデータ
が必要
⼤大量量 なし
半教師あり学習 教師なしデータで表現
を学習し、タスクを少
量量の教師データで学習
⼤大量量〜~中程度度 ⼤大量量
弱教師あり学習 ⾮非常に少量量のデータ
(ラベルあたり数個)
で学習
⾮非常に少量量 ⼤大量量
教師なし学習 教師データは不不必要。
⽬目的は対数尤度度最⼤大化
など
なし ⼤大量量
易易
難
従来の代表的な⽣生成モデル
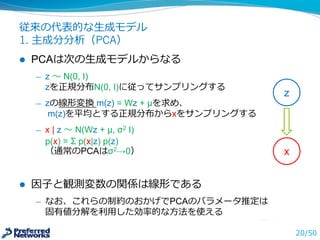
1. 主成分分析(PCA)
l PCAは次の⽣生成モデルからなる
̶— z 〜~ N(0,  I)
zを正規分布N(0,  I)に従ってサンプリングする
̶— zの線形変換 m(z)  =  Wz +  μを求め、
m(z)を平均とする正規分布からxをサンプリングする
̶— x  |  z 〜~ N(Wz +  μ,  σ2 I)
p(x)  =  Σ p(x|z)  p(z)  
(通常のPCAはσ2→0)
l 因⼦子と観測変数の関係は線形である
̶— なお、これらの制約のおかげでPCAのパラメータ推定は
固有値分解を利利⽤用した効率率率的な⽅方法を使える
20/50
z
x
従来の代表的な⽣生成モデル
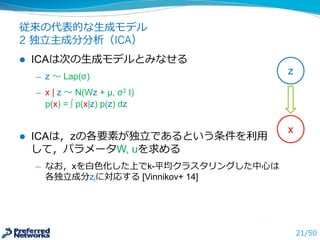
2 独⽴立立主成分分析(ICA)
l ICAは次の⽣生成モデルとみなせる
̶— z  〜~ Lap(σ)  
̶— x  |  z 〜~ N(Wz +  μ,  σ2 I)
p(x)  =  ∫ p(x|z)  p(z)  dz
l ICAは,zの各要素が独⽴立立であるという条件を利利⽤用
して,パラメータW,  uを求める
̶— なお,xを⽩白⾊色化した上でk-­平均クラスタリングした中⼼心は
各独⽴立立成分ziに対応する [Vinnikov+  14]
21/50
z
x
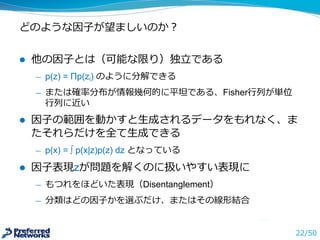
どのような因⼦子が望ましいのか?
l 他の因⼦子とは(可能な限り)独⽴立立である
̶— p(z)  =  Πp(zi) のように分解できる
̶— または確率率率分布が情報幾何的に平坦である、Fisher⾏行行列列が単位
⾏行行列列に近い
l 因⼦子の範囲を動かすと⽣生成されるデータをもれなく、ま
たそれらだけを全て⽣生成できる
̶— p(x)  =  ∫ p(x|z)p(z)  dz となっている
l 因⼦子表現zが問題を解くのに扱いやすい表現に
̶— もつれをほどいた表現(Disentanglement)
̶— 分類はどの因⼦子かを選ぶだけ、またはその線形結合
22/50
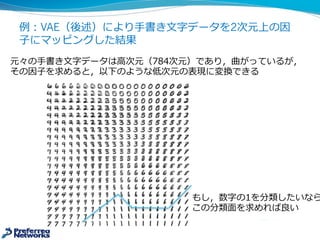
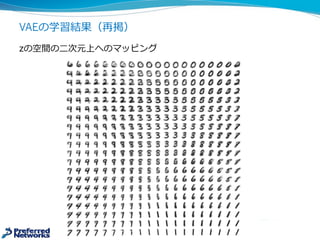
例例:VAE(後述)により⼿手書き⽂文字データを2次元上の因
⼦子にマッピングした結果
元々の⼿手書き⽂文字データは⾼高次元(784次元)であり,曲がっているが,
その因⼦子を求めると,以下のような低次元の表現に変換できる
もし,数字の1を分類したいなら
この分類⾯面を求めれば良良い
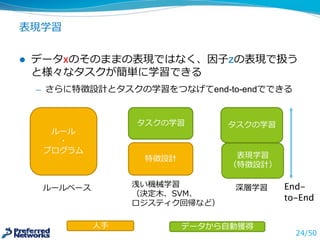
表現学習
l データxのそのままの表現ではなく、因⼦子zの表現で扱う
と様々なタスクが簡単に学習できる
̶— さらに特徴設計とタスクの学習をつなげてend-­to-­endでできる
24/50
特徴設計
ルール
・
プログラム
タスクの学習
ルールベース 浅い機械学習
(決定⽊木、SVM、
ロジスティク回帰など)
深層学習
タスクの学習
表現学習
(特徴設計)
⼈人⼿手 データから⾃自動獲得
End-
to-End
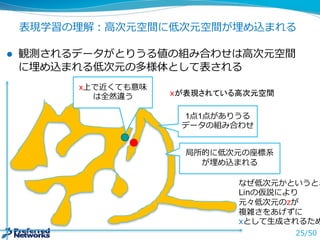
表現学習の理理解:⾼高次元空間に低次元空間が埋め込まれる
l 観測されるデータがとりうる値の組み合わせは⾼高次元空間
に埋め込まれる低次元の多様体として表される
25/50
xが表現されている高次元空間
1点1点がありうる
データの組み合わせ
x上で近くても意味
は全然違う
なぜ低次元かというと、
Linの仮説により
元々低次元のzが
複雑さをあげずに
xとして⽣生成されるため
局所的に低次元の座標系
が埋め込まれる
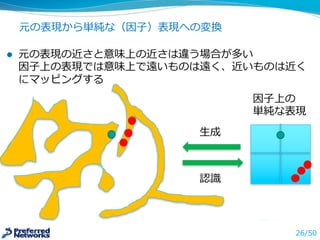
元の表現から単純な(因⼦子)表現への変換
26/50
⽣生成
認識識
因⼦子上の
単純な表現
l 元の表現の近さと意味上の近さは違う場合が多い
因⼦子上の表現では意味上で遠いものは遠く、近いものは近く
にマッピングする
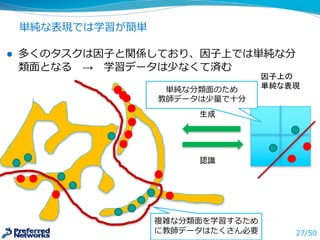
単純な表現では学習が簡単
27/50
生成
認識
因子上の
単純な表現
l 多くのタスクは因⼦子と関係しており、因⼦子上では単純な分
類⾯面となる → 学習データは少なくて済む
複雑な分類⾯面を学習するため
に教師データはたくさん必要
単純な分類⾯面のため
教師データは少量量で⼗十分
深層⽣生成モデル
深層⽣生成モデルを紹介
l 詳しく説明
̶— VAE:変分⾃自⼰己符号化器
̶— GAN:敵対的⽣生成モデル
l 重要だが今回は省省略略
̶— ⾃自⼰己回帰モデル
̶— エネルギーモデル
̶— モーメントマッチングモデル
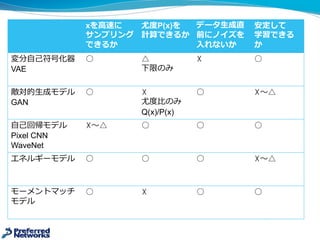
深層⽣生成モデルとして望ましい性質
l P(x)に従ってxを⾼高速にサンプリングできる
̶— 例例えば,ボルツマンマシンなどはサンプリング時はMCMCが必
要で遅いためサンプリング⽬目的に使えない
l 尤度度 P(x)を計算できる
̶— P(x)を陽に計算できない場合も存在する
̶— P(x)の代わりにその下限L(x)を出⼒力力するモデルもある
l データの⽣生成直前にノイズを⼊入れない
̶— xに近い場所でデータとはノイズを⼊入れるモデルの場合、⾼高次元
データではぼやけたデータになる
̶— ノイズをいれない場合,尤度度の勾配計算が難しくなる
xを⾼高速に
サンプリング
できるか
尤度度P(x)を
計算できるか
データ⽣生成直
前にノイズを
⼊入れないか
安定して
学習できる
か
変分⾃自⼰己符号化器
VAE
○ △
下限のみ
☓ ○
敵対的⽣生成モデル
GAN
○ ☓
尤度度⽐比のみ
Q(x)/P(x)
○ ☓〜~△
⾃自⼰己回帰モデル
Pixel  CNN
WaveNet
☓〜~△ ○ ○ ○
エネルギーモデル ○ ○ ○ ☓〜~△
モーメントマッチ
モデル
○ ☓ ○ ○
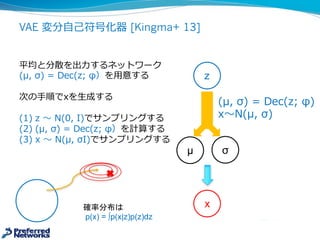
VAE 変分⾃自⼰己符号化器 [Kingma+ 13]
z
μ
(μ,  σ)  =  Dec(z;  φ)
x〜~N(μ,  σ)
σ
x
平均と分散を出⼒力力するネットワーク
(μ,  σ)  =  Dec(z;  φ)を⽤用意する
次の⼿手順でxを⽣生成する
(1) z  〜~ N(0,  I)でサンプリングする
(2) (μ,  σ)  =  Dec(z;  φ)を計算する
(3) x 〜~ N(μ,  σI)でサンプリングする
確率分布は
p(x)  =  ∫p(x|z)p(z)dz
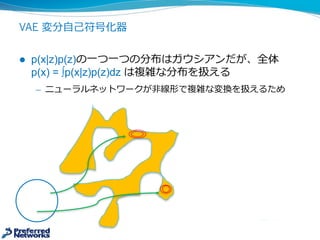
VAE 変分⾃自⼰己符号化器
l p(x|z)p(z)の⼀一つ⼀一つの分布はガウシアンだが、全体
p(x)  =  ∫p(x|z)p(z)dz は複雑な分布を扱える
̶— ニューラルネットワークが⾮非線形で複雑な変換を扱えるため
VAE 変分⾃自⼰己符号化器
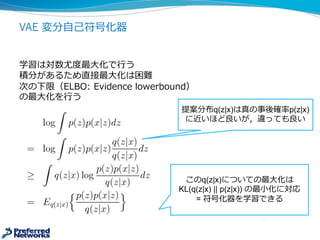
学習は対数尤度度最⼤大化で⾏行行う
積分があるため直接最⼤大化は困難
次の下限(ELBO:  Evidence  lowerbound)
の最⼤大化を⾏行行う
提案分布q(z|x)は真の事後確率率率p(z|x)
に近いほど良良いが,違っても良良い
このq(z|x)についての最⼤大化は
KL(q(z|x)  ||  p(z|x))  の最⼩小化に対応
=  符号化器を学習できる
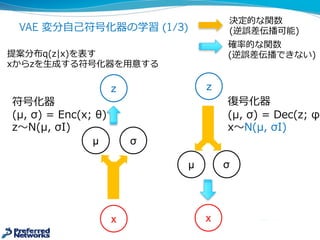
VAE 変分⾃自⼰己符号化器の学習 (1/3)
z
μ
復復号化器
(μ,  σ)  =  Dec(z;  φ)
x〜~N(μ,  σI)
σ
x
z
μ σ
x
符号化器
(μ,  σ)  =  Enc(x;  θ)
z〜~N(μ,  σI)
提案分布q(z|x)を表す
xからzを⽣生成する符号化器を⽤用意する
決定的な関数
(逆誤差伝播可能)
確率率率的な関数
(逆誤差伝播できない)
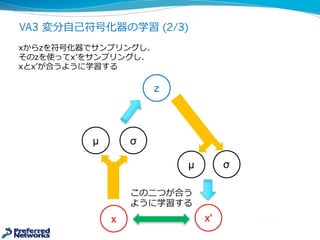
VA3 変分⾃自⼰己符号化器の学習 (2/3)
μ σ
x'
z
μ σ
x
この⼆二つが合う
ように学習する
xからzを符号化器でサンプリングし、
そのzを使ってxʼ’をサンプリングし、
xとxʼ’が合うように学習する
=さきほどの変分下限の最⼤大化
KL(q(z|x)||p(z))
の最⼩小化も同時にする
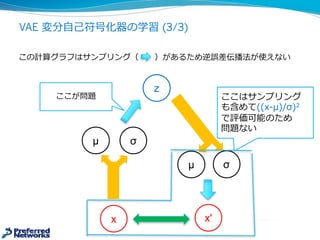
VAE 変分⾃自⼰己符号化器の学習 (3/3)
この計算グラフはサンプリング( )があるため誤差逆伝播法が使えない
ここはサンプリング
も含めて((x-‐‑‒μ)/σ)2
で評価可能のため
問題ない
μ σ
x'
z
μ σ
x
ここが問題
VAE 変分⾃自⼰己符号化器の学習 (3/3)
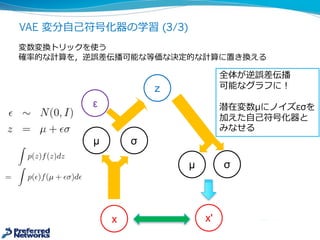
変数変換トリックを使う
確率率率的な計算を,逆誤差伝播可能な等価な決定的な計算に置き換える
μ σ
x'
z
μ σ
x
ε
全体が逆誤差伝播
可能なグラフに!
潜在変数μにノイズεσを
加えた⾃自⼰己符号化器と
みなせる
VAEの学習結果(再掲)
zの空間の⼆二次元上へのマッピング
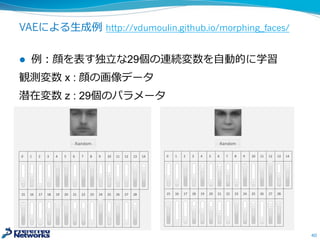
VAEによる⽣生成例例 http://vdumoulin.github.io/morphing_faces/
l 例例:顔を表す独⽴立立な29個の連続変数を⾃自動的に学習
観測変数 x  :  顔の画像データ
潜在変数 z  :  29個のパラメータ
40
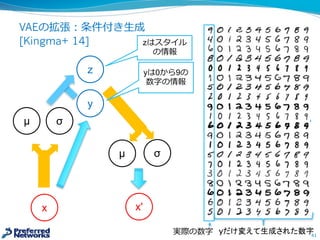
VAEの拡張:条件付き⽣生成
[Kingma+ 14]
41
μ σ
x'
z
μ σ
x
y
yは0から9の
数字の情報
zはスタイル
の情報
実際の数字 yだけ変えて生成された数字
複数の確率率率層を持つVAE
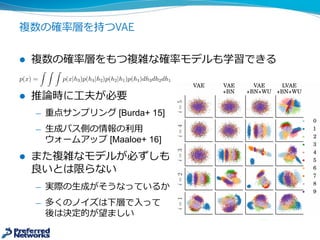
l 複数の確率率率層をもつ複雑な確率率率モデルも学習できる
l 推論論時に⼯工夫が必要
̶— 重点サンプリング [Burda+  15]
̶— ⽣生成パス側の情報の利利⽤用
ウォームアップ [Maaloe+  16]
l また複雑なモデルが必ずしも
良良いとは限らない
̶— 実際の⽣生成がそうなっているか
̶— 多くのノイズは下層で⼊入って
後は決定的が望ましい
獲得された表現は学習の役に⽴立立つのか? (1/2)
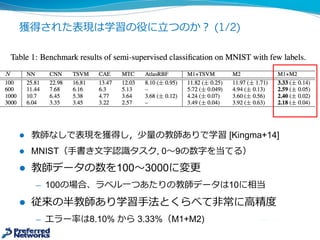
l 教師なしで表現を獲得し,少量量の教師ありで学習 [Kingma+14]
l MNIST(⼿手書き⽂文字認識識タスク,  0〜~9の数字を当てる)
l 教師データの数を100〜~3000に変更更
̶— 100の場合、ラベル⼀一つあたりの教師データは10に相当
l 従来の半教師あり学習⼿手法とくらべて⾮非常に⾼高精度度
̶— エラー率率率は8.10%  から 3.33%(M1+M2)  
獲得された表現は学習の役に⽴立立つのか? (2/2)
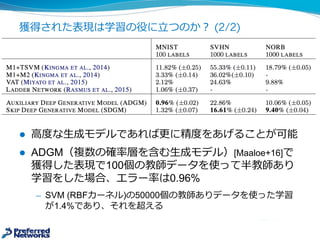
l ⾼高度度な⽣生成モデルであれば更更に精度度をあげることが可能
l ADGM(複数の確率率率層を含む⽣生成モデル)[Maaloe+16]で
獲得した表現で100個の教師データを使って半教師あり
学習をした場合、エラー率率率は0.96%
̶— SVM  (RBFカーネル)の50000個の教師ありデータを使った学習
が1.4%であり、それを超える
VAEの問題点
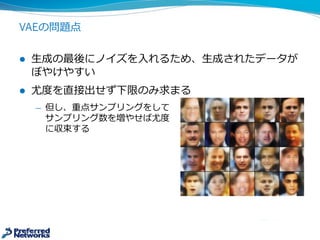
l ⽣生成の最後にノイズを⼊入れるため、⽣生成されたデータが
ぼやけやすい
l 尤度度を直接出せず下限のみ求まる
̶— 但し、重点サンプリングをして
サンプリング数を増やせば尤度度
に収束する
GAN(Generative Adversarial Net)敵対的⽣生成モデル
[Goodfellow+14]
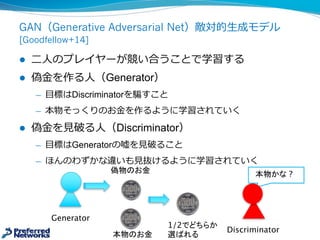
l ⼆二⼈人のプレイヤーが競い合うことで学習する
l 偽⾦金金を作る⼈人(Generator)
̶— ⽬目標はDiscriminatorを騙すこと
̶— 本物そっくりのお⾦金金を作るように学習されていく
l 偽⾦金金を⾒見見破る⼈人(Discriminator)
̶— ⽬目標はGeneratorの嘘を⾒見見破ること
̶— ほんのわずかな違いも⾒見見抜けるように学習されていく
Generator
本物のお⾦金金
Discriminator
本物かな ?偽物のお⾦金金
1/2でどちらか
選ばれる
GAN 敵対的⽣生成モデル
z
x =  G(z)
x
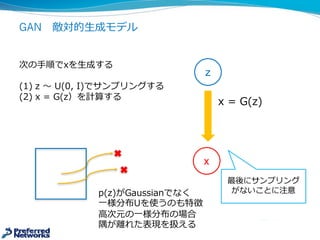
次の⼿手順でxを⽣生成する
(1) z  〜~ U(0,  I)でサンプリングする
(2) x  =  G(z)を計算する
最後にサンプリング
がないことに注意p(z)がGaussianでなく
⼀一様分布Uを使うのも特徴
⾼高次元の⼀一様分布の場合
隅が離離れた表現を扱える
GAN 敵対的⽣生成モデルの学習
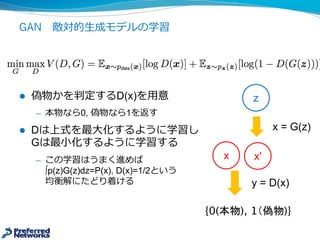
l 偽物かを判定するD(x)を⽤用意
̶— 本物なら1,  偽物なら0を返す
l Dは上式を最⼤大化するように学習し
Gは最⼩小化するように学習する
̶— この学習はうまく進めば
∫p(z)G(z)dz=P(x),  D(x)=1/2という
均衡解にたどり着ける
z
x'
x  =  G(z)
{1(本物), 0(偽物)}
y  =  D(x)
x
GANの学習過程のデモ
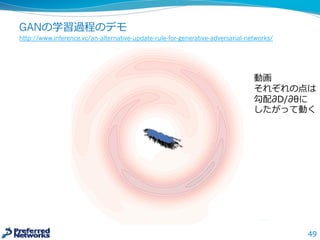
http://www.inference.vc/an-alternative-update-rule-for-generative-adversarial-networks/
49
動画
それぞれの点は
勾配∂D/∂θに
したがって動く
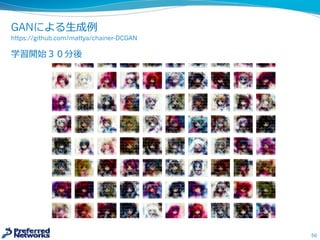
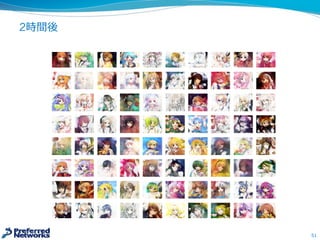
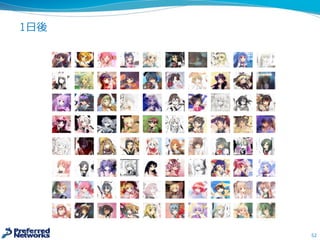
GANによる⽣生成例例
https://github.com/mattya/chainer-DCGAN
学習開始30分後
50
2時間後
51
1⽇日後
52
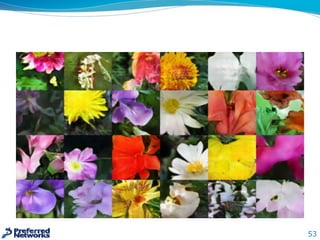
53
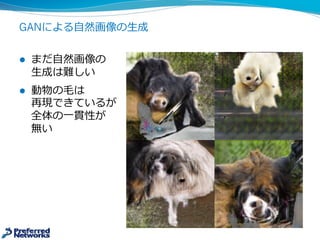
GANによる⾃自然画像の⽣生成
l まだ⾃自然画像の
⽣生成は難しい
l 動物の⽑毛は
再現できているが
全体の⼀一貫性が
無い
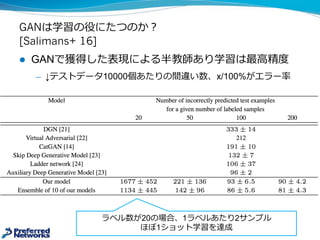
GANは学習の役にたつのか?
[Salimans+ 16]
l GANを使った半教師あり学習は最⾼高精度度
̶— ↓テストデータ10000個あたりの間違い数、x/100%がエラー率率率
ラベル数が20の場合、1ラベルあたり2サンプル
ほぼ1ショット学習を達成
この他の重要な⽣生成モデル
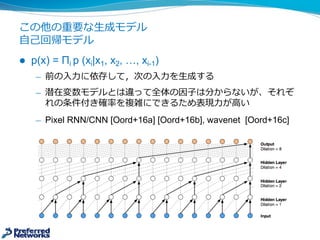
⾃自⼰己回帰モデル
l p(x)  =  Πi p  (xi|x1,  x2,  …,  xi-­1)
̶— 前の⼊入⼒力力に依存して,次の⼊入⼒力力を⽣生成する
̶— 潜在変数モデルとは違って全体の因⼦子は分からないが、それぞ
れの条件付き確率率率を複雑にできるため表現⼒力力が⾼高い
̶— Pixel  RNN/CNN  [Oord+16a]  [Oord+16b],  wavenet [Oord+16c]
エネルギーベースモデル [Kim+16]
l ⼊入⼒力力xのエネルギーをE(x)とし,そのギブス分布を確率率率
分布とする
pE(x)  =  exp(-­E(x))  /  N
l 学習時にp(x)からのサンプリングが必要で従来はMCMC
が必要だが、GANと同じ⽣生成モデルG(x)を⽤用意し、これ
を使ってサンプリング⽣生成する
̶— G(x)の分布がpE(x)と近づくようにG(x)を学習する
l このモデルは尤度度p(x)とその対数尤度度の勾配が効率率率的に
求まるため、様々な応⽤用が考えられる
̶— ⼊入⼒力力復復元、⼊入⼒力力補完もふくめた推定
モーメントマッチングモデル [Li+ 15]
l p(x)=q(x) ⇔あらゆる特徴φ(x)でEp(x)[φ(x)]=Eq(x)[φ(x)]
l xi~p(x),  xi’~q(x)についてそれらの経験分布における
モーメントが⼀一致する
l ((1/n)ΣiΦ(xi)  -­ (1/m)  ΣiΦ(x’i))2 を最⼩小化
̶— Φ(x)は⾃自⼰己符号化器を使って得られた潜在表現
̶— 内積<Φ(x), Φ(u)>  だけになるのでカーネルトリックが使える
̶— 誤差逆伝播法で学習できる
l GANと同様に⽣生成の最後にノイズを⼊入れずに学習できる
̶— GANとは違って,min  maxゲームを解く必要はなく安定して
学習できる
バイオ・ヘルスケアにおける
ディープラーニング
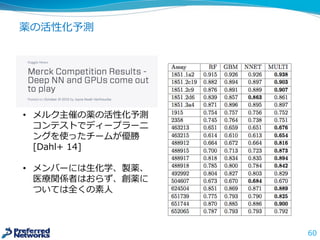
薬の活性化予測
60
• メルク主催の薬の活性化予測
コンテストでディープラーニ
ングを使ったチームが優勝
[Dahl+  14]
• メンバーには⽣生化学、製薬、
医療療関係者はおらず、創薬に
ついては全くの素⼈人
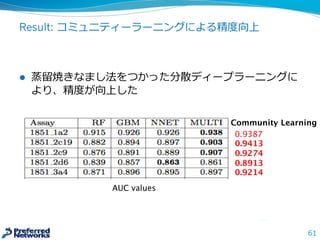
Result: コミュニティーラーニングによる精度度向上
l 蒸留留焼きなまし法をつかった分散ディープラーニングに
より、精度度が向上した
l D
61
Community Learning
AUC values
0.9387
0.9413
0.9274
0.8913
0.9214
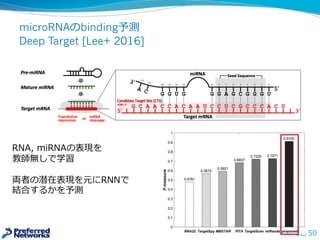
microRNAのbinding予測
Deep Target [Lee+ 2016]
62/50
RNA,  miRNAの表現を
教師無しで学習
両者の潜在表現を元にRNNで
結合するかを予測
可変⻑⾧長データをうまく表現できる
のが⼤大きい
まとめ
l ⽣生成モデルはデータの⽣生成過程を獲得し,逆向きの推論論,
認識識を実現できる
̶— ⾮非線形,複数層を持った⽣生成過程も推定できる
l ⽣生成モデルの学習はラベルなしデータでできる
̶— 世の中には⼤大量量のラベルなしデータが存在しそれを利利⽤用できる
l 今後半教師あり、教師なし学習が重要となる
̶— ⼤大量量の教師なしデータと、少量量または数個の教師ありデータま
たは関連するフィードバックから学習する
̶— 動物や⼈人間が実現しているワンショット学習、ゼロショット学
習と同様に加速度度的に新しいタスクを学習する
参考⽂文献
l [Lin+  16]  “Why  does  deep  and  cheap  learning  work  so  well?”,  H.  W.  Lin, M.  
Tegmark
l [Vinnikov+  14]  “K-­means  Recovers  ICA  Filters  when  Independent  
Components  are  Sparse”,  ICML  2014,  A.  Vinnikov,  S.  S.-­Shwartz
l [Kingma+  13]  ”Auto-­encoding  Variational Bayes”,  D.  P.  Kingma,  M.  Welling
l [Kingma+  14]  “Semi-­supervised  Learning  with  Deep  Generative  Models”,  D.  
P.  Kingma,  D.  J.  Rezende,  S.  Mohamed,  M.  Welling
l [Burda+  15]  “Importance  weighted  autoencoders”,  Y.  Burda,  R.  Grosse,  R.  
Salakhutdinov
l [Maaloe+  16]  ”Auxiliary  Deep  Generative  Models”,  L.  Maaloe,  c.  K.  
Sonderby,  S.  K.  Sonderby,  O.  Winther
l [Goodfellow+  14]  “Gerative Adversarial  Networks”,  I.  J.  Goodfellow and  et.  
al.
l [Salimans+  16]  ”Improved  Techniques  for  Training  GANs”,  T.  Salimans,  I.  
Goodfellow,  W.  Zaremba,  V.  Cheung,  A.  Radford,  X.  Chen
l [Oord+  16a]  “Pixcel Reucurrent Neural  Network”,  A.  Oord.  et  al.
l [Oord+  16b]  “Conditional  Image  Generation  with  PixelCNN Decoders”,  A.  
Oord  et  al.  
l [Oord+  16c]  “WaveNet:  A  Generative  Model  for  Raw  Audito”,  A.  Oord  et  al.
l [Kim+  16]  “Deep  Directed  Generative  Models  with  Energy-­based  Probability  
estimation”,  T.  Kim,  Y.  Bengio
l [Li+  15]  “Generative  Moment  Matching  Network”,  Y.  Li,  K.  Swersky,  R.  
Zemel
l [Dahl+  14]  “Multi-­task  Neural  Networks  for  QSAR  Predictions”,  G.  E.  Dahl,  N.  
Jaitly,  R.  alakhutdinov
l [Lee+  16]  “DeepTarget:  End-­to-­end  Learning  Framework  for  microRNA  
Target  Prediction  using  Deep  Recurrent  Neural  Networks”,  B.  Leett,  J.  Baek,  
S.  Park,  S.  Yoon
質問
l Q:深層学習は説明ができるか?
l A:ブラックボックスになりがちだが、いくつか⼿手法が
提案されている。例例えば,画像認識識では画像のどの部分
をみて判断したかを可視化することができる
最終出⼒力力に対する各⼊入⼒力力についての勾配をみても、わか
る場合もある。深層学習の内部状態は説明のしやすい
ローカル,スパースな表現ではなく,汎化のしやすい分
散表現を使っているため、説明はしにくい
⽣生成過程を獲得すれば、⾼高次元データをうまく説明でき
るのは偶然ではなさそうなので、実際の⽣生成過程と関連
しており、それに基づく認識識は説明ができるかもしれな
い
質問
l 変数変換トリックのεは全体をカバーできるのか?
l ε⾃自体,⾼高次元データであり全体をカバーはできないが
1)  実際の値ではなく勾配推定に使い,⼤大抵ミニバッチで
複数のサンプルの勾配の平均であるので各サンプルあた
りのεのサンプリングは⼀一つでも⼗十分
2)  変数変換トリック後の勾配の推定値は,真の勾配の
バイアス無しの推定になっている
バプニックの原則に対する反論論
l 「ある問題を解こうとする際に,中間的なステップとし
てより難しい問題を解くべきではない」
by  バプニック
l ⽣生成モデルを学習することは中間的なより難しい問題を
解いていることにならないのか?
l ⽣生成モデルは事前知識識であり、その⽣生成モデルが観測
データを⼗十分説明できるのであればより少ないサンプル
で推論論できる
l そして、(直感に反して)⽣生成p(x|z)の⽅方が推論論p(z|x)よ
りも簡単な場合が多い
̶— ⼀一般にモデル化が簡単な順に p(z),  p(x|z),  p(x,  z),  p(x),  p(z|x)
68/50