Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
NS
Uploaded by
NTT DATA OSS Professional Services
2,964 views
HDFS basics from API perspective
2017年9月7日に開催されたdb tech showcase Tokyo 2017での講演資料です。
Technology
◦
Read more
More Related Content
PDF
Distributed data stores in Hadoop ecosystem
by
NTT DATA OSS Professional Services
52 slides
5.7K views
PDF
Apache Hadoop and YARN, current development status
by
NTT DATA OSS Professional Services
27 slides
2.6K views
PDF
Apache Hadoopの新機能Ozoneの現状
by
NTT DATA OSS Professional Services
35 slides
6.3K views
PDF
HDFS Router-based federation
by
NTT DATA OSS Professional Services
16 slides
1.9K views
PDF
Hadoopエコシステムのデータストア振り返り
by
NTT DATA OSS Professional Services
43 slides
5.2K views
PDF
SIerとオープンソースの美味しい関係 ~コミュニティの力を活かして世界を目指そう~
by
NTT DATA OSS Professional Services
21 slides
3.7K views
PDF
サポートメンバは見た! Hadoopバグワースト10 (adoop / Spark Conference Japan 2016 ライトニングトーク発表資料)
by
NTT DATA OSS Professional Services
15 slides
3.4K views
PDF
Apache Hadoopの未来 3系になって何が変わるのか?
by
NTT DATA OSS Professional Services
48 slides
7.3K views
Distributed data stores in Hadoop ecosystem
by
NTT DATA OSS Professional Services
52 slides
5.7K views
Apache Hadoop and YARN, current development status
by
NTT DATA OSS Professional Services
27 slides
2.6K views
Apache Hadoopの新機能Ozoneの現状
by
NTT DATA OSS Professional Services
35 slides
6.3K views
HDFS Router-based federation
by
NTT DATA OSS Professional Services
16 slides
1.9K views
Hadoopエコシステムのデータストア振り返り
by
NTT DATA OSS Professional Services
43 slides
5.2K views
SIerとオープンソースの美味しい関係 ~コミュニティの力を活かして世界を目指そう~
by
NTT DATA OSS Professional Services
21 slides
3.7K views
サポートメンバは見た! Hadoopバグワースト10 (adoop / Spark Conference Japan 2016 ライトニングトーク発表資料)
by
NTT DATA OSS Professional Services
15 slides
3.4K views
Apache Hadoopの未来 3系になって何が変わるのか?
by
NTT DATA OSS Professional Services
48 slides
7.3K views
What's hot
PDF
20170303 java9 hadoop
by
NTT DATA OSS Professional Services
26 slides
3.6K views
PDF
HDFS新機能総まとめin 2015 (日本Hadoopユーザー会 ライトニングトーク@Cloudera World Tokyo 2015 講演資料)
by
NTT DATA OSS Professional Services
18 slides
2.2K views
PDF
分散処理基盤Apache Hadoopの現状と、NTTデータのHadoopに対する取り組み
by
NTT DATA OSS Professional Services
29 slides
3.2K views
PPTX
大規模データ処理の定番OSS Hadoop / Spark 最新動向 - 2021秋 -(db tech showcase 2021 / ONLINE 発...
by
NTT DATA Technology & Innovation
55 slides
1.1K views
PDF
Hadoop 2.6の最新機能(Cloudera World Tokyo 2014 LT講演資料)
by
NTT DATA OSS Professional Services
13 slides
9.2K views
PDF
Hadoop2.6の最新機能+
by
NTT DATA OSS Professional Services
21 slides
8K views
PDF
PostgreSQL10を導入!大規模データ分析事例からみるDWHとしてのPostgreSQL活用のポイント
by
NTT DATA OSS Professional Services
40 slides
8.5K views
PDF
Apache Spark 1000 nodes NTT DATA
by
NTT DATA OSS Professional Services
33 slides
8.6K views
PDF
Apache Kafkaって本当に大丈夫?~故障検証のオーバービューと興味深い挙動の紹介~
by
NTT DATA OSS Professional Services
43 slides
27.8K views
PDF
[db tech showcase Tokyo 2017] D33: Deep Learningや、Analyticsのワークロードを加速するには-Ten...
by
Insight Technology, Inc.
43 slides
1K views
PDF
並列分散処理基盤Hadoopの紹介と、開発者が語るHadoopの使いどころ (Silicon Valley x 日本 / Tech x Business ...
by
NTT DATA OSS Professional Services
38 slides
3.5K views
PDF
データインターフェースとしてのHadoop ~HDFSとクラウドストレージと私~ (NTTデータ テクノロジーカンファレンス 2019 講演資料、2019...
by
NTT DATA Technology & Innovation
56 slides
2K views
PDF
Hadoop ecosystem NTTDATA osc15tk
by
NTT DATA OSS Professional Services
68 slides
6.4K views
PDF
Sparkをノートブックにまとめちゃおう。Zeppelinでね!(Hadoopソースコードリーディング 第19回 発表資料)
by
NTT DATA OSS Professional Services
12 slides
14.7K views
PPTX
Apache Hadoopに見るJavaミドルウェアのcompatibility(Open Developers Conference 2020 Onli...
by
NTT DATA Technology & Innovation
42 slides
762 views
PDF
Hadoopエコシステムの最新動向とNTTデータの取り組み (OSC 2016 Tokyo/Spring 講演資料)
by
NTT DATA OSS Professional Services
47 slides
6K views
PDF
Apache Spark超入門 (Hadoop / Spark Conference Japan 2016 講演資料)
by
NTT DATA OSS Professional Services
35 slides
21K views
PDF
Hadoop概要説明
by
Satoshi Noto
44 slides
33.8K views
PDF
40分でわかるHadoop徹底入門 (Cloudera World Tokyo 2014 講演資料)
by
hamaken
34 slides
100.7K views
PDF
[db tech showcase Tokyo 2015] B34:データの仮想化を具体化するIBMのロジカルデータウェアハウス by 日本アイ・ビー・エ...
by
Insight Technology, Inc.
28 slides
5.2K views
20170303 java9 hadoop
by
NTT DATA OSS Professional Services
26 slides
3.6K views
HDFS新機能総まとめin 2015 (日本Hadoopユーザー会 ライトニングトーク@Cloudera World Tokyo 2015 講演資料)
by
NTT DATA OSS Professional Services
18 slides
2.2K views
分散処理基盤Apache Hadoopの現状と、NTTデータのHadoopに対する取り組み
by
NTT DATA OSS Professional Services
29 slides
3.2K views
大規模データ処理の定番OSS Hadoop / Spark 最新動向 - 2021秋 -(db tech showcase 2021 / ONLINE 発...
by
NTT DATA Technology & Innovation
55 slides
1.1K views
Hadoop 2.6の最新機能(Cloudera World Tokyo 2014 LT講演資料)
by
NTT DATA OSS Professional Services
13 slides
9.2K views
Hadoop2.6の最新機能+
by
NTT DATA OSS Professional Services
21 slides
8K views
PostgreSQL10を導入!大規模データ分析事例からみるDWHとしてのPostgreSQL活用のポイント
by
NTT DATA OSS Professional Services
40 slides
8.5K views
Apache Spark 1000 nodes NTT DATA
by
NTT DATA OSS Professional Services
33 slides
8.6K views
Apache Kafkaって本当に大丈夫?~故障検証のオーバービューと興味深い挙動の紹介~
by
NTT DATA OSS Professional Services
43 slides
27.8K views
[db tech showcase Tokyo 2017] D33: Deep Learningや、Analyticsのワークロードを加速するには-Ten...
by
Insight Technology, Inc.
43 slides
1K views
並列分散処理基盤Hadoopの紹介と、開発者が語るHadoopの使いどころ (Silicon Valley x 日本 / Tech x Business ...
by
NTT DATA OSS Professional Services
38 slides
3.5K views
データインターフェースとしてのHadoop ~HDFSとクラウドストレージと私~ (NTTデータ テクノロジーカンファレンス 2019 講演資料、2019...
by
NTT DATA Technology & Innovation
56 slides
2K views
Hadoop ecosystem NTTDATA osc15tk
by
NTT DATA OSS Professional Services
68 slides
6.4K views
Sparkをノートブックにまとめちゃおう。Zeppelinでね!(Hadoopソースコードリーディング 第19回 発表資料)
by
NTT DATA OSS Professional Services
12 slides
14.7K views
Apache Hadoopに見るJavaミドルウェアのcompatibility(Open Developers Conference 2020 Onli...
by
NTT DATA Technology & Innovation
42 slides
762 views
Hadoopエコシステムの最新動向とNTTデータの取り組み (OSC 2016 Tokyo/Spring 講演資料)
by
NTT DATA OSS Professional Services
47 slides
6K views
Apache Spark超入門 (Hadoop / Spark Conference Japan 2016 講演資料)
by
NTT DATA OSS Professional Services
35 slides
21K views
Hadoop概要説明
by
Satoshi Noto
44 slides
33.8K views
40分でわかるHadoop徹底入門 (Cloudera World Tokyo 2014 講演資料)
by
hamaken
34 slides
100.7K views
[db tech showcase Tokyo 2015] B34:データの仮想化を具体化するIBMのロジカルデータウェアハウス by 日本アイ・ビー・エ...
by
Insight Technology, Inc.
28 slides
5.2K views
Similar to HDFS basics from API perspective
PPTX
Hadoop Compatible File Systems (Azure編) (セミナー「Big Data Developerに贈る第二弾 ‐ Azur...
by
NTT DATA Technology & Innovation
61 slides
578 views
PDF
Hadoop Compatible File Systems 2019 (db tech showcase 2019 Tokyo講演資料、2019/09/25)
by
NTT DATA Technology & Innovation
61 slides
1.6K views
PDF
AI・HPC・ビッグデータで利用される分散ファイルシステムを知る
by
日本ヒューレット・パッカード株式会社
60 slides
682 views
PDF
Hadoop book-2nd-ch3-update
by
Taisuke Yamada
19 slides
1.1K views
PDF
Apache Hadoop HDFSの最新機能の紹介(2018)#dbts2018
by
Yahoo!デベロッパーネットワーク
36 slides
3.2K views
PDF
分散処理基盤Apache Hadoop入門とHadoopエコシステムの最新技術動向 (オープンソースカンファレンス 2015 Tokyo/Spring 講...
by
NTT DATA OSS Professional Services
68 slides
18.6K views
PDF
NTTデータ流 Hadoop活用のすすめ ~インフラ構築・運用の勘所~
by
NTT DATA OSS Professional Services
31 slides
6.4K views
PDF
HDFS vs. MapR Filesystem
by
日本ヒューレット・パッカード株式会社
76 slides
742 views
PPTX
Cloudera大阪セミナー 20130219
by
Cloudera Japan
46 slides
1.1K views
PDF
Osc2012 spring HBase Report
by
Seiichiro Ishida
69 slides
10.3K views
PDF
[de:code 2017] 並列分散処理の考え方とオープンソース分散処理系の動向
by
Naoki (Neo) SATO
109 slides
1.8K views
PDF
[DI06] 並列分散処理の考え方とオープンソース分散処理系の動向
by
de:code 2017
109 slides
1.6K views
PDF
【17-E-3】Hadoop:黄色い象使いへの道 ~「Hadoop徹底入門」より~
by
Developers Summit
27 slides
5.9K views
PDF
Hadoop, NoSQL, GlusterFSの概要
by
日本ヒューレット・パッカード株式会社
51 slides
736 views
PDF
分散処理基盤ApacheHadoop入門とHadoopエコシステムの最新技術動向(OSC2015 Kansai発表資料)
by
NTT DATA OSS Professional Services
64 slides
42K views
PPT
Hadoopの紹介
by
bigt23
41 slides
1.9K views
PDF
Apache Big Data Miami 2017 - Hadoop Source Code Reading #23 #hadoopreading
by
Yahoo!デベロッパーネットワーク
39 slides
616 views
PDF
HDFSのスケーラビリティの限界を突破するためのさまざまな取り組み | Hadoop / Spark Conference Japan 2019 #hc...
by
Yahoo!デベロッパーネットワーク
49 slides
3.4K views
PPTX
Tuning maniax 2014 Hadoop編
by
ThinkIT_impress
32 slides
983 views
PDF
Hadoopによる大規模分散データ処理
by
Yoji Kiyota
39 slides
3.3K views
Hadoop Compatible File Systems (Azure編) (セミナー「Big Data Developerに贈る第二弾 ‐ Azur...
by
NTT DATA Technology & Innovation
61 slides
578 views
Hadoop Compatible File Systems 2019 (db tech showcase 2019 Tokyo講演資料、2019/09/25)
by
NTT DATA Technology & Innovation
61 slides
1.6K views
AI・HPC・ビッグデータで利用される分散ファイルシステムを知る
by
日本ヒューレット・パッカード株式会社
60 slides
682 views
Hadoop book-2nd-ch3-update
by
Taisuke Yamada
19 slides
1.1K views
Apache Hadoop HDFSの最新機能の紹介(2018)#dbts2018
by
Yahoo!デベロッパーネットワーク
36 slides
3.2K views
分散処理基盤Apache Hadoop入門とHadoopエコシステムの最新技術動向 (オープンソースカンファレンス 2015 Tokyo/Spring 講...
by
NTT DATA OSS Professional Services
68 slides
18.6K views
NTTデータ流 Hadoop活用のすすめ ~インフラ構築・運用の勘所~
by
NTT DATA OSS Professional Services
31 slides
6.4K views
HDFS vs. MapR Filesystem
by
日本ヒューレット・パッカード株式会社
76 slides
742 views
Cloudera大阪セミナー 20130219
by
Cloudera Japan
46 slides
1.1K views
Osc2012 spring HBase Report
by
Seiichiro Ishida
69 slides
10.3K views
[de:code 2017] 並列分散処理の考え方とオープンソース分散処理系の動向
by
Naoki (Neo) SATO
109 slides
1.8K views
[DI06] 並列分散処理の考え方とオープンソース分散処理系の動向
by
de:code 2017
109 slides
1.6K views
【17-E-3】Hadoop:黄色い象使いへの道 ~「Hadoop徹底入門」より~
by
Developers Summit
27 slides
5.9K views
Hadoop, NoSQL, GlusterFSの概要
by
日本ヒューレット・パッカード株式会社
51 slides
736 views
分散処理基盤ApacheHadoop入門とHadoopエコシステムの最新技術動向(OSC2015 Kansai発表資料)
by
NTT DATA OSS Professional Services
64 slides
42K views
Hadoopの紹介
by
bigt23
41 slides
1.9K views
Apache Big Data Miami 2017 - Hadoop Source Code Reading #23 #hadoopreading
by
Yahoo!デベロッパーネットワーク
39 slides
616 views
HDFSのスケーラビリティの限界を突破するためのさまざまな取り組み | Hadoop / Spark Conference Japan 2019 #hc...
by
Yahoo!デベロッパーネットワーク
49 slides
3.4K views
Tuning maniax 2014 Hadoop編
by
ThinkIT_impress
32 slides
983 views
Hadoopによる大規模分散データ処理
by
Yoji Kiyota
39 slides
3.3K views
More from NTT DATA OSS Professional Services
PDF
Global Top 5 を目指す NTT DATA の確かで意外な技術力
by
NTT DATA OSS Professional Services
35 slides
10.5K views
PDF
Spark SQL - The internal -
by
NTT DATA OSS Professional Services
63 slides
5.5K views
PDF
Structured Streaming - The Internal -
by
NTT DATA OSS Professional Services
38 slides
5.2K views
PPTX
ブロックチェーンの仕組みと動向(入門編)
by
NTT DATA OSS Professional Services
30 slides
14.4K views
PDF
Application of postgre sql to large social infrastructure jp
by
NTT DATA OSS Professional Services
35 slides
1.8K views
PDF
Application of postgre sql to large social infrastructure
by
NTT DATA OSS Professional Services
35 slides
1K views
PDF
Apache Hadoop 2.8.0 の新機能 (抜粋)
by
NTT DATA OSS Professional Services
8 slides
3.2K views
PDF
データ活用をもっともっと円滑に! ~データ処理・分析基盤編を少しだけ~
by
NTT DATA OSS Professional Services
22 slides
10.1K views
PDF
商用ミドルウェアのPuppet化で気を付けたい5つのこと
by
NTT DATA OSS Professional Services
26 slides
2.2K views
PPTX
今からはじめるPuppet 2016 ~ インフラエンジニアのたしなみ ~
by
NTT DATA OSS Professional Services
18 slides
2K views
PDF
Apache Sparkに手を出してヤケドしないための基本 ~「Apache Spark入門より」~ (デブサミ 2016 講演資料)
by
NTT DATA OSS Professional Services
60 slides
53.9K views
PDF
PostgreSQLでpg_bigmを使って日本語全文検索 (MySQLとPostgreSQLの日本語全文検索勉強会 発表資料)
by
NTT DATA OSS Professional Services
29 slides
15K views
PDF
本当にあったHadoopの恐い話 Blockはどこへきえた? (Hadoop / Spark Conference Japan 2016 ライトニングトー...
by
NTT DATA OSS Professional Services
12 slides
3.9K views
PDF
Hadoopのメンテナンスリリースバージョンをリリースしてみた (日本Hadoopユーザー会 ライトニングトーク@Cloudera World Tokyo...
by
NTT DATA OSS Professional Services
12 slides
2.3K views
PDF
PostgreSQLコミュニティに飛び込もう
by
NTT DATA OSS Professional Services
32 slides
8.4K views
PDF
SIプロジェクトでのインフラ自動化の事例 (第1回 Puppetユーザ会 発表資料)
by
NTT DATA OSS Professional Services
30 slides
11.4K views
Global Top 5 を目指す NTT DATA の確かで意外な技術力
by
NTT DATA OSS Professional Services
35 slides
10.5K views
Spark SQL - The internal -
by
NTT DATA OSS Professional Services
63 slides
5.5K views
Structured Streaming - The Internal -
by
NTT DATA OSS Professional Services
38 slides
5.2K views
ブロックチェーンの仕組みと動向(入門編)
by
NTT DATA OSS Professional Services
30 slides
14.4K views
Application of postgre sql to large social infrastructure jp
by
NTT DATA OSS Professional Services
35 slides
1.8K views
Application of postgre sql to large social infrastructure
by
NTT DATA OSS Professional Services
35 slides
1K views
Apache Hadoop 2.8.0 の新機能 (抜粋)
by
NTT DATA OSS Professional Services
8 slides
3.2K views
データ活用をもっともっと円滑に! ~データ処理・分析基盤編を少しだけ~
by
NTT DATA OSS Professional Services
22 slides
10.1K views
商用ミドルウェアのPuppet化で気を付けたい5つのこと
by
NTT DATA OSS Professional Services
26 slides
2.2K views
今からはじめるPuppet 2016 ~ インフラエンジニアのたしなみ ~
by
NTT DATA OSS Professional Services
18 slides
2K views
Apache Sparkに手を出してヤケドしないための基本 ~「Apache Spark入門より」~ (デブサミ 2016 講演資料)
by
NTT DATA OSS Professional Services
60 slides
53.9K views
PostgreSQLでpg_bigmを使って日本語全文検索 (MySQLとPostgreSQLの日本語全文検索勉強会 発表資料)
by
NTT DATA OSS Professional Services
29 slides
15K views
本当にあったHadoopの恐い話 Blockはどこへきえた? (Hadoop / Spark Conference Japan 2016 ライトニングトー...
by
NTT DATA OSS Professional Services
12 slides
3.9K views
Hadoopのメンテナンスリリースバージョンをリリースしてみた (日本Hadoopユーザー会 ライトニングトーク@Cloudera World Tokyo...
by
NTT DATA OSS Professional Services
12 slides
2.3K views
PostgreSQLコミュニティに飛び込もう
by
NTT DATA OSS Professional Services
32 slides
8.4K views
SIプロジェクトでのインフラ自動化の事例 (第1回 Puppetユーザ会 発表資料)
by
NTT DATA OSS Professional Services
30 slides
11.4K views
HDFS basics from API perspective
1.
© 2017 NTT
DATA Corporation 07/09/2017 NTT DATA Masatake Iwasaki 今さら聞きにくいHDFSの基本
2.
© 2017 NTT
DATA Corporation 2 Apache Hadoopの分散ファイルシステムであるHDFSについて、アーキ テクチャ、ファイルシステムとしての特徴、オブジェクトストアとの違 いについて、ユーザAPIという切り口から、最近の開発動向や新機能、 ちょっと細かい実装の話などを混じえながら解説します。 はじめに
3.
© 2017 NTT
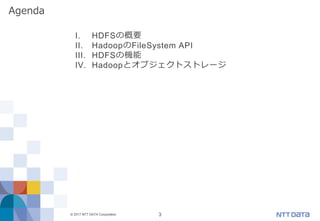
DATA Corporation 3 I. HDFSの概要 II. HadoopのFileSystem API III. HDFSの機能 IV. Hadoopとオブジェクトストレージ Agenda
4.
© 2017 NTT
DATA Corporation 4 HDFSの概要
5.
© 2017 NTT
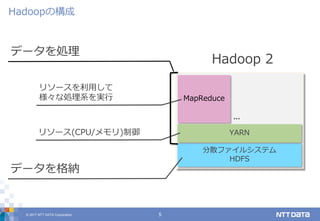
DATA Corporation 5 Hadoopの構成 Hadoop 2 分散ファイルシステム HDFS MapReduce YARN データを格納 リソース(CPU/メモリ)制御 リソースを利用して 様々な処理系を実行 データを処理 ...
6.
© 2017 NTT
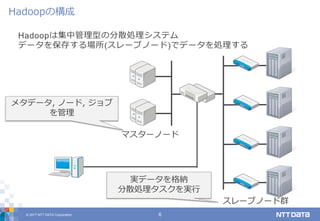
DATA Corporation 6 Hadoopは集中管理型の分散処理システム データを保存する場所(スレーブノード)でデータを処理する Hadoopの構成 マスターノード スレーブノード群 実データを格納 分散処理タスクを実行 メタデータ, ノード, ジョブ を管理
7.
© 2017 NTT
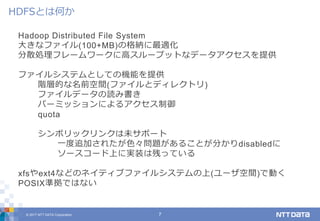
DATA Corporation 7 Hadoop Distributed File System 大きなファイル(100+MB)の格納に最適化 分散処理フレームワークに高スループットなデータアクセスを提供 ファイルシステムとしての機能を提供 階層的な名前空間(ファイルとディレクトリ) ファイルデータの読み書き パーミッションによるアクセス制御 quota シンボリックリンクは未サポート 一度追加されたが色々問題があることが分かりdisabledに ソースコード上に実装は残っている xfsやext4などのネイティブファイルシステムの上(ユーザ空間)で動く POSIX準拠ではない HDFSとは何か
8.
© 2017 NTT
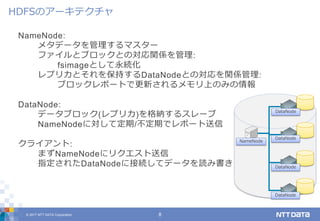
DATA Corporation 8 NameNode: メタデータを管理するマスター ファイルとブロックとの対応関係を管理: fsimageとして永続化 レプリカとそれを保持するDataNodeとの対応を関係管理: ブロックレポートで更新されるメモリ上のみの情報 DataNode: データブロック(レプリカ)を格納するスレーブ NameNodeに対して定期/不定期でレポート送信 クライアント: まずNameNodeにリクエスト送信 指定されたDataNodeに接続してデータを読み書き HDFSのアーキテクチャ NameNode DataNode DataNode DataNode DataNode
9.
© 2017 NTT
DATA Corporation 9 データ保全性と可用性 データは自動的に冗長化される ノード故障で低下した冗長度は自動的に回復される ラックを跨ぐようなデータの配置戦略(rack awareness) ノードダウン時にもクライアントが透過的にリトライ/リカバリ 分散処理フレームワークにデータローカリティを提供 データを持ってきて処理するのではなく 処理をデータのある場所に持っていく メタデータを1箇所(NameNode)で管理することによる一貫性 ただしNameNodeがスケーラビリティのボトルネックになる とはいえスレーブ数千台くらいはいける ただしNameNodeがSPOFになりうる なのでActive-Standby型のHA構成をビルトインでサポート HDFSの特徴
10.
© 2017 NTT
DATA Corporation 10 クライアントからNameNodeにブロック割り当てリクエスト 指定されたDataNodeに対して書き込みパイプライン構築 DataNodeからNameNodeにブロック情報を報告 IBR: Incremental Block Report ブロック書き込み開始時/書き込み完了時/sync要求受信時 レポートを受けてNameNode上のブロック情報が状態遷移 HDFSのデータ書き込みの流れ DataNode NameNode DataNode Client DataNode write ack write report 1. addBlock LocatedBlock 2. writeBlock ack ack
11.
© 2017 NTT
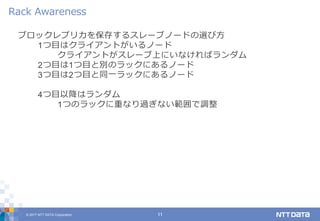
DATA Corporation 11 ブロックレプリカを保存するスレーブノードの選び方 1つ目はクライアントがいるノード クライアントがスレーブ上にいなければランダム 2つ目は1つ目と別のラックにあるノード 3つ目は2つ目と同一ラックにあるノード 4つ目以降はランダム 1つのラックに重なり過ぎない範囲で調整 Rack Awareness
12.
© 2017 NTT
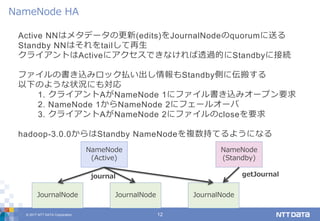
DATA Corporation 12 Active NNはメタデータの更新(edits)をJournalNodeのquorumに送る Standby NNはそれをtailして再生 クライアントはActiveにアクセスできなければ透過的にStandbyに接続 ファイルの書き込みロック払い出し情報もStandby側に伝搬する 以下のような状況にも対応 1. クライアントAがNameNode 1にファイル書き込みオープン要求 2. NameNode 1からNameNode 2にフェールオーバ 3. クライアントAがNameNode 2にファイルのcloseを要求 hadoop-3.0.0からはStandby NameNodeを複数持てるようになる NameNode HA JournalNode NameNode (Active) JournalNode NameNode (Standby) JournalNode journal getJournal
13.
© 2017 NTT
DATA Corporation 13 HadoopのFileSystem API
14.
© 2017 NTT
DATA Corporation 14 Hadoopが提供するファイルシステムにアクセスするためのAPI HDFS以外のバックエンドにも透過的にアクセスできるように抽象化 (基本的にはHDFSにできる範囲の機能を提供) ビルトインで付いてくる実装もいろいろ: LocalFileSystem DistributedFileSystem S3AFileSystem NativeAzureFileSystem AdlFileSystem SwiftNativeFileSystem AliyunOSSFileSystem ... FileSystem#getで各実装のインスタンスを取得 URLのschemeで使い分けられる file://..., hdfs://..., s3a://..., ... 各インスタンスは重量級なのでキャッシュされて使い回される Hadoop FileSystem API
15.
© 2017 NTT
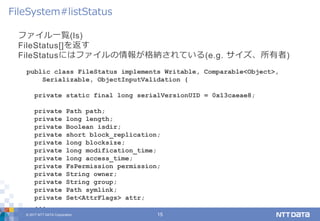
DATA Corporation 15 ファイル一覧(ls) FileStatus[]を返す FileStatusにはファイルの情報が格納されている(e.g. サイズ、所有者) FileSystem#listStatus public class FileStatus implements Writable, Comparable<Object>, Serializable, ObjectInputValidation { private static final long serialVersionUID = 0x13caeae8; private Path path; private long length; private Boolean isdir; private short block_replication; private long blocksize; private long modification_time; private long access_time; private FsPermission permission; private String owner; private String group; private Path symlink; private Set<AttrFlags> attr; ...
16.
© 2017 NTT
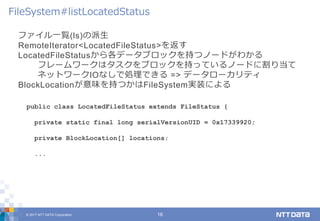
DATA Corporation 16 ファイル一覧(ls)の派生 RemoteIterator<LocatedFileStatus>を返す LocatedFileStatusから各データブロックを持つノードがわかる フレームワークはタスクをブロックを持っているノードに割り当て ネットワークIOなしで処理できる => データローカリティ BlockLocationが意味を持つかはFileSystem実装による FileSystem#listLocatedStatus public class LocatedFileStatus extends FileStatus { private static final long serialVersionUID = 0x17339920; private BlockLocation[] locations; ...
17.
© 2017 NTT
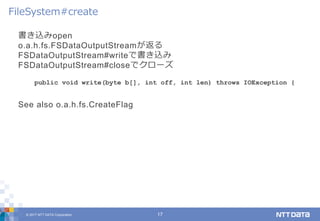
DATA Corporation 17 書き込みopen o.a.h.fs.FSDataOutputStreamが返る FSDataOutputStream#writeで書き込み FSDataOutputStream#closeでクローズ See also o.a.h.fs.CreateFlag FileSystem#create public void write(byte b[], int off, int len) throws IOException {
18.
© 2017 NTT
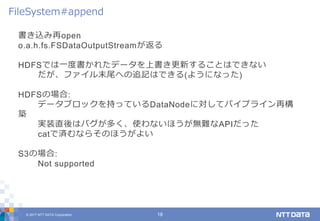
DATA Corporation 18 書き込み再open o.a.h.fs.FSDataOutputStreamが返る HDFSでは一度書かれたデータを上書き更新することはできない だが、ファイル末尾への追記はできる(ようになった) HDFSの場合: データブロックを持っているDataNodeに対してパイプライン再構 築 実装直後はバグが多く、使わないほうが無難なAPIだった catで済むならそのほうがよい S3の場合: Not supported FileSystem#append
19.
© 2017 NTT
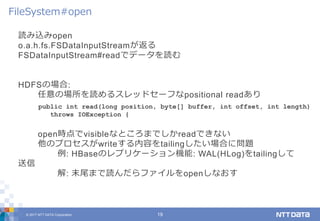
DATA Corporation 19 読み込みopen o.a.h.fs.FSDataInputStreamが返る FSDataInputStream#readでデータを読む HDFSの場合: 任意の場所を読めるスレッドセーフなpositional readあり open時点でvisibleなところまでしかreadできない 他のプロセスがwriteする内容をtailingしたい場合に問題 例: HBaseのレプリケーション機能: WAL(HLog)をtailingして 送信 解: 末尾まで読んだらファイルをopenしなおす FileSystem#open public int read(long position, byte[] buffer, int offset, int length) throws IOException {
20.
© 2017 NTT
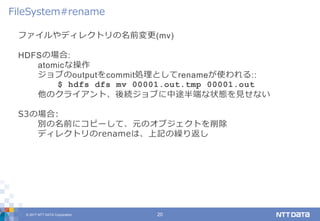
DATA Corporation 20 ファイルやディレクトリの名前変更(mv) HDFSの場合: atomicな操作 ジョブのoutputをcommit処理としてrenameが使われる:: $ hdfs dfs mv 00001.out.tmp 00001.out 他のクライアント、後続ジョブに中途半端な状態を見せない S3の場合: 別の名前にコピーして、元のオブジェクトを削除 ディレクトリのrenameは、上記の繰り返し FileSystem#rename
21.
© 2017 NTT
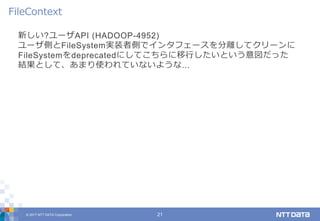
DATA Corporation 21 新しい?ユーザAPI (HADOOP-4952) ユーザ側とFileSystem実装者側でインタフェースを分離してクリーンに FileSystemをdeprecatedにしてこちらに移行したいという意図だった 結果として、あまり使われていないような... FileContext
22.
© 2017 NTT
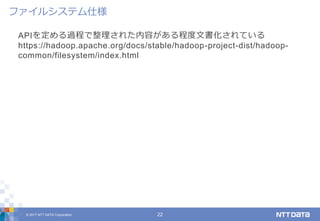
DATA Corporation 22 APIを定める過程で整理された内容がある程度文書化されている https://hadoop.apache.org/docs/stable/hadoop-project-dist/hadoop- common/filesystem/index.html ファイルシステム仕様
23.
© 2017 NTT
DATA Corporation 23 HDFSの機能
24.
© 2017 NTT
DATA Corporation 24 HDFSへのアクセスを提供 HDFS固有の機能もある クラスタ内のノードへのアクセスを抽象化 エラーに対してもクライアント内部で自動的にリカバリ/リトライ NameNodeが落ちたらstandby側にリトライ DataNodeが落ちたら: 読み込み中: 同一レプリカを持つ別ノードにリトライ 書き込み中: パイプライン上のノードを入れ替えてリトライ DistributedFileSystem extends FileSystem
25.
© 2017 NTT
DATA Corporation 25 fsyncに相当 (closeせずに)writeしたデータの書き込みを確定させる FSDataOutputStream#hflush: パイプライン上の全DataNodeがデータを受け取ったらreturn FSDataOutputStream#hsync: パイプライン上の全DataNodeでfsyncしてからreturn ユースケース: HBaseのWAL(HLog)書き込み WALエントリの書き込みを確定してからクライアントに成功を返す hflush/hsync
26.
© 2017 NTT
DATA Corporation 26 dfs.datanode.synconclose デフォルト設定はfalse: HDFSはファイルのsyncをOSに任せる HDFS的にファイルをcloseしてもsyncされない パイプライン上の全DNがsync前に電源断 => データロスト trueにするとclose時にfsync データセンター障害的な状況で整合性を保つために使える dfs.datanode.sync.behind.writes syncをOSに任せると、書き込みレイテンシにムラが出る 書き込んだデータをこまめにsyncすることでレイテンシを平滑化 データストア(e.g. HBase)のバックエンドとして使う場合に有用 Linuxのsync_file_rangeシステムコールを利用 ディスクアクセスの制御
27.
© 2017 NTT
DATA Corporation 27 dfs.datanode.drop.cache.behind.{reads|writes} ブロックファイルをOSのキャッシュから積極的に消す Linuxのposix_fadviseシステムコールを利用 でも、DataNode単位では使いにくい ストリーム単位での調整もできる FSDataInputStream#setDropBehind FSDataInputStream#setReadahead FSDataOutputStream#setDropBehind キャッシュ戦略のチューニング
28.
© 2017 NTT
DATA Corporation 28 「HDFSのこのファイルをメモリに乗せておきたい」と指定できる 指定されたファイルに紐づくブロックをオフヒープにキャッシュ mmap/mlockにもとづく仕組み hdfs cacheadmin
29.
© 2017 NTT
DATA Corporation 29 データローカリティがあってもDataNode経由でreadすると無駄がある DataNodeがファイルからread クライアントにソケット経由で送信 クライアントがブロックファイルを直接readできると高効率 しかしローカルファイルを直接openできるとアクセス制御がきかない Short Cirtcuit Local Readの仕組み: パーミッションのチェックをNameNodeで行う DataNodeからopen済みのfdをクライアントに渡す: Linuxのsendmsg/recvmsgシステムコールを利用 Short Circuit Local Read
30.
© 2017 NTT
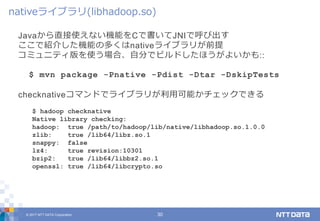
DATA Corporation 30 Javaから直接使えない機能をCで書いてJNIで呼び出す ここで紹介した機能の多くはnativeライブラリが前提 コミュニティ版を使う場合、自分でビルドしたほうがよいかも:: $ mvn package -Pnative -Pdist -Dtar -DskipTests checknativeコマンドでライブラリが利用可能かチェックできる nativeライブラリ(libhadoop.so) $ hadoop checknative Native library checking: hadoop: true /path/to/hadoop/lib/native/libhadoop.so.1.0.0 zlib: true /lib64/libz.so.1 snappy: false lz4: true revision:10301 bzip2: true /lib64/libbz2.so.1 openssl: true /lib64/libcrypto.so
31.
© 2017 NTT
DATA Corporation 31 libhdfs HDFSクライアントAPIのC言語バインディング JavaのAPIと機能性は近い JNIでJavaのクライアントAPIを呼ぶつくり WebHDFS REST API クラスタの外側のネットワークからアクセスする際に便利 クラスタ間のデータコピーによく利用される Java以外のバインディング
32.
© 2017 NTT
DATA Corporation 32 Hadoopとオブジェクトストレージ
33.
© 2017 NTT
DATA Corporation 33 Amazon S3をバックエンドとするFileSystem実装 S3FileSystem, NativeS3FileSystemの後継 Hadoop on Cloudを使う場合の低コストなデータ保存場所として便利 ファイルはオブジェクトに対応づけられる S3にディレクトリという概念はない "mkdir /foo/bar" => /foo/bar/ というキーで空オブジェクトを作成 S3にrenameという概念はない オブジェクトを別の名前でコピーして、コピー元を消す "mv /dir1 /dir2" => /dir1/* なキーを持つオブジェクトを全コピー eventual consistency ファイルを作成した直後にlsすると見えないことがある deleteしたファイルがしばらく見えることがある S3AFileSystem extends FileSystem
34.
© 2017 NTT
DATA Corporation 34 S3をバックエンドにした場合でも一貫性を提供する試み DynamoDBをファイルメタデータストアとして使う Amazon EMRで提供されているEMRFSのコミュニティ版 hadoop-3.0.0-beta1から利用可能 S3Guard (HADOOP-13345)
35.
© 2017 NTT
DATA Corporation 35 EMRのHBaseのデータディレクトリをS3上に置く http://docs.aws.amazon.com/emr/latest/ReleaseGuide/emr-hbase- s3.html データディレクトリと独立にWALディレクトリを設定することで実現 (HBASE-17437) hbase.root.dir: on S3 hbase.wal.dir: on HDFS EMRFSが前提 HBase on Amazon S3
36.
© 2017 NTT
DATA Corporation 36 HDFSのパーツでオブジェクトストレージを作る試み 特にブロックコンテナとしてのDataNode NameNodeは以下の2つのモジュールが密結合 FSNameSystem: メタデータ(inode)を管理 BlockManager: ブロックレプリカを管理 キー空間とコンテナの対応づけだけならスケールアウトしやすい ブロックメタデータはDataNode側で持ち、RAFTで冗長化 HDFS-7240ブランチでアクティブに開発されている 果たしてマージできるのか Ozone (HDFS-7240)
37.
© 2017 NTT
DATA Corporation 37 まとめ
38.
© 2017 NTT
DATA Corporation 38 HDFSはファイルシステムのセマンティクスを提供 データローカリティを活かした高スループットな分散処理の基盤 スループットだけではなくレイテンシもそれなりに追求 HBaseのようなデータストアのバックエンドとしても使える FileSystem APIを使えばバックエンドを透過的に切り替え可能 オブジェクトストアその他とうまく使い分けるとよい 今回紹介できなかったHDFSならではの機能は他にもいろいろ Transparent Encryption Extended Attributes Storage Policies Erasure Coding Summary
39.
© 2017 NTT
DATA Corporation