Copyright©2014 NTT corp. All Rights Reserved.
Taming YARN
-how can we tune it?-
Tsuyoshi Ozawa
ozawa.tsuyoshi@lab.ntt.co.jp
2Copyright©2014 NTT corp. All Rights Reserved.
• Tsuyoshi Ozawa
• Researcher & Engineer @ NTT
Twitter: @oza_x86_64
• A Hadoop Contributor
• Merged patches – 29 patches!
• Developing ResourceManager HA with community
• Author of “Hadoop 徹底入門 2nd Edition”
Chapter 22(YARN)
About me
3Copyright©2014 NTT corp. All Rights Reserved.
• Overview of YARN
• Components
• ResourceManager
• NodeManager
• ApplicationMaster
• Configuration
• Capacity Planning on YARN
• Scheduler
• Health Check on ResourceManager
• Threads
• ResourceManager HA
Agenda
4Copyright©2014 NTT corp. All Rights Reserved.
OVERVIEW
5Copyright©2014 NTT corp. All Rights Reserved.
YARN
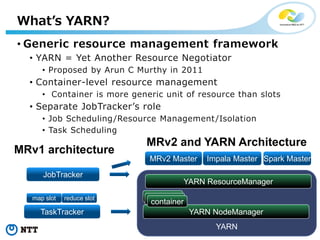
• Generic resource management framework
• YARN = Yet Another Resource Negotiator
• Proposed by Arun C Murthy in 2011
• Container-level resource management
• Container is more generic unit of resource than slots
• Separate JobTracker’s role
• Job Scheduling/Resource Management/Isolation
• Task Scheduling
What’s YARN?
JobTracker
MRv1 architecture
MRv2 and YARN Architecture
YARN ResourceManager
Impala Master Spark MasterMRv2 Master
TaskTracker YARN NodeManager
map slot reduce slot containercontainercontainer
6Copyright©2014 NTT corp. All Rights Reserved.
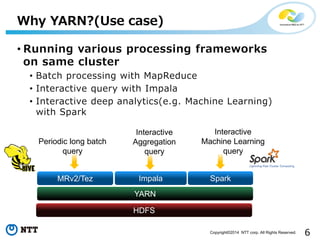
• Running various processing frameworks
on same cluster
• Batch processing with MapReduce
• Interactive query with Impala
• Interactive deep analytics(e.g. Machine Learning)
with Spark
Why YARN?(Use case)
MRv2/Tez
YARN
HDFS
Impala Spark
Periodic long batch
query
Interactive
Aggregation
query
Interactive
Machine Learning
query
7Copyright©2014 NTT corp. All Rights Reserved.
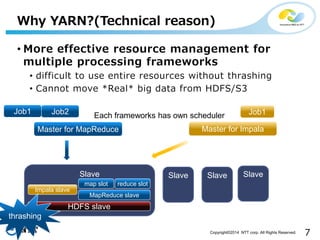
• More effective resource management for
multiple processing frameworks
• difficult to use entire resources without thrashing
• Cannot move *Real* big data from HDFS/S3
Why YARN?(Technical reason)
Master for MapReduce Master for Impala
Slave
Impala slave
map slot reduce slot
MapReduce slave
Slave Slave Slave
HDFS slave
Each frameworks has own schedulerJob2Job1 Job1
thrashing
8Copyright©2014 NTT corp. All Rights Reserved.
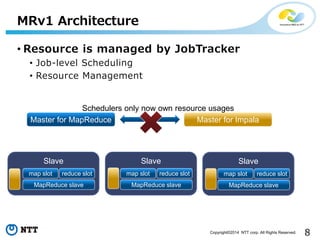
• Resource is managed by JobTracker
• Job-level Scheduling
• Resource Management
MRv1 Architecture
Master for MapReduce
Slave
map slot reduce slot
MapReduce slave
Slave
map slot reduce slot
MapReduce slave
Slave
map slot reduce slot
MapReduce slave
Master for Impala
Schedulers only now own resource usages
9Copyright©2014 NTT corp. All Rights Reserved.
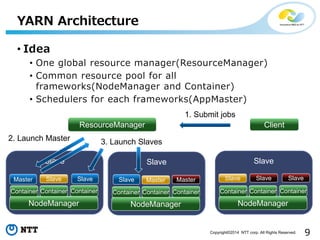
• Idea
• One global resource manager(ResourceManager)
• Common resource pool for all
frameworks(NodeManager and Container)
• Schedulers for each frameworks(AppMaster)
YARN Architecture
ResourceManager
Slave
NodeManager
Container Container Container
Slave
NodeManager
Container Container Container
Slave
NodeManager
Container Container Container
Master Slave Slave MasterSlave SlaveMaster Slave Slave
Client
1. Submit jobs
2. Launch Master 3. Launch Slaves
10Copyright©2014 NTT corp. All Rights Reserved.
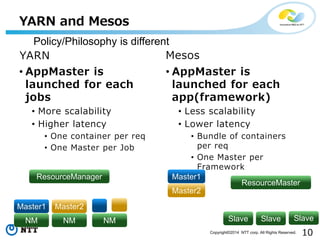
YARN and Mesos
YARN
• AppMaster is
launched for each
jobs
• More scalability
• Higher latency
• One container per req
• One Master per Job
Mesos
• AppMaster is
launched for each
app(framework)
• Less scalability
• Lower latency
• Bundle of containers
per req
• One Master per
Framework
ResourceManager
NM NM NM
ResourceMaster
Slave Slave Slave
Master1
Master2
Master1 Master2
Policy/Philosophy is different
11Copyright©2014 NTT corp. All Rights Reserved.
• MapReduce
• Of course, it works
• DAG-style processing framework
• Spark on YARN
• Hive on Tez on YARN
• Interactive Query
• Impala on YARN(via llama)
• Users
• Yahoo!
• Twitter
• LinkdedIn
• Hadoop 2 @ Twitter
http://www.slideshare.net/Hadoop_Summit/t-
235p210-cvijayarenuv2
YARN Eco-system
12Copyright©2014 NTT corp. All Rights Reserved.
YARN COMPONENTS
13Copyright©2014 NTT corp. All Rights Reserved.
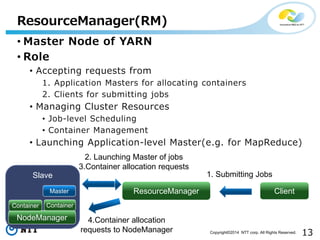
• Master Node of YARN
• Role
• Accepting requests from
1. Application Masters for allocating containers
2. Clients for submitting jobs
• Managing Cluster Resources
• Job-level Scheduling
• Container Management
• Launching Application-level Master(e.g. for MapReduce)
ResourceManager(RM)
ResourceManager Client
Slave
NodeManager
Container Container
Master
4.Container allocation
requests to NodeManager
1. Submitting Jobs
2. Launching Master of jobs
3.Container allocation requests
14Copyright©2014 NTT corp. All Rights Reserved.
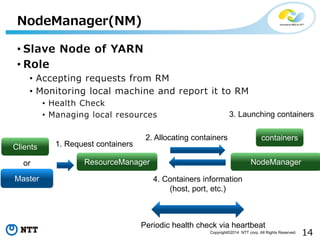
• Slave Node of YARN
• Role
• Accepting requests from RM
• Monitoring local machine and report it to RM
• Health Check
• Managing local resources
NodeManager(NM)
NodeManagerResourceManager
2. Allocating containers
Clients
Master
or
3. Launching containers
containers
4. Containers information
(host, port, etc.)
1. Request containers
Periodic health check via heartbeat
15Copyright©2014 NTT corp. All Rights Reserved.
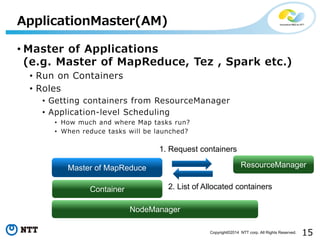
• Master of Applications
(e.g. Master of MapReduce, Tez , Spark etc.)
• Run on Containers
• Roles
• Getting containers from ResourceManager
• Application-level Scheduling
• How much and where Map tasks run?
• When reduce tasks will be launched?
ApplicationMaster(AM)
NodeManager
Container
Master of MapReduce ResourceManager
1. Request containers
2. List of Allocated containers
16Copyright©2014 NTT corp. All Rights Reserved.
CONFIGURATION YARN AND
FRAMEWORKS
17Copyright©2014 NTT corp. All Rights Reserved.
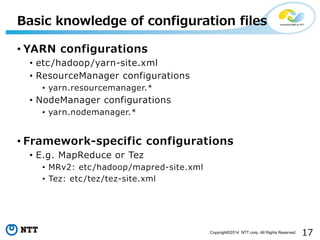
• YARN configurations
• etc/hadoop/yarn-site.xml
• ResourceManager configurations
• yarn.resourcemanager.*
• NodeManager configurations
• yarn.nodemanager.*
• Framework-specific configurations
• E.g. MapReduce or Tez
• MRv2: etc /hadoop/mapred-site.xml
• Tez: etc /tez/tez-site.xml
Basic knowledge of configuration files
18Copyright©2014 NTT corp. All Rights Reserved.
CAPACITY PLANNING ON YARN
19Copyright©2014 NTT corp. All Rights Reserved.
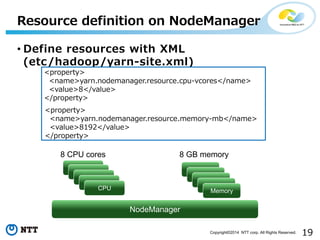
• Define resources with XML
(etc/hadoop/yarn-site.xml)
Resource definition on NodeManager
NodeManager
CPU
CPU
CPU
CPU
CPU
Memory
Memory
Memory
Memory
Memory
<property>
<name>yarn.nodemanager.resource.cpu-vcores</name>
<value>8</value>
</property>
<property>
<name>yarn.nodemanager.resource.memory-mb</name>
<value>8192</value>
</property>
8 CPU cores 8 GB memory
20Copyright©2014 NTT corp. All Rights Reserved.
Container allocation on ResourceManager
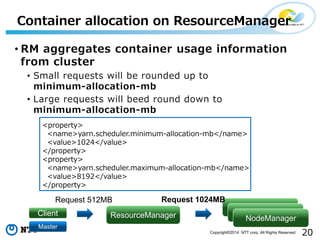
• RM aggregates container usage information
from cluster
• Small requests will be rounded up to
minimum-allocation-mb
• Large requests will beed round down to
minimum-allocation-mb
<property>
<name>yarn.scheduler.minimum-allocation-mb</name>
<value>1024</value>
</property>
<property>
<name>yarn.scheduler.maximum-allocation-mb</name>
<value>8192</value>
</property>
ResourceManagerClient
Request 512MB
NodeManager
NodeManager
NodeManager
Request 1024MB
Master
21Copyright©2014 NTT corp. All Rights Reserved.
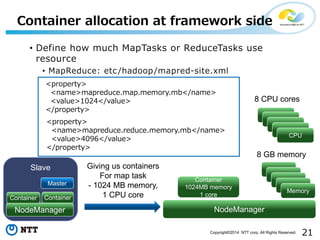
• Define how much MapTasks or ReduceTasks use
resource
• MapReduce: etc /hadoop/mapred-site.xml
Container allocation at framework side
NodeManager
CPU
CPU
CPU
CPU
CPU
Memory
Memory
Memory
Memory
Memory
8 CPU cores
8 GB memory
<property>
<name>mapreduce.map.memory.mb</name>
<value>1024</value>
</property>
<property>
<name>mapreduce.reduce.memory.mb</name>
<value>4096</value>
</property>
Slave
NodeManager
Container Container
Master
Giving us containers
For map task
- 1024 MB memory,
1 CPU core
Container
1024MB memory
1 core
22Copyright©2014 NTT corp. All Rights Reserved.
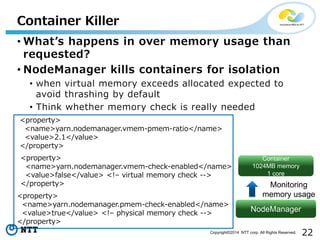
Container Killer
• What’s happens in over memory usage than
requested?
• NodeManager kills containers for isolation
• when virtual memory exceeds allocated expected to
avoid thrashing by default
• Think whether memory check is really needed
<property>
<name>yarn.nodemanager.vmem-pmem-ratio</name>
<value>2.1</value>
</property>
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value> <!– virtual memory check -->
</property>
NodeManager
Container
1024MB memory
1 core
Monitoring
memory usage<property>
<name>yarn.nodemanager.pmem-check-enabled</name>
<value>true</value> <!– physical memory check -->
</property>
23Copyright©2014 NTT corp. All Rights Reserved.
Difficulty of container killer and JVM
• -Xmx and -Xx:MaxPermSize is only for heap
memory!
• JVM can use -Xmx + -Xx:MaxPermSize + α
• Please see GC tutorial to understand
memory usage on JVM:
http://www.oracle.com/webfolder/technetw
ork/tutorials/obe/java/gc01/index.html
24Copyright©2014 NTT corp. All Rights Reserved.
vs Container Killer
• Basically same as OOM
• Deciding policy at first
• When should containers abort?
• Running test query again and again
• Profiling and dump heaps when Container killer appears
• Check (p,v)mem-check-enabled configuration
• pmem-check-enabled
• vmem-check-enabled
• One proposal is to automatic retry and tuning
• MAPREDUCE-5785
• YARN-2091
25Copyright©2014 NTT corp. All Rights Reserved.
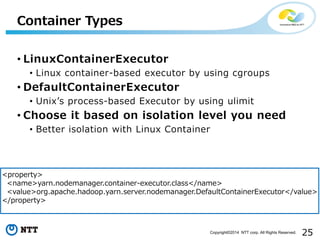
• LinuxContainerExecutor
• Linux container-based executor by using cgroups
• DefaultContainerExecutor
• Unix’s process-based Executor by using ulimit
• Choose it based on isolation level you need
• Better isolation with Linux Container
Container Types
<property>
<name>yarn.nodemanager.container-executor.class</name>
<value>org.apache.hadoop.yarn.server.nodemanager.DefaultContainerExecutor</value>
</property>
26Copyright©2014 NTT corp. All Rights Reserved.
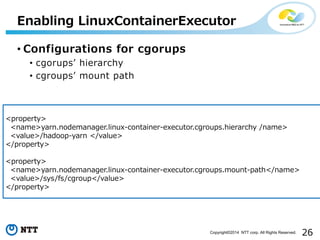
• Configurations for cgorups
• cgorups’ hierarchy
• cgroups’ mount path
Enabling LinuxContainerExecutor
<property>
<name>yarn.nodemanager.linux-container-executor.cgroups.hierarchy /name>
<value>/hadoop-yarn </value>
</property>
<property>
<name>yarn.nodemanager.linux-container-executor.cgroups.mount-path</name>
<value>/sys/fs/cgroup</value>
</property>
27Copyright©2014 NTT corp. All Rights Reserved.
SCHEDULERS
28Copyright©2014 NTT corp. All Rights Reserved.
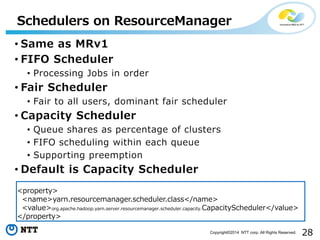
Schedulers on ResourceManager
• Same as MRv1
• FIFO Scheduler
• Processing Jobs in order
• Fair Scheduler
• Fair to all users, dominant fair scheduler
• Capacity Scheduler
• Queue shares as percentage of clusters
• FIFO scheduling within each queue
• Supporting preemption
• Default is Capacity Scheduler
<property>
<name>yarn.resourcemanager.scheduler.class</name>
<value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler</value>
</property>
29Copyright©2014 NTT corp. All Rights Reserved.
HELATH CHECK ON
NODEMANAGER
30Copyright©2014 NTT corp. All Rights Reserved.
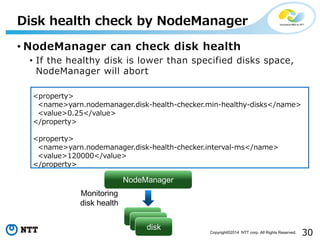
Disk health check by NodeManager
• NodeManager can check disk health
• If the healthy disk is lower than specified disks space,
NodeManager will abort
<property>
<name>yarn.nodemanager.disk-health-checker.min-healthy-disks</name>
<value>0.25</value>
</property>
<property>
<name>yarn.nodemanager.disk-health-checker.interval-ms</name>
<value>120000</value>
</property>
NodeManager
Monitoring
disk health
disk
disk
disk
31Copyright©2014 NTT corp. All Rights Reserved.
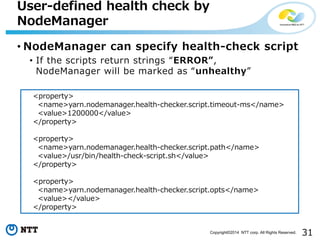
User-defined health check by
NodeManager
• NodeManager can specify health-check script
• If the scripts return strings “ERROR”,
NodeManager will be marked as “unhealthy”
<property>
<name>yarn.nodemanager.health-checker.script.timeout-ms</name>
<value>1200000</value>
</property>
<property>
<name>yarn.nodemanager.health-checker.script.path</name>
<value>/usr/bin/health-check-script.sh</value>
</property>
<property>
<name>yarn.nodemanager.health-checker.script.opts</name>
<value></value>
</property>
32Copyright©2014 NTT corp. All Rights Reserved.
THREAD TUNING
33Copyright©2014 NTT corp. All Rights Reserved.
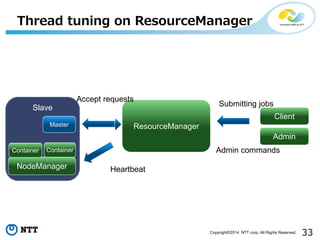
Thread tuning on ResourceManager
ResourceManager
Client
Slave
NodeManager
Container Container
Master
Admin
Admin commands
Submitting jobs
Accept requests
Heartbeat
34Copyright©2014 NTT corp. All Rights Reserved.
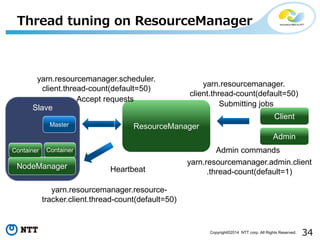
Thread tuning on ResourceManager
ResourceManager
Client
Slave
NodeManager
Container Container
Master
yarn.resourcemanager.
client.thread-count(default=50)
Admin
Admin commands
yarn.resourcemanager.scheduler.
client.thread-count(default=50)
yarn.resourcemanager.resource-
tracker.client.thread-count(default=50)
yarn.resourcemanager.admin.client
.thread-count(default=1)
Submitting jobs
Accept requests
Heartbeat
35Copyright©2014 NTT corp. All Rights Reserved.
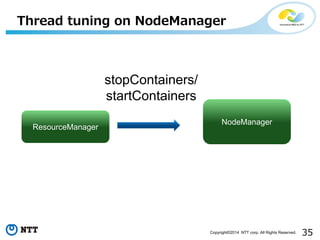
Thread tuning on NodeManager
ResourceManager
NodeManager
stopContainers/
startContainers
36Copyright©2014 NTT corp. All Rights Reserved.
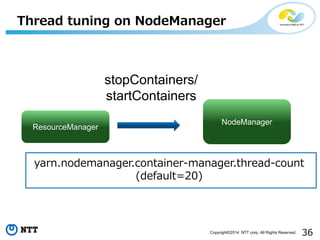
Thread tuning on NodeManager
yarn.nodemanager.container-manager.thread-count
(default=20)
ResourceManager
NodeManager
stopContainers/
startContainers
37Copyright©2014 NTT corp. All Rights Reserved.
ADVANCED CONFIGURATIONS
38Copyright©2014 NTT corp. All Rights Reserved.
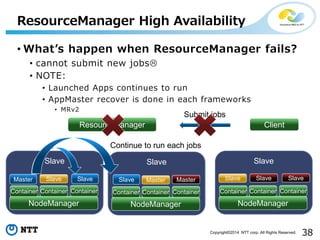
• What’s happen when ResourceManager fails?
• cannot submit new jobs
• NOTE:
• Launched Apps continues to run
• AppMaster recover is done in each frameworks
• MRv2
ResourceManager High Availability
ResourceManager
Slave
NodeManager
Container Container Container
Slave
NodeManager
Container Container Container
Slave
NodeManager
Container Container Container
Master Slave Slave MasterSlave SlaveMaster Slave Slave
Client
Submit jobs
Continue to run each jobs
39Copyright©2014 NTT corp. All Rights Reserved.
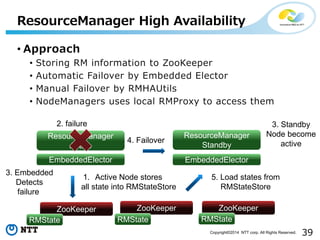
• Approach
• Storing RM information to ZooKeeper
• Automatic Failover by Embedded Elector
• Manual Failover by RMHAUtils
• NodeManagers uses local RMProxy to access them
ResourceManager High Availability
ResourceManager
Active
ResourceManager
Standby
ZooKeeper ZooKeeper ZooKeeper
2. failure
3. Embedded
Detects
failure
EmbeddedElector EmbeddedElector
4. Failover
RMState RMState RMState
1. Active Node stores
all state into RMStateStore
3. Standby
Node become
active
5. Load states from
RMStateStore
40Copyright©2014 NTT corp. All Rights Reserved.
cluster1
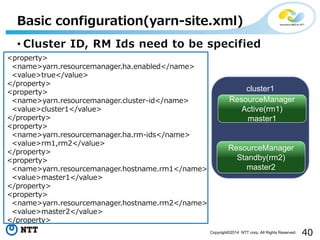
• Cluster ID, RM Ids need to be specified
Basic configuration(yarn-site.xml)
<property>
<name>yarn.resourcemanager.ha.enabled</name>
<value>true</value>
</property>
<property>
<name>yarn.resourcemanager.cluster-id</name>
<value>cluster1</value>
</property>
<property>
<name>yarn.resourcemanager.ha.rm-ids</name>
<value>rm1,rm2</value>
</property>
<property>
<name>yarn.resourcemanager.hostname.rm1</name>
<value>master1</value>
</property>
<property>
<name>yarn.resourcemanager.hostname.rm2</name>
<value>master2</value>
</property>
ResourceManager
Active(rm1)
master1
ResourceManager
Standby(rm2)
master2
41Copyright©2014 NTT corp. All Rights Reserved.
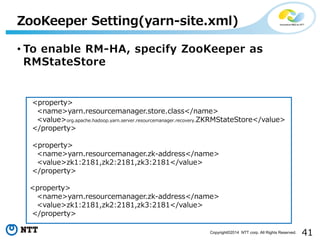
• To enable RM-HA, specify ZooKeeper as
RMStateStore
ZooKeeper Setting(yarn-site.xml)
<property>
<name>yarn.resourcemanager.store.class</name>
<value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
</property>
<property>
<name>yarn.resourcemanager.zk-address</name>
<value>zk1:2181,zk2:2181,zk3:2181</value>
</property>
<property>
<name>yarn.resourcemanager.zk-address</name>
<value>zk1:2181,zk2:2181,zk3:2181</value>
</property>
42Copyright©2014 NTT corp. All Rights Reserved.
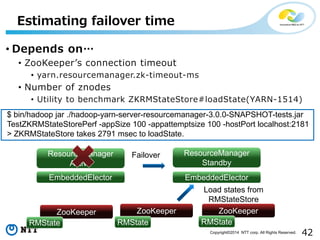
• Depends on…
• ZooKeeper’s connection timeout
• yarn.resourcemanager.zk-timeout-ms
• Number of znodes
• Utility to benchmark ZKRMStateStore#loadState(YARN-1514)
Estimating failover time
$ bin/hadoop jar ./hadoop-yarn-server-resourcemanager-3.0.0-SNAPSHOT-tests.jar
TestZKRMStateStorePerf -appSize 100 -appattemptsize 100 -hostPort localhost:2181
> ZKRMStateStore takes 2791 msec to loadState.
ResourceManager
Active
ResourceManager
Standby
ZooKeeper ZooKeeper ZooKeeper
EmbeddedElector EmbeddedElector
RMState RMState RMState
Load states from
RMStateStore
Failover
43Copyright©2014 NTT corp. All Rights Reserved.
• YARN is a new layer for managing resources
• New components from V2
• ResourceManager
• NodeManager
• Application Master
• There are lots tuning points
• Capacity Planning
• Health check on NM
• RM and NM threads
• ResourceManager HA
• Questions ->
user@hadoop.apache.org
• Issue ->
https://issues.apache.org/jira/browse/YARN/
Summary