Semi-supervised Learning with
Deep Generative Models
Yusuke Iwasawa
DL Hacks 輪読 2015.04.21
• NIPS2014(非引用:4)
• 選定理由
• MNISTデータでStyle(筆跡みたいなもの)を学習している結果を見て
• 人間行動でも同じこと大事なんじゃないかなーと
• Semi-Supervised Learningというよりは、Deep Generative Modelsの方に興味
Summary
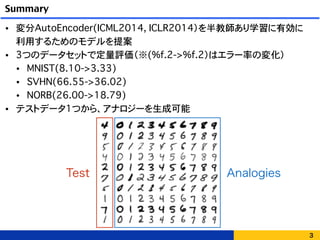
• 変分AutoEncoder(ICML2014, ICLR2014)を半教師あり学習に有効に

利用するためのモデルを提案
• 3つのデータセットで定量評価(※(%f.2->%f.2)はエラー率の変化)
• MNIST(8.10->3.33)
• SVHN(66.55->36.02)
• NORB(26.00->18.79)
• テストデータ1つから、アナロジーを生成可能
3
Test Analogies
半教師有り学習
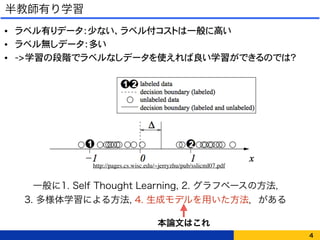
• ラベル有りデータ:少ない、ラベル付コストは一般に高い
• ラベル無しデータ:多い
• ->学習の段階でラベルなしデータを使えれば良い学習ができるのでは?
4
http://pages.cs.wisc.edu/~jerryzhu/pub/sslicml07.pdf
一般に1. Self Thought Learning, 2. グラフベースの方法, 

3. 多様体学習による方法, 4. 生成モデルを用いた方法,がある
本論文はこれ
生成モデルを半教師有り学習に活用するモデル
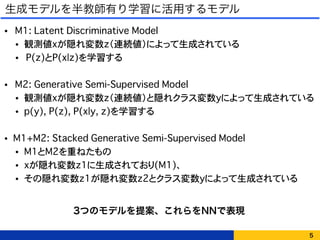
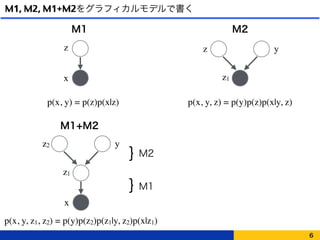
• M1: Latent Discriminative Model
• 観測値xが隠れ変数z(連続値)によって生成されている
• P(z)とP(x|z)を学習する
• M2: Generative Semi-Supervised Model
• 観測値xが隠れ変数z(連続値)と隠れクラス変数yによって生成されている
• p(y), P(z), P(x|y, z)を学習する
• M1+M2: Stacked Generative Semi-Supervised Model
• M1とM2を重ねたもの
• xが隠れ変数z1に生成されており(M1)、
• その隠れ変数z1が隠れ変数z2とクラス変数yによって生成されている�
5
3つのモデルを提案、これらをNNで表現
M1, M2, M1+M2をグラフィカルモデルで書く
6
M1 M2
M1+M2
z1
z2 y
x
z
x z1
z y
p(x, y) = p(z)p(x|z) p(x, y, z) = p(y)p(z)p(x|y, z)
p(x, y, z1, z2) = p(y)p(z2)p(z1|y, z2)p(x|z1)
M1
M2}
}
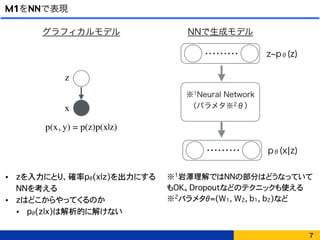
M1をNNで表現
• zを入力にとり、確率pθ(x|z)を出力にする
NNを考える
• zはどこからやってくるのか
• pθ(z|x)は解析的に解けない
7
………
※1Neural Network
(パラメタ※2θ)
………
pθ(x¦z)
z pθ(z)
※1岩澤理解ではNNの部分はどうなっていて
もOK。Dropoutなどのテクニックも使える
※2パラメタθ=(W1, W2, b1, b2)など
z
x
p(x, y) = p(z)p(x|z)
グラフィカルモデル NNで生成モデル
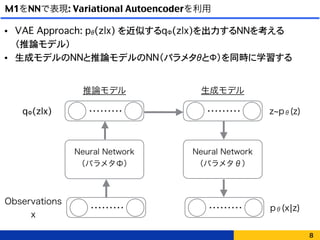
M1をNNで表現: Variational Autoencoderを利用
• VAE Approach: pθ(z|x) を近似するqΦ(z|x)を出力するNNを考える

(推論モデル)
• 生成モデルのNNと推論モデルのNN(パラメタθとΦ)を同時に学習する
8
………
Neural Network
(パラメタθ)
………
pθ(x¦z)
生成モデル
………
Neural Network
(パラメタΦ)
………
Observations

x
qΦ(z|x)
推論モデル
z pθ(z)
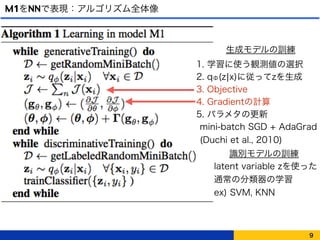
M1をNNで表現:アルゴリズム全体像
9
2. qΦ(z¦x)に従ってzを生成
1. 学習に使う観測値の選択
3. Objective
4. Gradientの計算
5. パラメタの更新
mini-batch SGD + AdaGrad
(Duchi et al., 2010)
生成モデルの訓練
識別モデルの訓練
latent variable zを使った
通常の分類器の学習
ex) SVM, KNN
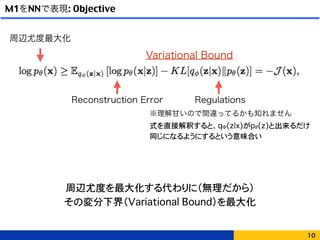
M1をNNで表現: Objective
周辺尤度を最大化する代わりに(無理だから)

その変分下界(Variational Bound)を最大化
10
周辺尤度最大化
Reconstruction Error Regulations
※理解甘いので間違ってるかも知れません
式を直接解釈すると、qΦ(z|x)がpθ(z)と出来るだけ
同じになるようにするという意味合い
Variational Bound
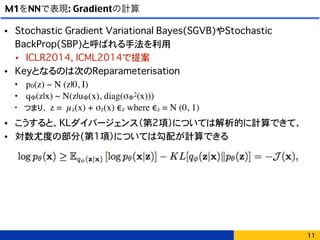
M1をNNで表現: Gradientの計算
• Stochastic Gradient Variational Bayes(SGVB)やStochastic
BackProp(SBP)と呼ばれる手法を利用
• ICLR2014, ICML2014で提案
• Keyとなるのは次のReparameterisation
• pθ(z) ~ N (z|0, I)
• qΦ(z|x) ~ N(z|uΦ(x), diag(σΦ
2(x)))
• つまり、z = µz(x) + σz(x) ϵz where ϵz = N (0, 1)
• こうすると、KLダイバージェンス(第2項)については解析的に計算できて、
• 対数尤度の部分(第1項)については勾配が計算できる
11
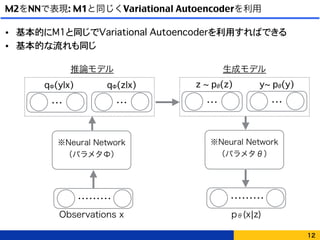
M2をNNで表現: M1と同じくVariational Autoencoderを利用
12
………
※Neural Network
(パラメタθ)
pθ(x¦z)
生成モデル
………
※Neural Network
(パラメタΦ)
Observations x
qΦ(y|x)
推論モデル
• 基本的にM1と同じでVariational Autoencoderを利用すればできる
• 基本的な流れも同じ
…
qΦ(z|x)
…
z ~ pθ(z)
…
y~ pθ(y)
…
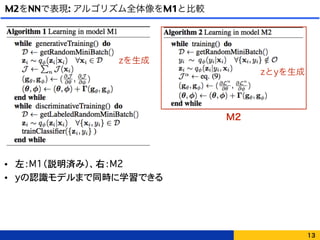
M2をNNで表現: アルゴリズム全体像をM1と比較
• 左:M1(説明済み)、右:M2
• yの認識モデルまで同時に学習できる
13
zとyを生成
zを生成
M2
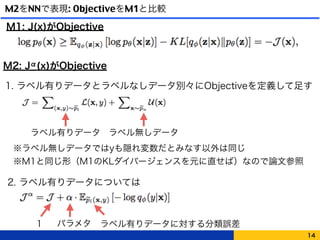
M2をNNで表現: ObjectiveをM1と比較
14
M1: J(x)がObjective
M2: Jα(x)がObjective
1. ラベル有りデータとラベルなしデータ別々にObjectiveを定義して足す
2. ラベル有りデータについては
1
ラベル無しデータ
※ラベル無しデータではyも隠れ変数だとみなす以外は同じ
※M1と同じ形(M1のKLダイバージェンスを元に直せば)なので論文参照
パラメタ ラベル有りデータに対する分類誤差
ラベル有りデータ
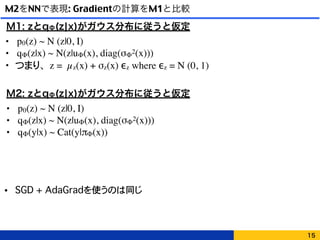
M2をNNで表現: Gradientの計算をM1と比較
• SGD + AdaGradを使うのは同じ
15
M1: zとqΦ(z¦x)がガウス分布に従うと仮定
• pθ(z) ~ N (z|0, I)
• qΦ(z|x) ~ N(z|uΦ(x), diag(σΦ
2(x)))
• つまり、z = µz(x) + σz(x) ϵz where ϵz = N (0, 1)
M2: zとqΦ(z¦x)がガウス分布に従うと仮定
• pθ(z) ~ N (z|0, I)
• qΦ(z|x) ~ N(z|uΦ(x), diag(σΦ
2(x)))
• qΦ(y|x) ~ Cat(y|πΦ(x))
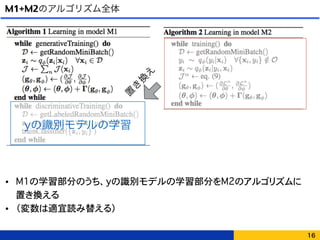
M1+M2のアルゴリズム全体
• M1の学習部分のうち、yの識別モデルの学習部分をM2のアルゴリズムに

置き換える
• (変数は適宜読み替える)
16
yの識別モデルの学習置
き
換
え
Computational Complexity
• auto-encoderやNNをベースにした他のアプローチより計算量が少ない
• 既存の有力な手法と比べて最も少ない計算量である
• (よく調べてないので詳しい方教えてください)
• かつ、完全な確率モデルを提供している
• いろんな推論を行える(あとで示すように、アナロジーみたいなものも

出せる)
17
評価実験
• 定量的評価
• ラベル有りデータ数を制限した上でMNIST, SVHN, NORBで評価
• 定性的評価:
• テストデータXから2次元の隠れ変数yを学習、ラベルyを固定して様々な

ZからX|y, zを生成
• テストデータXからZ|Xの推論モデルを構築し、あるテストデータxに対する
z推論、様々なラベルyでX|y,zを生成
18
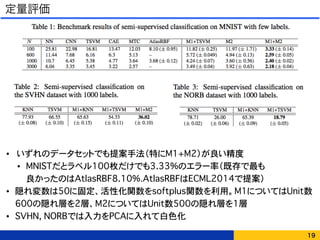
定量評価
• いずれのデータセットでも提案手法(特にM1+M2)が良い精度
• MNISTだとラベル100枚だけでも3.33%のエラー率(既存で最も

良かったのはAtlasRBF8.10%.AtlasRBFはECML2014で提案)
• 隠れ変数は50に固定、活性化関数をsoftplus関数を利用。M1についてはUnit数
600の隠れ層を2層、M2についてはUnit数500の隠れ層を1層
• SVHN, NORBでは入力をPCAに入れて白色化
19
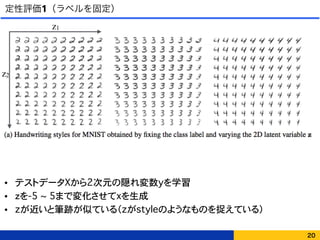
定性評価1(ラベルを固定)
• テストデータXから2次元の隠れ変数yを学習
• zを-5 ~ 5まで変化させてxを生成
• zが近いと筆跡が似ている(zがstyleのようなものを捉えている)
20
z1
z2
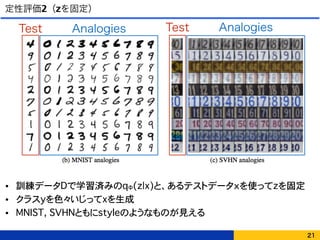
定性評価2(zを固定)
• 訓練データDで学習済みのqΦ(z|x)と、あるテストデータxを使ってzを固定
• クラスyを色々いじってxを生成
• MNIST, SVHNともにstyleのようなものが見える
21
Test Analogies AnalogiesTest
Discussion and Conclusion
• 半教師有り学習に有効なNNを利用した生成モデルを提案
• 変分Autoencoderを利用
• 提案モデルは、既存手法と同程度の計算コストでより良い精度を出せる
• 次の様な課題がある
1. Convolutional Neural Networkの枠組みをどう入れるか
2. クラスの数が増えると、計算量が増える
22
参考文献
• 論文
• Kingma, Max Welling, “Auto-Encoding Variational Bayes”, ICLR2014
• D. J. Rezende, S. Mohamed, D. Wiestra, “Stochastic Backpropagation and
Approximate Inference in Deep Generative Models”, ICML2014
• Webサイト
• NIPS2014読み会で深層半教師あり学習の論文を紹介しました: http://
beam2d.github.io/blog/2015/01/24/ssl-deep/
• PRML8章解説: http://www.slideshare.net/ruto5/chap08-1-12
• Denosing Autoencoderとその一般化、http://beam2d.github.io/blog/
2013/12/23/dae-and-its-generalization/
• Morphing Faces: http://vdumoulin.github.io/morphing_faces/#variational-
autoencoders
• Deep Learningによる医用画像読影支援:�http://www.slideshare.net/
issei_sato/deep-learning-41310617
• Variational Autoencoder参考サイト: https://
ift6266h15.files.wordpress.com/2015/04/20_vae.pdf
• 半教師あり学習: http://www.slideshare.net/syou6162/ss-3001118
• 多様体学習について: http://d.hatena.ne.jp/Zellij/20131127/p1
23
Variational Autoencoderを利用したDemo、関連するVideo、実装
• Demo
• Morphing Faces: http://vdumoulin.github.io/morphing_faces/
online_demo.html
• Video
• Deep Learning Lecture 14: Karol Gregor on Variational
Autoencoders and Image Generation: https://
www.youtube.com/watch?v=P78QYjWh5sM
• 実装
• 本論文の実験リポジトリ: https://github.com/dpkingma/nips14-ssl
24