Skip to main content
Download free for 30 days
Sign in
Upload
Language (EN)
Support
Business
Mobile
Social Media
Marketing
Technology
Art & Photos
Career
Design
Education
Presentations & Public Speaking
Government & Nonprofit
Healthcare
Internet
Law
Leadership & Management
Automotive
Engineering
Software
Recruiting & HR
Retail
Sales
Services
Science
Small Business & Entrepreneurship
Food
Environment
Economy & Finance
Data & Analytics
Investor Relations
Sports
Spiritual
News & Politics
Travel
Self Improvement
Real Estate
Entertainment & Humor
Health & Medicine
Devices & Hardware
Lifestyle
EN
Upload
Download free for 30 days
Sign in
Uploaded by
ARISE analytics
PPTX, PDF
949 views
【論文読み会】Deep Reinforcement Learning at the Edge of the Statistical Precipice
社内で行った「NeurIPS読み会」でまとめた資料です。
Data & Analytics
◦
Read more
0
Save
Share
Embed
Save to Drive
Download now
Download to read offline
1
/ 21
2
/ 21
3
/ 21
4
/ 21
5
/ 21
6
/ 21
7
/ 21
8
/ 21
9
/ 21
10
/ 21
11
/ 21
12
/ 21
13
/ 21
14
/ 21
15
/ 21
16
/ 21
17
/ 21
18
/ 21
19
/ 21
20
/ 21
More Related Content
PPTX
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
by
Deep Learning JP
24 slides
4.8K views
PDF
Action Recognitionの歴史と最新動向
by
Ohnishi Katsunori
40 slides
9.4K views
PDF
【DL輪読会】マルチエージェント強化学習における近年の 協調的方策学習アルゴリズムの発展
by
Deep Learning JP
37 slides
9K views
PDF
【DL輪読会】Hierarchical Text-Conditional Image Generation with CLIP Latents
by
Deep Learning JP
20 slides
65.8K views
PPTX
【DL輪読会】The Forward-Forward Algorithm: Some Preliminary
by
Deep Learning JP
29 slides
3K views
PPTX
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
by
Deep Learning JP
34 slides
4.5K views
PPTX
モデルアーキテクチャ観点からの高速化2019
by
Yusuke Uchida
90 slides
18.1K views
PDF
グラフニューラルネットワーク入門
by
ryosuke-kojima
65 slides
57.7K views
【DL輪読会】SimCSE: Simple Contrastive Learning of Sentence Embeddings (EMNLP 2021)
by
Deep Learning JP
24 slides
4.8K views
Action Recognitionの歴史と最新動向
by
Ohnishi Katsunori
40 slides
9.4K views
【DL輪読会】マルチエージェント強化学習における近年の 協調的方策学習アルゴリズムの発展
by
Deep Learning JP
37 slides
9K views
【DL輪読会】Hierarchical Text-Conditional Image Generation with CLIP Latents
by
Deep Learning JP
20 slides
65.8K views
【DL輪読会】The Forward-Forward Algorithm: Some Preliminary
by
Deep Learning JP
29 slides
3K views
[DL輪読会]Set Transformer: A Framework for Attention-based Permutation-Invariant...
by
Deep Learning JP
34 slides
4.5K views
モデルアーキテクチャ観点からの高速化2019
by
Yusuke Uchida
90 slides
18.1K views
グラフニューラルネットワーク入門
by
ryosuke-kojima
65 slides
57.7K views
What's hot
PDF
深層学習によるHuman Pose Estimationの基礎
by
Takumi Ohkuma
44 slides
3.9K views
PDF
POMDP下での強化学習の基礎と応用
by
Yasunori Ozaki
32 slides
4.5K views
PPTX
Depth Estimation論文紹介
by
Keio Robotics Association
14 slides
3.1K views
PDF
Transformer メタサーベイ
by
cvpaper. challenge
181 slides
31.4K views
PDF
最近強化学習の良記事がたくさん出てきたので勉強しながらまとめた
by
Katsuya Ito
36 slides
7.9K views
PPTX
畳み込みニューラルネットワークの高精度化と高速化
by
Yusuke Uchida
133 slides
66.3K views
PDF
【DL輪読会】Code as Policies: Language Model Programs for Embodied Control
by
Deep Learning JP
25 slides
987 views
PPTX
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets
by
Deep Learning JP
17 slides
4.6K views
PDF
【メタサーベイ】Vision and Language のトップ研究室/研究者
by
cvpaper. challenge
154 slides
2.4K views
PPTX
[DL輪読会] マルチエージェント強化学習と心の理論
by
Deep Learning JP
42 slides
5.6K views
PPTX
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
PDF
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
by
Deep Learning JP
29 slides
19.7K views
PDF
[DL輪読会]Reward Augmented Maximum Likelihood for Neural Structured Prediction
by
Deep Learning JP
26 slides
2.5K views
PPTX
Tensor コアを使った PyTorch の高速化
by
Yusuke Fujimoto
14 slides
9.1K views
PPTX
【DL輪読会】DayDreamer: World Models for Physical Robot Learning
by
Deep Learning JP
15 slides
1.2K views
PDF
多様な強化学習の概念と課題認識
by
佑 甲野
38 slides
59.4K views
PDF
点群深層学習 Meta-study
by
Naoya Chiba
47 slides
10.9K views
PPTX
帰納バイアスが成立する条件
by
Shinobu KINJO
38 slides
692 views
PPTX
ORB-SLAMの手法解説
by
Masaya Kaneko
39 slides
37.3K views
PPTX
【DL輪読会】Scaling Laws for Neural Language Models
by
Deep Learning JP
27 slides
5.2K views
深層学習によるHuman Pose Estimationの基礎
by
Takumi Ohkuma
44 slides
3.9K views
POMDP下での強化学習の基礎と応用
by
Yasunori Ozaki
32 slides
4.5K views
Depth Estimation論文紹介
by
Keio Robotics Association
14 slides
3.1K views
Transformer メタサーベイ
by
cvpaper. challenge
181 slides
31.4K views
最近強化学習の良記事がたくさん出てきたので勉強しながらまとめた
by
Katsuya Ito
36 slides
7.9K views
畳み込みニューラルネットワークの高精度化と高速化
by
Yusuke Uchida
133 slides
66.3K views
【DL輪読会】Code as Policies: Language Model Programs for Embodied Control
by
Deep Learning JP
25 slides
987 views
[DL輪読会]Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets
by
Deep Learning JP
17 slides
4.6K views
【メタサーベイ】Vision and Language のトップ研究室/研究者
by
cvpaper. challenge
154 slides
2.4K views
[DL輪読会] マルチエージェント強化学習と心の理論
by
Deep Learning JP
42 slides
5.6K views
【DL輪読会】An Image is Worth One Word: Personalizing Text-to-Image Generation usi...
by
Deep Learning JP
22 slides
1.3K views
[DL輪読会]Wasserstein GAN/Towards Principled Methods for Training Generative Adv...
by
Deep Learning JP
29 slides
19.7K views
[DL輪読会]Reward Augmented Maximum Likelihood for Neural Structured Prediction
by
Deep Learning JP
26 slides
2.5K views
Tensor コアを使った PyTorch の高速化
by
Yusuke Fujimoto
14 slides
9.1K views
【DL輪読会】DayDreamer: World Models for Physical Robot Learning
by
Deep Learning JP
15 slides
1.2K views
多様な強化学習の概念と課題認識
by
佑 甲野
38 slides
59.4K views
点群深層学習 Meta-study
by
Naoya Chiba
47 slides
10.9K views
帰納バイアスが成立する条件
by
Shinobu KINJO
38 slides
692 views
ORB-SLAMの手法解説
by
Masaya Kaneko
39 slides
37.3K views
【DL輪読会】Scaling Laws for Neural Language Models
by
Deep Learning JP
27 slides
5.2K views
Similar to 【論文読み会】Deep Reinforcement Learning at the Edge of the Statistical Precipice
PDF
未来画像予測モデルと時間重み付けを導入した価値関数に基づく強化学習
by
MILab
34 slides
257 views
PDF
[DL輪読会]Learning to Act by Predicting the Future
by
Deep Learning JP
42 slides
1.5K views
PDF
Reinforcement Learning: An Introduction 輪読会第1回資料
by
Yasunori Ozaki
18 slides
1.2K views
PDF
強化学習の実適用に向けた課題と工夫
by
Masahiro Yasumoto
60 slides
843 views
PDF
Beta policy-gunosy
by
b a
21 slides
85 views
PDF
強化学習と逆強化学習を組み合わせた模倣学習
by
Eiji Uchibe
48 slides
27.5K views
PPTX
強化学習1章
by
hiroki yamaoka
33 slides
585 views
PDF
強化学習勉強会・論文紹介(第22回)
by
Sotetsu KOYAMADA(小山田創哲)
23 slides
1.2K views
PDF
強化学習の基礎的な考え方と問題の分類
by
佑 甲野
43 slides
77.1K views
PDF
分散型強化学習手法の最近の動向と分散計算フレームワークRayによる実装の試み
by
SusumuOTA
68 slides
1.1K views
PPTX
Batch Reinforcement Learning
by
Takuma Oda
32 slides
255 views
PPTX
強化学習 と ゲーム理論 (MARL)
by
HarukaKiyohara
42 slides
1.9K views
PDF
強化学習とは (MIJS 分科会資料 2016/10/11)
by
Akihiro HATANAKA
10 slides
1.5K views
PDF
[Dl輪読会]introduction of reinforcement learning
by
Deep Learning JP
46 slides
6.2K views
PDF
Rainbow: Combining Improvements in Deep Reinforcement Learning (AAAI2018 unde...
by
Toru Fujino
38 slides
1.5K views
PPTX
[DL輪読会]Autonomous Reinforcement Learning: Formalism and Benchmarking
by
Deep Learning JP
17 slides
717 views
PPTX
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
PPT
Deep Auto-Encoder Neural Networks in Reiforcement Learnning (第 9 回 Deep Learn...
by
Ohsawa Goodfellow
27 slides
4.9K views
PDF
20190213 rl healthcare_guideline
by
Tomohisa Seki
20 slides
261 views
PDF
「これからの強化学習」勉強会#2
by
Chihiro Kusunoki
13 slides
3.7K views
未来画像予測モデルと時間重み付けを導入した価値関数に基づく強化学習
by
MILab
34 slides
257 views
[DL輪読会]Learning to Act by Predicting the Future
by
Deep Learning JP
42 slides
1.5K views
Reinforcement Learning: An Introduction 輪読会第1回資料
by
Yasunori Ozaki
18 slides
1.2K views
強化学習の実適用に向けた課題と工夫
by
Masahiro Yasumoto
60 slides
843 views
Beta policy-gunosy
by
b a
21 slides
85 views
強化学習と逆強化学習を組み合わせた模倣学習
by
Eiji Uchibe
48 slides
27.5K views
強化学習1章
by
hiroki yamaoka
33 slides
585 views
強化学習勉強会・論文紹介(第22回)
by
Sotetsu KOYAMADA(小山田創哲)
23 slides
1.2K views
強化学習の基礎的な考え方と問題の分類
by
佑 甲野
43 slides
77.1K views
分散型強化学習手法の最近の動向と分散計算フレームワークRayによる実装の試み
by
SusumuOTA
68 slides
1.1K views
Batch Reinforcement Learning
by
Takuma Oda
32 slides
255 views
強化学習 と ゲーム理論 (MARL)
by
HarukaKiyohara
42 slides
1.9K views
強化学習とは (MIJS 分科会資料 2016/10/11)
by
Akihiro HATANAKA
10 slides
1.5K views
[Dl輪読会]introduction of reinforcement learning
by
Deep Learning JP
46 slides
6.2K views
Rainbow: Combining Improvements in Deep Reinforcement Learning (AAAI2018 unde...
by
Toru Fujino
38 slides
1.5K views
[DL輪読会]Autonomous Reinforcement Learning: Formalism and Benchmarking
by
Deep Learning JP
17 slides
717 views
【DL輪読会】"Language Instructed Reinforcement Learning for Human-AI Coordination "
by
Deep Learning JP
18 slides
591 views
Deep Auto-Encoder Neural Networks in Reiforcement Learnning (第 9 回 Deep Learn...
by
Ohsawa Goodfellow
27 slides
4.9K views
20190213 rl healthcare_guideline
by
Tomohisa Seki
20 slides
261 views
「これからの強化学習」勉強会#2
by
Chihiro Kusunoki
13 slides
3.7K views
More from ARISE analytics
PDF
20260828_AriseUniversityTraning_生成AI講座_テックブログ
by
ARISE analytics
30 slides
1 view
PDF
ARISE analytics 会社紹介パンフレット ~2025年度版~ ご自由にダウンロードください。
by
ARISE analytics
10 slides
136 views
PDF
AgentOps:AIエージェント時代の幕開けとガバナンスについて ~AgentOpsの体系的な理解を目指して~
by
ARISE analytics
32 slides
749 views
PDF
【JSAI2024】学術論文の定量的評価と効果的な活用について Quantitative evaluation and effective utiliza...
by
ARISE analytics
1 slide
783 views
PDF
【JSAI2024】J-NER大規模言語モデルのための固有表現認識における拡張固有表現階層を考慮したベンチマークデータセット.pdf
by
ARISE analytics
1 slide
543 views
PDF
【JSAI2024】ブラックボックス大規模言語モデルにおけるHallucination検知手法の検討.pdf
by
ARISE analytics
1 slide
633 views
PDF
【JSAI2024】LLMエージェントの人間との対話における反芻的返答の親近感向上効果_v1.1.pdf
by
ARISE analytics
1 slide
501 views
PPTX
【第3回生成AIなんでもLT会資料】_動画生成AIと物理法則_v0.2.pptx
by
ARISE analytics
18 slides
797 views
PPTX
【第3回】生成AIなんでもLT会 2024_0304なんでも生成AI_sergicalsix.pptx
by
ARISE analytics
19 slides
1.3K views
PDF
めんどうな環境構築とはおさらば!Dockerの概要と使い方
by
ARISE analytics
23 slides
398 views
PDF
【論文レベルで理解しよう!】 欠測値処理編
by
ARISE analytics
19 slides
643 views
PDF
【論文レベルで理解しよう!】 大規模言語モデル(LLM)編
by
ARISE analytics
20 slides
1K views
PDF
【論文読み会】Signing at Scale: Learning to Co-Articulate Signs for Large-Scale Pho...
by
ARISE analytics
32 slides
444 views
PDF
Hierarchical Metadata-Aware Document Categorization under Weak Supervision (...
by
ARISE analytics
24 slides
254 views
PDF
教師なしGNNによるIoTデバイスの異常通信検知の検討
by
ARISE analytics
21 slides
1.8K views
PPTX
【論文読み会】Pyraformer_Low-Complexity Pyramidal Attention for Long-Range Time Seri...
by
ARISE analytics
18 slides
893 views
PPTX
【論文読み会】Analytic-DPM_an Analytic Estimate of the Optimal Reverse Variance in D...
by
ARISE analytics
17 slides
712 views
PPTX
【論文読み会】Autoregressive Diffusion Models.pptx
by
ARISE analytics
27 slides
6.7K views
PPTX
【論文読み会】BEiT_BERT Pre-Training of Image Transformers.pptx
by
ARISE analytics
29 slides
1.1K views
PPTX
【論文読み会】PiCO_Contrastive Label Disambiguation for Partial Label Learning.pptx
by
ARISE analytics
21 slides
811 views
20260828_AriseUniversityTraning_生成AI講座_テックブログ
by
ARISE analytics
30 slides
1 view
ARISE analytics 会社紹介パンフレット ~2025年度版~ ご自由にダウンロードください。
by
ARISE analytics
10 slides
136 views
AgentOps:AIエージェント時代の幕開けとガバナンスについて ~AgentOpsの体系的な理解を目指して~
by
ARISE analytics
32 slides
749 views
【JSAI2024】学術論文の定量的評価と効果的な活用について Quantitative evaluation and effective utiliza...
by
ARISE analytics
1 slide
783 views
【JSAI2024】J-NER大規模言語モデルのための固有表現認識における拡張固有表現階層を考慮したベンチマークデータセット.pdf
by
ARISE analytics
1 slide
543 views
【JSAI2024】ブラックボックス大規模言語モデルにおけるHallucination検知手法の検討.pdf
by
ARISE analytics
1 slide
633 views
【JSAI2024】LLMエージェントの人間との対話における反芻的返答の親近感向上効果_v1.1.pdf
by
ARISE analytics
1 slide
501 views
【第3回生成AIなんでもLT会資料】_動画生成AIと物理法則_v0.2.pptx
by
ARISE analytics
18 slides
797 views
【第3回】生成AIなんでもLT会 2024_0304なんでも生成AI_sergicalsix.pptx
by
ARISE analytics
19 slides
1.3K views
めんどうな環境構築とはおさらば!Dockerの概要と使い方
by
ARISE analytics
23 slides
398 views
【論文レベルで理解しよう!】 欠測値処理編
by
ARISE analytics
19 slides
643 views
【論文レベルで理解しよう!】 大規模言語モデル(LLM)編
by
ARISE analytics
20 slides
1K views
【論文読み会】Signing at Scale: Learning to Co-Articulate Signs for Large-Scale Pho...
by
ARISE analytics
32 slides
444 views
Hierarchical Metadata-Aware Document Categorization under Weak Supervision (...
by
ARISE analytics
24 slides
254 views
教師なしGNNによるIoTデバイスの異常通信検知の検討
by
ARISE analytics
21 slides
1.8K views
【論文読み会】Pyraformer_Low-Complexity Pyramidal Attention for Long-Range Time Seri...
by
ARISE analytics
18 slides
893 views
【論文読み会】Analytic-DPM_an Analytic Estimate of the Optimal Reverse Variance in D...
by
ARISE analytics
17 slides
712 views
【論文読み会】Autoregressive Diffusion Models.pptx
by
ARISE analytics
27 slides
6.7K views
【論文読み会】BEiT_BERT Pre-Training of Image Transformers.pptx
by
ARISE analytics
29 slides
1.1K views
【論文読み会】PiCO_Contrastive Label Disambiguation for Partial Label Learning.pptx
by
ARISE analytics
21 slides
811 views
【論文読み会】Deep Reinforcement Learning at the Edge of the Statistical Precipice
1.
Deep Reinforcement Learning
at the Edge of the Statistical Precipice Marketing Solution Division 内田 沙穂里 2022/03/23
2.
引用 ©2022 ARISE analytics
Reserved. 1 特に注釈がない限り、画像は論文・PJページからの引用。 論文 • Deep Reinforcement Learning at the Edge of the Statistical Precipice PJページ • Google AI Blog • rliable
3.
アジェンダ ©2022 ARISE analytics
Reserved. 2 1 強化学習とは 2 強化学習ロジック、既存評価方法の課題 4 新評価指標の提案 3 最新論文の評価結果の不確実性の検証
4.
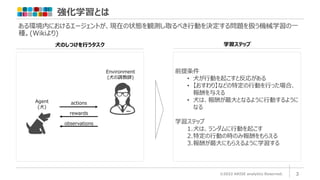
強化学習とは ©2022 ARISE analytics
Reserved. ある環境内におけるエージェントが、現在の状態を観測し取るべき行動を決定する問題を扱う機械学習の一 種。(Wikiより) 3 前提条件 • 犬が行動を起こすと反応がある • 【おすわり】などの特定の行動を行った場合、 報酬を与える • 犬は、報酬が最大となるように行動するように なる 学習ステップ 1.犬は、ランダムに行動を起こす 2.特定の行動の時のみ報酬をもらえる 3.報酬が最大にもらえるように学習する 犬のしつけを行うタスク 学習ステップ Environment (犬の調教師) Agent (犬) actions rewards observations
5.
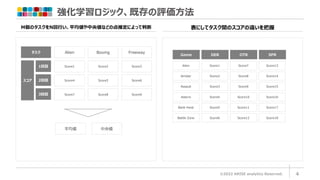
強化学習ロジック、既存の評価方法 ©2022 ARISE analytics
Reserved. 4 表にしてタスク間のスコアの違いを把握 スコア タスク Freeway 1回目 2回目 3回目 Score3 Score6 Alien Score1 Score4 Score7 Boxing Score2 Score5 Score8 Score9 平均値 中央値 M個のタスクをN回行い、平均値や中央値などの点推定によって判断 Game Alien Amidar Assault Asterix Bank Heist Battle Zone DER Score1 Score2 Score3 Score4 Score5 Score6 OTR Score7 Score8 Score9 Score10 Score11 Score12 SPR Score13 Score14 Score15 Score16 Score17 Score18
6.
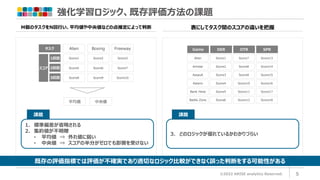
強化学習ロジック、既存評価方法の課題 ©2022 ARISE analytics
Reserved. 5 スコア タスク Freeway 1回目 2回目 3回目 Score3 Score7 Alien Score1 Score5 Score8 Boxing Score2 Score6 Score9 Score10 平均値 中央値 M個のタスクをN回行い、平均値や中央値などの点推定によって判断 1. 標準偏差が省略される 2. 集約値が不明瞭 • 平均値 ⇒ 外れ値に弱い • 中央値 ⇒ スコアの半分がゼロでも影響を受けない 課題 3. どのロジックが優れているかわかりづらい 課題 既存の評価指標では評価が不確実であり適切なロジック比較ができなく誤った判断をする可能性がある 表にしてタスク間のスコアの違いを把握 Game Alien Amidar Assault Asterix Bank Heist Battle Zone DER Score1 Score2 Score3 Score4 Score5 Score6 OTR Score7 Score8 Score9 Score10 Score11 Score12 SPR Score13 Score14 Score15 Score16 Score17 Score18
7.
最新論文の評価結果の不確実性の検証 ©2022 ARISE analytics
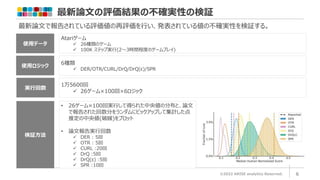
Reserved. 6 最新論文で報告されている評価値の再評価を行い、発表されている値の不確実性を検証する。 使用データ Atariゲーム 26種類のゲーム 100K ステップ実行(2~3時間程度のゲームプレイ) 検証方法 • 26ゲーム×100回実行して得られた中央値の分布と、論文 で報告された回数分をランダムにピックアップして集計した点 推定の中央値(破線)をプロット • 論文報告実行回数 DER : 5回 OTR : 5回 CURL :20回 DrQ :5回 DrQ(ε) :5回 SPR :10回 使用ロジック 6種類 DER/OTR/CURL/DrQ/DrQ(ε)/SPR 実行回数 1万5600回 26ゲーム×100回×6ロジック
8.
最新論文の評価の不確実性の検証 ©2022 ARISE analytics
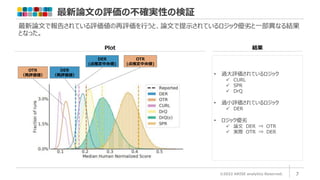
Reserved. 7 最新論文で報告されている評価値の再評価を行うと、論文で提示されているロジック優劣と一部異なる結果 となった。 • 過大評価されているロジック CURL SPR DrQ • 過小評価されているロジック DER • ロジック優劣 論文 DER ⇒ OTR 実際 OTR ⇒ DER Plot 結果 OTR (再評価値) DER (再評価値) OTR (点推定中央値) DER (点推定中央値)
9.
最新論文の評価の不確実性の証明 ©2022 ARISE analytics
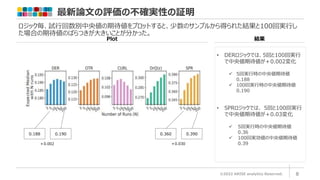
Reserved. 8 ロジック毎、試行回数別中央値の期待値をプロットすると、少数のサンプルから得られた結果と100回実行し た場合の期待値のばらつきが大きいことが分かった。 • DERロジックでは、5回と100回実行 で中央値期待値が+0.002変化 5回実行時の中央値期待値 0.188 100回実行時の中央値期待値 0.190 • SPRロジックでは、 5回と100回実行 で中央値期待値が+0.03変化 5回実行時の中央値期待値 0.36 100回実効値の中央値期待値 0.39 0.360 0.390 +0.030 0.188 0.190 +0.002 Plot 結果
10.
一般的な精度揺らぎの解消方法 ©2022 ARISE analytics
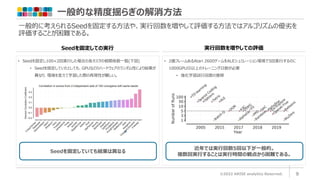
Reserved. 9 一般的に考えられるSeedを固定する方法や、実行回数を増やして評価する方法ではアルゴリズムの優劣を 評価することが困難である。 • Seedを固定し100×2回実行した場合の各タスクの相関係数一覧(下図) • Seedを固定していたとしても、GPUなどのハードウェアのランダム性により結果が 異なり、環境を変えて学習した際の再現性が難しい。 • 2億フレームあるAtari 2600ゲームをALEシュミレーション環境で5回実行するのに 1000GPU日以上のトレーニング日数が必要 • 強化学習試行回数の推移 近年では実行回数5回以下が一般的。 複数回実行することは実行時間の観点から困難である。 Seedを固定していても結果は異なる Seedを固定しての実行 実行回数を増やしての評価
11.
信頼性の高い評価のための3つの提案 ©2022 ARISE analytics
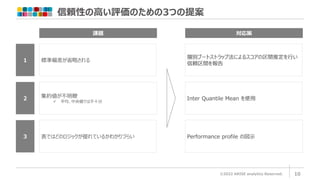
Reserved. 10 1 層別ブートストラップ法によるスコアの区間推定を行い 信頼区間を報告 2 Performance profile の図示 3 Inter Quantile Mean を使用 課題 標準偏差が省略される 対応策 集約値が不明瞭 平均、中央値では不十分 表ではどのロジックが優れているかわかりづらい
12.
1.層別ブートストラップ法を行い信頼区間を報告 ©2022 ARISE analytics
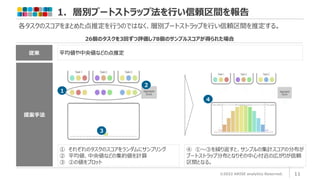
Reserved. 11 各タスクのスコアをまとめた点推定を行うのではなく、層別ブートストラップを行い信頼区間を推定する。 26個のタスクを3回ずつ評価し78個のサンプルスコアが得られた場合 従来 平均値や中央値などの点推定 ① それぞれのタスクのスコアをランダムにサンプリング ② 平均値、中央値などの集約値を計算 ③ ②の値をプロット ④ ①~③を繰り返すと、サンプルの集計スコアの分布が ブートストラップ分布となりその中心付近の広がりが信頼 区間となる。 提案手法 1 2 3 4
13.
2.Inter Quantile Mean
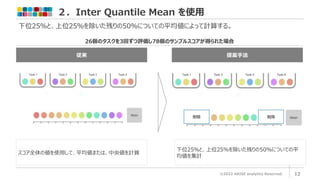
を使用 ©2022 ARISE analytics Reserved. 12 下位25%と、上位25%を除いた残りの50%についての平均値によって計算する。 スコア全体の値を使用して、平均値または、中央値を計算 下位25%と、上位25%を除いた残りの50%についての平 均値を集計 26個のタスクを3回ずつ評価し78個のサンプルスコアが得られた場合 従来 提案手法 削除 削除
14.
2.Inter Quantile Mean
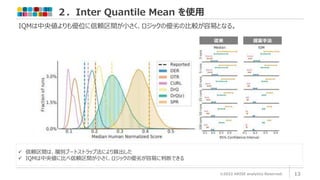
を使用 ©2022 ARISE analytics Reserved. 13 IQMは中央値よりも優位に信頼区間が小さく、ロジックの優劣の比較が容易となる。 信頼区間は、層別ブートストラップ法により算出した IQMは中央値に比べ信頼区間が小さく、ロジックの優劣が容易に判断できる 従来 提案手法
15.
Inter Quantile Mean
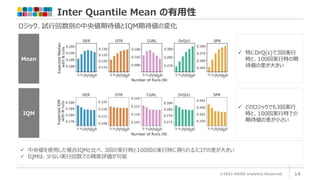
の有用性 ©2022 ARISE analytics Reserved. 14 ロジック、試行回数別の中央値期待値とIQM期待値の変化 Mean IQM 中央値を使用した場合IQMと比べ、3回の実行時と100回の実行時に得られるスコアの差が大きい IQMは、少ない実行回数での精度評価が可能 特にDrQ(ε)で3回実行 時と、100回実行時の期 待値の差が大きい どのロジックでも3回実行 時と、100回実行時での 期待値の差が小さい
16.
IQM以外の集計値 ©2022 ARISE analytics
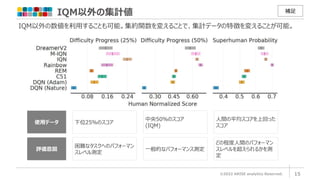
Reserved. 15 補足 IQM以外の数値を利用することも可能。集約関数を変えることで、集計データの特徴を変えることが可能。 使用データ 下位25%のスコア 中央50%のスコア (IQM) 人間の平均スコアを上回った スコア 評価意図 困難なタスクへのパフォーマン スレベル測定 一般的なパフォーマンス測定 どの程度人間のパフォーマン スレベルを超えられるかを測 定
17.
3.Performance profile の図示 ©2022
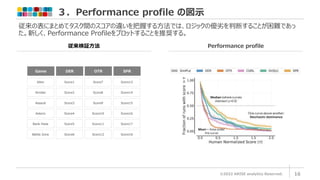
ARISE analytics Reserved. 16 従来の表にまとめてタスク間のスコアの違いを把握する方法では、ロジックの優劣を判断することが困難であっ た。新しく、Performance Profileをプロットすることを推奨する。 従来検証方法 Performance profile Game Alien Amidar Assault Asterix Bank Heist Battle Zone DER Score1 Score2 Score3 Score4 Score5 Score6 OTR Score7 Score8 Score9 Score10 Score11 Score12 SPR Score13 Score14 Score15 Score16 Score17 Score18
18.
3.Performance profile の図示 ©2022
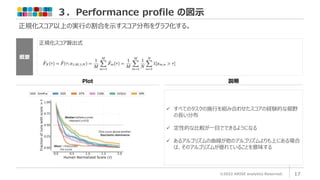
ARISE analytics Reserved. 17 正規化スコア以上の実行の割合を示すスコア分布をグラフ化する。 正規化スコア算出式 概要 すべてのタスクの施行を組み合わせたスコアの経験的な裾野 の長い分布 定性的な比較が一目でできるようになる あるアルゴリズムの曲線が他のアルゴリズムよりも上にある場合 は、そのアルゴリズムが優れていることを意味する Plot 説明
19.
評価プロトコルによるスコアの違い ©2022 ARISE analytics
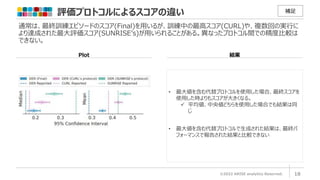
Reserved. 18 補足 通常は、最終訓練エピソードのスコア(Final)を用いるが、訓練中の最高スコア(CURL)や、複数回の実行に より達成された最大評価スコア(SUNRISE’s)が用いられることがある。異なったプロトコル間での精度比較は できない。 • 最大値を含む代替プロトコルを使用した場合、最終スコアを 使用した時よりもスコアが大きくなる。 平均値、中央値どちらを使用した場合でも結果は同 じ • 最大値を含む代替プロトコルで生成された結果は、最終パ フォーマンスで報告された結果と比較できない Plot 結果
20.
まとめ ©2022 ARISE analytics
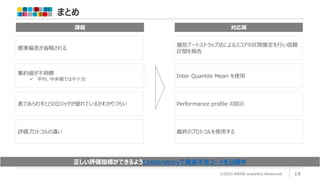
Reserved. 19 正しい評価指標ができるようColabratoryで提案手法コードを公開中 課題 対応策 層別ブートストラップ法によるスコアの区間推定を行い信頼 区間を報告 標準偏差が省略される Inter Quantile Mean を使用 集約値が不明瞭 平均、中央値では不十分 Performance profile の図示 表であらわすとどのロジックが優れているかわかりづらい 最終のプロトコルを使用する 評価プロトコルの違い
21.
Best Partner for
innovation, Best Creator for the future.