Ola Olsson
Markus Billeter
Ulf Assarsson
Chalmers University ofTechnology
1
CG 論文講読会 2013 / 5 / 20
Ryo Suzuki
HPG 2012
 類似するプロパティを持つ view sample を
Cluster にグループ化してシェーディング
 Tiled Shading より効率的に光源を割り当て、ラ
イティングのコストを大幅に削減
 Tiled Shading が苦手とする深度が不連続で高周
波なシーンに強い
 従来手法より 2 - 3 桁大きい数の光源(最大
100万個)がリアルタイムで可能
2
 近年 Tiled Shading への注目が高まっている
 Tiled Deferred Shading は PC /PS3 /
Xbox360 で実装されている
 演算コストと引き換えに、Deferred Shading
の帯域幅のボトルネックを緩和する
 帯域幅に比べ、大きな演算性能を持つ最新のコ
ンソールやハイエンドの GPU にとって効率的
3
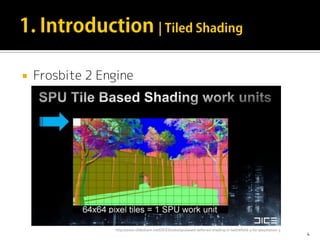
 Frosbite 2 Engine
4
http://www.slideshare.net/DICEStudio/spubased-deferred-shading-in-battlefield-3-for-playstation-3
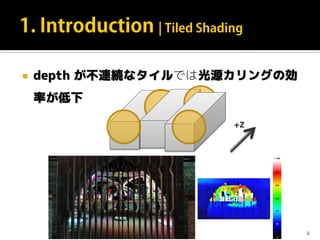
 Tiled Shading ではスクリーン空間の矩形タイル
でグループを作り、各タイルの最大・最小の
depth で錘台を定義して光源をカリング
 互いに近い depth を持つ面のタイルは小さな
Bounding Volume で表現できる
5
+Z
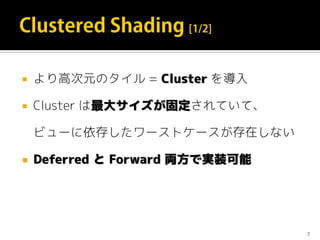
 depth が不連続なタイルでは光源カリングの効
率が低下
6
+Z
 より高次元のタイル = Cluster を導入
 Cluster は最大サイズが固定されていて、
ビューに依存したワーストケースが存在しない
 Deferred と Forward 両方で実装可能
7
 Cluster を拡張して法線情報を付与し、Cluster
ごとに光源の背面カリングをすることも可能
 光源割り当てを階層化し、大量の光源を堅牢に
サポート
 リアルタイムで最大 100 万光源
8
Deferred Shading
 1988 年にハードウェアデザインとして発表さ
れる
 1990 年に G-buffer を使ったより汎用的な手法
が登場
 ジオメトリとライティングの処理を分離し、大
量の光源の管理を単純化
 ハードウェア性能が向上し、ここ数年で主流に
9
Tiled Shading
 Deferred Shading をベースに、帯域幅のボトル
ネックに対処
 帯域幅が狭いコンソール機での AAA タイトル
開発における重要なアルゴリズムに
 GPU はメモリ帯域幅に比べて演算性能の向上が
早いため、将来世代の GPU にもうまくスケール
10
 どのように Cluster を作るか
 ある view sample がどの Cluster に属している
かを調べる方法
11
 Resolution Matched Shadow Maps (RMSM) では、
view sample がどの shadow page に属するかの
判断が必要
 スクリーン空間の coherency を利用して、近
傍ピクセルの重複したリクエストを削減
 残ったリクエストをソート・圧縮し、グローバ
ルで unique なリクエストを構築
12
 Compress-Sort-Decompress (CSD) では、フ
レームバッファを 1D 配列と見なし、ソートの
前にランレングス圧縮で重複を削減
 RMSM と CSD のどちらも、隣接した要素の
coherency に依存
 合理的な仮定だが coherency が低いシーンで
は、フレームバッファ全体のソートと変わらな
くなる
13
 ページテーブルを使う
 Virtual Textures 周辺の技術 [May10],
[HPLdW10]
 unique なシェーディングサンプル決定の手法
[LD12]
 シーンの coherency に依存せず、重複リクエ
ストを削減可能
14
1. シーンを G-Buffer にレンダリング
2. Cluster を割り当てる
3. 同一の Cluster を探す
4. Cluster に光源を割り当てる
5. サンプルのシェーディング
15
 1. シーンを G-Buffer にレンダリング
 従来の Deferred Shading や Tiled Deferred Shading
と同じ
 2. Cluster を割り当てる
 各ピクセルがどのクラスタに属するかを、座標(と必
要に応じて法線)から計算
 3. 同一の Cluster を探す
 unique な Cluster のリストを構築
16
 4. Cluster に光源を割り当てる
 どの光源が Cluster に影響しているかを効率的に探索
し、Cluster ごとに光源リストを作成
 5. サンプルのシェーディング
 サンプルが属する Cluster の光源リストを使って
シェーディング
17
 理想
 影響する光源が少ない、空間的に小さな Cluster
 効率のために Cluster 内にできるだけ多くのサンプル
 Cluster Key はできるだけ少ないビット数
18
 ワールド空間に一様なグリッドは?
 Cluster Key の計算が高速、すべての Cluster が同じ
サイズ
 しかし
 シーンに応じて適切なグリッドサイズを手作業で調整
する必要
 Cluster Key の表現に大きなビット数
 遠くの Cluster はスクリーン上では小さく、パフォー
マンスが低下
19
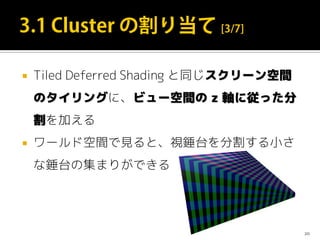
 Tiled Deferred Shading と同じスクリーン空間
のタイリングに、ビュー空間の z 軸に従った分
割を加える
 ワールド空間で見ると、視錘台を分割する小さ
な錘台の集まりができる
20
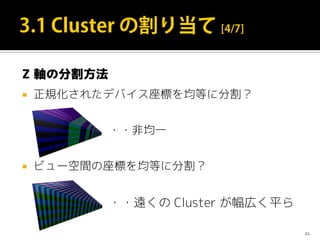
Z 軸の分割方法
 正規化されたデバイス座標を均等に分割?
・・非均一
 ビュー空間の座標を均等に分割?
・・遠くの Cluster が幅広く平ら
21
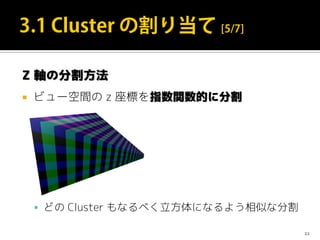
Z 軸の分割方法
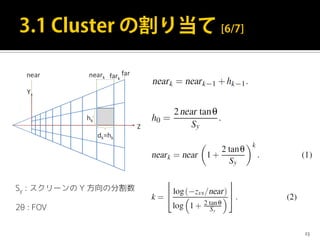
 ビュー空間の z 座標を指数関数的に分割
 どの Cluster もなるべく立方体になるよう相似な分割
22
23
Sy : スクリーンの Y 方向の分割数
2θ : FOV
 スクリーン空間の座標 (xss,yss) , ビュー空間の
depth (zvs) , タイルサイズ(tx,ty) , (2) 式を使っ
て Cluster Key となるタプル (i,j,k) を計算
 (i,j) = (xss/tx, yss/ty)
 必要に応じて、量子化した法線を追加
24
 2 つのオプション
1. ソート
2. ページテーブル
25
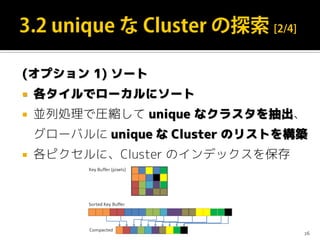
(オプション 1) ソート
 各タイルでローカルにソート
 並列処理で圧縮して unique なクラスタを抽出、
グローバルに unique な Cluster のリストを構築
 各ピクセルに、Cluster のインデックスを保存
26
(オプション 2) ページテーブル
 Virtual Texture の手法を利用
 仮想マッピングを使い、Cluster Key が必要とす
るストレージに物理メモリの割り当てを行う
 詳細な実装は [LSK*06]
27
 ソート、ページテーブルどちらの手法でも、
Cluster Key から 3D Bound (と法線情報があ
れば Normal Cone) を定義できる
 実際の view sample の位置や法線はより小さな
bound を持つため、さらに縮小した explicit な
3D Bound や Normal Cone を計算してもよい
 ただし、ページテーブルではアトミックな演算
が多く、実装しなかった
28
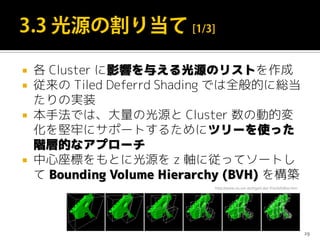
 各 Cluster に影響を与える光源のリストを作成
 従来の Tiled Deferrd Shading では全般的に総当
たりの実装
 本手法では、大量の光源と Cluster 数の動的変
化を堅牢にサポートするためにツリーを使った
階層的なアプローチ
 中心座標をもとに光源を z 軸に従ってソートし
て Bounding Volume Hierarchy (BVH) を構築
29
http://www.vis.uni-stuttgart.de/~frisch/h/diss.htm
 探索木のリーフノードはソートされたデータか
ら直接取得
 32 個の連続したノードを AABB でグループ化
し 、1 つ上のレベルのノードを構築、単一の
ルートノードが残るまで繰り返す
 深さ優先でトラバース、各レベルで Cluster と
子ノードの bounding テスト
 リーフノードにおいて光源の bounding sphere
とテスト
30
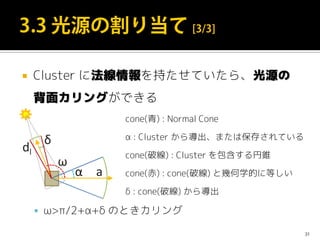
 Cluster に法線情報を持たせていたら、光源の
背面カリングができる
 ω>π/2+α+δ のときカリング
31
cone(青) : Normal Cone
α : Cluster から導出、または保存されている
cone(破線) : Cluster を包含する円錐
cone(赤) : cone(破線) と幾何学的に等しい
δ : cone(破線) から導出
 ソートの手法では、各ピクセルに保存した
unique な Cluster のインデックスを利用
 ページテーブルの手法では、Cluster のイン
デックスを Cluster Key の保存に使われる物理
メモリの位置に保存するので、Cluster Key か
ら Cluster のインデックスを得ることができる
32
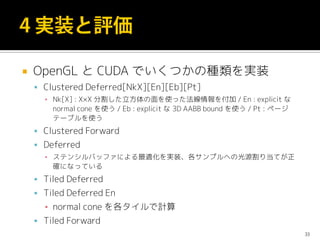
 OpenGL と CUDA でいくつかの種類を実装
 Clustered Deferred[NkX][En][Eb][Pt]
▪ Nk[X] : X×X 分割した立方体の面を使った法線情報を付加 / En : explicit な
normal cone を使う / Eb : explicit な 3D AABB bound を使う / Pt : ページ
テーブルを使う
 Clustered Forward
 Deferred
▪ ステンシルバッファによる最適化を実装、各サンプルへの光源割り当てが正
確になっている
 Tiled Deferred
 Tiled Deferred En
▪ normal cone を各タイルで計算
 Tiled Forward
33
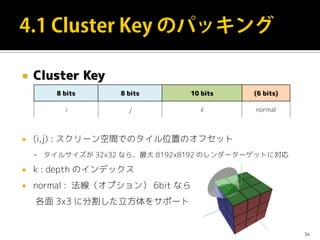
 Cluster Key
 (i,j) : スクリーン空間でのタイル位置のオフセット
 タイルサイズが 32x32 なら、最大 8192x8192 のレンダーターゲットに対応
 k : depth のインデックス
 normal : 法線(オプション) 6bit なら
各面 3x3 に分割した立方体をサポート
34
8 bits 8 bits 10 bits (6 bits)
i j k normal
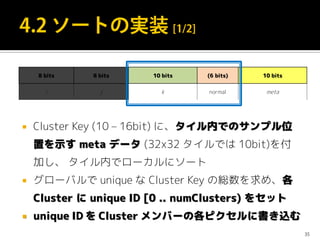
 Cluster Key (10 – 16bit) に、タイル内でのサンプル位
置を示す meta データ (32x32 タイルでは 10bit)を付
加し、 タイル内でローカルにソート
 グローバルで unique な Cluster Key の総数を求め、各
Cluster に unique ID [0 .. numClusters) をセット
 unique ID を Cluster メンバーの各ピクセルに書き込む
35
8 bits 8 bits 10 bits (6 bits) 10 bits
i j k normal meta
 3D Bound と Normal Cone は Cluster Key から
再構築可能
 必要に応じて、より縮小した AABB や normal
cone を保存する
 Explicit Bounds
 Explicit Normal Cone
 より高効率なカリングが可能に
36
 2-pass アプローチ
 並列 Prefix Sum を使って物理メモリを割り当
て、Cluster Key を保存
 シングルパスでの物理メモリの割り当てだと遅
かった。将来のハードウェアでは高速化の余地
37
 光源の探索木を毎フレーム構築
 Thurst[HB10] による効率的なソートを使用
 ツリー構築で CUDA warp (32 スレッド) を実行
 出力ノードが 32 個なのでトラバースでも CUDA
warp が役立つ
 最大深さが 5 レベルなら、再帰が発生する CUDA
の実装を回避できる
 5 レベルでは最大 3300 万の光源をサポート
38
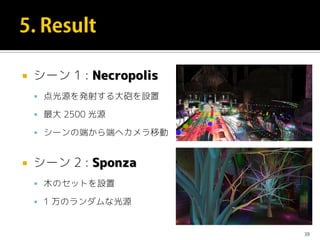
 シーン 1 : Necropolis
 点光源を発射する大砲を設置
 最大 2500 光源
 シーンの端から端へカメラ移動
 シーン 2 : Sponza
 木のセットを設置
 1 万のランダムな光源
39
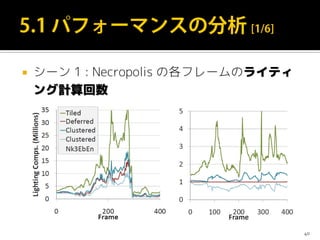
 シーン 1 : Necropolis の各フレームのライティ
ング計算回数
40
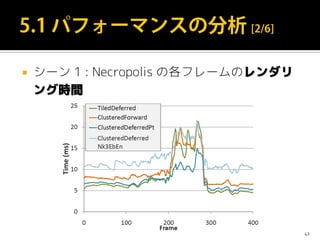
 シーン 1 : Necropolis の各フレームのレンダリ
ング時間
41
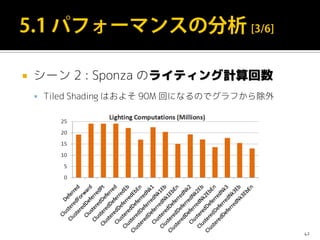
 シーン 2 : Sponza のライティング計算回数
 Tiled Shading はおよそ 90M 回になるのでグラフから除外
42
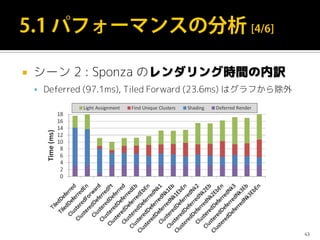
 シーン 2 : Sponza のレンダリング時間の内訳
 Deferred (97.1ms), Tiled Forward (23.6ms) はグラフから除外
43
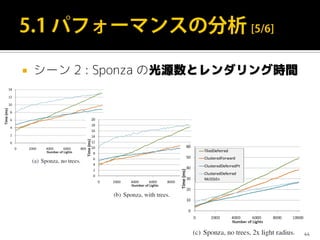
 シーン 2 : Sponza の光源数とレンダリング時間
44
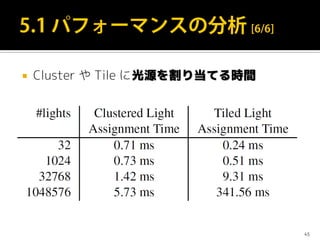
 Cluster や Tile に光源を割り当てる時間
45
 Clustered Shading は位置と任意で法線を使い、
類似した view sample を Cluster にグループ
化、Cluster に影響する光源のみ計算を行う
 Tiled Shading に比べ Cluster は小さく、光源の
影響は少なくなる
 Cluster の法線情報を光源の背面カリングに使
用可能
46
 ビューの状態変化に対する堅牢性が得られる
 Clustered Deferred / Clustered Forward どち
らもリアルタイムで 100 万光源が可能
 クラスタリングのコストは小さく、光源が少な
いシーンでも従来手法に匹敵するパフォーマン
ス
47
 Cluster 内のすべてのサンプルが特定の光源か
らおよそ等しく影響を受けているかをヒューリ
スティックに判断し、ライティングのコストを
削減
 簡単なテストでは、わずかな計算コストで最大
20 % ライティング計算を削減
 微細なアーティファクト、より高品質な近似を
 スペキュラのために、Cluster に平均輝度の情
報を付与?
48
 より複雑なシェーディングとの組み合わせ
 Clustered Shading は Tiled Shading に比べて
シェーディングコストが小さいので、シェーダ
の複雑さの増加に強い
49
50