Swin Transformer:
Hierarchical Vision Transformer
Using Shifted Windows
Ze Liu, Yutong Lin, Yue Cao, Han Hu, Yixuan Wei, Zheng Zhang,
Stephen Lin, Baining Guo
ICCV2021
細谷 優(名工大玉木研)
2022/04/15
概要
◼Transformer [Vaswani+, NeurIPS 2017] をComputer Visionへ適用
• 従来法(ViT)ではスケールの変化や高い解像度への対応に課題
• クラス分類,物体検出,セグメンテーションなど幅広いタスクが存在
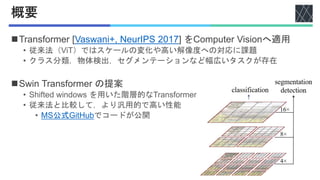
◼Swin Transformer の提案
• Shifted windows を用いた階層的なTransformer
• 従来法と比較して,より汎用的で高い性能
• MS公式GitHubでコードが公開
関連研究
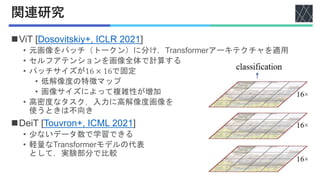
◼ViT [Dosovitskiy+, ICLR 2021]
• 元画像をパッチ(トークン)に分け,Transformerアーキテクチャを適用
• セルフアテンションを画像全体で計算する
• パッチサイズが16 × 16で固定
• 低解像度の特徴マップ
• 画像サイズによって複雑性が増加
• 高密度なタスク,入力に高解像度画像を
使うときは不向き
◼DeiT [Touvron+, ICML 2021]
• 少ないデータ数で学習できる
• 軽量なTransformerモデルの代表
として,実験部分で比較
Swin Transformer
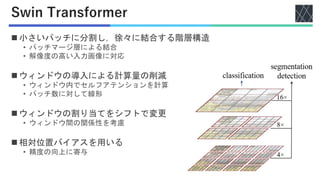
◼ 小さいパッチに分割し,徐々に結合する階層構造
• パッチマージ層による結合
• 解像度の高い入力画像に対応
◼ ウィンドウの導入による計算量の削減
• ウィンドウ内でセルフアテンションを計算
• パッチ数に対して線形
◼ ウィンドウの割り当てをシフトで変更
• ウィンドウ間の関係性を考慮
◼ 相対位置バイアスを用いる
• 精度の向上に寄与
アーキテクチャの概観
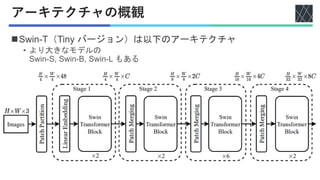
◼Swin-T(Tiny バージョン)は以下のアーキテクチャ
• より大きなモデルの
Swin-S, Swin-B, Swin-L もある
ステージ1の前処理
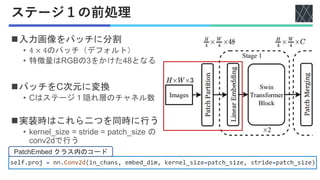
◼入力画像をパッチに分割
• 4 × 4のパッチ(デフォルト)
• 特徴量はRGBの3をかけた48となる
◼パッチをC次元に変換
• Cはステージ1隠れ層のチャネル数
◼実装時はこれら二つを同時に行う
• kernel_size = stride = patch_size の
conv2dで行う
PatchEmbed クラス内のコード
ステージ1以降
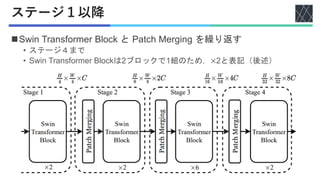
◼Swin Transformer Block と Patch Merging を繰り返す
• ステージ4まで
• Swin Transformer Blockは2ブロックで1組のため,×2と表記(後述)
Patch Merging
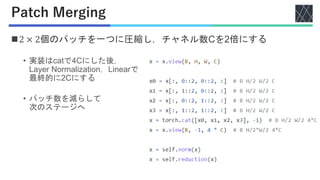
◼2 × 2個のパッチを一つに圧縮し,チャネル数Cを2倍にする
• 実装はcatで4Cにした後,
Layer Normalization,Linearで
最終的に2Cにする
• パッチ数を減らして
次のステージへ
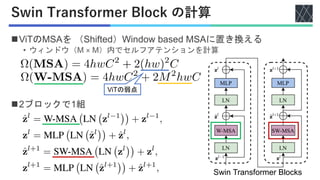
Swin Transformer Block の計算
◼ViTのMSAを (Shifted)Window based MSAに置き換える
• ウィンドウ(M × M)内でセルフアテンションを計算
◼2ブロックで1組
ViTの弱点
Swin Transformer Blocks
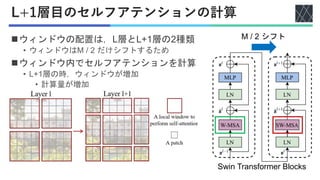
L+1層目のセルフアテンションの計算
◼ウィンドウの配置は,L層とL+1層の2種類
• ウィンドウはM / 2 だけシフトするため
◼ウィンドウ内でセルフアテンションを計算
• L+1層の時,ウィンドウが増加
• 計算量が増加
Swin Transformer Blocks
M / 2 シフト
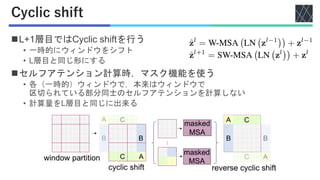
Cyclic shift
◼L+1層目ではCyclic shiftを行う
• 一時的にウィンドウをシフト
• L層目と同じ形にする
◼セルフアテンション計算時,マスク機能を使う
• 各(一時的)ウィンドウで,本来はウィンドウで
区切られている部分同士のセルフアテンションを計算しない
• 計算量をL層目と同じに出来る
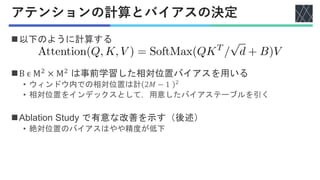
アテンションの計算とバイアスの決定
◼以下のように計算する
◼B ϵ M2 × M2 は事前学習した相対位置バイアスを用いる
• ウィンドウ内での相対位置は計 2𝑀 − 1 2
• 相対位置をインデックスとして,用意したバイアステーブルを引く
◼Ablation Study で有意な改善を示す(後述)
• 絶対位置のバイアスはやや精度が低下
実験概要
◼3つのタスクで実験
• Swin Transformerの汎用性を示す
• 実験の詳細は補足資料で
◼クラス分類
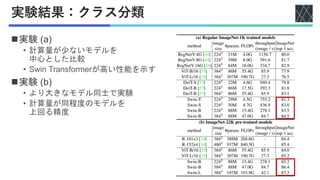
• 計算量に対する精度が従来法より増加
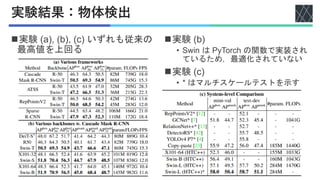
◼物体検出
• フレームワークやバックボーンを変えて,3つの実験を行う
• いずれも従来の最高値を上回る
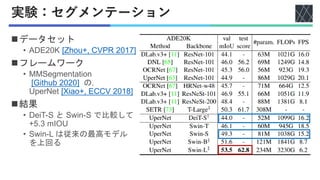
◼セマンティックセグメンテーション
• DeiT-S と Swin-S で比較
• Swin-L はmIOUで従来の最高モデルを上回る
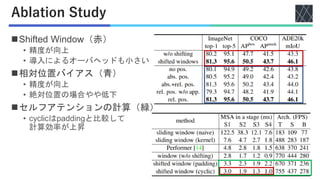
Ablation Study
◼Shifted Window(赤)
• 精度が向上
• 導入によるオーバヘッドも小さい
◼相対位置バイアス(青)
• 精度が向上
• 絶対位置の場合やや低下
◼セルフアテンションの計算(緑)
• cyclicはpaddingと比較して
計算効率が上昇
まとめ
◼Swin Transformer を提案
• 階層的な特徴表現
• 計算量を削減する様々な工夫
◼物体検出やセグメンテーションで優れた性能
• 従来手法にはない汎用性
補足資料
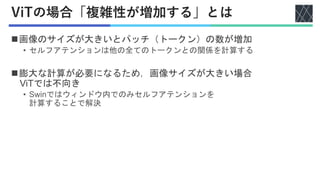
ViTの場合「複雑性が増加する」とは
◼画像のサイズが大きいとパッチ(トークン)の数が増加
• セルフアテンションは他の全てのトークンとの関係を計算する
◼膨大な計算が必要になるため,画像サイズが大きい場合
ViTでは不向き
• Swinではウィンドウ内でのみセルフアテンションを
計算することで解決
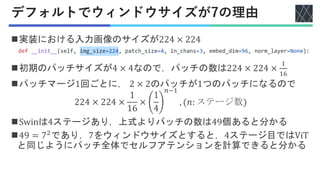
デフォルトでウィンドウサイズが7の理由
◼実装における入力画像のサイズが224 × 224
◼初期のパッチサイズが4 × 4なので,パッチの数は224 × 224 ×
1
16
◼パッチマージ1回ごとに, 2 × 2のパッチが1つのパッチになるので
224 × 224 ×
1
16
×
1
4
𝑛−1
, (𝑛: ステージ数)
◼Swinは4ステージあり,上式よりパッチの数は49個あると分かる
◼49 = 72であり,7をウィンドウサイズとすると,4ステージ目ではViT
と同じようにパッチ全体でセルフアテンションを計算できると分かる
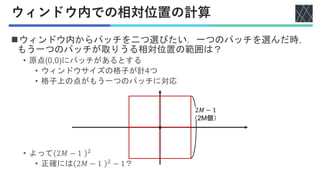
ウィンドウ内での相対位置の計算
◼ウィンドウ内からパッチを二つ選びたい.一つのパッチを選んだ時,
もう一つのパッチが取りうる相対位置の範囲は?
• 原点(0,0)にパッチがあるとする
• ウィンドウサイズの格子が計4つ
• 格子上の点がもう一つのパッチに対応
• よって 2𝑀 − 1 2
• 正確には 2𝑀 − 1 2 − 1?
2𝑀 − 1
(2M個)
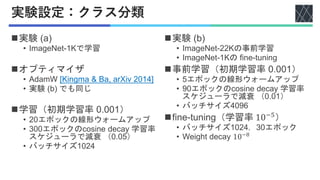
実験設定:クラス分類
◼実験 (a)
• ImageNet-1Kで学習
◼オプティマイザ
• AdamW [Kingma & Ba, arXiv 2014]
• 実験 (b) でも同じ
◼学習(初期学習率 0.001)
• 20エポックの線形ウォームアップ
• 300エポックのcosine decay 学習率
スケジューラで減衰 (0.05)
• バッチサイズ1024
◼実験 (b)
• ImageNet-22Kの事前学習
• ImageNet-1Kの fine-tuning
◼事前学習(初期学習率 0.001)
• 5エポックの線形ウォームアップ
• 90エポックのcosine decay 学習率
スケジューラで減衰 (0.01)
• バッチサイズ4096
◼fine-tuning(学習率 10−5)
• バッチサイズ1024,30エポック
• Weight decay 10−8
実験結果:クラス分類
◼実験 (a)
• 計算量が少ないモデルを
中心とした比較
• Swin Transformerが高い性能を示す
◼実験 (b)
• より大きなモデル同士で実験
• 計算量が同程度のモデルを
上回る精度
実験設定:物体検出
◼データセット
• COCO 2017 [Lin+, arXiv 2014]
◼オプティマイザ
• AdamW
◼学習(初期学習率 0.0001)
• Weight decay 0.05
• バッチサイズ 16
◼実験 (a)
• 4つのフレームワーク
• Swin-TとResNet-50の比較
◼実験 (b)
• Cascade Mask R-CNN
[He+, ICCV 2017]を使う
• バックボーンを変えて比較
◼実験 (c)
• 最先端モデルとSwin-B,
Swin-L を比較
実験結果:物体検出
◼実験 (a), (b), (c) いずれも従来の
最高値を上回る
◼実験 (b)
• Swin は PyTorch の関数で実装され
ているため,最適化されていない
◼実験 (c)
• * はマルチスケールテストを示す
実験:セグメンテーション
◼データセット
• ADE20K [Zhou+, CVPR 2017]
◼フレームワーク
• MMSegmentation
[Github 2020] の,
UperNet [Xiao+, ECCV 2018]
◼結果
• DeiT-S と Swin-S で比較して
+5.3 mIOU
• Swin-L は従来の最高モデル
を上回る