PostgreSQLをどこまで高速化できるのか?
~ハードウェアの限界に挑むPG-Stromの挑戦~
HeteroDB,Inc
Chief Architect & CEO
KaiGai Kohei <kaigai@heterodb.com>
 設立: 2017年7月4日(火)
 拠点: 品川区西大井1-1-2-206(西大井創業支援センター内)
 事業内容:
✓ 高性能データ処理ソフトウェアの開発と販売
✓ GPU&DB領域の技術コンサルティング
自己紹介
 海外 浩平 (KaiGai Kohei)
 Chief Architect & CEO of HeteroDB
 PostgreSQL, Linux kernel 開発者 (2003~)
 PG-Stromのメイン開発者(2012~)
 興味範囲:Big-data, GPU, NVME, PMEM, …
about myself
about our company
PG-Strom
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?2
PG-Stromとは?
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?3
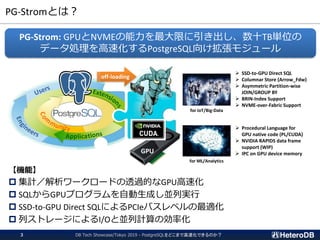
【機能】
 集計/解析ワークロードの透過的なGPU高速化
 SQLからGPUプログラムを自動生成し並列実行
 SSD-to-GPU Direct SQLによるPCIeバスレベルの最適化
 列ストレージによるI/Oと並列計算の効率化
PG-Strom: GPUとNVMEの能力を最大限に引き出し、数十TB単位の
データ処理を高速化するPostgreSQL向け拡張モジュール
App
GPU
off-loading
for IoT/Big-Data
for ML/Analytics
➢ SSD-to-GPU Direct SQL
➢ Columnar Store (Arrow_Fdw)
➢ Asymmetric Partition-wise
JOIN/GROUP BY
➢ BRIN-Index Support
➢ NVME-over-Fabric Support
➢ Procedural Language for
GPU native code (PL/CUDA)
➢ NVIDIA RAPIDS data frame
support (WIP)
➢ IPC on GPU device memory
PG-Strom as an Open Source Project
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?4
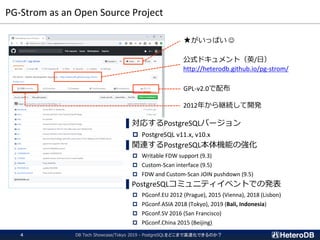
公式ドキュメント(英/日)
http://heterodb.github.io/pg-strom/
★がいっぱい ☺
GPL-v2.0で配布
2012年から継続して開発
▌対応するPostgreSQLバージョン
 PostgreSQL v11.x, v10.x
▌関連するPostgreSQL本体機能の強化
 Writable FDW support (9.3)
 Custom-Scan interface (9.5)
 FDW and Custom-Scan JOIN pushdown (9.5)
▌PostgreSQLコミュニティイベントでの発表
 PGconf.EU 2012 (Prague), 2015 (Vienna), 2018 (Lisbon)
 PGconf.ASIA 2018 (Tokyo), 2019 (Bali, Indonesia)
 PGconf.SV 2016 (San Francisco)
 PGconf.China 2015 (Beijing)
ターゲットワークロード
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?5
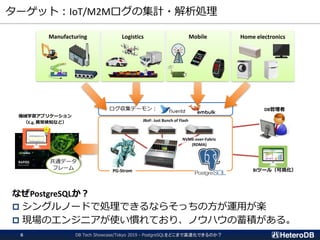
ログ収集デーモン:
ターゲット:IoT/M2Mログの集計・解析処理
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?6
Manufacturing Logistics Mobile Home electronics
なぜPostgreSQLか?
 シングルノードで処理できるならそっちの方が運用が楽
 現場のエンジニアが使い慣れており、ノウハウの蓄積がある。
JBoF: Just Bunch of Flash
NVME-over-Fabric
(RDMA)
DB管理者
BIツール(可視化)
機械学習アプリケーション
(E.g, 異常検知など)
共通データ
フレーム PG-Strom
どれ位のデータサイズを想定するか?(1/3)
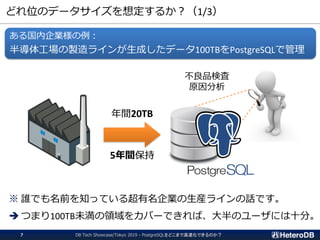
※ 誰でも名前を知っている超有名企業の生産ラインの話です。
➔ つまり100TB未満の領域をカバーできれば、大半のユーザには十分。
ある国内企業様の例:
半導体工場の製造ラインが生成したデータ100TBをPostgreSQLで管理
年間20TB
5年間保持
不良品検査
原因分析
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?7
どれ位のデータサイズを想定するか?(2/3)
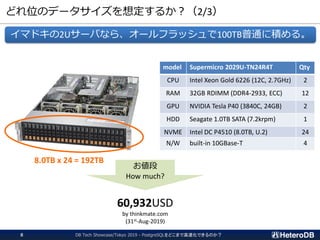
イマドキの2Uサーバなら、オールフラッシュで100TB普通に積める。
model Supermicro 2029U-TN24R4T Qty
CPU Intel Xeon Gold 6226 (12C, 2.7GHz) 2
RAM 32GB RDIMM (DDR4-2933, ECC) 12
GPU NVIDIA Tesla P40 (3840C, 24GB) 2
HDD Seagate 1.0TB SATA (7.2krpm) 1
NVME Intel DC P4510 (8.0TB, U.2) 24
N/W built-in 10GBase-T 4
8.0TB x 24 = 192TB
お値段
How much?
60,932USD
by thinkmate.com
(31st-Aug-2019)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?8
どれ位のデータサイズを想定するか?(3/3)
とは言うものの、”余裕で捌ける”というにはちと大きい。
TB
TB
TB
B
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?9
H/W限界に挑戦するためのテクノロジー
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?10
• SSD-to-GPU Direct SQL
効率的な
ストレージ
• Arrow_Fdw (Apache Arrow)
効率的な
データ構造
• PostgreSQL Partition
• Asymmetric Partition-wise JOIN
データの
パーティション化
PG-Strom: SSD-to-GPU Direct SQL
効率的なストレージ
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?11
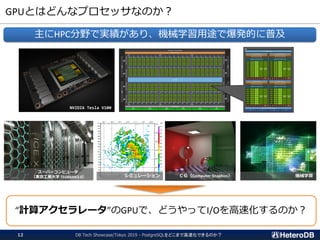
GPUとはどんなプロセッサなのか?
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?12
主にHPC分野で実績があり、機械学習用途で爆発的に普及
NVIDIA Tesla V100
スーパーコンピュータ
(東京工業大学 TSUBAME3.0) CG(Computer Graphics) 機械学習
“計算アクセラレータ”のGPUで、どうやってI/Oを高速化するのか?
シミュレーション
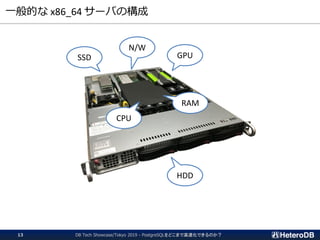
一般的な x86_64 サーバの構成
GPUSSD
CPU
RAM
HDD
N/W
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?13
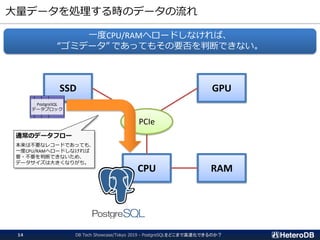
大量データを処理する時のデータの流れ
CPU RAM
SSD GPU
PCIe
PostgreSQL
データブロック
通常のデータフロー
本来は不要なレコードであっても、
一度CPU/RAMへロードしなければ
要・不要を判断できないため、
データサイズは大きくなりがち。
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?14
一度CPU/RAMへロードしなければ、
“ゴミデータ” であってもその要否を判断できない。
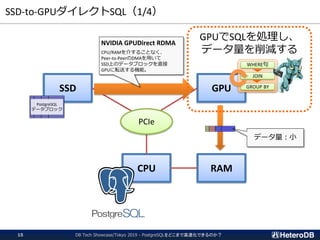
SSD-to-GPUダイレクトSQL(1/4)
CPU RAM
SSD GPU
PCIe
PostgreSQL
データブロック
NVIDIA GPUDirect RDMA
CPU/RAMを介することなく、
Peer-to-PeerのDMAを用いて
SSD上のデータブロックを直接
GPUに転送する機能。
WHERE句
JOIN
GROUP BY
GPUでSQLを処理し、
データ量を削減する
データ量:小
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?15
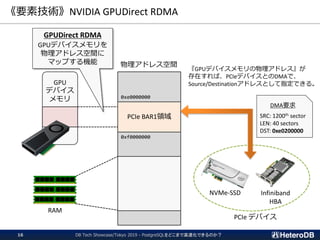
《要素技術》NVIDIA GPUDirect RDMA
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?16
物理アドレス空間
PCIe BAR1領域
GPU
デバイス
メモリ
RAM
NVMe-SSD Infiniband
HBA
PCIe デバイス
GPUDirect RDMA
GPUデバイスメモリを
物理アドレス空間に
マップする機能
『GPUデバイスメモリの物理アドレス』が
存在すれば、PCIeデバイスとのDMAで、
Source/Destinationアドレスとして指定できる。
0xf0000000
0xe0000000
DMA要求
SRC: 1200th sector
LEN: 40 sectors
DST: 0xe0200000
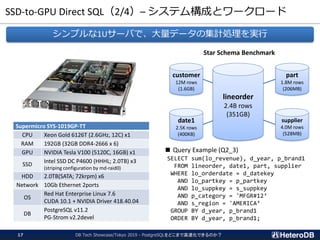
SSD-to-GPU Direct SQL(2/4)– システム構成とワークロード
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?17
Supermicro SYS-1019GP-TT
CPU Xeon Gold 6126T (2.6GHz, 12C) x1
RAM 192GB (32GB DDR4-2666 x 6)
GPU NVIDIA Tesla V100 (5120C, 16GB) x1
SSD
Intel SSD DC P4600 (HHHL; 2.0TB) x3
(striping configuration by md-raid0)
HDD 2.0TB(SATA; 72krpm) x6
Network 10Gb Ethernet 2ports
OS
Red Hat Enterprise Linux 7.6
CUDA 10.1 + NVIDIA Driver 418.40.04
DB
PostgreSQL v11.2
PG-Strom v2.2devel
■ Query Example (Q2_3)
SELECT sum(lo_revenue), d_year, p_brand1
FROM lineorder, date1, part, supplier
WHERE lo_orderdate = d_datekey
AND lo_partkey = p_partkey
AND lo_suppkey = s_suppkey
AND p_category = 'MFGR#12‘
AND s_region = 'AMERICA‘
GROUP BY d_year, p_brand1
ORDER BY d_year, p_brand1;
customer
12M rows
(1.6GB)
date1
2.5K rows
(400KB)
part
1.8M rows
(206MB)
supplier
4.0M rows
(528MB)
lineorder
2.4B rows
(351GB)
シンプルな1Uサーバで、大量データの集計処理を実行
Star Schema Benchmark
SSD-to-GPU Direct SQL(3/4)– ベンチマーク結果
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?18
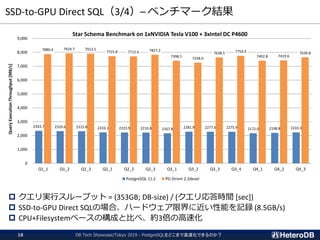
 クエリ実行スループット = (353GB; DB-size) / (クエリ応答時間 [sec])
 SSD-to-GPU Direct SQLの場合、ハードウェア限界に近い性能を記録 (8.5GB/s)
 CPU+Filesystemベースの構成と比べ、約3倍の高速化
2343.7 2320.6 2315.8 2233.1 2223.9 2216.8 2167.8 2281.9 2277.6 2275.9 2172.0 2198.8 2233.3
7880.4 7924.7 7912.5
7725.8 7712.6 7827.2
7398.1 7258.0
7638.5 7750.4
7402.8 7419.6
7639.8
0
1,000
2,000
3,000
4,000
5,000
6,000
7,000
8,000
9,000
Q1_1 Q1_2 Q1_3 Q2_1 Q2_2 Q2_3 Q3_1 Q3_2 Q3_3 Q3_4 Q4_1 Q4_2 Q4_3
QueryExecutionThroughput[MB/s]
Star Schema Benchmark on 1xNVIDIA Tesla V100 + 3xIntel DC P4600
PostgreSQL 11.2 PG-Strom 2.2devel
SSD-to-GPU Direct SQL – ソフトウェアスタック
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?19
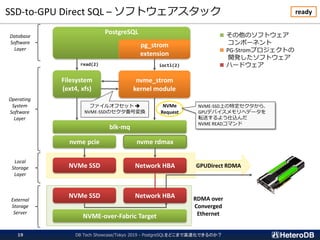
Filesystem
(ext4, xfs)
nvme_strom
kernel module
NVMe SSD
PostgreSQL
pg_strom
extension
read(2) ioctl(2)
Operating
System
Software
Layer
Database
Software
Layer
blk-mq
nvme pcie nvme rdmax
Network HBA
NVMe
Request
ready
Network HBANVMe SSD
NVME-over-Fabric Target
RDMA over
Converged
Ethernet
GPUDirect RDMA
ファイルオフセット ➔
NVME-SSDのセクタ番号変換
■ その他のソフトウェア
コンポーネント
■ PG-Stromプロジェクトの
開発したソフトウェア
■ ハードウェア
NVME-SSD上の特定セクタから、
GPUデバイスメモリへデータを
転送するよう仕込んだ
NVME READコマンド
External
Storage
Server
Local
Storage
Layer
PG-Strom: Arrow_Fdw (列データストア)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?20
効率的なデータ構造
Apache Arrowとは(1/2)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?21
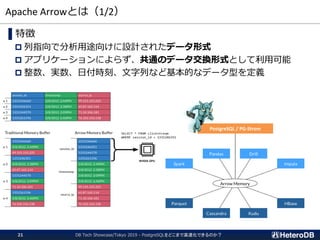
▌特徴
 列指向で分析用途向けに設計されたデータ形式
 アプリケーションによらず、共通のデータ交換形式として利用可能
 整数、実数、日付時刻、文字列など基本的なデータ型を定義
NVIDIA GPU
PostgreSQL / PG-Strom
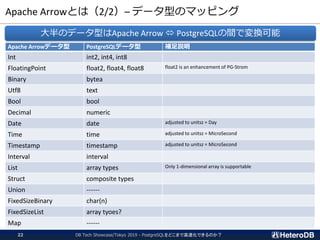
Apache Arrowとは(2/2)– データ型のマッピング
Apache Arrowデータ型 PostgreSQLデータ型 補足説明
Int int2, int4, int8
FloatingPoint float2, float4, float8 float2 is an enhancement of PG-Strom
Binary bytea
Utf8 text
Bool bool
Decimal numeric
Date date adjusted to unitsz = Day
Time time adjusted to unitsz = MicroSecond
Timestamp timestamp adjusted to unitsz = MicroSecond
Interval interval
List array types Only 1-dimensional array is supportable
Struct composite types
Union ------
FixedSizeBinary char(n)
FixedSizeList array tyoes?
Map ------
大半のデータ型はApache Arrow  PostgreSQLの間で変換可能
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?22
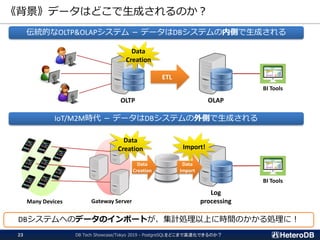
《背景》データはどこで生成されるのか?
ETL
OLTP OLAP
伝統的なOLTP&OLAPシステム - データはDBシステムの内側で生成される
Data
Creation
IoT/M2M時代 - データはDBシステムの外側で生成される
Log
processing
BI Tools
BI Tools
Gateway Server
Data
Creation
Data
Creation
Many Devices
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?23
DBシステムへのデータのインポートが、集計処理以上に時間のかかる処理に!
Data
Import
Import!
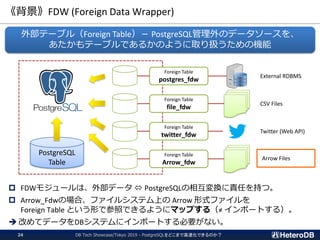
《背景》FDW (Foreign Data Wrapper)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?24
 FDWモジュールは、外部データ  PostgreSQLの相互変換に責任を持つ。
 Arrow_Fdwの場合、ファイルシステム上の Arrow 形式ファイルを
Foreign Table という形で参照できるようにマップする(≠ インポートする)。
➔ 改めてデータをDBシステムにインポートする必要がない。
外部テーブル(Foreign Table)- PostgreSQL管理外のデータソースを、
あたかもテーブルであるかのように取り扱うための機能
PostgreSQL
Table
Foreign Table
postgres_fdw
Foreign Table
file_fdw
Foreign Table
twitter_fdw
Foreign Table
Arrow_fdw
External RDBMS
CSV Files
Twitter (Web API)
Arrow Files
SSD-to-GPU Direct SQL on Arrow_Fdw(1/4)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?25
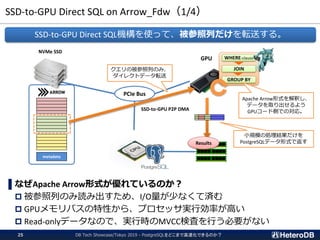
▌なぜApache Arrow形式が優れているのか?
 被参照列のみ読み出すため、I/O量が少なくて済む
 GPUメモリバスの特性から、プロセッサ実行効率が高い
 Read-onlyデータなので、実行時のMVCC検査を行う必要がない
SSD-to-GPU Direct SQL機構を使って、被参照列だけを転送する。
PCIe Bus
NVMe SSD
GPU
SSD-to-GPU P2P DMA
WHERE-clause
JOIN
GROUP BY
クエリの被参照列のみ、
ダイレクトデータ転送
Apache Arrow形式を解釈し、
データを取り出せるよう
GPUコード側での対応。
小規模の処理結果だけを
PostgreSQLデータ形式で返すResults
metadata
SSD-to-GPU Direct SQL on Arrow_Fdw(2/4)– ベンチマーク結果①
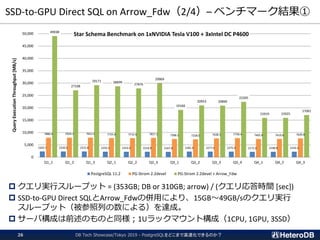
 クエリ実行スループット = (353GB; DB or 310GB; arrow) / (クエリ応答時間 [sec])
 SSD-to-GPU Direct SQLとArrow_Fdwの併用により、15GB~49GB/sのクエリ実行
スループット(被参照列の数による)を達成。
 サーバ構成は前述のものと同様;1Uラックマウント構成(1CPU, 1GPU, 3SSD)
2343.7 2320.6 2315.8 2233.1 2223.9 2216.8 2167.8 2281.9 2277.6 2275.9 2172.0 2198.8 2233.3
7880.4 7924.7 7912.5 7725.8 7712.6 7827.2 7398.1 7258.0 7638.5 7750.4 7402.8 7419.6 7639.8
49038
27108
29171 28699
27876
29969
19166
20953 20890
22395
15919 15925
17061
0
5,000
10,000
15,000
20,000
25,000
30,000
35,000
40,000
45,000
50,000
Q1_1 Q1_2 Q1_3 Q2_1 Q2_2 Q2_3 Q3_1 Q3_2 Q3_3 Q3_4 Q4_1 Q4_2 Q4_3
QueryExecutionThroughput[MB/s]
Star Schema Benchmark on 1xNVIDIA Tesla V100 + 3xIntel DC P4600
PostgreSQL 11.2 PG-Strom 2.2devel PG-Strom 2.2devel + Arrow_Fdw
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?26
SSD-to-GPU Direct SQL on Arrow_Fdw(3/4)– ベンチマーク結果②
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?27
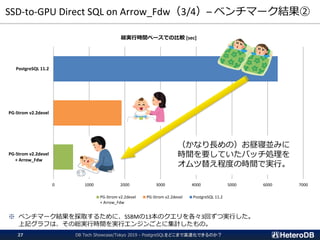
※ ベンチマーク結果を採取するために、SSBMの13本のクエリを各々3回ずつ実行した。
上記グラフは、その総実行時間を実行エンジンごとに集計したもの。
0 1000 2000 3000 4000 5000 6000 7000
PG-Strom v2.2devel
+ Arrow_Fdw
PG-Strom v2.2devel
PostgreSQL 11.2
総実行時間ベースでの比較 [sec]
PG-Strom v2.2devel
+ Arrow_Fdw
PG-Strom v2.2devel PostgreSQL 11.2
(かなり長めの)お昼寝並みに
時間を要していたバッチ処理を
オムツ替え程度の時間で実行。
SSD-to-GPU Direct SQL on Arrow_Fdw(4/4)– 結果の検証
Foreign table "public.flineorder"
Column | Type | Size
--------------------+---------------+--------------------------------
lo_orderkey | numeric | 35.86GB
lo_linenumber | integer | 8.96GB
lo_custkey | numeric | 35.86GB
lo_partkey | integer | 8.96GB
lo_suppkey | numeric | 35.86GB <-- ★Referenced by Q2_1
lo_orderdate | integer | 8.96GB <-- ★Referenced by Q2_1
lo_orderpriority | character(15) | 33.61GB <-- ★Referenced by Q2_1
lo_shippriority | character(1) | 2.23GB
lo_quantity | integer | 8.96GB
lo_extendedprice | bigint | 17.93GB
lo_ordertotalprice | bigint | 17.93GB
lo_discount | integer | 8.96GB
lo_revenue | bigint | 17.93GB
lo_supplycost | bigint | 17.93GB <-- ★Referenced by Q2_1
lo_tax | integer | 8.96GB
lo_commit_date | character(8) | 17.93GB
lo_shipmode | character(10) | 22.41GB
FDW options: (file '/opt/nvme/lineorder_s401.arrow') ... file size = 310GB
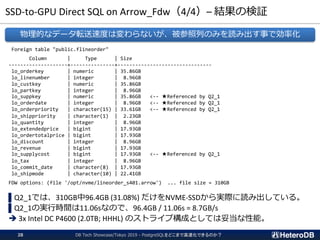
▌Q2_1では、310GB中96.4GB (31.08%) だけをNVME-SSDから実際に読み出している。
▌Q2_1の実行時間は11.06sなので、96.4GB / 11.06s = 8.7GB/s
➔ 3x Intel DC P4600 (2.0TB; HHHL) のストライプ構成としては妥当な性能。
物理的なデータ転送速度は変わらないが、被参照列のみを読み出す事で効率化
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?28
《補足》なぜGPUには列指向のデータが向いているか
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?29
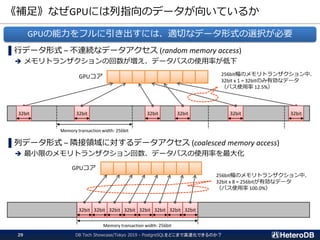
▌行データ形式 – 不連続なデータアクセス (random memory access)
➔ メモリトランザクションの回数が増え、データバスの使用率が低下
▌列データ形式 – 隣接領域に対するデータアクセス (coalesced memory access)
➔ 最小限のメモリトランザクション回数、データバスの使用率を最大化
32bit
Memory transaction width: 256bit
32bit 32bit32bit 32bit 32bit
32bit 32bit 32bit 32bit 32bit 32bit 32bit 32bit
Memory transaction width: 256bit
256bit幅のメモリトランザクション中、
32bit x 8 = 256bitが有効なデータ
(バス使用率 100.0%)
256bit幅のメモリトランザクション中、
32bit x 1 = 32bitのみ有効なデータ
(バス使用率 12.5%)
GPUコア
GPUコア
GPUの能力をフルに引き出すには、適切なデータ形式の選択が必要
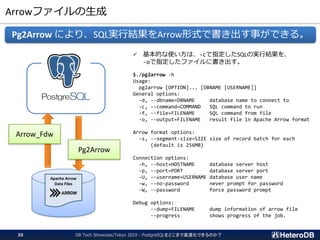
Arrowファイルの生成
✓ 基本的な使い方は、-cで指定したSQLの実行結果を、
-oで指定したファイルに書き出す。
$./pg2arrow -h
Usage:
pg2arrow [OPTION]... [DBNAME [USERNAME]]
General options:
-d, --dbname=DBNAME database name to connect to
-c, --command=COMMAND SQL command to run
-f, --file=FILENAME SQL command from file
-o, --output=FILENAME result file in Apache Arrow format
Arrow format options:
-s, --segment-size=SIZE size of record batch for each
(default is 256MB)
Connection options:
-h, --host=HOSTNAME database server host
-p, --port=PORT database server port
-U, --username=USERNAME database user name
-w, --no-password never prompt for password
-W, --password force password prompt
Debug options:
--dump=FILENAME dump information of arrow file
--progress shows progress of the job.
Pg2Arrow により、SQL実行結果をArrow形式で書き出す事ができる。
Apache Arrow
Data Files
Arrow_Fdw
Pg2Arrow
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?30
PostgreSQLパーティショニングと
PCIeバスレベル最適化
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?31
データのパーティション化
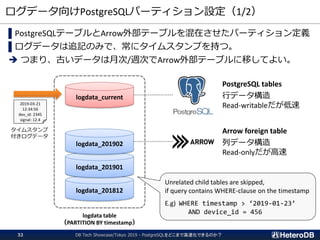
ログデータ向けPostgreSQLパーティション設定(1/2)
▌PostgreSQLテーブルとArrow外部テーブルを混在させたパーティション定義
▌ログデータは追記のみで、常にタイムスタンプを持つ。
➔ つまり、古いデータは月次/週次でArrow外部テーブルに移してよい。
logdata_201812
logdata_201901
logdata_201902
logdata_current
logdata table
(PARTITION BY timestamp)
2019-03-21
12:34:56
dev_id: 2345
signal: 12.4
タイムスタンプ
付きログデータ
PostgreSQL tables
行データ構造
Read-writableだが低速
Arrow foreign table
列データ構造
Read-onlyだが高速
Unrelated child tables are skipped,
if query contains WHERE-clause on the timestamp
E.g) WHERE timestamp > ‘2019-01-23’
AND device_id = 456
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?32
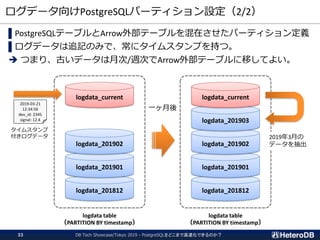
ログデータ向けPostgreSQLパーティション設定(2/2)
logdata_201812
logdata_201901
logdata_201902
logdata_current
logdata table
(PARTITION BY timestamp)
2019-03-21
12:34:56
dev_id: 2345
signal: 12.4
logdata_201812
logdata_201901
logdata_201902
logdata_201903
logdata_current
logdata table
(PARTITION BY timestamp)
一ヶ月後
2019年3月の
データを抽出
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?33
▌PostgreSQLテーブルとArrow外部テーブルを混在させたパーティション定義
▌ログデータは追記のみで、常にタイムスタンプを持つ。
➔ つまり、古いデータは月次/週次でArrow外部テーブルに移してよい。
タイムスタンプ
付きログデータ
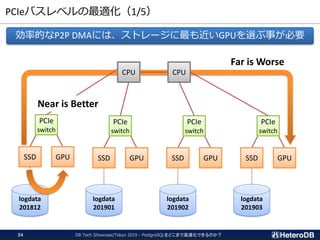
PCIeバスレベルの最適化(1/5)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?34
効率的なP2P DMAには、ストレージに最も近いGPUを選ぶ事が必要
CPU CPU
PCIe
switch
SSD GPU
PCIe
switch
SSD GPU
PCIe
switch
SSD GPU
PCIe
switch
SSD GPU
logdata
201812
logdata
201901
logdata
201902
logdata
201903
Near is Better
Far is Worse
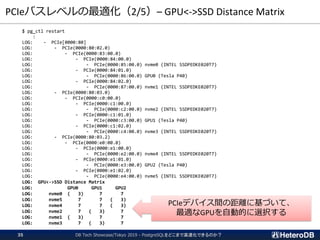
PCIeバスレベルの最適化(2/5)– GPU<->SSD Distance Matrix
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?35
$ pg_ctl restart
:
LOG: - PCIe[0000:80]
LOG: - PCIe(0000:80:02.0)
LOG: - PCIe(0000:83:00.0)
LOG: - PCIe(0000:84:00.0)
LOG: - PCIe(0000:85:00.0) nvme0 (INTEL SSDPEDKE020T7)
LOG: - PCIe(0000:84:01.0)
LOG: - PCIe(0000:86:00.0) GPU0 (Tesla P40)
LOG: - PCIe(0000:84:02.0)
LOG: - PCIe(0000:87:00.0) nvme1 (INTEL SSDPEDKE020T7)
LOG: - PCIe(0000:80:03.0)
LOG: - PCIe(0000:c0:00.0)
LOG: - PCIe(0000:c1:00.0)
LOG: - PCIe(0000:c2:00.0) nvme2 (INTEL SSDPEDKE020T7)
LOG: - PCIe(0000:c1:01.0)
LOG: - PCIe(0000:c3:00.0) GPU1 (Tesla P40)
LOG: - PCIe(0000:c1:02.0)
LOG: - PCIe(0000:c4:00.0) nvme3 (INTEL SSDPEDKE020T7)
LOG: - PCIe(0000:80:03.2)
LOG: - PCIe(0000:e0:00.0)
LOG: - PCIe(0000:e1:00.0)
LOG: - PCIe(0000:e2:00.0) nvme4 (INTEL SSDPEDKE020T7)
LOG: - PCIe(0000:e1:01.0)
LOG: - PCIe(0000:e3:00.0) GPU2 (Tesla P40)
LOG: - PCIe(0000:e1:02.0)
LOG: - PCIe(0000:e4:00.0) nvme5 (INTEL SSDPEDKE020T7)
LOG: GPU<->SSD Distance Matrix
LOG: GPU0 GPU1 GPU2
LOG: nvme0 ( 3) 7 7
LOG: nvme5 7 7 ( 3)
LOG: nvme4 7 7 ( 3)
LOG: nvme2 7 ( 3) 7
LOG: nvme1 ( 3) 7 7
LOG: nvme3 7 ( 3) 7
PCIeデバイス間の距離に基づいて、
最適なGPUを自動的に選択する
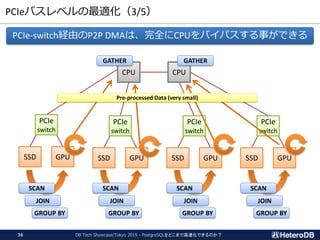
PCIeバスレベルの最適化(3/5)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?36
PCIe-switch経由のP2P DMAは、完全にCPUをバイパスする事ができる
CPU CPU
PCIe
switch
SSD GPU
PCIe
switch
SSD GPU
PCIe
switch
SSD GPU
PCIe
switch
SSD GPU
SCAN SCAN SCAN SCAN
JOIN JOIN JOIN JOIN
GROUP BY GROUP BY GROUP BY GROUP BY
Pre-processed Data (very small)
GATHER GATHER
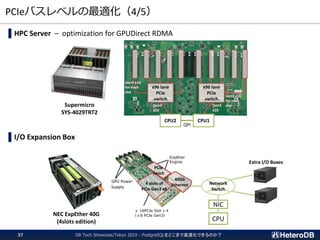
PCIeバスレベルの最適化(4/5)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?37
Supermicro
SYS-4029TRT2
x96 lane
PCIe
switch
x96 lane
PCIe
switch
CPU2 CPU1
QPI
Gen3
x16
Gen3 x16
for each
slot
Gen3 x16
for each
slotGen3
x16
▌HPC Server – optimization for GPUDirect RDMA
▌I/O Expansion Box
NEC ExpEther 40G
(4slots edition)
Network
Switch
4 slots of
PCIe Gen3 x8
PCIe
Swich
40Gb
Ethernet
CPU
NIC
Extra I/O Boxes
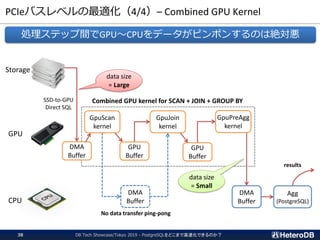
PCIeバスレベルの最適化(4/4)– Combined GPU Kernel
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?38
処理ステップ間でGPU~CPUをデータがピンポンするのは絶対悪
GpuScan
kernel
GpuJoin
kernel
GpuPreAgg
kernel
GPU
CPU
Storage
GPU
Buffer
GPU
Buffer
results
DMA
Buffer
Agg
(PostgreSQL)
Combined GPU kernel for SCAN + JOIN + GROUP BY
data size
= Large
data size
= Small
DMA
Buffer
SSD-to-GPU
Direct SQL
DMA
Buffer
No data transfer ping-pong
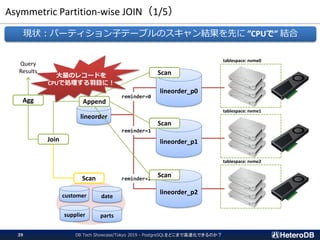
Asymmetric Partition-wise JOIN(1/5)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?39
lineorder
lineorder_p0
lineorder_p1
lineorder_p2
reminder=0
reminder=1
reminder=2
customer date
supplier parts
tablespace: nvme0
tablespace: nvme1
tablespace: nvme2
現状:パーティション子テーブルのスキャン結果を先に ”CPUで” 結合
Scan
Scan
Scan
Append
Join
Agg
Query
Results
Scan
大量のレコードを
CPUで処理する羽目に!
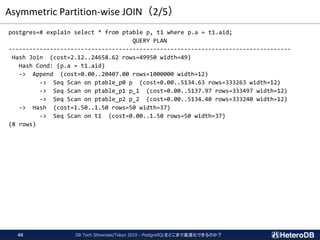
Asymmetric Partition-wise JOIN(2/5)
postgres=# explain select * from ptable p, t1 where p.a = t1.aid;
QUERY PLAN
----------------------------------------------------------------------------------
Hash Join (cost=2.12..24658.62 rows=49950 width=49)
Hash Cond: (p.a = t1.aid)
-> Append (cost=0.00..20407.00 rows=1000000 width=12)
-> Seq Scan on ptable_p0 p (cost=0.00..5134.63 rows=333263 width=12)
-> Seq Scan on ptable_p1 p_1 (cost=0.00..5137.97 rows=333497 width=12)
-> Seq Scan on ptable_p2 p_2 (cost=0.00..5134.40 rows=333240 width=12)
-> Hash (cost=1.50..1.50 rows=50 width=37)
-> Seq Scan on t1 (cost=0.00..1.50 rows=50 width=37)
(8 rows)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?40
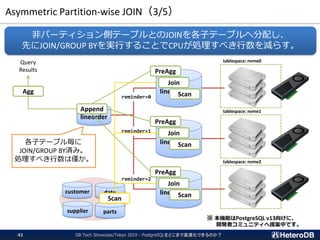
Asymmetric Partition-wise JOIN(3/5)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?41
lineorder
lineorder_p0
lineorder_p1
lineorder_p2
reminder=0
reminder=1
reminder=2
customer date
supplier parts
非パーティション側テーブルとのJOINを各子テーブルへ分配し、
先にJOIN/GROUP BYを実行することでCPUが処理すべき行数を減らす。
Join
Append
Agg
Query
Results
Scan
Scan
PreAgg
Join
Scan
PreAgg
Join
Scan
PreAgg
tablespace: nvme0
tablespace: nvme1
tablespace: nvme2
各子テーブル毎に
JOIN/GROUP BY済み。
処理すべき行数は僅か。
※ 本機能はPostgreSQL v13向けに、
開発者コミュニティへ提案中です。
Asymmetric Partition-wise JOIN(4/5)
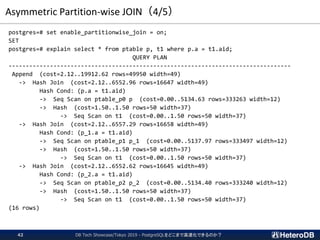
postgres=# set enable_partitionwise_join = on;
SET
postgres=# explain select * from ptable p, t1 where p.a = t1.aid;
QUERY PLAN
----------------------------------------------------------------------------------
Append (cost=2.12..19912.62 rows=49950 width=49)
-> Hash Join (cost=2.12..6552.96 rows=16647 width=49)
Hash Cond: (p.a = t1.aid)
-> Seq Scan on ptable_p0 p (cost=0.00..5134.63 rows=333263 width=12)
-> Hash (cost=1.50..1.50 rows=50 width=37)
-> Seq Scan on t1 (cost=0.00..1.50 rows=50 width=37)
-> Hash Join (cost=2.12..6557.29 rows=16658 width=49)
Hash Cond: (p_1.a = t1.aid)
-> Seq Scan on ptable_p1 p_1 (cost=0.00..5137.97 rows=333497 width=12)
-> Hash (cost=1.50..1.50 rows=50 width=37)
-> Seq Scan on t1 (cost=0.00..1.50 rows=50 width=37)
-> Hash Join (cost=2.12..6552.62 rows=16645 width=49)
Hash Cond: (p_2.a = t1.aid)
-> Seq Scan on ptable_p2 p_2 (cost=0.00..5134.40 rows=333240 width=12)
-> Hash (cost=1.50..1.50 rows=50 width=37)
-> Seq Scan on t1 (cost=0.00..1.50 rows=50 width=37)
(16 rows)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?42
Asymmetric Partition-wise JOIN(5/5)
May be available
at PostgreSQL v13
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?43
シングルノード処理性能 100GB/s に向けて
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?44
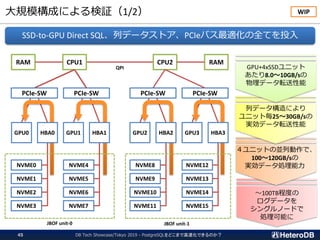
~100TB程度の
ログデータを
シングルノードで
処理可能に
4ユニットの並列動作で、
100~120GB/sの
実効データ処理能力
列データ構造により
ユニット毎25~30GB/sの
実効データ転送性能
大規模構成による検証(1/2)
QPI
SSD-to-GPU Direct SQL、列データストア、PCIeバス最適化の全てを投入
CPU2CPU1RAM RAM
PCIe-SW PCIe-SW
NVME0
NVME1
NVME2
NVME3
NVME4
NVME5
NVME6
NVME7
NVME8
NVME9
NVME10
NVME11
NVME12
NVME13
NVME14
NVME15
GPU0 GPU1 GPU2 GPU3HBA0 HBA1 HBA2 HBA3
GPU+4xSSDユニット
あたり8.0~10GB/sの
物理データ転送性能
45
PCIe-SW PCIe-SW
JBOF unit-0 JBOF unit-1
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?
WIP
大規模構成による検証(2/2)
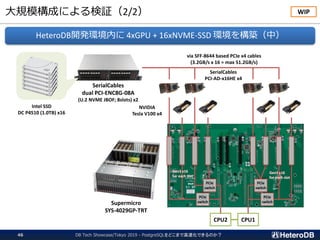
CPU2 CPU1
SerialCables
dual PCI-ENC8G-08A
(U.2 NVME JBOF; 8slots) x2
NVIDIA
Tesla V100 x4
46
PCIe
switch
PCIe
switch
PCIe
switch
PCIe
switch
Gen3 x16
for each slot
Gen3 x16
for each slot
via SFF-8644 based PCIe x4 cables
(3.2GB/s x 16 = max 51.2GB/s)
Intel SSD
DC P4510 (1.0TB) x16
SerialCables
PCI-AD-x16HE x4
WIP
Supermicro
SYS-4029GP-TRT
HeteroDB開発環境内に 4xGPU + 16xNVME-SSD 環境を構築(中)
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?
Resources
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?47
▌リポジトリ
 https://github.com/heterodb/pg-strom
 https://heterodb.github.io/swdc/
▌ドキュメント
 http://heterodb.github.io/pg-strom/
▌コンタクト
 kaigai@heterodb.com
 Tw: @kkaigai
ぜひ一緒にやりましょう!
DB Tech Showcase/Tokyo 2019 - PostgreSQLをどこまで高速化できるのか?48
✓ 問題解決に向けたアプローチの検討
✓ 技術課題の洗い出し、実現可能性の検討
✓ 必要な新機能の実装、実機・実データによる実証実験
✓ 製品化/実システム適用に向けた諸々の技術支援
PG-Stromの能力を活かすソリューションを一緒に創る事のできる
パートナー様、ユーザー様を探しています。
20190925_DBTS_PGStrom