第14回 GPGPU組込開発環境
長岡技術科学大学 電気電子情報工学専攻 出川智啓
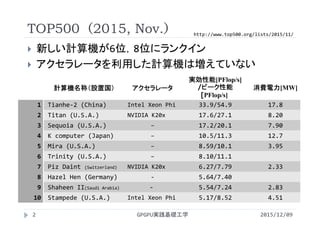
TOP500(2015, Nov.)
 新しい計算機が6位,8位にランクイン
 アクセラレータを利用した計算機は増えていない
GPGPU実践基礎工学2
計算機名称(設置国) アクセラレータ
実効性能[PFlop/s]
/ピーク性能
[PFlop/s]
消費電力[MW]
1 Tianhe‐2 (China) Intel Xeon Phi 33.9/54.9 17.8
2 Titan (U.S.A.) NVIDIA K20x 17.6/27.1 8.20
3 Sequoia (U.S.A.) − 17.2/20.1 7.90
4 K computer (Japan) − 10.5/11.3 12.7
5 Mira (U.S.A.) − 8.59/10.1 3.95
6 Trinity (U.S.A.) − 8.10/11.1
7 Piz Daint (Switzerland) NVIDIA K20x 6.27/7.79 2.33
8 Hazel Hen (Germany) ‐ 5.64/7.40
9 Shaheen II(Saudi Arabia) ‐ 5.54/7.24 2.83
10 Stampede (U.S.A.) Intel Xeon Phi 5.17/8.52 4.51
2015/12/09
http://www.top500.org/lists/2015/11/
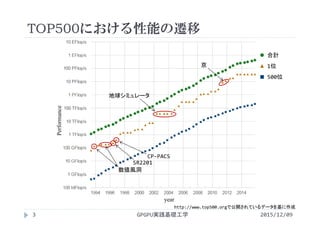
TOP500における性能の遷移
GPGPU実践基礎工学3
year
Performance
合計
1位
500位
京
地球シミュレータ
数値風洞
SR2201
CP‐PACS
2015/12/09
http://www.top500.orgで公開されているデータを基に作成
今回の内容
GPGPU実践基礎工学
 Jetson TK1の紹介
 外観,仕様
 サンプルの実行
 補足
 OpenCVによる画像処理
 OpenCVからGPUを利用する
4 2015/12/09
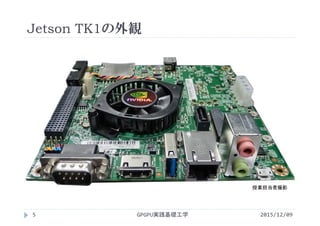
Jetson TK1の外観
GPGPU実践基礎工学5 2015/12/09
授業担当者撮影
Jetson TK1の仕様
GPGPU実践基礎工学6
 世界初の組み込みスーパーコンピューター
 NVIDIA Tegra K1を採用
 Keplarアーキテクチャ(192 CUDA コアを搭載)
 NVIDIA 4‐Plus‐1™ クアッドコア ARM® Cortex‐A15 CPU
 メモリ 2GB
 eMMC 16GB
 Linux for Tegraが動作
 CUDAやNsightも動作
 NVIDIA公式ページ
 http://www.nvidia.co.jp/object/jetson‐tk1‐
embedded‐dev‐kit‐jp.html
2015/12/09
https://developer.nvidia.com/nvidia‐nsight‐tegra
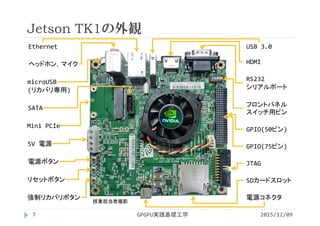
Jetson TK1の外観
GPGPU実践基礎工学7 2015/12/09
電源ボタン
リセットボタン
強制リカバリボタン
5V 電源
Mini PCIe
SATA
microUSB
ヘッドホン,マイク
Ethernet USB 3.0
HDMI
RS232
シリアルポート
フロントパネル
スイッチ用ピン
GPIO(75ピン)
JTAG
SDカードスロット
電源コネクタ
GPIO(50ピン)
(リカバリ専用)
授業担当者撮影
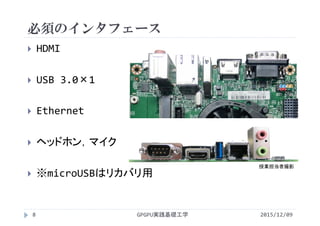
必須のインタフェース
GPGPU実践基礎工学8
 HDMI
 USB 3.0×1
 Ethernet
 ヘッドホン,マイク
 ※microUSBはリカバリ用
2015/12/09
授業担当者撮影
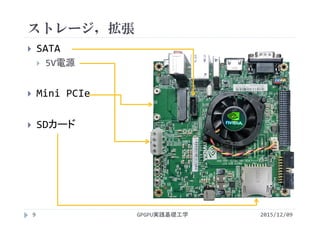
ストレージ,拡張
GPGPU実践基礎工学9
 SATA
 5V電源
 Mini PCIe
 SDカード
2015/12/09
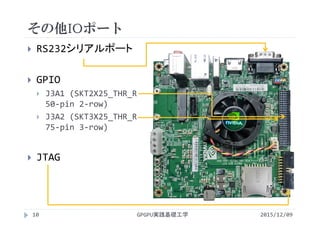
その他IOポート
2015/12/09GPGPU実践基礎工学10
 RS232シリアルポート
 GPIO
 J3A1 (SKT2X25_THR_R 
50‐pin 2‐row)
 J3A2 (SKT3X25_THR_R 
75‐pin 3‐row)
 JTAG
Jetson TK1の仕様で困った事
GPGPU実践基礎工学11
 USBポートが一つしかない
 USB Hubは必須
 電池が無いため,電源を抜くと時間がリセットされる
 電源供給が絶たれると日付が2000年1月1日にリセット
 電源に繋ぐと電源ボタンを押さなくても勝手に起動
 停電が明けると勝手に起動している
2015/12/09
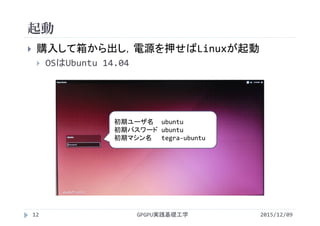
起動
GPGPU実践基礎工学12
 購入して箱から出し,電源を押せばLinuxが起動
 OSはUbuntu 14.04
初期ユーザ名 ubuntu
初期パスワード ubuntu
初期マシン名 tegra‐ubuntu
2015/12/09
初回起動後の設定
GPGPU実践基礎工学13
 言語,時間等
 標準ではOSの言語が英語,タイムゾーンがGMT
 利用する言語や地域に応じて設定
 CUDA Toolkitのインストール
 CUDA Samplesのインストール
 実行ファイルの場所
インストールしたディレクトリ/NVIDIA_CUDA‐6.5_Samples/
bin/armv7l/linux/release/gnueabihf
 OpenCVのインストール
2015/12/09
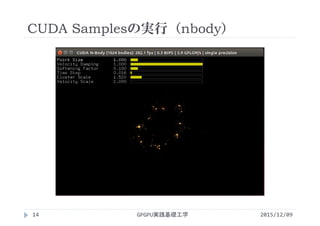
CUDA Samplesの実行(nbody)
2015/12/09GPGPU実践基礎工学14
CUDA Samplesの実行
2015/12/09GPGPU実践基礎工学15
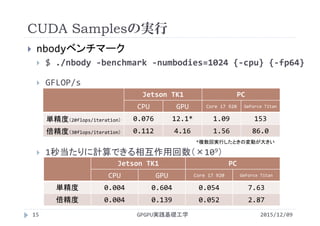
 nbodyベンチマーク
 $ ./nbody ‐benchmark ‐numbodies=1024 {‐cpu} {‐fp64}
 GFLOP/s
 1秒当たりに計算できる相互作用回数(×109)
Jetson TK1 PC
CPU GPU Core i7 920 GeForce Titan
単精度(20flops/iteration) 0.076 12.1* 1.09 153
倍精度(30flops/iteration) 0.112 4.16 1.56 86.0
Jetson TK1 PC
CPU GPU Core i7 920 GeForce Titan
単精度 0.004 0.604 0.054 7.63
倍精度 0.004 0.139 0.052 2.87
*複数回実行したときの変動が大きい
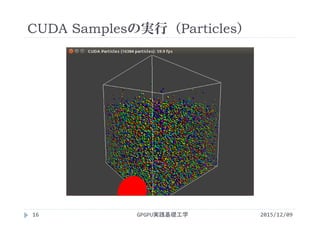
CUDA Samplesの実行(Particles)
2015/12/09GPGPU実践基礎工学16
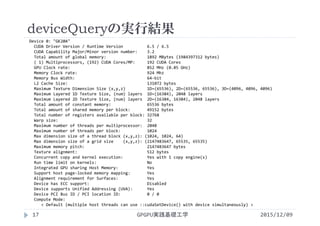
deviceQueryの実行結果
2015/12/09GPGPU実践基礎工学17
Device 0: "GK20A"
CUDA Driver Version / Runtime Version          6.5 / 6.5
CUDA Capability Major/Minor version number:    3.2
Total amount of global memory:                 1892 MBytes (1984397312 bytes)
( 1) Multiprocessors, (192) CUDA Cores/MP:     192 CUDA Cores
GPU Clock rate:                                852 MHz (0.85 GHz)
Memory Clock rate:                             924 Mhz
Memory Bus Width:                              64‐bit
L2 Cache Size:                                 131072 bytes
Maximum Texture Dimension Size (x,y,z)         1D=(65536), 2D=(65536, 65536), 3D=(4096, 4096, 4096)
Maximum Layered 1D Texture Size, (num) layers  1D=(16384), 2048 layers
Maximum Layered 2D Texture Size, (num) layers  2D=(16384, 16384), 2048 layers
Total amount of constant memory:               65536 bytes
Total amount of shared memory per block:       49152 bytes
Total number of registers available per block: 32768
Warp size:                                     32
Maximum number of threads per multiprocessor:  2048
Maximum number of threads per block:           1024
Max dimension size of a thread block (x,y,z): (1024, 1024, 64)
Max dimension size of a grid size    (x,y,z): (2147483647, 65535, 65535)
Maximum memory pitch:                          2147483647 bytes
Texture alignment:                             512 bytes
Concurrent copy and kernel execution:          Yes with 1 copy engine(s)
Run time limit on kernels:                     No
Integrated GPU sharing Host Memory:            Yes
Support host page‐locked memory mapping:       Yes
Alignment requirement for Surfaces:            Yes
Device has ECC support:                        Disabled
Device supports Unified Addressing (UVA):      Yes
Device PCI Bus ID / PCI location ID:           0 / 0
Compute Mode:
< Default (multiple host threads can use ::cudaSetDevice() with device simultaneously) >
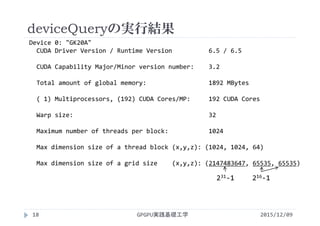
deviceQueryの実行結果
2015/12/09GPGPU実践基礎工学18
Device 0: "GK20A"
CUDA Driver Version / Runtime Version          6.5 / 6.5
CUDA Capability Major/Minor version number:    3.2
Total amount of global memory:                 1892 MBytes
( 1) Multiprocessors, (192) CUDA Cores/MP:     192 CUDA Cores
Warp size:                                     32
Maximum number of threads per block:           1024
Max dimension size of a thread block (x,y,z): (1024, 1024, 64)
Max dimension size of a grid size    (x,y,z): (2147483647, 65535, 65535)
231‐1 216‐1
プログラムの開発環境
GPGPU実践基礎工学19
 CUDA (Compute Unified Device Architecture)
 NVIDIA社製GPU向け開発環境
 Windows, Linux, Mac OS Xに対応
 C/C++言語 + GPU向け拡張
 専用コンパイラ(nvcc)とランタイムライブラリ
 いくつかのライブラリ
 cuFFT, cuBLAS, cuSPARSE, cuRAND, NPP, Thrust
 大量のサンプルプログラム
 CUDAのほぼ全ての機能を利用した例を確認できる
2015/12/09
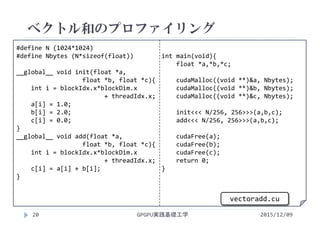
#define N (1024*1024)
#define Nbytes (N*sizeof(float))
__global__ void init(float *a,
float *b, float *c){
int i = blockIdx.x*blockDim.x
+ threadIdx.x;
a[i] = 1.0;
b[i] = 2.0;
c[i] = 0.0;
}
__global__ void add(float *a,
float *b, float *c){
int i = blockIdx.x*blockDim.x
+ threadIdx.x;
c[i] = a[i] + b[i];
}
int main(void){
float *a,*b,*c;
cudaMalloc((void **)&a, Nbytes);
cudaMalloc((void **)&b, Nbytes);
cudaMalloc((void **)&c, Nbytes);
init<<< N/256, 256>>>(a,b,c);
add<<< N/256, 256>>>(a,b,c);
cudaFree(a);
cudaFree(b);
cudaFree(c);
return 0;
}
ベクトル和のプロファイリング
GPGPU実践基礎工学
vectoradd.cu
20 2015/12/09
簡単なプロファイリング(CUDA 5以降)
GPGPU実践基礎工学21
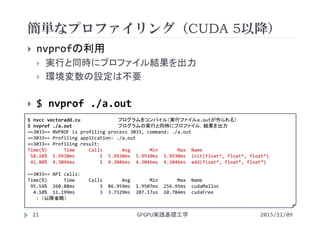
 nvprofの利用
 実行と同時にプロファイル結果を出力
 環境変数の設定は不要
 $ nvprof ./a.out
$ nvcc vectoradd.cu プログラムをコンパイル(実行ファイルa.outが作られる)
$ nvprof ./a.out プログラムの実行と同時にプロファイル,結果を出力
==3033== NVPROF is profiling process 3033, command: ./a.out
==3033== Profiling application: ./a.out
==3033== Profiling result:
Time(%)      Time     Calls       Avg Min       Max  Name
58.20%  5.9930ms         1  5.9930ms  5.9930ms 5.9930ms init(float*, float*, float*)
41.80%  4.3046ms         1  4.3046ms  4.3046ms 4.3046ms add(float*, float*, float*)
==3033== API calls:
Time(%)      Time     Calls       Avg Min       Max  Name
95.54%  260.88ms         3  86.959ms  1.9507ms  256.95ms  cudaMalloc
4.10%  11.199ms         3  3.7329ms  207.17us  10.784ms  cudaFree
: (以降省略)
2015/12/09
簡単なプロファイリング(CUDA 5以降)
GPGPU実践基礎工学22
 nvprofの特徴
 カーネルだけでなくAPI Callもプロファイリング可能
 $ nvprof ‐‐query‐events
 プロファイルできるイベント一覧を表示
 $ nvprof ‐‐events gld_request ./a.out
 プロファイルするイベントを指定して実行
 gst_request グローバルメモリへの書込回数
 gld_request グローバルメモリからの読込回数
2015/12/09
Jetson TK1の性能
GPGPU実践基礎工学23
 Jetson TK1に搭載されたGPU
 KeplerのSM1個分
 デスクトップに搭載されるGPUと比較すると低速
 CPU性能も低いので相対的に高速
 Jetson TK1は組込開発用のボード
 GPUの性能が低いチープなボード
 GPUによりデスクトップPC並の性能と省電力を両立
2015/12/09
OpenCV for Tegra
OpenCV
GPGPU実践基礎工学25
 Open Source Computer Vision Library
 オープンソースの動画像処理・解析用ライブラリ
 インテルが開発・公開
 Willow Garageに移管された後,Itseezがメンテナンス
 実装されている機能は多岐に渡る
 対応言語
 C/C++, Java, Python, MATLAB
 対応OS
 Windows, Mac OS X, Linux, FreeBSD, Android, iOS
2015/12/09
OpenCVから利用できるGPUの環境
2015/12/09GPGPU実践基礎工学26
 gpuモジュール
 CUDAを利用
 OpenCV2.2から
 OpenCVをビルドする際に有効化する必要がある
 oclモジュール
 OpenCLを利用
 OpenCV2.4.1から
 OpenCVをビルドする際に有効化する必要がある
 OpenCV3.0での変更点
 gpuモジュール→cudaモジュールに改称
 oclモジュールは廃止(各モジュールに取り込まれる)
OpenCVサンプルの実行(物体検出)
GPGPU実践基礎工学27
 コンパイル
 $
 実行(動画ファイルを利用)
 $
 実行(カメラを利用)
 $
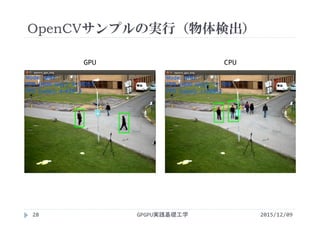
 GPUを利用する事で3~4倍程度高速化
2015/12/09
g++ hog.cpp ‐lopencv_core ‐lopencv_contrib ‐lopencv_objdet
ect ‐lopencv_highgui ‐lopencv_imgproc ‐lopencv_gpu
./a.out ‐‐video 768x576.avi
./a.out ‐‐camera 0
OpenCVサンプルの実行(物体検出)
GPGPU実践基礎工学28 2015/12/09
GPU CPU
OpenCVプログラム
2015/12/09GPGPU実践基礎工学29
 いくつかC++の機能を利用
 ソースファイルの拡張子は.cpp
 インクルードするヘッダはopencv2/*.hpp
 cvという名前空間に所属した変数(クラス)や関数群を利用
 ライブラリのリンク
 OpenCVのランタイムライブラリは非常に多数
 コンパイル時に必要なライブラリをリンク
 ‐lopencv_*(必要な機能に応じて決定)
輪郭抽出(ラプラシアンフィルタ)
2015/12/09GPGPU実践基礎工学30
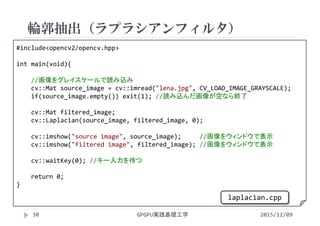
#include<opencv2/opencv.hpp>
int main(void){
//画像をグレイスケールで読み込み
cv::Mat source_image = cv::imread("lena.jpg", CV_LOAD_IMAGE_GRAYSCALE);
if(source_image.empty()) exit(1); //読み込んだ画像が空なら終了
cv::Mat filtered_image;
cv::Laplacian(source_image, filtered_image, 0);
cv::imshow("source image", source_image);     //画像をウィンドウで表示
cv::imshow("filtered image", filtered_image); //画像をウィンドウで表示
cv::waitKey(0); //キー入力を待つ
return 0;
}
laplacian.cpp
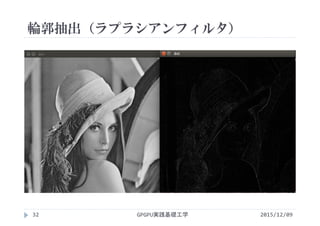
輪郭抽出(ラプラシアンフィルタ)
2015/12/09GPGPU実践基礎工学31
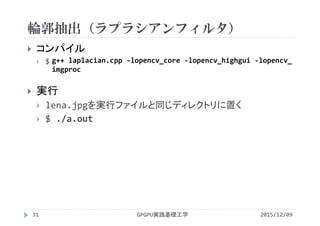
 コンパイル
 $
 実行
 lena.jpgを実行ファイルと同じディレクトリに置く
 $ ./a.out
g++ laplacian.cpp ‐lopencv_core ‐lopencv_highgui ‐lopencv_
imgproc
輪郭抽出(ラプラシアンフィルタ)
2015/12/09GPGPU実践基礎工学32
OpenCVからGPUを使う
GPGPU実践基礎工学33
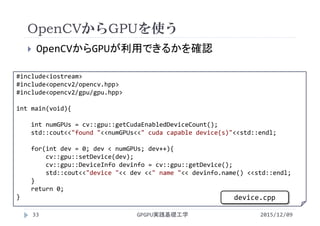
 OpenCVからGPUが利用できるかを確認
#include<iostream>
#include<opencv2/opencv.hpp>
#include<opencv2/gpu/gpu.hpp>
int main(void){
int numGPUs = cv::gpu::getCudaEnabledDeviceCount();
std::cout<<"found "<<numGPUs<<" cuda capable device(s)"<<std::endl;
for(int dev = 0; dev < numGPUs; dev++){
cv::gpu::setDevice(dev);
cv::gpu::DeviceInfo devinfo = cv::gpu::getDevice();
std::cout<<"device "<< dev <<" name "<< devinfo.name() <<std::endl;
}
return 0;
}
2015/12/09
device.cpp
OpenCVからGPUを使う
2015/12/09GPGPU実践基礎工学34
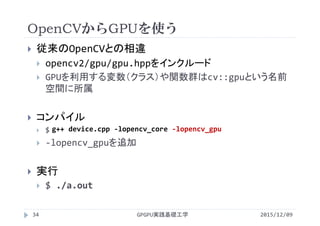
 従来のOpenCVとの相違
 opencv2/gpu/gpu.hppをインクルード
 GPUを利用する変数(クラス)や関数群はcv::gpuという名前
空間に所属
 コンパイル
 $
 ‐lopencv_gpuを追加
 実行
 $ ./a.out
g++ device.cpp ‐lopencv_core ‐lopencv_gpu
OpenCVからGPUを使う
2015/12/09GPGPU実践基礎工学35
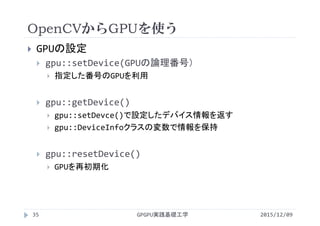
 GPUの設定
 gpu::setDevice(GPUの論理番号)
 指定した番号のGPUを利用
 gpu::getDevice()
 gpu::setDevce()で設定したデバイス情報を返す
 gpu::DeviceInfoクラスの変数で情報を保持
 gpu::resetDevice()
 GPUを再初期化
OpenCVからGPUを使う
2015/12/09GPGPU実践基礎工学36
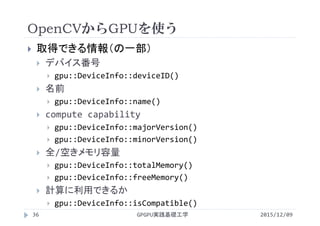
 取得できる情報(の一部)
 デバイス番号
 gpu::DeviceInfo::deviceID()
 名前
 gpu::DeviceInfo::name()
 compute capability
 gpu::DeviceInfo::majorVersion()
 gpu::DeviceInfo::minorVersion()
 全/空きメモリ容量
 gpu::DeviceInfo::totalMemory()
 gpu::DeviceInfo::freeMemory()
 計算に利用できるか
 gpu::DeviceInfo::isCompatible()
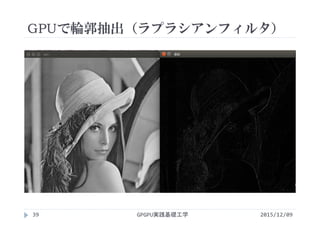
GPUで輪郭抽出(ラプラシアンフィルタ)
GPGPU実践基礎工学37
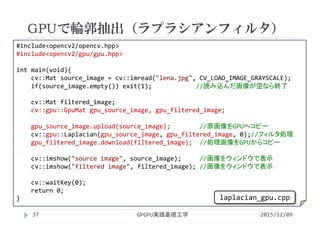
 画像を開いてLaplacian(輪郭抽出フィルタをかける)#include<opencv2/opencv.hpp>
#include<opencv2/gpu/gpu.hpp>
int main(void){
cv::Mat source_image = cv::imread("lena.jpg", CV_LOAD_IMAGE_GRAYSCALE);
if(source_image.empty()) exit(1);            //読み込んだ画像が空なら終了
cv::Mat filtered_image;
cv::gpu::GpuMat gpu_source_image, gpu_filtered_image;
gpu_source_image.upload(source_image); //原画像をGPUへコピー
cv::gpu::Laplacian(gpu_source_image, gpu_filtered_image, 0);//フィルタ処理
gpu_filtered_image.download(filtered_image); //処理画像をGPUからコピー
cv::imshow("source image", source_image);     //画像をウィンドウで表示
cv::imshow("filtered image", filtered_image); //画像をウィンドウで表示
cv::waitKey(0);
return 0;
}
2015/12/09
laplacian_gpu.cpp
GPUで輪郭抽出(ラプラシアンフィルタ)
2015/12/09GPGPU実践基礎工学38
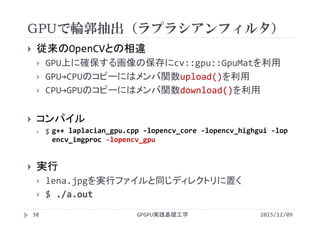
 従来のOpenCVとの相違
 GPU上に確保する画像の保存にcv::gpu::GpuMatを利用
 GPU→CPUのコピーにはメンバ関数upload()を利用
 CPU→GPUのコピーにはメンバ関数download()を利用
 コンパイル
 $
 実行
 lena.jpgを実行ファイルと同じディレクトリに置く
 $ ./a.out
g++ laplacian_gpu.cpp ‐lopencv_core ‐lopencv_highgui ‐lop
encv_imgproc ‐lopencv_gpu
GPUで輪郭抽出(ラプラシアンフィルタ)
2015/12/09GPGPU実践基礎工学39
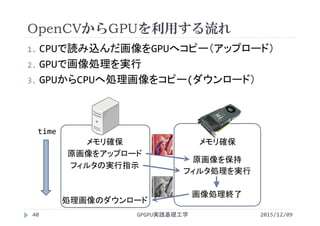
OpenCVからGPUを利用する流れ
1. CPUで読み込んだ画像をGPUへコピー(アップロード)
2. GPUで画像処理を実行
3. GPUからCPUへ処理画像をコピー(ダウンロード)
メモリ確保 メモリ確保
フィルタの実行指示
フィルタ処理を実行
処理画像のダウンロード
画像処理終了
time
2015/12/09GPGPU実践基礎工学40
原画像をアップロード
原画像を保持
カメラから画像を取得して画面表示
GPGPU実践基礎工学41
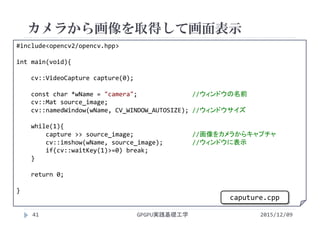
 カメラで画像を取り込む
 カラー
#include<opencv2/opencv.hpp>
int main(void){
cv::VideoCapture capture(0);
const char *wName = "camera";               //ウィンドウの名前
cv::Mat source_image;
cv::namedWindow(wName, CV_WINDOW_AUTOSIZE); //ウィンドウサイズ
while(1){
capture >> source_image;                //画像をカメラからキャプチャ
cv::imshow(wName, source_image);        //ウィンドウに表示
if(cv::waitKey(1)>=0) break;
}
return 0;
}
2015/12/09
caputure.cpp
カメラから画像を取得して画面表示
2015/12/09GPGPU実践基礎工学42
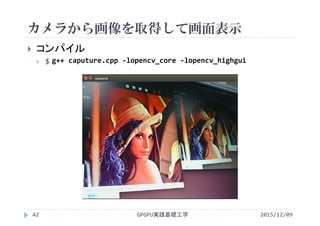
 コンパイル
 $ g++ caputure.cpp ‐lopencv_core ‐lopencv_highgui
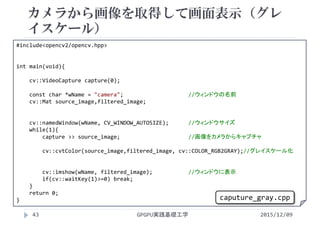
カメラから画像を取得して画面表示(グレ
イスケール)
GPGPU実践基礎工学43
 カメラで画像を取り込む
 カラー
#include<opencv2/opencv.hpp>
int main(void){
cv::VideoCapture capture(0);
const char *wName = "camera";                    //ウィンドウの名前
cv::Mat source_image,filtered_image;
cv::namedWindow(wName, CV_WINDOW_AUTOSIZE);      //ウィンドウサイズ
while(1){
capture >> source_image;                     //画像をカメラからキャプチャ
cv::cvtColor(source_image,filtered_image, cv::COLOR_RGB2GRAY);//グレイスケール化
cv::imshow(wName, filtered_image);           //ウィンドウに表示
if(cv::waitKey(1)>=0) break;
}
return 0;
}
2015/12/09
caputure_gray.cpp
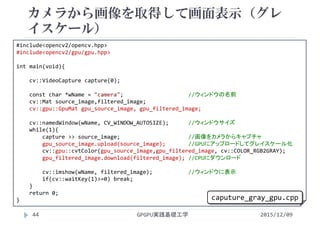
カメラから画像を取得して画面表示(グレ
イスケール)
GPGPU実践基礎工学44
 カメラで画像を取り込む
 カラー
#include<opencv2/opencv.hpp>
#include<opencv2/gpu/gpu.hpp>
int main(void){
cv::VideoCapture capture(0);
const char *wName = "camera";                    //ウィンドウの名前
cv::Mat source_image,filtered_image;
cv::gpu::GpuMat gpu_source_image, gpu_filtered_image;
cv::namedWindow(wName, CV_WINDOW_AUTOSIZE);      //ウィンドウサイズ
while(1){
capture >> source_image;                     //画像をカメラからキャプチャ
gpu_source_image.upload(source_image);       //GPUにアップロードしてグレイスケール化
cv::gpu::cvtColor(gpu_source_image,gpu_filtered_image, cv::COLOR_RGB2GRAY);
gpu_filtered_image.download(filtered_image); //CPUにダウンロード
cv::imshow(wName, filtered_image);           //ウィンドウに表示
if(cv::waitKey(1)>=0) break;
}
return 0;
}
2015/12/09
caputure_gray_gpu.cpp
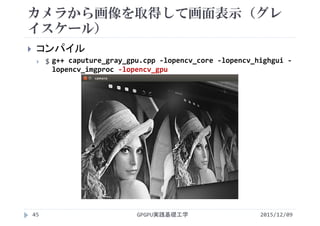
カメラから画像を取得して画面表示(グレ
イスケール)
2015/12/09GPGPU実践基礎工学45
 コンパイル
 $ g++ caputure_gray_gpu.cpp ‐lopencv_core ‐lopencv_highgui ‐
lopencv_imgproc ‐lopencv_gpu
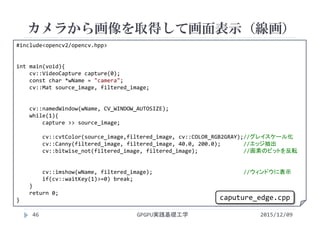
カメラから画像を取得して画面表示(線画)
GPGPU実践基礎工学46
 カメラで画像を取り込む
 カラー
#include<opencv2/opencv.hpp>
int main(void){
cv::VideoCapture capture(0);
const char *wName = "camera";
cv::Mat source_image, filtered_image;
cv::namedWindow(wName, CV_WINDOW_AUTOSIZE);
while(1){
capture >> source_image;
cv::cvtColor(source_image,filtered_image, cv::COLOR_RGB2GRAY);//グレイスケール化
cv::Canny(filtered_image, filtered_image, 40.0, 200.0);       //エッジ抽出
cv::bitwise_not(filtered_image, filtered_image);              //画素のビットを反転
cv::imshow(wName, filtered_image);                            //ウィンドウに表示
if(cv::waitKey(1)>=0) break;
}
return 0;
}
2015/12/09
caputure_edge.cpp
カメラから画像を取得して画面表示(線画)
GPGPU実践基礎工学47
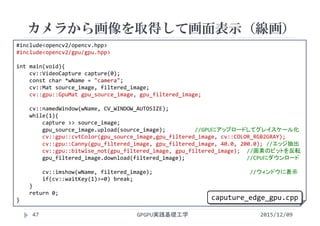
 カメラで画像を取り込む
 カラー
#include<opencv2/opencv.hpp>
#include<opencv2/gpu/gpu.hpp>
int main(void){
cv::VideoCapture capture(0);
const char *wName = "camera";
cv::Mat source_image, filtered_image;
cv::gpu::GpuMat gpu_source_image, gpu_filtered_image;
cv::namedWindow(wName, CV_WINDOW_AUTOSIZE);
while(1){
capture >> source_image;
gpu_source_image.upload(source_image);         //GPUにアップロードしてグレイスケール化
cv::gpu::cvtColor(gpu_source_image,gpu_filtered_image, cv::COLOR_RGB2GRAY);
cv::gpu::Canny(gpu_filtered_image, gpu_filtered_image, 40.0, 200.0); //エッジ抽出
cv::gpu::bitwise_not(gpu_filtered_image, gpu_filtered_image); //画素のビットを反転
gpu_filtered_image.download(filtered_image);                   //CPUにダウンロード
cv::imshow(wName, filtered_image);                              //ウィンドウに表示
if(cv::waitKey(1)>=0) break;
}
return 0;
}
2015/12/09
caputure_edge_gpu.cpp
カメラから画像を取得して画面表示(グレ
イスケール)
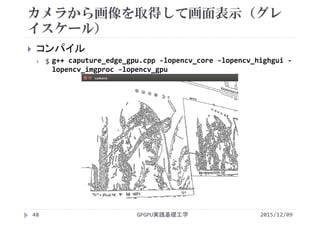
2015/12/09GPGPU実践基礎工学48
 コンパイル
 $ g++ caputure_edge_gpu.cpp ‐lopencv_core ‐lopencv_highgui ‐
lopencv_imgproc ‐lopencv_gpu
まとめ
2015/12/09GPGPU実践基礎工学49
 Jetson TK1を紹介
 組込用途に設計されているため省電力
 CPUはARMで非力
 GPUはデスクトップ版KeplerのSM1個分
 うまく活用することで,省電力と高い性能を両立
 OpenCV for Tegraを紹介
 GPUを利用するための環境が整えられている
 ヘッダをインクルードし,cv::gpuに所属する関数等を利用