Hbase勉強会	
  
Chapter	
  6	
  Available	
  Clients	
          2012年4月23日	
  
             遠山敏章
内容	
•  利用可能なクライアントの紹介/説明	
  
 –  インタラクティブなクライアント	
  
     •  Na8ve	
  Java,	
  REST,	
  Thri?,	
  Avroなど	
  
 –  バッチクライアント	
  
     •  MapReduce,	
  Hive,	
  Pig,	
  Cacading	
  
 –  Shellコマンド	
  
     •  Hbase	
  shellコマンド、スクリプティング(JRuby)	
  
 –  Web-­‐based	
  UI	
  
     •  Master	
  UI,	
  RegionServer	
  UI,	
  Shared	
  Pages	
  
REST,	
  Thri?,	
  Avro	
  の紹介(p241)	
•  Hbase	
  のアクセス方法	
  
  –  クライアントAPI:	
  Java	
  
  –  プロキシ:	
  あらゆる言語	
  
      •  内部はHtableのクライアントAPI	
  
•  Gatewayとクライント間のプロトコルはリモート
   クライアントの要求しだいで決まる	
  
  –  REST	
  (Representa8onal	
  State	
  Transfer)	
  
REST	
•  Webアプリの標準プロトコルであるHTTP経由な
   ので、ヘテロなシステム間での通信に適している	
  
•  プロトコルを変更せずに既存の技術と互換性が
   ある。	
  
    •  URIでユニークにリソースにアクセス可。一方、SOAPは新し
       い標準に合わせるために新しいプロトコルを定義する。	
  
•  テキスト/XMLは冗長で帯域を消費する	
  
•  → オーバーヘッドを減らす場合はProtocol	
  
   Buffers,	
  Thri?,	
  Avroを使う
Protocol	
  Buffersと	
  Thri?,	
  Avroの違い
                  (p242)	
•  Protocol	
  Bufferers	
  	
  
     –  RPC	
  スタックを持たない	
  
     –  RPCの定義のみを生成	
  
     –  HbaseのRESTサーバーをgatwayとして利用	
  
•  Thri?,	
  Avro	
  
     –  独自のRPCの実装を持つ	
  
        •  Hbaseのgatewayサーバーはその実装のラッパーを提
           供する	
  
※RESTの実装はhbaseが独自に用意している
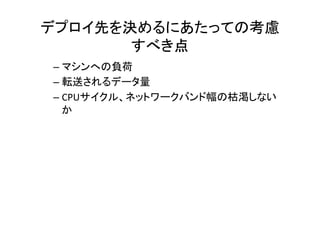
Gatewayとデプロイ先(p242)	
•  Gateway	
  サーバーはHtableベースのClient	
  APIを利用	
  
•  Gatewayサーバーのデプロイ先	
  
   –  RegionServerと同じマシン	
  
   –  GatwayServer専用のマシン	
  
   –  GatewayClientのマシン	
  
      •  例:webServerにデプロイすると、	
  
         –  clientとgateway間通信をローカルで行う	
  
         –  gatewayとhbase間のRPCはna8ve	
  protocolで行う。	


       Figure	
  6-­‐2	
  gatewayサーバー経由で接続したクライアント
デプロイ先を決めるにあたっての考慮
       すべき点	
–  マシンへの負荷	
  
–  転送されるデータ量	
  
–  CPUサイクル、ネットワークバンド幅の枯渇しない
   か	
  
コネクション(p243)	
•  パフォーマンスの最大化にはコネクションの
   再利用が必要(p199	
  Htable	
  Pool)	
  
  –  短命のプロセスはコネクションの確立とメタデータ
     の準備が実際の操作よりも時間がかかる。	
  
  –  リージョン情報のキャッシングのためにコネクショ
     ンを再利用するのは特に重要。	
  
    •  しないと、row-­‐to-­‐region	
  lookupをアクセスする度に行う。
RESTとThri?/Avroのユースケース
               (p244)	
•  RESTユースケース	
  
   –  少数のリクエスト数でリクエストのサイズが大きいとき、有
      効	
  
   –  ウェブベースなので、リバースプロキシやキャッシュの技
      術が利用可能。	
  
   –  負荷分散のためにRESTサーバーを並列にデプロイする。	
  
       •  例:全てのappサーバーにデプロイ(single-­‐app-­‐to-­‐server	
  
          rela8onship)	
  
•  Thri?/Avro	
  
   –  スループットの最大化したい時に有効	
  
   –  デプロイするサーバー数を少なくできる。	
  
       •  例:Regionサーバーごとにデプロイ(many-­‐app-­‐to-­‐server	
  
          cardinality)	
  
Interac8veクライアント	
•  クライアントAPIを必要に応じて発行(get,	
  put,	
  
   delete)	
  
  –  Na8ve	
  Java(Chapter	
  3,	
  4)	
  
      •  Gateway	
  serverは不要。HTableを使ってRPC経由で通
         信	
  
  –  REST	
  
      •  HbaseはClient	
  APIとadmin	
  APIをサポートしたRESTサー
         バーを提供する。また、異なったフォーマットもサポート。	
  
REST	
  オペレーション(p244)	
•  RESTサーバーはHbase	
  tableの全ての操作が可
            能	
  
	
  $	
  bin/hbase	
  rest 	


  #	
  ヘルプの表示	
	
  $	
  bin/hbase-­‐daemon.sh	
  start	
  rest 	
   	
   	
  #	
  デーモンの起動	
 $	
  bin/hbase	
  rest	
  start 	


  #	
  起動	

 $	
  bin/hbase-­‐daemon.sh	
  stop	
  rest               	
   	
   	
  #	
  デーモンの停止	
	
  $	
  curl	
  h]p://<servername>:8080/	


  #	
  テーブルノリスト	
 $	
  curl	
  h]p://<servername>:8080/version 	
                    	
  #バージョンの表示	
	
  
•  オペレーションとXMLスキーマのドキュメント	
  
     h]p://hbase.apache.org/apidocs/org/apache/hadoop/
     hbase/rest/package-­‐summary.html	
  
•  ステートレスなので、複数のサーバーで起動して
   負荷分散する事ができる(例:ラウンドロビン)。	
  
サポートしているフォーマット(p246) 	
•  H]pのContents-­‐Type	
  と	
  Accept	
  ヘッダーを指
   定してRESTサーバーと異なるフォーマットで通
   信できる	
  
サポートしているフォーマット	
  
                  text/plain	
  (p246)	
•  バイトデータをURLエンコーディングして指定
   可能。	
  
•  ‘tes]able’テーブル,	
  rowKey	
  ‘%01%02%03’,	
  
   colfam1:col1	
  のvalueを取得	
  
•  複雑なresultをplain	
  text	
  にフォーマットできな
   い。	

$	
  curl	
  -­‐H	
  "Accept:	
  text/plain"	
  h]p://localhost:8080/tes]able/%01%02%03/colfam1:col1	
  
<html>	
  
<head>	
  
<meta	
  h]p-­‐equiv="Content-­‐Type"	
  content="text/html;	
  charset=ISO-­‐8859-­‐1"/>	
  
<8tle>Error	
  406	
  Not	
  Acceptable</8tle>	
  
</head>…	
  
サポートしているフォーマット	
  
                          XML(text/plain)	
  (p247)	
•  XMLはデフォルトのフォーマット	
  
•  カラム名とvalueはBase64にエンコードされる。	
  
•  Base64	
  コマンドでコンテンツを取得できる。	
  
$	
  curl	
  h]p://localhost:8080/tes]able/%01%02%03/colfam1:col1	
  
<?xml	
  version="1.0"	
  encoding="UTF-­‐8"	
  standalone="yes"?>	
  
<CellSet>	
  
           	
  <Row	
  key="AQID">	


  <Cell	
  8mestamp="1334479509580"	
  column="Y29sZmFtMTpjb2wx">dmFsdWUx</Cell>	
  
           	
  </Row>	
  
</CellSet>	


$	
  echo	
  AQID	
  |	
  base64	
  -­‐d	
  |	
  hexdump	
  
0000000	
  01	
  02	
  03	


0000003	


$	
  echo	
  Y29sZmFtMTpjb2wx	
  |	
  base64	
  -­‐d	
  
colfam1:col1	


$	
  echo	
  dmFsdWUx	
  |	
  base64	
  -­‐d	
  
Value1	
  
サポートしているフォーマット	
  
            JSON(applica8on/plain)	
  (p247)	
•  ヘッダーで指定	


 $	
  curl	
  -­‐H	
  "Accept:	
  applica8on/json"	
  h]p://localhost:8080/tes]able/%01%02%03/colfam1:col1	
  
	
  {"Row":[{"key":"AQID","Cell":[{"8mestamp":	
  
1334479509580,"column":"Y29sZmFtMTpjb2wx","$":"dmFsdWUx"}]}]}	


•  XMLとJSONの違いはJSONはkey/valueで指定
   しなければならない。’$’keyはcellのデータを
   を意味する。	
  
サポートしているフォーマット	
  
            Protocol	
  Buffer(applica8on/x-­‐protobuf)	
  (p247)	
       •  ProtocolBufferはna8veのRPCスタックを提供し
          ないのでRESTサーバーがencodingをサポート	
  
       •  Schemaの定義はドキュメントを参照	
  
       •  Hexdump	
  コマンドでバイナリーフォーマットで
          表示	
  
$	
  curl	
  -­‐H	
  "Accept:	
  applica8on/x-­‐protobuf"	
  h]p://localhost:8080/tes]able/%01%02%03/colfam1:col1	
  |	
  	
  
hexdump	
  -­‐C	


  %	
  Total	


  %	
  Received	
  %	
  Xferd	
  	
  Average	
  Speed	
  	
  	
  Time	


  Time	


  Time	
  	
  Current	


  Dload	
  	
  Upload	
  	
  	
  Total	
  	
  	
  Spent	


  Le?	
  	
  Speed	


  0	


  38	


  0	


  38	


  0	


  0	
  	
  11695	


  0	
  -­‐-­‐:-­‐-­‐:-­‐-­‐	
  -­‐-­‐:-­‐-­‐:-­‐-­‐	
  -­‐-­‐:-­‐-­‐:-­‐-­‐	
  19000	
  
00000000	
  	
  0a	
  24	
  0a	
  03	
  01	
  02	
  03	
  12	
  	
  1d	
  12	
  0c	
  63	
  6f	
  6c	
  66	
  61	
  	
  |.$.........colfa|	
  
00000010	
  	
  6d	
  31	
  3a	
  63	
  6f	
  6c	
  31	
  18	
  	
  cc	
  b0	
  b5	
  a9	
  eb	
  26	
  22	
  06	
  	
  |m1:col1......&".|	
  
00000020	
  	
  76	
  61	
  6c	
  75	
  65	
  31	


  |value1|	
  
00000026
サポートしているフォーマット	
  
                   Raw	
  binary(applica8on/octet-­‐stream)	
  (p249)	
          •  戻り値はcellのデータのみ	
  
$	
  curl	
  -­‐H	
  "Accept:	
  applica9on/octet-­‐stream"	
  h]p://localhost:8080/tes]able/%01%02%03/colfam1:col1	
  |	
  	
  
hexdump	
  –C	


  %	
  Total	


  %	
  Received	
  %	
  Xferd	
  	
  Average	
  Speed	
  	
  	
  Time	


  Time	


  Time	
  	
  Current	


  Dload	
  	
  Upload	
  	
  	
  Total	
  	
  	
  Spent	


  Le?	
  	
  Speed	


  0	


  6	


  0	


  6	


  0	


  0	


  196	


  0	
  -­‐-­‐:-­‐-­‐:-­‐-­‐	
  -­‐-­‐:-­‐-­‐:-­‐-­‐	
  -­‐-­‐:-­‐-­‐:-­‐-­‐	
  	
  	
  206	
  
00000000	
  	
  76	
  61	
  6c	
  75	
  65	
  31	


  |value1|	
  
00000006	

          •  RESTサーバーは構造データをカスタムヘッダー
             に詰める。	
  
 curl	
  -­‐D-­‐	
  -­‐H	
  "Accept:	
  applica8on/octet-­‐stream"	
  h]p://localhost:8080/tes]able/%01%02%03/colfam1:col1	
  
 HTTP/1.1	
  200	
  OK	
  
 Content-­‐Length:	
  6	
  
 X-­‐Timestamp:	
  1334479509580 	
                        	
   	
  #	
  raw	
  getはcellの8mestampをresponse	
  header	
  に詰める	
  
 Content-­‐Type:	
  applica8on/octet-­‐stream
REST	
  Java	
  client	
  (p250)	
•  RESTのJava	
  API	
  client	
  
    –  org.apache.hadoop.hbase.rest.client	
  
    –  主要なクラス	
  	
  
        •  RemoteHTable	
  (Example	
  6-­‐1)	
  
        •  RemoteAdmin	
  
•  RemoteHTableはGet/Scanなどの標準のJava	
  Client	
  API
   を使いながら、多くのRESTサーバーと通信するのに便
   利な手段	
  
•  Java	
  REST	
  client	
  はprotocol	
  buffer	
  encodingをREST
   サーバーの通信に利用	
  
    –  RESTサーバーがサポートする1番コンパクトなプロトコル
       なので、帯域効率が一番良い
Thri?	
  (p251)	
•  C++で実装	
  
•  多くの言語のスキーマのコンパイラーを提供し、異なる言
   語間で透過的にメッセージ交換できる。	
  
•  Hbaseにはclient/admin	
  APIのスキーマファイルが同梱され
   ている。	
  
•  Thri?と通信するJavaの生成されたコードはHbaseに同梱済
   み。	
  
•  php	
  の設定例(p253、省略)	
  

[	
  hbase-­‐0.90.4-­‐cdh3u2	
  でのコードの生成例	
  ]	
  
$	
  cd	
  hbase-­‐0.90.4-­‐cdh3u2/src/examples/thri?	
  
$	
  thri?	
  -­‐-­‐gen	
  cpp	
  -­‐-­‐gen	
  java	
  -­‐-­‐gen	
  rb	
  -­‐-­‐gen	
  py	
  -­‐-­‐gen	
  php	


  ../../../src/main/resources/org/apache/hadoop/hbase/thri?/Hbase.thri?	
  
$	
  ls	
  ./	
  |	
  grep	
  gen	
  |	
  tr	
  '012'	
  ' '	
  
gen-­‐cpp gen-­‐java gen-­‐php gen-­‐py gen-­‐rb
Avro	
  (p255)	
•  Thri?と同様に、多くの言語のスキーマのコンパイラーを提供し、異なる言
   語間で透過的にメッセージ交換できる。	
  
•  Hbaseテーブルの全ての操作をAvroサーバーは提供する	
  
•  ドキュメント	
  
      –  Javadoc:	
  	
  
             •  h]p://hbase.apache.org/apidocs/org/apache/hadoop/hbase/avro/package-­‐
                summary.html#pbufschema	
  
      –  スキーマ:	
  	
  
             •  $HBASE_HOME/src/main/java/org/apache/hadoop/hbase/avro/hbase.avdl	
  
•  ステートレスなので負荷分散のために複数のAvroサーバーをデプロイし、
   ラウンドロビンでロードバランスするのも有効。	


[	
  hbase	
  shell	
  操作 ]	
  
$	
  bin/hbase	
  avro          	


  #	
  ヘルプの表示	
$	
  bin/hbase	
  avro	
  start	


  #	
  起動	
$	
  bin/hbase-­‐daemon.sh	
  start	
  avro      	
     	
     	
  #	
  デーモンの起動	
$	
  bin/hbase-­‐daemon.sh	
  stop	
  avro       	
     	
     	
  #	
  デーモンの停止
その他のクライアント(p256)	
•  Jvm上で動いたり、gatewayサーバーと通信したりする
   クライアントが存在する	
  
•  プロジェクト例	
  
 –  JRuby:	
  jvmベースの言語。例はhbase	
  shell	
  
 –  HBsql:	
  	
  SQLライクな構文を提供	
  
 –  Hbase-­‐DSL:	
  Builderライクにクエリーを構築できるクラスを
    提供	
  
 –  JPA/JPO:	
  JPA/JPOアクセス層を提供。例はDataNucleus	
  
 –  PyHBase:	
  Avro	
  gataway	
  server経由のHbase	
  client	
  
 –  AsyncHBase:	
  非同期、ノンブロッキング、スレッドセーフな
    クライアント。Na8veのRPCプロトコルを利用。	
  
•  メンテされていないプロジェクトもあるので注意	
  
バッチクライアント(p257)	
•  大規模データの構築にバックグラウンドで非
   同期に実行される	
  
 –  使用例:インデックスの構築、機械学習ベースの
    数学モデル、レポートに必要な統計	
  
•  ユーザー駆動型のアクセスではないため
   サービス品質保証はバッチの実行時間に連
   動する	
  
MapReduce(p257)	
•  数PBのデータ処理を信頼性を確保して容易
   にプログラミングできる	
  
•  MapReduceジョブでHbaseをソース/ターゲット
   にする方法はいろいろある	
  
•  手法	
  
 –  Na8ve	
  Java	
  (ch.	
  7)	
  
 –  Clojure:	
  Hbase-­‐runnerはClojureでMapReduceジョ
    ブを書くことができる
Hive	
  (p258)	
•  Hadoop上のデータウェアハウスインフラ	
  
•  HiveQL	
  
   –  SQL-­‐likeなクエリー言語	
  
   –  クエリはMRジョブに変換される	
  
   –  データはジョブ実行時にパースされる	
  
•  Storage	
  Handler	
  
   –  データソースの抽象レイヤー	
  
   –  例	
  
       •  HDFS、HBase(Hive	
  ver.	
  >=	
  0.6.0)
Hive	
  (p258)	
  	
•  Hive	
  version	
  0.6.0	
  はHbaseのhandlerを同梱	
  
•  必要に応じて、カラムのマッピングをできる	
  
•  Row	
  keyは1つのカラムとして扱える	
  
Hbase	
  Versionサポート(p258)	
•  Hive	
  ver.	
  0.7.0はHbase	
  0.89.0-­‐SNAPSHOTのみ
   サポート(執筆時)	
  
   –  RPCはversionの変更にセンシティブなためマイ
      ナーな違いもbail	
  out	
  する。	
  
•  現在のHbaseのバージョンで利用するには
   Hbaseのjarを置き換えて、hiveをソースからコ
   ンパイルする方法がある	
  
•  Hbaseにアクセスするための手順	
  
   –  Conf/hive-­‐env.shの修正
Hive	
  (p260)	
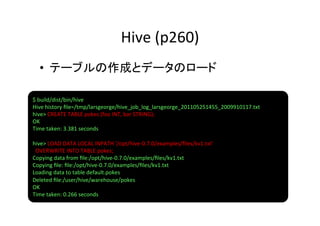
   •  テーブルの作成とデータのロード	
  

$	
  build/dist/bin/hive	
  
Hive	
  history	
  file=/tmp/larsgeorge/hive_job_log_larsgeorge_201105251455_2009910117.txt	
  
hive>	
  CREATE	
  TABLE	
  pokes	
  (foo	
  INT,	
  bar	
  STRING);	


OK	
  
Time	
  taken:	
  3.381	
  seconds	


hive>	
  LOAD	
  DATA	
  LOCAL	
  INPATH	
  '/opt/hive-­‐0.7.0/examples/files/kv1.txt'	


  OVERWRITE	
  INTO	
  TABLE	
  pokes;	
  
Copying	
  data	
  from	
  file:/opt/hive-­‐0.7.0/examples/files/kv1.txt	
  
Copying	
  file:	
  file:/opt/hive-­‐0.7.0/examples/files/kv1.txt	
  
Loading	
  data	
  to	
  table	
  default.pokes	
  
Deleted	
  file:/user/hive/warehouse/pokes	
  
OK	
  
Time	
  taken:	
  0.266	
  seconds	
  
Hive	
  (p260)	
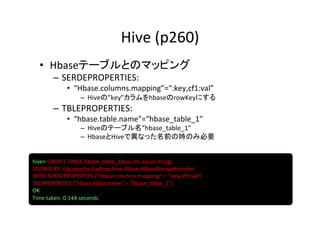
   •  Hbaseテーブルとのマッピング	
  
         –  SERDEPROPERTIES:	
  	
  
                •  “Hbase.columns.mapping”=“:key,cf1:val”	
  
                       –  Hiveの”key”カラムをhbaseのrowKeyにする	
  
         –  TBLEPROPERTIES:	
  	
  
                •  “hbase.table.name”=“hbase_table_1”	
  
                       –  Hiveのテーブル名”hbase_table_1”	
  
                       –  HbaseとHiveで異なった名前の時のみ必要	


hive>	
  CREATE	
  TABLE	
  hbase_table_1(key	
  int,	
  value	
  string)	
  
STORED	
  BY	
  'org.apache.hadoop.hive.hbase.HBaseStorageHandler'	
  	
  
WITH	
  SERDEPROPERTIES	
  ("hbase.columns.mapping"	
  =	
  ":key,cf1:val")	
  	
  
TBLPROPERTIES	
  ("hbase.table.name"	
  =	
  "hbase_table_1");	
  
OK	
  
Time	
  taken:	
  0.144	
  seconds	
  
Hive	
  (p261)	
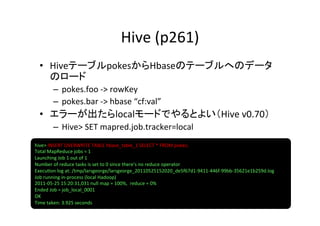
  •  HiveテーブルpokesからHbaseのテーブルへのデータ
     のロード	
  
         –  pokes.foo	
  -­‐>	
  rowKey	
  
         –  pokes.bar	
  -­‐>	
  hbase	
  “cf:val”	
  
  •  エラーが出たらlocalモードでやるとよい(Hive	
  v0.70)	
  
         –  Hive>	
  SET	
  mapred.job.tracker=local	
  
hive>	
  INSERT	
  OVERWRITE	
  TABLE	
  hbase_table_1	
  SELECT	
  *	
  FROM	
  pokes;	
  
Total	
  MapReduce	
  jobs	
  =	
  1	
  
Launching	
  Job	
  1	
  out	
  of	
  1	
  
Number	
  of	
  reduce	
  tasks	
  is	
  set	
  to	
  0	
  since	
  there's	
  no	
  reduce	
  operator	
  
Execu8on	
  log	
  at:	
  /tmp/larsgeorge/larsgeorge_20110525152020_de5f67d1-­‐9411-­‐446f-­‐99bb-­‐35621e1b259d.log	
  
Job	
  running	
  in-­‐process	
  (local	
  Hadoop)	
  
2011-­‐05-­‐25	
  15:20:31,031	
  null	
  map	
  =	
  100%,	
  	
  reduce	
  =	
  0%	
  
Ended	
  Job	
  =	
  job_local_0001	
  
OK	
  
Time	
  taken:	
  3.925	
  seconds	
  
Hive	
  (p261-­‐262)	
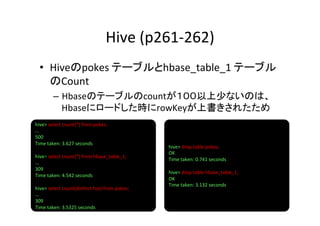
   •  Hiveのpokes	
  テーブルとhbase_table_1	
  テーブル
      のCount	
  
               –  Hbaseのテーブルのcountが100以上少ないのは、
                  Hbaseにロードした時にrowKeyが上書きされたため	
  
hive>	
  select	
  count(*)	
  from	
  pokes;	


…	
  
500	
  
Time	
  taken:	
  3.627	
  seconds	
  
                                                                                             hive>	
  drop	
  table	
  pokes;	


                                                                                             OK	
  
hive>	
  select	
  count(*)	
  from	
  hbase_table_1;	
  
                                                                                             Time	
  taken:	
  0.741	
  seconds	
  
…	


309	
  
                                                                                             hive>	
  drop	
  table	
  hbase_table_1;	
  
Time	
  taken:	
  4.542	
  seconds	
  
                                                                                             OK	


                                                                                             Time	
  taken:	
  3.132	
  seconds	
  
hive>	
  select	
  count(dis8nct	
  foo)	
  from	
  pokes;	


…	
  
309	
  
Time	
  taken:	
  3.5325	
  seconds	
  
Hive	
  (p262)	
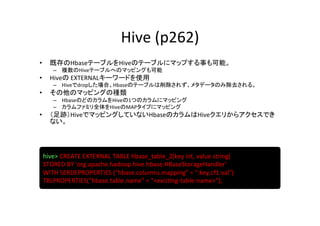
•       既存のHbaseテーブルをHiveのテーブルにマップする事も可能。	
  
         –  複数のHiveテーブルへのマッピングも可能	
  
•       Hiveの	
  EXTERNALキーワードを使用	
  
         –  Hiveでdropした場合、Hbaseのテーブルは削除されず、メタデータのみ除去される。	
  
•       その他のマッピングの種類	
  
         –  HbaseのどのカラムをHiveの1つのカラムにマッピング	
  
         –  カラムファミリ全体をHiveのMAPタイプにマッピング	
  
•       (足跡)HiveでマッピングしていないHbaseのカラムはHiveクエリからアクセスでき
        ない。	


     hive>	
  CREATE	
  EXTERNAL	
  TABLE	
  hbase_table_2(key	
  int,	
  value	
  string)	
  	
  
     STORED	
  BY	
  'org.apache.hadoop.hive.hbase.HBaseStorageHandler'	
  
     WITH	
  SERDEPROPERTIES	
  ("hbase.columns.mapping"	
  =	
  ":key,cf1:val")	
  
     TBLPROPERTIES("hbase.table.name"	
  =	
  "<exis8ng-­‐table-­‐name>");	
  
Hive	
  (p262)	
•  StorageHandlerは高レベルのレイヤーとして
   透過的に機能するためUDFも使用できる。	
  
•  欠点	
  
 –  Serializa8onがカスタムできない	
  
   •  Hbaseは	
  byte[]	
  のみ保存するので、HiveはStringに全
      て変換する	
  
      –  Ex.	
  Hive	
  の	
  INT	
  カラムの	
  12	
  は Bytes.toBytes(“12”)として扱わ
         れ、文字列になる	
  
 –  Hbase	
  のversionの指定をサポートしない	
   •  最新のversionをHiveは返す	
  
Pig	
  (p263)	
•  Pig	
  La8n言語を持つ高レベルクエリー言語	
  
•  命令的なプログラミングスタイル	
  
   –  入力データを出力データにするまでの変換手順を記述できる	
  
•  Pig	
  v0.7.0の LoadFunc/StoreFunc	
  はHDFS以外をデータ
   ソースにできる	
  
•  HBaseStorage	
  クラスはHbaseをソースとする	
  
   –  既存のテーブルのread/writeができる	
  
   –  TableのカラムをPigのtupleにマッピングできる	
  
      •  Readでは最初のフィールドをrowKeyとして扱える(オプション)	
  
      •  Writeでは最初のフィールドは常にrowKeyになる	
  
   –  基本的なfilteringをrowの粒度でサポート	
  
   –  比較演算子もサポート(p139)	
  
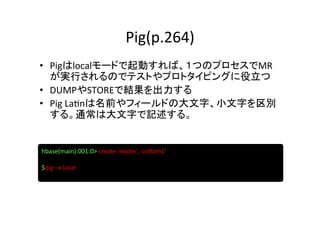
Pig(p.264)	
•  Pigはlocalモードで起動すれば、1つのプロセスでMR
   が実行されるのでテストやプロトタイピングに役立つ	
  
•  DUMPやSTOREで結果を出力する	
  
•  Pig	
  La8nは名前やフィールドの大文字、小文字を区別
   する。通常は大文字で記述する。	


hbase(main):001:0>	
  create	
  'excite',	
  'colfam1’	


$pig	
  –x	
  local	


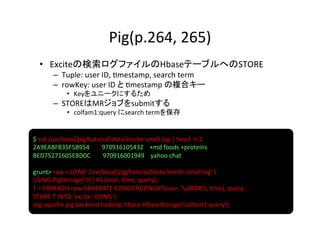
Pig(p.264,	
  265)	
   •  Exciteの検索ログファイルのHbaseテーブルへのSTORE	
  
         –  Tuple:	
  user	
  ID,	
  8mestamp,	
  search	
  term	
  
         –  rowKey:	
  user	
  ID	
  と	
  8mestamp	
  の複合キー	
  
                •  Keyをユニークにするため	
  
         –  STOREはMRジョブをsubmitする	
  
                •  colfam1:query	
  にsearch	
  termを保存	


$	
  cat	
  /usr/local/pig/tutorial/data/excite-­‐small.log	
  |	
  head	
  -­‐n	
  2	
  
2A9EABFB35F5B954	


  970916105432	


  +md	
  foods	
  +proteins	
  
BED75271605EBD0C	


  970916001949	


  yahoo	
  chat	


grunt>	
  raw	
  =	
  LOAD	
  '/usr/local/pig/tutorial/data/excite-­‐small.log'	
  	
  
USING	
  PigStorage('t')	
  AS	
  (user,	
  8me,	
  query);	
  
T	
  =	
  FOREACH	
  raw	
  GENERATE	
  CONCAT(CONCAT(user,	
  'u0000'),	
  8me),	
  query;	
  
STORE	
  T	
  INTO	
  'excite'	
  USING	
  	
  
org.apache.pig.backend.hadoop.hbase.HBaseStorage('colfam1:query');	
  
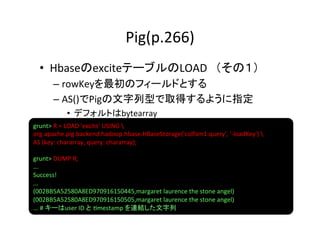
Pig(p.266)	
  •  HbaseのexciteテーブルのLOAD (その1)	
  
       –  rowKeyを最初のフィールドとする	
  
       –  AS()でPigの文字列型で取得するように指定	
  
             •  デフォルトはbytearray	
  
grunt>	
  R	
  =	
  LOAD	
  'excite'	
  USING	
  	
  
org.apache.pig.backend.hadoop.hbase.HBaseStorage('colfam1:query',	
  '-­‐loadKey')	
  	
  
AS	
  (key:	
  chararray,	
  query:	
  chararray);	


grunt>	
  DUMP	
  R;	
  
...	
  
Success!	
  
...	
  
(002BB5A52580A8ED970916150445,margaret	
  laurence	
  the	
  stone	
  angel)	
  
(002BB5A52580A8ED970916150505,margaret	
  laurence	
  the	
  stone	
  angel)	
  
...	
  #	
  キーはuser	
  ID	
  と 8mestamp	
  を連結した文字列	
  
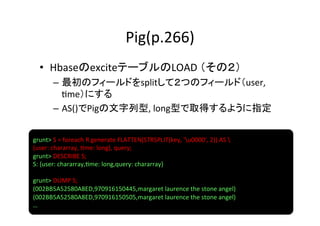
Pig(p.266)	
   •  HbaseのexciteテーブルのLOAD	
  (その2)	
  
          –  最初のフィールドをsplitして2つのフィールド(user,	
  
             8me)にする	
  
          –  AS()でPigの文字列型,	
  long型で取得するように指定	


grunt>	
  S	
  =	
  foreach	
  R	
  generate	
  FLATTEN(STRSPLIT(key,	
  'u0000',	
  2))	
  AS	
  	
  
(user:	
  chararray,	
  8me:	
  long),	
  query;	
  
grunt>	
  DESCRIBE	
  S;	
  
S:	
  {user:	
  chararray,8me:	
  long,query:	
  chararray}	


grunt>	
  DUMP	
  S;	
  
(002BB5A52580A8ED,970916150445,margaret	
  laurence	
  the	
  stone	
  angel)	
  
(002BB5A52580A8ED,970916150505,margaret	
  laurence	
  the	
  stone	
  angel)	
  
…	
  
Pig(p.266)	
•  欠点	
  
   –  Hbase	
  のversionの指定をサポートしない	
      •  最新のversionをPigは返す	
  
   –  固定のカラムマッピング	
  
      •  rowKeyは必ず最初のフィールドにしなければならない	
  
      •  FOREAH	
  …	
  GENERATE	
  文でフィールドの順序を変更す
         る事ができる	
  
Cascading	
  (p267)	
•  MapReduceの代替のAPI	
  
   –  MapReduceので考えずに開発が行え、Hadoop上でジョブの実行がで
      きる	
  
•  構成要素	
  
   –  Pipe	
  
   –  データソース:	
  tap	
  
   –  出力ソース:	
  sink	
  
•  Tapとsinkをpipeでつなげて、処理フローを構成できる。	
  
•  複数のpipeを互いにつなげて、より大きなpipeを組み立てられる	
  
•  データはパイプラインを通って、split,	
  merge,	
  grouping,	
  join	
  するこ
   とができる。	
  
•  データはtupleで表現される	
  
•  v1.01でHbaseクラスターから読み書きするモジュールを提供する	
  
•  Cascading上のDSLを提供するプロジェクトもある	
  
   –  Ex.	
  cascalog,	
  scalding,	
  cascading.jruby	
  
Shell	
  (p268,	
  p269)	
•  Hbase	
  shell	
  は	
  local/remoteのHbaseクラス
   ターをインタラクティブに操作するCLI	
  
•  クライアントとadminのオペレーションができる	
  
•  Jrubyベースのshell	
  
  –  コマンド履歴、コマンドの補完、rubyのコマンドを
     サポート	
  
•  Jrubyを実行するためのJARを同梱しているの
   でrubyのインストールは不要	
  
Shell	
  (p269,	
  p270)	
•  基本コマンド	
  
  –  help:	
  ヘルプ表示	
  
  –  exit:	
  終了	
  
  –  $HBASE_HOME/bin/hbase	
  shell	
  –h	
  
        •  コマンドラインオプションの表示	
  
  –  debug:	
  	
  
        •  Debugモードの切り替え 。OFFだとERRORレベルで出力。	
  
•  設定ファイルはHBASE_HOMEディレクトリが適用され
   る	
  
•  特定のディレクトリ配下の設定を指定する場合	
  
  –  $	
  HBASE_CONF_DIR="/<your-­‐other-­‐config-­‐dir>/"	
  bin/
     hbase	
  shell	
  
Commnds	
  (p271)	
•  ガイドライン	
  
  –  名前のクオート	
  
       •  テーブル名/カラム名はシングル/ダブルクオートする	
  
  –  Valueのクオート	
  
       •  8/16進数表記のバイナリvalueの入出力をサポート	
  
       •  シングルクオートはリテラルとして扱う	
  
       •  ダブルクオートは8進/16進をバイトに変換する	
  
             –  Ex.	
  hbase>	
  put	
  't1',	
  "testxefxff",	
  'f1:',	
  "x01x33x70"	
  
  –  コンマ区切りのパラメータ	
  
       •  Ex.	
  hbase(main):001:0>	
  get	
  'tes]able',	
  'row-­‐1’,	
  'colfam1:qual1’	
  
  –  プロパティのためのRuby	
  ハッシュ	
  
       •  Ex.	
  hbase(main):001:0>	
  create	
  'tes]able',	
  {NAME=>'colfam1',	
  
          VERSIONS	
  =>	
  1,	
  TTL	
  =>	
  2592000,	
  BLOCKCACHE	
  =>	
  true}	
  
•  コマンドごとの詳細なヘルプの表示するhelp	
  
  –  Ex.	
  hbase(main):001:0>	
  help	
  'status'	
  
出力の制限(p271)	
  •  MAXLENGTH	
  パラメータでconsoleに出力する
     valueの長さの最大値を指定できる	


hbase(main):001:0>	
  put	
  'tes]able','rowlong','colfam1:qual1','abcdefghijklmnopqrstuvwxyzabcdefghi	
  	
  
jklmnopqrstuvwxyzabcdefghijklmnopqrstuvwxyzabcdefghijklmnopqrstuvwxyzabcde	
  	
  
...	
  
xyzabcdefghijklmnopqrstuvwxyzabcdefghijklmnopqrstuvwxyz'	


hbase(main):018:0>	
  get	
  'tes]able',	
  'rowlong',	
  MAXLENGTH	
  =>	
  60	
  
COLUMN	


  CELL	
  
colfam1:qual1	
  	
  	
  8mestamp=1306424577316,	
  value=abcdefghijklmnopqrstuvwxyzabc	
  
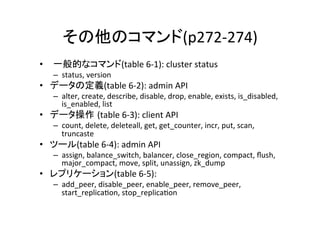
その他のコマンド(p272-­‐274)	
•  	
   一般的なコマンド(table	
  6-­‐1):	
  cluster	
  status	
  
    –  status,	
  version	
  
•  データの定義(table	
  6-­‐2):	
  admin	
  API	
  
    –  alter,	
  create,	
  describe,	
  disable,	
  drop,	
  enable,	
  exists,	
  is_disabled,	
  
       is_enabled,	
  list	
  
•  データ操作 (table	
  6-­‐3):	
  client	
  API	
  
    –  count,	
  delete,	
  deleteall,	
  get,	
  get_counter,	
  incr,	
  put,	
  scan,	
  
       truncaste	
  
•  ツール(table	
  6-­‐4):	
  admin	
  API	
  
    –  assign,	
  balance_switch,	
  balancer,	
  close_region,	
  compact,	
  flush,	
  
       major_compact,	
  move,	
  split,	
  unassign,	
  zk_dump	
  
•  レプリケーション(table	
  6-­‐5):	
  
    –  add_peer,	
  disable_peer,	
  enable_peer,	
  remove_peer,	
  
       start_replica8on,	
  stop_replica8on	
  
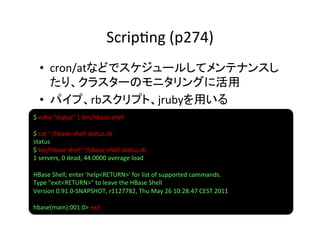
Scrip8ng	
  (p274)	
  •  cron/atなどでスケジュールしてメンテナンスし
     たり、クラスターのモニタリングに活用	
  
  •  パイプ、rbスクリプト、jrubyを用いる	
  
$	
  echo	
  "status"	
  |	
  bin/hbase	
  shell	


$	
  cat	
  ~/hbase-­‐shell-­‐status.rb	
  	
  
status	
  
$	
  bin/hbase	
  shell	
  ~/hbase-­‐shell-­‐status.rb	
  	
  
1	
  servers,	
  0	
  dead,	
  44.0000	
  average	
  load	


HBase	
  Shell;	
  enter	
  'help<RETURN>'	
  for	
  list	
  of	
  supported	
  commands.	
  
Type	
  "exit<RETURN>"	
  to	
  leave	
  the	
  HBase	
  Shell	
  
Version	
  0.91.0-­‐SNAPSHOT,	
  r1127782,	
  Thu	
  May	
  26	
  10:28:47	
  CEST	
  2011	


hbase(main):001:0>	
  exit	
  
Scrip8ng	
  (p275)	
   •  Jrubyでjavaのクラスを使用できる	
  

$	
  cat	
  ~/hbase-­‐shell-­‐status-­‐2.rb	
  	
  
include	
  Java	
  
import	
  org.apache.hadoop.hbase.HBaseConfigura8on	
  
import	
  org.apache.hadoop.hbase.client.HBaseAdmin	


conf	
  =	
  HBaseConfigura8on.new	
  
admin	
  =	
  HBaseAdmin.new(conf)	
  
tables	
  =	
  admin.listTables	
  
tables.each	
  {	
  |table|	
  puts	
  table.getNameAsString()	
  	
  }	


$	
  bin/hbase	
  org.jruby.Main	
  ~/hbase-­‐shell-­‐status-­‐2.rb	
  
Tes]able	
  
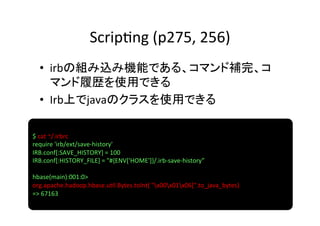
Scrip8ng	
  (p275,	
  256)	
  •  irbの組み込み機能である、コマンド補完、コ
     マンド履歴を使用できる	
  
  •  Irb上でjavaのクラスを使用できる	

$	
  cat	
  ~/.irbrc	
  
require	
  'irb/ext/save-­‐history'	
  
IRB.conf[:SAVE_HISTORY]	
  =	
  100	
  
IRB.conf[:HISTORY_FILE]	
  =	
  "#{ENV['HOME']}/.irb-­‐save-­‐history”	


hbase(main):001:0>	
  
org.apache.hadoop.hbase.u8l.Bytes.toInt(	
  "x00x01x06[".to_java_bytes)	
  
=>	
  67163	
  
Scrip8ng	
  (p256)	
#	
  epoch時刻の取得	
  
hbase(main):002:0>	
  java.text.SimpleDateFormat.new("yyyy/MM/dd	
  HH:mm:ss").parse(	


  "2011/05/30	
  20:56:29").getTime()	
  
=>	
  1306781789000	
  
#	
  時刻の取得	
  
hbase(main):002:0>	
  java.u8l.Date.new(1306781789000).toString()	
  
=>	
  "Mon	
  May	
  30	
  20:56:29	
  CEST	
  2011"	
  
#ループを使ってテストデータをPUT	
  
hbase(main):003:0>	
  for	
  i	
  in	
  'a'..'z'	
  do	
  for	
  j	
  in	
  
'a'..'z'	
  do	
  put	
  'tes]able',	
  	
  
"row-­‐#{i}#{j}",	
  "colfam1:#{j}",	
  "#{j}"	
  end	
  end	
  
#	
  年月日の文字列をqualifier、	
  
#	
  ランダムなLongの数値を配列にし、文字列に変換した値をvalueにPUT	
  
hbase(main):004:0>	
  require	
  'date';	
  
import	
  java.lang.Long	
  
import	
  org.apache.hadoop.hbase.u8l.Bytes	
  
(Date.new(2011,	
  01,	
  01)..Date.today).each	
  {	
  |x|	
  put	
  "tes]able",	
  "daily",	
  	
  
"colfam1:"	
  +	
  x.str?ime("%Y%m%d"),	
  Bytes.toBytes(Long.new(rand	
  *	
  	
  
4000).longValue).to_a.pack("CCCCCCCC")	
  }	
  
Web-­‐based	
  UI	
  (p277)	
•  Web-­‐based	
  UIのポート	
  
   –  Master	
  UIポート:	
  60010	
  
   –  ResgionServer	
  ポート:	
  60030	
  
•  Hbase-­‐site.xmlの Hbase.master.info.port,	
  
   hbase.regionserver.info.port	
  で変更可能	
  
•  Master	
  UI	
  ページの構成	
  
   –  Mainページ(Figure	
  6-­‐2)	
  
   –  User	
  Tableページ(Figure	
  6-­‐5)	
  
   –  ZooKeeperページ(Figure	
  6-­‐7)	
  
Web-­‐based	
  UI	
  (p277-­‐279)	
•  Mainページ(Figure	
  6-­‐8)	
  
    –  RegionServer属性	
  
        •  クラスター全体の詳細	
  
    –  実行中のタスク(Figure	
  6-­‐3)	
  
        •  マスターによって行われた内部オペレーション	
  
        •  背景の色:白→実行中、緑→成功、黄→中止	
  
    –  Catalog	
  テーブル	
  
        •  .META.,	
  -­‐ROOT-­‐	
  の詳細	
  
    –  ユーザーテーブル	
  
        •  全てのテーブルのリスト	
  
    –  リージョンサーバー	
  
        •  マスターに登録されているリージョンサーバーのリスト	
  
    –  移行中のリージョン(Figure	
  6-­‐4)	
  
        •  ロードバランシング中のリージョンのリスト。リージョンのopen,	
  close,	
  
           splitしているリージョン。リージョンのライフサイクルはp348を参照。	
  
Web-­‐based	
  UI	
  (p279-­‐281)	
•  User	
  Table	
  Page:	
  ユーザーテーブルのリンクをクリックすると出る
   ページ(Figure	
  6-­‐5)	
  
   –  テーブル属性	
  
         •  テーブルの状態などを表示	
  
   –  テーブルリージョン	
  
         •  startKey,	
  endKey,	
  リクエストの総数(read/write)	
  
         •  “Not	
  deploy”はどのRegionServerでのサーブされていないリージョン	
  
   –  Regions	
  by	
  region	
  server	
  
         •  RegionServerごとのリージョン数。通常は均等に分散されている。されてなけ
            れば、moveコマンドで手動でリージョンの移動可能。	
  
•  Adminのオペレーションの実行	
  
   –  Compact	
  
         •  コンパクションをバックグランドで非同期に実行。任意でリージョン名を指定可
            能。	
  
   –  Split	
  
         •  テーブル、又は、リージョンの範囲でsplitコマンドを実行。セルが全くなかった
            り、ほとんどない場合、又は、splitの最中のリージョンはsplitできない。	
  
Web-­‐based	
  UI	
  (p282)	
•  ZooKeeperページ(Figure	
  6-­‐7)	
  
   –  ZooKeeper内に保存されている全てのノードのコ
      ンテンツをダンプ(zk_dumpコマンド)	
  
      •  トラブルシューティングに役立つ	
  
   –  zk_dumpの内容	
  
      •  現在のMasterサーバー	
  
      •  どのRegionServerが-­‐ROOT-­‐カタログを保持しているか	
  
      •  Masterに登録されているRegionServer	
  
      •  ZooKeeperの内部の詳細	
  
Web-­‐based	
  UI	
  (p283)	
•  Shared	
  Pages	
  
   –  Local	
  logs	
  (Figure	
  6-­‐9)	
  
        •  ログファイルを表示	
  
   –  Thread	
  dumps	
  (Figure	
  6-­‐10)	
  
        •  デバッグ目的で、Hbaseのプロセスのスタックとレース
           を表示	
  
   –  Log	
  level	
  
        •  Hbaseプロセスのログレベルの取得/設定ができる	
  
        •  Ex.	
  org.apache.hadoop.hbase	
  を第一フィールドに入力
           (Figure6-­‐12)